


I 6 migliori strumenti open-source di analisi dei log: Wazuh, Graylog e altri
In qualità di CISO in un settore altamente regolamentato con circa 2 decenni di esperienza in cybersecurity, ho lavorato con molteplici piattaforme di analisi dei log simili a SIEM. Da queste ho selezionato i 6 migliori strumenti open-source di analisi dei log. Nel valutare questi strumenti mi sono concentrato su fattori chiave come la flessibilità nella raccolta dei log, il rilevamento degli eventi in tempo reale, la scalabilità e il supporto di vari formati di log.
Funzionalità di gestione e rilevamento dei log
Funzionalità di integrità e non ripudio
Prezzi degli strumenti di analisi dei log
Wazuh
Wazuh è un SIEM open-source che va oltre la maggior parte degli strumenti di questa categoria. Combina monitoraggio dei log, sicurezza degli endpoint, monitoraggio dell'integrità dei file, rilevamento delle vulnerabilità e rilevamento degli eventi di sicurezza in tempo reale in un'unica piattaforma basata su agenti.
Come funziona la gestione dei log in Wazuh
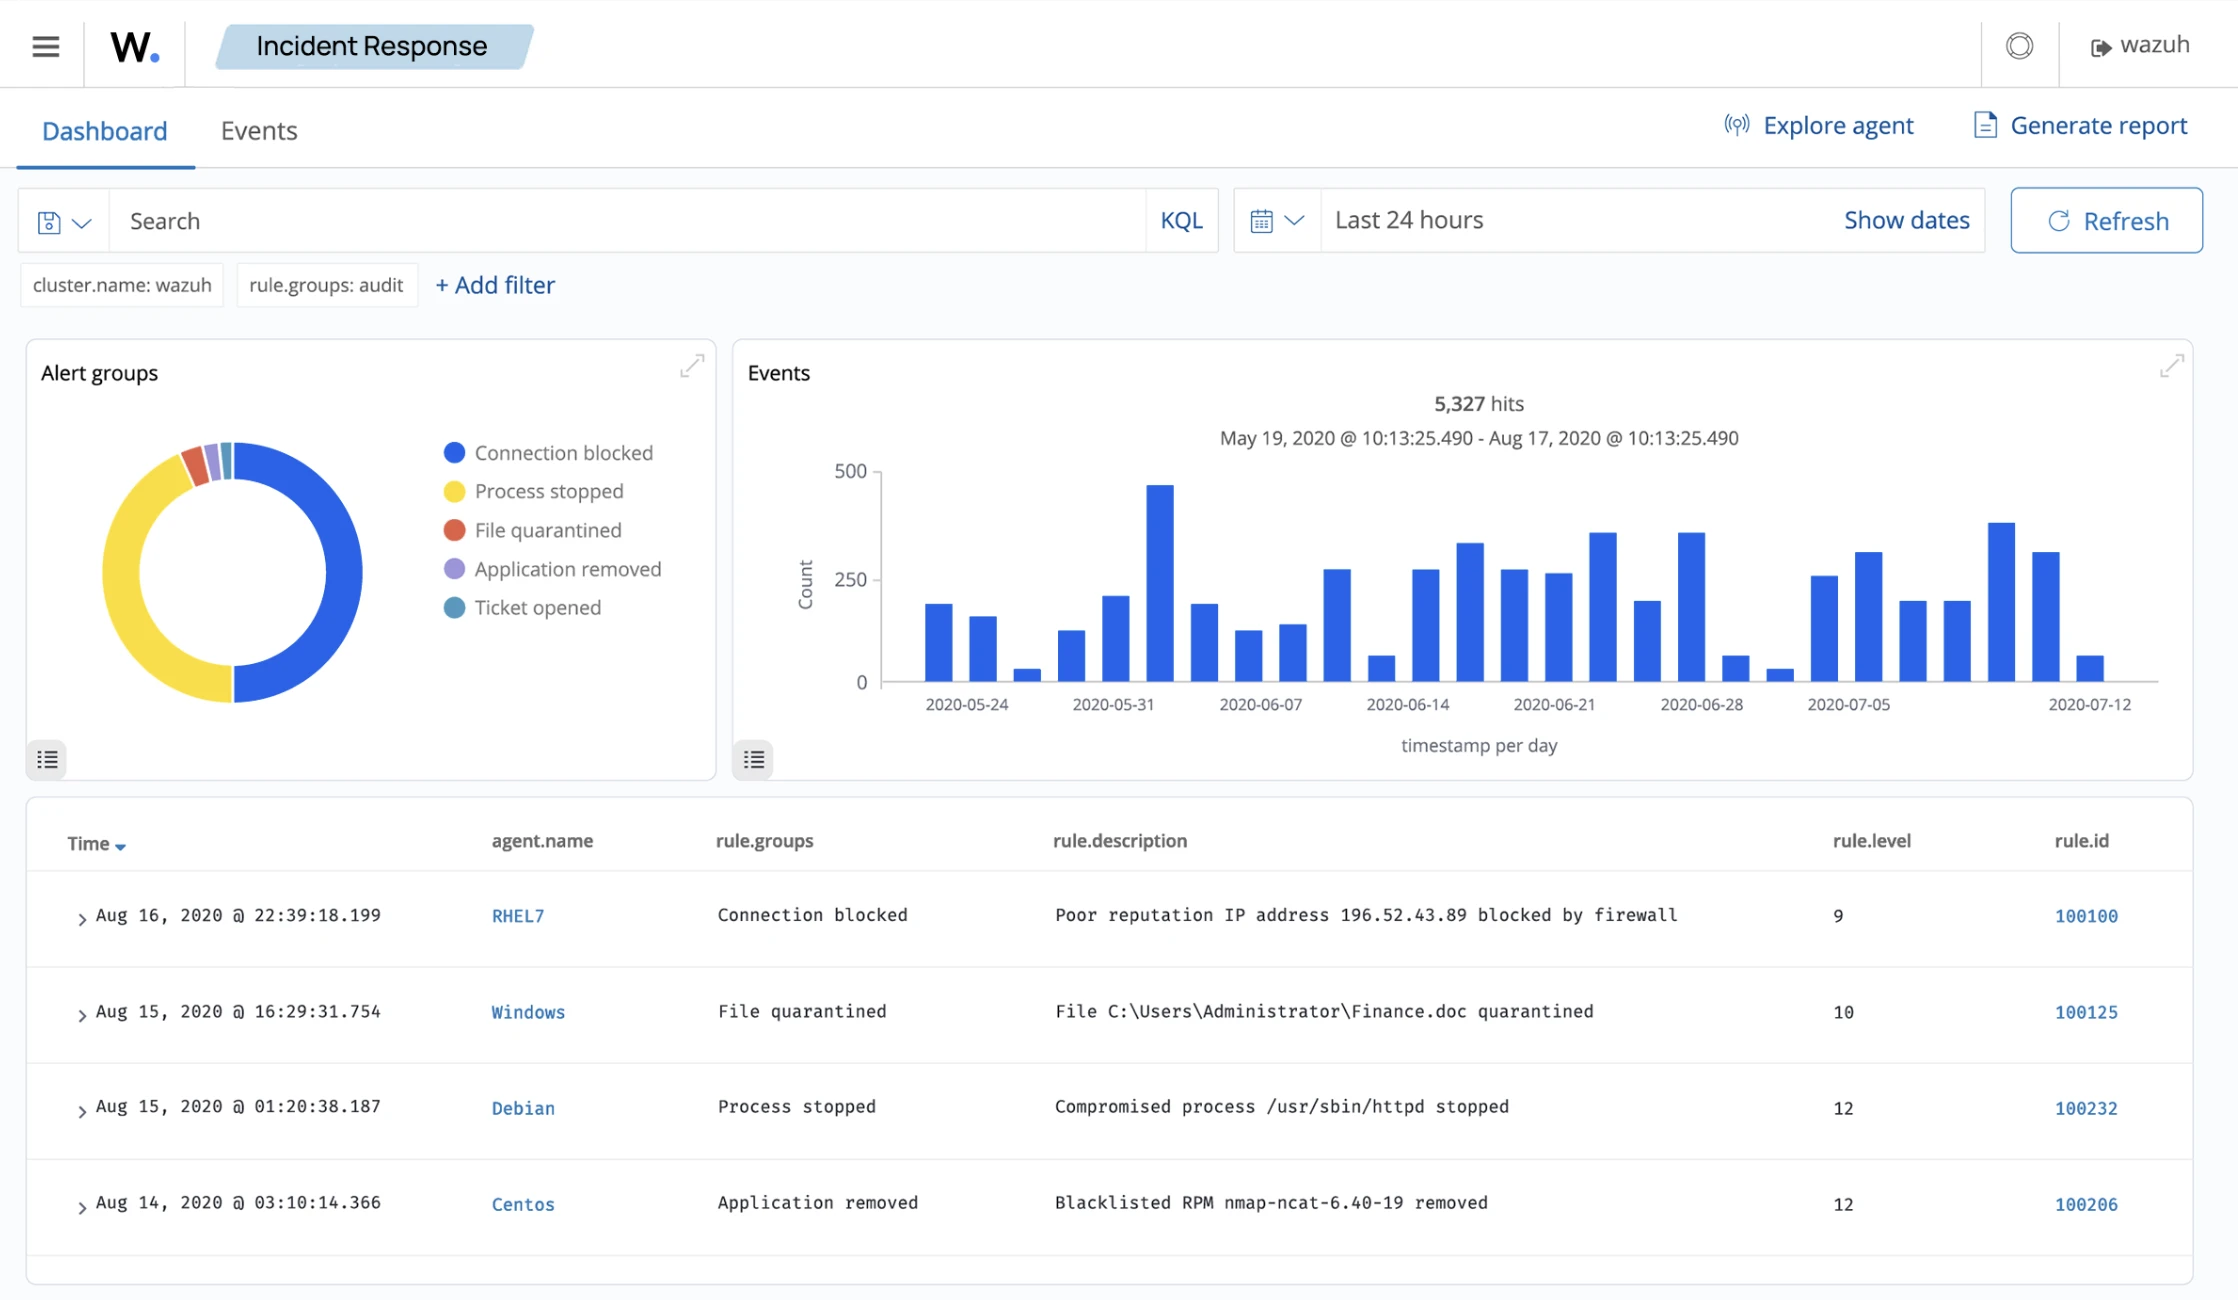
Un agente endpoint installato su ogni sistema monitorato raccoglie i log localmente e li inoltra al server di gestione Wazuh per l'elaborazione e l'analisi. L'agente gestisce localmente la raccolta dei log, il monitoraggio dell'integrità e la risposta attiva. Wazuh si integra nativamente con Elastic Stack, usando Elasticsearch per l'archiviazione e la ricerca dei log e Kibana (tramite il plugin Wazuh) per cruscotti e indagini.
Il motore di regole viene eseguito sul manager e valuta gli eventi di log in ingresso rispetto a un set di regole che include regole predefinite, benchmark CIS, mappature MITRE ATT&CK ed eventuali regole personalizzate scritte dall'utente. Quando una regola scatta, Wazuh genera un avviso e, se è configurata una risposta attiva, può intraprendere automaticamente azioni sull'endpoint: bloccare un IP, terminare un processo o mettere in quarantena un file.
Opzioni di hosting:
- Self-hosted: La piattaforma è gratuito da scaricare e utilizzare. Il supporto annuale opzionale ha un prezzo basato sul numero di endpoint monitorati (server, workstation e dispositivi di rete). In questo modello l'organizzazione è responsabile della manutenzione di hardware e risorse.
- Cloud-hosted: Il provider di hosting gestisce Wazuh Server ed Elastic Stack; è necessario distribuire gli agenti. Il prezzo dipende dai dati indicizzati (precedentemente chiamati hot storage) e dal periodo di conservazione scelto.
Caratteristiche distintive:
- Raccolta flessibile dei log: Wazuh acquisisce log da Windows Event Viewer, messaggi di sistema Linux, log applicativi in formato JSON e un'ampia gamma di tipi di origine senza plugin aggiuntivi. La copertura pronta all'uso è più ampia di Graylog o Logstash, che richiedono più configurazione per raggiungere la stessa ampiezza.
- Mappatura MITRE ATT&CK: Le regole vengono mappate per impostazione predefinita alle tecniche MITRE ATT&CK, quindi gli avvisi non solo dicono cosa è successo ma anche in quale punto della catena di attacco si inserisce. Questo è importante per il triage: si può distinguere un errore di autenticazione rumoroso da un tentativo di credential stuffing senza scrivere correlazioni personalizzate.
- Integrazioni di terze parti: Integrazioni native con Office 365, AWS, GCP, Azure e Rapid7. Una libreria Python integrata supporta integrazioni personalizzate senza la configurazione dei plugin richiesta da Syslog-ng o Fluentd.
- API e risposta attiva: Un'API RESTful copre query sui log, gestione di regole e decoder, query sugli avvisi e interazioni con gli agenti. La funzione di risposta attiva esegue script sull'endpoint monitorato al verificarsi di avvisi, bloccando indirizzi IP, terminando processi e isolando gli host. Questa funzionalità non è disponibile in Elastic Stack senza strumenti aggiuntivi.
Graylog
Graylog è una piattaforma di gestione dei log con un core source-available (Graylog Open) ed edizioni a pagamento che si estendono alle operazioni di sicurezza. Questa distinzione è più importante di quanto lascino intendere la maggior parte delle descrizioni dei fornitori: Graylog Open offre raccolta dei log, ricerca, pipeline di elaborazione, cruscotti e avvisi basati su flussi, sufficienti per i casi d'uso operativi. Le regole Sigma, l'allineamento MITRE ATT&CK, UEBA, il rilevamento delle anomalie e la gestione dei casi sono funzionalità a pagamento di Graylog Security ed Enterprise. Se il caso d'uso principale è la sicurezza operativa piuttosto che il monitoraggio dell'infrastruttura, è necessario tenerne conto nel calcolo dei costi.
Come funziona Graylog
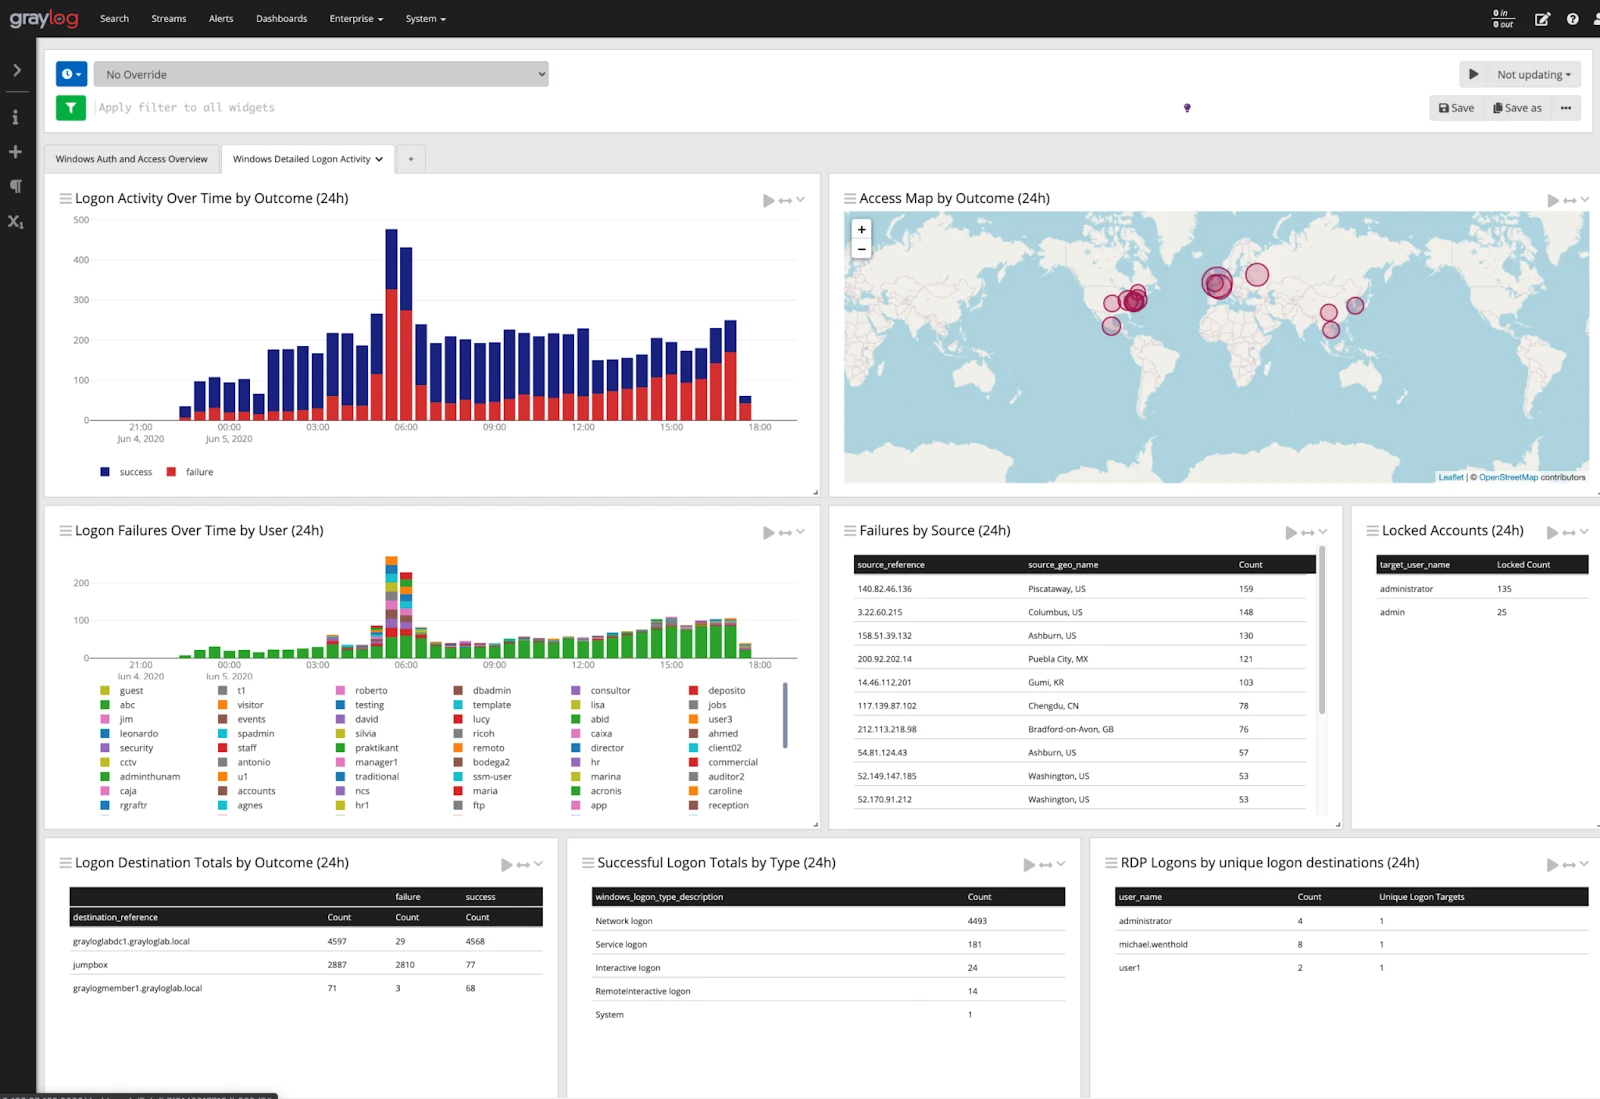
Graylog riceve i dati di log tramite input GELF (Graylog Extended Log Format), syslog, Beats o HTTP, li archivia in Elasticsearch o OpenSearch (tramite il Graylog Data Node) e li rende ricercabili tramite un'interfaccia web. Il sistema di flussi è centrale nel funzionamento di Graylog: i messaggi in arrivo vengono instradati ai flussi in base a regole e avvisi, pipeline e controlli di accesso sono tutti associati ai flussi piuttosto che al livello di archiviazione. Ciò significa che si può avere un flusso per gli errori applicativi instradato a un team e un flusso separato per gli eventi di autenticazione instradato alla sicurezza, con criteri di conservazione e autorizzazioni diversi per ciascuno.
Le pipeline di elaborazione consentono di analizzare, arricchire, scartare o riscrivere i messaggi prima dell'archiviazione. Se i log applicativi arrivano come testo non strutturato, si scrive una regola di pipeline per estrarre i campi in dati strutturati. Graylog Illuminate (incluso nelle edizioni a pagamento, disponibile per Open con limitazioni) fornisce parser e cruscotti predefiniti per le origini comuni: Windows Event Logs, Cisco, Palo Alto, AWS CloudTrail e altri.
- Il broker Kafka minimo è la versione 2.1. Qualsiasi input Kafka connesso a un broker più vecchio fallirà dopo l'aggiornamento.
- I token API ora scadono per impostazione predefinita dopo 30 giorni. Qualsiasi automazione, integrazione di monitoraggio o script che utilizza un token API a lunga durata smetterà di funzionare a meno che non sia in atto una politica di rotazione dei token. Questo tende a emergere come incidente notturno quando qualcosa smette di inviare dati piuttosto che durante l'aggiornamento stesso.
Caratteristiche distintive:
- Instradamento ed elaborazione basati su flussi: Il modello a flussi consente di segmentare i dati di log per origine, applicazione o livello di sensibilità al momento dell'acquisizione e quindi applicare pipeline, criteri di conservazione e controlli di accesso diversi per ciascun flusso. È operativamente più flessibile dei modelli indice-per-origine di Elasticsearch.
- Estrazione e parsing dei log: Gli estrattori estraggono campi specifici dai messaggi di log al momento dell'acquisizione. Le pipeline di elaborazione gestiscono trasformazioni più complesse, logica condizionale, lookup, ridenominazione dei campi ed eliminazione dei messaggi. Together offrono un controllo granulare su ciò che finisce in archiviazione. Graylog Illuminate ha inoltre rilasciato correzioni dei parser nella versione 7.0.3, inclusa una correzione del parsing dei timestamp di Apache HTTPD che produceva valori orari errati.
- Ricerca e analisi: La sintassi di ricerca di Graylog è più semplice di Lucene/KQL per le query di base, il che è importante quando un ingegnere di turno deve cercare nei log a mezzanotte senza documentazione di riferimento. Ricerche salvate, intervalli di tempo relativi e sovrapposizioni di istogrammi sono disponibili senza componenti aggiuntivi a pagamento.
- Gestione utenti con integrazione AD/LDAP: L'autenticazione Active Directory e LDAP è supportata in Graylog Open. I controlli di accesso basati sui ruoli consentono di limitare quali flussi e cruscotti ogni team può vedere.
I limiti di Graylog
Il livello gratuito di Graylog presenta lacune significative se il caso d'uso è la sicurezza operativa: il supporto alle regole Sigma, il rilevamento delle anomalie e la gestione dei casi sono tutti a pagamento. La dipendenza da Elasticsearch/OpenSearch aggiunge complessità operativa simile a quella di ELK Stack. Su larga scala, l'elaborazione tramite pipeline può creare colli di bottiglia prestazionali che richiedono un'attenta ottimizzazione dell'ordine delle fasi della pipeline e dell'allocazione dei thread di lavoro.
Elastic Stack (ELK Stack) – Logstash
Elastic Stack è un insieme di prodotti open-source; i suoi componenti principali sono Elasticsearch, Kibana e Logstash.
Come funziona l'analisi dei log con ELK
Logstash è una pipeline di elaborazione dati lato server. Riceve i dati di log da input (file, Beats, syslog, Kafka, HTTP e decine di altri), applica plugin di filtro per analizzare e arricchire i dati e instrada l'output verso una o più destinazioni. La maggior parte delle distribuzioni invia l'output a Elasticsearch, ma Logstash può scrivere contemporaneamente su S3, un SIEM, una coda di messaggi o un altro cluster Elasticsearch.
Elasticsearch archivia i dati di log elaborati e li rende ricercabili utilizzando un indice invertito. È il motivo per cui ELK scala fino a petabyte continuando a restituire risultati di ricerca inferiori al secondo su query mirate; ma queste prestazioni derivano dalla struttura dell'indice, il che significa che i carichi di lavoro con scritture intensive richiedono un'attenta gestione del ciclo di vita dell'indice. Kibana si trova sopra Elasticsearch e fornisce il livello visivo: cruscotti, la vista Discover per la ricerca ad-hoc nei log, Canvas per report personalizzati e Lens per visualizzazioni drag-and-drop.
- Ricerca full-text su larga scala: L'architettura a indice invertito di Elasticsearch supporta ricerche inferiori al secondo su miliardi di voci di log. KQL (Kibana Query Language) ed ES|QL (il più recente linguaggio di query basato su pipe della 9.x) offrono agli analisti due diverse interfacce di query a seconda del modo in cui preferiscono lavorare. Per indagini complesse sui log su grandi dataset, nulla nello spazio open-source eguaglia la profondità di ricerca di ELK.
- Acquisizione e filtraggio da più origini: Logstash dispone di circa 200 plugin di input e 200 plugin di filtro. Il filtro grok gestisce testo non strutturato tramite pattern di cattura denominati; il filtro json gestisce log JSON strutturati; il filtro csv gestisce dati tabulari. Più fasi di filtraggio vengono eseguite in sequenza, così è possibile analizzare una riga syslog grezza, estrarre campi, cercare un IP in un database GeoIP ed eliminare i messaggi di livello debug prima che l'evento raggiunga Elasticsearch, tutto in un'unica pipeline.
- Rilevamento di anomalie con machine learning: Le funzionalità ML di Kibana (a pagamento) identificano pattern insoliti nei dati di log senza richiedere la definizione di soglie. Utili per rilevare attacchi a lenta combustione o degradi graduali delle prestazioni che gli avvisi a soglia fissa non rilevano.
- Cruscotti Kibana: Le opzioni di visualizzazione di Kibana sono ampie: serie temporali, mappe, mappe di calore, tabelle di dati, indicatori e altro. Le ricerche salvate e i pattern di indice consentono agli analisti di condividere i contesti di indagine tra i team.
- Instradamento estensibile dell'output: Una singola pipeline Logstash può scrivere su Elasticsearch, su un bucket S3, su un secondo cluster Elasticsearch per il disaster recovery e su un topic Kafka per l'elaborazione a valle, contemporaneamente.
I limiti di ELK
Il sovraccarico operativo è reale. I cluster Elasticsearch richiedono pianificazione della memoria (l'heap JVM necessita di un dimensionamento accurato), gestione degli shard (troppi shard piccoli o troppo pochi grandi danneggiano entrambi le prestazioni) e configurazione delle policy del ciclo di vita degli indici per controllare i costi di conservazione.
La maggior parte dei team che esegue ELK su larga scala finisce per avere un platform engineer dedicato la cui responsabilità principale è Elasticsearch. Vale anche la pena comprendere la situazione delle licenze: i componenti di Elastic Stack sono sotto la Elastic License 2.0, non open source approvata dall'OSI. L'uso self-hosted è gratuito, ma offrire Elasticsearch come servizio gestito a terzi non è consentito dal livello gratuito.
Fluentd
Fluentd è un raccoglitore di dati open-source sotto la Apache License 2.0, progettato per unificare l'acquisizione e l'instradamento dei log attraverso infrastrutture eterogenee. Il compito principale è semplice: accettare eventi di log dalle origini, applicare elaborazioni opzionali e instradarli verso le destinazioni. Fluentd non archivia né analizza i log da solo; è un raccoglitore e un router, non una piattaforma di analisi dei log1
Questa distinzione è importante quando si valuta Fluentd rispetto a Wazuh o Graylog. Fluentd è tipicamente il primo livello di una pipeline più ampia. Un'architettura comune: gli agenti Fluentd su ogni server raccolgono log applicativi, log di sistema e log dei container, li bufferizzano localmente (così non si perde nulla se la destinazione a valle è temporaneamente non disponibile), applicano parsing e filtraggio e inoltrano il risultato a Elasticsearch, Splunk, un SIEM cloud o un altro backend di archiviazione. L'analisi avviene in qualunque componente riceva i dati.
Fluentd vs. Fluent Bit
I team che valutano Fluentd per ambienti Kubernetes spesso finiscono per scegliere Fluent Bit, ed è utile capire perché. Fluent Bit è un forwarder leggero nello stesso ecosistema CNCF, un binario di circa 4 MB rispetto al processo Ruby di Fluentd che risulta notevolmente più pesante. Per le distribuzioni Kubernetes in cui si desidera un raccoglitore di log in esecuzione come DaemonSet su ogni nodo, la differenza nell'uso delle risorse è significativa su larga scala. Fluent Bit supporta inoltre il parsing dei log multilinea, l'iniezione dinamica di metadati dalle etichette e annotazioni dei pod Kubernetes e la gestione integrata della backpressure per prevenire la perdita di dati quando le destinazioni a valle rallentano.
Fluentd è la scelta migliore quando serve l'intero ecosistema di 500+ plugin o una logica di instradamento complessa che la libreria di plugin più piccola di Fluent Bit non può coprire. Per la maggior parte delle distribuzioni native Kubernetes che effettuano semplice invio di log, Fluent Bit è la scelta pratica. I progetti condividono concetti di configurazione, quindi il passaggio dall'uno all'altro non richiede una riscrittura completa.
Come Fluentd gestisce i dati di log
Fluentd modella i dati di log come un flusso di eventi etichettati. Ogni evento ha un tag (una stringa separata da punti come app.web o system.syslog), un timestamp e un record. I tag guidano l'instradamento: le direttive match nella configurazione specificano quali tag vengono inviati dove, quali filtri si applicano e in che ordine. Più output possono corrispondere allo stesso tag, quindi si possono inviare gli stessi eventi sia a Elasticsearch sia a un archivio S3 contemporaneamente.
Il sistema di buffer è ciò che rende Fluentd affidabile in produzione. Invece di scrivere direttamente nella destinazione, gli eventi si accumulano in un buffer e vengono svuotati in blocchi a intervalli configurabili o quando il buffer raggiunge una soglia di dimensione. Se la destinazione non è raggiungibile, gli eventi restano nel buffer e vengono ritentati con backoff esponenziale.
Caratteristiche distintive:
- 500+ plugin della community: Copre integrazioni con la maggior parte delle principali destinazioni e origini dati di log senza sviluppo personalizzato.
- Instradamento flessibile dei dati: Gli eventi possono essere instradati verso più destinazioni simultanee, come file, RDBMS, NoSQL, IaaS, SaaS e Hadoop, in base a regole di instradamento basate su tag.
- Focus sull'elaborazione dei log: Fluentd è ottimizzato per l'elaborazione e l'inoltro dei log su larga scala, il che lo rende adatto come livello di raccolta e instradamento davanti a Elasticsearch o ad altri backend di archiviazione piuttosto che come piattaforma di analisi autonoma.
 Aggiungi come fonte preferita
Syslog-ng
Syslog-ng è un programma open-source di gestione dei log che raccoglie, classifica, trasforma e instrada i dati di log da più origini verso piattaforme di archiviazione o a valle. La sua capacità distintiva è l'elaborazione strutturata: i log possono essere normalizzati in un formato coerente prima di essere inoltrati a sistemi come Apache Kafka o Elasticsearch.
Funzionalità:
- Classificare e strutturare i log usando parser integrati come csv-parser
- Archiviare i log in file, code di messaggi (AMQP) o database (PostgreSQL, MongoDB)
- Inoltrare verso piattaforme big data, tra cui Elasticsearch, Apache Kafka o Hadoop
Caratteristiche distintive:
- Archiviazione automatica dei log: Syslog-ng gestisce nativamente la rotazione e l'archiviazione dei log, inclusa la compressione e la denominazione dei file con timestamp. Per gli ambienti con requisiti di conservazione e conformità, ciò riduce la necessità di strumenti esterni come logrotate sovrapposto.
- Supporto di più formati di messaggio: RFC3164 (syslog tradizionale), RFC5424 (syslog strutturato), JSON e formati chiave-valore vengono tutti analizzati nativamente. Syslog-ng può ricevere un messaggio RFC3164 e produrlo come RFC5424 con campi di dati strutturati aggiunti, utile quando si inviano dati a sistemi che si aspettano il formato syslog moderno.
- Trasporto crittografato: Il trasporto syslog con crittografia TLS è supportato nativamente sia in ricezione sia in inoltro. Questo è importante negli ambienti in cui i dati di log transitano su segmenti di rete non attendibili.
- Instradamento condizionale: Le espressioni di filtro consentono di instradare in base a qualsiasi campo analizzato: gravità, facility, host o campi personalizzati estratti dai parser. Una singola istanza syslog-ng può instradare i fallimenti di autenticazione verso il flusso del team di sicurezza, gli errori applicativi verso il flusso del team di sviluppo e i messaggi di debug verso /dev/null.
Dove syslog-ng è adatto (e dove non lo è)
Syslog-ng è la scelta giusta quando le origini dei log sono principalmente dispositivi di rete e server che parlano syslog e quando si necessita di una raccolta affidabile e ad alta velocità con estrazione di campi strutturati prima dell'inoltro a un backend di archiviazione. Non è una piattaforma di analisi dei log; non dispone di interfaccia di query, di cruscotti né di avvisi integrati. Funziona come livello di raccolta e instradamento davanti a Elasticsearch o Graylog, non come strumento autonomo.
Nagios
Una necessaria precisazione prima di procedere: Nagios Core è il progetto di monitoraggio open-source con licenza GPL e si concentra sul monitoraggio di host, servizi e rete piuttosto che sull'analisi dei log.[15] Il prodotto qui descritto è Nagios Log Server, un prodotto commerciale separato di Nagios Enterprises. Se si cerca specificamente uno strumento open-source e gratuito per l'analisi dei log, Nagios Log Server non lo è. Offre una piattaforma di gestione dei log supportata commercialmente da un fornitore con una lunga esperienza nel monitoraggio delle infrastrutture.
Nagios Log Server raccoglie i dati di log in tempo reale e li inserisce in un'interfaccia di ricerca. È compatibile con server Windows, Linux e Unix e include una procedura guidata di configurazione per integrare nuovi endpoint o applicazioni.2
Caratteristiche distintive:
- Monitoraggio dei servizi di rete: Copre SMTP, POP3, HTTP, PING e altri servizi di rete con un focus sulla salute dell'infrastruttura.
- Monitoraggio delle risorse degli host: Tiene traccia del carico del processore, dell'utilizzo del disco e dello stato di salute del sistema su tutti gli host monitorati.
- Rotazione e archiviazione dei file di log: Rotazione automatica e archiviazione a lungo termine senza intervento manuale.
- Filtraggio geografico dei log: Filtra i dati di log in base all'origine geografica e genera mappe del flusso di traffico.
- Interfaccia web: Interfaccia opzionale per visualizzare lo stato di rete corrente e i file di log.
FAQ
Gli strumenti open-source di analisi dei log consentono agli utenti di raccogliere, elaborare, archiviare, cercare e analizzare i dati di log provenienti da varie origini, come server, applicazioni e dispositivi di rete. Questi strumenti possono aiutare i team SecOps, ITOps e DevOps a:
-Eseguire la risoluzione dei problemi di sistema monitorando i file di log delle transazioni.
-Sfruttare la risposta agli incidenti e l'analisi investigativa di sicurezza per mantenere prestazioni ottimali del database o eseguire l'analisi comportamentale di utenti ed entità (UEBA).
-Mantenere la conformità a audit, normative e speciali regole di sicurezza (GDPR).
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{hafa2026,
  author = {Hafa, Adil and PhD., Ezgi Arslan,},
  title  = {{I 6 migliori strumenti open-source di analisi dei log: Wazuh, Graylog e altri}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-log-analysis-tools}},
  note   = {AIMultiple. Consultato il 14 settembre 2026}
}Risultati e timestamp di 18 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 3 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
6 aggiornamentiAggiunte sezioni sul funzionamento e sui limiti per Graylog, l'ELK Stack, Fluentd e syslog-ng.
Aggiornato il prodotto Wazuh con nuove capacità di rilevamento e una politica SCA.
Collegamenti di riferimento







Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.