


I 3 migliori generatori di documenti sintetici a confronto

I generatori di documenti sintetici creano immagini di documenti realistiche e annotate che aiutano ad addestrare e valutare i modelli di machine learning senza fare affidamento su grandi dataset etichettati manualmente.
Mettiamo a confronto 3 generatori di documenti sintetici, Genalog, DocCreator e Tonic Textual, creando più di 2.500 documenti sintetici, confrontandone l'efficacia in termini di layout realistici, dati numerici accurati e dataset di addestramento per attività di analisi documentale.
Risultati del benchmark di generazione di documenti
I risultati mostrano che
- Genalog e DocCreator offrono ottime prestazioni sia in termini di utilità che di fedeltà, con Genalog leggermente migliore per l'accuratezza numerica.
- Tonic Textual eccelle nel realismo del layout visivo ma resta indietro in altre aree, rendendolo più adatto ad attività che richiedono documenti realistici.
Per maggiori informazioni sulle metriche, consulta la metodologia del benchmark.
- Utilità misura quanto bene i modelli addestrati su dati sintetici funzionano sui documenti reali.
- Fedeltà del layout misura quanto la disposizione spaziale degli elementi nei documenti sintetici corrisponda a quelli reali.
- Fedeltà numerica verifica se i valori numerici nei documenti sintetici assomigliano ai dati reali.
Commento sui risultati: Per comprendere meglio le differenze di prestazioni, il benchmark è stato condotto anche utilizzando il set di addestramento invece del set di test separato. Questa secondaria valutazione mirava a determinare se fornire ai modelli materiale di addestramento avrebbe migliorato la loro capacità di riprodurre output strutturati e numericamente accurati.
I risultati mostrano che, anche quando valutati sui dati di addestramento, i modelli hanno ottenuto punteggi leggermente più alti. Ciò indica che i risultati riflettono quanto bene gli strumenti gestiscono il compito stesso. I risultati moderati sono probabilmente influenzati dai limiti nella qualità dell'OCR e dalla capacità del modello addestrato, piuttosto che dalla procedura di benchmark stessa.
Genalog
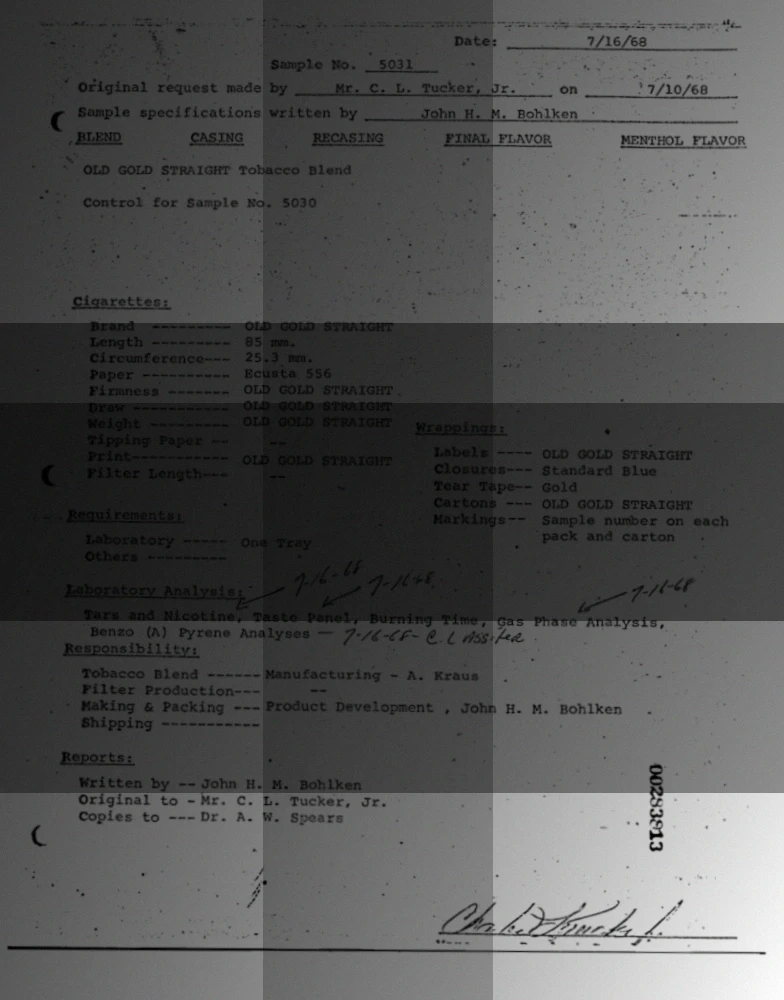
Genalog ha ottenuto complessivamente le migliori prestazioni. I suoi documenti sintetici si sono dimostrati efficaci per l'addestramento dei modelli e hanno mantenuto un buon equilibrio tra elementi di layout realistici e accuratezza numerica. I documenti generati riflettevano fedelmente la struttura e la spaziatura di moduli e ricevute reali, rendendoli adatti a una varietà di attività di analisi documentale.
DocCreator
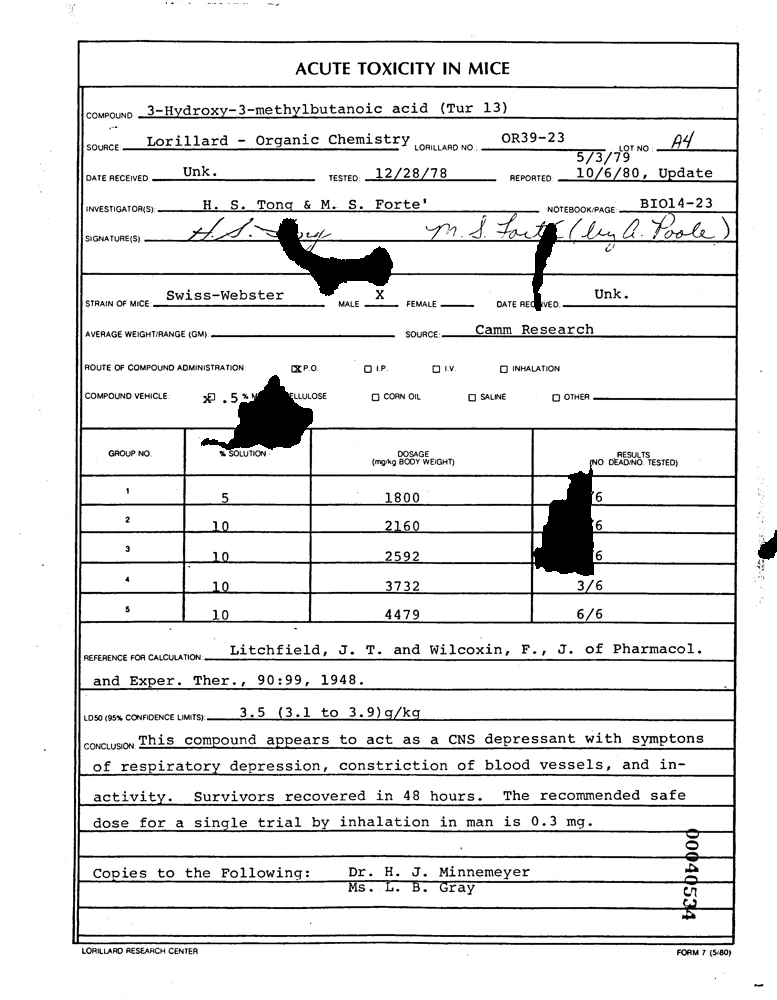
Anche DocCreator ha prodotto output di alta qualità. I documenti di questo generatore di documenti si sono dimostrati quasi altrettanto utili per l'addestramento quanto quelli di Genalog. I layout erano realistici e i documenti sintetici preservavano le proprietà statistiche dei numeri. Il punto di forza di DocCreator risiede nella combinazione di una generazione di layout diversificata con i suoi modelli di degrado, rendendo gli output visivamente simili ai documenti reali scansionati.
Tonic Textual

Tonic Textual ha ottenuto risultati contrastanti. Sebbene questo generatore di documenti sintetici producesse layout puliti e coerenti, i documenti sono risultati meno efficaci per l'addestramento dei modelli. Inoltre, i numeri sintetici non erano sempre statisticamente simili ai dati reali. Ciò suggerisce che Tonic Textual è più adatto ad attività incentrate sull'aspetto del documento o sulla sostituzione di PII nel rispetto della privacy, piuttosto che all'addestramento su larga scala per attività di struttura del layout ed estrazione di informazioni.
A marzo 2026, Tonic Textual ha sostituito il proprio componente di entity-linking da un modello basato su LLM a un modello basato su BERT per migliorare il throughput.1 La stessa release (v391) ha inoltre aggiunto filtri e ordinamenti migliorati nella pagina Datasets.1
Panoramica generale
Genalog è lo strumento più equilibrato, offrendo sia layout realistici sia numeri accurati.
DocCreator è forte nei layout complessi e diversificati e nel degrado dei documenti, con lievi imprecisioni numeriche.
Tonic Textual è ideale per attività incentrate sul layout ma non per attività che richiedono dati numerici precisi.
Panoramica della metodologia
Metriche di valutazione
Ogni dataset generato è stato valutato rispetto ai dati originali utilizzando le seguenti metriche:
Punteggio di utilità
(Punteggio F1 KIE): Un punteggio compreso tra 0 e 1, dove più alto è meglio. È definito dal punteggio F1 del modello LayoutLMv3 addestrato sui dati sintetici quando valutato sul set di test reale. Un punteggio alto indica che i dati sintetici sono un sostituto altamente efficace dei dati reali.
Punteggi di fedeltà
Queste metriche misurano quanto i documenti sintetici assomiglino a quelli reali.
- Fedeltà del layout (punteggio EMD): La Earth Mover’s Distance (dEMD) misura la differenza tra la distribuzione dei punti centrali dei bounding box nei documenti reali rispetto a quelli sintetici. È un valore da 0 a 1, dove più basso è meglio. Un punteggio basso indica che gli elementi spaziali del layout sono ben preservati.
- Fedeltà numerica (distanza K-S): La distanza di Kolmogorov-Smirnov (DKS) misura la differenza massima tra le funzioni di distribuzione cumulativa (CDF) dei valori numerici (ad esempio prezzi, quantità) nei dati reali e sintetici. Varia da 0 a 1, dove più basso è meglio. Un punteggio basso significa che il generatore riproduce accuratamente le proprietà statistiche dei numeri.
Tutte le metriche sono state normalizzate durante il calcolo.
Datasets
FUNSD: una raccolta di 199 moduli scansionati caratterizzati da testo rumoroso, layout complessi e diversificati e annotazioni manoscritte. È stato scaricato più di 1.500 volte il mese scorso. Questo mette alla prova la capacità di un generatore di gestire dati non strutturati e imperfetti.2
- Dividiamo il campione in due: l'80% dei dati viene utilizzato per addestrare il modello, mentre il restante 20% è riservato ai test dopo l'addestramento.
- Ogni strumento ha prodotto tra tre e sei documenti sintetici per ogni originale, per un totale di oltre 2.500 documenti sintetici.
Valutazione delle attività
Per misurare l'utilità, un popolare modello LayoutLMv3 con 22K stelle su GitHub e oltre 750K download è stato addestrato sui dati sintetici generati da ciascuno strumento di generazione di documenti sintetici.3
Le prestazioni di questo modello sono state poi valutate su un set di test separato di documenti reali dai dataset originali. Questo misura direttamente quanto siano utili i dati sintetici per un'attività reale.
Strumenti di generazione sintetica
Genalog
Una libreria Python open-source di Microsoft per generare immagini di documenti sintetici con rumore sintetico. Funziona prendendo modelli di testo + layout (scritti in HTML + CSS), li renderizza tramite WeasyPrint e applica effetti di degrado (sfocatura, bleed-through, rumore sale e pepe, operazioni morfologiche).4
DocCreator
Uno strumento multi-piattaforma e open-source per generare immagini di documenti sintetici con relative ground truth. È stato ampiamente utilizzato nella ricerca sull'analisi e il riconoscimento delle immagini di documenti (DIAR).5,6
Tonic Textual
Una soluzione per l'oscuramento e la sintesi in formati di documenti reali (PDF, Word). Sostiene di scansionare documenti non strutturati, identificare entità nominate (ad es. PII), oscurarle o sostituirle con valori sintetici e produrre documenti de-identificati in formati simili.
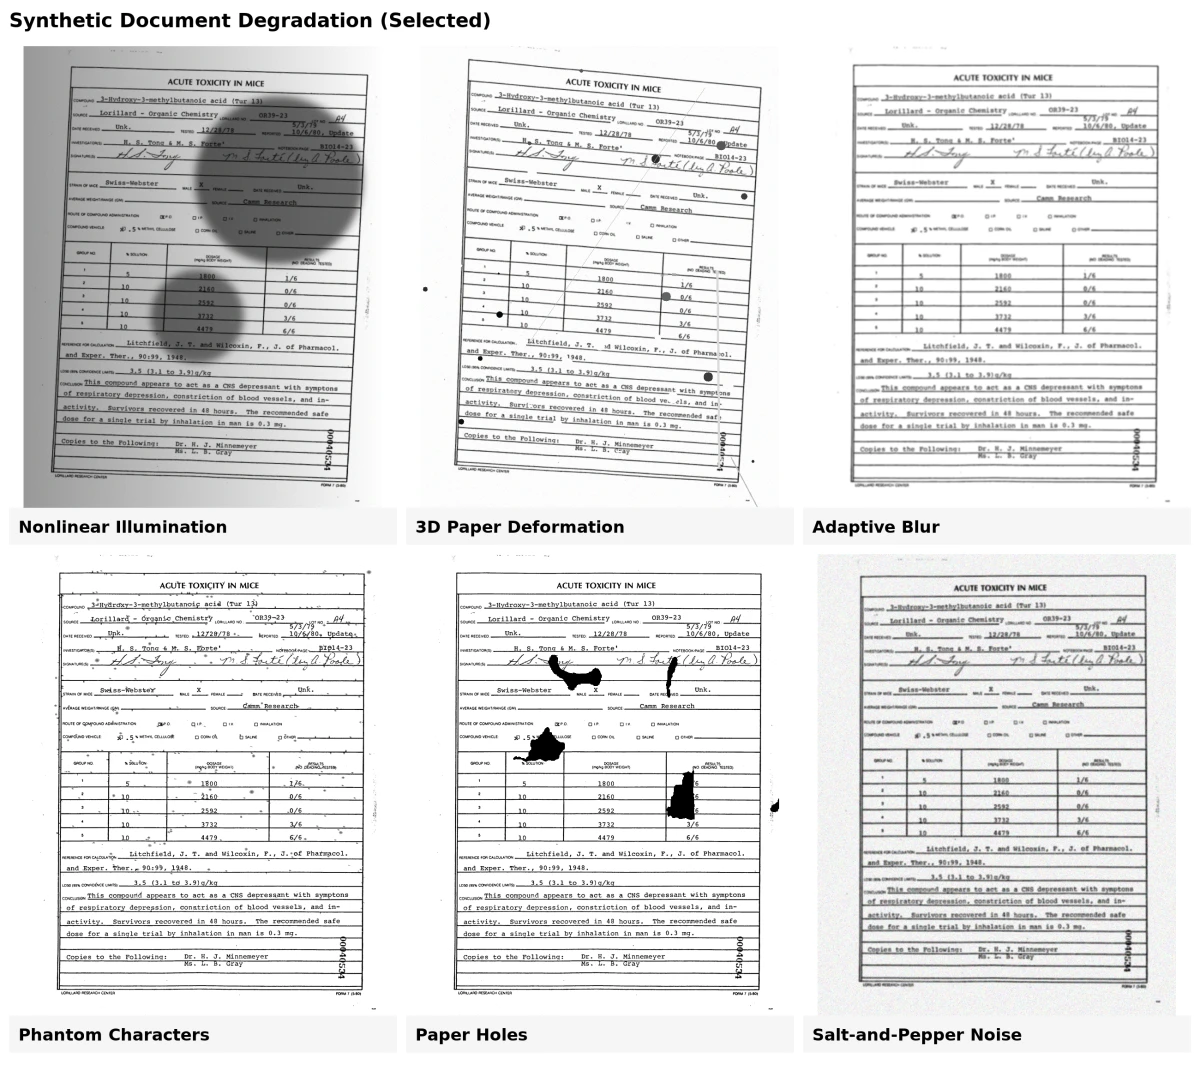
8 metodi di degrado dei documenti sintetici
La generazione di documenti sintetici spesso include l'aggiunta di difetti realistici per far assomigliare i dati artificiali ai documenti reali. Questi difetti, o modelli di degrado, aiutano ad addestrare modelli che funzionano meglio su documenti rumorosi, invecchiati o scansionati. Questi strumenti applicano diverse trasformazioni fisiche e visive per simulare le comuni imperfezioni dei documenti.6
1. Degrado dell'inchiostro
Questo modello simula sbiadimenti, macchie o striature causati dall'invecchiamento o da una stampa di bassa qualità. Aggiunge piccole macchie d'inchiostro o rimuove parti delle lettere per imitare il vero deterioramento dell'inchiostro.
2. Caratteri fantasma
Vecchi strumenti di stampa spesso lasciavano contorni deboli o segni “fantasma” attorno alle lettere. Il modello di caratteri fantasma li ricrea inserendo difetti estratti da scansioni reali tra i caratteri stampati.
3. Fori nella carta
Fori di forme e dimensioni diverse vengono aggiunti casualmente ai documenti, replicando strappi o fori dovuti a perforazioni visibili nella carta usurata.
4. Trapasso d'inchiostro
Questo effetto imita l'inchiostro che filtra dall'altro lato della pagina. Utilizza sia le immagini del fronte che del retro di un documento per ricreare il modo in cui l'inchiostro si trasferisce parzialmente attraverso la carta.
5. Sfocatura adattiva
La scansione o la fotografia dei documenti spesso crea una leggera sfocatura. Questo modello confronta esempi reali sfocati e applica una sfocatura simile utilizzando filtri gaussiani, mantenendo il risultato delicato e realistico.
6. Deformazione della carta in 3D
I documenti possono piegarsi, incresparsi o curvarsi quando vengono scansionati o fotografati. Utilizzando mesh 3D di carte reali, questo modello ricrea queste forme ed effetti di illuminazione, contribuendo ad addestrare modelli per l'analisi documentale basata su fotocamera.
7. Illuminazione non lineare
Un'illuminazione non uniforme durante la scansione può far apparire più scuro un lato del documento. Questo modello regola la luminosità in base ad angoli di luce simulati e alla curvatura della pagina, riproducendo l'effetto di una scarsa illuminazione.
8. Rumore sale e pepe
Aggiunge pixel neri e bianchi casuali per simulare polvere, grana della carta o rumore del sensore di scansione. Questo effetto “sale e pepe” aiuta a creare l'aspetto granuloso delle scansioni digitali invecchiate o di bassa qualità.
 Aggiungi come fonte preferita
La generazione di documenti sintetici come soluzione alle sfide dell'analisi del layout
La sfida dell'analisi del layout
Comprendere la struttura dei documenti è più difficile che leggere il testo. Gli strumenti OCR possono extract parole, ma non spiegano il ruolo di ciascun blocco, come titoli, tabelle o figure.
Per affrontare questa sfida, sono stati sviluppati diversi metodi:
I primi metodi per l'analisi del layout erano basati su regole. Si basavano su regole geometriche e sull'analisi della trama per suddividere le pagine in blocchi. Sebbene utili, questi approcci richiedevano un'accurata regolazione manuale e non generalizzavano bene.
Gli approcci di machine learning, come le Support Vector Machines (SVM) e i Gaussian Mixture Models (GMM), hanno migliorato questo aspetto apprendendo dai dati.7 Tuttavia, dipendevano ancora da caratteristiche realizzate a mano e avevano difficoltà con la diversità dei documenti reali.
Il deep learning ha trasformato il settore. Le reti neurali convoluzionali (CNN) hanno reso possibile trattare il riconoscimento del layout come il rilevamento di oggetti, identificando tabelle, figure o formule nello stesso modo in cui i modelli rilevano oggetti nelle immagini naturali.8 Alcuni modelli combinano inoltre caratteristiche testuali e visive per risultati più accurati.
La sfida del deep learning: richiede grandi dataset etichettati per l'addestramento.
I dati sintetici come soluzione: il processo di generazione di documenti sintetici offre un modo scalabile per creare dati di addestramento annotati senza il costo dell'etichettatura manuale.
I modelli generativi offrono ora possibilità più avanzate. Gli autoencoder variazionali (VAE), i modelli basati su attenzione e le GAN possono apprendere gli schemi strutturali dei documenti e produrre nuovi layout realistici.9
Differenze chiave tra i generatori di documenti sintetici
I tre generatori di documenti sintetici messi a confronto differiscono per focus, qualità dell'output e usabilità:
- Genalog: il più equilibrato sia per i layout realistici sia per l'accuratezza numerica. Il suo flusso di lavoro basato su Python con modelli HTML/CSS e modelli di degrado lo rende ideale per addestrare modelli di machine learning in diverse attività di analisi documentale.
- DocCreator: forte nella generazione di documenti visivamente complessi e degradati, preservando la diversità dei layout. Leggermente meno accurato numericamente rispetto a Genalog, ma efficace per attività che richiedono la simulazione realistica di documenti scansionati.
- Tonic Textual: eccelle nei layout puliti e visivamente coerenti e nella sintesi di dati che preserva la privacy. Meno adatto all'accuratezza numerica o ai dataset di addestramento completi, il che lo rende migliore per attività incentrate sul layout o per la sostituzione di PII.
Queste differenze riflettono i loro approcci principali: Genalog bilancia realismo e fedeltà dei dati, DocCreator enfatizza la varietà del layout e il degrado dei documenti, mentre Tonic Textual privilegia aspetto e privacy. Questo aiuta gli utenti a scegliere lo strumento giusto in base al fatto che la priorità sia l'efficacia dell'addestramento, il realismo del layout o la de-identificazione dei dati.
Altri generatori di documenti sintetici comunemente utilizzati
YData SDK: offre un generatore di documenti sintetici in grado di produrre documenti sintetici di alta qualità in formato PDF, DOCX o HTML, spesso utilizzato per aggirare gli ostacoli di conformità alla privacy.10
DoGe: uno strumento open-source progettato specificamente per sintetizzare scansioni di documenti realistiche con testo significativo, intestazioni e tabelle per l'addestramento di Document IA.11
DocXPand: specializzato nella generazione di documenti di identità (passaporti, carte d'identità) basati sugli standard ISO, riempiendo i modelli con informazioni false e volti generati dall'IA.12
Ulteriori letture
- Benchmark e best practice per la generazione di dati sintetici
- I 25 principali casi d'uso dei dati sintetici
- Utenti sintetici spiegati: i 7 migliori strumenti IA per la ricerca sugli utenti
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{arslan2026,
  author = {Arslan, Ezgi},
  title  = {{I 3 migliori generatori di documenti sintetici a confronto}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/synthetic-document-generator}},
  note   = {AIMultiple. Consultato il 3 giugno 2026}
}Risultati e timestamp di 9 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 3 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
2 aggiornamentiL'introduzione è stata ampliata con nomi di prodotti specifici.
Collegamenti di riferimento




Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.