


LLM Prezzi: i migliori 15+ fornitori a confronto

Monitoriamo i prezzi di lancio di più di 160 LLM, da GPT-3.5 Turbo nel marzo 2023 fino alle ultime release, raggruppati per classe di dimensioni. Confrontiamo anche i prezzi delle API dei modelli attuali con i risultati dei benchmark e analizziamo i piani di abbonamento dei principali fornitori.
LLM tendenze dei prezzi di lancio
- Claude Opus: i prezzi di lancio sono scesi da $30,00 (Opus 4.1, agosto 2025) a $8,00 (Opus 5.5, settembre 2026).
- Claude Fable 5 è stato lanciato a $20,00 nel giugno 2026, il doppio del prezzo di Claude Opus 4.8 due settimane prima. OpenAI GPT-6 Astra è seguito a $20,00 a settembre.
- GPT-6 Sol è stato lanciato a $4,00 nel settembre 2026, il 64% in meno rispetto ai $11,25 di GPT-5.6 Sol a luglio. GPT-6 Luna è stato lanciato a $0,20, contro $2,25 per GPT-5.6 Luna.
- Il prezzo di lancio mediano dei modelli chiusi piccoli è salito da $0,53 nel 2024 a $0,85 nel 2025. Nel 2026, Gemini 3.5 a 3.8 Flash è stato lanciato a $3,00 - $3.38.
- Nel 2025, il prezzo di lancio mediano dei grandi modelli open-weight è stato inferiore a un quarto della mediana dei modelli chiusi di fascia media. Kimi K3 di Moonshot è stato lanciato a $6,00 nel luglio 2026, superiore ai $4,00 di Claude Sonnet 5.
I prezzi sono per milione di token, con un mix di tre parti di input e una di output, ed escludono le promozioni a tempo limitato. I modelli open-weight hanno pesi rilasciati pubblicamente; per quelli senza un'API di prima parte, il prezzo è la tariffa di un provider di hosting intorno al momento del lancio. I nuovi lanci possono comunque modificare le medie del trimestre corrente.
LLM API valutazione dei prezzi
Esistono due modi per pagare un LLM: piani di abbonamento con prezzi LLM a tariffa flat dei principali provider, oppure un modello API pay-as-you-go fatturato in base all'uso dei token.
Fai clic sui nomi dei modelli per visualizzare i risultati dei benchmark, la latenza reale e i prezzi, e valutare l'efficienza e il rapporto costo-efficacia di ciascun modello.
Classifica: I modelli sono classificati in base alla loro posizione media in tutti i benchmark.
Puoi verificare i tassi di allucinazione e le prestazioni di ragionamento dei migliori LLM nei nostri benchmark.
Confronto dei piani di abbonamento LLM
Gli utenti non tecnici potrebbero preferire usare l'interfaccia utente piuttosto che l'API. Nel 2026, la maggior parte degli abbonamenti dei provider include molto più di una semplice chat. Gli agenti di coding come Claude Code, Codex, Kimi Code e Mistral Vibe sono inclusi nei piani di livello Pro. Per sviluppatori e utenti intensivi, l'abbonamento giusto da $10–$200 spesso sostituisce ciò che altrimenti sarebbe un abbonamento separato a un IDE di coding, un budget API per token e uno strumento video o di ricerca, tutto in uno.
OpenAI
Il piano Free include chat testuali quotidiane illimitate con GPT-5.6 Luna, modalità vocale standard, caricamenti limitati e generazione di immagini di base. Gli annunci contestuali raggiungono circa 40 mercati ad agosto 2026, inclusi Stati Uniti e gran parte dell'Europa, e compaiono solo sui piani Free e Go.
- ChatGPT Go ($8/mese) è un piano a basso costo che può includere annunci. Le chat testuali sono illimitate, come su Free; l'upgrade offre limiti più elevati su caricamento di file, creazione di immagini, voce e memoria, tutto su GPT-5.6 Luna.
- ChatGPT Plus ($20/mese) include limiti di utilizzo estesi, accesso a GPT-5.6 Sol, Terra e Luna, modalità vocale avanzata, agente Codex, generazione di immagini e funzionalità in accesso anticipato.
Il piano Pro ha due livelli a partire da aprile 2026:
- ChatGPT Pro ($100/mese) offre la stessa gamma di modelli del livello da $200 (incluso GPT-5.6 Sol) con limiti di utilizzo circa 5x rispetto a Plus.
- ChatGPT Pro ($200/mese) offre i limiti di utilizzo individuali più elevati (circa 20x Plus), la massima disponibilità di Deep Research, voce avanzata con video e condivisione schermo, Codex con massimo incremento di utilizzo e Sora.
Entrambi i livelli Pro includono accesso prioritario nelle ore di punta. Il pricing di Codex su Plus, Pro e Business è passato da un costo per messaggio a un utilizzo allineato ai token dell'API ad aprile 2026.
ChatGPT Work, l'agente di OpenAI per progetti multi-step di lunga durata (lanciato il 9 luglio 2026), è incluso nei piani a pagamento e l'app desktop che include Chat, Work e Codex è disponibile su ogni piano, incluso Free.
- Piano Business ($20/utente/mese annuale o $25/utente/mese mensile) è il piano di OpenAI per team piccoli e medi (ex ChatGPT Team, rinominato ad agosto 2025). Aggiunge limiti di messaggi più elevati, console di amministrazione, SSO, dati del team esclusi dall'addestramento e pool di crediti condivisi per funzionalità avanzate. App incluse: Codex con crediti condivisi per workspace. I posti solo Codex sono stati chiusi ai nuovi workspace il 24 giugno 2026; OpenAI ha annunciato posti Premium a $100/utente/mese con fatturazione annuale ($125 mensili) con utilizzo 5x Standard. Il piano richiede almeno 2 posti.
- Piano Enterprise (prezzo personalizzato) offre accesso ai modelli ad alta velocità, finestre di contesto ampliate, controlli sui dati di livello enterprise, verifica del dominio, analisi e registri di audit. App incluse: Codex con pool di crediti condiviso e posti opzionali solo Codex.
Anthropic (Claude)
Il piano Free include accesso web e mobile, analisi di base, accesso a Claude Sonnet 5 e Haiku e caricamento di documenti. L'uso giornaliero è limitato e i modelli Opus e Fable non sono disponibili.
- Piano Pro ($20/mese, oppure $17/mese con fatturazione annuale) offre accesso a Opus 5, Sonnet 5 e Haiku, circa 5x più utilizzo rispetto a Free, organizzazione dei progetti e accesso prioritario nelle ore di punta. Fable 5 non rientra nei limiti di utilizzo di Pro; viene fatturato alle tariffe API tramite crediti di utilizzo pay-as-you-go. App incluse: Claude Code (l'agente di coding di Anthropic nel terminale e nell'IDE), Cowork, Claude Design e Claude per Microsoft 365, tutti condividono lo stesso pool di utilizzo della chat.
- Piano Max 5x ($100/mese) offre circa 5x più utilizzo rispetto a Pro, accesso prioritario alle nuove funzionalità e ai nuovi modelli e accesso completo a Claude Code al livello di utilizzo superiore Max.
- Piano Max 20x ($200/mese) offre circa 20x più utilizzo rispetto a Pro, massima priorità di accesso e accesso completo a Claude Code. Progettato per utenti intensivi giornalieri che eseguono carichi di lavoro Claude Code. Entrambi i livelli Max includono Fable 5, il modello più costoso di Anthropic; il suo uso può assorbire fino alla metà del limite di utilizzo settimanale del piano.
Il piano Team offre due tipi di posti e supporta da 2 a 150 membri:
- Posto Standard: $20/utente/mese annuale ($25/utente/mese mensile). Include funzionalità di base, limiti di utilizzo standard e accesso a Claude Code.
- Posto Premium: $100/utente/mese annuale ($125/utente/mese mensile). Tutto ciò che è incluso in Standard, più limiti di utilizzo più elevati per utenti intensivi che eseguono carichi di lavoro Claude Code più pesanti.
App incluse: Claude Code e Cowork sono inclusi con ogni posto Team (Standard e Premium); la differenza sta nella quota di utilizzo, non nell'accesso. Entrambi i tipi di posto includono fatturazione centralizzata, strumenti di collaborazione e controlli di amministrazione.
- Piano Enterprise ($20/posto/mese più utilizzo alle tariffe API sul livello self-service; prezzo personalizzato con il team commerciale) offre finestre di contesto ampliate, SSO, acquisizione del dominio, accesso basato sui ruoli, SCIM, registri di audit e integrazioni di dati. App incluse: sui nuovi piani Enterprise e self-service, Claude Code e Cowork sono inclusi con ogni posto; i vecchi contratti Enterprise possono distinguere tra posti solo chat e posti Chat + Claude Code con fatturazione a consumo.
Google (Gemini)
Il piano gratuito offre accesso a Gemini 3.6 Flash e accesso variabile a Gemini 3.1 Pro, generazione di immagini di base, Deep Research, Gemini Live, Canvas e Gems. App incluse: Gemini Notebook (ex NotebookLM) e Flow con accesso limitato a Nano Banana Pro.
Google utilizza prezzi regionali, quindi i prezzi possono variare in base alla regione.
- Google IA Plus ($4,99/mese, USA) è il livello a pagamento di ingresso con limiti di utilizzo Free 2x. App incluse: più accesso a Gemini 3.1 Pro nella chat, generazione di immagini con Nano Banana Pro, generazione di video con Gemini Omni Flash, 200 crediti Flow, Gemini Notebook con più Audio Overviews, Gemini in Gmail, Docs e Vids e accesso anticipato a Gemini in Chrome. Include 400 GB di storage.
- Google IA Pro ($19,99/mese, USA) offre limiti di utilizzo Free 4x e 5 TB di storage. App incluse: Jules (agente di coding asincrono), Google Antigravity (piattaforma di sviluppo agentica), limiti ampliati di IA Studio, $40/mese in crediti Google Cloud, Gemini Notebook con 5x Audio Overviews, Deep Research, 1.000 crediti Flow, YouTube Premium Lite e Google Home Premium (piano Standard).
- Google IA Ultra (USA) costa $99,99/mese per limiti di utilizzo IA Pro 5x oppure $199,99/mese per 20x. App incluse: ragionamento Deep Think, Gemini Agent (solo USA), Gemini Spark, Project Genie (modello di mondo interattivo), Jules ai limiti più alti, Antigravity di livello superiore, 10.000 o 25.000 crediti Flow, Google Home Premium (piano Advanced) e un abbonamento individuale YouTube Premium. Lo storage parte da 20 TB.
Microsoft Copilot
Il piano gratuito (Copilot Chat) è disponibile senza costi aggiuntivi per tutti gli utenti Microsoft Entra con un abbonamento idoneo a Microsoft 365. Include la chat Copilot di base nelle app Microsoft senza le funzionalità più avanzate all'interno dei documenti.
- Microsoft 365 Premium ($19,99/mese o $199,99/anno) è ora il piano Copilot consumer. Include le app Office, fino a 6 TB di storage (1 TB ciascuno per un massimo di sei persone) e i limiti Copilot consumer più elevati; le funzionalità IA si applicano solo al titolare dell'abbonamento. Il precedente Copilot Pro ($20/mese) è chiuso ai nuovi acquisti e gli abbonati esistenti possono mantenerlo o passare a Premium.
- Microsoft 365 Copilot Business ($21/utente/mese annuale; $18/utente/mese tariffa primo anno per acquisti fino al 30 settembre 2026; $25,20/utente/mese mensile) aggiunge Copilot nelle app Microsoft 365, integrazione con Teams e controlli di amministrazione. App incluse: Copilot Studio Lite per creare agenti leggeri, Copilot in SharePoint e Copilot Pages per bozze collaborative. Limitato a organizzazioni con un massimo di 300 utenti.
- Microsoft 365 Copilot Enterprise ($30/utente/mese annuale, o $31,50/utente/mese con fatturazione mensile; richiede una licenza idonea di Microsoft 365) offre sicurezza avanzata, conformità e analisi in aggiunta alle funzionalità Business. App incluse: creazione di agenti con Copilot Studio (gli agenti predefiniti e con dati di lavoro possono essere misurati; Copilot Studio autonomo è venduto separatamente), Copilot in Microsoft Purview e Intune per flussi di lavoro IT e di sicurezza, e governance sugli agenti distribuiti.
xAI (Grok)
Il piano gratuito offre accesso limitato a Grok.
- SuperGrok Lite ($10/mese) è il livello a pagamento di ingresso. Include conversazioni più lunghe 2x, limiti di velocità superiori e creazione di immagini e video IA. App incluse: Grok Build (l'agente di creazione di app di xAI, anche gratuito sul web da agosto 2026) e Grok Imagine per la generazione di immagini e video.
- SuperGrok ($30/mese, oppure $300/anno) include ragionamento potenziato con Grok 4.6, conversazioni più lunghe 5x, caricamenti di file più lunghi, modalità Voice per chat vocale e 20x più generazioni di immagini e video Grok Imagine, inclusi video HD 720p da 30 secondi.
- SuperGrok Plus ($100/mese) aggiunge accesso a Grok Bot, generazione video 1080p, limiti di utilizzo più elevati, risposte più veloci e accesso prioritario.
- SuperGrok Heavy ($300/mese) offre tutto ciò che è incluso in Plus, un team di agenti per lavoro parallelo, limiti di velocità massimi, anteprime anticipate delle prossime funzionalità xAI e un abbonamento X Premium+. Nel luglio 2026 xAI ha anche distribuito componenti aggiuntivi per Excel, Outlook e Google Workspace, oltre ad Automazioni pianificate; la maggior parte sono gratuito, mentre il componente aggiuntivo Outlook e le Automazioni attivate via email sono riservati agli utenti a pagamento.
Grok è anche incluso negli abbonamenti X: X Premium ($8/mese) è il percorso a pagamento più economico per Grok all'interno dell'app X e include stato verificato e annunci ridotti. X Premium+ ($40/mese) rimuove gli annunci su X e offre i limiti di utilizzo Grok più elevati, insieme alla monetizzazione completa per i creator.
Moonshot IA (Kimi)
I piani consumer di Kimi prendono il nome dalle indicazioni di tempo musicali, dal più lento al più veloce. I prezzi internazionali sono in USD; gli utenti cinesi pagano in CNY a tariffe più basse. A partire da agosto 2026, i nuovi acquisti sono in lista d'attesa. La pagina dei prezzi annuncia piani futuri che separano i vantaggi di Kimi e Kimi Code, e la nota del 20 luglio di Moonshot cita vincoli di capacità di calcolo per il lancio ritardato, quattro giorni dopo il rilascio di K3. Gli abbonati esistenti mantengono i loro piani e possono rinnovarli.
- Adagio (Free) offre conversazioni di base illimitate con 6 utilizzi dell'agente, richieste Deep Research limitate e attività di base dell'agente OK Computer.
- Moderato ($19/mese) aggiunge Kimi K3 in chat e nelle attività dell'agente, più sessioni Deep Research ampliate. App incluse: Kimi Code (agente di coding IA terminal-first; una stima di 300 - 1.200 richieste per finestra di 5 ore, fatturate dal pool di crediti condiviso), più gli strumenti di creazione Slides e Websites.
- Allegretto ($39/mese) offre un utilizzo maggiore per tutto ciò che è incluso in Moderato. App incluse: Agent Swarm (orchestrazione di subagenti paralleli, fino a 4 sottoattività parallele su questo livello), distribuzione cloud Kimi Claw per gruppi di agenti eterogenei con memoria persistente e 2x i crediti agente di Moderato.
- Allegro ($99/mese) offre 5x i crediti agente, Agent Swarm con un massimo di 8 sottoattività parallele e chat K3 con un massimo di 1M token di contesto.
- Vivace ($199/mese) offre 10x i crediti agente, 4 attività concorrenti, Agent Swarm con un massimo di 8 sottoattività parallele e chat K3 con un massimo di 1M token di contesto, pensato per carichi di lavoro intensivi di ricerca e agentici.
L'iscrizione include chiavi API Kimi Code per l'uso in strumenti di coding di terze parti; la API separata Kimi Open Platform viene fatturata per token.
MiniMax
MiniMax vende un unico Token Plan basato sui suoi modelli M3 e M2.7. Ha sostituito i precedenti piani separati di crediti Agent e il Coding Plan a metà 2026.
MiniMax Token Plan (un'unica quota per agenti, coding e lavoro multimodale):
- Plus ($20/mese): finestre di quota mobili di 5 ore e settimanali, sufficienti per 3-4 agenti di coding in parallelo; per progetti personali e prototipazione.
- Max ($50/mese): le stesse finestre per 4-5 agenti paralleli; per coding quotidiano con agenti e lavoro multimodale.
- Ultra ($120/mese): 6-7 agenti paralleli; per flussi di lavoro agentici pesanti e sessioni estese.
- Pacchetti di crediti: $5 per 5.000 crediti, $25 per 25.000, $100 per 100.000 (1.000 crediti = $1, validi 365 giorni), utilizzabili in aggiunta a qualsiasi piano.
Il Token Plan copre l'intera gamma di modelli (M3, M2.7, immagini e voce) in un'unica quota, risultando uno dei percorsi più economici verso un modello di coding frontier se abbinato a una CLI come Cline o Kilo Code.
Mistral AI
Il piano Free di Mistral Vibe (ex Le Chat) include navigazione web, analisi file di base, generazione di immagini, sessioni di coding limitate, 100+ connettori e $10/mese in crediti API.
- Piano Pro ($14,99/utente/mese) include più messaggi e ricerche web, più rapporti di pensiero esteso e Deep Research, 15 GB di storage documenti, fino a 1.000 progetti, generazione di immagini e $30/mese in crediti API. App incluse: la modalità Code di Mistral Vibe in CLI, IDE o web, con pagamento a consumo oltre la quota inclusa. Gli studenti verificati ottengono Pro a $5,99/mese.
- Piano Team ($24,99/utente/mese) include tutto ciò che è in Pro con un massimo di 30 GB di storage per utente, fatturazione centralizzata, controllo accessi basato sui ruoli, verifica del nome di dominio ed esportazione dei dati. App incluse: Mistral Vibe al livello di utilizzo team con controlli amministrativi condivisi.
- Piano Enterprise (prezzo personalizzato) offre opzioni di implementazione sicure, tra cui self-hosted e cloud privato, SAML SSO, registri di audit, supporto premium e analisi dettagliate. App incluse: Mistral Vibe con opzioni di implementazione on-premise per carichi di lavoro regolamentati.
DeepSeek
DeepSeek non offre piani di abbonamento tradizionali. L'accesso via web e mobile ai modelli più recenti (attualmente DeepSeek V4-Flash e V4-Pro) è gratuito per tutti gli utenti, con limitazione per uso corretto.
L'accesso API è pay-per-token con tariffe di punta e non di punta dal 16 agosto 2026. Fuori punta, V4-Flash costa $0,22 per milione di token di input (cache miss) e $0,66 per milione di token di output; le tariffe di punta sono doppie ($0,44 e $1,32). V4-Pro costa $0,66 e $1,98 fuori punta. I cache hit costano circa il 3% della tariffa miss e gli orari di punta sono 01:00-04:00 e 06:00-10:00 UTC nei giorni feriali.
DeepSeek è entrata anche nel tooling per agenti. DeepSeek Harness, un toolkit open-source basato su plugin per creare ed eseguire agenti IA, è in anteprima per sviluppatori con codice sorgente pubblico. Non ha un prezzo proprio ed è agnostico rispetto al modello; l'uso viene fatturato in base all'API del modello chiamato dall'agente.
Meta (Muse Spark)
Meta IA rimane gratuito all'interno di WhatsApp, Instagram, Facebook, Messenger, l'app Meta IA e gli occhiali Ray-Ban Meta, basata su Muse Spark (lanciato l'8 aprile 2026, ora alla versione 1.2). Meta ha avviato test limitati degli abbonamenti a pagamento Meta One. I piani Plus e Premium aumentano la quota mensile di utilizzo IA e l'accesso alla modalità Thinking, segnalati a $7,99 e $19,99 al mese.1
La Meta Model API è in anteprima pubblica, self-service e compatibile con l'SDK di OpenAI. Il pricing pay-as-you-go di Muse Spark 1.2 parte da $1,25 per milione di token di input e $4,25 per milione di token di output con una finestra di contesto da 1M token. Muse Code, un agente di coding per terminale, è stato rilasciato in beta il 5 agosto 2026.
Comprendere il LLM pricing
Token: l'unità fondamentale di prezzo
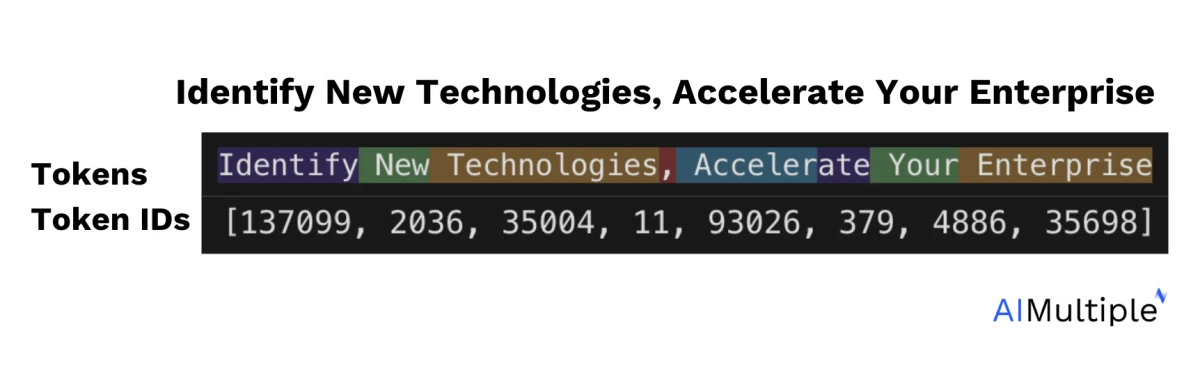
Figura 1: Esempio di tokenizzazione con il tokenizer GPT-4o & GPT-4o mini per la frase “Identify New Technologies, Accelerate Your Enterprise.”2
Sebbene i provider offrano diverse strutture di prezzo, il pricing per token è il più comune. I metodi di tokenizzazione differiscono tra i modelli; gli esempi includono:
- Byte-Pair Encoding (BPE): Divide le parole in unità subword frequenti, bilanciando dimensione del vocabolario ed efficienza.3
- Esempio: “unbelievable” → [“un”, “believ”, “able”]
- WordPiece: Simile a BPE ma ottimizzato per la verosimiglianza del modello linguistico, usato in BERT.4
- Esempio: “tokenization” → [“token”, “##ization”]. “token” è una parola autonoma; “##ization” è un suffisso.
- SentencePiece: Tokenizza il testo senza fare affidamento sugli spazi, efficace per modelli multilingue come T5.5
- Esempio: “natural language” → [” natural”, ” lan”, “guage”] o [” natu”, “ral”, ” language”].
Si noti che le subword esatte dipendono dai dati di addestramento e dal processo BPE/WordPiece. Per comprendere meglio questi metodi di tokenizzazione, guarda il video qui sotto:
Dopo aver compreso la tokenizzazione, è possibile stimare un prezzo medio in base alla lunghezza in token del progetto. La Tabella 2 mostra gli intervalli di token per tipo di contenuto, inclusi prompt UI, snippet email, blog di marketing, report dettagliati e articoli di ricerca, e nota che il numero di token varia tra i modelli. Una volta scelto un modello, il suo tokenizer può essere usato per stimare il numero medio di token per il contenuto.
Tabella 2: Tipi di contenuto tipici, relative dimensioni e considerazioni aziendali (gli intervalli sono stime e possono variare).
Implicazioni della finestra di contesto
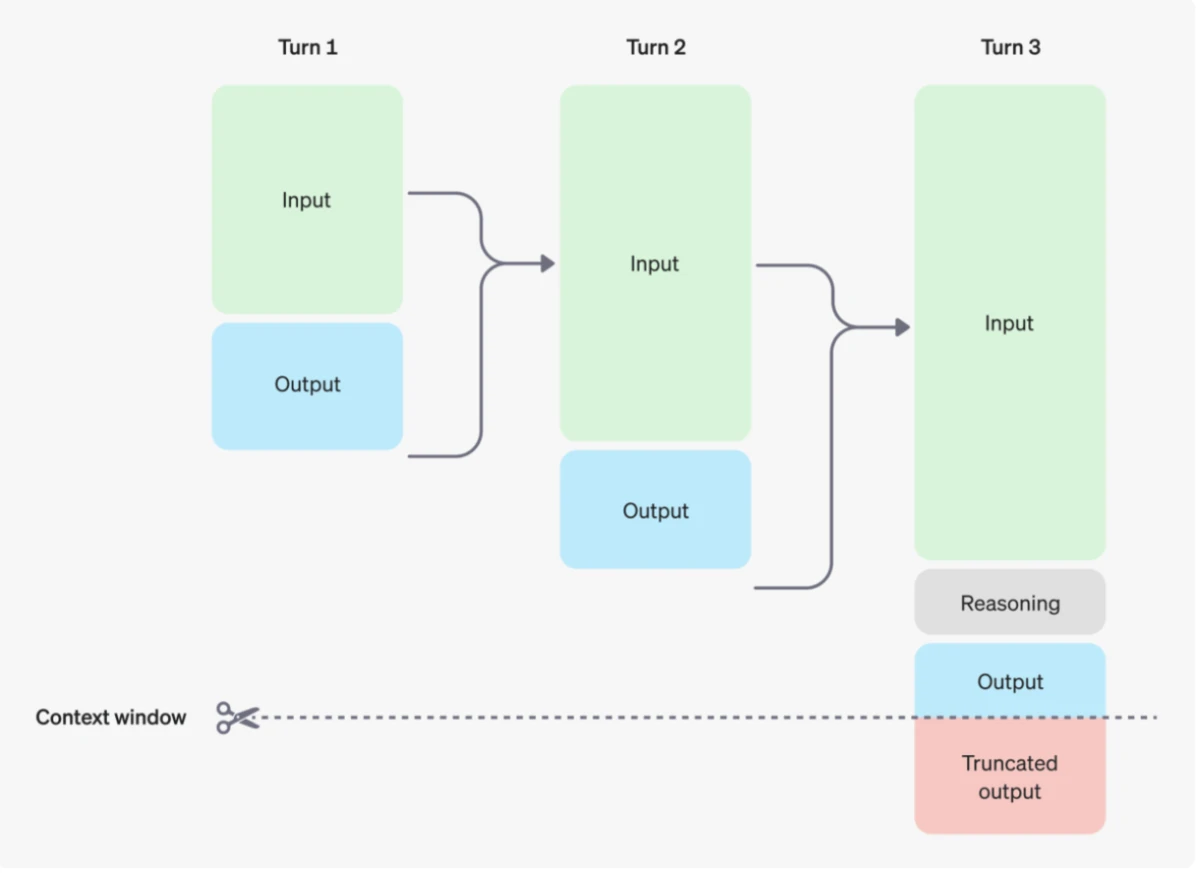
La finestra di contesto impone un limite rigido al numero di token di input e output per chiamata, inclusi eventuali token usati dai modelli di ragionamento per il chain-of-thought. Se il totale supera questo limite, la risposta viene troncata oppure la richiesta fallisce del tutto.
Figura 2: Illustrazione delle limitazioni della finestra di contesto che portano al troncamento dell'output in una conversazione multi-turno.6
Per le applicazioni che mantengono conversazioni lunghe, ogni turno aggiuntivo inserisce più cronologia nell'input. Senza interventi, i token di input crescono linearmente con la lunghezza della conversazione, e così anche il conto. Gli utenti delle API affrontano in genere questo problema in tre modi:
- Prompt caching. OpenAI, Anthropic, Google e DeepSeek memorizzano nella cache i prefissi di prompt ripetuti lato server e fatturano i cache hit a una frazione della tariffa di input standard, in genere dal 3 al 10 percento del prezzo in caso di cache miss. Per le applicazioni che riutilizzano un lungo prompt di sistema o un prefisso di conversazione, la cache può ridurre il costo di input di un ordine di grandezza.
- Finestra a scorrimento o retrieval-augmented generation (RAG). Elimina i turni più vecchi una volta raggiunta una soglia, oppure recupera solo i messaggi passati pertinenti da un vector store a ogni chiamata.
- Riassunto. Condensa periodicamente i turni più vecchi in un riassunto invece di rinviarli integralmente.
Per carichi di lavoro agentici come sessioni di coding o ricerca approfondita, i moderni agenti di coding gestiscono automaticamente la cosa nella sessione. Claude Code, ad esempio, include la compattazione del contesto: quando la conversazione si avvicina al limite, riassume i messaggi più vecchi in una versione condensata mantenendo intatti i turni recenti. I turni successivi inviano al modello solo il riassunto e il contesto recente.
L'impatto sul pricing è diretto. Sulle API per-token, la compattazione limita la crescita dell'input di ogni chiamata e la cache riduce il prezzo del prefisso ripetuto, quindi il costo per turno rimane prevedibile nelle sessioni lunghe. Sugli abbonamenti a tariffa flat come Claude Pro, ChatGPT Plus o Kimi Moderato, la compattazione estende i limiti di utilizzo giornalieri e settimanali perché ogni chiamata trasporta meno contesto. Una sessione di coding che altrimenti brucerebbe un limite di velocità di 5 ore può durare più a lungo quando i turni più vecchi vengono compressi.
Il compromesso è che qualsiasi forma di riassunto comporta perdita di informazioni. Il riassunto può omettere dettagli che in seguito si rivelano importanti, costringendo l'utente a fornirli di nuovo
Token massimi in output
Il numero massimo di token in output limita la lunghezza della risposta di un modello. Sebbene molte documentazioni indichino che può essere regolato tramite il parametro max_tokens, è fondamentale consultare la documentazione della specifica API usata per identificare il parametro corretto. Dovrebbe essere regolato in base alle esigenze specifiche:
Se impostato troppo basso, può produrre output incompleti, inducendo il modello a interrompere le risposte prima di fornire la risposta completa.
Se impostato troppo alto, a seconda della temperature (parametro che controlla la creatività della risposta), può portare a output inutilmente prolissi, tempi di risposta più lunghi e costi maggiori.
Pertanto, è un parametro che richiede un'attenta valutazione per ottimizzare l'uso delle risorse bilanciando qualità dell'output, costi e prestazioni.
Tabella 3: Esempi di prompt di input e conteggi di token stimati per tipo di contenuto.
*Questo presuppone che ogni modello produca risposte con un numero uguale di token di output, sebbene il conteggio dei token sia per input sia per output possa variare in base alla tokenizzazione di ciascun modello; qui il numero è stato mantenuto costante per ogni modello.
Combinando gli intervalli di token della Tabella 2 con le tariffe per token di un modello si ottiene il costo previsto per tipo di contenuto; i prompt di esempio della Tabella 3 mostrano le dimensioni di input e output dietro tali stime.
Utilizzare più modelli linguistici
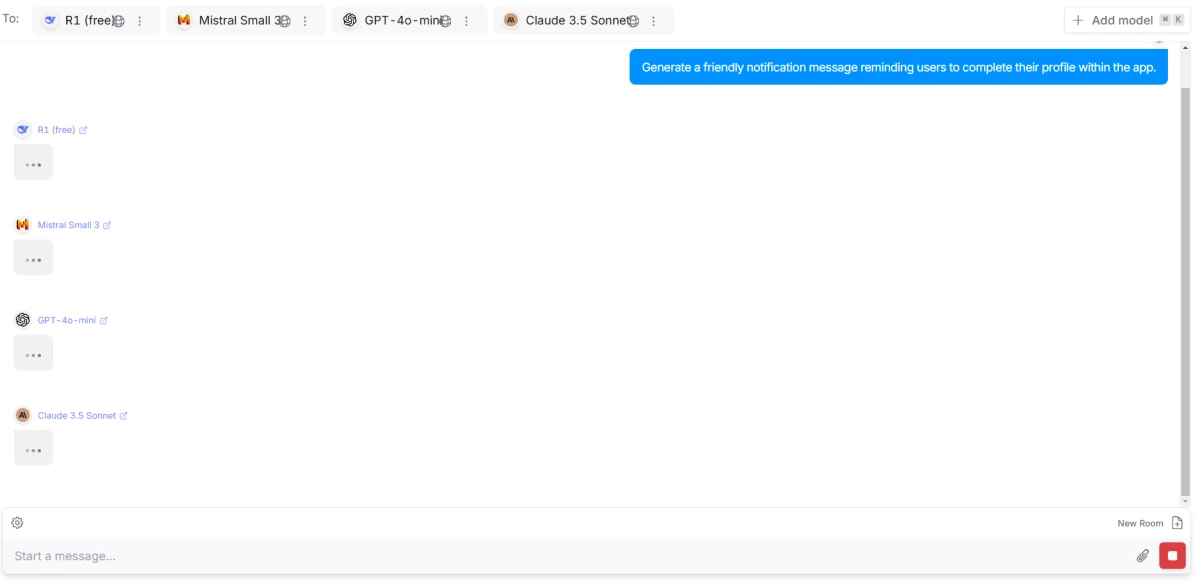
Un gateway IA come OpenRouter consente di inviare lo stesso prompt a più modelli contemporaneamente. Risposte, consumo di token, tempo di risposta e pricing possono essere confrontati per determinare quale modello sia più adatto al compito.
Figura 3: Interfaccia che mostra un prompt inviato a più Large Language Models tramite OpenRouter.7
Vantaggi e sfide
- Maggiore adattabilità ed efficienza: L'orchestrazione migliora la reattività, consentendo una valutazione in tempo reale dell'efficienza del modello e l'identificazione di un modello conveniente e di potenziali risparmi.
- Sensibilità e ottimizzazione del prompt: Prompt identici possono produrre output molto diversi tra i modelli, rendendo necessario un prompt engineering su misura per ciascun modello per ottenere i risultati desiderati, aumentando la complessità di sviluppo e manutenzione.
Meccaniche di pricing & costi nascosti
Token di ragionamento vs. token di output
Un numero crescente di provider ha introdotto modelli di ragionamento che impiegano calcolo aggiuntivo per eseguire internamente il chain-of-thought. OpenAI, Anthropic e Google fatturano questi token di ragionamento come token di output alla tariffa di output standard del modello, quindi l'aumento dei costi deriva dal volume, non da un prezzo per token più elevato.
Modelli come GPT-5.5 Pro, Claude Opus 5 con pensiero esteso o Gemini 3.1 Pro Deep Think generano internamente tracce di ragionamento
anche quando non le richiedi esplicitamente. Questi token interni contano ai fini della fatturazione e possono aumentare sostanzialmente i costi, soprattutto in attività analitiche lunghe come revisione legale, analisi dei dati o ragionamento multi-step.
Ciò rende essenziale:
- Scegliere un modello di ragionamento solo quando l'accuratezza supera sostanzialmente il costo.
- Disattivare il chain-of-thought o impostare un numero massimo di token di output più breve quando possibile.
- Testare la stessa attività su modelli non di ragionamento per vedere se le prestazioni sono paragonabili a una frazione del prezzo.
Poiché un modello di ragionamento può emettere da 10 a 30 volte più token di output di quanti ne produrrebbe lo stesso prompt senza ragionamento, è fondamentale comprendere questa distinzione per la pianificazione dei costi.
Differenze di pricing legate all'architettura
Le architetture dei LLM influenzano direttamente l'efficienza del modello e, di conseguenza, il pricing delle API. Ad esempio:
- Mixture-of-Experts (MoE) attiva solo un sottoinsieme di parametri per richiesta, riducendo i costi di calcolo e consentendo ai provider di offrire tariffe per token più basse.
- Speculative decoding abbina un modello draft più piccolo a uno più grande, migliorando il throughput e riducendo i costi per attività deterministiche.
- Varianti quantizzate (ad es. 4-bit o 8-bit) possono eseguire inferenza a precisione inferiore, consentendo prezzi più bassi per versioni distribuite localmente o ospitate nel cloud.
Comprendere queste scelte architetturali aiuta gli utenti a prevedere non solo le differenze di pricing, ma anche latenza, qualità e scalabilità di un modello sotto carichi di lavoro di produzione.
Costi operativi oltre le tariffe API
Sebbene il pricing per token sia il principale fattore di costo, molte implementazioni di produzione comportano costi aggiuntivi oltre l'uso delle API:
- Embedding e database vettoriali: L'archiviazione e il recupero dei vettori (ad es. Pinecone, Weaviate, ChromaDB) aggiungono costi per query e per GB di storage.
- Modelli di reranking e post-elaborazione: Molte applicazioni usano modelli più piccoli per riassunto, filtraggio o classificazione prima di inviare una richiesta finale a un modello più grande.
- Livelli di caching: Provider come OpenAI offrono ora la cache a livello di prompt, ma un'infrastruttura di cache locale può richiedere calcolo aggiuntivo.
- Logging, monitoraggio e audit: Le aziende spesso sostengono costi per il monitoraggio a livello di token, il tracciamento della latenza e gli audit di sicurezza.
Questi costi nascosti rappresentano spesso il 20–40% delle spese operative totali per gli LLM e dovrebbero essere considerati quando si valutano le strutture di pricing.
 Aggiungi come fonte preferita
Considerazioni sul pricing specifiche per le aziende
Molti fornitori di LLM applicano costi aggiuntivi per funzionalità di sicurezza e conformità di livello enterprise, come:
- Distribuzioni single-tenant
- Cluster GPU dedicati
- SLA migliorati (ad es. garanzie su uptime e latenza)
- Residenza dei dati e controlli regionali
- Modalità di conformità SOC2, HIPAA o GDPR
Queste offerte possono aumentare notevolmente i costi, ma sono essenziali per settori regolamentati come sanità, finanza, servizi legali e istituzioni pubbliche.
Tendenze future nel pricing degli LLM
Tre elementi hanno definito il pricing degli LLM nel 2025: i modelli commodity sono diventati economici, quasi tutti i principali provider hanno lanciato un abbonamento chat e i modelli di ragionamento sono rimasti costosi. Il divario è strutturale e probabilmente si amplierà: un milione di token di output costa $0,66 su DeepSeek V4-Flash (fuori punta) e $180 su GPT-5.5 Pro. Le domande interessanti dal 2026 in poi riguardano cosa cambierà su quella base.
La fatturazione per token lascia il posto al pricing per attività
Gli agenti ora generano la maggior parte dell'uso intensivo degli LLM. Una singola attività di coding con Claude Code, una sessione di ricerca con Cowork o una navigazione autonoma con Operator può effettuare centinaia di chiamate sequenziali al modello. La fatturazione a token diventa imprevedibile sia per l'acquirente sia per il venditore.
In risposta, i provider stanno passando dai contatori di token a quote per attività e sessione. Moonshot stima da 300 a 1.200 richieste Kimi Code per finestra di 5 ore da un pool di crediti condiviso. Claude Code limita l'utilizzo per sessione di 5 ore anziché per messaggio. MiniMax definisce le quote del Token Plan come finestre mobili di 5 ore e settimanali dimensionate in base al numero di agenti di coding paralleli. Kimi imposta limiti specifici per livello sui subagenti paralleli di Agent Swarm.
Gli harness per agenti multi-provider come OpenClaw e MaxHermes spingono oltre questo concetto. Si collocano tra utenti e più API di modelli, e il loro pricing segue sempre più il throughput per attività piuttosto che per milione di token. È prevedibile che più provider pubblichino SKU per attività o per sessione nel prossimo anno.
I piccoli modelli di ragionamento si spostano sul dispositivo
Apple Intelligence esegue l'inferenza sul dispositivo per le richieste di routine, ricorrendo a Private Cloud Compute solo per richieste complesse. I PC Copilot+ di Microsoft vengono forniti con un modello locale. I dispositivi Pixel eseguono Gemini Nano. Piccoli modelli recenti come Microsoft Phi-4 e Google Gemma 3 sono in grado di ragionare in dimensioni compatibili con l'unità di elaborazione neurale di un telefono o laptop.
La conseguenza sul pricing è un mercato consumer a due livelli. Il lavoro di routine viene eseguito gratuito al costo marginale del token sul dispositivo. Gli abbonamenti cloud competono su ciò che il locale non può fare: ragionamento frontier, contesto ampio, generazione multimodale e orchestrazione di agenti. Il pavimento gratuito locale spinge verso zero gli abbonamenti solo chat, lasciando le app incluse come vero motivo per pagare.
Contesto lungo e memoria decidono chi vince il lavoro agentico
Le attività agentiche di lungo orizzonte falliscono quando i modelli perdono traccia delle istruzioni precedenti o allucinano fatti che dovrebbero ricordare. Il lavoro agentico prolungato dipende da tre elementi: un'ampia finestra di contesto, memoria persistente e un basso tasso di allucinazione.
In un anno, tre capacità frontier sono crollate verso la baseline. Claude Opus 5, Gemini 3.1 Pro, GPT-5.6 e Kimi K3 offrono finestre di contesto da 1M token. Su OpenAI, Anthropic, Google e DeepSeek, i cache hit costano dal 3 al 10 percento dei cache miss. ChatGPT e Claude ora includono la memoria persistente nei loro livelli gratuito.
Modelli agentici specializzati stanno emergendo al vertice di questo mercato. A giugno 2026, Anthropic ha rilasciato Claude Fable 5, un modello di classe Mythos generalmente disponibile8, al prezzo di $10 per input e $50 per output per milione di token, il doppio della tariffa di Opus 5. Fable 5 è pensato per coding agentico, uso del computer e ricerca di lungo orizzonte; Claude Mythos 5, lo stesso modello con alcune protezioni rimosse, rimane limitato ai partner approvati allo stesso prezzo.
La domanda competitiva si sposta da “quanto è grande la finestra di contesto” a “quanto a buon mercato e in modo affidabile il modello può sostenere un'attività agentica lunga?”. I provider che risolvono bene questo aspetto imporranno prezzi premium. Quelli che non lo fanno perderanno carichi di lavoro agentici indipendentemente dal prezzo per token dichiarato.
FAQ
L'accesso a Large Language Models (LLM) tramite un'Application Programming Interface (API) garantisce l'accesso remoto ai modelli IA. Questo accesso è soggetto a una tariffa, spesso chiamata “API fee”, addebitata dal fornitore del servizio. Questa tariffa è un elemento critico quando si integrano gli LLM nelle proprie applicazioni.
Rappresenta il costo associato a ogni query, richiesta o attività eseguita tramite l'API del provider. Poiché le strutture di prezzo possono variare notevolmente (in base a fattori come uso dei token, volume di chiamate API, utilizzo delle funzionalità o modelli di abbonamento), è essenziale capire come i provider calcolano questi costi.
Il pricing LLM API può essere complesso a causa di fattori come consumo di token, lunghezza del contesto e scelta del modello. Le procedure di tokenizzazione variano tra i modelli: alcune usano Byte-Pair Encoding (BPE), WordPiece o SentencePiece, ciascuna influisce su come il testo viene suddiviso in token e sull'efficienza dei costi. Comprendere queste differenze aiuta a ottimizzare l'uso e il pricing dell'API.
I costi degli LLM sono determinati principalmente dall'uso dei token (sia input sia output), dal volume di chiamate API e dal modello di pricing (ad es. per token o in abbonamento).
Confronta i prezzi dei token di input e output, i limiti della finestra di contesto e eventuali costi aggiuntivi. Strumenti come OpenRouter consentono di inviare lo stesso prompt a più modelli e confrontare direttamente risultati, uso dei token, velocità e pricing. Considera la lunghezza tipica dei tuoi contenuti e i modelli di utilizzo per stimare i costi complessivi.
I token di input sono i token nel prompt inviato al LLM, mentre i token di output sono i token nella risposta generata. Per i modelli di ragionamento, anche i token generati durante il processo di ragionamento vengono conteggiati come token di output, influendo sul costo finale. Sia input sia output contribuiscono al costo complessivo.
Richieste di testo più grandi richiedono più elaborazione, aumentando tempi di risposta e costi. Ottimizza le dimensioni degli input e usa un calcolatore di pricing delle LLM API per stimare il numero di token e gestire efficacemente il budget.
La community degli LLM ha sviluppato vari strumenti e benchmark per aiutare gli utenti a comprendere e ottimizzare il pricing degli LLM. Queste risorse spesso includono calcolatori e grafici di confronto che offrono indicazioni sulla potenza e sull'efficienza dei diversi modelli.
Piattaforme come Hugging Face e GitHub ospitano strumenti e codice sviluppati dalla community per analizzare prestazioni e costi dei modelli. Molti servizi offrono supporto alla community tramite forum o funzionalità di chat.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM Prezzi: i migliori 15+ fornitori a confronto}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/llm-pricing}},
  note   = {AIMultiple. Consultato il 26 agosto 2026}
}Risultati e timestamp di 284 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 6 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
8 aggiornamentiAggiornata la descrizione del grafico nell'introduzione.
Aggiunto un grafico alla sezione dei tipi di prezzo LLM.
Rimossa la sezione 'Comprendere i prezzi LLM'.
Espansa la sezione "Implicazioni della finestra di contesto" con strategie per la gestione dell'utilizzo dei token nelle conversazioni lunghe.
Aggiunto ChatGPT Go alla sezione OpenAI.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.




Commenti 1
Condividi i tuoi pensieri
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.
"Really well-written and timely article! Your analysis of how different large language model (LLM) providers compare - based on token pricing, context window, and performance - really helps demystify an often opaque cost structure. I found the detailed breakdown of token-based billing (input vs output tokens), context-window implications, and the built-in “price calculator” particularly useful for anyone trying to realistically estimate LLM usage