


AIM-Text-to-SQL Benchmark: Accuratezza SQL su oltre 70 LLM
We evaluated SQL answers from 70+ LLMs on a 759-question BIRD-SQL subset. Each model selected a database from 11 candidates, then produced a query.
L'accuratezza SQL è la percentuale di query valutate che restituiscono il risultato di riferimento. I percorsi errati e i riferimenti contrassegnati come non validi sono esclusi. Una query di riferimento è la SQL fornita come risposta attesa.
Ogni model raggiunge un insieme diverso di domande SQL perché il punteggio dipende dalle scelte del database. Le differenze tra questi sottoinsiemi e la configurazione di esecuzione limitano i confronti.
Risultati Text-to-SQL
Opus 5.5 ha registrato 87,8% di accuratezza SQL
claude-opus-5.5 ha corrisposto al risultato di riferimento su 444 delle 506 domande valutate. gemini-4-argon ha seguito con 78,6% (407 delle 518), poi gemini-3.8-flash con 77,2% (342 delle 443). Questi sono stati i tre punteggi di accuratezza SQL più alti nel panel di 81 model. Muse Wonder ha registrato 56,4% (285 delle 505). GPT-6.1 Terra ha registrato 56,6% (280 delle 495). MiniMax M3.1 Flash ha registrato 36,5% (177 delle 485). Kimi K3.1 Pro ha registrato 52,3% (257 delle 491). Muse Spark Open ha registrato 44,9% (219 delle 488), e DeepSeek V4.1 Flash 1017 ha registrato 22,8% (108 delle 474).
Il punteggio esclude le scelte di database errate e i riferimenti contrassegnati come non validi. Opus 5.5 ha usato Claude Code. Gemini 4 Argon e Gemini 3.8 Flash hanno usato OpenRouter. La classifica riflette sia le condizioni di esecuzione sia le differenze nelle domande instradate correttamente da ciascun model.
Tre varianti Pro hanno ottenuto punteggi inferiori ai propri model base
gpt-6.1-sol-pro ha registrato 63,6% di accuratezza SQL, rispetto al 65,1% di gpt-6.1-sol. gpt-6-sol-pro ha ottenuto 53,6% contro il 53,8% di gpt-6-sol. gpt-6-luna-pro ha ottenuto 44,2% contro il 45,4% di gpt-6-luna.
Tutti e sei i model hanno usato OpenRouter. Questi punteggi derivano da un'unica esecuzione per model e da sottoinsiemi diversi di domande instradate correttamente. Sarebbero necessarie esecuzioni ripetute sulle stesse domande SQL per valutare se i piccoli divari persistono.
Costo vs. accuratezza SQL
Il costo di esecuzione copre le risposte di routing e SQL conservate da ogni esecuzione benchmark di ciascun model. L'obiettivo era di 759 domande. Sette esecuzioni hanno meno risposte conservate. Sono esclusi i test smoke separati, i tentativi scartati e le chiamate della giuria. L'accuratezza SQL usa le domande instradate correttamente da ciascun model dopo aver escluso i riferimenti contrassegnati come non validi.
gemini-3-flash-preview ha registrato 67,7% di accuratezza SQL a $7,67 per esecuzione. gemini-3.8-flash ha raggiunto 77,2% a $26.48. Opus 5.5 ha un punteggio di 87,8% associato a un costo stimato equivalente API di $188.71. Gemini 4 Argon ha raggiunto 78,6% a $41,41 nei costi di esecuzione conservati. Muse Wonder ha raggiunto 56,4% a $77,44 nei costi di esecuzione conservati. GPT-6.1 Terra ha raggiunto 56,6% a $7,19 nei costi di esecuzione conservati. MiniMax M3.1 Flash ha raggiunto 36,5% a $2,30 nei costi di esecuzione conservati. Kimi K3.1 Pro ha raggiunto 52,3% a $27,14 nei costi di esecuzione conservati. Muse Spark Open è costato $22,03 e DeepSeek V4.1 Flash 1017 è costato $1,75 per le esecuzioni conservate di routing-più-SQL.
I 78 model API usano costi misurati. Opus 5.5, Fable 5.1 e GPT-6 Astra hanno stime etichettate separatamente basate sui token CLI registrati e sui prezzi OpenRouter verificati il 1° ottobre 2026, con l'uso della cache registrato preservato.
I costi includono l'esplorazione del database e i punteggi SQL coprono sottoinsiemi di domande diversi. Questo confronto descrive quindi il costo e l'accuratezza del flusso di lavoro benchmark combinato. I costi isolati di generazione SQL non sono stati misurati. Il benchmark RAG agentico riporta la selezione del database separatamente.
Risultati di accuratezza SQL
Prima della revisione dei riferimenti misura la corrispondenza esatta dei risultati su tutte le domande instradate correttamente. Dopo la revisione delle risposte aggiunge credito per le risposte accettate dalla giuria. Entrambe le colonne di confronto usano il denominatore originale, mentre l'accuratezza SQL esclude i riferimenti contrassegnati.
Come i model hanno risposto alla stessa domanda SQL
La stessa domanda ha prodotto corrispondenze esatte, risposte corrette con colonne extra e un'istituzione non correlata. Tutti gli otto model hanno scelto il database corretto, college_completion. La tabella institution_details memorizza i nomi delle istituzioni in chronname, le città in city e gli stati in state. Queste risposte provengono da esecuzioni benchmark salvate. Sette model hanno usato OpenRouter, mentre Opus 5.5 ha usato Claude Code.
GPT-6.1 Terra, Kimi K3.1 Pro, Gemini 4 Argon e Opus 5.5 hanno restituito Georgia e superato la corrispondenza di esecuzione. Muse Spark Open e DeepSeek V4.1 Flash 1017 hanno identificato anch'essi la Georgia, ma hanno incluso le colonne nome e città. Non hanno superato il confronto stretto dei risultati. Tutti e tre i giurati della revisione delle risposte hanno accettato ogni risposta.
MiniMax M3.1 Flash e GLM 5.3 hanno usato LIKE '%Mercer%', che ha restituito anche il Mercer County Community College nel New Jersey. Tutti e tre i giurati hanno classificato ogni risposta come un errore del model. Il riferimento ha superato l'audit di validità separato.
Abbiamo selezionato questo caso per mostrare come il filtraggio e le colonne di output influenzino la valutazione. Illustra le risposte individuali. I risultati benchmark completi sopra forniscono il confronto complessivo tra i model.
Condizioni che influenzano l'accuratezza SQL
I suggerimenti di BIRD hanno aumentato per Gemini Flash l'accuratezza SQL di 8.7 punti
Abbiamo ripetuto gemini-3-flash-preview con le evidenze supplementari di BIRD. Sulle domande instradate correttamente in entrambe le condizioni, l'accuratezza SQL è salita da 67,5% a 76,2%. L'accuratezza stretta, prima della revisione dei riferimenti, è salita da 55,0% a 61,6%.
Questo è stato un esperimento su un singolo model. Non stabilisce un miglioramento comune per il panel di 81 model. Il panel principale nasconde i suggerimenti perché possono anche rivelare quale database selezionare.
I model hanno raggiunto insiemi diversi di domande SQL
Le scelte di database di ciascun model determinano quali domande raggiungono il punteggio SQL. Per claude-opus-5, il denominatore stretto contiene 717 domande, incluse 156 dal gruppo di routing più difficile. Per nova-lite-v1, contiene 285 domande, incluse 22 da quel gruppo. Le quote sono 21,8% e 7,7%.
Le loro percentuali SQL combinano quindi le prestazioni di scrittura delle query con la difficoltà dei casi che hanno raggiunto il punteggio. Un confronto SQL controllato fornirebbe a ogni model il database corretto per le stesse domande. Quell'esperimento non è stato eseguito.
La selezione delle domande è importante anche quando si confrontano benchmark IA che forniscono schemi, suggerimenti o budget degli strumenti diversi.
Risultati dalla revisione dei riferimenti e delle risposte
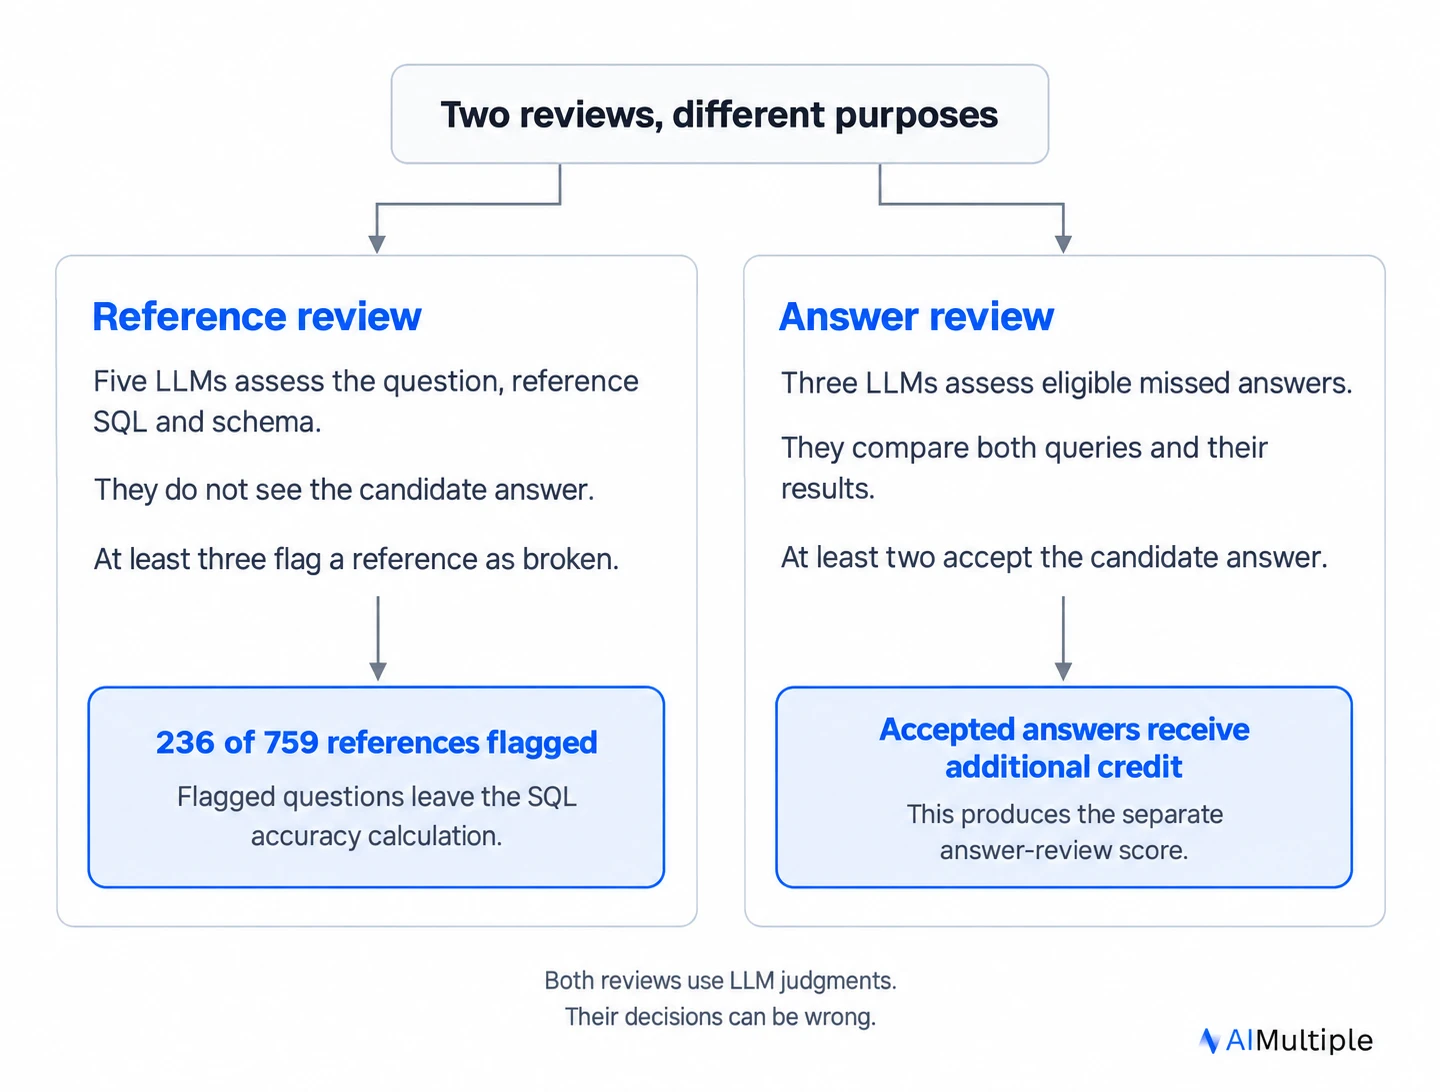
L'audit dei riferimenti ha contrassegnato 236 delle 759 query
Cinque model hanno valutato ogni query di riferimento rispetto alla sua domanda e alle informazioni sullo schema disponibili. Non hanno visto alcuna risposta candidata del model. Una maggioranza di almeno tre ha contrassegnato 236 riferimenti come non validi, ovvero il 31,1% dell'insieme.
Dopo l'audit, il proprietario del benchmark ha riesaminato i contrassegni. Annotatori umani indipendenti non hanno ripetuto quella revisione. Queste percentuali descrivono il sottoinsieme sottoposto ad audit. Non dovrebbero essere generalizzate a tutto BIRD.
Le risposte equivalenti hanno aggiunto 22.7 punti al punteggio di claude-sonnet-5
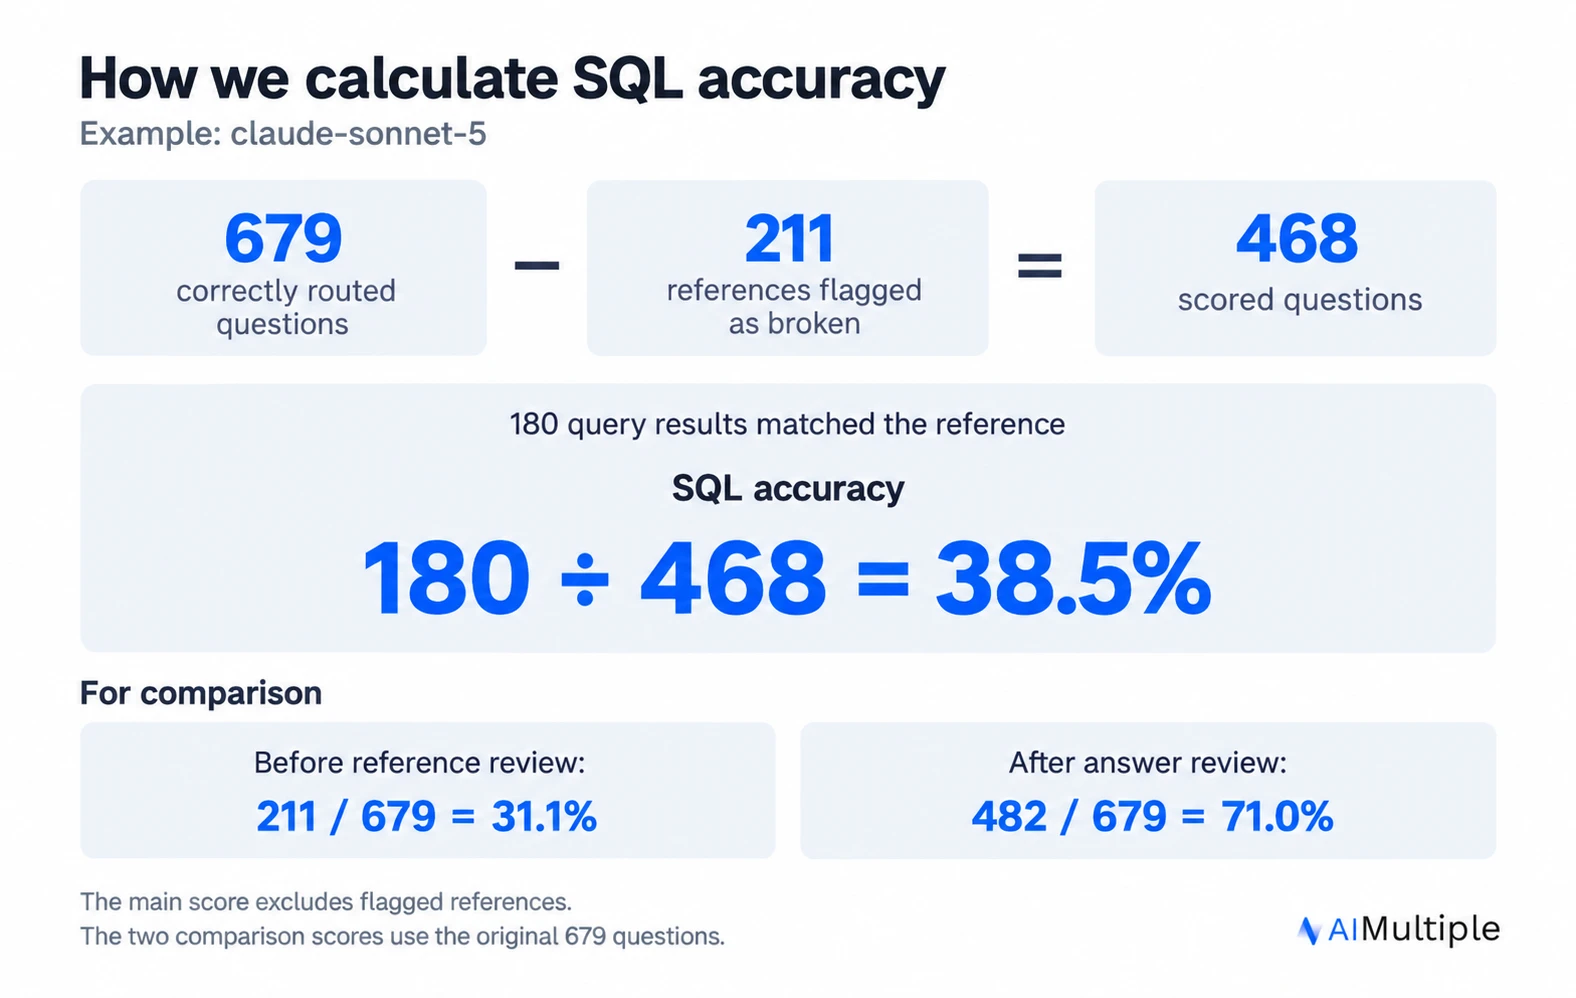
claude-sonnet-5 ha superato 211 delle 679 domande a punteggio stretto, ovvero il 31,1%. Una giuria ha accettato altre 154 risposte come equivalenti al riferimento. Queste hanno contribuito con 22.7 punti percentuali.
Ulteriori 117 risposte hanno ricevuto credito perché la giuria ha accettato la query del model e ha rifiutato il riferimento. Queste hanno contribuito con 17.2 punti. Together, le due categorie hanno portato il punteggio a 71,0%, un aumento di 39.9 punti.
Le risposte equivalenti possono restituire le informazioni richieste con una colonna extra o una proiezione diversa. Il confronto stretto può rifiutare quel risultato anche quando un revisore lo accetta come risposta alla domanda. Dell'aumento, 22.7 punti derivano dalle decisioni della giuria su questi casi. I difetti dei riferimenti rappresentano i restanti 17.2 punti.
 Aggiungi come fonte preferita
Metodologia del benchmark Text-to-SQL
Questions and execution
BIRD-SQL fornisce domande in linguaggio naturale, riferimenti SQL e contenuti di database.1 Abbiamo usato una selezione congelata di 759 domande da 11 database, che copre 560 esempi train e 199 esempi dev.
I model hanno ricevuto brevi descrizioni dei database e strumenti per elencare le tabelle, leggere le definizioni delle colonne ed eseguire SQL. Ogni domanda consentiva fino a nove chiamate con gli strumenti e una risposta finale contenente il database scelto e SQL. Il limite di anteprima dello schema era di 4.000 caratteri e le anteprime delle query erano limitate a 50 righe.
La query candidata finale e il riferimento sono stati eseguiti sullo stesso file di database. Il punteggio stretto ha confrontato i loro risultati, inclusa una modalità sensibile all'ordine per le domande che richiedono una risposta ordinata. Le query candidate mancanti, malformate o con errori di esecuzione non hanno ricevuto credito stretto per le domande altrimenti idonee e instradate correttamente.
Per le 78 esecuzioni OpenRouter, abbiamo richiesto temperatura 0. Di queste, 61 hanno usato il livello di recupero delle chiamate strumento v3, 15 lo precedevano e due hanno combinato record di entrambe le versioni. GPT-6 Astra è stato eseguito tramite Codex CLI. Opus 5.5 e Fable 5.1 hanno usato Claude Code. Tutte e tre le esecuzioni CLI hanno usato uno sforzo di ragionamento medio. Le esecuzioni di GPT-6 Luna, Luna Pro, Sol e Sol Pro e GPT-5.2 hanno usato OpenRouter. Queste differenze di esecuzione impediscono di attribuire un divario di punteggio al solo model.
Sette esecuzioni hanno completato meno di 759 domande. I record mancanti sono assenti dai denominatori di punteggio. La tabella riporta le dimensioni effettive del campione per i punteggi principali e supplementari. GPT-6.1 Terra, MiniMax M3.1 Flash e Kimi K3.1 Pro hanno completato ciascuno tutte le 759 domande tramite OpenRouter il 27 ottobre. Le risposte corrette precedenti sono state conservate tra le fasi di misurazione. DeepSeek V4.1 Flash 1017 e Muse Spark Open hanno completato ciascuno tutte le 759 domande tramite OpenRouter il 30 ottobre.
Punteggio SQL
Il punteggio principale esclude le domande contrassegnate sia dal numeratore sia dal denominatore. Tre riferimenti contrassegnati come incerti rimangono nel calcolo. I file dei risultati chiamano questa metrica ex_gold_clean.
Due punteggi supplementari mostrano come la revisione cambia il risultato:
Prima della revisione dei riferimenti, il punteggio stretto misura la corrispondenza esatta di esecuzione su tutte le domande instradate correttamente. Include le domande con riferimenti contrassegnati.
Dopo la revisione delle risposte, il punteggio aggiunge credito quando una giuria separata accetta una risposta mancata idonea. Usa lo stesso denominatore del punteggio stretto. I file dei risultati chiamano questa accuratezza aggiudicata.
La dimensione del campione (n) è il numero di domande valutate. Il punteggio principale usa un sottoinsieme più piccolo rispetto ai due punteggi supplementari.
Per claude-sonnet-5, l'esclusione dei riferimenti contrassegnati ha ridotto le risposte accettate da 211 a 180 e le domande valutate da 679 a 468. La sua accuratezza SQL è stata del 38,5%.
L'esclusione modifica entrambi i conteggi. La revisione delle risposte mantiene invece il denominatore originale e aggiunge credito per le risposte mancate accettate.
Revisione dei riferimenti e delle risposte
L'audit dei riferimenti e la revisione delle risposte candidate richiedono input diversi.
Gli auditor dei riferimenti erano claude-opus-4.8, gpt-5.6-sol, gemini-3.1-pro-preview, grok-4.5 e deepseek-v4-pro. Le risposte candidate sono state nascoste per mantenere i contrassegni indipendenti dal model in valutazione.
L'aggiudicazione delle risposte ha usato tre giurati di famiglie di model diverse da quella del candidato. Le query di riferimento e candidate sono apparse in posizioni A/B randomizzate senza etichette che rivelassero i loro ruoli. I casi ambigui e quelli con voti validi insufficienti non hanno ricevuto credito aggiuntivo. GPT-6.1 Terra, MiniMax M3.1 Flash e Kimi K3.1 Pro avevano almeno due voti validi della giuria per ogni caso idoneo. I singoli voti falliti restano nei registri di audit. Una risposta della giuria troncata di GPT-6.1 Terra è stata completata con un limite di output di 4.000-token, aumentato rispetto a 1.200. Il model della giuria, il prompt e le regole di punteggio sono rimasti invariati. DeepSeek V4.1 Flash 1017 e Muse Spark Open avevano almeno due voti validi della giuria per ogni caso idoneo.
La copertura della revisione è asimmetrica. I superamenti stretti restano accettati, mentre le risposte mancate idonee ricevono un'altra valutazione. Di conseguenza, l'aggiudicazione può conservare falsi positivi dal punteggio stretto e aggiungerne di propri. È una stima supplementare, senza correttezza garantita né un limite superiore garantito sull'accuratezza reale.
Una risposta mancata si qualificava per l'aggiudicazione quando la query candidata veniva eseguita e la sovrapposizione F1 tra le sue righe di risultato e il riferimento era inferiore a 0.5. L'F1 combina la proporzione di righe candidate trovate nel riferimento con la proporzione di righe di riferimento recuperate dal candidato.
Per esempio, gemini-3.5-flash-lite ha avuto 346 mancate risposte strette. Di queste, 314 si sono qualificate per la revisione. La giuria ha accettato la candidata in 144 casi: 92 con un riferimento rifiutato e 52 con entrambe le risposte accettate. Ha classificato 105 come errori del model e ha lasciato 65 ambigui. Le altre 32 mancate comprendevano 27 con una sovrapposizione dei risultati più elevata e cinque errori di esecuzione.
La giuria ha accettato il 45,9% delle 314 mancate risposte esaminate.
Limitazioni
Gli errori dei riferimenti restano incerti. L'audit a cinque model ha ispezionato le colonne delle tabelle usate da ciascuna query di riferimento, quindi potrebbe non rilevare una risposta situata in una tabella diversa. L'audit può anche rifiutare un riferimento valido. È necessaria una revisione ripetuta da parte di annotatori umani indipendenti per stimare entrambi i tipi di errore.
I giudizi della giuria dipendono dall'interpretazione del LLM. Nessuna revisione umana indipendente ha verificato tutti i verdetti di aggiudicazione. Nel controllo nova-lite-v1, l'accuratezza è salita da 18,9% con il punteggio stretto a 31,6% dopo l'aggiudicazione, mostrando che la revisione non ha prodotto automaticamente un punteggio elevato. Quel controllo da solo non può stabilire l'accuratezza della giuria.
Il confronto stretto può fallire in entrambe le direzioni. Colonne extra o un ordine diverso delle colonne possono far rifiutare una risposta utile. La normalizzazione delle maiuscole e l'arrotondamento dei valori in virgola mobile a sei cifre significative possono far accettare differenze che contano.
Gli intervalli di campionamento delle domande sono disponibili per i punteggi stretti e per l'accuratezza SQL nell'esportazione dei risultati. Omettono l'incertezza delle etichette dei riferimenti, l'errore della giuria e la variazione tra esecuzioni SQL ripetute. Nessuna analisi ripetuta SQL è riportata qui.
Questi sono risultati per un carico di lavoro selezionato, hint-free, con un requisito di routing del database. Non sono direttamente confrontabili con la classifica BIRD. I dati di addestramento pubblici comportano anche un rischio di sovrapposizione dei dati di addestramento, come discusso nell'articolo sul routing.
Conclusione
claude-opus-5.5 ha guidato l'accuratezza SQL con 87,8%, seguito da gemini-4-argon con 78,6% e gemini-3.8-flash con 77,2%.
Ogni punteggio SQL riflette le domande che quel model ha instradato correttamente e i riferimenti conservati dopo la revisione. Un confronto SQL controllato darebbe a ogni model le stesse domande e informazioni sul database, con controlli indipendenti delle etichette dei riferimenti e delle decisioni della giuria.
Ulteriori letture
- Benchmark RAG agentico: routing multi-database
- 800+ principali benchmark IA
- HALC-Bench: allucinazione degli LLM nel benchmark di retrieval a contesto lungo
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Text-to-SQL Benchmark: Accuratezza SQL su oltre 70 LLM}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/text-to-sql}},
  note   = {AIMultiple. Consultato il 30 ottobre 2026}
}Risultati e timestamp di 1.5 mila punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 5 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
9 aggiornamentiSostituiti i risultati del benchmark text-to-SQL con un panel di 36 modelli valutato tramite corrispondenza di esecuzione strict, gold-clean e adjudicated.
Aggiunto un changelog alla sezione "Agentic RAG benchmark: multi-database routing and query generation".
Sostituita la sezione metodologia con un riassunto e un riferimento a un altro articolo.
Collegamenti di riferimento





Commenti 1
Condividi i tuoi pensieri
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.
Curious, how much of the context engineering and specific prompting did you apply in your benchmarks. Or, was it to review the models only? I have found much higher return of correct and consistent responses. A higher fidelity. To do that, I needed to provide a most sophisticated prompt that fed the context window as the question was being asked. Not perfect, but better than those scores represented in this article when using the Grok 4.x .
Great point. This benchmark intentionally uses zero-shot, minimal prompting with temperature=0. No few-shot examples, no domain-specific instructions, no iterative refinement. The goal was to measure each model's baseline text-to-SQL capability. So your experience with Grok 4 getting higher fidelity through sophisticated context engineering is completely expected. A well-crafted prompt with detailed schema descriptions, few-shot examples, and domain-specific rules will improve any model's performance significantly. What this benchmark isolates is how well the model performs out-of-the-box when given only the raw question and retrieved schema, which helps compare the models' inherent SQL reasoning abilities on a level playing field. We'll make this clearer in the methodology section. Thanks for raising it.