


AIM-Agentic RAG Benchmark: instradamento tra 11 SQL database
We benchmarked 70+ LLMs on 759 questions that require choosing among 11 SQL databases. The benchmark measures whether each model identifies the right database, explores alternatives and states a final choice.
L'accuratezza di routing è la percentuale di domande valutate per cui il modello nomina esplicitamente il database corretto nella risposta finale. Il risultato principale usa le 184 domande contrassegnate come difficili sia dal nostro test di similarità sia da una giuria di tre LLM. Le dichiarazioni esplicite mancanti non ricevono alcun credito.
Risultati del routing dei database
Gemini 4 Argon ha registrato l'accuratezza di routing più alta, pari al 94,0%
gemini-4-argon ha selezionato il database corretto per 173 di 184 domande difficili. claude-opus-5.5 segue con il 90,2% (166 di 184). Muse Wonder ha registrato 86,4% (159 di 184). GPT-6.1 Terra ha registrato 83,7% (154 di 184). MiniMax M3.1 Flash ha registrato 81,5% (150 di 184). Kimi K3.1 Pro ha registrato 84,8% (156 di 184). Muse Spark Open ha registrato 81,0% (149 di 184) e DeepSeek V4.1 Flash 1017 ha registrato 77,2% (142 di 184).
Gemini 4 Argon ha guidato su tutte le domande con il 98,4% (747 di 759). È stato eseguito tramite OpenRouter. I punteggi osservati riflettono sia le condizioni del modello sia quelle di esecuzione.
DeepSeek V4 Flash 0731 ha registrato un'accuratezza di routing del 82,1% a $1,37
DeepSeek V4 Flash 0731 ha risposto correttamente a 151 di 184 domande difficili. Le sue risposte conservate su tutte le 759 domande sono costate $1.37. Qwen3.8 Flash ha ottenuto 79,3% a $2,08, mentre MiMo-V2.6-Pro ha raggiunto 82,6% a $4.17.
Questi costi sommano le risposte riuscite conservate in ogni file dei risultati. I tentativi falliti e sostituiti sono esclusi. Questi totali dipendono dai provider e dalle condizioni di caching utilizzate durante la misurazione. Il grafico dei costi include 78 totali misurati di API e tre stime equivalenti a OpenRouter etichettate separatamente per Opus 5.5, Fable 5.1 e GPT-6 Astra. Queste stime applicano i prezzi API del 1° ottobre 2026 ai token CLI registrati e all'uso della cache. Non misurano la spesa per abbonamenti.
Grok 4.6 ha guadagnato 41.8 punti dopo la prima scelta del database
L'accuratezza di routing sulle domande difficili di Grok 4.6 è salita dal 38,0% alla prima analisi al 79,9% nella dichiarazione finale. GPT-6 Sol Pro ha guadagnato 34.2 punti nel corso della sua esecuzione. Nova Lite ha perso 14.0 punti.
Queste variazioni usano domande con un solo database al primo turno. Descrivono traiettorie registrate. Nessun intervento separato ha isolato il beneficio delle chiamate aggiuntive.
Tra tutti gli 81 modelli, 8.203 record di domande difficili includevano un cambio di database:
Questa tabella considera il primo database nell'ordine delle chiamate registrate, inclusi i primi turni con più database. Il credito finale richiede una dichiarazione corretta esplicita. Le variazioni in punti percentuali sopra usano il sottoinsieme più ristretto della singola prima scelta.
Risultati del routing dei database
I modelli sono ordinati per accuratezza di routing, dal più alto. La metodologia identifica differenze nel software utilizzato per eseguirli. Queste condizioni sono importanti quando si interpretano piccole differenze di punteggio.
Gli intervalli stimano l'incertezza del campionamento delle domande. I costi registrati coprono i record riusciti in ogni esecuzione. Riflettono i provider e le condizioni di caching utilizzate al momento della misurazione.
Condizioni che influenzano la selezione del database
Database simili hanno ridotto l'accuratezza di routing di circa 20 punti
Abbiamo testato il metodo di selezione del database in un esperimento separato su 128 domande. Ogni domanda manteneva il proprio database corretto, mentre le altre 10 candidate provenivano dal nostro gruppo selezionato o da un'estrazione casuale.
Nel sottoinsieme difficile, claude-opus-4.8 ha ottenuto 71,3% con candidate simili e 92,0% con candidate casuali. gemini-3.5-flash ha ottenuto 77,0% e 96,6%. Entrambe le differenze avevano p-value inferiori a 0.001 nei test appaiati.
Questo esperimento ha usato descrizioni e una risposta del modello per domanda, senza il ciclo di strumenti agentico. Supporta il risultato più ristretto secondo cui selezionare candidate simili rende più difficile la scelta del database. Il divario misurato non deve essere presentato come effetto dell'esplorazione agentica.
I soli nomi hanno prodotto un'accuratezza del 68,8% e del 71,1% in un progetto pilota
In un altro pilota da 128 domande, claude-opus-4.8 ha selezionato il database giusto il 68,8% delle volte usando solo i nomi. Il suo punteggio con nomi e descrizioni è stato del 67,2%. gemini-3.5-flash ha ottenuto 71,1% dai nomi e 75,0% dal catalogo completo.
Nomi come california_schools e toxicology rivelano direttamente il soggetto. Per il benchmark principale, sostituiamo i nomi dei database con alias da db_01 a db_11. Le descrizioni spiegano ancora il dominio di ciascun database e le risposte degli strumenti espongono i nomi delle tabelle e delle colonne.
Affidabilità dei confronti di routing e costi
Le esecuzioni ripetute hanno modificato l'accuratezza di routing di 1.6 a 2.7 punti
claude-opus-5 ha selezionato il database corretto per 156 di 184 domande difficili nella prima esecuzione e 151 nella ripetizione. La sua accuratezza è scesa dal 84,8% al 82,1%. qwen3.8-max è passato da 153 risposte corrette a 150, un calo dal 83,2% al 81,5%.
Entrambe le ripetizioni hanno usato le stesse domande, anonimizzazione, temperatura e impostazioni del provider delle esecuzioni originali. qwen3.8-max ha cambiato risposta su 13 domande difficili anche se il suo totale è variato di tre. I miglioramenti su alcune domande hanno annullato gli errori su altre.
Queste ripetizioni mostrano che piccole differenze di punteggio possono scomparire in un'altra esecuzione. Una sola ripetizione per modello non può stabilire una distribuzione dei risultati, e gli altri 79 modelli non hanno misurazioni ripetute.
I costi registrati dipendono dalle impostazioni del provider e di caching
La cache dei prompt riutilizza input già elaborati per ridurre i costi fatturati dell'input. L'esecuzione di claude-opus-5 è costata $62,78, rispetto a una stima di $105,54 alle tariffe di listino senza cache per lo stesso utilizzo registrato. Questa stima implica un risparmio del 40,5%. È un confronto contabile, senza un'esecuzione separata di accuratezza senza cache.
La RAG agentica e la selezione del database
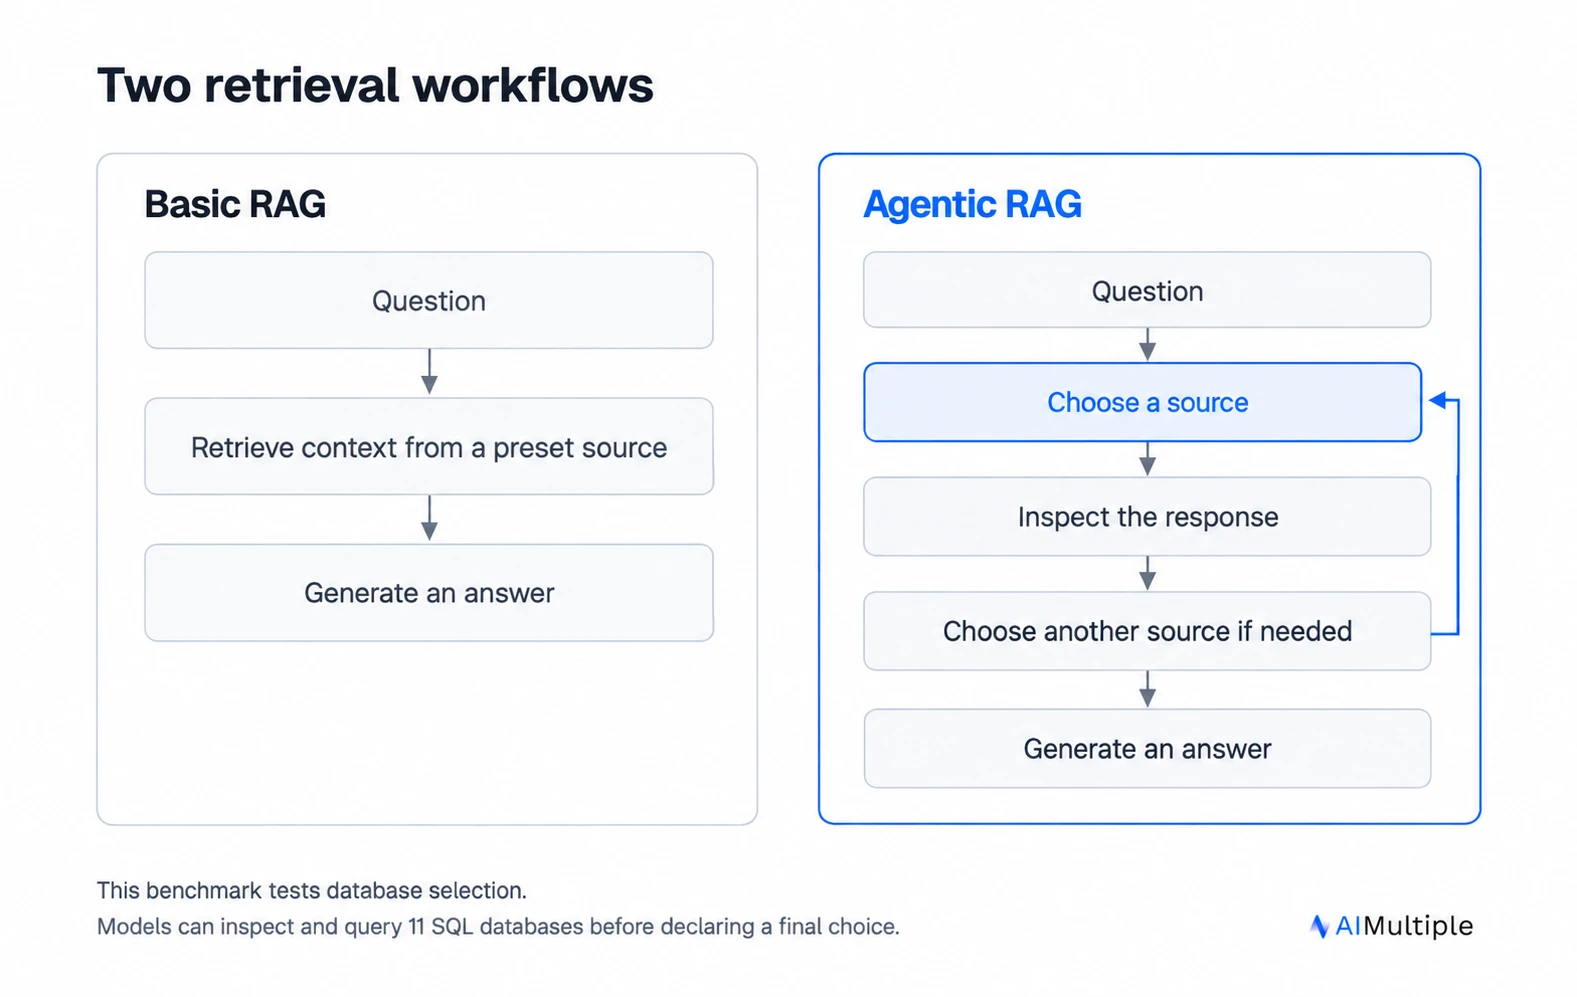
La RAG agentica dà al modello il controllo sulle decisioni di recupero. Può scegliere una fonte, esaminare la risposta e fare un'altra richiesta. Una semplice RAG pipeline recupera il contesto attraverso una sequenza predeterminata prima di generare una risposta.
Questo benchmark verifica la selezione delle fonti tramite strumenti per database SQL. Non contiene un indice di documenti, passaggi recuperati o punteggio di fondatezza delle risposte. I risultati descrivono quindi una parte di un sistema di recupero agentico. La ricerca documentale è trattata separatamente nel nostro benchmark di ricerca agentica.
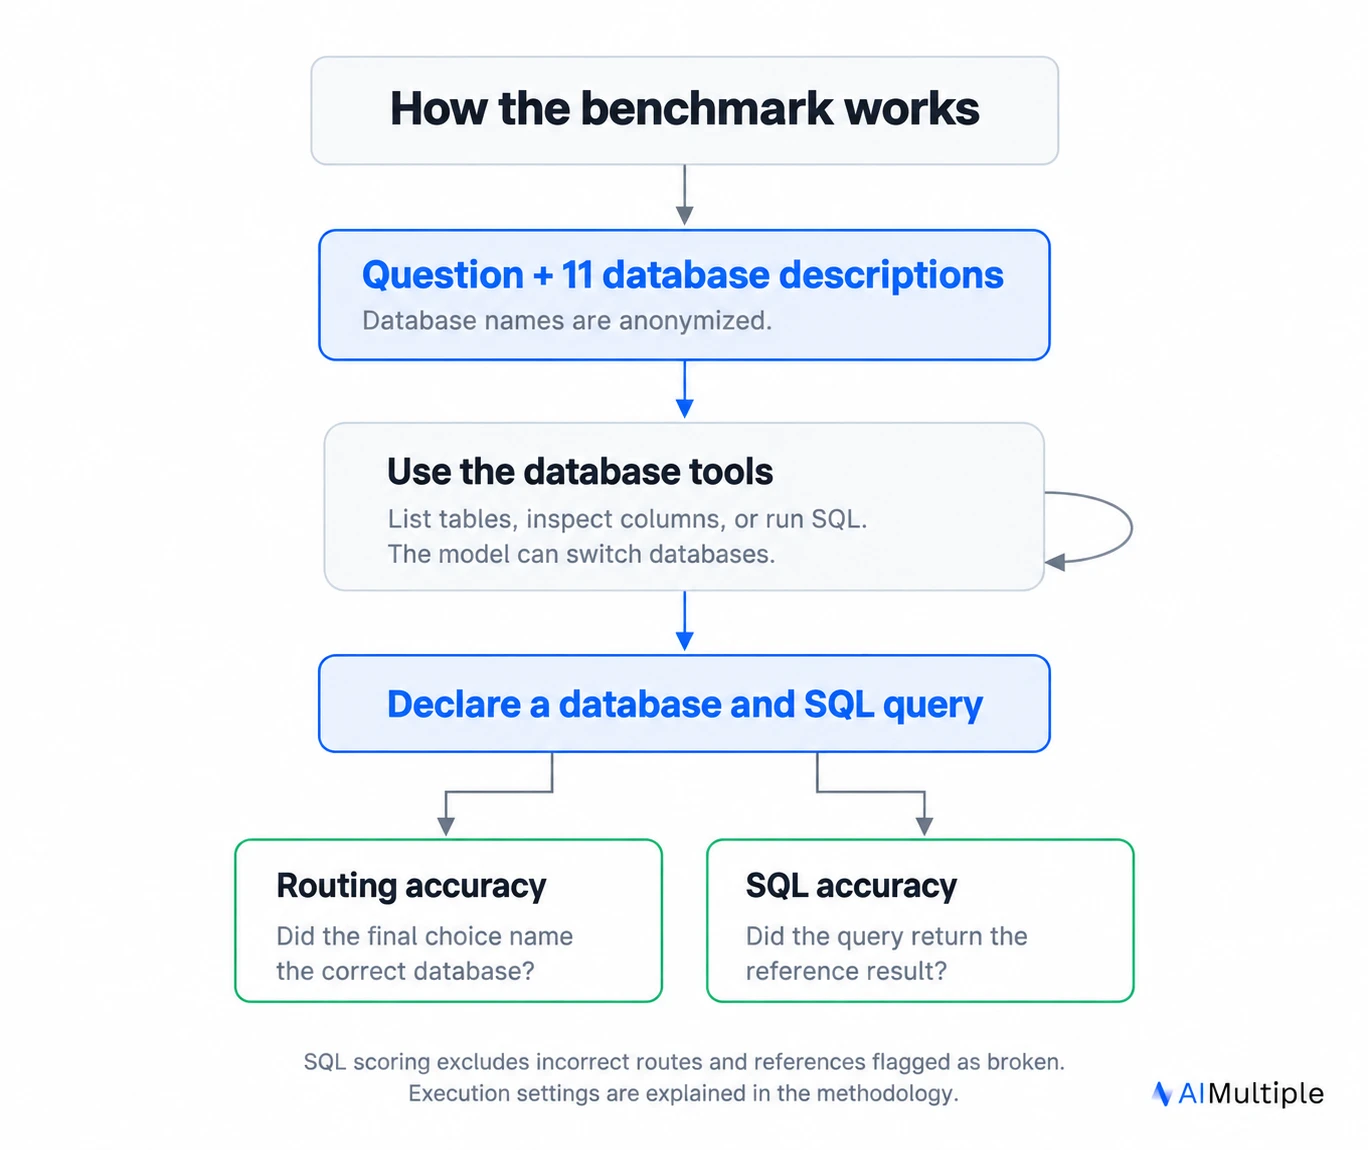
Un modello parte da brevi descrizioni dei database. Può richiedere elenchi di tabelle, esaminare colonne, eseguire SQL e cambiare database. La sua risposta finale contiene una scelta del database e una query. Il nostro benchmark text-to-SQL riporta l'accuratezza SQL e due punteggi di revisione supplementari.
Metodologia del benchmark di RAG agentica
Il set di domande è un sottoinsieme congelato di BIRD-SQL, che associa domande in linguaggio naturale a query di riferimento SQL.1
Due segnali definiscono la difficoltà. Il test di similarità conta quanti dei 20 vicini più prossimi di una domanda appartengono ad altri database. Tre LLM valutano se la domanda è confondente tra i database. L'appartenenza al gruppo più difficile richiede almeno cinque vicini cross-database e un'etichetta di confondimento della giuria.
Il routing usa il database indicato nel campo esplicito selected_database. Un percorso dedotto dalla prosa è escluso dal risultato principale. La correttezza SQL viene valutata separatamente e non determina il credito di routing.
L'harness è il software che presenta gli strumenti e registra le risposte dei modelli. Il pannello contiene 78 esecuzioni OpenRouter, due esecuzioni Claude Code e un'esecuzione Codex CLI. Tra le esecuzioni API, 61 hanno usato la v3, 15 hanno usato una versione precedente e due hanno combinato record di entrambe le versioni. Nella v3, un livello di ripristino analizza i formati alternativi supportati per le chiamate degli strumenti. Per llama-4-maverick, la quota registrata di formato non nativo era del 97,9%, quindi quel risultato dipende fortemente dall'adattatore. minimax-m2.7 è stato escluso perché non ha effettuato le chiamate agli strumenti del database richieste dal compito.
GPT-6 Astra è stato eseguito all'interno di Codex CLI. Opus 5.5 e Fable 5.1 sono stati eseguiti tramite Claude Code. Tutti e tre hanno usato uno sforzo di ragionamento medio e hanno completato 759 domande. Le esecuzioni Claude Code hanno usato abbonamenti e Astra non ha riportato costi in dollari. Il grafico dei costi include stime equivalenti a OpenRouter etichettate separatamente per queste tre esecuzioni CLI. Le esecuzioni di GPT-6 Luna, Luna Pro, Sol e Sol Pro e GPT-5.2 hanno usato OpenRouter.
 Aggiungi come fonte preferita
Limitazioni
Il sottoinsieme difficile si concentra sul commercio. Quattro database contribuiscono a 171 delle sue 184 domande, pari al 92,9%. Cinque degli 11 database non ne contribuiscono nessuna. Questo supporta conclusioni sulla scelta tra database simili all'interno di un dominio, con prove limitate per altre combinazioni di domini. GPT-6.1 Terra, MiniMax M3.1 Flash e Kimi K3.1 Pro hanno completato tutte le 759 domande tramite OpenRouter il 27 ottobre. Le risposte precedenti riuscite sono state conservate. Gli esiti dei nuovi tentativi possono dipendere da cambiamenti nella disponibilità del servizio. DeepSeek V4.1 Flash 1017 e Muse Spark Open hanno completato tutte le 759 domande tramite OpenRouter il 30 ottobre.
I dati pubblici dei benchmark potrebbero essere comparsi nell'addestramento dei modelli. I controlli che hanno usato 138 parafrasi validate e 65 domande scritte ex novo non hanno rilevato un calo di accuratezza nei modelli a basso costo testati. La loro copertura era limitata rispettivamente a sei e tre database. Non risolvono la contaminazione per l'intero pannello e nessun controllo ha usato database rilasciati dopo le date limite di addestramento dei modelli.
Il troncamento dello schema può nascondere tabelle utili. In works_cycles, il limite di 4.000 caratteri lascia visibili 26 tabelle delle 66 nell'elenco iniziale dello schema. Il modello può richiedere ulteriori dettagli, ma la visualizzazione iniziale è incompleta.
Conclusioni
gemini-4-argon ha registrato il punteggio di routing più alto sulle domande difficili con il 94,0%. DeepSeek V4 Flash 0731 ha raggiunto l'82,1% con $1,37 di costi per le risposte conservate nell'intera esecuzione.
La configurazione di esecuzione, i nuovi tentativi e i prezzi dei provider limitano i confronti. Questi risultati misurano la selezione del database tra fonti SQL simili. Il recupero dei documenti e la generazione di risposte fondate richiedono valutazioni separate.
Ulteriori letture
- Text-to-SQL: confronto dell'accuratezza degli LLM
- RAG Framework: LangChain vs LangGraph vs LlamaIndex
- I migliori strumenti, framework e librerie RAG
- Ricerca agentica nel 2026: benchmark di 8 API di ricerca per agenti
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Agentic RAG Benchmark: instradamento tra 11 SQL database}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/agentic-rag}},
  note   = {AIMultiple. Consultato il 27 ottobre 2026}
}Risultati e timestamp di 1.1 mila punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 7 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
16 aggiornamentiAggiornata la sezione 'Cosa rende difficile una domanda in questo benchmark?' con nuovi contenuti.
Aggiornata la metodologia per chiarire come le domande più difficili sono distribuite tra i database.
La sezione sulla metodologia di benchmark RAG Agentic è stata sostituita con una nuova che copre 36 LLM e 11 database.
Aggiunti nuovi modelli al benchmark: Claude Fable 5, Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, Claude Opus 4.7.
Aggiornata la sezione della metodologia con nuovi dettagli sull'ambiente del database, l'architettura dell'agente e il processo di valutazione.
Aggiunta una sezione sui modelli a contesto lungo rispetto al RAG agentico.
Rimosse metriche agentiche aggiuntive dalla metodologia.
Collegamenti di riferimento








Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.