


15 Strumenti di osservabilità per agenti IA: AgentOps & Langfuse

Abbiamo testato 15 piattaforme di osservabilità per applicazioni LLM e agenti IA. Ogni piattaforma è stata implementata sul campo attraverso la configurazione di flussi di lavoro, integrazioni e l'esecuzione di scenari di test. Abbiamo valutato tramite benchmark 4 strumenti di osservabilità per misurare se introducono overhead nelle pipeline di produzione. Abbiamo inoltre dimostrato un LangChain tutorial di osservabilità con Langfuse.
Benchmark dell'overhead degli strumenti di monitoraggio agentico
Abbiamo integrato ciascuna piattaforma di osservabilità nel nostro sistema multi-agente di pianificazione dei viaggi e abbiamo eseguito 100 query identiche per misurarne l'overhead prestazionale rispetto a una baseline senza strumentazione. Leggi la nostra metodologia di benchmark.
- LangSmith ha dimostrato un'efficienza eccezionale senza overhead praticamente misurabile, il che lo rende ideale per ambienti di produzione critici dal punto di vista delle prestazioni.
- Laminar ha introdotto un overhead minimo pari al 5%, risultando molto adatto ad ambienti di produzione in cui le prestazioni sono critiche.
- AgentOps e Langfuse hanno mostrato un overhead moderato, rispettivamente del 12% e del 15%, rappresentando un compromesso ragionevole tra funzionalità di osservabilità e impatto sulle prestazioni. Queste piattaforme mantengono comunque una latenza accettabile per la maggior parte dei casi d'uso in produzione.
Possibili ragioni alla base delle differenze di prestazioni
Il nostro benchmark indica che le differenze di latenza sono determinate dalla profondità della strumentazione e dal coinvolgimento del percorso di esecuzione, in particolare nei flussi di lavoro multi-agente. Gli strumenti che offrono un'osservabilità più profonda, a livello di singolo passaggio, hanno mostrato un overhead più elevato, mentre gli approcci di tracciamento più leggeri sono rimasti più vicini alla baseline.
1. Profondità della strumentazione sul percorso di esecuzione
Gli strumenti di osservabilità aggiungono logica al flusso di esecuzione dell'agente per acquisire tracce e metadati. Quando questa logica viene eseguita in modo sincrono durante la gestione delle richieste, aumenta direttamente la latenza end-to-end perché l'agente deve completare questo lavoro aggiuntivo prima di restituire una risposta.
Ad esempio:
- LangSmith ha aggiunto un overhead praticamente non misurabile (~0%), indicando poco lavoro sincrono,
- la strumentazione più profonda a livello di passaggio di Langfuse ha contribuito a un overhead più elevato (~15%).
2. Amplificazione degli eventi nelle pipeline multi-step
Nei sistemi multi-agente, una singola richiesta utente attiva molteplici azioni dell'agente. Quando uno strumento registra dati dettagliati a ogni passaggio, il numero totale di eventi cresce rapidamente, aumentando l'overhead di elaborazione e gestione delle tracce man mano che il flusso di lavoro diventa più profondo.
Nei risultati del benchmark:
- Langfuse e AgentOps hanno generato un overhead notevolmente più elevato (15% e 12%) nel nostro flusso di lavoro di pianificazione viaggi multi-step
- LangSmith e Laminar hanno emesso meno eventi per passaggio dell'agente.
3. Overhead di valutazione e validazione inline
Alcune piattaforme eseguono controlli o monitoraggi aggiuntivi mentre l'agente è in esecuzione. Sebbene ogni controllo sia leggero, applicarli ripetutamente a tutti i passaggi dell'agente aggiunge una latenza misurabile.
Ad esempio:
- Il monitoraggio a livello di ciclo di vita di AgentOps è coinciso con un overhead del 12%
- Laminar non ha mostrato evidenze che la valutazione inline influisse sull'esecuzione, rimanendo a circa il 5%.
4. Frequenza di serializzazione e persistenza
L'acquisizione di dati di osservabilità dettagliati richiede la serializzazione delle tracce e la loro scrittura su storage o backend esterni. Un maggiore dettaglio delle tracce aumenta la frequenza con cui ciò avviene, aggiungendo overhead di I/O a ogni richiesta.
Nel nostro benchmark:
- Il tracciamento dettagliato di prompt, output e token di Langfuse ha determinato l'overhead più elevato (~15%)
- Gli artefatti di traccia più leggeri di LangSmith sono rimasti vicini alla baseline.
5. Grado di integrazione con il framework agente
Quanto strettamente uno strumento si integra con il framework dell'agente influisce sulle prestazioni. Integrazioni più strette riducono i passaggi di traduzione e orchestrazione, mentre SDK più generici aggiungono livelli di elaborazione aggiuntivi.
Ad esempio:
- Lo stretto allineamento di LangSmith con l'esecuzione dell'agente è correlato a un overhead di circa lo 0%
- AgentOps e Langfuse hanno mostrato un impatto sulla latenza più elevato, coerente con percorsi di integrazione più disaccoppiati.
Piattaforme di osservabilità per agenti IA
Tier 1: Osservabilità granulare di LLM e prompt/output
* Le funzionalità elencate in queste colonne sono esempi illustrativi di ciò che ciascuno strumento può monitorare quando viene esteso tramite integrazioni o personalizzazione. Non sono esclusive di una singola piattaforma.
Tier 2: Osservabilità di workflow, modello e valutazione
Tier 3: Osservabilità del ciclo di vita e delle operazioni degli agenti
Tier 4: Monitoraggio di sistema e infrastruttura (non nativo per agenti)
Datadog (con il suo modulo di osservabilità LLM) e Prometheus (tramite exporter) sono sempre più utilizzati insieme a Langfuse/LangSmith.
Piattaforme di sviluppo e orchestrazione degli agenti:
- Strumenti come Flowise, Langflow, SuperAGI e CrewAI consentono di creare, orchestrare e ottimizzare flussi di lavoro degli agenti con interfacce no-code/low-code
Edizioni gratuito e prezzi di implementazione
Le edizioni gratuito variano in base ai limiti di utilizzo (ad es. osservazioni, tracce, token o unità di lavoro). I prezzi iniziali si riferiscono in genere a un piano base, che può prevedere restrizioni su funzionalità, utenti o limiti di utilizzo.
CoreWeave Forge (W&B Weave)
Caso d'uso: Debug degli errori nei sistemi multi-agente tracciando come gli errori si propagano tra le chiamate degli agenti.
W&B Weave, parte di CoreWeave Forge (precedentemente Weights & Biases), registra tracce di esecuzione strutturate per sistemi multi-agente, preservando le relazioni genitore-figlio tra le chiamate degli agenti.
Funzionalità di monitoraggio di Weave
- Tracciamento gerarchico degli agenti invece di log di richiesta piatti
- Attribuzione di costi e latenza a livello di agente
- Supporto nativo per gli scorer di valutazione applicati direttamente alle tracce.
Capacità di valutazione
Weave fornisce inoltre scorer integrati per la valutazione, tra cui:
- HallucinationFreeScorer per rilevare le allucinazioni,
- SummarizationScorer per valutare la qualità dei riassunti,
- EmbeddingSimilarityScorer per la similarità semantica,
- ValidJSONScorer e ValidXMLScorer per la validazione del formato,
- PydanticScorer per la conformità allo schema,
- OpenAIModerationScorer per la sicurezza dei contenuti,
- scorer RAGAS come ContextEntityRecallScorer,
- ContextRelevancyScorer per la valutazione dei sistemi RAG.
Più adatto per: Team che eseguono flussi di lavoro multi-step o multi-agente e hanno bisogno di un'analisi delle cause profonde a livello di traccia piuttosto che di metriche di superficie.
Langfuse
Casi d'uso: Tracciare le interazioni con i LLM, gestire le versioni dei prompt e monitorare le prestazioni del modello con sessioni utente.
Langfuse offre una visibilità approfondita sul livello dei prompt, acquisendo prompt, risposte, costi e tracce di esecuzione per supportare debug, monitoraggio e ottimizzazione delle applicazioni LLM.
Tuttavia, Langfuse potrebbe non essere adatto ai team che preferiscono flussi di lavoro basati su Git per la gestione del codice e dei prompt, poiché il suo sistema esterno di gestione dei prompt potrebbe non offrire lo stesso livello di controllo delle versioni e di collaborazione.
Funzionalità di monitoraggio di Langfuse
- Visibilità sull'evoluzione dei prompt e sui modelli di utilizzo
- Analisi basata sulle sessioni adatta alle applicazioni rivolte agli utenti
- Modello pratico di metadati e tagging per filtri e revisione
Funzionalità di livello enterprise:
Alcune di queste funzionalità includono:
- Livelli di log: regola la verbosità dei log per insight più granulari.
- Multimodalità: supporta testo, immagini, audio e altri formati per applicazioni LLM multimodali.
- Release e versionamento: traccia la cronologia delle versioni e verifica l'impatto delle nuove release sulle prestazioni del modello.
- URL delle tracce: accedi a tracce dettagliate tramite URL univoci per ulteriori ispezioni e debug.
- Grafici degli agenti: visualizza interazioni e dipendenze degli agenti per comprendere meglio il comportamento degli agenti.
- Campionamento: raccogli dati rappresentativi dalle interazioni per analizzarli senza sovraccaricare il sistema.
- Monitoraggio di token e costi: traccia l'utilizzo dei token e i costi per ogni chiamata al modello, garantendo una gestione efficiente delle risorse.
- Mascheramento: proteggi i dati sensibili mascherandoli nelle tracce, garantendo privacy e conformità.
Più adatto per: Team che iterano sui prompt e monitorano l'utilizzo in produzione, soprattutto quando le sessioni utente sono importanti.
Galileo
Casi d'uso: Monitorare costi/latenza, valutare la qualità dell'output, bloccare risposte non sicure e fornire correzioni attuabili.
Galileo monitora metriche di costo, latenza e qualità dell'output applicando al contempo controlli di sicurezza e conformità in tempo reale.
La piattaforma combina osservabilità tradizionale (latenza, costo, prestazioni) con debug e valutazione basati sull'IA (rilevamento di allucinazioni, correttezza fattuale, coerenza, aderenza al contesto).
Funzionalità di monitoraggio di Galileo
- Identificazione delle modalità di errore oltre gli errori superficiali (ad es. allucinazioni che portano a input di strumenti non validi)
- Feedback prescrittivo come modifiche ai prompt suggerite o aggiunte few-shot
- Stretta integrazione tra risultati della valutazione e correzioni raccomandate.
Più adatto per: Organizzazioni che danno priorità a qualità dell'output, sicurezza e cicli di iterazione rapidi con correzione guidata.
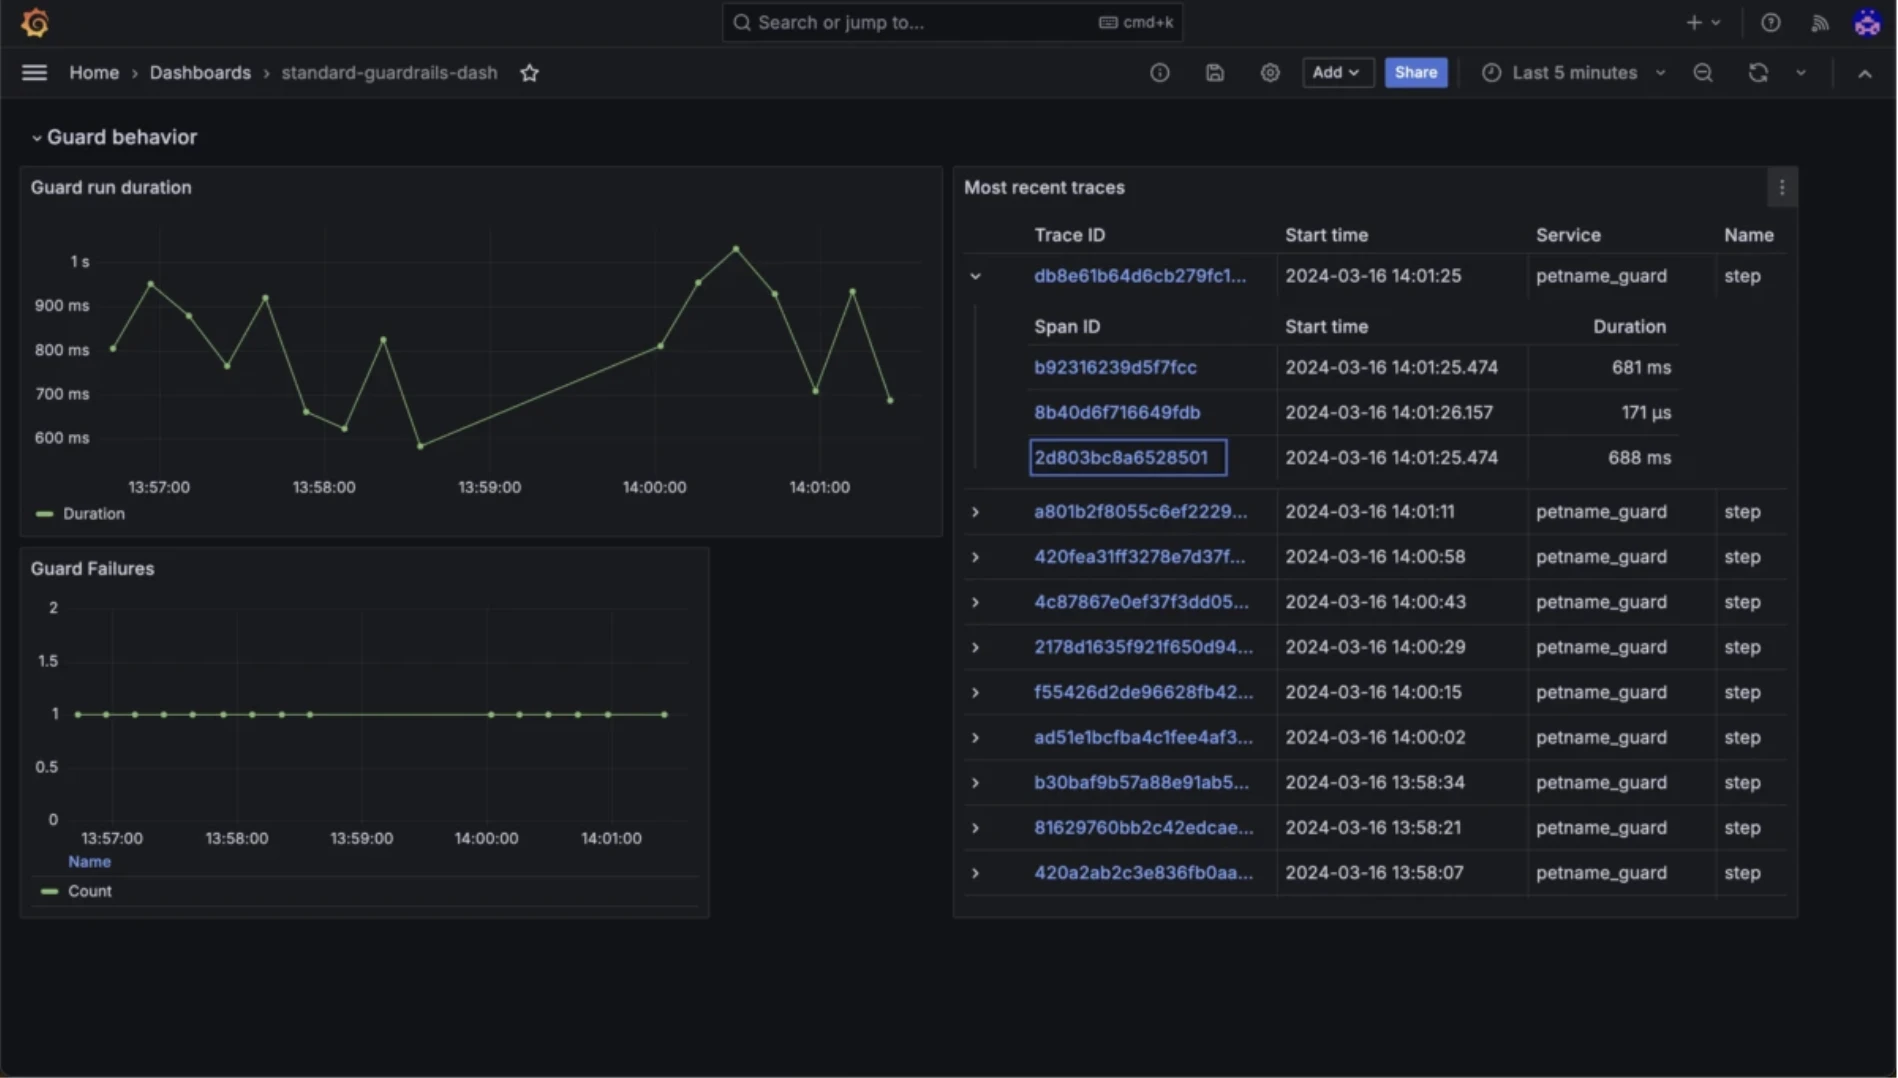
Guardrails AI
Casi d'uso: Prevenire output dannosi, convalidare le risposte LLM e garantire la conformità alle policy di sicurezza
Guardrails convalida input e output LLM rispetto a regole configurabili, tra cui tossicità, bias, esposizione di PII, segnalazione di allucinazioni e conformità del formato.
Guardrails AI funzionalità di monitoraggio
- Validazione deterministica tramite specifiche RAIL
- Guardie di input per prompt injection e rilevamento di jailbreak
- Nuovi tentativi automatici in caso di fallimento della validazione.
Più adatto per
Team che devono applicare garanzie rigorose di sicurezza, conformità o formattazione prima che le risposte vengano restituite.
LangSmith
Casi d'uso: Debug del ragionamento degli agenti e delle chiamate agli strumenti (incentrato su LangChain)
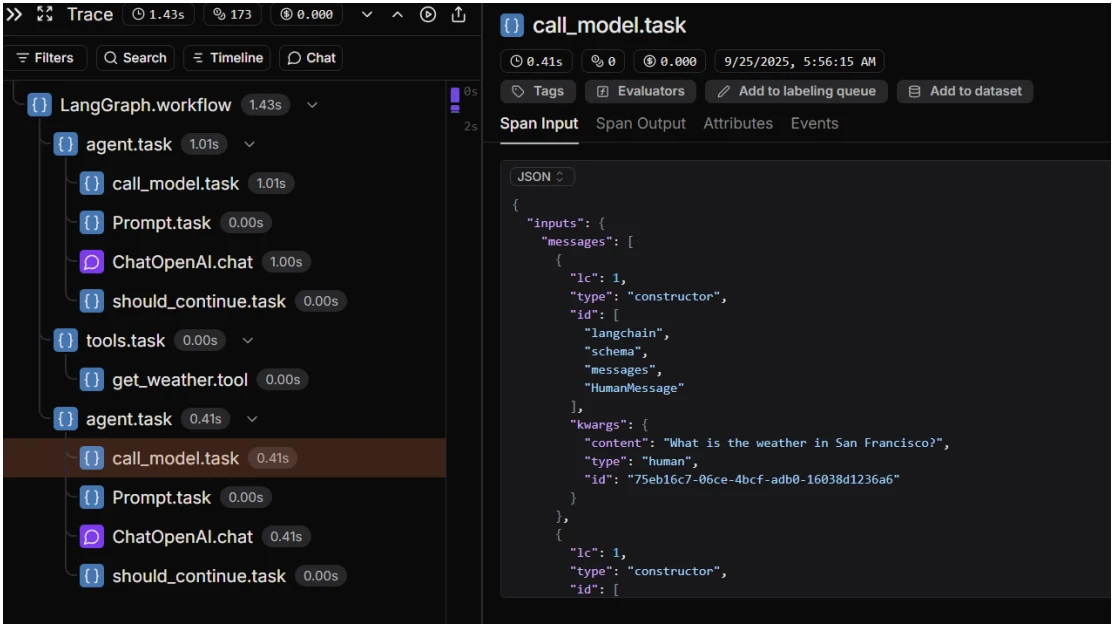
LangSmith acquisisce tracce complete del ragionamento per agenti basati su LangChain, inclusi prompt, contesto recuperato, logica di selezione degli strumenti, input/output degli strumenti, errori ed eccezioni.
Funzionalità di monitoraggio di LangSmith
- Ispezione passo dei percorsi decisionali dell'agente
- Riproduzione delle esecuzioni e confronto fianco a fianco tra prompt, modelli o strumenti
- Integrazione stretta con LangChain tramite callback.
Più adatto per
Team che sviluppano con LangChain e hanno bisogno di eseguire il debug in dettaglio di ragionamenti errati o chiamate a strumenti errate.
Langtrace IA
Casi d'uso: Identificare i colli di bottiglia di costi e latenza nelle applicazioni LLM
Langtrace tiene traccia di conteggi di token, durata dell'esecuzione, costi delle API e parametri delle richieste nelle pipeline LLM utilizzando tracce compatibili con OpenTelemetry.
Langtrace IA funzionalità di monitoraggio
- Allineamento a OpenTelemetry per l'integrazione con backend esistenti
- Visibilità sui fattori di costo e latenza per ogni passaggio
- Versionamento leggero dei prompt e ambiente di test.
Più adatto per: Team che ottimizzano prestazioni e spesa nei flussi di lavoro LLM piuttosto che valutare la qualità dell'output.
Arize (Phoenix)
Casi d'uso: Monitorare il drift del modello, rilevare i bias e valutare gli output LLM con sistemi di scoring completi
Phoenix si concentra sul drift comportamentale, sul rilevamento dei bias e sullo scoring LLM-as-a-judge per pertinenza, tossicità e accuratezza.
Tuttavia, presenta un overhead di integrazione più elevato rispetto ai proxy leggeri e non gestisce il versionamento dei prompt in modo altrettanto pulito degli strumenti dedicati.
Funzionalità di monitoraggio di Phoenix
- Nucleo open-source con estensioni enterprise opzionali
- Ambiente interattivo per prompt per lo sviluppo
- Rilevamento del drift per tracciare i cambiamenti comportamentali nel tempo
- Controlli dei bias per identificare distorsioni nelle risposte,
- Scoring LLM-as-a-judge per accuratezza, tossicità e pertinenza.
Più adatto per: Team che monitorano il comportamento del modello a lungo termine e il rischio di regressione piuttosto che l'iterazione sui prompt.
Agenta
Casi d'uso: Individuare quale prompt funziona meglio su quale modello
Agenta confronta le risposte dei modelli in termini di costo, latenza e qualità dell'output utilizzando input condivisi e contesto controllato.
Funzionalità di monitoraggio di Agenta
- Valutazione fianco a fianco dei modelli
- Supporto decisionale in pre-produzione.
Più adatto per: Valutazione in fase iniziale e selezione del modello.
AgentOps.ai
Casi d'uso: Monitorare il ragionamento degli agenti, tracciare i costi e fare debug delle sessioni in produzione
AgentOps acquisisce tracce di ragionamento, chiamate a strumenti/API, stato della sessione, comportamento di caching e metriche di costo per gli agenti distribuiti.
Funzionalità di monitoraggio di AgentOps
- Riesecuzione della sessione per il debug in produzione
- Attenzione al comportamento degli agenti in tempo reale piuttosto che alla valutazione offline.
Più adatto per: Team che eseguono agenti in produzione e hanno bisogno di visibilità operativa.
Braintrust
Casi d'uso: Individuare quale prompt, dataset o modello offre prestazioni migliori con valutazione dettagliata e analisi degli errori
Braintrust valuta prompt, dataset e modelli rispetto agli output attesi, monitorando latenza, costi, errori degli strumenti e metriche di esecuzione.
Funzionalità di monitoraggio di Braintrust
- Valuta dataset di test con input e output attesi, quindi confronta prompt o modelli fianco a fianco utilizzando variabili come
{{input}},{{expected}}e{{metadata}}. - Suddivisioni delle metriche, inclusa la qualità di esecuzione degli strumenti
Più adatto per: Team che confrontano modelli e prompt tramite benchmark prima del rilascio.
AgentNeo
Casi d'uso: Debug delle interazioni multi-agente, tracciamento dell'uso degli strumenti e valutazione dei flussi di lavoro di coordinamento
AgentNeo traccia la comunicazione tra agenti, l'uso degli strumenti, i grafi di esecuzione e i costi e la latenza per singolo agente tramite un SDK Python.
Funzionalità di monitoraggio di AgentNeo
- Open-source ed eseguibile localmente
- Dashboard locale interattiva (
localhost:3000) per il monitoraggio in tempo reale dei flussi di lavoro multi-agente. - Integrazione tramite decoratori (ad es.
@tracer.trace_agent,@tracer.trace_tool)
Più adatto per: Team di ingegneri che sperimentano sistemi multi-agente.
 Aggiungi come fonte preferita
Laminar
Caso d'uso: Tracciare le prestazioni tra diversi framework e modelli LLM.
Laminar traccia gli span di esecuzione, i costi, l'utilizzo dei token e i percentili di latenza tra framework e modelli LLM.
Funzionalità di monitoraggio di Laminar
- Analisi delle prestazioni indipendente dal framework
- Ispezione granulare degli span.
Più adatto per: Analisi comparativa delle prestazioni tra stack eterogenei.
Helicone
Casi d'uso: Tracciare flussi di lavoro degli agenti multi-step e analizzare i modelli di sessione degli utenti.
Helicone acquisisce volumi di richieste, costi, errori, tendenze di latenza e flussi di lavoro degli agenti a livello di sessione.
Funzionalità di monitoraggio di Helicone
- Visibilità sul percorso dell'utente
- Analisi dei trend storici.
Più adatto per: Team di prodotto che monitorano modelli di utilizzo e comportamento a livello dei singoli utenti.
Coval
Casi d'uso: Simulare migliaia di conversazioni tra agenti, testare interazioni vocali/chat e validare il comportamento prima dell'implementazione.
Coval simula migliaia di conversazioni per misurare il completamento dei task, la correttezza e l'efficacia delle chiamate agli strumenti.
Funzionalità di monitoraggio di Coval
- Test degli agenti basato su simulazioni
- Rilevamento automatico delle regressioni
- Supporto per agenti vocali e testuali.
Più adatto per: Validazione pre-implementazione e rilevamento delle regressioni.
Datadog
Casi d'uso: Osservabilità di infrastruttura e applicazioni con correlazione dei segnali LLM.
Datadog raccoglie metriche di infrastruttura (CPU, memoria, rete), dati sulle prestazioni delle applicazioni (latenza, tassi di errore, throughput) e log. Per le applicazioni LLM, può acquisire utilizzo dei token, costo per richiesta, latenza del modello e segnali relativi alla sicurezza come i tentativi di prompt injection.
Datadog funzionalità di monitoraggio
- Osservabilità ampia e a livello di sistema su infrastruttura, applicazioni e carichi di lavoro IA
- Ampio ecosistema di integrazioni (900+ integrazioni) che consente di correlare il comportamento dell'IA con lo stato dell'infrastruttura
Più adatto per: Organizzazioni che desiderano correlare il comportamento dei LLM con l'infrastruttura sottostante e le prestazioni delle applicazioni, piuttosto che ispezionare il ragionamento degli agenti o i prompt
Prometheus
Casi d'uso: Monitorare le prestazioni di sistema, tracciare le metriche delle applicazioni e configurare avvisi per problemi di infrastruttura.
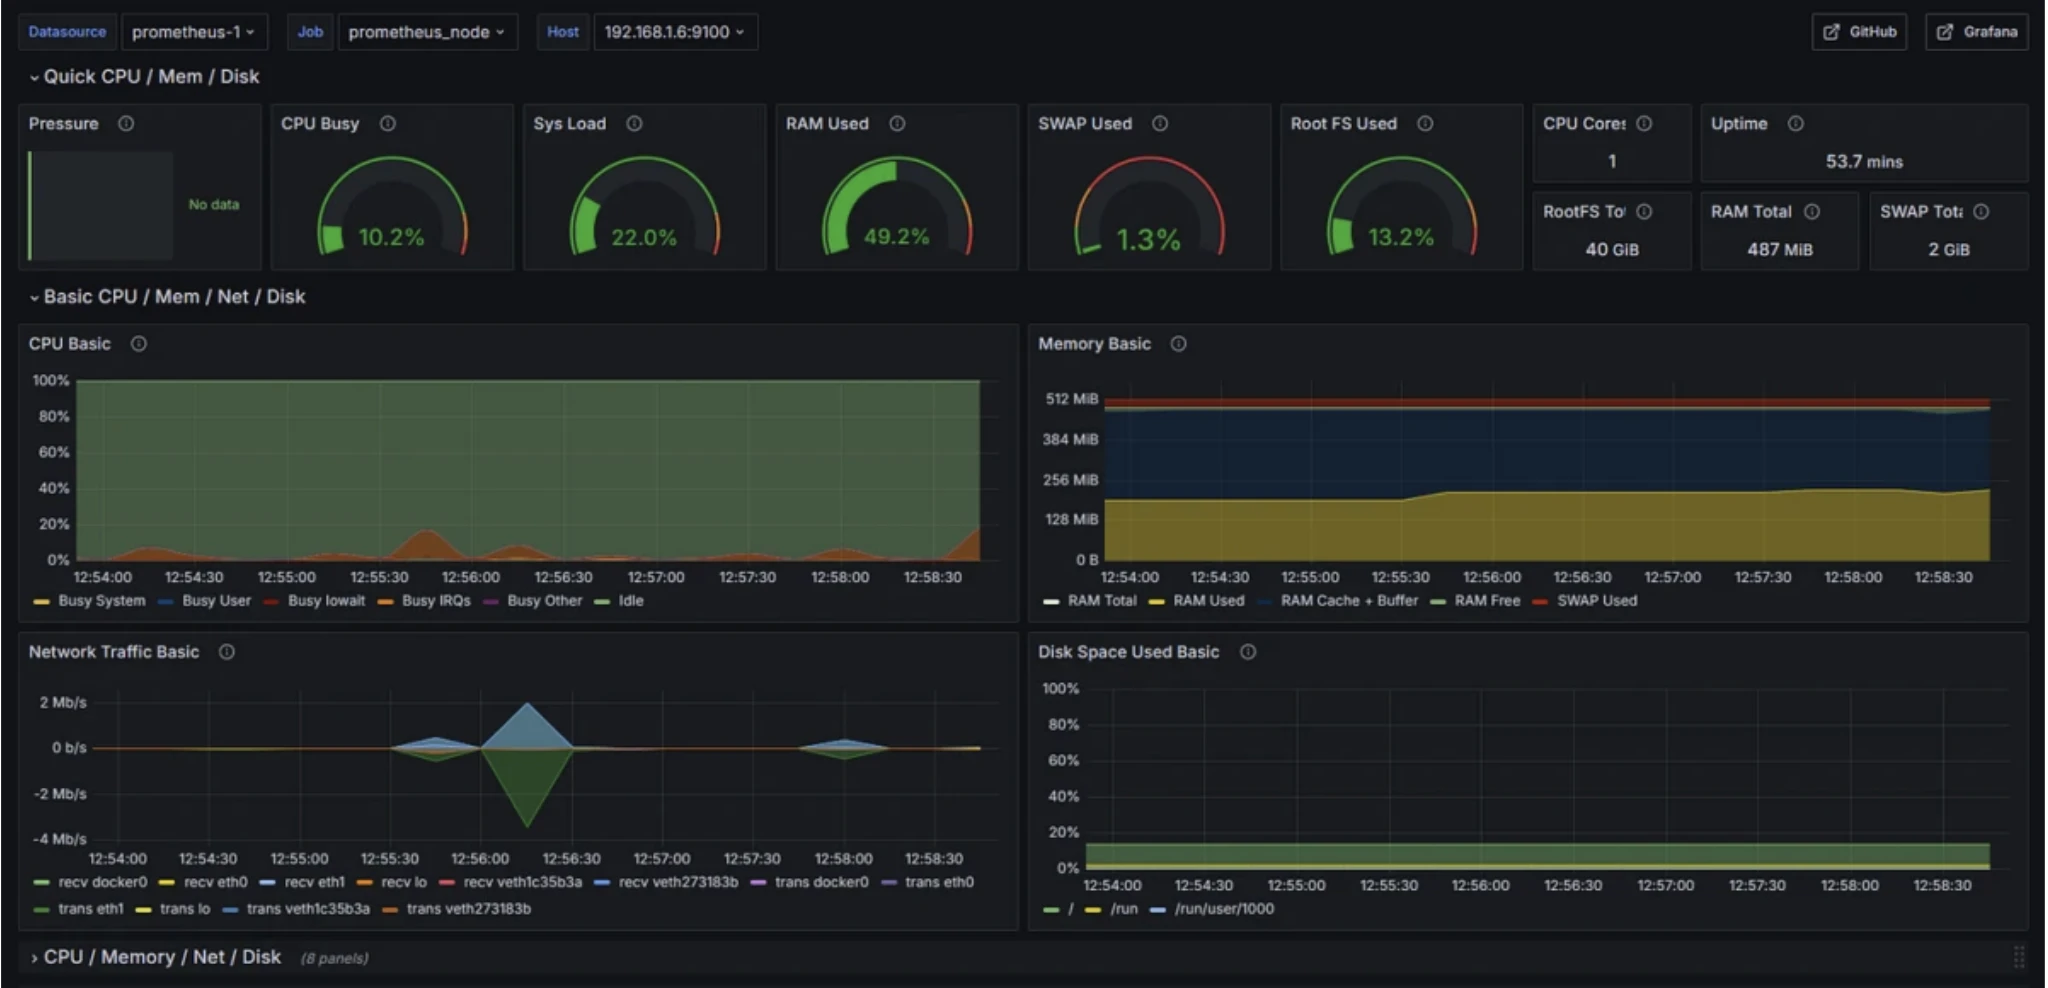
Prometheus è un sistema di monitoraggio open-source che raccoglie metriche time-series da endpoint HTTP a intervalli regolari per tracciare metriche di infrastruttura, applicazioni, database, container e metriche aziendali personalizzate.
Funzionalità di monitoraggio di Prometheus
- Raccolta di metriche time-series tramite scraping basato su pull
- PromQL per query, aggregazione e condizioni di avviso
- Ecosistema di exporter (ad es. Node Exporter) per un'ampia copertura di sistema
Più adatto per: Monitoraggio di infrastruttura e applicazioni con avvisi basati su regole.
Grafana
Casi d'uso: Visualizzare metriche, creare dashboard e instradare avvisi tra dati LLM, agenti e infrastruttura.
Grafana è una piattaforma open-source di visualizzazione e analisi che si integra con sorgenti dati come Prometheus, OpenTelemetry e Datadog per fornire dashboard di osservabilità unificate.
Funzionalità di monitoraggio di Grafana
- Dashboard per metriche, log e tracce
- Correlazione tra sistemi per segnali LLM, agenti e infrastruttura
- Instradamento degli avvisi e gestione delle notifiche.
Più adatto per: Visualizzazione centralizzata dell'osservabilità e risposta agli incidenti.
Tutorial: osservabilità di LangChain con Langfuse
Abbiamo creato una pipeline LangChain multi-step con tre fasi:
- analisi della domanda
- generazione della risposta
- verifica della risposta
Dopo aver configurato la pipeline, l'abbiamo collegata a Langfuse per monitorare e tracciare l'esecuzione in tempo reale. In questo modo, abbiamo potuto esplorare come Langfuse aiuti a raccogliere insight dettagliati su prestazioni, costi e comportamento delle applicazioni IA.
Ecco cosa abbiamo osservato tramite Langfuse:
Panoramica della dashboard
Langfuse ci ha fornito diverse dashboard che offrono visibilità su diversi aspetti delle prestazioni della pipeline:
- Dashboard dei costi: tiene traccia della spesa per tutte le chiamate API, con suddivisioni dettagliate per modello e periodo di tempo.
- Gestione dell'utilizzo: monitora le metriche di esecuzione, come il numero di osservazioni e l'allocazione delle risorse, aiutandoci a tracciare come le risorse vengono utilizzate durante l'esecuzione.
- Dashboard della latenza: questa dashboard ci ha aiutato ad analizzare i tempi di risposta, rilevare i colli di bottiglia e visualizzare i trend delle prestazioni.
Metriche di utilizzo
La dashboard delle metriche di utilizzo ci ha fornito i seguenti insight sulle prestazioni del sistema:
- Conteggio totale delle tracce: abbiamo tracciato otto tracce, ciascuna rappresentante un ciclo completo domanda-risposta nella pipeline.
- Conteggio totale delle osservazioni: In media, ogni traccia aveva 16 osservazioni, a riflettere la natura multi-step del processo.
Inoltre, Langfuse ci consente di monitorare modelli di utilizzo, allocazione delle risorse e orari di picco negli ultimi 7 giorni, aiutandoci a capire quando il sistema è più attivo e come le risorse sono distribuite nel tempo.
Ispezione delle tracce
Analizzando una singola traccia, abbiamo potuto vedere informazioni dettagliate sull'esecuzione:
- Righe di traccia: ogni riga rappresenta un'esecuzione completa della pipeline con un ID di traccia univoco.
- Metriche di latenza: il tempo di esecuzione variava da 0.00s a 34.08s.
- Conteggi di token: la dashboard ha monitorato l'utilizzo dei token di input/output, utile per la gestione di costi ed efficienza.
- Filtro per ambiente: abbiamo potuto filtrare le tracce in base agli ambienti di implementazione (ad es. sviluppo, produzione).
Dettagli delle singole tracce
Abbiamo ulteriormente esplorato la traccia in dettaglio per comprendere la suddivisione dell'esecuzione:
- Architettura di catena sequenziale: la traccia ha mostrato un flusso visivo di ogni passaggio, partendo da SequentialChain → LLMChain → ChatOpenAI, con struttura gerarchica.
- Monitoraggio di input/output: la domanda originale, “Quali sono i vantaggi dell'uso di Langfuse per l'osservabilità degli agenti IA?” è stata tracciata in ogni fase, insieme ai rispettivi output prodotti dall'IA in ogni passaggio.
- Analisi dei token: abbiamo osservato che sono stati utilizzati 1.203 token per l'input e 1.516 token per l'output, con implicazioni di costo legate all'utilizzo dei token e di supporto all'ottimizzazione della gestione delle risorse.
- Dati di temporizzazione: la latenza totale per l'intera traccia è stata di 34.08s, suddivisa tra i singoli componenti:
- SequentialChain → 14.02s
- LLMChain → 10.25s
- ChatOpenAI → 9.81s
- Informazioni sul modello: Langfuse ha confermato l'utilizzo del modello Anthropic Claude-Sonnet-4, con dettagli sulle impostazioni specifiche, inclusa la configurazione della temperatura.
- Output formattato: sono state fornite sia la visualizzazione Preview sia quella JSON per il debug, offrendo insight sulla risposta del modello in formato leggibile e in formato leggibile dalle macchine.
Analisi automatizzata
Langfuse ha inoltre fornito valutazioni automatizzate delle nostre risposte:
- Valutazione della qualità: il sistema ha valutato struttura, coerenza e completezza delle risposte, evidenziando sezioni ben organizzate ma suggerendo che le risposte avrebbero potuto essere più concise.
- Suggerimenti di miglioramento: ha identificato sezioni ridondanti, suggerendo dove la formulazione potrebbe essere migliorata, e ha combinato punti correlati per rendere la risposta più trasparente ed efficiente.
- Insight sulle prestazioni: il sistema ha fornito feedback sull'utilizzo dei token e sulla pertinenza della risposta, aiutandoci a ottimizzare l'efficienza garantendo al contempo che l'output rimanga utile e pertinente.
- Feedback strutturato: il feedback è stato organizzato in categorie, consentendoci di affrontare aree specifiche di miglioramento in modo mirato.
Analisi degli utenti
Langfuse traccia le interazioni dettagliate tra utenti e agente IA:
- Sequenza temporale delle attività utente: mostra la prima e l'ultima interazione di ogni utente, aiutando a identificare utenti attivi e inattivi. Possiamo vedere quando gli utenti hanno interagito con il sistema per la prima e l'ultima volta.
- Monitoraggio del volume di eventi: tiene traccia del numero di eventi attivati da ciascun utente. Ad esempio, alcuni utenti hanno generato oltre 2.000 eventi, a dimostrazione del loro livello di coinvolgimento con il sistema.
- Analisi del consumo di token: monitora il numero totale di token consumati da ciascun utente. L'utilizzo dei token variava da 6.59K a 357K token, fornendo insight sull'utilizzo delle risorse.
- Attribuzione dei costi: suddivide i costi associati a ciascun utente, rendendo più semplice tracciare la spesa e ottimizzare l'allocazione del budget per l'uso delle risorse.
- Identificazione dell'utente: utilizza ID utente anonimizzati per preservare la privacy tracciando al contempo le interazioni dei singoli utenti, supportando l'analisi dell'utilizzo senza compromettere la riservatezza.
La visualizzazione della sessione ci consente di monitorare dettagli granulari delle interazioni degli utenti:
- Flusso completo della conversazione: mostra l'intera interazione domanda-risposta, rendendo semplice seguire l'intera conversazione dall'inizio alla fine.
- Visibilità sull'implementazione: mostra il codice Python effettivo utilizzato durante la sessione, fornendo informazioni sull'implementazione tecnica.
- Correlazione input/output: collega le domande degli utenti alle corrispondenti risposte di sistema, aiutandoci a individuare e risolvere eventuali problemi nella conversazione.
- Metadati della sessione: include dettagli tecnici come tempi, contesto utente e dati di implementazione specifici, offrendo una visione completa dell'esecuzione della sessione.
Quando non usare gli strumenti di osservabilità
- Sviluppo in fase iniziale: se stai ancora validando l'adattamento prodotto-mercato o costruendo i primi flussi di lavoro degli agenti, l'attenzione dovrebbe concentrarsi sulle funzionalità principali piuttosto che su un'osservabilità estesa.
- Colli di bottiglia delle API: se i problemi principali sono costi, latenza o caching delle API, la priorità immediata dovrebbe essere l'ottimizzazione di queste aree, non il monitoraggio delle metriche a livello di sistema.
- Ottimizzazione del modello: se i miglioramenti sono guidati principalmente dalla selezione del modello, dal fine-tuning o dalla progettazione dei prompt, gli strumenti di osservabilità per drift e bias potrebbero non essere ancora necessari.
Quando usare gli strumenti di osservabilità
- Produzione su larga scala: quando operi con più modelli, agenti o catene, gli strumenti di osservabilità sono essenziali per monitorare le prestazioni e garantire lo stato di salute del sistema.
- Applicazioni enterprise o rivolte ai clienti: per applicazioni in cui affidabilità, sicurezza e conformità sono irrinunciabili, gli strumenti di osservabilità forniscono la visibilità e il controllo necessari.
- Monitoraggio continuo: quando è necessario monitorare nel tempo drift, bias, prestazioni e problemi di sicurezza, che non possono essere rilevati facilmente con script di base o controlli manuali, gli strumenti di osservabilità sono cruciali.
- Scenari ad alto rischio: in ambienti in cui il costo degli errori (ad es. allucinazioni, output non sicuri) è significativo, l'osservabilità garantisce che i rischi siano ridotti al minimo e che i problemi vengano rilevati precocemente.
Metodologia del benchmark
Per valutare l'overhead prestazionale delle piattaforme di osservabilità nelle applicazioni LLM in produzione, abbiamo sviluppato un approccio sistematico di benchmark utilizzando un flusso di lavoro agentico reale.
Applicazione di test
Abbiamo creato un sistema sequenziale multi-agente di pianificazione dei viaggi utilizzando LangChain che elabora richieste di viaggio in linguaggio naturale attraverso cinque fasi:
- Agente parser: estrae dati strutturati (origine, destinazione, date, durata) dall'input dell'utente
- Agente di ricerca voli: recupera i voli disponibili tramite le API Amadeus
- Agente bollettino meteo: recupera le previsioni meteo della destinazione utilizzando WeatherAPI
- Agente di raccomandazione attività: suggerisce attività in base alle condizioni meteo
- Agente di pianificazione del viaggio: sintetizza tutti gli output in un itinerario completo
Il sistema utilizza Claude 4 Haiku tramite OpenRouter per tutte le chiamate LLM e integra API esterne per dati in tempo reale.
Progettazione del benchmark
Definizione della baseline: abbiamo prima misurato le prestazioni dell'applicazione senza alcuna strumentazione di osservabilità, eseguendo 100 query identiche per stabilire una baseline di confronto.
Integrazione della piattaforma: abbiamo poi integrato cinque piattaforme di osservabilità leader (LangSmith, Laminar, AgentOps, Langfuse) una alla volta, strumentando gli stessi punti di tracciamento su tutte le piattaforme per coerenza.
Esecuzione sequenziale: ogni piattaforma è stata testata indipendentemente eseguendo tutte le 100 query consecutivamente prima di passare alla piattaforma successiva. Questo approccio riduce al minimo la variabilità dovuta a fattori esterni come condizioni di rete o limiti di velocità delle API.
Ambiente controllato: tutti i test sono stati eseguiti sulla stessa infrastruttura server con set di query identici per garantire un confronto equo. Per isolare l'overhead dalle variazioni di latenza indotte dai LLM, abbiamo configurato il modello con temperature=0 e prompt strutturati per ridurre al minimo la variabilità delle risposte tra le esecuzioni.
Metriche raccolte
Per ciascuna piattaforma, abbiamo misurato la latenza media e calcolato l'overhead come latenza aggiuntiva introdotta rispetto alla baseline: ((Platform Latency - Base Latency) / Base Latency) × 100
FAQ
L'osservabilità è la capacità di comprendere il funzionamento interno di un agente IA esaminando segnali esterni come log, metriche e tracce.
Per gli agenti IA, ciò implica monitorare azioni, utilizzo degli strumenti, interazioni con i modelli e risposte per individuare i problemi e migliorare le prestazioni.
L'osservabilità degli agenti è fondamentale per monitorare e migliorare le prestazioni dell'IA consentendo di:
Comprendere i compromessi: aiuta a misurare metriche chiave come accuratezza e costo, rendendo più semplice trovare un equilibrio tra prestazioni e utilizzo delle risorse.
Misurare la latenza: il monitoraggio della latenza in tempo reale offre insight sui tempi di risposta, aiutando a ottimizzare le prestazioni degli agenti.
Rilevare input dannosi: l'osservabilità aiuta a identificare linguaggio dannoso e prompt injection, consentendo interventi tempestivi per prevenire problemi.
Monitoraggio del feedback degli utenti: osservando le interazioni e il feedback degli utenti, l'osservabilità fornisce dati preziosi per il miglioramento continuo e il fine-tuning degli agenti.
I componenti chiave includono:
– Monitoraggio delle azioni: monitorare ogni passaggio compiuto dall'agente.
– Utilizzo degli strumenti: osservare gli strumenti e le risorse che l'agente utilizza.
– Misurazione della latenza: monitorare i tempi di risposta per ottimizzare le prestazioni.
– Valutazioni: valutare il comportamento dell'agente e le prestazioni del modello.
– Rilevamento di input dannosi: identificare prompt dannosi o attacchi.
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{15 Strumenti di osservabilità per agenti IA: AgentOps & Langfuse}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/agentic-monitoring}},
  note   = {AIMultiple. Consultato il 3 giugno 2026}
}Risultati e timestamp di 35 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 5 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
8 aggiornamentiAggiornata la sezione "Potenziali ragioni dietro le differenze di prestazioni" con nuove spiegazioni ed esempi.
Espansa la sezione 'Piattaforme di osservabilità degli agenti AI' con le possibili ragioni dietro le differenze di performance.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

Prossimo da leggere
IT agentico: gli agenti IA possono progettare un benchmark


Automazione MSP: NinjaOne, Acronis & ConnectWise

I 5 migliori guardrail IA: Xnode Cortx e Weights and Biases

















Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.