


Deep Research IA: Codex vs Claude vs Grok vs Exa

Uno strumento di deep research risponde a una domanda con un report scritto invece di una pagina di link. Abbiamo eseguito cinque modi per produrne uno sugli stessi 20 brief di ricerca aziendale e abbiamo valutato ogni report in base a regole scritte prima delle esecuzioni per trovare il miglior strumento per la deep research. Quattro dei cinque sono agenti di codifica, strumenti a riga di comando creati per il lavoro software che possono anche cercare e leggere il web; il quinto, Exa Agent, è progettato per la ricerca.
Risultati del benchmark DR-20
Ciascuno dei cinque strumenti ha prodotto un report per ciascuno dei 20 compiti, 100 report in totale, valutati in cieco rispetto a regole scritte prima delle esecuzioni. Per maggiori dettagli, consultare la metodologia.
L'unico prodotto di deep research progettato appositamente è arrivato sotto tre dei quattro agenti di codifica. Exa Agent ha ottenuto 0.584 e ciascuno di questi tre divari sopravvive alla correzione di Holm in tutti i dieci confronti a coppie. Su questi brief, Codex CLI, Claude Code e Grok CLI hanno tutti ottenuto un punteggio superiore al prodotto creato per questo compito.
Exa Agent e Gemini CLI non hanno mostrato differenze statisticamente significative nei punteggi dei requisiti.
Non abbiamo trovato differenze statisticamente significative tra Codex CLI e Claude Code su questi 20 compiti. Il divario è di 0.015 su una scala da 0 a 1, con un p non corretto di 0.67 e 0.96 dopo la correzione di Holm. In 10.000 campioni bootstrap, entrambi avevano un intervallo di rango al 95% compreso tra 1 e 2. Guidano su misure diverse: Codex CLI sui requisiti scritti di 0.015, Claude Code sulla riproduzione dei fatti di 1.2 punti percentuali.
Fatti esatti riprodotti
Claude Code ha riprodotto integralmente 202 dei 434 elementi fattuali richiesti, Codex CLI 198 ed Exa Agent 89. Nessuno strumento ha raggiunto la metà. Un elemento ha ricevuto credito solo quando il report includeva correttamente tutti i dettagli richiesti. Questo controllo ha coperto un elenco predefinito di fatti; non abbiamo verificato ogni affermazione nei report.
Costo e qualità della ricerca
Grok CLI ha ottenuto 0.699 a $1,91 per compito; i due leader costano da $13,38 a $18,35, da sette a dieci volte tanto. Grok è rimasto indietro rispetto a Claude Code di 0.076, con un p corretto secondo Holm di 0.006. Il suo divario di 0.091 rispetto a Codex CLI non era significativo dopo la correzione, a 0.072.
Anche i due strumenti più economici hanno ottenuto i punteggi più bassi. Gemini CLI è costato $0,58 a compito e ha ottenuto 0.565; Exa Agent è costato $1,00 e ha ottenuto 0.584, una differenza con un p corretto secondo Holm di 0.958.
Codex CLI, Claude Code e Grok CLI sono stati eseguiti qui su abbonamenti; i loro valori sono equivalenti ai listini API. Per i costi di quegli abbonamenti e delle relative tariffe API, consultare LLM prezzi. Exa è stato fatturato come utilizzo API e $20,00 è la sua spesa effettiva. I $0,58 a compito di Gemini coprono solo i token ed escludono il grounding della ricerca, il cui numero di query fatturabili non è stato registrato.
Tempo per compito e qualità della ricerca
I due leader sono anche i due più lenti. Il compito mediano di Codex CLI ha richiesto 42 minuti per un punteggio di 0.790 e i 36 minuti di Claude Code per 0.775, contro i 13 minuti di Grok CLI a 0.699. Il tempo di esecuzione non determina l'ordine degli altri. Gemini CLI ha impiegato 1.5 minuti in più rispetto a Exa Agent e ha ottenuto 0.019 in meno.
Lunghezza del report e lavoro svolto
Il controesempio più chiaro al fatto che più lungo sia meglio si trova in cima alla tabella. Nel report mediano, Claude Code spende 271 parole per requisito soddisfatto e Codex CLI 137, e i due ottengono punteggi entro 0.015 l'uno dall'altro. Exa Agent è il più economico con 91 parole per requisito, per un punteggio di 0.584.
L'ampiezza e la qualità delle fonti non vanno di pari passo. Il report mediano di Claude Code cita 28 siti web distinti contro i 16 di Codex CLI, mentre una quota maggiore di citazioni di Codex CLI punta a pagine ufficiali e primarie, 34,8% contro 25,8%. Gemini CLI cita con minore densità, a 4.2 link per 1.000 parole.
Alcuni link citati erano interrotti. Abbiamo contato gli URL che restituivano un errore 404 o 410 o avevano un formato non valido. I totali su 20 report per strumento erano:
- Gemini CLI: 63
- Claude Code: 26
- Grok CLI: 16
- Codex CLI: 14
- Exa Agent: 14
Sviluppi negli strumenti di deep research IA
La deep research ha raggiunto Gemini API
Google ha aggiunto Deep Research a Gemini API come agente che gli sviluppatori chiamano direttamente, accanto alla funzione già disponibile nell'app Gemini.1 Viene distribuita in due versioni: deep-research-preview-04-2026 per la velocità e deep-research-max-preview-04-2026 per l'esaustività.
Google la propone con tariffazione pay-as-you-go sui modelli e sugli strumenti sottostanti e stima un compito tipico tra $1 e $3 per la versione standard e tra $3 e $7 per Max. Un compito viene eseguito in background ed è limitato a 60 minuti, con la maggior parte che termina entro 20.
Exa ha indicizzato le pubblicazioni accademiche
Exa ha lanciato la ricerca semantica sugli articoli accademici il 23 luglio 2026, coprendo circa 350 milioni di pubblicazioni e 30 milioni di autori.2 La proposta è trovare un articolo da un ricordo vago invece che da un titolo esatto.
Exa riporta un recall del 86,4% nel suo benchmark di retrieval contro il 66,8% di Perplexity e il 28,0% di Google Scholar. Si tratta dei numeri dello stesso fornitore sul benchmark dello stesso fornitore, quindi considerateli come un'indicazione piuttosto che una classifica consolidata; lo stesso post riporta due latenze medie diverse, motivo per attendere una verifica indipendente.
Bright Data Deep Lookup risponde a una domanda diversa
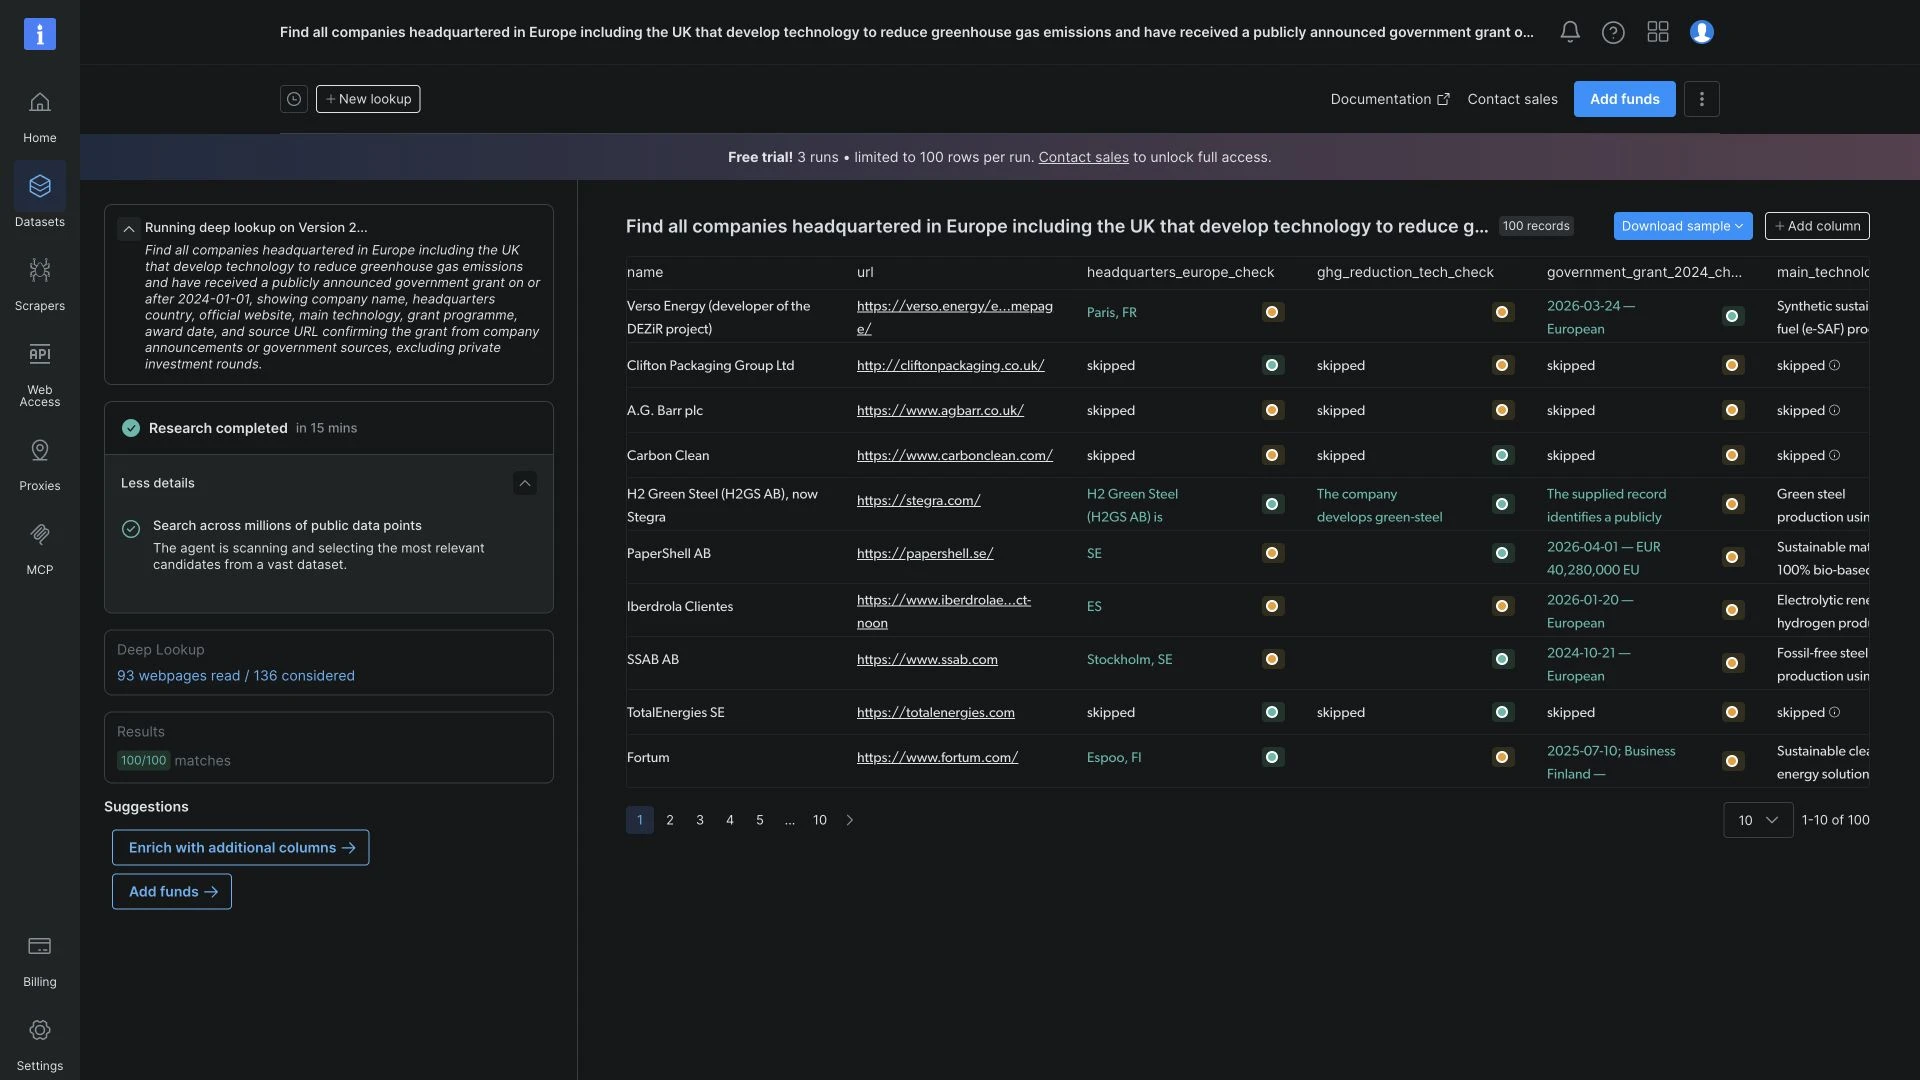
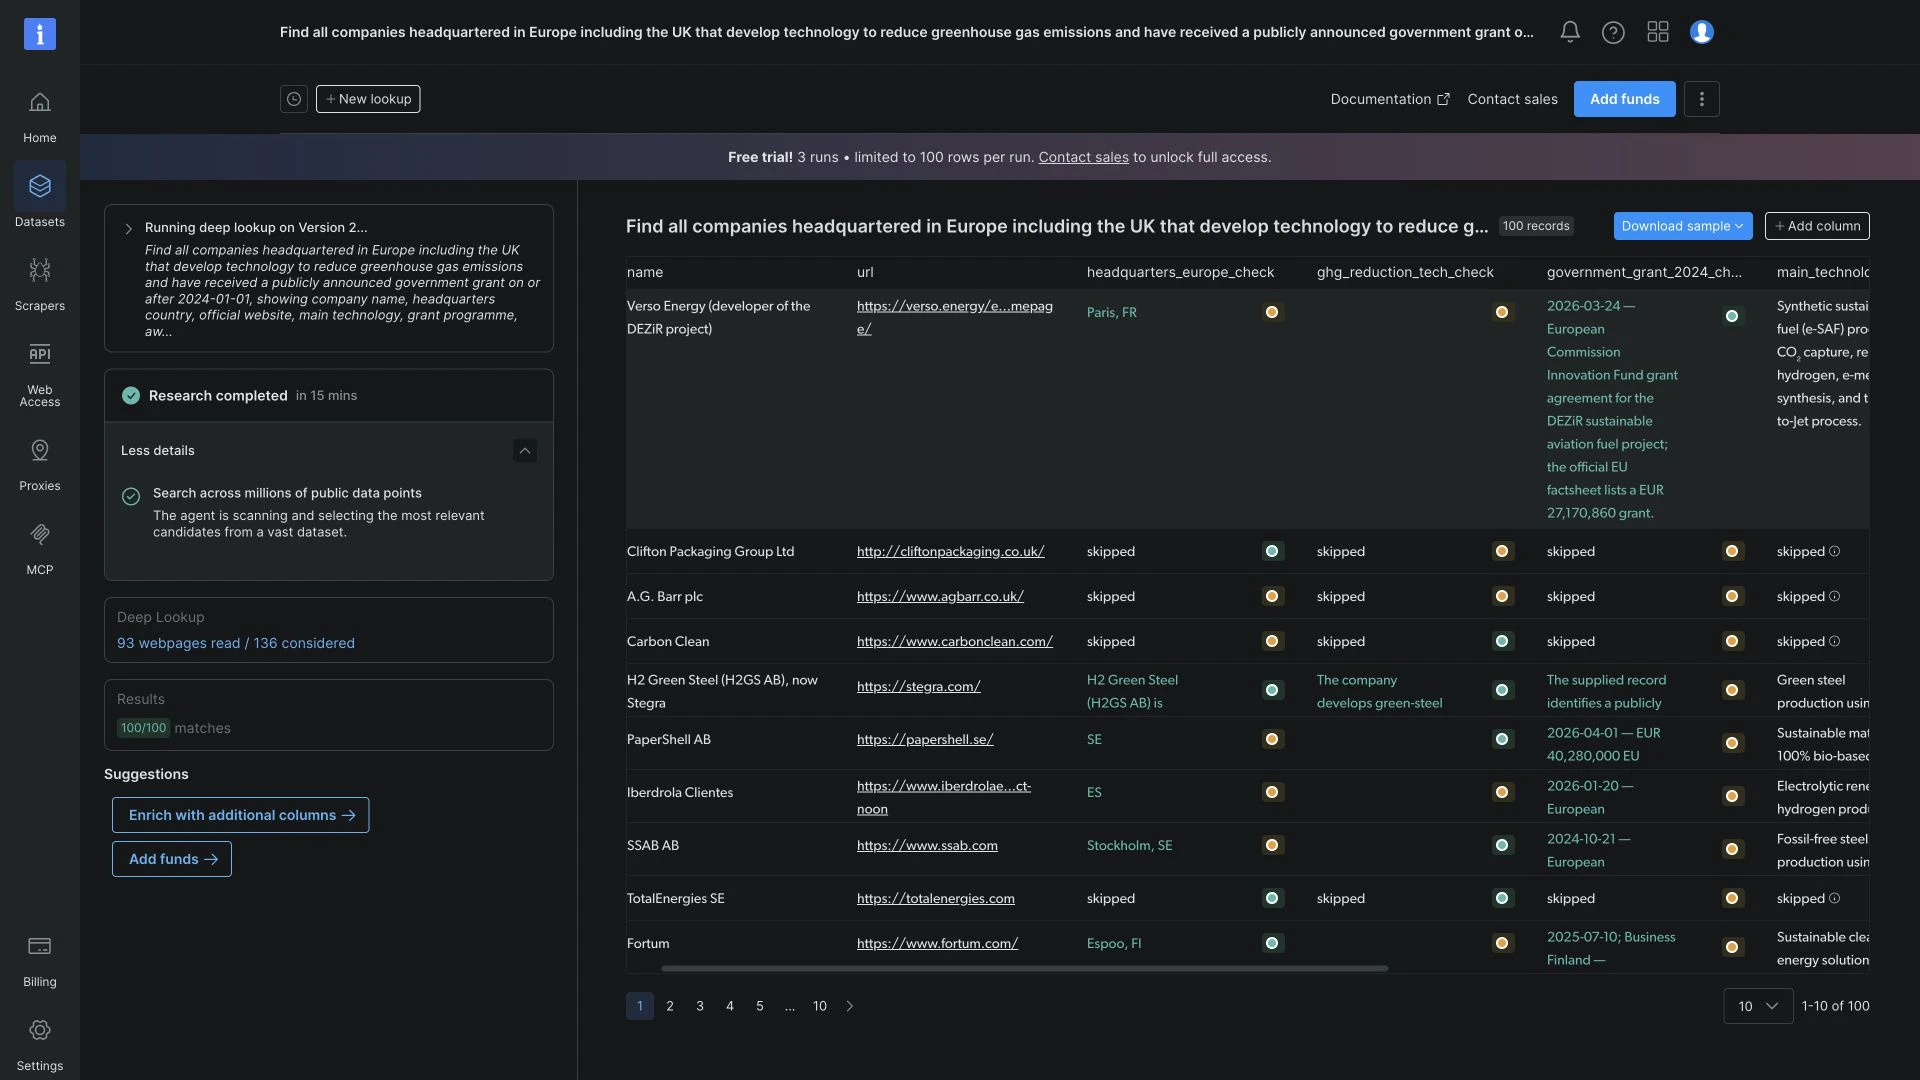
Deep Lookup di Bright Data restituisce righe di entità, non un report di ricerca scritto. Ogni riga rappresenta un'azienda, una persona o un prodotto. Gli utenti possono creare elenchi per la prospezione commerciale, la ricerca sugli investimenti o il reclutamento.3
Abbiamo cercato aziende europee che sviluppano tecnologie per ridurre le emissioni di gas serra. La query includeva il Regno Unito e richiedeva un finanziamento pubblico annunciato dal 1° gennaio 2024.
Deep Lookup ha creato una colonna separata per ogni condizione. Espandendo una riga si vedevano spiegazioni più lunghe, con indicatori di affidabilità colorati accanto ai singoli dettagli. L'interfaccia ha segnalato un'esecuzione da 15 minuti che ha raggiunto il limite di 100 record della prova.
Altre colonne contenevano descrizioni tecnologiche, programmi di finanziamento, date di assegnazione e link alle fonti. I link ci hanno permesso di verificare le affermazioni sui finanziamenti rispetto agli annunci. Il menu di download offriva i formati CSV e JSON.3
I team di vendita possono usare Deep Lookup per trovare aziende in un settore e in una regione target. Gli investitori possono identificare imprese che sviluppano una particolare tecnologia o che ricevono finanziamenti pubblici. I reclutatori possono cercare professionisti con ruoli ed esperienze pertinenti.3
Combinare diverse condizioni di ricerca con colonne di risultati personalizzate consente ai team di creare elenchi in base ai propri criteri e di confrontare i dettagli in un unico posto.
Azure presenta nel suo strumento Deep Research un avviso sui confini dei dati
Microsoft offre Deep Research in Azure AI Foundry Agent Service, raggiungibile dagli SDK Python, C# e JavaScript, e ora documentato tra gli strumenti classici per agenti.4
Il motivo per leggere quella pagina prima di adottarlo è nella pagina stessa: Microsoft dichiara che la query di ricerca Bing, i parametri dello strumento e la chiave della risorsa vengono trasferiti al di fuori del confine di conformità di Azure verso Grounding con Bing Search. I team che hanno scelto Azure proprio perché nulla lasci il confine dovrebbero verificare quali parti di un'esecuzione di ricerca lo attraversino.
Vantaggi degli strumenti di deep research IA
Un report di ricerca con fonti in pochi minuti
Nel nostro benchmark, i tempi mediani per compito variavano da 5.5 a 42 minuti, a seconda dello strumento. Ogni esecuzione ha prodotto un report di ricerca con link alle fonti. Non abbiamo misurato quanto tempo impiegherebbe una persona per completare gli stessi compiti.
I punteggi dei requisiti hanno raggiunto 0.790 al massimo tra i cinque strumenti e i 20 brief. I requisiti coprono l'intero report, dalle sezioni richieste ai calcoli nella tabella dei costi, quindi un punteggio di quel livello significa che la maggior parte del brief è stata soddisfatta nella forma richiesta.
Ampiezza in un unico passaggio
Un agente di ricerca può raccogliere materiale da più siti web per un confronto tra fornitori, una revisione delle modifiche a uno standard di settore o un'introduzione a un tema di ricerca sconosciuto. Il report risultante offre al lettore una panoramica iniziale e le fonti da approfondire.
Una bozza di ricerca modificabile
L'output è un documento, quindi può essere modificato, messo in discussione e rieseguito. È una modalità di lavoro diversa da una pagina di risultati di ricerca. Un documento dall'aspetto definitivo è anche il rischio: invita a controllare meno di un elenco di link.
 Aggiungi come fonte preferita
Sfide e limiti degli strumenti di deep research IA
I fatti sono il punto debole, non la struttura
Molti sanno che un LLM può inventare una risposta e controllano ciò che produce. Un report di deep research invita a fare meno di questi controlli, perché è lungo, documentato e ben organizzato, quindi si legge come già verificato.
Un report può soddisfare i requisiti relativi a sezioni, tabelle e calcoli pur omettendo o riportando in modo errato i fatti richiesti.
Prima di usare un report per prendere una decisione, verifica date, cifre e conclusioni normative pertinenti confrontandole con le fonti originali.
Le citazioni non significano che la fonte lo dica
Il nostro audit delle citazioni ha verificato se i link funzionavano e ha classificato le loro fonti. Non ha verificato se ogni pagina supportasse l'affermazione collegata. Anche un link funzionante verso una fonte ufficiale richiede questa verifica: la pagina può trattare l'argomento senza supportare la cifra o la conclusione specifica del report.
La lunghezza non è profondità
Claude Code registra un report mediano di 11.449 parole contro le 5.734 di Codex CLI, senza differenze statisticamente significative nei punteggi dei requisiti.
I lettori dovrebbero considerare quanto materiale dovranno esaminare insieme al tempo di esecuzione e al prezzo dello strumento.
Bias, privacy ed eccessivo affidamento
I dati di addestramento portano con sé i bias di ciò che è stato scritto e una fase di sintesi può consolidarli in qualcosa che suona come una conclusione. Con uno strumento ospitato, qualsiasi documento interno caricato come contesto esce dai tuoi sistemi, ed è bene verificarlo rispetto ai termini del fornitore prima che diventi routine. Il rischio più difficile da misurare è l'ultimo: un report curato che nessuno controlla erode l'abitudine al controllo.
Metodologia
Ambiente di test
Abbiamo eseguito i quattro strumenti CLI da un server cloud Linux e abbiamo utilizzato Exa Agent tramite la sua API. Ognuno ha usato i propri strumenti di ricerca.
Compiti e procedura di test
- Abbiamo scritto 20 brief su selezione dei fornitori, pianificazione della migrazione, modelli di costo e ricerca normativa. Ciascuno specificava una data limite per il report e aveva risposte di riferimento basate su fonti primarie.
- Ogni strumento ha ricevuto gli stessi prompt per i compiti. Abbiamo valutato un report per strumento per compito, per un totale di 100 report tra i cinque strumenti.
- Abbiamo fissato prompt, configurazioni dei modelli e regole di punteggio prima della produzione. Nessun compito è stato rieseguito per migliorare un punteggio basso.
Criteri di punteggio
- Requisiti: Ogni compito aveva da 42 a 74 controlli superato/non superato. Per esempio, una tabella dei costi poteva richiedere un prezzo unitario e la relativa fonte.
- Penalità: Difetti predefiniti riducevano il punteggio, come trattare una questione come risolta dopo averla definita irrisolta altrove nel report. Punteggio = max(0, (requisiti superati − penalità attivate) / requisiti totali). Il punteggio complessivo di ogni strumento è la media dei punteggi dei suoi 20 compiti. Abbiamo anche verificato una formula alternativa che sottrae 0.1 per ogni penalità dalla frazione di requisiti superati, con un punteggio minimo pari a zero. Questa è l'opzione Penalità alternativa del grafico. L'ordine dei cinque strumenti è rimasto invariato.
- Dettagli fattuali: Una checklist separata conteneva 434 fatti richiesti. Un elemento riceveva credito solo quando il report includeva correttamente ogni dettaglio richiesto entro la tolleranza indicata. Le risposte parziali non ricevevano credito. Questi controlli non contribuivano al punteggio dei requisiti. Le percentuali sui fatti danno lo stesso peso a ogni compito. I conteggi sommano i risultati di tutti i 434 elementi.
Giudici basati su modelli
- Abbiamo rimosso i metadati identificativi e i percorsi dei file locali prima della valutazione. Entrambi i giudici hanno ricevuto lo stesso report, le stesse regole per i compiti, gli stessi fatti di riferimento e lo stesso audit delle citazioni.
- GPT-5.6 Sol e Grok 4.6 hanno valutato ogni report in modo indipendente. Per ogni requisito e ogni penalità, ogni giudice ha registrato una motivazione legata al report prima di assegnare un verdetto superato/non superato. Hanno inoltre controllato ogni elemento fattuale.
- Claude Opus 5 ha risolto i disaccordi usando le stesse prove. Le decisioni su cui i primi due giudici erano d'accordo sono rimaste invariate. I due giudici iniziali hanno concordato sul 93,3% dei verdetti sulle regole e sull'89,1% delle decisioni sugli elementi fattuali.
Analisi statistica
Abbiamo usato test appaiati sui 20 compiti e applicato la correzione di Holm a tutti i dieci confronti a coppie tra strumenti. Abbiamo stimato gli intervalli di rango al 95% ricampionando i compiti 10.000 volte.
Limiti
- Un solo report per strumento per compito non misura quanto varino tra un'esecuzione e l'altra le risposte dello stesso strumento.
- Abbiamo verificato la disponibilità dei link e il tipo di fonte, ma non abbiamo verificato se ogni pagina citata supportasse l'affermazione collegata. I controlli che richiedevano tale verifica hanno ricevuto un verdetto negativo in tutti gli strumenti: i controlli positivi non hanno ricevuto credito e i controlli negativi non hanno attivato penalità.
- Abbiamo perfezionato otto compiti dopo un progetto pilota precedente. Manteniamo i brief non pubblicati per le valutazioni future.
FAQ
La ricerca basata sull'IA utilizza strumenti di IA per trovare, analizzare e riassumere informazioni. Uno strumento di deep research va oltre una risposta della chat: viene eseguito per minuti, apre molte fonti e produce un report con citazioni.
Ciò in cui è bravo, nelle nostre misurazioni, è la forma della risposta. Ciò in cui è debole sono i dettagli. Il più forte dei cinque strumenti testati ha riprodotto 202 dei 434 valori, date e nomi richiesti, e il più debole ne ha riprodotti 89.
Ecco perché un report di deep research deve essere controllato prima di pubblicare qualsiasi cosa. Il report può sembrare finito anche se i numeri sono sbagliati. Benchmark correlati: IA coding.
Gli strumenti di IA possono assistere in vari aspetti delle revisioni della letteratura, tra cui l'individuazione di articoli pertinenti, la sintesi dei risultati principali e l'organizzazione dei temi di ricerca. Questi strumenti possono elaborare rapidamente grandi volumi di letteratura accademica e aiutare i ricercatori a individuare lacune o pattern tra gli studi. Tuttavia, l'IA non può sostituire completamente il giudizio umano nella valutazione della qualità delle fonti, nella sintesi di argomentazioni complesse o nell'analisi critica. I ricercatori devono comunque rivedere, verificare e interpretare i contenuti generati dall'IA per garantire l'accuratezza e mantenere il rigore accademico nelle loro revisioni della letteratura.
Gli strumenti di IA possono assistere nell'analisi dei dati e nel lavoro statistico pulendo i dataset, eseguendo test statistici, creando visualizzazioni e individuando pattern in grandi dataset. Questi strumenti possono suggerire metodi statistici appropriati in base al tipo di dati e alle domande di ricerca. Tuttavia, i ricercatori devono comprendere il contesto dei propri dati e convalidare i risultati, perché l'IA può non cogliere sfumature specifiche del dominio o fare assunzioni inappropriate.
La maggior parte dei moderni strumenti di ricerca con IA utilizza interfacce in linguaggio naturale che non richiedono competenze di programmazione. Tuttavia, una cultura dei dati di base e la comprensione dei concetti fondamentali della ricerca aiutano gli utenti a formulare query migliori e a interpretare i risultati in modo più efficace. Le applicazioni avanzate possono trarre beneficio da conoscenze tecniche per analisi personalizzate o flussi di lavoro specializzati.
Aprite ogni fonte usata per un'affermazione importante e verificate che supporti le cifre, le date e le conclusioni del report. Confermate che la fonte si applichi al periodo di tempo e al contesto pertinenti. La checklist dei fatti del nostro benchmark copriva dettagli predefiniti, quindi i suoi punteggi non stabiliscono l'accuratezza di ogni affermazione di un report.
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{Deep Research IA: Codex vs Claude vs Grok vs Exa}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-deep-research}},
  note   = {AIMultiple. Consultato il 11 settembre 2026}
}Risultati e timestamp di 10 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 2 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
8 aggiornamentiSostituito il riepilogo Agenti contro Modelli di Ricerca Approfondita con il risultato che gli agenti eguagliano la loro accuratezza a costi inferiori.
Aggiunta una sezione benchmark Agenti vs modelli di ricerca approfondita che confronta sei strumenti su cinque attività.
Aggiunta una sezione sulla metodologia del benchmark che descrive i cinque compiti di ricerca, le fonti di riferimento, il punteggio e le interfacce degli strumenti.
Aggiunto il DR-2T (Deep Research 2 Task) Bench alla sezione di benchmark della ricerca approfondita AI.
Collegamenti di riferimento
Prossimo da leggere
LLM Leggi di scaling: analisi dei ricercatori di IA

Le migliori 15+ piattaforme di ricerca finanziaria con IA per investitori

Utenti sintetici spiegati: i 7 migliori strumenti di ricerca sugli utenti con IA



Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.