


Modelli di embedding: 25 modelli valutati in benchmark per il retrieval

Abbiamo sottoposto a benchmark 25 modelli di embedding su 200 domande di retrieval in ambito finanziario, contratti legali, supporto tecnico e letteratura medica. I quattro corpora contenevano in totale 341.040 brani di testo. Ogni query ha effettuato la ricerca nel proprio dominio.
Risultati del benchmark dei modelli di embedding
nDCG@10 misura quanto in alto appaiono i brani pertinenti registrati nei primi dieci risultati. I punteggi vanno da 0 a 1, con valori più alti che premiano un posizionamento migliore.
Recall@10 misura la quota dei brani pertinenti registrati per ogni domanda recuperati entro i primi dieci risultati, calcolata in media tra le domande. L'accuratezza delle risposte generate è rimasta fuori da questa valutazione.
Gli intervalli di confidenza (IC) al 95% stimano l'incertezza nel nDCG@10 medio dovuta al campionamento delle domande. Intervalli più ampi indicano stime meno precise.
Le domande sono state selezionate perché BM25 non trovava i brani con le risposte nei suoi primi dieci risultati. Il suo punteggio pari a zero riflette tale selezione e limita i confronti con il recupero tramite keyword sul traffico ordinario.
Risultati del retrieval tra i 25 modelli
Voyage 4 Large ha registrato il nDCG@10 più alto, pari a 0.851
Il suo IC al 95% era 0.817–0.884. I test appaiati non hanno rilevato differenze significative rispetto a Cohere Embed 5 Pro, Cohere Embed 5 Fast, Gemini Embedding 2, Voyage 4 o Gemini Embedding 001 dopo la correzione per confronti multipli. La classifica rimane incerta. Un risultato non significativo non dimostra prestazioni equivalenti.
Cohere Embed 5 Pro e Fast hanno ottenuto punteggi significativamente superiori a Embed v4.0
Pro ha ottenuto 0.850 e Fast ha ottenuto 0.839, rispetto a 0.772 per Cohere Embed v4.0. I loro miglioramenti di 0.078 e 0.067 nel nDCG@10 sono risultati significativi dopo la correzione su tutte le 300 coppie di modelli. La differenza di 0.010 tra Pro e Fast non era significativa.
Gemini Embedding 2 ha registrato il Recall@10 più alto, pari a 96,50%
Cohere Embed 5 Pro seguiva a 95,88% e Voyage 4 a 95,83%. Nessuna differenza rispetto a Gemini Embedding 2 era significativa dopo la correzione. Spostare un brano pertinente dal quinto al primo posto migliora il nDCG senza modificare il recall.
PPLX Embed v1 4B ha guidato i modelli open-weight con 0.741 di nDCG@10
PPLX Embed v1 0.6B seguiva a 0.698. Il modello 4B ha ottenuto punteggi significativamente superiori a nove degli altri dieci modelli open-weight. Il suo distacco rispetto a 0.6B non era significativo. Il confronto di modelli di embedding open-source copre questo sottoinsieme.
Risultati per dominio: finanza, contratti, supporto e medicina
I sei punteggi nDCG@10 più alti in ciascun dominio. Ogni filtro riclassifica i modelli completati sulle 50 domande di quel dominio.
Ogni dominio contribuisce in egual misura alla media complessiva. Cohere Embed 5 Fast ha registrato il punteggio CUAD più alto, pari a 0.762, e Pro ha registrato il punteggio TechQA più alto, pari a 0.894. MedRAG ha prodotto il nDCG@10 più alto per ogni modello. Con 50 domande per dominio, piccole differenze in questi punteggi restano incerte.
Costi di embedding e qualità del retrieval
Abbiamo calcolato il costo API per l'embedding degli stessi 341.040 brani e delle 200 query per ciascun modello.
PPLX Embed v1 0.6B ha avuto il costo di embedding più basso, pari a $0,13, e ha ottenuto un nDCG@10 di 0.698. Voyage 4 Lite è costato $0,62 e ha ottenuto 0.793. A $1,87, Voyage 4 ha raggiunto 0.829.
Cohere Embed 5 Fast è costato $2,52 e ha ottenuto 0.839, mentre Pro è costato $3,40 e ha ottenuto 0.850. Il costo di embedding di Fast era inferiore del 26% su questo carico di lavoro. La differenza nei loro punteggi di retrieval non era statisticamente significativa dopo la correzione per confronti multipli.
Voyage 4 Large è costato $3,74 e ha registrato il punteggio più alto, pari a 0.851. Gemini Embedding 2 ha avuto il costo più alto, pari a $6,68, e ha ottenuto 0.830. Spendere di più per gli embedding non ha prodotto in modo costante un punteggio di retrieval più alto in questo test.
I costi coprono le chiamate di embedding riuscite utilizzate nella valutazione. I totali di Cohere usano i token di input segnalati moltiplicati per la tariffa registrata. Il costo di $3,72 di Embed v4.0 è una stima perché la sua tariffa API diretta non è stata verificata. Sono esclusi tentativi, diagnostica, commissioni dell'account, storage e calcolo per la ricerca. Questi importi descrivono il carico di lavoro testato e le route API. I costi di produzione dipenderanno dal volume di testo, dalla tokenizzazione e dai prezzi del provider.
Come gli embedding testuali supportano il retrieval
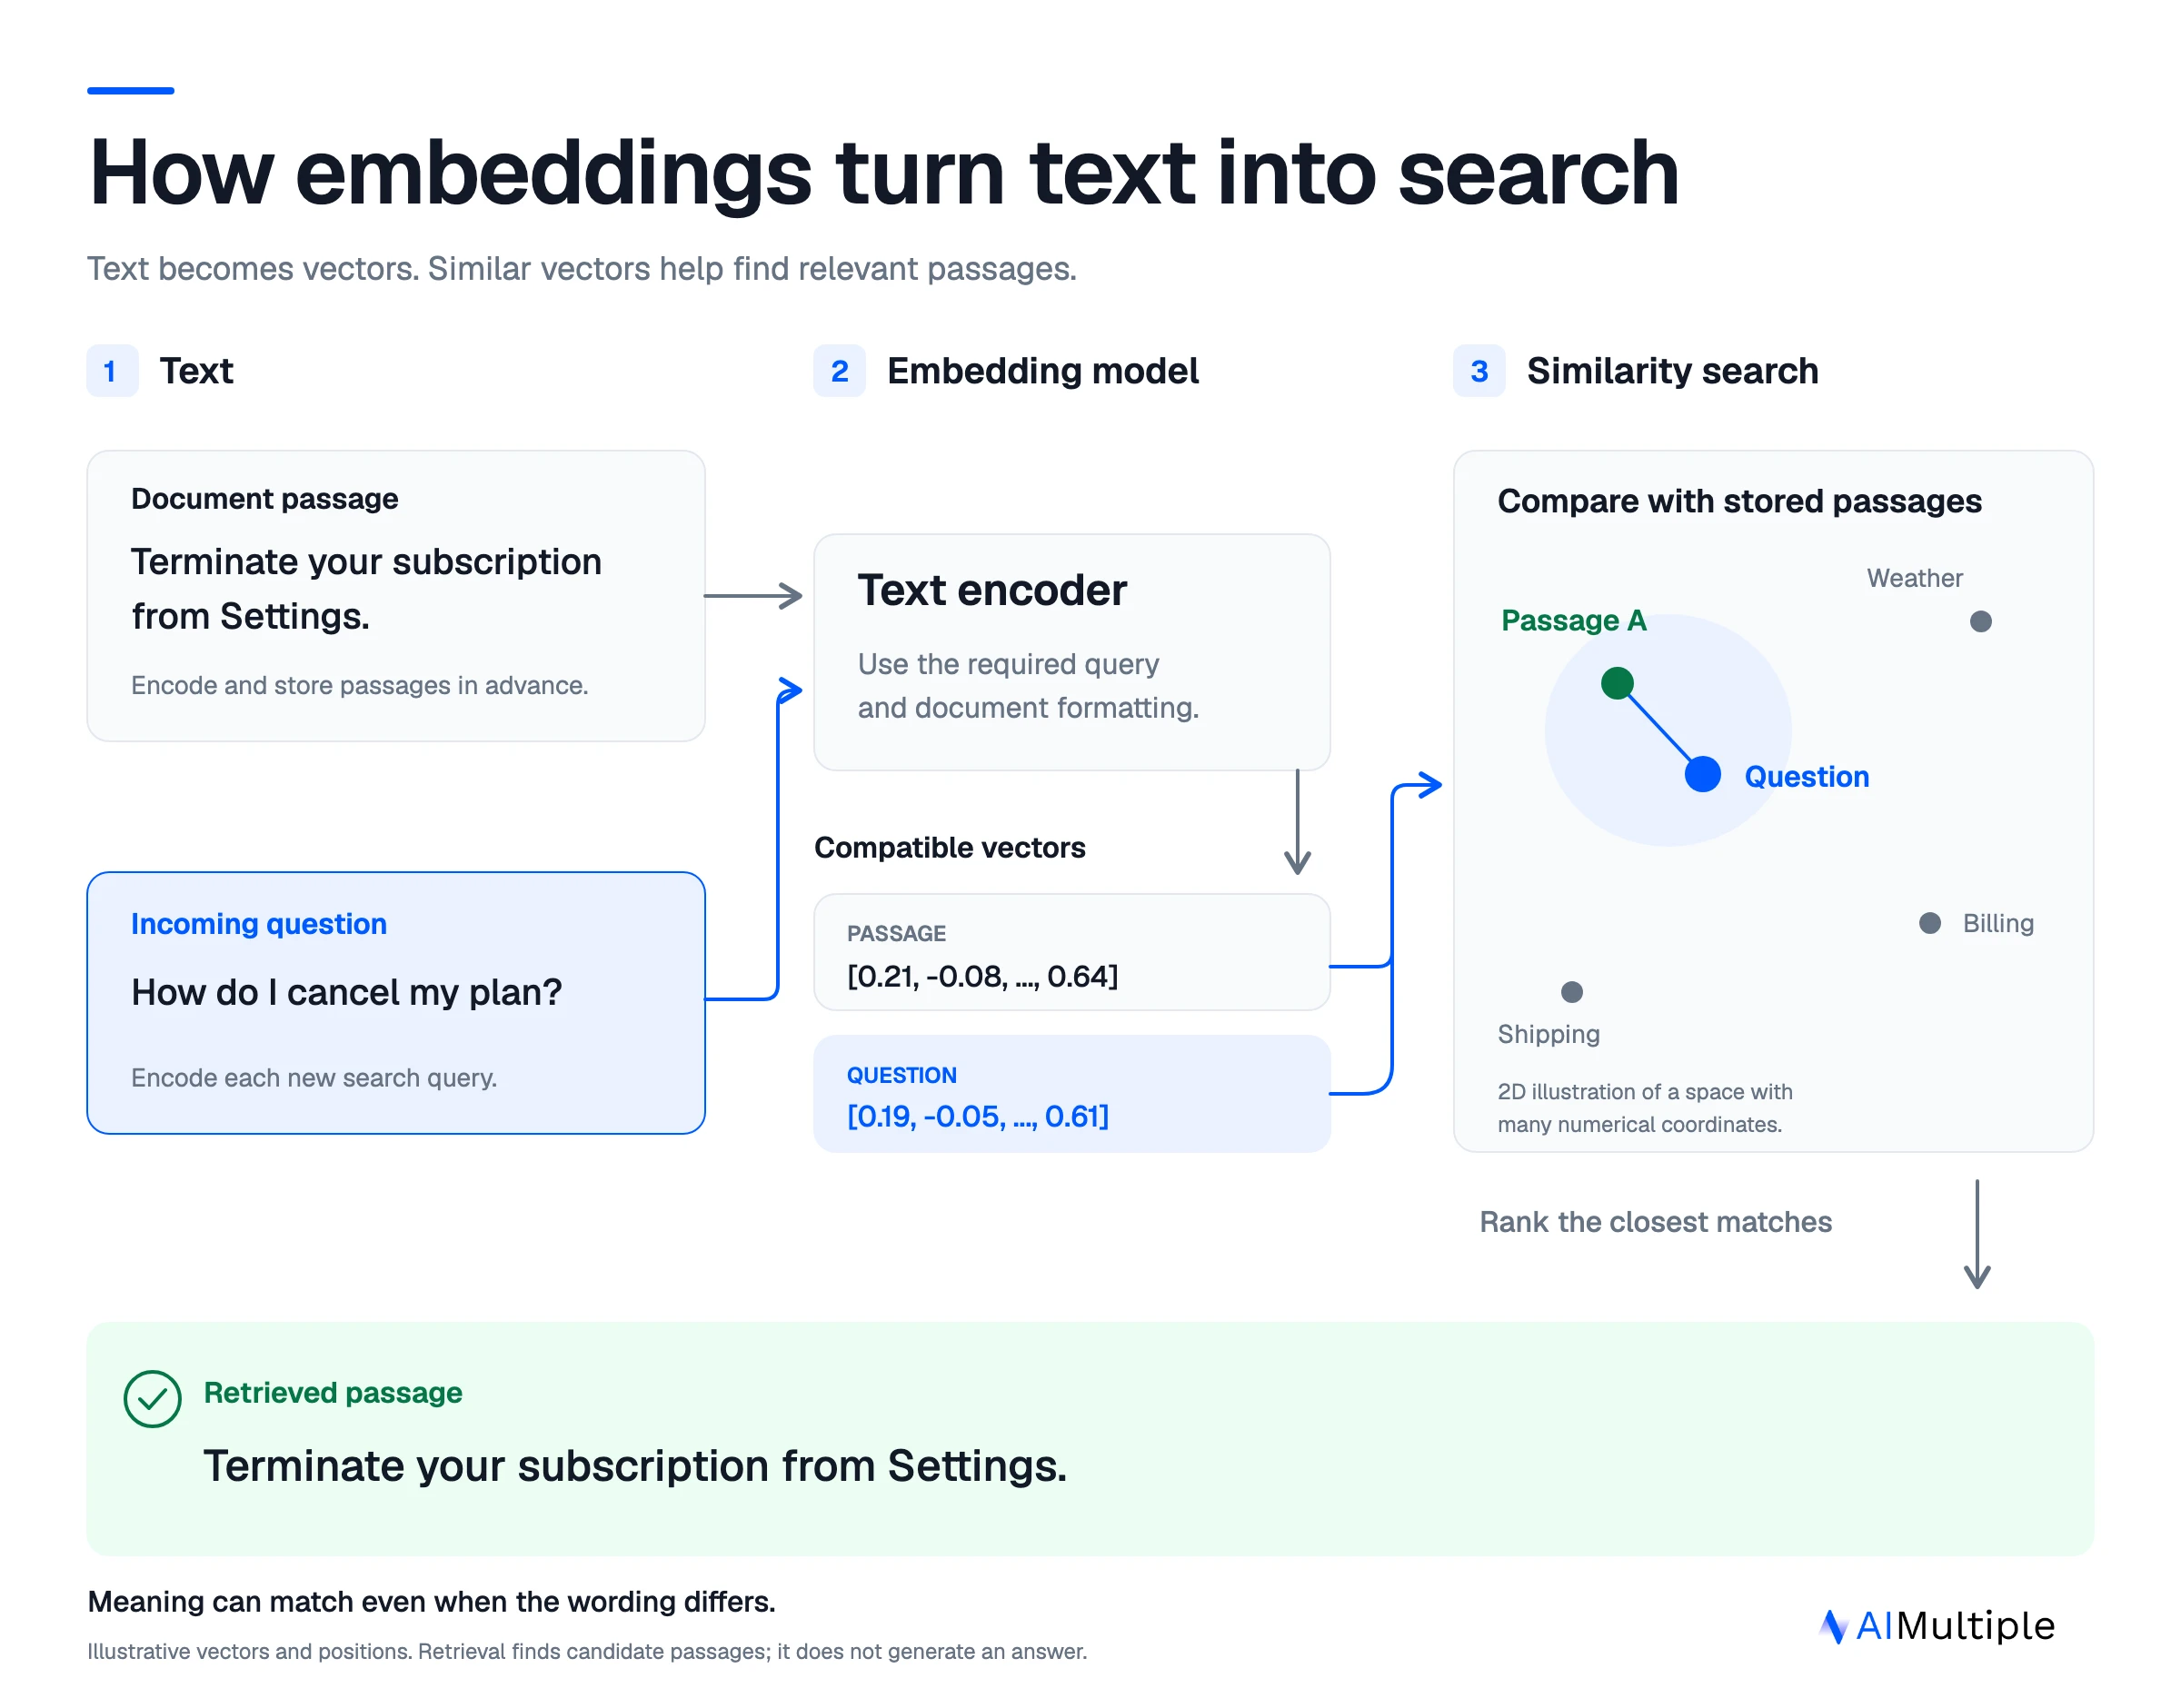
Un modello di embedding converte il testo in un vettore, un elenco di valori numerici che può essere confrontato con altri vettori di un modello compatibile. Nel retrieval semantico, i brani dei documenti vengono codificati in anticipo. Al momento della ricerca, il sistema codifica la query e classifica i brani memorizzati in base alla similarità vettoriale.1
Per esempio, una domanda sulla cancellazione di un piano può essere vicina a un brano sulla disdetta di un abbonamento nonostante una formulazione diversa. L'addestramento del modello determina quali relazioni vengono preservate dai vettori.2 Il diagramma comprime questa idea in due dimensioni. Gli embedding in produzione contengono generalmente molte più coordinate.
Anche la formattazione di query e documenti è importante. Un modello può richiedere ruoli o prefissi di retrieval separati anche quando entrambi gli output occupano uno spazio vettoriale compatibile. Abbiamo applicato la formattazione di query e documenti richiesta da ciascun modello.
Un database vettoriale memorizza e ricerca i vettori, mentre il modello di embedding determina le rappresentazioni oggetto della ricerca. I brani recuperati possono poi diventare contesto per un generatore di risposte. Questo benchmark si ferma al recupero dei brani e non valuta le risposte generate.
Metodologia del benchmark dei modelli di embedding
Tutti i modelli hanno cercato gli stessi brani utilizzando le stesse 200 domande e 225 coppie domanda-brano pertinenti registrate. Le domande e le etichette sono state congelate prima di confrontare i punteggi di embedding. Gli input delle query contenevano solo la domanda originale.
I brani finanziari provengono dai report annuali di FinQA e i brani legali dai contratti CUAD v1.34 Il supporto tecnico ha utilizzato le note tecniche di TechQA e la letteratura medica ha utilizzato un campione di abstract di PubMed di MedRAG.56
I brani erano paragrafi interi, tabelle con contesto, clausole contrattuali o abstract con titoli. Abbiamo escluso le unità più lunghe di 256 token secondo il tokenizer all-MiniLM-L6-v2. I brani accettati sono stati mantenuti intatti e i modelli con 512 token hanno ricevuto al massimo 459 token per brano. Questo benchmark valuta quindi brani brevi.
Un gruppo di LLMs di frontiera ha redatto le domande a partire dai brani sorgente. Un membro del team ha verificato il 20% delle domande (40 su 200). Gli LLMs hanno inoltre giudicato i primi 20 brani di BM25 per ogni domanda, aggiungendo 25 brani pertinenti ai 200 brani sorgente originali.
Analisi statistica e del retrieval
Il retrieval ha confrontato ogni query con tutti i brani del suo dominio. Abbiamo utilizzato la similarità coseno per 21 modelli e il prodotto scalare per MultiQA MPNet Base Dot v1. BGE-M3 ha utilizzato i suoi vettori densi.7 Gli input di query e documenti hanno utilizzato i ruoli o prefissi di retrieval configurati per ciascun modello.
Entrambe le metriche sono medie tra le domande. Abbiamo calcolato gli IC al 95% con 10.000 campioni bootstrap, ricampionando 50 domande all'interno di ciascun dominio. I confronti a coppie hanno utilizzato test dei segni appaiati con correzione di Holm su tutte le 231 coppie di modelli per ogni metrica e ambito. Abbiamo considerato significative le differenze con un valore p corretto inferiore a 0.05.
ID dei modelli testati, dimensioni e limiti di input
I 22 modelli originali sono stati eseguiti tramite OpenRouter, con un provider backend fisso per modello e fallback disabilitati. I tre modelli Cohere sono stati eseguiti tramite l'API Cohere utilizzando i ruoli nativi per documenti e query (search_document e search_query). La tabella registra gli identificatori API, le dimensioni di output e i limiti di input utilizzati, inclusi i limiti conservativi.
Gli identificatori API non garantiscono uno snapshot immutabile del modello. Le revisioni del tokenizer sono state bloccate dove disponibili. I pesi dei modelli ospitati non sono stati verificati in modo indipendente. Le lunghezze di input di Gemini e Cohere sono state controllate utilizzando stime conservative. I brani brevi non hanno testato il retrieval su contesti lunghi.
 Aggiungi come fonte preferita
Ambito e limitazioni
Le domande costituiscono un set di sviluppo selezionato tramite BM25. I risultati su query di produzione ordinarie potrebbero differire. I giudizi di pertinenza sono stati limitati ai brani sorgente e ai primi 20 di BM25. In tutti i 25 modelli, l'87% delle coppie domanda-brano distinte recuperate nella top ten non è stato giudicato e non ha ricevuto credito di pertinenza.
Ogni modello è stato eseguito una sola volta. Gli IC riflettono il campionamento delle domande ed escludono la variazione tra esecuzioni API o l'incertezza dovuta a etichette incomplete. La contaminazione dei dati di addestramento non è stata testata.
Questa valutazione riguarda il recupero di testo. L'accuratezza delle risposte generate, il recupero ibrido, il reranking, la latenza e i costi di serving erano al di fuori del suo ambito. Il benchmark dei reranker, il confronto di embedding multilingue e il confronto di embedding multimodali coprono carichi di lavoro separati.
Conclusione
Voyage 4 Large ha registrato il nDCG@10 più alto, senza un divario significativo rispetto a Cohere Embed 5 Pro o Fast. Entrambi i modelli Cohere hanno ottenuto punteggi significativamente superiori a Embed v4.0. Gemini Embedding 2 ha guidato il recall e PPLX Embed v1 4B ha guidato il gruppo open-weight.
Utilizzate i risultati per dominio per scegliere i candidati, quindi confrontateli su query rappresentative con etichette di pertinenza verificate. Misurate separatamente latenza e costo di serving end-to-end.
Ulteriori letture
- Benchmark di modelli di embedding open-source
- Modelli di embedding multilingue per RAG
- Modelli di embedding multimodali
- Benchmark di database vettoriali open-source
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Modelli di embedding: 25 modelli valutati in benchmark per il retrieval}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/embedding-models}},
  note   = {AIMultiple. Consultato il 1 ottobre 2026}
}Risultati e timestamp di 132 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 5 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
5 aggiornamentiAggiunta la definizione della metrica Top-1 hit alla metodologia del benchmark di embedding.
Sostituito il benchmark con 15 modelli e una baseline BM25 testati su corpora legali, di assistenza clienti e sanitari.
Collegamenti di riferimento





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.