


Open Source Embedding Models: 11 Models sottoposti a benchmark per il retrieval
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support and medical questions each searched their own domain's corpus.

nDCG@10 misura la posizione dei passaggi pertinenti registrati tra i primi dieci risultati di ricerca. Un punteggio pari a 1 rappresenta il ranking ideale per i positivi registrati. I passaggi più vicini alla cima ricevono più peso.
PPLX Embed v1 4B ha guidato il confronto con 0.741 nDCG@10, seguito da PPLX Embed v1 0.6B con 0.698. Multilingual E5 Large si è classificato terzo con 0.628. Il piccolo divario tra BGE Large e E5 Large è nascosto dall'arrotondamento a tre decimali. I loro punteggi non arrotondati determinano l'ordine.
Model | nDCG@10 | 95% IC | Recall@10 |
|---|---|---|---|
PPLX Embed v1 4B | 0.741 | 0.700–0.782 | 90,46% |
PPLX Embed v1 0.6B | 0.698 | 0.651–0.744 | 86,71% |
Multilingual E5 Large | 0.628 | 0.578–0.680 | 79,38% |
BGE Large EN v1.5 | 0.624 | 0.572–0.676 | 78,21% |
E5 Large v2 | 0.624 | 0.572–0.675 | 78,88% |
BGE-M3 (dense) | 0.614 | 0.562–0.666 | 79,50% |
GTE Large | 0.612 | 0.563–0.660 | 77,71% |
All-MPNet Base v2 | 0.608 | 0.556–0.661 | 77,33% |
GTE Base | 0.596 | 0.547–0.645 | 76,21% |
E5 Base v2 | 0.586 | 0.534–0.640 | 75,21% |
Recall@10 è la frazione media, per ciascuna domanda, dei passaggi pertinenti registrati trovati nei primi dieci risultati. Misura la copertura dei passaggi e non valuta se una risposta generata sia corretta.
Gli intervalli di confidenza al 95% (IC) stimano l'incertezza nella media di nDCG@10 dovuta al campionamento delle domande. Intervalli più ampi indicano stime meno precise.
Le domande sono state selezionate per mettere alla prova BM25, che ha ottenuto zero su questo set. Riportiamo quella baseline insieme alla procedura di selezione. Le prestazioni sul traffico di ricerca ordinario restano non testate. L'inference è stata eseguita tramite endpoint ospitati.
Risultati di retrieval all'interno dei model open-weight
PPLX Embed v1 4B ha registrato il punteggio nDCG@10 più alto con 0.741
PPLX Embed v1 0.6B segue con 0.698. Il model 4B ha ottenuto un punteggio significativamente superiore a nove degli altri dieci model open-weight dopo la correzione per confronti multipli. Il suo divario rispetto a 0.6B non era significativo. I loro punteggi Recall@10 erano 90,46% e 86,71%, anch'essi senza una differenza significativa. Questi test non stabiliscono prestazioni uguali.
BGE Large ha registrato il punteggio finance più alto con 0.604
PPLX 4B ha ottenuto 0.596 sulle stesse 50 domande finance. Tale differenza non era significativa dopo la correzione. BGE Large si è classificato quarto in assoluto, mostrando come l'ordine osservato cambi tra i domini.
GTE Large ha recuperato ogni positivo MedRAG registrato entro i primi dieci risultati
GTE Large ha raggiunto 100% Recall@10 nelle 50 domande mediche. Il suo nDCG@10 era 0.894, rispetto a 0.954 di PPLX 4B. Recuperare i positivi registrati e classificarli per primi sono risultati distinti. Questi punteggi riguardano il recupero dei passaggi e non misurano l'accuratezza delle risposte mediche.
Confronti per dominio per gli undici model
nDCG@10 a livello di dominio. Le viste Finance, CUAD, TechQA e MedRAG conservano tutti gli undici model e li ordinano in base al punteggio del dominio selezionato.
BGE-M3 ha raggiunto 0.616 su CUAD e 0.743 su MedRAG. Queste cifre descrivono la configurazione a vettori densi utilizzata qui. BGE-M3 supporta anche il retrieval sparse e multi-vettore. Tali modalità e le combinazioni ibride erano al di fuori di questo esperimento.1
Tutti e quattro i domini hanno lo stesso peso nel risultato complessivo. Una forte prestazione di un model su MedRAG può compensare un retrieval finance più debole in quella media, anche se i casi d'uso finanziari e medici richiedono evidenze diverse.
Rappresentazioni di embedding e scelte di implementazione
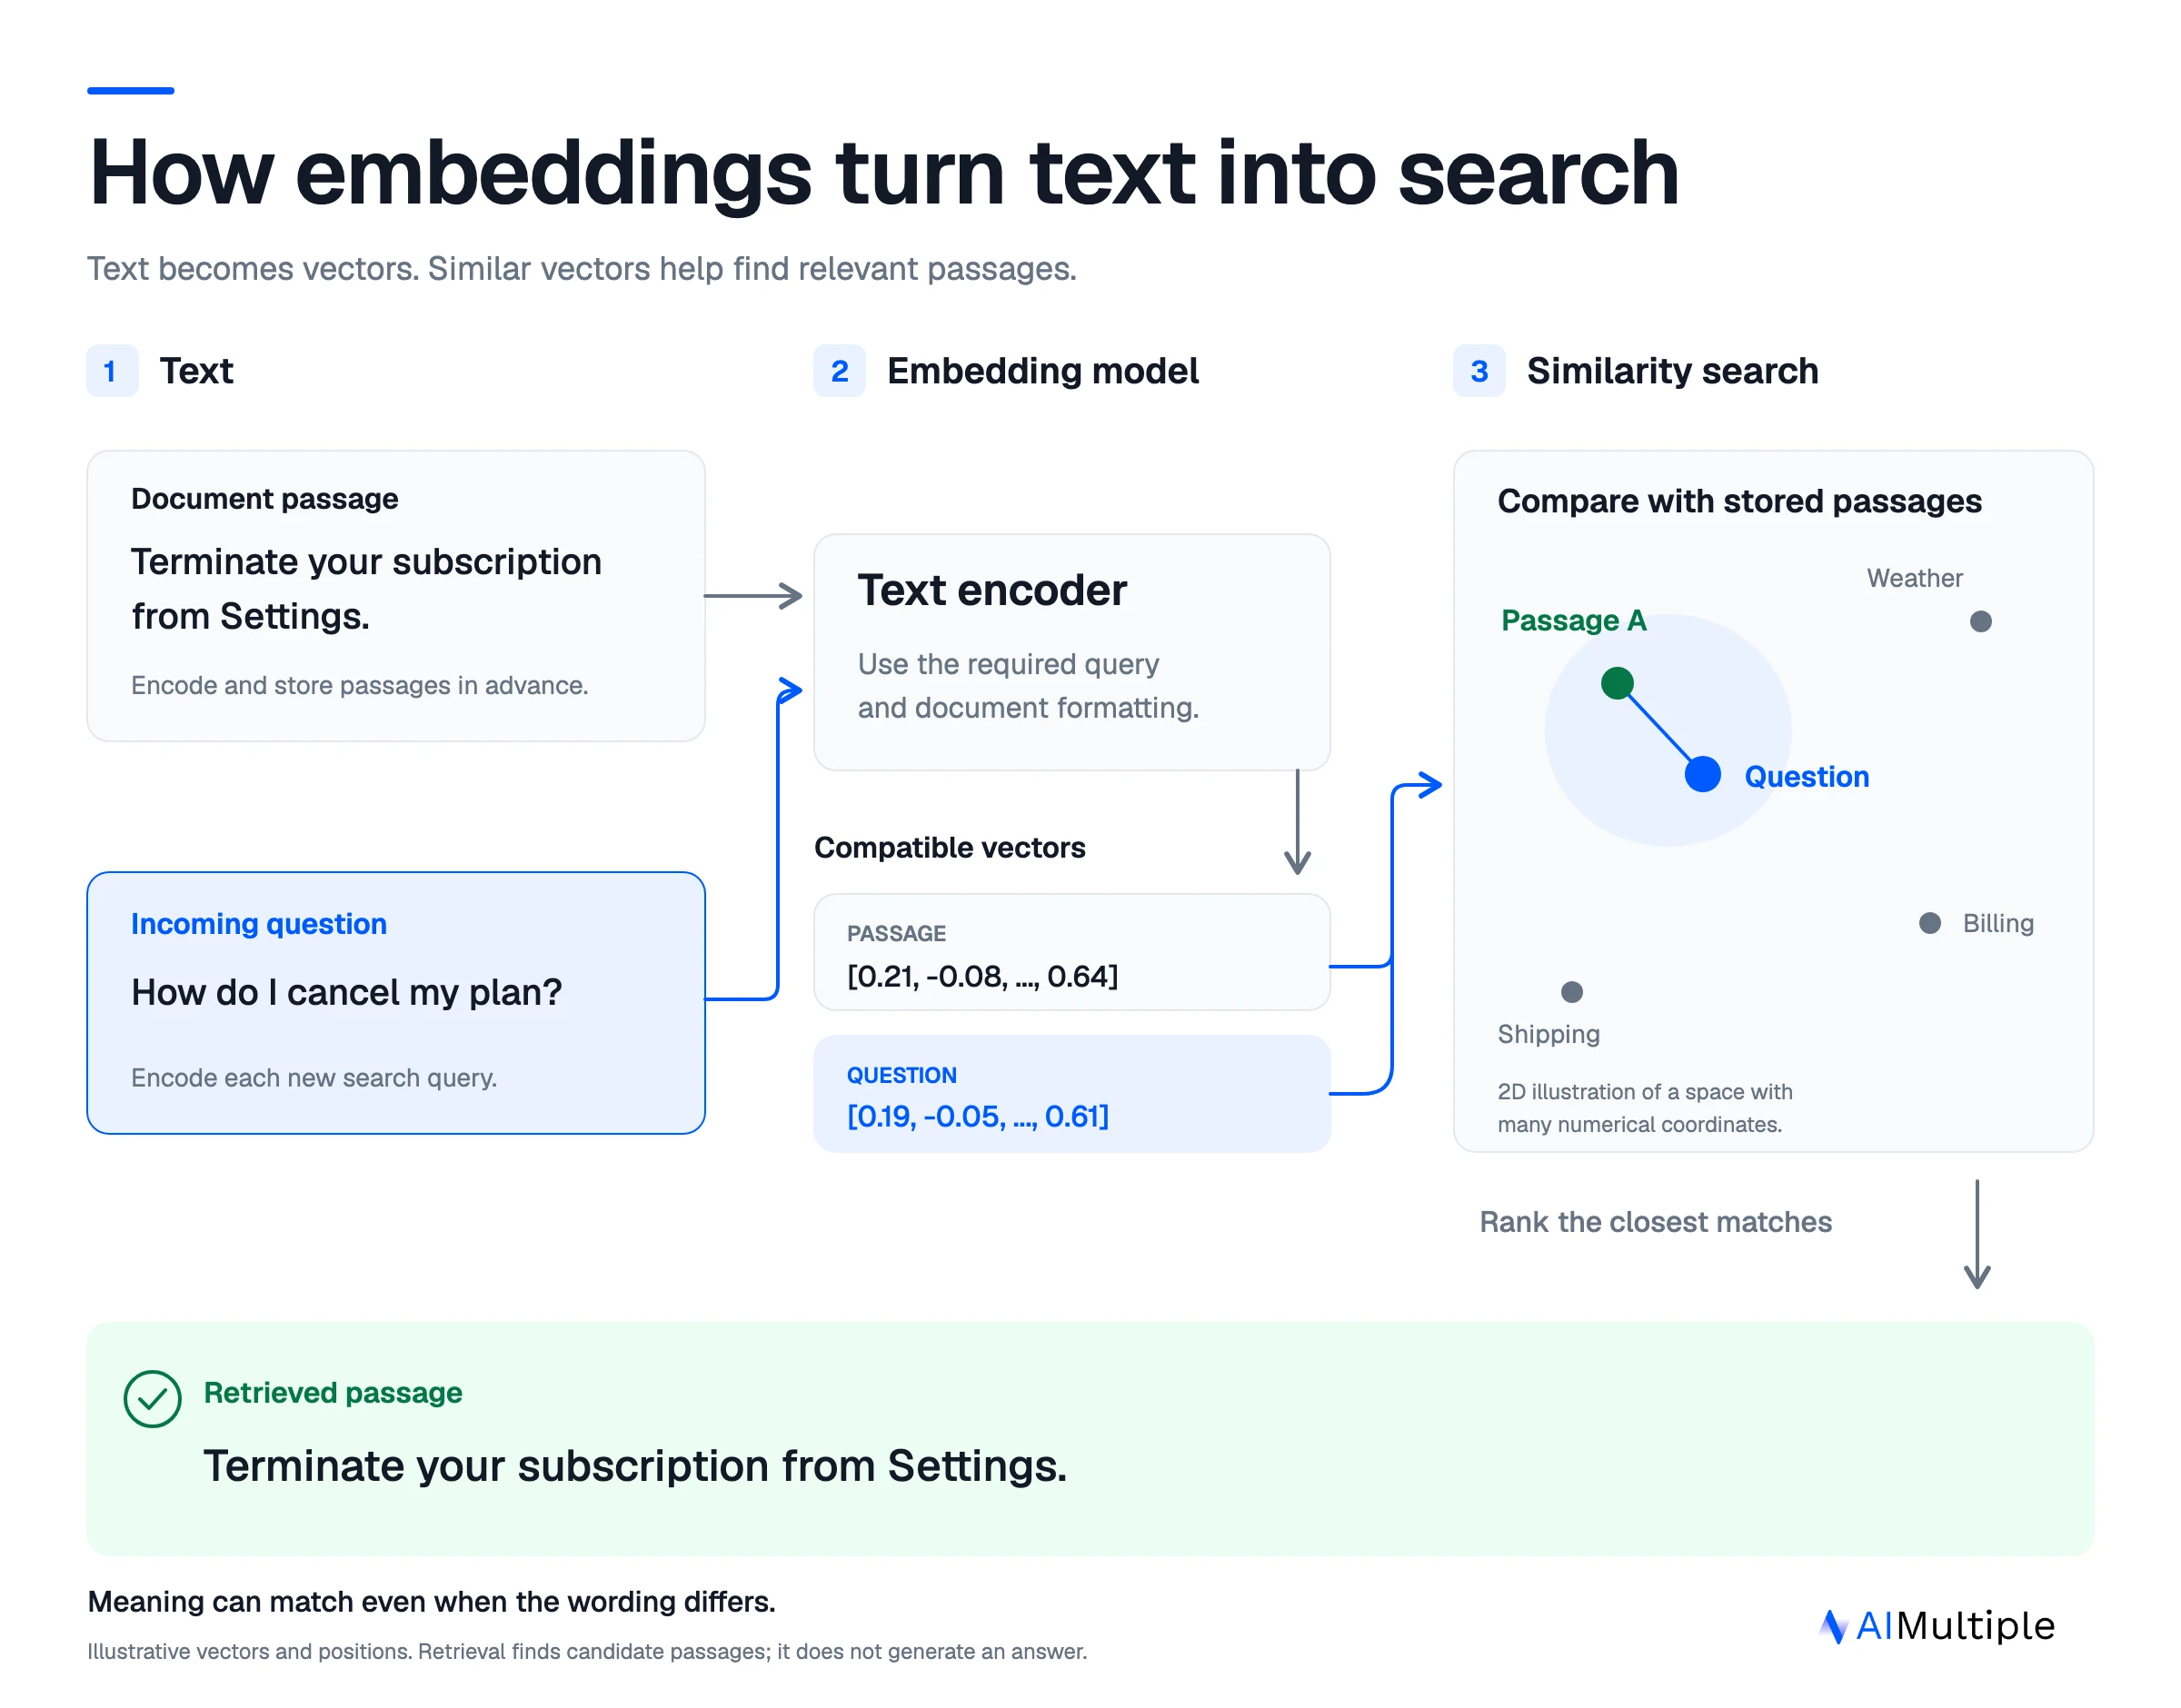
Il retrieval basato su embedding codifica passaggi e query in vettori compatibili, quindi confronta tali vettori per selezionare i passaggi candidati. I documenti possono essere codificati prima della ricerca. Ogni query in ingresso richiede una propria rappresentazione. I prompt o ruoli di query e documento specifici del model devono seguire la configurazione di retrieval del model.2
Anche il comportamento di archiviazione e ricerca dipende dal database vettoriale e dalla sua configurazione dell'indice. La scelta del model, la precisione dei vettori, le impostazioni dell'indice e la profondità di retrieval dovrebbero rimanere decisioni separate quando si pianifica un'implementazione. Il più ampio embedding model benchmark colloca queste undici voci accanto ai model API commerciali sulle stesse domande.
Metodologia del benchmark degli open source embedding model
Ogni model ha cercato gli stessi passaggi con 200 domande congelate e 225 coppie domanda-passaggio pertinenti registrate. Le domande e le etichette di rilevanza sono state fissate prima di confrontare i punteggi di embedding. Gli input delle query contenevano solo la domanda originale.
I passaggi finance provenivano dai report annuali FinQA e i passaggi legali dai contratti CUAD v1.34 L'assistenza tecnica ha utilizzato le note tecniche TechQA e la letteratura medica ha utilizzato un campione di abstract PubMed di MedRAG.56
I passaggi erano paragrafi interi, tabelle con contesto, clausole contrattuali o abstract con titoli. Abbiamo escluso le unità più lunghe di 256 token secondo il tokenizer all-MiniLM-L6-v2 e mantenuto intatti i passaggi accettati. I model con 512 token hanno ricevuto al massimo 459 token per passaggio, quindi questa valutazione copre passaggi brevi.
I LLM di frontiera hanno redatto le domande dai passaggi di origine. Un membro del team ha verificato il 20% delle domande (40 di 200). I LLM hanno inoltre giudicato i primi 20 passaggi di BM25 per ciascuna domanda, aggiungendo 25 passaggi pertinenti ai 200 passaggi di origine originali.
Retrieval e analisi statistica
Ogni query è stata confrontata con ogni passaggio nel suo dominio. MultiQA ha utilizzato il prodotto scalare, coerentemente con la sua model card.7 Gli altri dieci model hanno utilizzato la similarità del coseno. BGE-M3 ha utilizzato i suoi vettori densi.1 Gli input hanno utilizzato i ruoli o prefissi di retrieval configurati per ciascun model.
Entrambe le metriche sono medie tra le domande. Abbiamo calcolato IC al 95% con 10.000 campioni bootstrap, ricampionando 50 domande all'interno di ciascun dominio. La significatività utilizza i test appaiati con inversione di segno dell'intero benchmark, con correzione di Holm su tutte le 231 coppie tra i suoi 22 model per ogni metrica e ambito. Le differenze sono significative con un p-value corretto inferiore a 0.05.
ID dei model testati, dimensioni e limiti di input
Le esecuzioni sono avvenute tramite OpenRouter, con un provider backend fisso per model e fallback disabilitati. Questi sono gli identificativi API, le dimensioni di output e i limiti di input utilizzati in quelle esecuzioni.
Gli identificativi API non garantiscono uno snapshot immutabile del model. Le revisioni del tokenizer sono state bloccate e i pesi dei model ospitati non sono stati verificati in modo indipendente. I limiti di input descrivono la configurazione del benchmark. I passaggi brevi non hanno testato il retrieval a contesto lungo.
Limiti del confronto
Le domande costituiscono un set di sviluppo selezionato con BM25. I risultati su query di produzione ordinarie potrebbero differire. I giudizi di rilevanza erano limitati ai passaggi di origine e ai primi 20 di BM25. Tra questi undici model, circa 85% delle coppie distinte domanda-passaggio recuperate nelle prime dieci posizioni non sono state giudicate e non hanno ricevuto credito di rilevanza.
Ogni model è stato eseguito una volta. Gli IC riflettono il campionamento delle domande ed escludono la variazione tra esecuzioni API o l'incertezza derivante da etichette incomplete. La contaminazione dei dati di addestramento non è stata testata.
La valutazione copre il retrieval di testi in inglese. I carichi di lavoro di embedding multilingue e i model di embedding multimodali richiedono evidenze separate. L'accuratezza delle risposte generate, il retrieval ibrido, il reranking, la memoria GPU, il throughput locale e i costi di serving erano al di fuori di questo confronto.
Conclusione
PPLX Embed v1 4B e 0.6B hanno ottenuto i punteggi complessivi più alti tra gli undici model open-weight. La loro differenza non era statisticamente significativa. BGE Large ha registrato il punteggio finance più alto e GTE Large ha recuperato tutti i positivi MedRAG registrati entro i primi dieci risultati.
Prima dell'implementazione, testa il set di query previsto e misura velocità di serving locale, uso di memoria e costi.
 Aggiungi come fonte preferita
Ulteriori letture
- Benchmark di embedding model
- Model di embedding multilingue per RAG
- Benchmark dei database vettoriali open-source
- Dimensionamento e selezione del database vettoriale
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Open Source Embedding Models: 11 Models sottoposti a benchmark per il retrieval}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-embedding-models}},
  note   = {AIMultiple. Consultato il 26 settembre 2026}
}Risultati e timestamp di 105 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 7 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
4 aggiornamentiIl benchmark Top-K di 16 modelli sulle recensioni Amazon è stato sostituito con uno di 14 modelli con nDCG@3 e costi su CUAD, TechQA e MedRAG.
Aggiunta la sezione Licenza e uso commerciale alla panoramica dei modelli di embedding open source.
Il benchmark è stato ampliato per includere cinque modelli open source aggiuntivi.
Aggiornati hardware, dimensione del batch e precisione nella configurazione di valutazione.
Collegamenti di riferimento






Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.