


Copyright dell'IA generativa: diritto e contenzioso

Abbiamo esaminato decisioni giudiziarie, interventi normativi e accordi di licenza per rispondere a tre domande chiave sul copyright e sull'IA generativa.
- I dati protetti da copyright possono essere utilizzati per addestrare l'IA? Non esiste un approccio giuridico uniforme. Negli Stati Uniti, i tribunali applicano il fair use caso per caso. I tribunali distrettuali hanno raggiunto risultati diversi a seconda dello scopo dell'uso, delle modalità di ottenimento del materiale e del suo effetto sui mercati esistenti.
- Le opere generate dall'IA possono beneficiare della protezione del copyright? La risposta dipende dalla giurisdizione. La legge statunitense sul copyright richiede la paternità umana. Alcuni altri paesi hanno regole specifiche per le opere generate da computer.
- Chi detiene il copyright su un'opera generata dall'IA? La titolarità dipende dall'esistenza del copyright e da chi la legge riconosce come autore. Nessun tribunale ha riconosciuto un sistema di IA stesso come autore ai fini del copyright.
1. I dati protetti da copyright possono essere utilizzati come dati di addestramento?
Stati Uniti
Sony Music Publishing e Warner Chappell fanno causa a Anthropic
Nell'agosto 2026, Anthropic ha affrontato un ulteriore contenzioso sul copyright da parte di importanti editori musicali. Sony Music Publishing e Warner Chappell hanno presentato causa nell'agosto 28, dopo un'azione intentata ad agosto da Round Hill Music.1
Concord e UMG chiedono più di 3 miliardi di dollari a Anthropic
Nel gennaio 2026, BMG e un gruppo guidato da Concord Music Group e Universal Music Group hanno anche citato in giudizio Anthropic.2
La denuncia guidata da Concord/UMG sostiene che Anthropic ha ottenuto illegalmente più di 20.000 canzoni, testi, composizioni e opere di spartiti protetti da copyright. I ricorrenti chiedono danni legali potenziali superiori a 3 miliardi di dollari.
Bartz v. Anthropic sul fair use nell'addestramento dell'IA
Nel caso Bartz v. Anthropic, il Tribunale distrettuale della California settentrionale ha stabilito che l'uso di libri da parte di Anthropic per addestrare i suoi model era fair use. Il tribunale ha inoltre stabilito che l'acquisizione e la conservazione di milioni di libri piratati per una biblioteca centrale non erano protette dal fair use.
Nel luglio 2026, la giudice Araceli Martínez-Olguín ha concesso l'approvazione definitiva dell'accordo da 1.5 miliardi di dollari in Bartz v. Anthropic e ha emesso la sentenza definitiva. I legali del gruppo hanno riferito che le richieste coprivano almeno il 91,3% delle opere ammissibili, mentre 350 esclusioni valide riguardavano 1.802 opere. Il tribunale ha respinto la richiesta di 187.5 milioni di dollari di onorari per gli avvocati e ha approvato circa 101.56 milioni.3
L'accordo risolve specifiche rivendicazioni relative alle opere incluse nella classe dell'accordo. Non autorizza l'addestramento futuro né risolve rivendicazioni separate relative agli output dei model o ad altre opere protette da copyright.
Il Terzo Circuito esamina il fair use nell'addestramento dell'IA
Nel giugno 2026, il Terzo Circuito ha ascoltato le discussioni orali in Thomson Reuters contro Ross Intelligence. Il caso è il primo procedimento d'appello federale ad affrontare se l'uso di materiale protetto da copyright per sviluppare un sistema di IA costituisca fair use. Il collegio si è concentrato sulla trasformatività e sul danno al mercato. A settembre 2026, non era stata ancora emessa alcuna decisione d'appello.4
La legge californiana AB 2013 richiede la divulgazione dei dati di addestramento
La legge californiana AB 2013 è entrata in vigore nel gennaio 2026. Gli sviluppatori devono pubblicare informazioni sui dataset utilizzati per addestrare i sistemi di IA generativa. Le informative richieste includono le fonti dei dataset, i tipi di dati, l'eventuale inclusione di materiale protetto da copyright, l'eventuale licenza o acquisto dei dataset e l'eventuale presenza di informazioni personali.5
Kadrey v. Meta sull'addestramento dell'IA
Nel caso Kadrey v. Meta, un altro tribunale federale ha respinto le richieste di risarcimento per violazione dei ricorrenti sulla base delle prove presentate, anche perché non hanno dimostrato un danno di mercato sufficiente.6
Queste decisioni non stabiliscono una regola generale secondo cui tutto l'addestramento dell'IA costituisce fair use.
Francia
L'autorità garante della concorrenza francese (Autorité de la concurrence) ha multato Google per €250 milioni per aver utilizzato articoli di notizie senza autorizzazione nell'addestramento di Gemini. Si è trattato di un intervento di applicazione normativa, non di una decisione sul copyright.7
Regno Unito
Il governo del Regno Unito sulla rimozione della protezione per le opere generate da computer
Nel marzo 2026, il governo del Regno Unito ha pubblicato il suo rapporto su copyright e intelligenza artificiale.
Il rapporto propone di rimuovere la protezione speciale del copyright per le opere generate da computer ai sensi della Section 9(3) del Copyright, Designs and Patents Act. La disposizione resta in vigore a meno che il Parlamento non modifichi la legge.8
Getty v. Stability IA sulla rivendicazione di violazione relativa ai pesi del model
Nel caso Getty Images contro Stability IA, l'Alta Corte del Regno Unito ha respinto la richiesta di violazione secondaria del copyright di Getty relativa ai pesi del model Stable Diffusion. La corte non ha considerato il model stesso una copia in violazione ai fini di tale richiesta.9
Unione europea
La CGUE e il suo primo caso sul copyright dell'IA generativa
La Corte di giustizia dell'Unione europea sta esaminando il caso Like Company contro Google Ireland, causa C-250/25. La Grande Sezione ha tenuto le discussioni orali nel marzo 2026.
Il caso affronta se l'addestramento degli LLM comporti una riproduzione rilevante ai fini del copyright, se l'eccezione dell'UE per l'estrazione di testo e dati possa applicarsi e quando gli output dei chatbot contenenti materiale protetto possano violare il copyright. A settembre 2026, il caso è ancora pendente.10
Articolo 53 conformità al copyright per l'IA per finalità generali
L'articolo 53 del regolamento europeo sull'IA impone ai fornitori di model di IA per finalità generali di mantenere una politica di conformità con la normativa europea sul copyright.
I fornitori devono inoltre pubblicare una sintesi sufficientemente dettagliata dei contenuti utilizzati per l'addestramento e affrontare le riserve di diritti formulate ai sensi dell'articolo 4(3) della direttiva sul mercato unico digitale.11
Germania
La GEMA vince la causa sul copyright contro Suno
Nel luglio 2026, il Tribunale regionale di Monaco ha stabilito che la società musicale di IA Suno ha violato i diritti d'autore su canzoni rappresentate dalla società tedesca di gestione collettiva GEMA.
Il tribunale ha ritenuto che Suno non disponesse dell'autorizzazione per trattare le canzoni protette e ha ordinato alla società di divulgare i ricavi legati alla violazione.12
La GEMA vince la causa sui testi contro OpenAI
La decisione su Suno ha fatto seguito alla sentenza del novembre 2025 della GEMA contro OpenAI riguardante testi di canzoni protetti da copyright riprodotti tramite ChatGPT. OpenAI ha impugnato tale decisione dinanzi al Tribunale superiore regionale di Monaco.13
Giappone
Il Giappone adotta il codice di principi per la trasparenza dell'IA generativa
Nell'agosto 2026, la sede per la strategia sulla proprietà intellettuale del Giappone ha pubblicato il suo codice di principi per la protezione della proprietà intellettuale e la trasparenza nell'uso appropriato dell'IA generativa.14
Il codice di principi non è vincolante e segue un approccio di conformità o spiegazione. Incoraggia le imprese di IA a divulgare informazioni sui processi di addestramento, sulle categorie di dataset e sui metodi di raccolta dei dati.
La legge giapponese sul copyright contiene un'eccezione che può consentire l'uso di opere protette da copyright per l'analisi delle informazioni, incluso parte dell'addestramento dell'IA.
L'eccezione è soggetta a limiti legali, tra cui se l'uso consente il godimento del contenuto espressivo dell'opera e se danneggia irragionevolmente gli interessi del titolare del copyright.
Singapore
Singapore su IA e copyright
Nell'agosto 2026, il Ministero della Legge e l'Ufficio per la proprietà intellettuale di Singapore hanno avviato una consultazione pubblica su IA e proprietà intellettuale.
La consultazione riguarda l'eccezione per l'analisi computazionale dei dati, la gestione del rischio di copyright quando vengono impiegati sistemi di IA e il ruolo della creatività umana nelle opere assistite dall'IA.15
2. Le opere generate dall'IA possono beneficiare della protezione del copyright?
L'India respinge DABUS come autore
Nell'agosto 2026, l'Ufficio del copyright indiano ha respinto la domanda di Stephen Thaler di registrare l'immagine generata da DABUS “A Recent Entrance to Paradise”.16
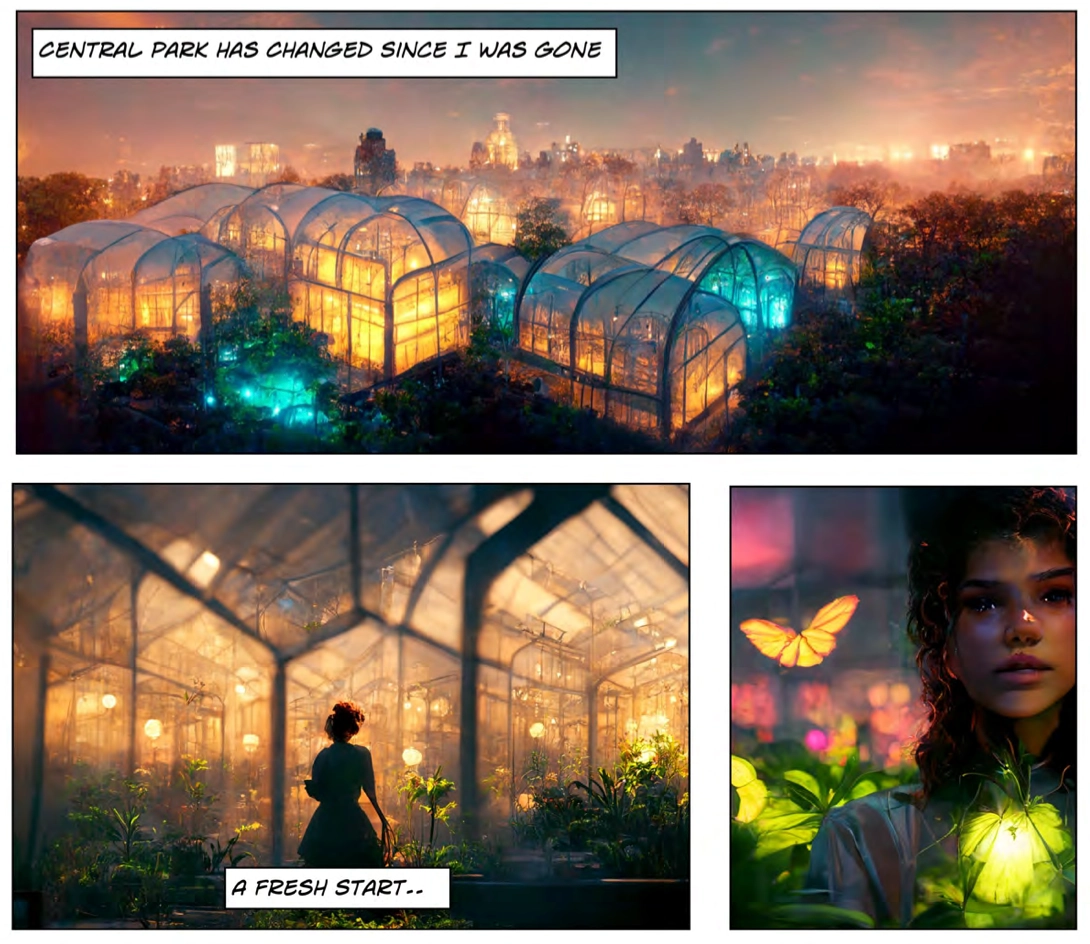
L'autrice ha chiarito che l'opera era assistita dall'IA, non generata esclusivamente dall'IA. Ha strutturato la storia, progettato l'impaginazione e compiuto scelte artistiche per disporre gli elementi accanto alle immagini generate dall'IA.
Figura 1: Disegni tratti dall'ultima pagina del fumetto generato dall'IA Zarya of the Dawn.
L'immagine premiata di Midjourney non ha ottenuto la protezione del copyright
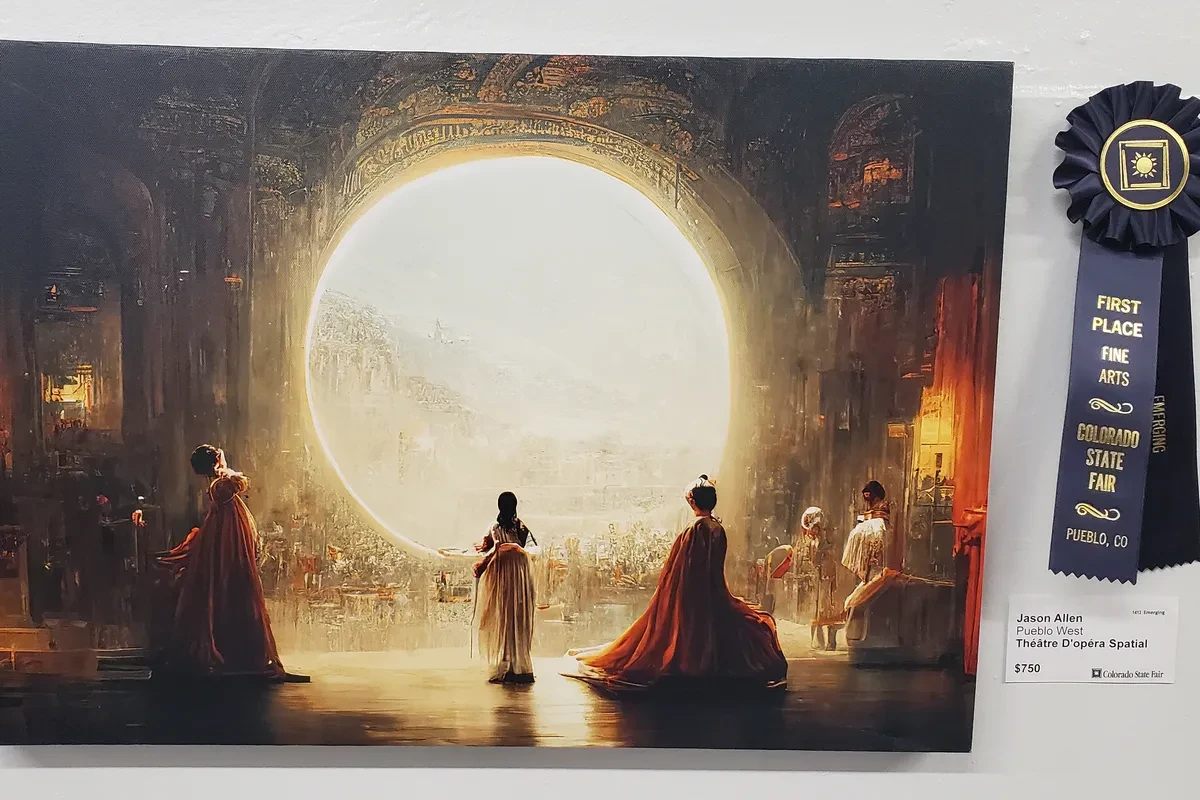
Nel 2022, Jason Allen ha vinto il primo posto nella categoria arti digitali della Fiera statale del Colorado con Théâtre D’opéra Spatial, un'immagine creata con Midjourney.
Allen ha usato prompt testuali per generare l'immagine, poi ha apportato ulteriori modifiche prima di stamparla e presentarla. Il premio ha suscitato critiche da parte di artisti che sostenevano che le opere generate dall'IA non dovessero competere alle stesse condizioni dell'arte creata tradizionalmente.
Figura 2: La stampa premiata generata dall'IA Theatre d’Opera Spatial.17
Nel settembre 2023, l'Ufficio del copyright statunitense ha rifiutato di registrare l'opera di Jason Allen come opera protetta da copyright perché l'immagine conteneva più di una quantità minima di materiale generato dall'IA.
Allen ha sostenuto di aver usato centinaia di prompt e di aver successivamente modificato l'immagine in Photoshop. L'Ufficio del copyright ha concluso che gli elementi generati da Midjourney non erano il prodotto di paternità umana.18
3. Chi detiene il copyright in un'opera generata dall'IA?
Nella maggior parte dei paesi, la legge sul copyright assegna la titolarità al creatore di un'opera. Quando l'IA produce l'opera, la questione di chi sia il creatore e, quindi, di chi ne detenga la titolarità non ha una risposta universale consolidata.
- Regno Unito: Il Copyright, Designs and Patents Act prevede che, per un'opera qualificata generata da computer, l'autore sia la persona che adotta le disposizioni necessarie per la sua creazione.
- India: Per un'opera generata da computer, l'autore legale è la persona che determina la creazione dell'opera.
- Stati Uniti: Il materiale generato dall'IA senza sufficiente paternità umana non è protetto dal copyright. Quando un'opera assistita dall'IA contiene contributi umani proteggibili, la titolarità segue le regole applicabili a tali autori umani.
Per saperne di più sull'IA generativa
- IA generativa in sanità: benefici, sfide, potenzialità
- IA generativa nella moda: 5 casi d'uso con studi di caso
- I 5 principali casi d'uso dell'IA generativa nell'istruzione
 Aggiungi come fonte preferita
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Copyright dell'IA generativa: diritto e contenzioso}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/generative-ai-copyright}},
  note   = {AIMultiple. Consultato il 3 settembre 2026}
}
Registro delle modifiche
14 aggiornamentiRimosse le sezioni su accordi di licenza IA, best practice e glossario.
La sezione USA è stata aggiornata con nuove sentenze e dettagli sui contenziosi.
Aggiornata la sezione "I dati protetti da copyright possono essere usati come dati di addestramento?" con nuove informazioni sul fair use negli Stati Uniti.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.


Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.