


LLM Orchestrazione: 21 framework e gateway

Ottimizzare l'orchestrazione LLM è fondamentale per migliorare le prestazioni mantenendo sotto controllo l'uso delle risorse. Per valutare nella pratica le prestazioni dei diversi approcci di orchestrazione, abbiamo eseguito dei benchmark:
- Framework di orchestrazione agentica: utilizzando un flusso di lavoro identico di pianificazione del viaggio con cinque agenti, eseguito 100 volte ciascuno, misurando la latenza della pipeline, l'uso dei token, le transizioni da agente a agente e i divari di esecuzione tra agente e strumento.
- Gateway IA: OpenRouter, SambaNova, TogetherAI, Groq e IA/ML API testati su latenza del primo token, latenza totale e numero di token in output con 300 test con prompt brevi (≈18 token) e lunghi (≈203 token).
Scopri strumenti selezionati di orchestrazione LLM, tra cui framework per sviluppatori e gateway aziendali:
Cos'è l'orchestrazione in LLM?
L'orchestrazione LLM consiste nel gestire e integrare più Large Language Models (LLMs) per eseguire compiti complessi in modo efficiente. Garantisce l'interazione tra i model, flussi di lavoro, origini dati e pipeline, ottimizzando le prestazioni come sistema unificato. Le organizzazioni utilizzano l'orchestrazione LLM per attività come la generazione di linguaggio naturale, la traduzione automatica, il processo decisionale e i chatbot.
Sebbene i LLM abbiano solide capacità di base, sono limitati nell'apprendimento in tempo reale, nel mantenere il contesto e nella risoluzione di problemi a più fasi. Inoltre, gestire più LLM tramite API di provider diversi aggiunge complessità all'orchestrazione.
I framework di orchestrazione LLM affrontano queste sfide semplificando il prompt engineering, le interazioni con le API, il recupero dei dati e la gestione dello stato. Questi framework consentono ai LLM di collaborare in modo efficiente, migliorando la loro capacità di generare output accurati e consapevoli del contesto.
Qual è la migliore piattaforma per l'orchestrazione LLM?
I framework di orchestrazione LLM possono gestire, coordinare e ottimizzare l'uso di Large Language Models (LLMs) in varie applicazioni. Un sistema di orchestrazione LLM consente l'integrazione con diversi componenti di IA, facilita il prompt engineering, gestisce i flussi di lavoro e migliora il monitoraggio delle prestazioni.
Sono particolarmente utili per applicazioni che coinvolgono sistemi multi-agente, generazione aumentata da recupero (RAG), IA conversazionale e processi decisionali autonomi.
Per facilitare la navigazione, gli strumenti sono suddivisi in due categorie:
1. Piattaforme basate su gateway
Le piattaforme gateway sono soluzioni orientate all'azienda che centralizzano l'accesso ai LLM, applicano le policy di sicurezza, gestiscono la conformità e forniscono monitoraggio dell'utilizzo. Queste piattaforme sono ideali per le organizzazioni che necessitano di un deployment LLM controllato, scalabile e governato.
Ecco alcuni gateway IA e i loro punteggi GitHub:
Risultati del benchmark dei gateway IA
Il nostro benchmark ha utilizzato la latenza del primo token (FTL) e la latenza totale con l'output dei token per valutare l'efficienza con cui i gateway selezionano i provider e forniscono le risposte. Ecco alcuni dei nostri risultati:
- Migliori prestazioni:
- Groq: FTL più veloce per prompt lunghi (0.14 s) e bassa latenza totale (2.7 s) con 1.900 token
- SambaNova: a pari merito per l'FTL più veloce sui prompt brevi (0.13 s) e seconda latenza totale più bassa (3 s) producendo al contempo il numero più alto di token (1.997)
- Prestazioni moderate:
- OpenRouter: FTL 0.40–0.45 s, latenza totale 25 s per prompt lunghi, output di token moderato
- TogetherAI: FTL 0.43–0.45 s, latenza totale 11 s con 1.812 token
- Prestazione più bassa: IA/ML API, FTL più alto (0.84–0.90 s) e latenza totale (13 s), nonostante un output di token moderato.
Per maggiori dettagli e metodologia, consulta il nostro articolo sul benchmark dei gateway IA.
Ecco un elenco di piattaforme basate su gateway per l'orchestrazione LLM, in ordine alfabetico:
Bifrost di Maxim IA
Bifrost è un gateway IA che unifica l'accesso a oltre 15 provider LLM tramite un'unica API compatibile con OpenAI, supportando failover automatico, bilanciamento del carico e policy di governance centralizzate.
Caratteristica unica: integrazione del Model Context Protocol (MCP), che consente streaming, monitoraggio basato su plugin e analisi per LLM multi-provider.
Cloudflare IA Gateway
Cloudflare IA Gateway è un proxy di inference IA e una piattaforma di orchestrazione che fornisce accesso a molteplici large language model, offrendo fatturazione unificata, monitoraggio dei costi e funzionalità di resilienza automatizzate per carichi di lavoro IA tecnici.
Caratteristica unica: failover multi-provider e bufferizzazione dello streaming edge-based, che protegge le risposte di streaming delle applicazioni a lunga esecuzione dalle disconnessioni memorizzando nella cache l'output di inference direttamente sulla rete globale di Cloudflare.
Kong
Kong IA Gateway è un gateway IA semantico che centralizza e protegge il traffico LLM, consentendo alle organizzazioni di integrare, governare e monitorare più model IA per la conformità e il monitoraggio delle risorse.
Caratteristica unica: sicurezza semantica dei prompt, inclusa la sanitizzazione dei PII e template di prompt avanzati per proteggere le informazioni sensibili.
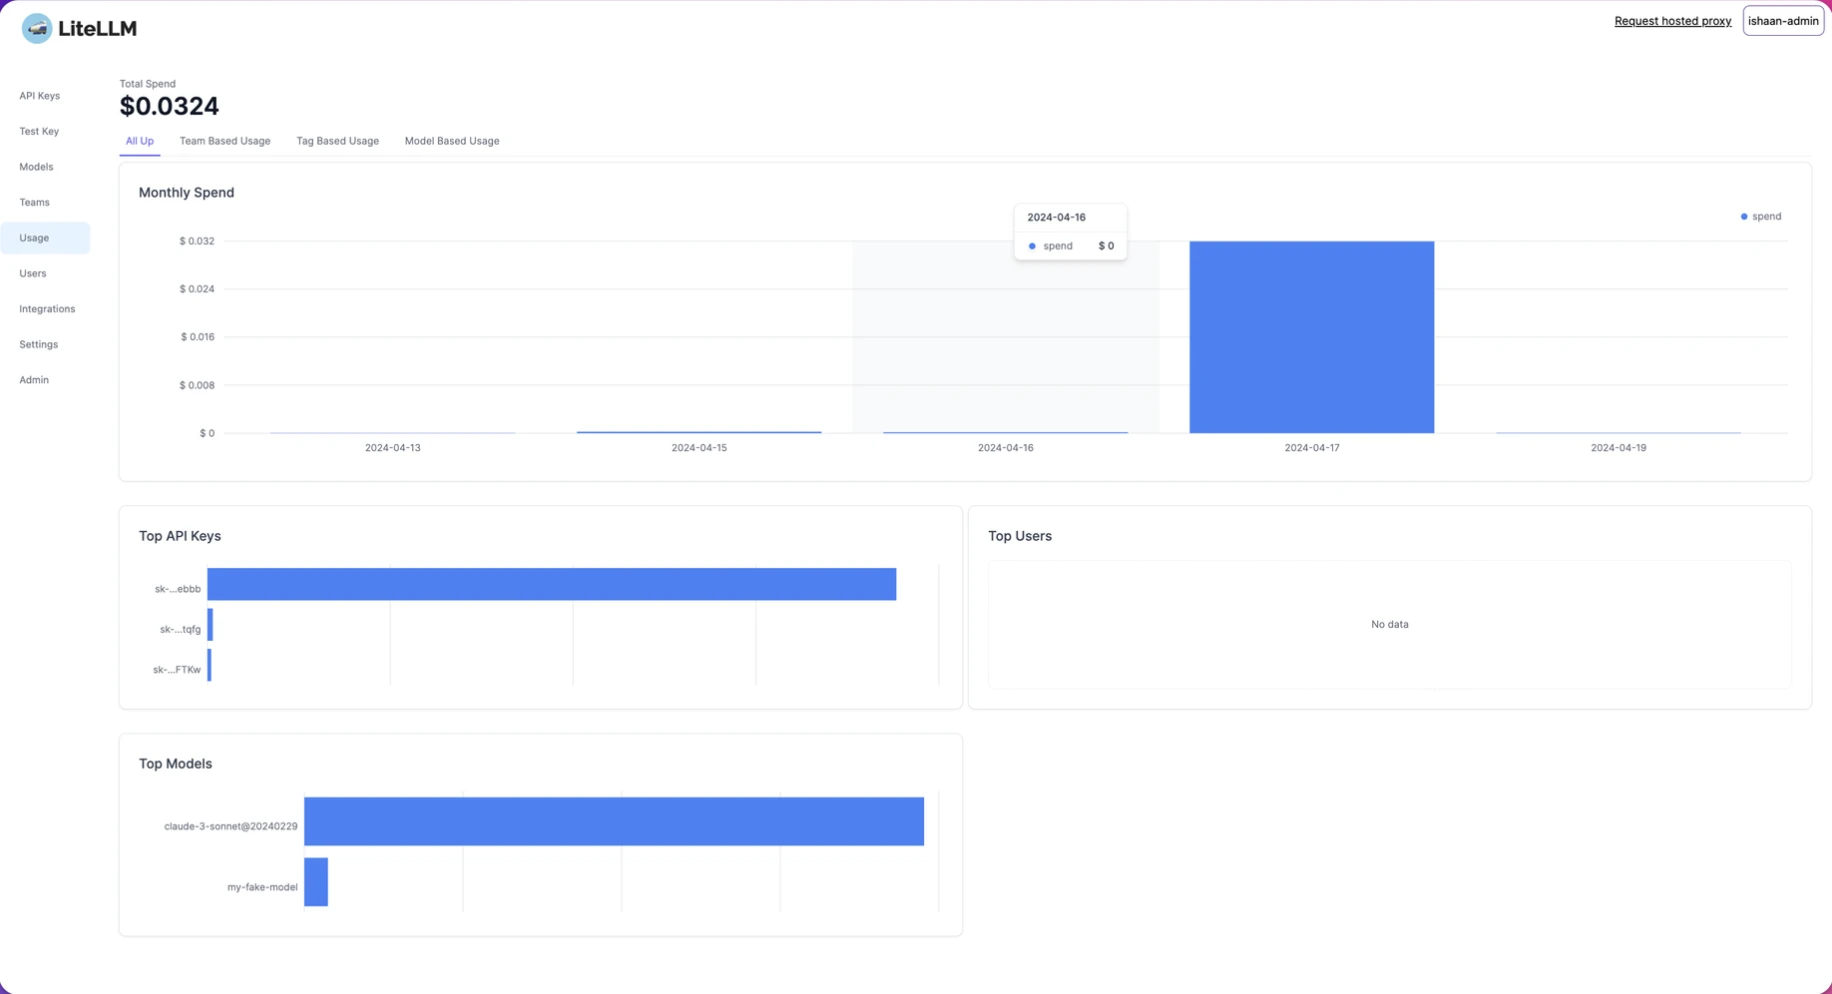
LiteLLM
LiteLLM fornisce accesso a più LLM tramite un'interfaccia unificata, offrendo sia un Proxy Server (LLM Gateway) sia un Python SDK per la gestione centralizzata e l'osservabilità del sistema.
Caratteristica unica: integrazione con Python SDK per la gestione programmatica dei LLM e l'osservabilità, consentendo agli sviluppatori di incorporare controlli IA centralizzati direttamente nel codice.
Prisma AIRS IA Gateway (precedentemente Portkey)
Prisma AIRS IA è un gateway IA e una piattaforma di orchestrazione che connette gli sviluppatori a più LLM, supportando routing programmatico, failover, monitoraggio dei costi e funzionalità di deployment per team IA tecnici.
Caratteristica unica: supporto LLM multimodale, inclusi model di testo, immagini, audio e visione con capacità di fine-tuning per una maggiore coerenza dell'output.
2. Framework per sviluppatori
I framework per sviluppatori sono progettati per ingegneri e sviluppatori IA che desiderano il pieno controllo sulla creazione e sull'orchestrazione dei flussi di lavoro LLM. Forniscono SDK, API e moduli predefiniti per concatenare i model, gestire i prompt e gestire le interazioni multi-LLM.
Ecco l'elenco completo degli strumenti di orchestrazione LLM per sviluppatori e le loro stelle GitHub in ordine alfabetico:
Risultati del benchmark
Risultati chiave del benchmark sui framework di orchestrazione:
- LangGraph: esegue più velocemente con la gestione dello stato più efficiente
- LangChain: consuma più token a causa della gestione più pesante della memoria e della cronologia
- AutoGen: prestazioni moderate con comportamento di coordinamento coerente
- CrewAI: presenta i ritardi più lunghi a causa della deliberazione autonoma prima delle chiamate agli strumenti.
Per la metodologia e un'analisi più dettagliata del benchmark, consulta il benchmark sull'orchestrazione agentica.
Gli strumenti spiegati di seguito sono elencati in ordine alfabetico:
Agency Swarm
Agency Swarm è un framework Multi-Agent System (MAS) che fornisce strumenti per creare, orchestrare e gestire sciami di agenti IA, utilizzando l'SDK degli agenti OpenAI.
Caratteristiche principali:
- Supporta il coordinamento multi-agente, consentendo a più agenti IA di scambiare dati ed eseguire flussi di lavoro contemporaneamente.
- Include strumenti di simulazione e visualizzazione che aiutano a testare e monitorare le interazioni degli agenti in un ambiente simulato.
- Consente interazioni IA basate sull'ambiente poiché gli agenti IA possono rispondere dinamicamente alle condizioni mutevoli.
AutoGen
AutoGen, sviluppato da Microsoft, è un framework open source di orchestrazione multi-agente che semplifica l'automazione dei compiti IA utilizzando agenti conversazionali.
Caratteristiche principali:
- Framework di conversazione multi-agente che consente agli agenti IA di comunicare e coordinare i compiti.
- Funziona con più provider di model, tra cui OpenAI e Azure
- Architettura modulare e configurabile, una configurazione personalizzabile per varie applicazioni IA.
crewAI
crewAI è un framework multi-agente open source. Consente ad agenti IA basati su ruoli di collaborare su compiti strutturati.
Caratteristiche principali:
- Automazione del flusso di lavoro basata su agenti che assegna agli agenti IA ruoli specifici nell'esecuzione dei compiti.
- Supporta sia utenti tecnici sia non tecnici
- Disponibile versione Enterprise (crewAI+)
Haystack
Haystack è un framework Python open source che consente la creazione flessibile di pipeline IA tramite un approccio basato su componenti. Supporta applicazioni di information retrieval e Q&A.
Caratteristiche principali:
- Progettazione di sistemi IA basata su componenti, un approccio modulare per assemblare funzioni IA.
- Integrazione con database vettoriali e provider LLM, consentendo di lavorare con vari data storage e model IA.
- Supporta la ricerca semantica e l'estrazione di informazioni, consentendo ricerca avanzata e recupero di conoscenza.
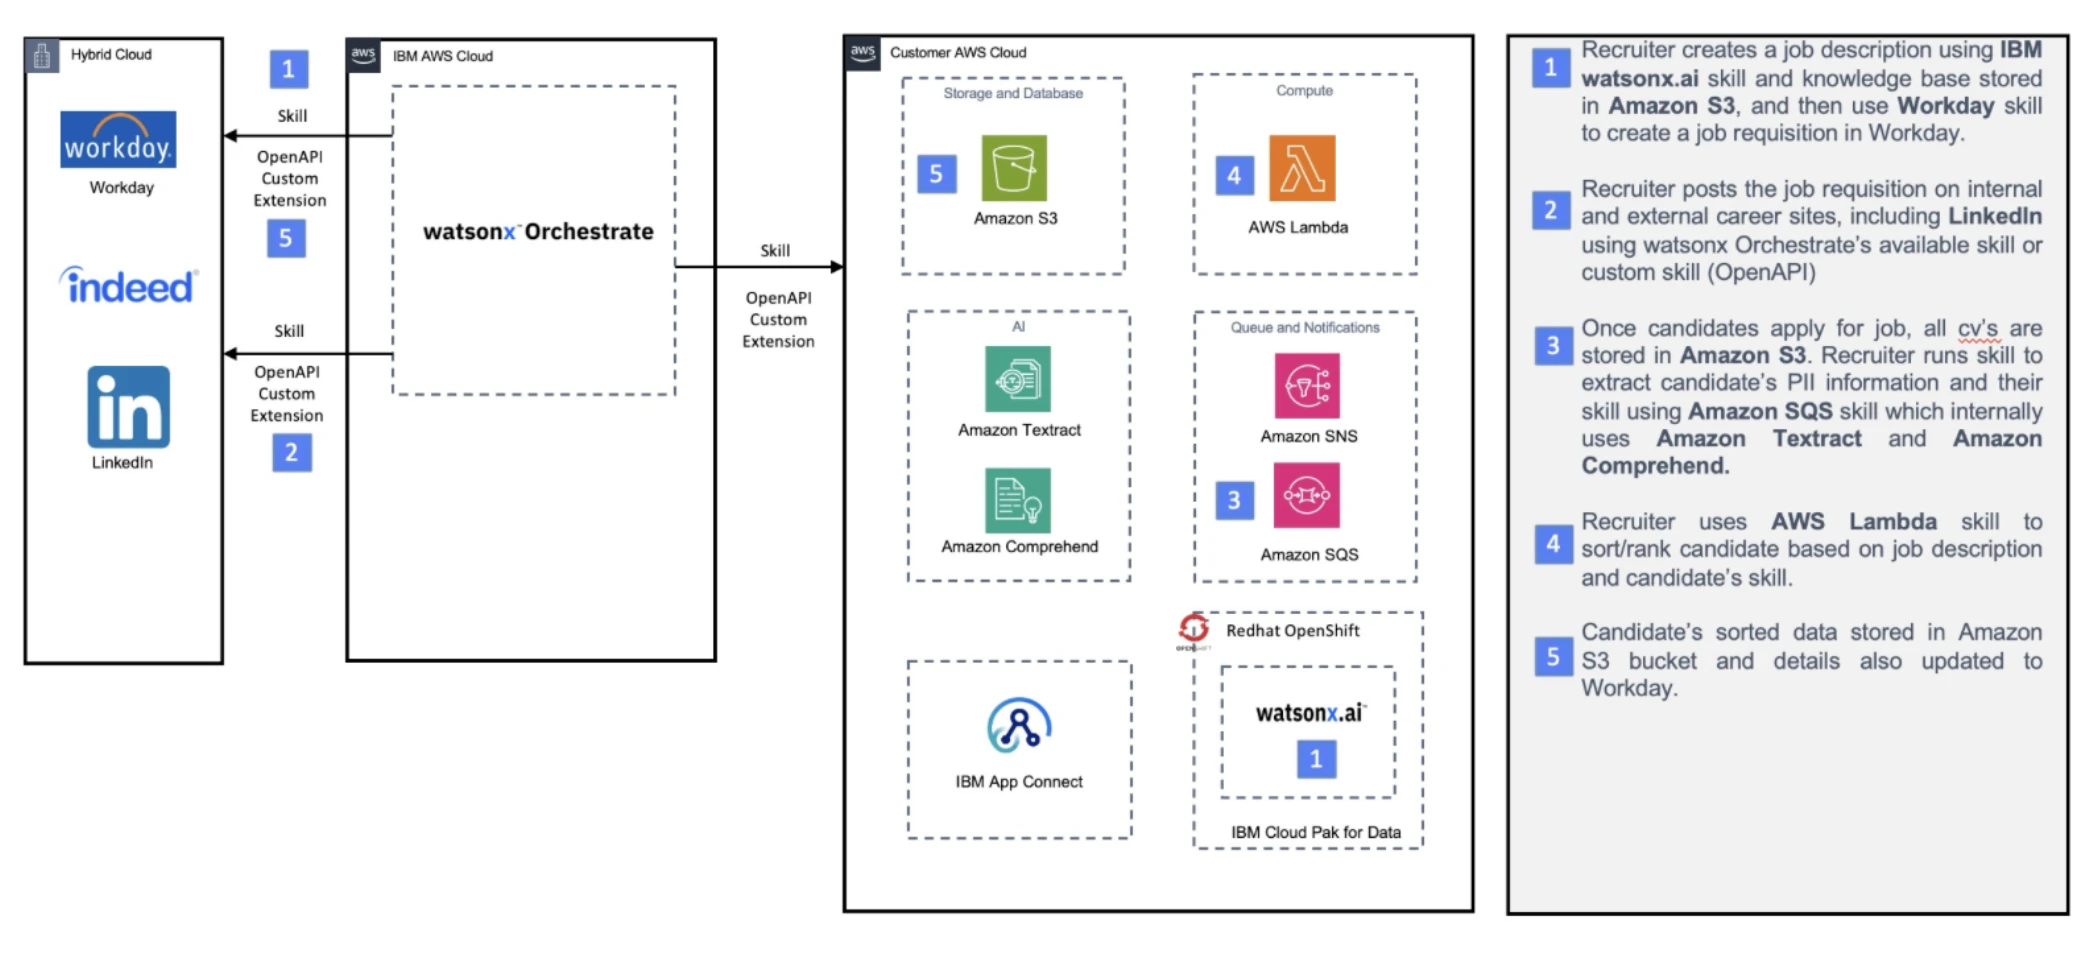
IBM watsonx orchestrate
IBM watsonx orchestrate è un framework proprietario di orchestrazione IA che utilizza l'elaborazione del linguaggio naturale (NLP) per automatizzare i flussi di lavoro aziendali.
Caratteristiche principali:
- Automazione del flusso di lavoro basata sull'IA che consente di automatizzare processi aziendali ripetitivi utilizzando l'IA.
- Applicazioni predefinite e set di competenze, fornendo strumenti IA pronti all'uso per diversi settori.
- Integrazione orientata all'azienda, che si collega a software e flussi di lavoro aziendali esistenti.
LangChain
LangChain è un framework Python open source per creare applicazioni LLM, concentrandosi sull'aumento degli strumenti e sull'orchestrazione degli agenti. Fornisce interfacce per l'incorporamento di model, LLM e vector store.
Caratteristiche principali:
- RAG supporto
- Integrazione con più componenti LLM
- Framework ReAct per ragionamento e azione
LlamaIndex
LlamaIndex è un framework open source di integrazione dei dati progettato per creare applicazioni LLM aumentate dal contesto. Consente di recuperare facilmente dati da più origini.
Caratteristiche principali:
- Connettori dati per oltre 160 origini, consentendo all'IA di accedere a diversi dati strutturati e non strutturati.
- Supporto alla Retrieval-Augmented Generation (RAG)
- Suite di moduli di valutazione per il monitoraggio delle prestazioni
LOFT
LOFT, sviluppato da Master of Code Global, è un framework Large Language Model-Orchestrator progettato per ottimizzare le interazioni con i clienti basate sull'IA. Utilizza un'architettura basata su code progettata per gestire richieste concorrenti e deployment multi-utente.
Caratteristiche principali:
- Agnostico rispetto al framework: si integra in qualsiasi sistema backend senza dipendenze da framework HTTP.
- Prompt calcolati dinamicamente: supporta prompt generati su misura per interazioni utente personalizzate.
- Rilevamento e gestione degli eventi: dispone di meccanismi integrati per rilevare e gestire eventi basati su chat, incluso il filtraggio delle allucinazioni.
Microchain
Microchain è un framework leggero e open source di orchestrazione LLM noto per la sua semplicità, ma non è attivamente mantenuto.
Caratteristiche principali:
- Supporto al ragionamento chain-of-thought che aiuta l'IA a scomporre i problemi complessi passo dopo passo.
- Approccio minimalista all'orchestrazione IA.
Orq IA
Orq è una piattaforma di collaborazione IA generativa e uno strumento LLMOps progettato per gestire il ciclo di vita del deployment delle applicazioni LLM. Fornisce funzionalità per consentire a team tecnici e non tecnici di creare, distribuire e monitorare funzionalità IA.
Caratteristiche principali:
- Orchestrazione serverless dei LLM: fornisce un'infrastruttura di deployment tramite una API unificata, con routing integrato, controllo delle versioni, fallback e retry.
- Osservabilità e valutazione: offre monitoraggio in tempo reale, tracce, log e valutatori personalizzati per garantire le prestazioni dei LLM e la qualità dell'output.
- IA gateway e RAG: garantisce un accesso a punto singolo a più model e strumenti IA per creare pipeline di Retrieval-Augmented Generation (RAG).
Semantic Kernel
Semantic Kernel (SK) è un framework open source di orchestrazione IA di Microsoft. Aiuta gli sviluppatori a integrare i large language model (LLM) come GPT di OpenAI con la programmazione tradizionale per creare applicazioni basate sull'IA.
Caratteristiche principali:
- Gestione di memoria e contesto: SK consente l'archiviazione e il recupero delle interazioni passate, aiutando a mantenere il contesto durante le conversazioni.
- Embedding e ricerca vettoriale: supporta ricerche basate sugli embedding, rendendolo compatibile con casi d'uso di generazione aumentata da recupero (RAG).
- Supporto multimodale: funziona con testo, codice, immagini e altro.
Come scegliere il giusto framework di orchestrazione LLM?
Il numero di stelle GitHub può indicare la popolarità, ma la scelta ideale dipende da diversi fattori, tra cui le competenze tecniche del team, la scala del progetto, il budget e le integrazioni desiderate.
Considera le competenze tecniche del team:
- Per team altamente tecnici come sviluppatori e data scientist che necessitano di controllo granulare e flessibilità, framework come LangChain, AutoGen e LlamaIndex sono scelte eccellenti. Sono code-first e richiedono una solida conoscenza di Python e dei principi dell'IA.
- Per utenti business o team con una preferenza low-code/no-code, le piattaforme incentrate su interfacce dichiarative sono più adatte. Loft e crewAI offrono flussi di lavoro semplificati, consentendo una prototipazione rapida senza un'ampia codifica.
Valuta la scala del progetto:
- Per sistemi multi-agente complessi, i framework appositamente progettati per questo scopo, come AutoGen, crewAI o Agency Swarm, forniscono l'architettura necessaria affinché gli agenti possano comunicare e collaborare.
- Per applicazioni aziendali su larga scala e mission-critical che richiedono alto throughput, sicurezza e supporto dedicato, le soluzioni proprietarie come IBM watsonx orchestrate sono spesso l'opzione preferita.
- Per applicazioni leggere e proof-of-concept (POC), può essere sufficiente un framework minimalista, poiché la sua semplicità riduce l'overhead.
Pensa ai vincoli di budget:
- I framework open source come LangChain e Haystack sono gratuito da usare, ma comportano i "costi nascosti" dell'infrastruttura cloud, della manutenzione e di un team specializzato.
- Le soluzioni proprietarie possono offrire una struttura di prezzi prevedibile che include supporto e può essere più conveniente per le organizzazioni senza un team MLOps dedicato.
Considera lo stack tecnologico esistente.
- Se la tua azienda è investita in un ecosistema specifico, eliminare i framework che non possono funzionare con quell'ecosistema è un passo utile. Ad esempio, Semantic Kernel per ambienti Microsoft o Haystack per applicazioni incentrate sul recupero di documenti possono fornire integrazione.
Come funzionano gli strumenti di orchestrazione LLM?
I framework di orchestrazione LLM gestiscono l'interazione tra i diversi componenti delle applicazioni basate su LLM, garantendo flussi di lavoro strutturati ed esecuzione efficiente. Il livello di orchestrazione svolge un ruolo centrale nel coordinare processi come la gestione dei prompt, l'allocazione delle risorse, la preelaborazione dei dati e le interazioni con i model.
Livello di orchestrazione
Il livello di orchestrazione funge da sistema di controllo centrale all'interno di un'applicazione basata su LLM. Gestisce le interazioni tra i vari componenti, inclusi LLM, template di prompt, database vettoriali e agenti IA. Supervisionando questi elementi, l'orchestrazione garantisce prestazioni coese in diversi compiti e ambienti.
Compiti chiave dell'orchestrazione
Gestione delle catene di prompt
- Il framework struttura e gestisce gli input dei LLM (prompt) per ottimizzare l'output.
- Fornisce un repository di template di prompt, consentendo una selezione dinamica in base al contesto e agli input dell'utente.
- Sequenzia i prompt in modo logico per mantenere flussi di conversazione strutturati.
- Valuta le risposte per migliorare la qualità dell'output, rilevare incoerenze e garantire l'aderenza alle linee guida.
- Possono essere implementati meccanismi di fact-checking per ridurre le inesattezze, indirizzando le risposte contrassegnate alla revisione umana.
Gestione delle risorse e delle prestazioni dei LLM
- I framework di orchestrazione monitorano le prestazioni dei LLM tramite test di benchmark e dashboard in tempo reale.
- Forniscono strumenti diagnostici per l'analisi delle cause radice (RCA) per facilitare il debug.
- Allocano le risorse computazionali in modo efficiente per ottimizzare le prestazioni.
Gestione e preelaborazione dei dati
- L'orchestratore recupera i dati da origini specifiche tramite connettori o API.
- La preelaborazione converte i dati grezzi in un formato compatibile con i LLM, garantendo qualità e rilevanza dei dati.
- Raffina e struttura i dati per migliorarne l'idoneità all'elaborazione da parte di diversi algoritmi.
Integrazione e interazione dei LLM
- L'orchestratore avvia le operazioni dei LLM, elabora l'output generato e lo instrada verso la destinazione appropriata.
- Mantiene archivi di memoria che migliorano la comprensione contestuale preservando le interazioni precedenti.
- I meccanismi di feedback valutano la qualità dell'output e perfezionano le risposte sulla base dei dati storici.
Misure di osservabilità e sicurezza
- L'orchestratore supporta strumenti di monitoraggio per tracciare il comportamento dei model e garantire l'affidabilità dell'output.
- Implementa framework di sicurezza per mitigare i rischi associati a output non verificati o imprecisi.
Miglioramenti aggiuntivi
Integrazione del flusso di lavoro
- Incorpora strumenti, tecnologie o processi nei sistemi operativi esistenti per migliorare efficienza, coerenza e produttività.
- Garantisce transizioni fluide tra diversi provider di model mantenendo la qualità di prompt e output.
Cambiare provider di model
- Alcuni framework consentono di cambiare provider di model con modifiche minime, riducendo l'attrito operativo.
- L'aggiornamento delle importazioni del provider, la regolazione dei parametri dei model e la modifica dei riferimenti di classe facilitano le transizioni.
Gestione dei prompt
- Mantiene la coerenza nella creazione dei prompt aiutando gli utenti a iterare e sperimentare in modo più produttivo.
- Si integra con le pipeline CI/CD per semplificare la collaborazione e automatizzare il monitoraggio delle modifiche.
- Alcuni sistemi tracciano automaticamente le modifiche ai prompt, aiutando a individuare impatti imprevisti sulla qualità dei prompt.
Schema emergente: context engineering
Con l'evolversi dell'orchestrazione LLM, è emersa una nuova disciplina: il context engineering. Si concentra sull'ottimizzazione delle informazioni incluse nell'input di un LLM, soprattutto quando si combinano recupero in tempo reale, interazioni passate e memoria per migliorare qualità ed efficienza delle risposte.
Questa pratica può essere inquadrata come uno schema di orchestrazione, in cui il contesto diventa una risorsa gestita che viene recuperata, filtrata e modellata con precisione per corrispondere all'intento dell'utente e ai limiti di token.
Gli elementi chiave di questo schema di orchestrazione includono:
- Context broker: un'unità centralizzata nel livello di orchestrazione che raccoglie e normalizza input da memoria, moduli di recupero e interazioni recenti. Garantisce coerenza in tutti i flussi di lavoro sensibili al contesto.
- Moduli e percorsi: componenti specializzati (come riassuntori, motori di retrieval o ricerche in memoria) vengono attivati selettivamente tramite meccanismi dinamici di assegnazione degli strumenti in base alla natura della query dell'utente o allo stato del sistema.
- Context packing: i contenuti recuperati e memorizzati vengono classificati, compressi e organizzati in prompt strutturati. Questo impacchettamento selettivo garantisce che le informazioni ad alto valore rientrino nella finestra di input del LLM senza superare i vincoli di token.
- Guardrail e adattamento: vincoli integrati possono imporre risposte basate solo sul recupero e gli aggiornamenti della memoria a lungo termine garantiscono che il sistema perfezioni la selezione del contesto.
Questo schema è sempre più essenziale nei sistemi che utilizzano la generazione aumentata da recupero (RAG), la collaborazione multi-agente e i copiloti basati su LLM, dove ogni query deve attivare i moduli giusti e far emergere le informazioni più rilevanti.
 Aggiungi come fonte preferita
4 best practice per l'orchestrazione LLM
1-Inizia con un'architettura solida e modulare
- Scomposizione dei compiti: definisci chiaramente il flusso di lavoro e suddividi il problema in passaggi piccoli, distinti e testabili. Progetta la pipeline in modo che le funzioni chiave (ad es. creazione dei prompt, accesso alla memoria, logica avanzata) siano isolate nei propri moduli.
- Progettazione iterativa: inizia con il prototipo funzionante più semplice (un "prodotto minimo realizzabile") e aggiungi complessità in modo incrementale. Verifica che ogni passaggio, dal recupero dei dati all'output finale, funzioni in isolamento prima di integrarlo in una catena complessa.
2-Routing dinamico e selezione dei model
- Ottimizza per costi e velocità: evita di usare il LLM più costoso e grande per ogni compito. Implementa una logica nell'orchestratore per instradare le query semplici (come classificazione o riepilogo) verso model più economici e piccoli e riservare i model di alto livello per ragionamenti complessi o analisi a più fasi.
- Agnosticismo del fornitore: struttura il livello di orchestrazione per consentire un facile passaggio tra provider di model (ad es. OpenAI, Anthropic, Google) per mitigare il vendor lock-in, gestire i limiti di velocità delle API e sfruttare i model con le migliori prestazioni man mano che il mercato evolve.
3-Implementa osservabilità e monitoraggio robusti
- Registra tutto: registra gli input e gli output di ogni passaggio della catena, non solo il risultato finale. Questo è fondamentale per il debug di flussi conversazionali a più fasi e per l'analisi delle cause radice (RCA) degli errori.
- Traccia le metriche chiave: monitora latenza, throughput, consumo di token (per il controllo dei costi) e tassi di errore dei model in tempo reale. Gli avvisi automatici dovrebbero essere configurati per segnalare immediatamente picchi di allucinazioni o guasti.
4-Verifica i guardrail di governance e sicurezza
- Controlli di pre e post-elaborazione: avvolgi tutte le chiamate ai LLM con dei guardrail. Usa controlli di pre-elaborazione (ad es. filtraggio dei contenuti, blacklist di argomenti non consentiti) sull'input dell'utente e controlli di post-elaborazione (ad es. verifica del formato strutturato dell'output, controlli di sicurezza) sulla risposta del model prima della consegna.
- Conformità: per i dati sensibili, implementa livelli di autorizzazione, anonimizzazione e crittografia nelle prime fasi del processo di progettazione per mantenere la conformità (ad es. HIPAA, GDPR).
4 sfide dell'orchestrazione LLM e strategie di mitigazione
Ecco alcuni problemi associati all'orchestrazione LLM e i metodi per affrontarli: sfide principali nell'orchestrazione multi-LLM
1.Coordinamento e deadlock del flusso di lavoro
A causa della natura non deterministica dei LLM, definire passaggi di consegna chiari tra ruoli specializzati di LLM è difficile. Ciò comporta sovrapposizione di compiti (uso ridondante di token) o deadlock del flusso di lavoro (un'istanza LLM attende indefinitamente un output ambiguo da un'altra).
Mitiga con flusso di lavoro strutturato e comunicazione
- Usa un controller del flusso di lavoro per scomporre l'obiettivo in un Directed Acyclic Graph (DAG) di sotto-attività.
- Applica un protocollo di comunicazione Pydantic/JSON per tutti i passaggi di consegna. Ciò obbliga il LLM a produrre dati leggibili dalle macchine e convalidati dallo schema, rendendo i segnali di avanzamento inequivocabili e prevenendo i cicli.
2. Deriva contestuale e incoerenza della memoria
La finestra di contesto fissa dei LLM e l'assenza di stato intrinseca li rendono inclini alla deriva contestuale, in cui un ruolo LLM dimentica l'obiettivo generale o fatti cruciali precedenti. In una configurazione multi-LLM, questo crea decisioni contrastanti e output complessivi incoerenti.
Mitiga utilizzando una knowledge base esternalizzata con RAG
- Implementa un sistema di memoria esterna (Vector Database o Knowledge Graph). I ruoli specializzati di LLM registrano fatti, decisioni e output chiave come dati strutturati. Quando un'istanza LLM ha bisogno di contesto, utilizza la Retrieval Augmented Generation (RAG) per interrogare questa fonte esterna, garantendo il recupero delle informazioni più rilevanti e non ridondanti.
3. Output non deterministico e allucinazione a cascata
L'output probabilistico dei LLM significa che le risposte sono inaffidabili. Quando un'istanza LLM (il produttore) inventa informazioni (allucina), un'istanza LLM a valle (il consumatore) le tratta come fatti, portando a un completo fallimento a cascata del flusso di lavoro multi-LLM.
Mitiga con meccanismi di consenso e validazione
- Adotta un pattern di consenso per gli output critici. Il Workflow Controller instrada l'output iniziale a un ruolo secondario di validatore LLM o a un database/API esterno per il fact-checking. Il flusso di lavoro procede se l'output viene verificato con successo, mitigando efficacemente il rischio di errori non deterministici del model.
4. Contesa delle risorse e superamento dei costi
Il ridimensionamento dei flussi di lavoro multi-LLM crea una domanda elevata per l'LLM API (una risorsa costosa e soggetta a limiti di velocità). Ciò provoca errori di superamento dei limiti (throttling delle API) e un enorme consumo di token (superamento dei costi) dovuto a lavoro ridondante o cicli.
Mitiga con accodamento asincrono e guardrail di budget
- Utilizza una coda di attività asincrona (ad es. Celery) con un limitatore di velocità per controllare la concorrenza di esecuzione delle chiamate API.
- Implementa strumenti di osservabilità per tracciare l'uso di token per ogni compito e imposta budget automatici di token (interruttori di circuito) che terminano o mettono in pausa qualsiasi istanza LLM fuori controllo, gestendo il costo operativo in tempo reale.
L'orchestrazione è un componente chiave dei LLM?
Sì. L'orchestrazione è un componente chiave nei sistemi basati su LLM, ma non è un componente core del model come i pesi del model o il tokenizer. È invece una capacità a livello di sistema che rende i LLM utilizzabili nelle applicazioni del mondo reale.
Tra i componenti essenziali, l'orchestrazione si colloca in genere accanto a:
- LLM model: un Large Language Model (LLM) elabora enormi quantità di dati per comprendere e generare testo simile a quello umano. I model open source offrono flessibilità, mentre quelli closed source offrono facilità d'uso e supporto. I LLM generici gestiscono vari compiti, mentre i model specifici per dominio si rivolgono a settori specializzati.
- Prompt: prompt efficaci guidano le risposte dei LLM.
- Prompt zero-shot: generano risposte senza esempi precedenti.
- Prompt few-shot: usano alcuni campioni per migliorare l'accuratezza. Scopri di più su few-shot learning prompting e altri metodi di fine tuning dei LLM.
- Prompt chain-of-thought: incoraggiano il ragionamento logico per risposte migliori.
- Database vettoriale: archivia dati strutturati come vettori numerici. I LLM usano ricerche di similarità per recuperare il contesto rilevante, migliorando l'accuratezza e prevenendo risposte obsolete.
- Agenti e strumenti: estendono le capacità dei LLM eseguendo ricerche web, eseguendo codice o interrogando database. Migliorano l'automazione basata sull'IA e le soluzioni aziendali.
- Orchestratore (livello di controllo): integra LLM, prompt, database vettoriali e agenti in un sistema coeso. Garantisce un coordinamento fluido per applicazioni IA efficienti.
- Monitoraggio: traccia le prestazioni, rileva anomalie e registra le interazioni. Garantisce risposte di alta qualità e aiuta a mitigare gli errori negli output dei LLM.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{LLM Orchestrazione: 21 framework e gateway}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/llm-orchestration}},
  note   = {AIMultiple. Consultato il 21 ottobre 2026}
}Risultati e timestamp di 206 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 5 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
9 aggiornamentiRimossa la sezione FAQ e la voce Nexos.ai dall'elenco dei gateway di IA.
Aggiunti i risultati del benchmark all'introduzione e a una nuova sezione.
Espansa la sezione "Strumenti di orchestrazione LLM" con una nuova categorizzazione degli strumenti in "Piattaforme basate su gateway" e "Framework per sviluppatori."
Collegamenti di riferimento










Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.