


I 7 migliori metodi per l'analisi del sentiment audio

Poiché il numero di consumatori aumenta e i dati degli utenti si accumulano quotidianamente, un'esplosione di dati non è una sorpresa. Le aziende utilizzano la raccolta e l'analisi dei dati per migliorare le vendite, le informazioni sui clienti o la reputazione del marchio. Anche se i dati vocali sono il feedback più diretto che le aziende ricevono dai clienti, spesso ne trascurano l'importanza.
Per comprendere meglio come i clienti valutano prodotti e servizi, scopri come analizzare il sentiment nei file audio e gli otto metodi principali che le aziende possono implementare:
Che cos'è l'analisi del sentiment audio?
I metodi tradizionali di analisi del sentiment si basano principalmente su testi scritti come recensioni, feedback, sondaggi, ecc. Tuttavia, poiché il linguaggio umano è complesso, sfumature come l'ironia, il sarcasmo o le intenzioni non sono sempre facilmente comprensibili nel contenuto scritto.
Il tono acustico nei file audio trasporta informazioni più ricche e fornisce migliori intuizioni sui sentimenti.1 Le informazioni sul sentiment possono essere raccolte da varie caratteristiche vocali, come2
- intonazione
- volume
- tono di voce
- altre misure relative alla frequenza
Quindi, le emozioni possono essere riconosciute meglio combinando l'analisi del tono del parlato e del contenuto scritto piuttosto che considerando solo il feedback scritto.
Negli ultimi anni, le aziende hanno iniziato a implementare metodi di analisi del sentiment per comprendere meglio i sentimenti dei loro clienti e offrire loro un'esperienza migliore.
Come funziona l'analisi del sentiment audio?
Figura 1. Un confronto semplificato tra analisi del sentiment su contenuto scritto e multimodale (testo + audio)
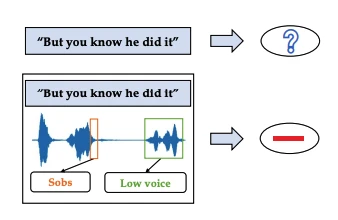
Fonte: CM-BERT: Cross-Modal BERT per l'analisi del sentiment testo-audio.3
Le fasi dell'analisi del sentiment audio sono:
1. Raccolta dell'audio
Raccolta dell'audio
Inizia raccogliendo l'audio. Puoi utilizzare registrazioni dal vivo, file preregistrati o audio provenienti da piattaforme online.
Garantire la qualità
Un audio chiaro è essenziale. Cerca di ridurre il rumore di fondo e di mantenere il suono nitido. Inoltre, assicurati che i tuoi dati siano diversificati; voci, toni ed emozioni differenti aiuteranno il tuo modello ad apprendere meglio.
Preelaborazione
Una volta raccolto, pulisci l'audio. Ciò include la rimozione del rumore, la regolazione del volume e il taglio del silenzio. Questi passaggi rendono l'audio pronto per le fasi successive.
2. Trascrizione in testo
Conversione dell'audio in testo
Gli strumenti di riconoscimento vocale trasformano le parole parlate in testo. OpenAI’s Whisper rimane una scelta comune, ma le versioni attuali, come large-v3 e il più veloce large-v3-turbo, hanno sostituito la versione del 2022 che la maggior parte delle guide cita ancora. Le opzioni più recenti, tra cui i modelli di trascrizione OpenAI GPT-4o, aggiungono l'etichettatura automatica dei parlanti. Ciò elimina la necessità di uno strumento separato per distinguere la voce di un agente da quella di un cliente in una chiamata registrata.
Pulizia del testo
Il testo trascritto potrebbe richiedere una formattazione. Potresti rimuovere la punteggiatura in eccesso, convertire tutte le parole in minuscolo o pulire i caratteri speciali.
3. Scelta del modello
Scegli un modello che funzioni bene con audio e testo. Alcuni modelli sono addestrati su linguaggio emotivo o parlato. Scegline uno con buona precisione e flessibilità.
4. Interpretazione e utilizzo dei risultati
Comprensione dei risultati
Utilizza i dati per capire come si sentono le persone. Ciò è utile in ambiti come il servizio clienti, il marketing e il feedback pubblico.
Visualizzazione dei risultati
Mostra i punteggi del sentiment in grafici, tabelle o dashboard. Ciò aiuta le persone a vedere rapidamente il tono emotivo dell'audio.
7 metodi per condurre l'analisi del sentiment audio
Esistono sette metodi principali per condurre l'analisi del sentiment audio.
1- Riconoscimento vocale automatico (ASR)
Figura 2. Un esempio di come funziona l'ASR
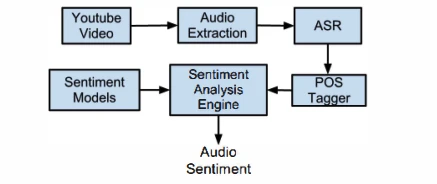
Fonte: Estrazione del sentiment da flussi audio naturali4
Processo: ASR trascrive le frasi parlate in testo utilizzando il riconoscimento vocale. Il testo trascritto viene poi analizzato per il sentiment tramite tecniche di elaborazione del linguaggio naturale (NLP).
Esempio: Nei call center, l'ASR può trascrivere le conversazioni dei clienti, consentendo ai modelli di analisi del sentiment di determinare il sentiment complessivo dell'interazione.
2- WaveNet (Analisi della forma d'onda audio grezza)
Processo: WaveNet analizza direttamente le forme d'onda audio grezze per estrarre caratteristiche audio utilizzando reti neurali profonde. Questo metodo non richiede la trascrizione audio e può catturare dettagli intricati nel segnale audio. È un metodo probabilistico che offre risultati all'avanguardia con un multimodale dataset (testo+audio).
Esempio: WaveNet può rilevare diverse emozioni dal tono e dall'intonazione dell'audio, fornendo una buona rappresentazione dello stato emotivo del parlante.
WaveNet è stato creato principalmente per generare parlato, non per valutare il sentiment. I team che oggi lavorano sul sentiment da forme d'onda grezze ricorrono più spesso a codificatori auto-supervisionati come Wav2Vec 2.0 o HuBERT, addestrati specificamente per rappresentare sia il contenuto del parlato sia i segnali vocali come il tono.5 L'idea centrale di WaveNet, apprendere direttamente dalla forma d'onda invece che da caratteristiche costruite a mano, è ancora valida. Il modello specifico è stato in gran parte sostituito da questi nuovi codificatori.
3- Rappresentazioni di encoder bidirezionale crossmodale da transformer (CM-BERT)
Figura 3. L'architettura della rete CM-BERT
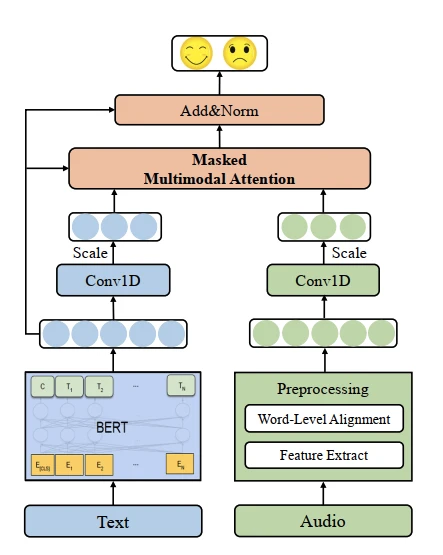
Fonte: CM-BERT: Cross-Modal BERT per l'analisi del sentiment testo-audio.3
Processo: L'approccio CM-BERT si basa sull'interazione tra testo e audio e regola dinamicamente il peso delle parole confrontando le informazioni provenienti da diverse modalità. Utilizza modelli di machine learning per analizzare sia il segnale audio sia la sua trascrizione, sfruttando i punti di forza di entrambe le modalità.
Esempio: In un progetto che analizza registrazioni audio di podcast, CM-BERT può fornire informazioni sul sentiment espresso sia nelle parole parlate sia nelle caratteristiche audio.
4- Coefficienti cepstrali a frequenza Mel (MFCC)
Processo: Gli MFCC sono utilizzati per rappresentare lo spettro di potenza a breve termine del suono. Vengono estratti dalle registrazioni audio e utilizzati come caratteristiche per i modelli di analisi del sentiment.
Esempio: Analizzando gli MFCC, i modelli di machine learning possono riconoscere diversi stati emotivi nei file audio, come felicità, tristezza o rabbia.
Gli MFCC funzionano ancora come un insieme di caratteristiche leggero e veloce, e rimangono una scelta predefinita ragionevole per i team con budget di calcolo limitati. I modelli auto-supervisionati più recenti, come Wav2Vec 2.0, HuBERT e emotion2vec, superano ora i sistemi basati su MFCC nella maggior parte dei benchmark pubblicati, poiché apprendono le caratteristiche direttamente dall'audio grezzo invece di basarsi su una formula fissa.6 I team che puntano alla massima precisione tendono a scegliere uno di questi.
5- Analisi delle caratteristiche prosodiche
Processo: Questo metodo analizza caratteristiche prosodiche come intonazione, accento e ritmo nel parlato. Queste caratteristiche sono cruciali per comprendere il tono emotivo nelle registrazioni audio.
Esempio: L'analisi delle caratteristiche prosodiche può essere utilizzata nelle interazioni con il servizio clienti per identificare stress o frustrazione nella voce di un cliente, contribuendo a migliorare l'interfaccia utente e le strategie di risposta.
6- Reti neurali profonde (DNN)
Processo: Le DNN possono essere addestrate su grandi dataset di registrazioni audio per riconoscere pattern e classificare i sentimenti. Sono in grado di apprendere rappresentazioni complesse dei dati audio.
Esempio: Le DNN possono essere impiegate in progetti di analisi del sentiment in cui è richiesta un'elevata precisione, come nei post audio sui social media per valutare l'opinione pubblica.
emotion2vec, rilasciato nel 2024 e mantenuto attivamente fino al 2026, è un modello open-source addestrato specificamente per estrarre segnali emotivi dall'audio grezzo.7 Funziona su una singola GPU, è gratuito da usare, ed è diventato una baseline comune nella ricerca sulle emozioni nel parlato: il ruolo che Whisper svolge per la trascrizione.
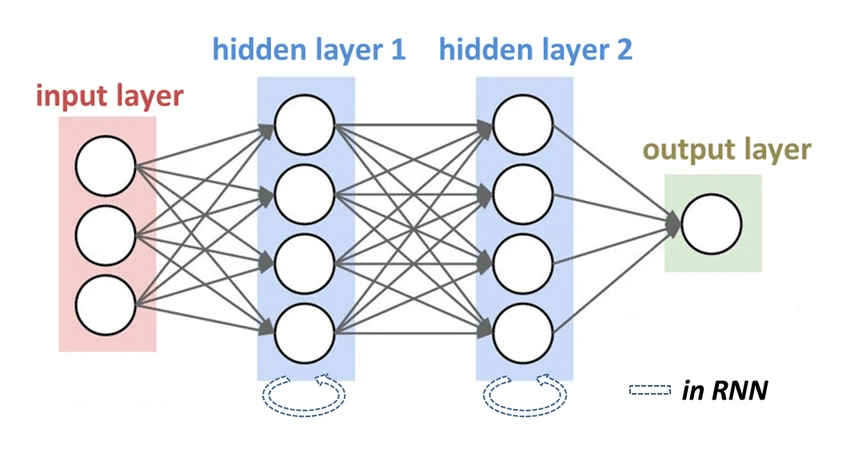
7- Reti neurali ricorrenti (RNN) e reti a memoria a lungo breve termine (LSTM)
Figura 4. Reti neurali ricorrenti con due strati nascosti
Fonte: Classificazione e previsione di sistemi caotici d'onda con tecniche di machine learning.8
Processo: Le RNN e le LSTM sono progettate per gestire dati sequenziali, rendendole adatte ad analizzare le dipendenze temporali nei segnali audio. Possono catturare la progressione delle emozioni.
Esempio: Nell'analizzare registrazioni audio lunghe come interviste o discorsi, le RNN e le LSTM possono tracciare i cambiamenti del sentiment lungo l'intero file audio.
8- Grandi modelli audio-linguaggio (LALM)
Processo: Un grande modello audio-linguaggio legge audio e testo in un'unica passata, all'interno di un singolo modello. I metodi più vecchi dividono il lavoro in due: un modello trasforma il parlato in testo e un modello separato legge quel testo per il sentiment. Dividere il lavoro fa perdere informazioni; un piatto e impassibile “Che bello” può risultare positivo quando si valutano le parole. Un grande modello audio-linguaggio mantiene insieme tono, ritmo e scelta delle parole, quindi coglie quella discrepanza.
Esempi in produzione includono OpenAI’s GPT-4o Audio, Google’s Gemini 2.5 e Qwen2.5-Omni di Alibaba. Ognuno accetta direttamente una clip audio e restituisce una trascrizione, un'etichetta emotiva o entrambe, senza esporre un passaggio di trascrizione separato.
Esempio: Una piattaforma di supporto instrada una chiamata di un cliente direttamente a uno di questi modelli. Restituisce una trascrizione, un punteggio di sentiment e una nota su dove il tono è cambiato durante la chiamata, tutto da un'unica passata sull'audio.
Compromesso: Questi modelli costano di più da eseguire per minuto di audio rispetto a modelli più piccoli e costruiti per compiti specifici. I team che gestiscono volumi di chiamate elevati spesso eseguono un modello open-source leggero, come emotion2vec, come primo passaggio, quindi inviano le chiamate segnalate a un modello più grande per una lettura più approfondita.9
Le 8 principali applicazioni dell'analisi del sentiment audio
L'analisi del sentiment audio ha un'ampia gamma di applicazioni in vari settori, migliorando i processi e fornendo preziose informazioni in tutti i settori industriali.
1- Call center
Nei call center, l'analisi del sentiment audio viene utilizzata per analizzare le interazioni con i clienti. Eseguendo l'analisi del sentiment sulle registrazioni audio, le aziende possono determinare il sentiment espresso durante le chiamate, sia positivo, negativo o neutro. Queste informazioni possono aiutare a migliorare il servizio clienti tramite:
- Identificazione dei problemi: Rilevare precocemente i sentimenti negativi consente agli agenti del call center di affrontare le preoccupazioni dei clienti in modo più efficace.
- Finalità di formazione: Comprendere gli stati emotivi dei clienti durante le chiamate può essere utilizzato per addestrare gli agenti, migliorando la loro capacità di gestire emozioni diverse.
- Assicurazione della qualità: I risultati dell'analisi del sentiment possono essere utilizzati per monitorare e mantenere la qualità del servizio, garantendo una soddisfazione costante del cliente.
2- Riconoscimento delle emozioni
Rilevare diverse emozioni nelle registrazioni audio può migliorare significativamente le interfacce utente e creare sistemi di intelligenza artificiale più empatici. Il riconoscimento delle emozioni tramite l'analisi del sentiment audio comporta:
- Esperienze personalizzate: Adattare le risposte in base alle emozioni rilevate per fornire un'esperienza utente più personalizzata e coinvolgente.
- Applicazioni per la salute mentale: Il monitoraggio degli stati emotivi può aiutare nelle applicazioni per la salute mentale riconoscendo segni di stress, ansia o depressione nelle registrazioni audio.
- Assistenti virtuali: Migliorare le interazioni degli assistenti virtuali consentendo loro di rispondere in modo più appropriato al tono emotivo dell'utente.
3- Ricerche di mercato
Nelle ricerche di mercato, l'analisi del sentiment audio dei file audio provenienti da focus group o feedback dei clienti può fornire informazioni preziose. Analizzando i sentimenti nelle risposte parlate, le aziende possono:
- Comprendere le preferenze dei consumatori: Ottenere informazioni sulle opinioni dei clienti riguardo a prodotti o servizi, aiutando le aziende a prendere decisioni informate.
- Sviluppo del prodotto: Utilizzare i dati del sentiment per guidare lo sviluppo e il miglioramento dei prodotti in base al feedback dei clienti.
- Percezione del marchio: Monitorare e analizzare il sentiment pubblico verso un marchio, consentendo alle aziende di adeguare le proprie strategie di conseguenza.
4- Monitoraggio dei social media
L'analisi del sentiment audio può anche essere applicata ai file audio provenienti da podcast o contenuti video condivisi sulle piattaforme di social media. Questa applicazione aiuta a:
- Analisi dell'opinione pubblica: Analizzare i sentimenti nei contenuti parlati per valutare l'opinione pubblica su vari argomenti.
- Strategia dei contenuti: Influenzare le strategie di creazione dei contenuti comprendendo le reazioni emotive del pubblico a diversi tipi di contenuto.
- Analisi delle tendenze: Identificare tendenze emergenti e sentimenti nelle conversazioni sui social media, consentendo alle aziende di stare al passo con i loro sforzi di marketing.
5- Sanità
Nel settore sanitario, l'analisi del sentiment audio può essere applicata alle interazioni paziente-medico, alle consultazioni di telemedicina e al feedback dei pazienti. Ciò può portare a:
- Cura del paziente migliorata: Comprendere le emozioni del paziente può aiutare i fornitori di assistenza sanitaria a offrire cure più empatiche e personalizzate.
- Rilevazione precoce delle condizioni: Riconoscere i cambiamenti nello stato emotivo di un paziente può aiutare nella diagnosi precoce di problemi di salute mentale o altre condizioni.
- Soddisfazione del paziente: Analizzare il feedback dei pazienti per migliorare la qualità dei servizi sanitari e garantire la soddisfazione del paziente.
6- Istruzione
Negli ambienti educativi, l'analisi del sentiment audio può essere utilizzata per analizzare le interazioni degli studenti, il feedback degli insegnanti e le discussioni in classe. Ciò può supportare:
- Coinvolgimento degli studenti: Comprendere le risposte emotive degli studenti può aiutare gli educatori ad adattare i loro metodi di insegnamento per mantenere gli studenti coinvolti.
- Monitoraggio delle prestazioni: Monitorare il sentiment nel feedback degli studenti può fornire informazioni sull'efficacia dei programmi educativi e delle strategie di insegnamento.
- Supporto emotivo: Identificare gli studenti che potrebbero aver bisogno di supporto emotivo aggiuntivo, consentendo un intervento tempestivo.
7- Industria dell'intrattenimento
L'industria dell'intrattenimento può sfruttare l'analisi del sentiment audio per analizzare le reazioni del pubblico a film, musica e altri contenuti multimediali. Ciò può portare a:
- Miglioramento dei contenuti: Utilizzare i risultati dell'analisi del sentiment per migliorare sceneggiature, dialoghi e contenuti complessivi in base alle reazioni del pubblico.
- Strategie di marketing: Adattare le campagne di marketing per risuonare meglio con le risposte emotive del pubblico.
- Coinvolgimento del pubblico: Creare contenuti più coinvolgenti ed emotivamente risonanti comprendendo i sentimenti del pubblico.
8- Risorse umane
Nelle risorse umane, l'analisi del sentiment audio può essere applicata al feedback dei dipendenti, ai colloqui e alle valutazioni delle prestazioni. Ciò può migliorare:
- Soddisfazione dei dipendenti: Analizzare i sentimenti nel feedback dei dipendenti per migliorare le condizioni di lavoro e affrontare le preoccupazioni.
- Processi di assunzione: Comprendere le risposte emotive dei candidati durante i colloqui per prendere decisioni di assunzione migliori.
- Gestione delle prestazioni: Utilizzare i dati del sentiment per supportare le valutazioni delle prestazioni e fornire feedback costruttivo.
Regole da conoscere prima di implementare l'analisi del sentiment audio nell'UE
La legge sull'IA dell'UE vieta un uso specifico di questa tecnologia: dedurre le emozioni di un dipendente dalla sua voce sul lavoro. Tale divieto, ai sensi dell'articolo 5, paragrafo 1, lettera f), è una delle disposizioni sulle pratiche vietate della legge, e si applica dal 2 febbraio 2025.10 I regolatori nazionali, tra cui la CNIL francese, hanno pubblicato orientamenti su come prepararsi all'applicazione mentre il resto della legge entra gradualmente in vigore: le norme sull'IA per scopi generali sono entrate in vigore nell'agosto 2025, e la maggior parte delle disposizioni rimanenti raggiungerà la piena applicazione il 2 agosto 2026.
Cosa è vietato
- Leggere le emozioni dalla voce, dal volto o da altri segnali biometrici di un dipendente durante le attività lavorative, i colloqui o le valutazioni delle prestazioni.
Cosa non è coperto dal divieto
- Sistemi che trascrivono una riunione in testo.
- Sistemi incentrati sulla sicurezza, come strumenti che rilevano l'affaticamento del conducente.
Le due eccezioni
- Uso medico.
- Uso per la sicurezza.
- Valutare il livello di stress di un agente del servizio clienti a fini di coaching non rientra in nessuna delle due.
L'uso rivolto al cliente è trattato diversamente: Leggere l'umore di un cliente durante una chiamata di supporto non è vietato dalla legge dell'UE. Al di fuori del divieto sul posto di lavoro e nell'istruzione, tuttavia, alcune implementazioni di riconoscimento delle emozioni possono ancora essere classificate come ad alto rischio ai sensi di una parte separata della legge (Allegato III) e possono comportare obblighi di trasparenza aggiuntivi ai sensi dell'articolo 50. La classificazione dipende dall'implementazione specifica, non dal caso d'uso nel suo complesso.11
Sanzioni: Le multe per la violazione del divieto sul posto di lavoro raggiungono 35 milioni di euro o il 7% del fatturato annuo globale di un'azienda, a seconda di quale sia più alto.12 Anche prima che questo divieto esistesse, l'autorità ungherese per la protezione dei dati ha ordinato a una banca di smettere di analizzare il tono di voce dei dipendenti ai sensi delle norme GDPR separate, in quello che oggi è noto come il caso Budapest Bank: un segno che i regolatori consideravano questo un problema ai sensi della vecchia legge sulla privacy.13
Cosa significa questo per i metodi sopra
- Valutare il sentiment del cliente in un call center rimane fattibile in tutta l'UE, soggetto ai controlli ad alto rischio e di trasparenza sopra indicati.
- Applicare lo stesso punteggio alla voce di un agente, per tracciare l'umore o lo stress durante un turno, è vietato ai sensi dell'articolo 5, paragrafo 1, lettera f), a meno che non si applichi l'eccezione medica o di sicurezza.
- I casi d'uso per colloqui e valutazioni delle prestazioni, menzionati nella sezione delle risorse umane sopra, sono di solito vietati del tutto piuttosto che semplicemente ad alto rischio. Trattali come off-limits nelle implementazioni nell'UE senza una giustificazione medica o di sicurezza confermata, non come una “revisione prima del lancio”.
Quanto hanno successo gli strumenti di analisi del sentiment audio?
Un benchmark del 2025, AHELM, ha testato come i grandi modelli audio-linguaggio gestiscono specificamente il rilevamento delle emozioni, insieme ad altri nove compiti di comprensione audio.14 Google’s Gemini 2.5 Pro ha guidato il gruppo complessivamente, primeggiando in cinque delle dieci categorie, incluso il rilevamento delle emozioni. Nessun singolo modello ha guidato ogni categoria. La scelta di un modello dipende ancora dal caso d'uso specifico, non da una posizione in classifica.
Un esperimento di benchmarking del 2026 ha valutato quanto bene i modelli moderni rilevano il sentiment direttamente dai segnali vocali.15 I risultati mostrano che l'analisi del sentiment basata sull'audio può catturare segnali emotivi come tono, intonazione e velocità del parlato. Questi segnali spesso vanno persi quando il parlato viene convertito in testo.
Lo studio ha testato diversi modelli vocali noti, tra cui HuBERT,16 Wav2Vec,17 e Whisper.18 Quando i modelli hanno analizzato brevi frasi pronunciate con toni emotivi diversi, le prestazioni erano relativamente buone. La precisione variava da 78–91%, indicando che questi modelli possono rilevare segnali emotivi chiari nel parlato controllato.
Tuttavia, le prestazioni sono diminuite quando i modelli sono stati testati su frasi più complesse e varie. In questi casi, la precisione è scesa a circa 54–60%. I modelli hanno avuto difficoltà perché il significato della frase, lo stile del parlante e il contesto variavano più ampiamente.
Nel complesso, i risultati suggeriscono che gli strumenti di analisi del sentiment audio possono funzionare bene quando i segnali emotivi sono chiari. Tuttavia, le loro prestazioni diminuiscono nelle conversazioni realistiche. Per questo motivo, molti sistemi combinano segnali audio e analisi del testo per migliorare l'affidabilità.
 Aggiungi come fonte preferita
Ulteriori letture
- Strumenti open source per l'analisi del sentiment
- Test di benchmark per l'analisi del sentiment
- Strumenti di ottimizzazione per motori di risposta
- Strumenti di Emotion IA testati
Link esterni
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{phd2026,
  author = {PhD., Ezgi Arslan,},
  title  = {{I 7 migliori metodi per l'analisi del sentiment audio}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/audio-sentiment-analysis}},
  note   = {AIMultiple. Consultato il 3 luglio 2026}
}
Registro delle modifiche
6 aggiornamentiAggiunta una sezione sui grandi modelli audio-linguaggio come ottavo metodo.
Rimosso un link a un articolo correlato nella sezione 'Scelta di un modello di analisi del sentiment'.
Collegamenti di riferimento
Prossimo da leggere
Ottimizzazione dei costi di Kubernetes: 8 passaggi, 23 strumenti e casi di studio

Come configurare le impostazioni del server proxy su Android

I migliori server proxy di Spotify e impostazioni proxy

Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.