


Modelli multimodali di grandi dimensioni (LMM) vs LLM

Valuta i LLM e gli LMM confrontando i loro punteggi benchmark e la latenza nel mondo reale cliccando sul nome del modello nella tabella sottostante. Puoi anche valutare i prezzi di input e output per giudicare l'efficienza e il valore complessivi.
Modelli multimodali di grandi dimensioni open-weight
*L'audio è nativo solo sui modelli E2B, E4B e 12B.
Gemma 4 (Google DeepMind)
Disponibile in cinque dimensioni: E2B, E4B, 12B, 26B A4B e 31B. La famiglia elabora testo e immagini con proporzioni e risoluzioni variabili su tutti i modelli. Supporta anche video e audio, con audio nativo solo sui modelli E2B, E4B e 12B.1
La variante 12B è la più notevole dal punto di vista architetturale. Google ha sostituito l'encoder visivo con un modulo di embedding leggero e ha rimosso completamente l'encoder audio, proiettando il segnale audio grezzo nello stesso spazio dimensionale dei token di testo. Senza encoder multimodali nella pipeline, la latenza diminuisce e il modello diventa abbastanza piccolo da funzionare su una GPU per laptop con 16GB di memoria.
Kimi K3 (Moonshot IA)
Un modello da 2.8T parametri costruito su Kimi Delta Attention e Attention Residuals, con capacità visive native e una finestra di contesto da un milione di token. Moonshot lo descrive come il primo modello aperto nella classe da 3 trilioni di parametri.
Il suo encoder visivo, MoonViT-V2, è stato addestrato da zero mediante l'obiettivo di previsione del token successivo del modello e non è stato inizializzato da un modello visivo pre-addestrato in modo contrastivo come SigLIP.2
MiniMax M3
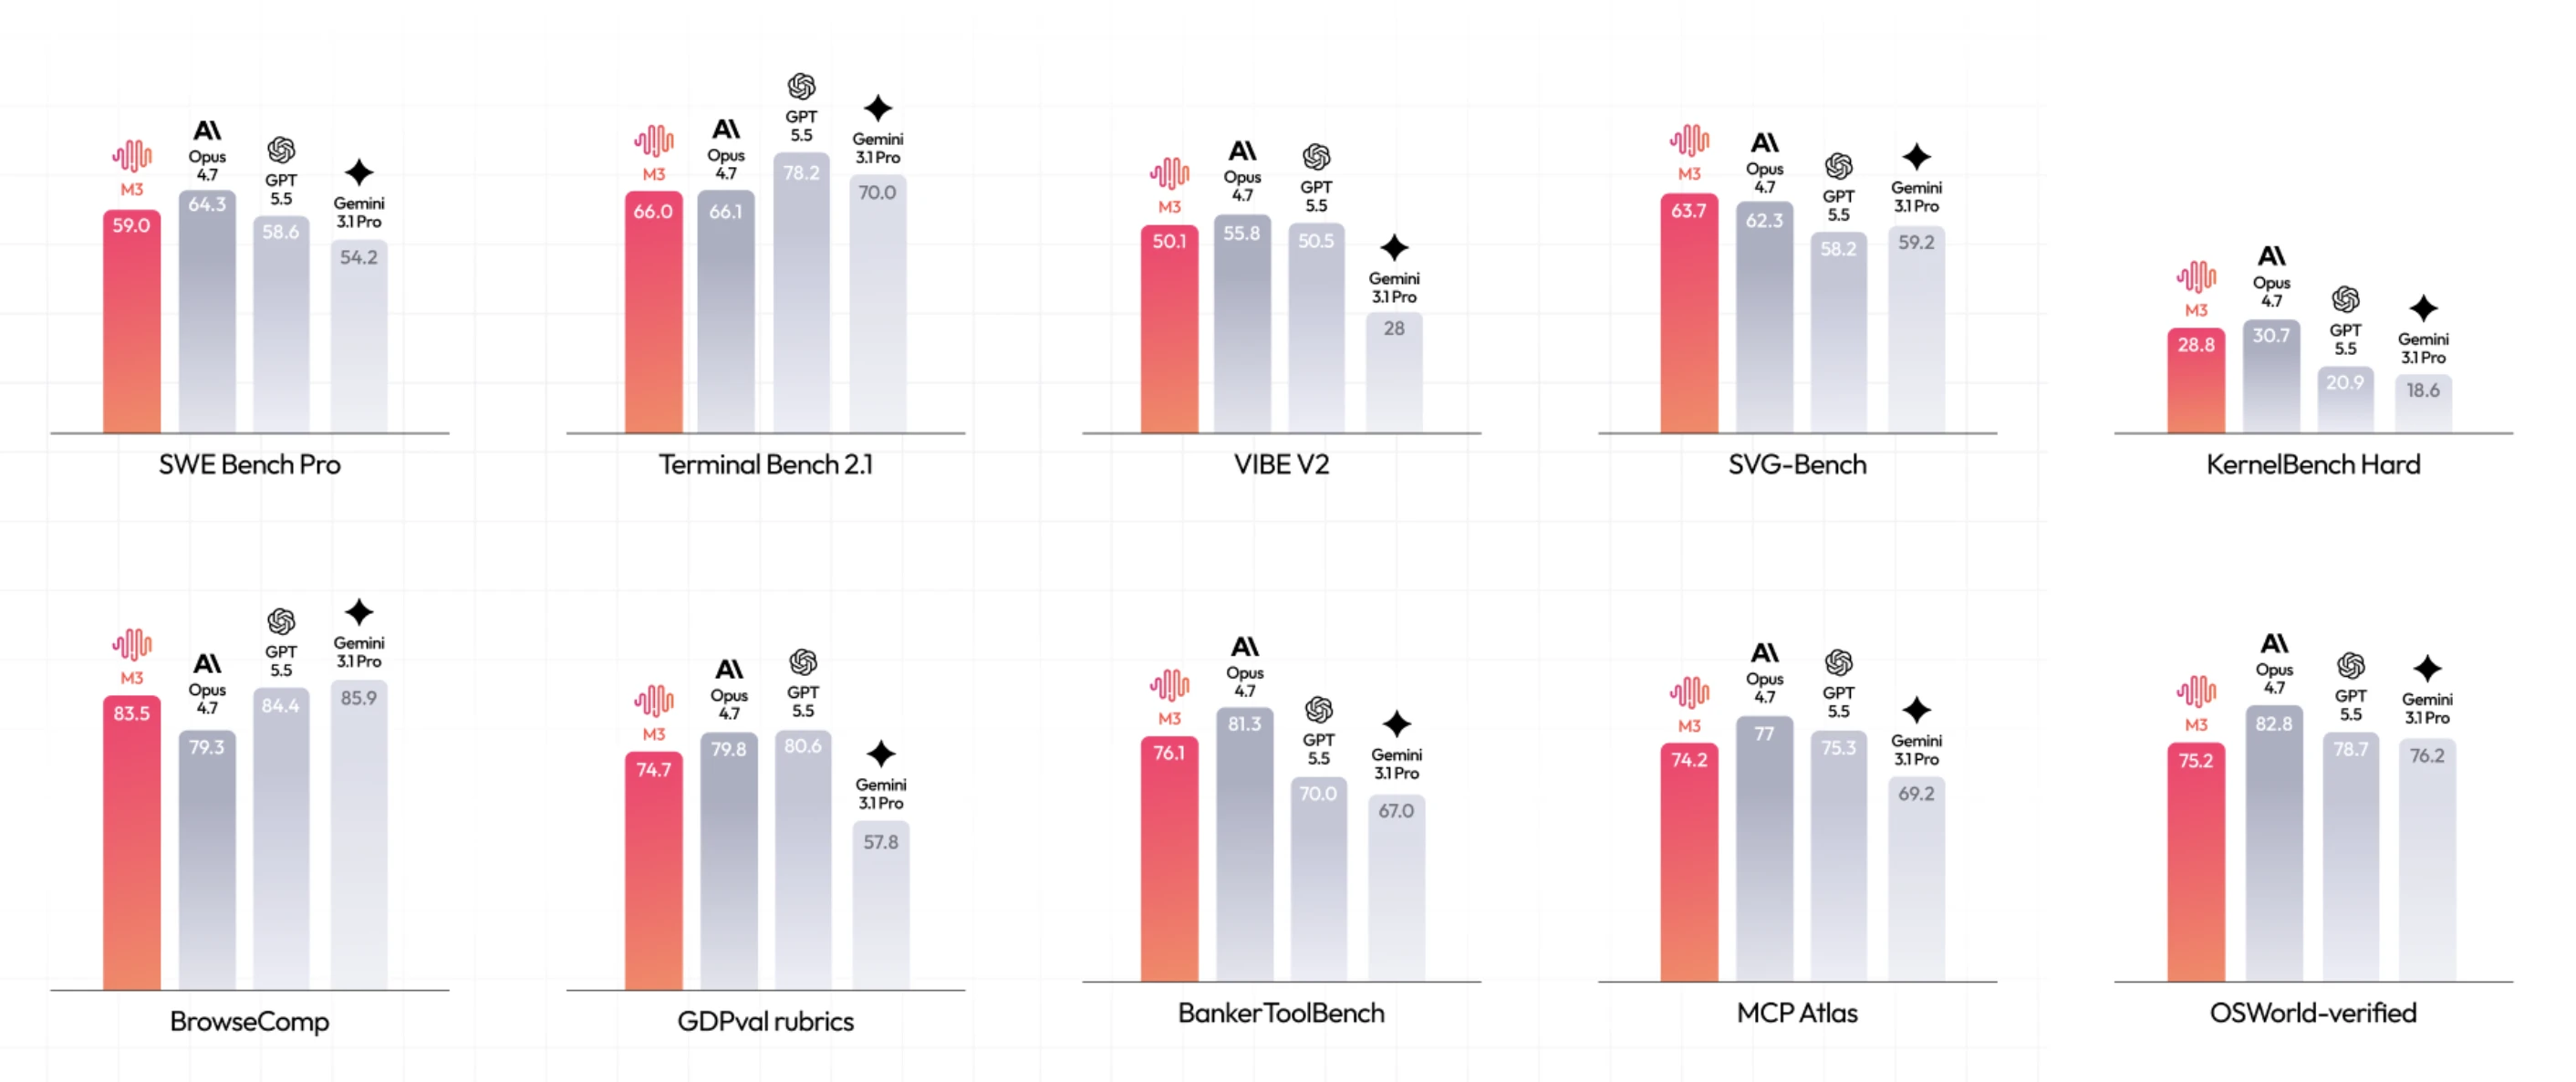
Un modello multimodale nativo con circa 428B parametri e 23B attivi, addestrato su modalità miste (testo, immagine e video). MiniMax lo presenta come il primo modello open-weight a combinare prestazioni di coding all'avanguardia, una finestra di contesto da 1M token e multimodalità nativa in un unico sistema. Può anche controllare un computer desktop da screenshot.
Figura 1: Risultati benchmark di MiniMax M3.3
GLM-5.3-Flash (Z.ai)
Il primo modello multimodale nativo della serie GLM-5, con 320B parametri totali e 18B attivati, e il primo modello open-source di frontiera a combinare attenzione sparsa e lineare.
Z.ai riferisce che il design ibrido riduce il calcolo dell'attenzione e la cache KV di 3.01x e 4.44x rispetto a GLM-5.3.4
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash è il modello più piccolo della famiglia di architetture di DeepSeek e il primo della linea a supportare la comprensione visiva nativa.
Utilizza un design a miscela di esperti da 552 miliardi di parametri con un'architettura Causal Encoder-Decoder, attivando otto miliardi di parametri per l'input e 16 miliardi per l'output. Ha sostituito sia V4 Flash sia il modello sperimentale V4 Flash Vision Exp, i cui nomi ora indirizzano al nuovo endpoint per compatibilità.5
Modelli multimodali di grandi dimensioni proprietari
GPT-6 Astra (OpenAI)
OpenAI posiziona Astra come lo stato dell'arte in uso del computer, navigazione, ingegneria del software, sicurezza informatica, scienza e lavoro professionale, con un punteggio del 98% su FrontierMath Tier 4 e del 99,9% su ARC-AGI-3.6
È il primo modello dell'azienda a raggiungere il livello Critical di capacità di sicurezza informatica nell'ambito del suo Preparedness Framework e la versione pubblicamente disponibile di conseguenza rifiuta il lavoro informatico avanzato. Il modello accetta testo e immagini e restituisce testo.
Gemini Omni (Google DeepMind)
Gemini Omni è la famiglia di modelli generativi nativamente multimodali di Google e la sua prima release è Gemini Omni Flash.
Google lo descrive come un modello in grado di creare qualsiasi cosa da qualsiasi input, a partire dal video: gli utenti forniscono qualsiasi combinazione di immagini, audio, video e testo e ricevono video fondati sulla conoscenza del mondo reale di Gemini, che possono poi rivedere tramite conversazione anziché rigenerare da zero.7
Qwen3.8-Omni-Flash (Alibaba)
Qwen3.8-Omni-Flash accetta testo, immagine, audio e video in un unico contesto da 1M token, gestisce fino a un'ora di audio e video continui per chiamata e restituisce testo.
Dato un video e una domanda, identifica ciò che merita ulteriori indagini, cerca fonti multimodali sul web e produce un rapporto di ricerca illustrato. Gli utenti possono accedervi solo tramite l'API ospitata, senza pesi aperti al lancio.
Claude Opus 5 (Anthropic)
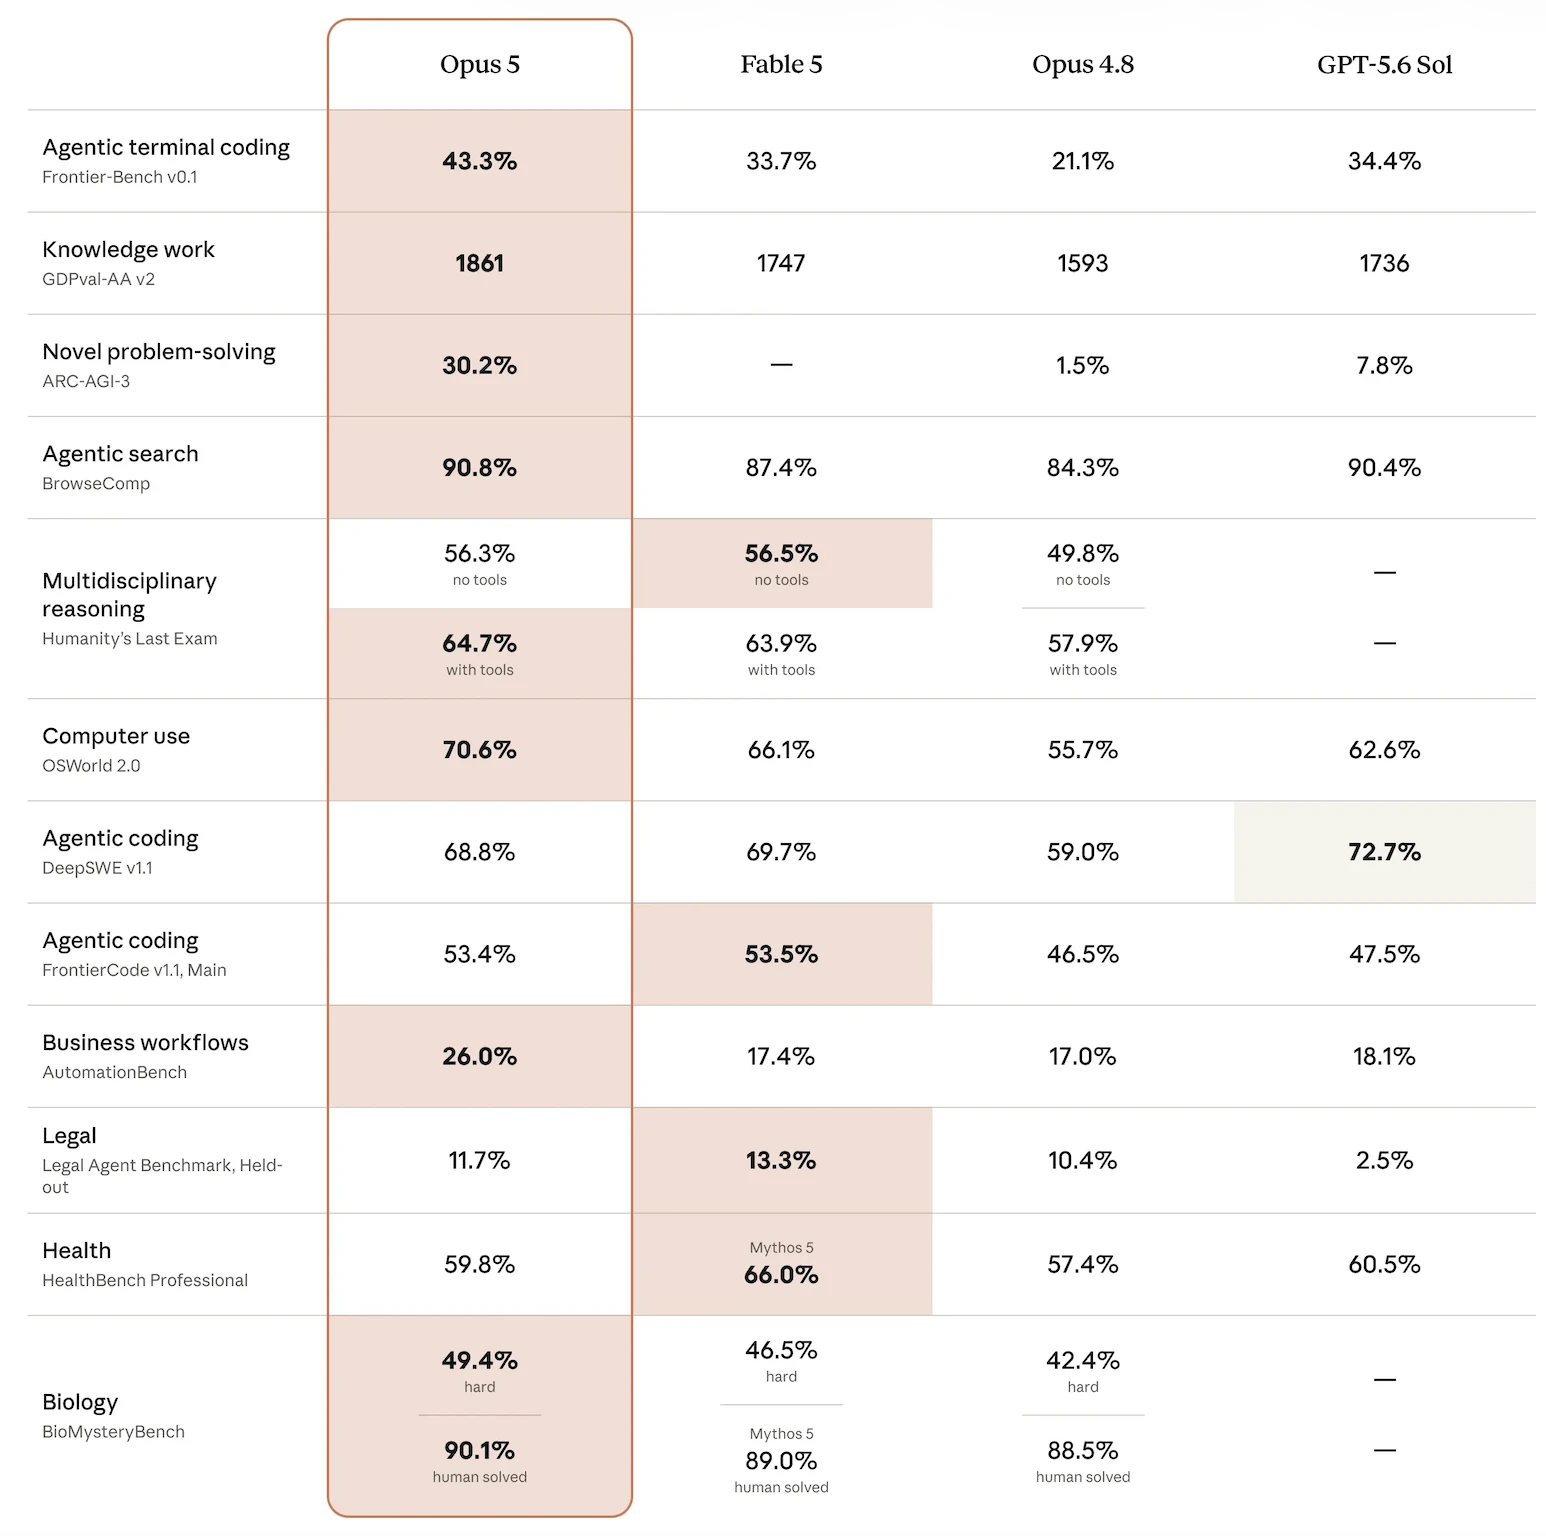
Il modello Opus 5 di Anthropic è posizionato come prossimo all'intelligenza di frontiera di Claude Fable 5 a metà del costo. Nelle valutazioni di coding e lavoro di conoscenza, tra cui Frontier-Bench e GDPval-AA, Anthropic lo segnala come stato dell'arte, pur osservando che è inferiore a Mythos 5 nei compiti di sicurezza informatica.
Il prezzo è di $5 per un milione di token di input e di $25 per un milione di token di output, come per Opus 4.8, con una modalità Fast che funziona a circa due volte e mezza la velocità predefinita al doppio della tariffa base.
Figura 2: Risultati benchmark di Claude Opus 5.8
Grok 4.6 (xAI)
Basato su Grok 4.5, si concentra su agenti di lunga durata e su lavori interattivi e visivi più ambiziosi, mantenendo un compito attraverso molti passaggi sia che si tratti di fare ricerche su un argomento, lavorare su una codebase o trasformare un'idea in un'applicazione finita.
Nelle valutazioni pubblicate da xAI, Grok 4.6 raggiunge il 69,9% su CursorBench v3.2, davanti a GPT-5.6 Sol Max con il 67,2% e appena dietro Fable 5 Max con il 70,5%, e registra il punteggio più alto dei quattro modelli confrontati su Harvey LAB con il 15,8%. Il prezzo parte da $2 per un milione di token di input e $6 per un milione di token di output, con una variante fast al doppio di tale tariffa.9
Muse Spark (Meta)
Muse Spark è il primo modello della famiglia Muse di Meta Superintelligence Labs. Meta lo descrive come un modello di ragionamento nativamente multimodale che supporta l'uso di strumenti, la catena di pensiero visiva e l'orchestrazione multi-agente.
Il modello integra informazioni visive tra domini e strumenti e ottiene buoni risultati su domande STEM visive, riconoscimento di entità e localizzazione. I casi d'uso includono la creazione di piccoli giochi o la risoluzione di problemi di un elettrodomestico con annotazioni disegnate su ciò che la fotocamera vede.
Per la salute, Meta ha collaborato con più di mille medici per curare i dati di addestramento e il modello produce display interattivi che spiegano informazioni come il contenuto nutrizionale degli alimenti o i muscoli coinvolti durante un determinato esercizio.
Amazon Nova 2 Omni
Amazon Nova 2 Omni elabora input di testo, immagini, video e parlato generando sia testo sia immagini, gestendo fino a 750.000 parole, ore di audio, video lunghi e documenti di cento pagine in un'unica passata.
A fine luglio, il modello è in accesso anticipato per i clienti Nova Forge.10
Quali sono le differenze tra LMM e LLM?
Come funzionano gli LMM?
I modelli multimodali di grandi dimensioni condividono somiglianze con i modelli linguistici di grandi dimensioni in addestramento, progettazione e funzionamento. Utilizzano la stessa architettura transformer e le stesse strategie di addestramento. I modelli multimodali di grandi dimensioni sono addestrati su:
- Dati testuali
- Milioni o miliardi di immagini con descrizioni testuali
- Clip video
- Frammenti audio
- Altri dati di input, come il codice
Questo addestramento comporta l'apprendimento simultaneo di più modalità di dati, consentendo al modello di:
- Riconoscere una foto di un gatto
- Identificare una parola in una clip audio
- Comprendere concetti e dettagli sensoriali oltre il testo
In questo modo, gli utenti possono caricare:
- Un'immagine per:
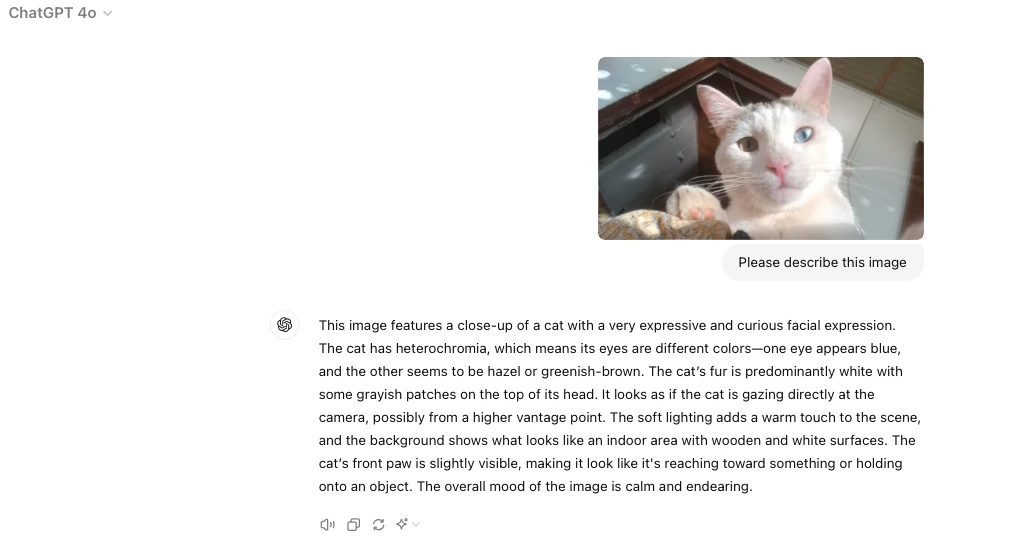
- Ottenere una descrizione di ciò che sta accadendo
- Usare l'immagine come parte di un prompt per generare testo o immagini
- Fare domande di follow-up su elementi specifici dell'immagine
- Tradurre il testo dell'immagine in una lingua diversa (ad es. Menu)
Figura 3: Caricamento di un'immagine di un gatto su ChatGPT per descriverla.
- Grafici e diagrammi per:
- Fare domande di follow-up complesse su ciò che mostrano
- Mockup di design per:
- Ottenere il codice HTML e CSS necessario per crearlo.
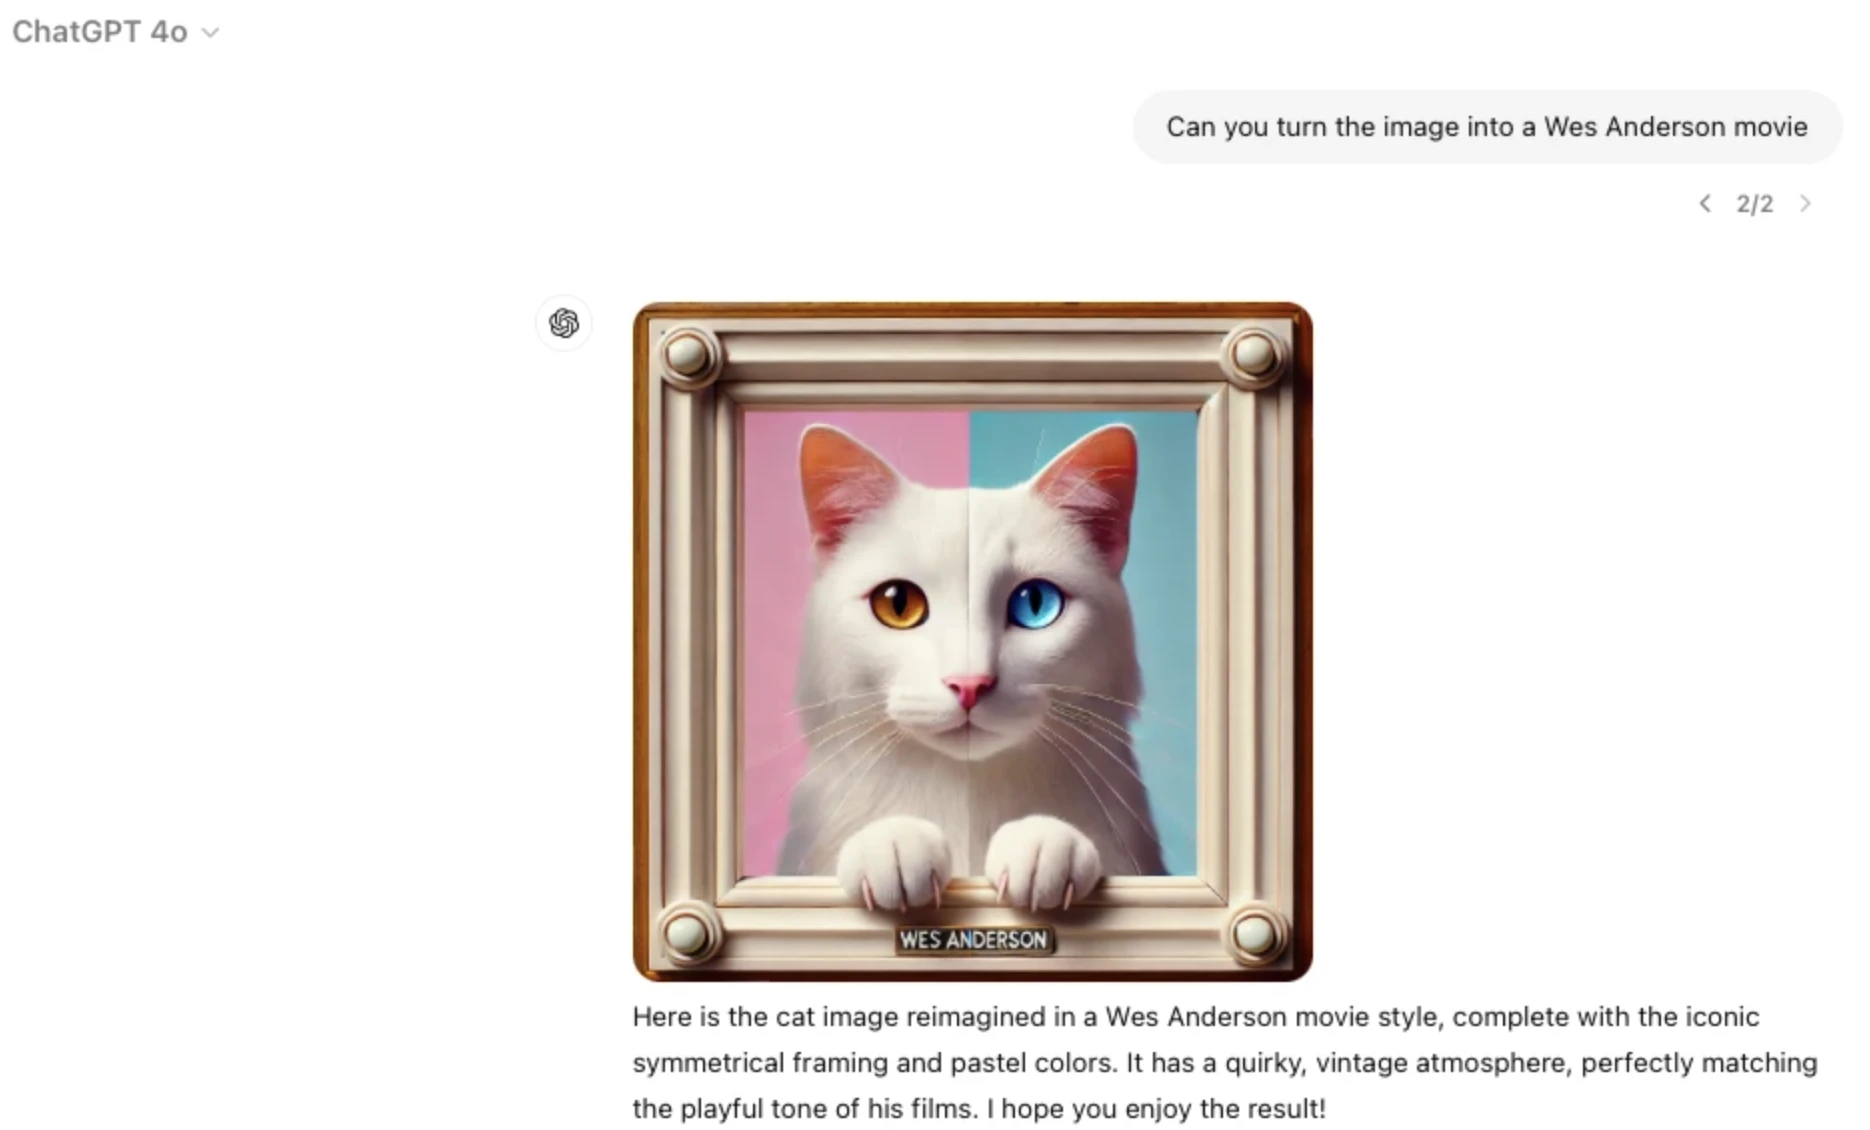
Figura 4: Fornire un prompt all'immagine in stile film di Wes Anderson. ChatGPT inserisce il prompt in un modello di generazione di immagini (come DALL·E), che interpreta la richiesta e produce l'immagine stilizzata.
Dopo l'addestramento, i modelli potrebbero incorporare stereotipi malsani e idee tossiche. Per perfezionarli, tecniche come:
- Apprendimento per rinforzo con feedback umano (RLHF)
- Modelli di IA supervisionati
- Red teaming (testare la robustezza del modello) possono essere utilizzati.
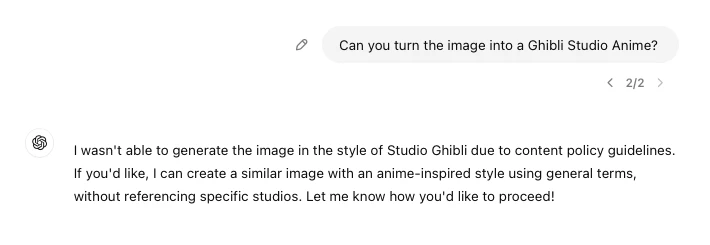
Figura 5: ChatGPT rifiuta la mia richiesta a causa delle linee guida della policy sui contenuti per proteggere i diritti d'autore.
L'obiettivo è sviluppare un sistema multimodale funzionale in grado di gestire:
- Sintesi testo-immagine
- Didascalizzazione di immagini
- Recupero di immagini basato su testo
- Risposta a domande visive.
 Aggiungi come fonte preferita
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Modelli multimodali di grandi dimensioni (LMM) vs LLM}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-multimodal-models}},
  note   = {AIMultiple. Consultato il 21 settembre 2026}
}Risultati e timestamp di 19 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 3 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
22 aggiornamentiSostituita la voce del modello Qwen3-VL con Qwen2.5-VL nella sezione prodotti.
Aggiunta una sezione su Gemini 3 e sostituite le voci Qwen2.5-VL con descrizioni del modello Qwen3-VL.
Aggiunti i modelli fondamentali multimodali "Video-first", la versione "Mistral 3 multimodal frontier" e i modelli di visione-linguaggio MoE open source alla sezione sui recenti progressi nei modelli multimodali.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.