


Top 6 Ferramentas de Código Aberto para Análise de Logs: Wazuh, Graylog e Mais
Como CISO em um setor altamente regulamentado com cerca de 2 décadas de experiência em segurança cibernética, trabalhei com múltiplas plataformas de análise de logs semelhantes a SIEM. A partir delas, selecionei as 6 principais ferramentas de código aberto para análise de logs. Ao avaliar essas ferramentas, concentrei-me em fatores-chave como flexibilidade de coleta de logs, detecção de eventos em tempo real, escalabilidade e suporte a vários formatos de logs.
Recursos de gerenciamento e detecção de logs
Recursos de integridade e não repúdio
Preços das ferramentas de análise de logs
Wazuh
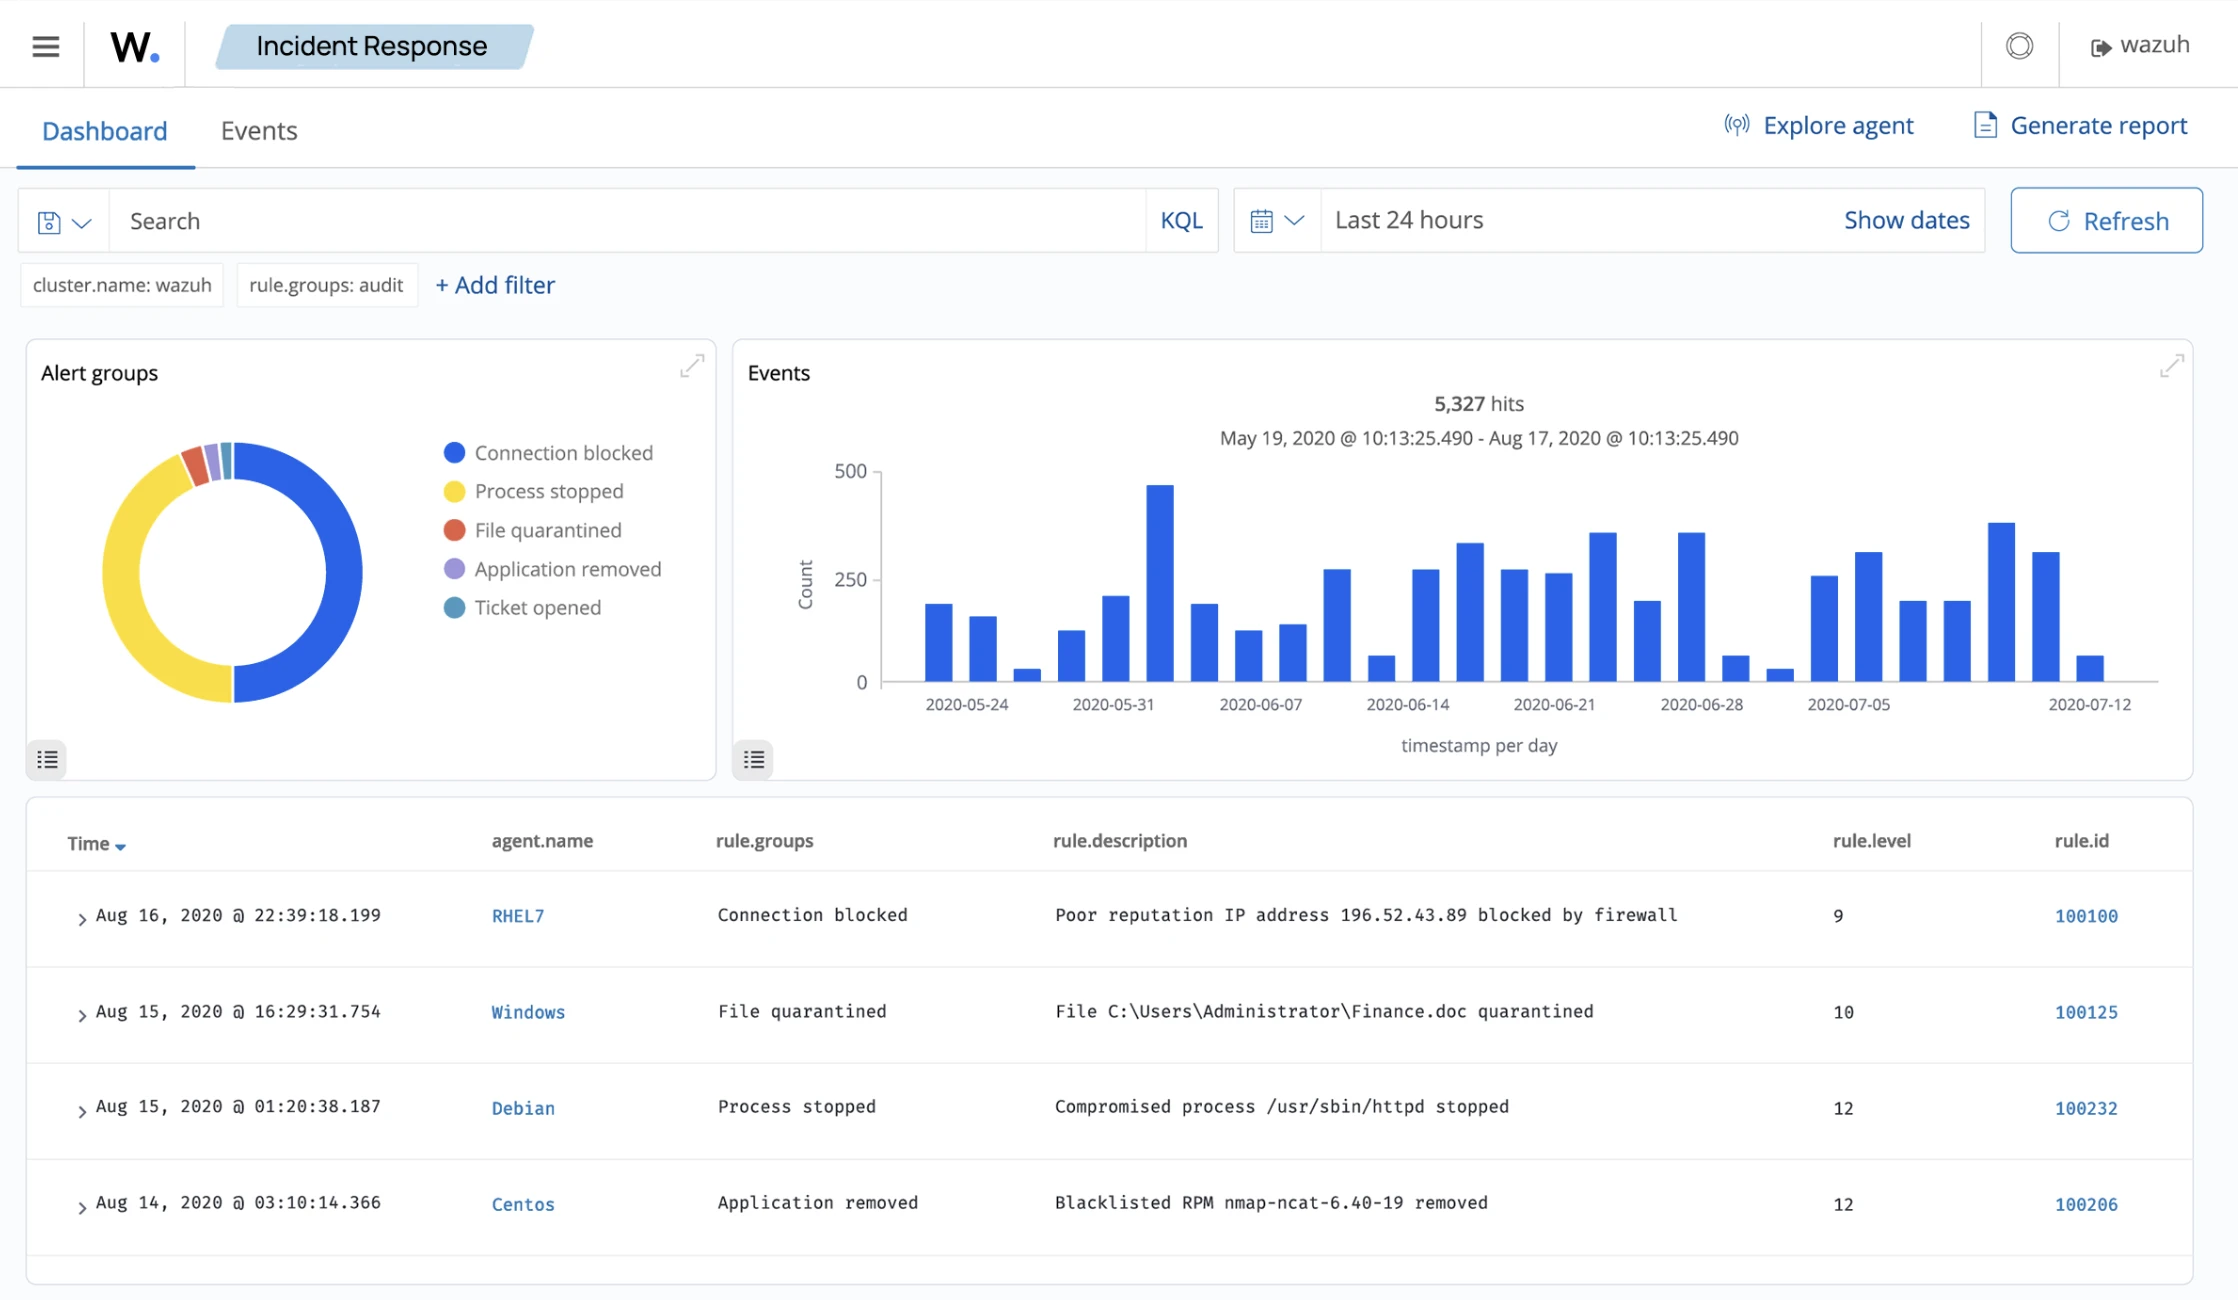
O Wazuh é um SIEM de código aberto que vai além da maioria das ferramentas desta categoria. Ele combina monitoramento de logs, segurança de endpoint, monitoramento de integridade de arquivos, detecção de vulnerabilidades e detecção de eventos de segurança em tempo real em uma única plataforma baseada em agentes.
Como funciona o gerenciamento de logs no Wazuh
Um agente de endpoint implantado em cada sistema monitorado coleta logs localmente e os encaminha ao servidor de gerenciamento do Wazuh para processamento e análise. O agente cuida da coleta de logs, do monitoramento de integridade e da resposta ativa localmente. O Wazuh integra-se nativamente ao Elastic Stack, usando o Elasticsearch para armazenamento e busca de logs, e o Kibana (via o plugin do Wazuh) para painéis e investigação.
O motor de regras é executado no gerenciador e avalia os eventos de log recebidos em relação a um conjunto de regras que inclui regras padrão, benchmarks CIS, mapeamentos MITRE ATT&CK e quaisquer regras personalizadas que você escrever. Quando uma regra é acionada, o Wazuh gera um alerta e, se você tiver uma resposta ativa configurada, pode executar uma ação automatizada no endpoint: bloquear um IP, encerrar um processo ou colocar um arquivo em quarentena.
Opções de hospedagem:
- Auto-hospedado: A plataforma é gratuito para baixar e usar. O suporte anual opcional é precificado com base no número de endpoints monitorados (servidores, estações de trabalho e dispositivos de rede). Nesse modelo, a organização é responsável por manter hardware e recursos.
- Hospedado na nuvem: O provedor de hospedagem gerencia o Wazuh Server e o Elastic Stack; você precisa implantar os agentes. O preço depende dos dados indexados (anteriormente chamados de armazenamento quente) e do período de retenção escolhido.
Recursos de destaque:
- Coleta flexível de logs: O Wazuh coleta logs do Windows Event Viewer, mensagens do sistema Linux, logs de aplicativos no formato JSON e uma ampla variedade de tipos de origem sem plugins adicionais. A cobertura pronta para uso é mais ampla que a do Graylog ou do Logstash, que exigem mais configuração para alcançar a mesma abrangência.
- Mapeamento MITRE ATT&CK: As regras são mapeadas para as técnicas MITRE ATT&CK por padrão, então os alertas não apenas informam o que aconteceu, mas onde isso se encaixa em uma cadeia de ataque. Isso é importante para a triagem; você pode distinguir entre uma falha de autenticação ruidosa e uma tentativa de credential stuffing sem escrever correlação personalizada.
- Integrações de terceiros: Integrações nativas com Office 365, AWS, GCP, Azure e Rapid7. Uma biblioteca Python integrada oferece suporte a integrações personalizadas sem a configuração de plugins que o Syslog-ng ou o Fluentd exigem.
- API e resposta ativa: Uma API RESTful cobre consultas de logs, gerenciamento de regras e decodificadores, consultas de alertas e interações com agentes. O recurso de resposta ativa executa scripts no endpoint monitorado mediante alerta, bloqueando endereços IP, encerrando processos e isolando hosts. Isso não está disponível no Elastic Stack sem ferramentas adicionais.
Graylog
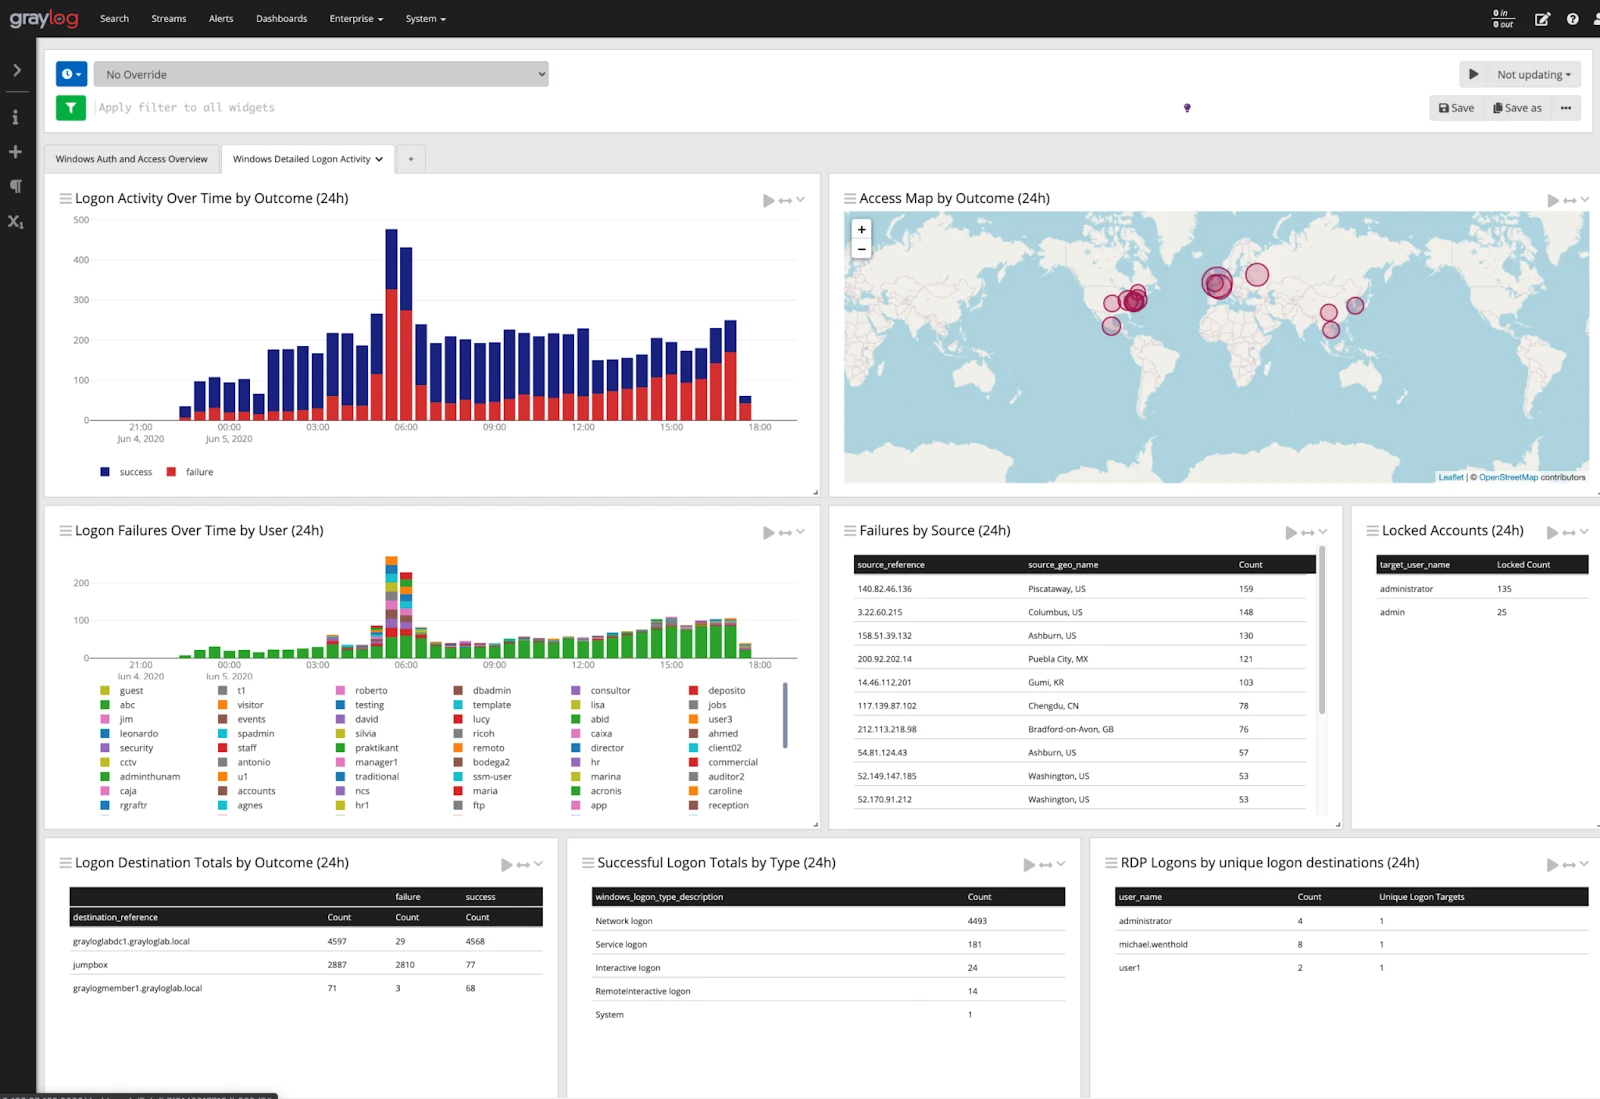
O Graylog é uma plataforma de gerenciamento de logs com um núcleo de código-fonte disponível (Graylog Open) e edições pagas que se estendem às operações de segurança. Essa distinção importa mais do que a maioria das descrições dos fornecedores deixa transparecer: o Graylog Open oferece coleta de logs, busca, pipelines de processamento, painéis e alertas baseados em fluxos, o que é suficiente para casos de uso operacionais. Regras Sigma, alinhamento MITRE ATT&CK, UEBA, detecção de anomalias e gerenciamento de casos são recursos pagos das edições Graylog Security e Enterprise. Se o seu principal caso de uso são operações de segurança e não monitoramento de infraestrutura, leve isso em consideração no cálculo de custos.
Como o Graylog funciona
O Graylog recebe dados de logs por meio de entradas GELF (Graylog Extended Log Format), syslog, Beats ou HTTP, armazena-os no Elasticsearch ou OpenSearch (via o Graylog Data Node) e os torna pesquisáveis por meio de uma interface web. O sistema de fluxos é central para o funcionamento do Graylog: as mensagens recebidas são roteadas para fluxos com base em regras, e alertas, pipelines e controles de acesso são vinculados aos fluxos e não à camada de armazenamento. Isso significa que você pode ter um fluxo para erros de aplicação roteado para uma equipe e um fluxo separado para eventos de autenticação roteado para a segurança, com políticas de retenção e permissões diferentes em cada um.
Os pipelines de processamento permitem analisar, enriquecer, descartar ou reescrever mensagens antes do armazenamento. Se os logs da sua aplicação chegam como texto não estruturado, você escreve uma regra de pipeline para extrair campos em dados estruturados. O Graylog Illuminate (incluído nas edições pagas, disponível para o Open com limitações) fornece parsers e painéis pré-construídos para fontes comuns: Windows Event Logs, Cisco, Palo Alto, AWS CloudTrail e outros.
- O broker Kafka mínimo é 2.1. Qualquer entrada do Kafka conectada a um broker mais antigo falhará após a atualização.
- Tokens de API agora expiram por padrão após 30 dias. Qualquer automação, integração de monitoramento ou script que use um token de API de longa duração deixará de funcionar, a menos que você tenha uma política de rotação de tokens em vigor. Isso tende a aparecer como um incidente tarde da noite, quando algo para de reportar, e não durante a própria atualização.
Recursos de destaque:
- Roteamento e processamento baseados em fluxos: O modelo de fluxos permite segmentar os dados de logs por origem, aplicação ou nível de sensibilidade no momento da ingestão e, em seguida, aplicar pipelines, políticas de retenção e controles de acesso diferentes por fluxo. Isso é operacionalmente mais flexível do que os padrões de Elasticsearch de índice por origem.
- Extração e análise de logs: Os extratores extraem campos específicos das mensagens de log na ingestão. Os pipelines de processamento cuidam de transformações mais complexas, lógica condicional, consultas, renomeação de campos e descarte de mensagens. Together eles oferecem controle refinado sobre o que acaba armazenado. O Graylog Illuminate também incluiu correções de parser no 7.0.3, incluindo uma correção na análise de timestamps do Apache HTTPD que estava produzindo valores de tempo incorretos.
- Busca e investigação: A sintaxe de busca do Graylog é mais simples que Lucene/KQL para consultas básicas, o que faz diferença quando você precisa que um engenheiro de plantão pesquise logs à meia-noite sem documentação de referência. Pesquisas salvas, intervalos de tempo relativos e sobreposições de histograma estão disponíveis sem complementos pagos.
- Gerenciamento de usuários com integração AD/LDAP: A autenticação no Active Directory e LDAP é suportada no Graylog Open. Controles de acesso baseados em funções permitem restringir quais fluxos e painéis cada equipe pode ver.
Onde o Graylog enfrenta dificuldades
O nível gratuito do Graylog tem lacunas significativas se o seu caso de uso são operações de segurança: suporte a regras Sigma, detecção de anomalias e gerenciamento de casos são todos pagos. A dependência do Elasticsearch/OpenSearch adiciona complexidade operacional semelhante à do ELK Stack. Em grande escala, o processamento de pipeline pode criar gargalos de desempenho que exigem ajuste cuidadoso da ordem dos estágios do pipeline e da alocação de threads de trabalho.
Elastic Stack (ELK Stack) – Logstash
O Elastic Stack é um conjunto de produtos de código aberto; seus componentes principais são o Elasticsearch, o Kibana e o Logstash.
Como funciona a análise de logs do ELK
O Logstash é um pipeline de processamento de dados do lado do servidor. Ele recebe dados de logs de entradas (arquivos, Beats, syslog, Kafka, HTTP e dezenas de outras), aplica plugins de filtro para analisar e enriquecer os dados e roteia a saída para um ou mais destinos. A maioria das implantações envia a saída para o Elasticsearch, mas o Logstash pode gravar simultaneamente no S3, em um SIEM, em uma fila de mensagens ou em outro cluster Elasticsearch.
O Elasticsearch armazena os dados de logs processados e os torna pesquisáveis usando um índice invertido. É por isso que o ELK escala para petabytes e ainda retorna resultados de busca em menos de um segundo em consultas direcionadas, mas esse desempenho vem da estrutura do índice, o que significa que cargas de trabalho com muitas gravações exigem um gerenciamento cuidadoso do ciclo de vida do índice. O Kibana fica sobre o Elasticsearch e fornece a camada visual: painéis, a visão Discover para busca de logs ad-hoc, Canvas para relatórios personalizados e Lens para visualizações de arrastar e soltar.
- Busca de texto completo em escala: A arquitetura de índice invertido do Elasticsearch oferece suporte a buscas em menos de um segundo em bilhões de entradas de logs. KQL (Kibana Query Language) e ES|QL (a linguagem de consulta baseada em pipes mais recente da versão 9.x) oferecem aos analistas duas interfaces de consulta diferentes, dependendo de como preferem trabalhar. Para investigações complexas de logs em grandes conjuntos de dados, nada no espaço de código aberto se iguala à profundidade de busca do ELK.
- Ingestão e filtragem de múltiplas fontes: O Logstash tem cerca de 200 plugins de entrada e 200 plugins de filtro. O filtro grok lida com texto não estruturado usando padrões de captura nomeados; o filtro json lida com logs JSON estruturados; o filtro csv lida com dados tabulares. Vários estágios de filtro são executados em sequência, então você pode analisar uma linha de syslog bruta, extrair campos, consultar um IP em um banco de dados GeoIP e descartar mensagens de nível debug antes que o evento chegue ao Elasticsearch, tudo em um único pipeline.
- Detecção de anomalias com machine learning: Os recursos de ML do Kibana (pagos) identificam padrões incomuns nos dados de logs sem exigir que você defina limites. Útil para detectar ataques lentos ou degradação gradual do desempenho que alertas de limite fixo não captam.
- Painéis do Kibana: As opções de visualização do Kibana são extensas: séries temporais, mapas, mapas de calor, tabelas de dados, medidores e muito mais. Pesquisas salvas e padrões de índice permitem que os analistas compartilhem contextos de investigação entre equipes.
- Roteamento de saída extensível: Um único pipeline do Logstash pode gravar simultaneamente no Elasticsearch, em um bucket S3, em um segundo cluster Elasticsearch para recuperação de desastres e em um tópico Kafka para processamento downstream.
Onde o ELK enfrenta dificuldades
A sobrecarga operacional é real. Os clusters do Elasticsearch exigem planejamento de memória (o heap da JVM precisa de dimensionamento cuidadoso), gerenciamento de shards (muitos shards pequenos ou poucos shards grandes prejudicam o desempenho) e configuração de políticas de ciclo de vida de índice para controlar os custos de retenção.
A maioria das equipes que executam o ELK em escala acaba tendo um engenheiro de plataforma dedicado cuja principal responsabilidade é o Elasticsearch. Também vale a pena entender a situação da licença: os componentes do Elastic Stack estão sob a Elastic License 2.0, não sob uma licença de código aberto aprovada pela OSI. O uso auto-hospedado é gratuito, mas oferecer o Elasticsearch como serviço gerenciado a terceiros não é permitido no nível gratuito.
Fluentd
O Fluentd é um coletor de dados de código aberto sob a Apache License 2.0, projetado para unificar a ingestão e o roteamento de logs em infraestruturas heterogêneas. A tarefa principal é simples: aceitar eventos de log das origens, aplicar processamento opcional e roteá-los para destinos. O Fluentd não armazena nem analisa logs por si só; é um coletor e roteador, não uma plataforma de análise de logs1
Essa distinção é importante ao avaliá-lo em comparação com o Wazuh ou o Graylog. O Fluentd normalmente é a primeira camada em um pipeline maior. Uma arquitetura comum: agentes Fluentd em cada servidor coletam logs de aplicações, logs do sistema e logs de contêineres, armazenam-nos em buffer localmente (para que nada seja perdido se o destino downstream ficar temporariamente indisponível), aplicam análise e filtragem e encaminham o resultado para o Elasticsearch, Splunk, um SIEM na nuvem ou outro backend de armazenamento. A análise acontece no que quer que receba os dados.
Fluentd vs. Fluent Bit
Equipes que avaliam o Fluentd para ambientes Kubernetes geralmente acabam escolhendo o Fluent Bit, e vale a pena entender por quê. O Fluent Bit é um forwarder leve no mesmo ecossistema CNCF, aproximadamente um binário de 4 MB, em comparação com o processo baseado em Ruby do Fluentd, que roda com um peso notavelmente maior. Para implantações Kubernetes em que você quer um coletor de logs rodando como DaemonSet em cada nó, a diferença na pegada de recursos é significativa em escala. O Fluent Bit também oferece suporte à análise de logs multilinha, à injeção dinâmica de metadados a partir de labels e anotações de pods do Kubernetes e ao tratamento integrado de contrapressão para evitar perda de dados quando os destinos downstream ficam lentos.
O Fluentd é a melhor opção quando você precisa de todo o ecossistema de 500+ plugins ou de lógica de roteamento complexa que a biblioteca de plugins menor do Fluent Bit não consegue cobrir. Para a maioria das implantações nativas do Kubernetes que fazem envio simples de logs, o Fluent Bit é a escolha prática. Os projetos compartilham conceitos de configuração, então alternar entre eles não é uma reescrita completa.
Como o Fluentd lida com os dados de logs
O Fluentd modela os dados de logs como um fluxo de eventos etiquetados. Cada evento tem uma tag (uma string separada por pontos como app.web ou system.syslog), um timestamp e um registro. As tags orientam o roteamento: as diretivas match na configuração especificam quais tags são enviadas para onde, quais filtros se aplicam e em que ordem. Várias saídas podem corresponder à mesma tag, então você pode enviar os mesmos eventos simultaneamente para o Elasticsearch e um arquivo S3.
O sistema de buffer é o que torna o Fluentd confiável em produção. Em vez de gravar diretamente no destino, os eventos se acumulam em um buffer e são descarregados em blocos em intervalos configuráveis ou quando o buffer atinge um limite de tamanho. Se o destino ficar inacessível, os eventos permanecem no buffer e são repetidos com backoff exponencial.
Recursos de destaque:
- 500+ plugins da comunidade: Cobre integrações com a maioria dos principais destinos de logs e fontes de dados sem desenvolvimento personalizado.
- Roteamento flexível de dados: Os eventos podem ser roteados para múltiplos destinos simultâneos, como arquivos, RDBMS, NoSQL, IaaS, SaaS e Hadoop, com base em regras de roteamento por tags.
- Foco no processamento de logs: O Fluentd é otimizado para processamento e encaminhamento de logs em escala, o que o torna adequado como camada de coleta e roteamento à frente do Elasticsearch ou de outros backends de armazenamento, em vez de uma plataforma de análise independente.
 Adicionar como fonte preferencial
Syslog-ng
O Syslog-ng é um programa de gerenciamento de logs de código aberto que coleta, classifica, transforma e roteia dados de logs de várias fontes para armazenamento ou plataformas downstream. Sua capacidade distintiva é o processamento estruturado: os logs podem ser normalizados em um formato consistente antes de serem encaminhados para sistemas como Apache Kafka ou Elasticsearch.
Capacidades:
- Classificar e estruturar logs usando parsers integrados como csv-parser
- Armazenar logs em arquivos, filas de mensagens (AMQP) ou bancos de dados (PostgreSQL, MongoDB)
- Encaminhar para plataformas de big data, incluindo Elasticsearch, Apache Kafka ou Hadoop
Recursos distintos:
- Arquivamento automatizado de logs: O Syslog-ng cuida da rotação e do arquivamento de logs nativamente, incluindo compactação e nomenclatura de arquivos com timestamp. Para ambientes com requisitos de conformidade de retenção, isso reduz a necessidade de ferramentas externas como logrotate em camadas.
- Suporte a múltiplos formatos de mensagens: RFC3164 (syslog tradicional), RFC5424 (syslog estruturado), JSON e formatos chave-valor são todos analisados nativamente. O Syslog-ng pode receber uma mensagem RFC3164 e produzi-la como RFC5424 com campos de dados estruturados adicionados, o que é útil ao alimentar sistemas que esperam o formato syslog moderno.
- Transporte criptografado: O transporte syslog criptografado com TLS é suportado nativamente tanto para recebimento quanto para encaminhamento. Isso é importante em ambientes onde os dados de logs transitam por segmentos de rede não confiáveis.
- Roteamento condicional: Expressões de filtro permitem rotear com base em qualquer campo analisado, como severidade, facility, host ou campos personalizados extraídos por parsers. Uma única instância do syslog-ng pode rotear falhas de autenticação para o fluxo da equipe de segurança, erros de aplicação para o fluxo da equipe de desenvolvimento e mensagens de debug para /dev/null.
Onde o syslog-ng se encaixa (e onde não se encaixa)
O Syslog-ng é a escolha certa quando suas fontes de logs são principalmente dispositivos de rede e servidores que falam syslog e quando você precisa de coleta confiável e de alta vazão com extração de campos estruturados antes do encaminhamento para um backend de armazenamento. Não é uma plataforma de análise de logs; não há interface de consulta, não há painéis e não há alertas integrados. Ele funciona como a camada de coleta e roteamento à frente do Elasticsearch ou do Graylog, não como uma ferramenta independente.
Nagios
Um esclarecimento necessário antes de prosseguir: o Nagios Core é o projeto de monitoramento de código aberto licenciado sob GPL e se concentra no monitoramento de hosts, serviços e redes, e não na análise de logs.[15] O produto descrito aqui é o Nagios Log Server, um produto comercial separado da Nagios Enterprises. Se você está procurando especificamente uma ferramenta de análise de logs de código aberto e sem custo, o Nagios Log Server não é essa ferramenta. O que ele oferece é uma plataforma de gerenciamento de logs com suporte comercial de um fornecedor com longo histórico em monitoramento de infraestrutura.
O Nagios Log Server coleta dados de logs em tempo real e os alimenta em uma interface de busca. Ele é compatível com servidores Windows, Linux e Unix e inclui um assistente de configuração para integrar novos endpoints ou aplicações.2
Recursos de destaque:
- Monitoramento de serviços de rede: Cobre SMTP, POP3, HTTP, PING e outros serviços de rede com foco na saúde da infraestrutura.
- Monitoramento de recursos de hosts: Acompanha carga do processador, utilização de disco e saúde do sistema em todos os hosts monitorados.
- Rotação e arquivamento de arquivos de log: Rotação automatizada e arquivamento de longo prazo sem intervenção manual.
- Filtragem geográfica de logs: Filtra dados de logs por origem geográfica e gera mapas de fluxo de tráfego.
- Interface web: Interface opcional para visualizar o status atual da rede e os arquivos de logs.
Perguntas frequentes
As ferramentas de código aberto para análise de logs permitem aos usuários coletar, processar, armazenar, pesquisar e analisar dados de logs de várias fontes, como servidores, aplicações e dispositivos de rede. Essas ferramentas podem ajudar SecOps, ITOps e DevOps a:
-Realizar solução de problemas do sistema monitorando arquivos de log de transações.
-Aproveitar a resposta a incidentes e investigação de segurança para manter o desempenho ideal do banco de dados ou executar análise de comportamento de usuários e entidades (UEBA).
-Manter a conformidade com auditorias, legislação e regras de segurança especiais (GDPR).
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{hafa2026,
  author = {Hafa, Adil and PhD., Ezgi Arslan,},
  title  = {{Top 6 Ferramentas de Código Aberto para Análise de Logs: Wazuh, Graylog e Mais}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/open-source-log-analysis-tools}},
  note   = {AIMultiple. Acessado em 21 agosto 2026}
}Resultados e carimbos de data/hora de 18 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 3 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
6 atualizaçõesAdicionadas seções sobre funcionamento e limitações para Graylog, o ELK Stack, Fluentd e syslog-ng.
Atualizado o produto Wazuh com novas capacidades de detecção e uma política SCA.
Links de referência
A seguir, leia
Melhores Proxies do Discord: Planos Gratuitos, Recursos e Configuração

Provedores de Proxy IPv6: Preços e Desempenho
Top 12 Software de RPA e Seus Recursos

Top 10 Softwares de Segurança de Endpoint
Top 10 Soluções PAM Gratuitas
As 6 Melhores Ferramentas de Código Aberto para Descoberta de Dados Sensíveis



Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.