


Modelos de Embedding de Código Aberto: 11 Modelos Avaliados em Benchmark para Recuperação
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support and medical questions each searched their own domain's corpus.

O nDCG@10 pontua a posição das passagens relevantes registradas entre os dez primeiros resultados de busca. Uma pontuação de 1 representa a classificação ideal para os positivos registrados. Passagens mais próximas do topo recebem mais peso.
PPLX Embed v1 4B liderou a comparação com 0.741 nDCG@10, seguido pelo PPLX Embed v1 0.6B com 0.698. O Multilingual E5 Large ficou em terceiro com 0.628. A pequena diferença entre o BGE Large e o E5 Large fica oculta pelo arredondamento de três casas decimais. Suas pontuações não arredondadas determinam a ordem.
Modelo | nDCG@10 | 95% IC | Recall@10 |
|---|---|---|---|
PPLX Embed v1 4B | 0.741 | 0.700–0.782 | 90,46% |
PPLX Embed v1 0.6B | 0.698 | 0.651–0.744 | 86,71% |
Multilingual E5 Large | 0.628 | 0.578–0.680 | 79,38% |
BGE Large EN v1.5 | 0.624 | 0.572–0.676 | 78,21% |
E5 Large v2 | 0.624 | 0.572–0.675 | 78,88% |
BGE-M3 (dense) | 0.614 | 0.562–0.666 | 79,50% |
GTE Large | 0.612 | 0.563–0.660 | 77,71% |
All-MPNet Base v2 | 0.608 | 0.556–0.661 | 77,33% |
GTE Base | 0.596 | 0.547–0.645 | 76,21% |
E5 Base v2 | 0.586 | 0.534–0.640 | 75,21% |
O Recall@10 é a fração média das passagens relevantes registradas de cada pergunta encontrada entre os dez primeiros resultados. Ele mede a cobertura de passagens e não avalia se uma resposta gerada está correta.
Os intervalos de confiança (ICs) de 95% estimam a incerteza na média do nDCG@10 a partir da amostragem de perguntas. Intervalos mais amplos indicam estimativas menos precisas.
As perguntas foram selecionadas para desafiar o BM25, que obteve pontuação zero neste conjunto. Relatamos essa linha de base junto com o procedimento de seleção. O desempenho no tráfego de busca comum permanece não testado. A inferência foi realizada por meio de endpoints hospedados.
Descobertas de recuperação nos modelos open-weight
PPLX Embed v1 4B registrou o maior nDCG@10 com 0.741
O PPLX Embed v1 0.6B veio em seguida com 0.698. O modelo 4B pontuou significativamente acima de nove dos outros dez modelos open-weight após correção para comparações múltiplas. Sua diferença para o 0.6B não foi significativa. As pontuações de Recall@10 deles foram 90,46% e 86,71%, também sem diferença significativa. Esses testes não estabelecem desempenho igual.
O BGE Large registrou a maior pontuação em finanças com 0.604
O PPLX 4B pontuou 0.596 nas mesmas 50 perguntas de finanças. Essa diferença não foi significativa após a correção. O BGE Large ficou em quarto lugar no geral, ilustrando como a ordem observada muda entre os domínios.
GTE Large recuperou todos os positivos registrados do MedRAG entre os dez primeiros resultados
O GTE Large alcançou 100% de Recall@10 nas 50 perguntas médicas. Seu nDCG@10 foi 0.894, em comparação com o PPLX 4B, que obteve 0.954. Recuperar os positivos registrados e classificá-los primeiro são resultados separados. Essas pontuações dizem respeito à recuperação de passagens e não medem a precisão das respostas médicas.
Comparações de domínio para os onze modelos
nDCG@10 em nível de domínio. As visões de Finanças, CUAD, TechQA e MedRAG mantêm todos os onze modelos e os classificam pela pontuação do domínio selecionado.
O BGE-M3 alcançou 0.616 no CUAD e 0.743 no MedRAG. Esses números descrevem a configuração de vetor denso usada aqui. O BGE-M3 também suporta recuperação esparsa e multivariada. Esses modos e combinações híbridas ficaram fora deste experimento.1
Todos os quatro domínios têm peso igual no resultado geral. Um desempenho forte no MedRAG pode compensar uma recuperação mais fraca em finanças nessa média, embora os casos de uso financeiro e médico exijam evidências diferentes.
Representações de embedding e opções de implantação
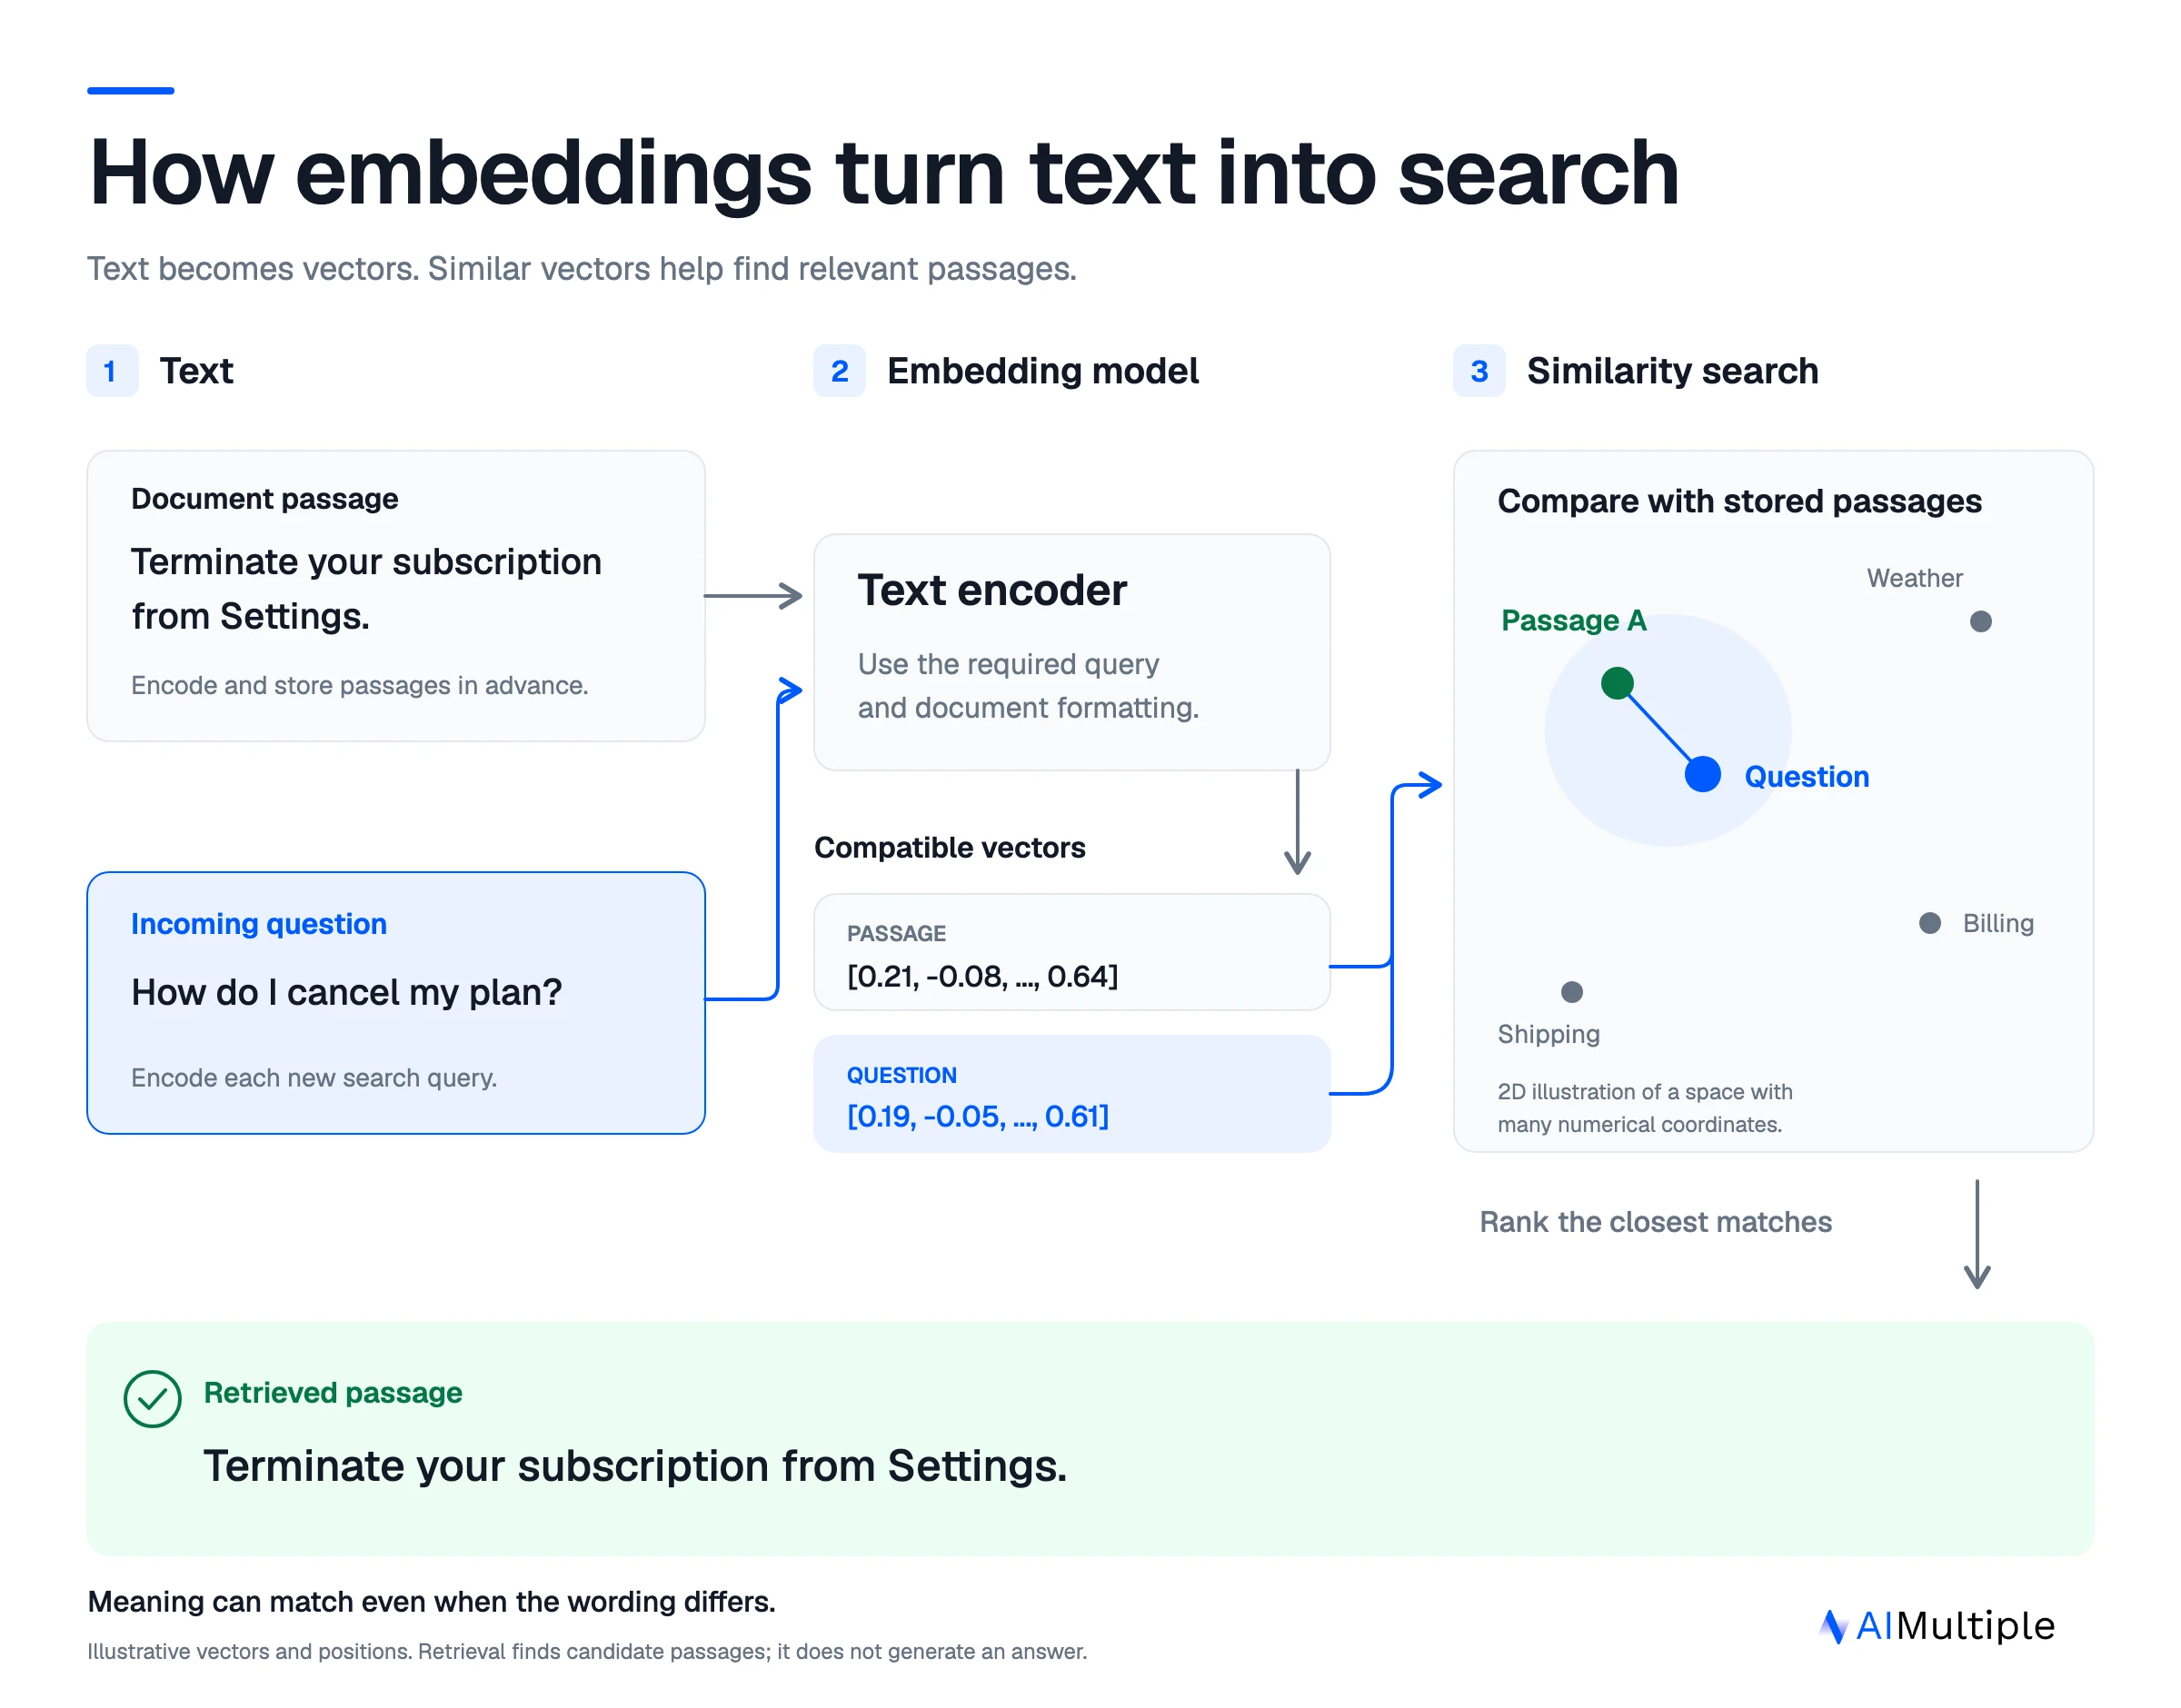
A recuperação por embedding codifica passagens e consultas em vetores compatíveis e, em seguida, compara esses vetores para selecionar passagens candidatas. Os documentos podem ser codificados antes da busca. Cada consulta recebida precisa da própria representação. Os prompts ou funções específicos do modelo para consulta e documento devem seguir a configuração de recuperação do modelo.2
O armazenamento e o comportamento de busca também dependem do banco de dados vetorial e da configuração de índice dele. A escolha do modelo, a precisão do vetor, as configurações de índice e a profundidade de recuperação devem permanecer decisões separadas ao planejar uma implantação. O benchmark de modelos de embedding mais amplo coloca essas onze entradas ao lado dos modelos de API comerciais nas mesmas perguntas.
Metodologia do benchmark dos modelos de embedding de código aberto
Cada modelo pesquisou as mesmas passagens com 200 perguntas congeladas e 225 pares registrados de pergunta-passagem relevantes. As perguntas e os rótulos de relevância foram fixados antes de comparar as pontuações de embedding. As entradas de consulta continham apenas a pergunta original.
As passagens de finanças vieram de relatórios anuais da FinQA, e as passagens jurídicas vieram de contratos CUAD v1.34 O suporte técnico usou notas técnicas do TechQA, e a literatura médica usou uma amostra de resumos PubMed do MedRAG.56
As passagens eram parágrafos inteiros, tabelas com contexto, cláusulas de contrato ou resumos com títulos. Excluímos unidades com mais de 256 tokens segundo o tokenizador all-MiniLM-L6-v2 e mantivemos intactas as passagens aceitas. Os modelos de 512 tokens receberam no máximo 459 tokens por passagem, portanto esta avaliação cobre passagens curtas.
LLMs de fronteira elaboraram as perguntas a partir das passagens de origem. Um membro da equipe verificou 20% das perguntas (40 de 200). Os LLMs também julgaram as 20 principais passagens do BM25 por pergunta, adicionando 25 passagens relevantes às 200 passagens de origem.
Recuperação e análise estatística
Cada consulta foi comparada com todas as passagens do seu domínio. O MultiQA usou produto escalar, de acordo com o cartão de modelo dele.7 Os outros dez modelos usaram similaridade de cosseno. O BGE-M3 usou seus vetores densos.1 As entradas usaram as funções ou prefixos de recuperação configurados de cada modelo.
Ambas as métricas são médias entre as perguntas. Calculamos ICs de 95% com 10.000 amostras bootstrap, reamostrando 50 perguntas dentro de cada domínio. A significância usa os testes pareados de inversão de sinal do benchmark completo, com correção de Holm entre todos os 231 pares entre seus 22 modelos para cada métrica e escopo. As diferenças são significativas com um p-valor corrigido abaixo de 0.05.
IDs dos modelos testados, dimensões e limites de entrada
As execuções ocorreram por meio do OpenRouter, com um provedor de backend fixo por modelo e fallbacks desativados. Estes são os identificadores de API, as dimensões de saída e os limites de entrada usados nessas execuções.
Os identificadores de API não garantem um instantâneo imutável do modelo. As revisões do tokenizer foram fixadas, e os pesos dos modelos hospedados não foram verificados de forma independente. Os limites de entrada descrevem a configuração do benchmark. As passagens curtas não testaram a recuperação de contexto longo.
Limites da comparação
As perguntas formam um conjunto de desenvolvimento selecionado pelo BM25. Os resultados em consultas de produção comuns podem ser diferentes. Os julgamentos de relevância foram limitados às passagens de origem e às 20 principais do BM25. Entre esses onze modelos, aproximadamente 85% dos pares distintos de pergunta-passagem recuperados entre os dez primeiros não foram julgados e não receberam crédito de relevância.
Cada modelo foi executado uma vez. Os ICs refletem a amostragem de perguntas e excluem a variação entre execuções de API ou a incerteza de rótulos incompletos. A contaminação dos dados de treinamento não foi testada.
A avaliação cobre recuperação de texto em inglês. Cargas de trabalho de embedding multilíngue e modelos de embedding multimodal precisam de evidências separadas. A precisão da resposta gerada, a recuperação híbrida, o reranqueamento, a memória de GPU, a vazão local e o custo de serving ficaram fora desta comparação.
Conclusão
PPLX Embed v1 4B e 0.6B tiveram as maiores pontuações gerais entre os onze modelos open-weight. A diferença entre eles não foi estatisticamente significativa. O BGE Large registrou a maior pontuação em finanças, e o GTE Large recuperou todos os positivos registrados do MedRAG entre os dez primeiros resultados.
Antes da implantação, teste o conjunto de consultas pretendido e meça a velocidade de serving local, o uso de memória e o custo.
 Adicionar como fonte preferencial
Leitura adicional
- Benchmark de modelos de embedding
- Modelos de embedding multilíngue para RAG
- Benchmark de banco de dados vetorial de código aberto
- Dimensionamento e seleção de banco de dados vetorial
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Modelos de Embedding de Código Aberto: 11 Modelos Avaliados em Benchmark para Recuperação}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-embedding-models}},
  note   = {AIMultiple. Acessado em 26 setembro 2026}
}Resultados e carimbos de data/hora de 105 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 7 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
4 atualizaçõesO benchmark Top-K de 16 modelos sobre avaliações da Amazon foi substituído por um de 14 modelos com nDCG@3 e custos em CUAD, TechQA e MedRAG.
Adicionada Licença e uso comercial à visão geral dos modelos de incorporação de código aberto.
O benchmark foi expandido para incluir cinco modelos adicionais de código aberto.
Hardware, tamanho do lote e precisão atualizados na configuração de avaliação.
Links de referência






Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.