


15 Ferramentas de Observabilidade de Agentes de IA: AgentOps e Langfuse

Testamos 15 plataformas de observabilidade para aplicações LLM e agentes de IA. Cada plataforma foi implementada na prática por meio da configuração de fluxos de trabalho, integrações e execução de cenários de teste. Comparamos 4 ferramentas de observabilidade para medir se elas introduzem sobrecarga em pipelines de produção. Também demonstramos um LangChain tutorial de observabilidade usando Langfuse.
Benchmark de sobrecarga das ferramentas de monitoramento agêntico
Integramos cada plataforma de observabilidade ao nosso sistema multiagente de planejamento de viagens e executamos 100 consultas idênticas para medir a sobrecarga de desempenho em comparação com uma linha de base sem instrumentação. Leia nossa metodologia de benchmark.
- LangSmith demonstrou eficiência excepcional com praticamente nenhuma sobrecarga mensurável, o que o torna ideal para ambientes de produção críticos em termos de desempenho.
- Laminar introduziu sobrecarga mínima de 5%, tornando-o altamente adequado para ambientes de produção onde o desempenho é crítico.
- AgentOps e Langfuse apresentaram sobrecarga moderada de 12% e 15%, respectivamente, representando uma troca razoável entre recursos de observabilidade e impacto no desempenho. Essas plataformas ainda mantêm latência aceitável para a maioria dos casos de uso em produção.
Possíveis motivos por trás das diferenças de desempenho
Nosso benchmark indica que as diferenças de latência são impulsionadas pela profundidade da instrumentação e pelo envolvimento no caminho de execução, especialmente em fluxos de trabalho multiagente. Ferramentas que oferecem observabilidade mais profunda, em nível de etapa, apresentaram maior sobrecarga, enquanto abordagens de rastreamento mais leves permaneceram mais próximas da linha de base.
1. Profundidade da instrumentação no caminho de execução
As ferramentas de observabilidade adicionam lógica ao fluxo de execução do agente para capturar rastreamentos e metadados. Quando essa lógica é executada de forma síncrona durante o tratamento de solicitações, ela aumenta diretamente a latência de ponta a ponta, porque o agente precisa concluir esse trabalho extra antes de retornar uma resposta.
Por exemplo:
- O LangSmith adicionou praticamente nenhuma sobrecarga mensurável (~0%), indicando pouco trabalho síncrono,
- A instrumentação mais profunda em nível de etapa do Langfuse contribuiu para uma sobrecarga maior (~15%).
2. Amplificação de eventos em pipelines de múltiplas etapas
Em sistemas multiagente, uma única solicitação do usuário aciona múltiplas ações do agente. Quando uma ferramenta registra dados detalhados em cada etapa, o número total de eventos cresce rapidamente, aumentando a sobrecarga de processamento e de tratamento de rastreamentos à medida que o fluxo de trabalho se aprofunda.
Nos resultados do benchmark:
- O Langfuse e o AgentOps geraram sobrecarga visivelmente maior (15% e 12%) em nosso fluxo de trabalho de planejamento de viagens com múltiplas etapas
- O LangSmith e o Laminar emitiram menos eventos por etapa do agente.
3. Sobrecarga de avaliação e validação inline
Algumas plataformas realizam verificações ou monitoramento adicionais enquanto o agente está em execução. Embora cada verificação seja leve, aplicá-las repetidamente em todas as etapas do agente adiciona latência mensurável.
Por exemplo:
- O monitoramento em nível de ciclo de vida do AgentOps coincidiu com uma sobrecarga de 12%
- O Laminar não mostrou evidências de que a avaliação inline tenha afetado a execução, permanecendo em torno de ~5%.
4. Frequência de serialização e persistência
A captura de dados detalhados de observabilidade exige serializar os rastreamentos e gravá-los em armazenamento ou backends externos. Quanto maior o detalhe dos rastreamentos, maior a frequência com que isso ocorre, adicionando sobrecarga de E/S a cada solicitação.
Em nosso benchmark:
- O rastreamento detalhado de prompt, saída e tokens do Langfuse resultou na maior sobrecarga (~15%)
- Os artefatos de rastreamento mais leves do LangSmith permaneceram próximos da linha de base.
5. Grau de integração com o framework do agente
O grau de integração de uma ferramenta com o framework do agente afeta o desempenho. Integrações mais estreitas reduzem etapas de tradução e orquestração, enquanto SDKs mais genéricos adicionam camadas extras de processamento.
Por exemplo:
- O alinhamento estreito do LangSmith com a execução do agente se correlacionou com sobrecarga de ~0%
- O AgentOps e o Langfuse mostraram maior impacto na latência, consistente com caminhos de integração mais desacoplados.
Plataformas de observabilidade de agentes de IA
Nível 1: Observabilidade detalhada de LLM e prompt / saída
* Os recursos listados nessas colunas são exemplos ilustrativos do que cada ferramenta pode monitorar quando ampliada por meio de integrações ou personalizações. Esses recursos não são exclusivos de uma única plataforma.
Nível 2: Observabilidade de workflow, modelo e avaliação
Nível 3: Observabilidade do ciclo de vida e das operações do agente
Nível 4: Monitoramento de sistema e infraestrutura (não nativo de agentes)
Datadog (com seu módulo de Observabilidade de LLM) e o Prometheus (via exportadores) são cada vez mais usados junto com Langfuse/LangSmith.
Plataformas de desenvolvimento e orquestração de agentes:
- Ferramentas como Flowise, Langflow, SuperAGI e CrewAI permitem criar, orquestrar e otimizar fluxos de trabalho de agentes com interfaces no-code/low-code
Edições de implantação gratuito e preços
As edições gratuito variam conforme os limites de uso (por exemplo, observações, rastreamentos, tokens ou unidades de trabalho). Os preços iniciais geralmente se referem a um plano básico, que pode ter restrições de recursos, usuários ou limites de uso.
CoreWeave Forge (W&B Weave)
Caso de uso: Depuração de falhas em sistemas multiagente por meio do rastreamento de como os erros se propagam entre as chamadas do agente.
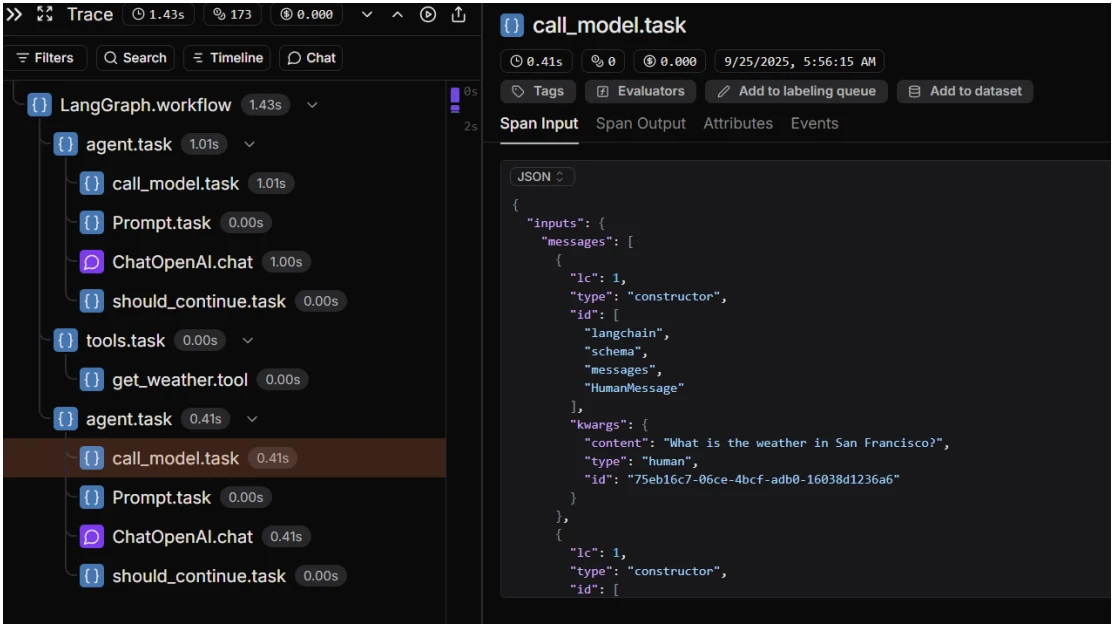
O W&B Weave, parte do CoreWeave Forge (anteriormente Weights & Biases), registra rastreamentos estruturados de execução para sistemas multiagente, preservando os relacionamentos pai–filho entre as chamadas do agente.
Recursos de monitoramento do Weave
- Rastreamento hierárquico de agentes em vez de logs simples de solicitações
- Atribuição de custo e latência no nível do agente
- Suporte nativo para avaliadores aplicados diretamente aos rastreamentos.
Recursos de avaliação
O Weave também oferece avaliadores integrados para avaliação, incluindo:
- HallucinationFreeScorer para detectar alucinações,
- SummarizationScorer para avaliar a qualidade dos resumos,
- EmbeddingSimilarityScorer para similaridade semântica,
- ValidJSONScorer e ValidXMLScorer para validação de formato,
- PydanticScorer para conformidade de esquema,
- OpenAIModerationScorer para segurança de conteúdo,
- avaliadores RAGAS como ContextEntityRecallScorer,
- ContextRelevancyScorer para avaliação de sistemas RAG.
Mais adequado para: Equipes que executam fluxos de trabalho de múltiplas etapas ou multiagente e precisam de análise de causa raiz em nível de rastreamento, em vez de métricas superficiais.
Langfuse
Casos de uso: Rastrear interações de LLM, gerenciar versões de prompt e monitorar o desempenho do modelo com sessões de usuários.
O Langfuse oferece visibilidade profunda na camada de prompt, capturando prompts, respostas, custos e rastreamentos de execução para ajudar a depurar, monitorar e otimizar aplicações LLM.
No entanto, o Langfuse pode não ser adequado para equipes que preferem fluxos de trabalho baseados em Git para gerenciamento de código e prompts, pois seu sistema externo de gerenciamento de prompts pode não oferecer o mesmo nível de controle de versão e colaboração.
Recursos de monitoramento do Langfuse
- Visibilidade da evolução dos prompts e dos padrões de uso
- Análise baseada em sessões, adequada para aplicações voltadas ao usuário
- Modelo prático de metadados e tags para filtragem e revisão
Recursos de nível empresarial:
Alguns desses recursos incluem:
- Níveis de log: Ajuste a verbosidade dos logs para obter insights mais granulares.
- Multimodalidade: Suporta texto, imagens, áudio e outros formatos para aplicações LLM multimodais.
- Releases e versionamento: Registre o histórico de versões e veja como novos releases afetam o desempenho do modelo.
- URLs de rastreamento: Acesse rastreamentos detalhados por meio de URLs exclusivas para inspeção e depuração adicionais.
- Grafos de agentes: Visualize interações e dependências dos agentes para entender melhor o comportamento do agente.
- Amostragem: Colete dados representativos das interações para análise sem sobrecarregar o sistema.
- Rastreamento de tokens e custos: Acompanhe o uso de tokens e os custos de cada chamada de modelo, garantindo gerenciamento eficiente de recursos.
- Mascaramento: Proteja dados sensíveis ao mascará-los nos rastreamentos, garantindo privacidade e conformidade.
Mais adequado para: Equipes que iteram prompts e monitoram o uso em produção, especialmente onde as sessões de usuários são importantes.
Galileo
Casos de uso: Monitorar custo/latência, avaliar a qualidade da saída, bloquear respostas inseguras e fornecer correções acionáveis.
O Galileo rastreia métricas de custo, latência e qualidade da saída enquanto aplica verificações de segurança e conformidade em tempo real.
A plataforma combina observabilidade tradicional (latência, custo, desempenho) com depuração e avaliação com IA (detecção de alucinações, correção factual, coerência, aderência ao contexto).
Recursos de monitoramento do Galileo
- Identificação de modos de falha além de erros superficiais (por exemplo, alucinações que levam a entradas inválidas de ferramentas)
- Feedback prescritivo, como sugestões de mudanças de prompt ou adições de exemplos few-shot
- Forte acoplamento entre os resultados da avaliação e as correções recomendadas.
Mais adequado para: Organizações que priorizam qualidade de saída, segurança e ciclos rápidos de iteração com remediação orientada.
Guardrails AI
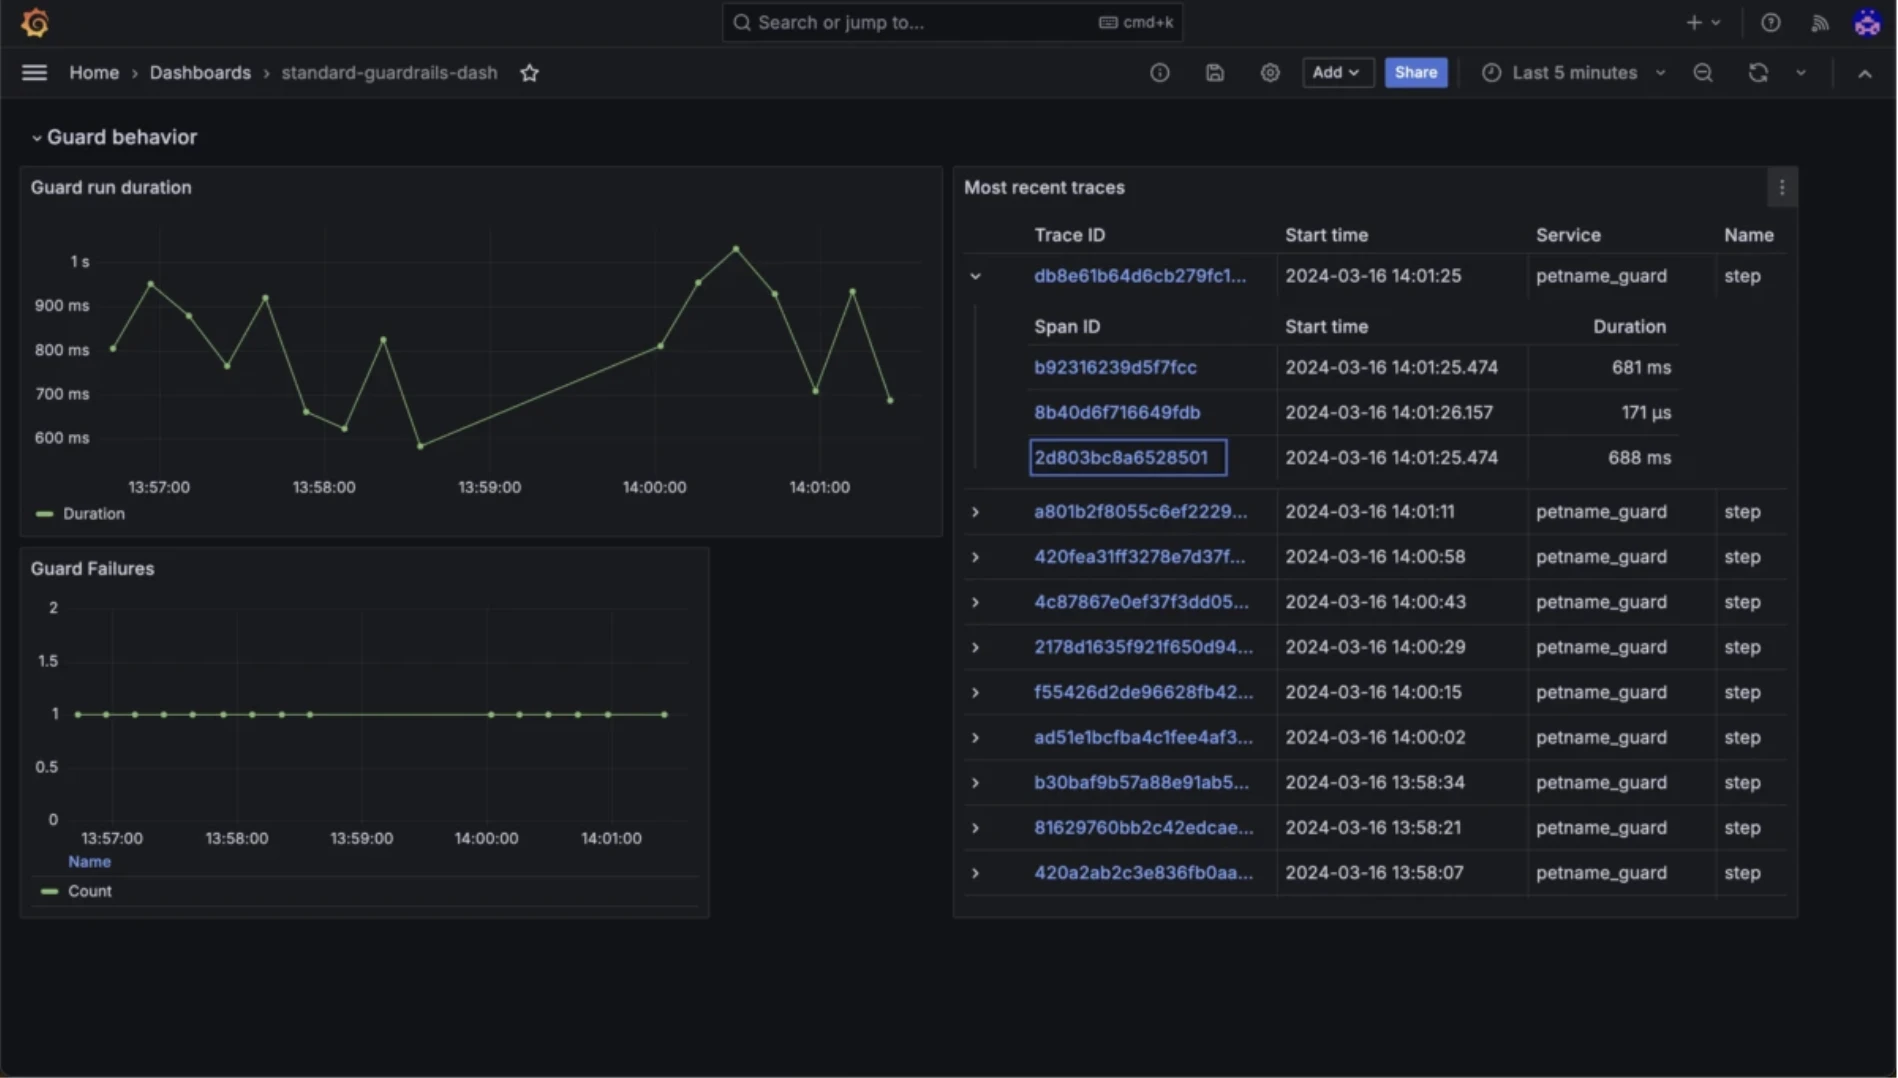
Casos de uso: Prevenir saídas prejudiciais, validar respostas de LLM e garantir conformidade com políticas de segurança
O Guardrails valida entradas e saídas de LLM em relação a regras configuráveis, incluindo toxicidade, viés, exposição de PII, sinalização de alucinações e conformidade de formato.
Guardrails AI: recursos de monitoramento
- Validação determinística por meio de especificações RAIL
- Guardas de entrada para detecção de injeção de prompt e jailbreak
- Novas tentativas automáticas quando a validação falha.
Mais adequado para
Equipes que precisam impor garantias estritas de segurança, conformidade ou formatação antes que as respostas sejam retornadas.
LangSmith
Casos de uso: Depuração de raciocínio do agente e de chamadas de ferramentas (centrado no LangChain)
O LangSmith captura rastreamentos completos de raciocínio para agentes baseados no LangChain, incluindo prompts, contexto recuperado, lógica de seleção de ferramentas, entradas/saídas de ferramentas, erros e exceções.
Recursos de monitoramento do LangSmith
- Inspeção passo a passo dos caminhos de decisão do agente
- Repetição de execuções e comparação lado a lado entre prompts, modelos ou ferramentas
- Integração estreita com o LangChain por meio de callbacks.
Mais adequado para
Equipes que criam com o LangChain e precisam depurar raciocínio incorreto ou invocação de ferramentas em detalhes.
Langtrace IA
Casos de uso: Identificar gargalos de custo e latência em aplicações LLM
O Langtrace rastreia contagens de tokens, duração da execução, custos de API e parâmetros de solicitações em pipelines de LLM usando rastreamentos compatíveis com OpenTelemetry.
Recursos de monitoramento do Langtrace IA
- Alinhamento com OpenTelemetry para integração com backends existentes
- Visibilidade dos fatores de custo e latência por etapa
- Versionamento leve de prompts e ambiente de testes.
Mais adequado para: Equipes que otimizam desempenho e gastos em fluxos de trabalho de LLM, em vez de avaliar a qualidade da saída.
Arize (Phoenix)
Casos de uso: Monitorar o drift do modelo, detectar viés e avaliar as saídas de LLM com sistemas abrangentes de pontuação
O Phoenix concentra-se em drift comportamental, detecção de viés e pontuação de LLM-como-juiz para relevância, toxicidade e precisão.
No entanto, ele tem maior sobrecarga de integração em comparação com proxies leves e não gerencia o versionamento de prompts de forma tão limpa quanto ferramentas dedicadas.
Recursos de monitoramento do Phoenix
- Núcleo open-source com extensões empresariais opcionais
- Ambiente interativo de prompts para desenvolvimento
- Detecção de drift para acompanhar mudanças comportamentais por tempo
- Verificações de viés para identificar vieses nas respostas,
- Pontuação de LLM-como-juiz para precisão, toxicidade e relevância.
Mais adequado para: Equipes que monitoram o comportamento do modelo no longo prazo e o risco de regressão, em vez de iterar prompts.
Agenta
Casos de uso: Descobrir qual prompt funciona melhor em qual modelo
O Agenta compara respostas de modelos em termos de custo, latência e qualidade da saída usando entradas compartilhadas e contexto controlado.
Recursos de monitoramento do Agenta
- Avaliação lado a lado de modelos
- Suporte à decisão antes da produção.
Mais adequado para: Avaliação em estágio inicial e seleção de modelos.
AgentOps.ai
Casos de uso: Monitorar o raciocínio do agente, acompanhar custos e depurar sessões em produção
O AgentOps captura rastreamentos de raciocínio, chamadas de ferramentas/API, estado da sessão, comportamento de cache e métricas de custo para agentes implantados.
Recursos de monitoramento do AgentOps
- Replay de sessão para depuração em produção
- Foco no comportamento do agente ao vivo, em vez de avaliação offline.
Mais adequado para: Equipes que executam agentes em produção e precisam de visibilidade operacional.
Braintrust
Casos de uso: Descobrir qual prompt, dataset ou modelo apresenta melhor desempenho com avaliação detalhada e análise de erros
O Braintrust avalia prompts, datasets e modelos em relação às saídas esperadas, rastreando latência, custo, erros de ferramentas e métricas de execução.
Recursos de monitoramento do Braintrust
- Avalie datasets de teste com entradas e saídas esperadas e compare prompts ou modelos lado a lado usando variáveis como
{{input}},{{expected}}e{{metadata}}. - Análises detalhadas de métricas, incluindo a qualidade da execução de ferramentas
Mais adequado para: Equipes que comparam modelos e prompts antes do lançamento.
AgentNeo
Casos de uso: Depurar interações multiagente, rastrear o uso de ferramentas e avaliar fluxos de trabalho de coordenação
O AgentNeo rastreia a comunicação dos agentes, o uso de ferramentas, os grafos de execução e o custo e a latência por agente por meio de um SDK Python.
Recursos de monitoramento do AgentNeo
- Open-source e executável localmente
- Painel local interativo (
localhost:3000) para monitoramento em tempo real de fluxos de trabalho multiagente. - Integração usando decoradores (por exemplo,
@tracer.trace_agent,@tracer.trace_tool)
Mais adequado para: Equipes de engenharia que experimentam sistemas multiagente.
 Adicionar como fonte preferencial
Laminar
Caso de uso: Acompanhar o desempenho em diferentes frameworks e modelos de LLM.
O Laminar rastreia spans de execução, custos, uso de tokens e percentis de latência em frameworks e modelos de LLM.
Recursos de monitoramento do Laminar
- Análise de desempenho independente de framework
- Inspeção detalhada de spans.
Mais adequado para: Análise comparativa de desempenho em stacks heterogêneos.
Helicone
Casos de uso: Rastrear fluxos de trabalho de agentes em múltiplas etapas e analisar padrões de sessão de usuários.
O Helicone captura volumes de solicitações, custos, erros, tendências de latência e fluxos de trabalho de agente em nível de sessão.
Recursos de monitoramento do Helicone
- Visibilidade da jornada do usuário
- Análise de tendências históricas.
Mais adequado para: Equipes de produto que monitoram padrões de uso e comportamento no nível do usuário.
Coval
Casos de uso: Simular milhares de conversas de agentes, testar interações de voz/chat e validar o comportamento antes da implantação.
A Coval simula milhares de conversas para medir a conclusão de tarefas, a correção e a eficácia das chamadas de ferramentas.
Recursos de monitoramento da Coval
- Testes de agentes baseados em simulação
- Detecção automática de regressões
- Suporte a agentes de voz e texto.
Mais adequado para: Validação pré-implantação e detecção de regressões.
Datadog
Casos de uso: Observabilidade de infraestrutura e aplicações com correlação de sinais de LLM.
Datadog coleta métricas de infraestrutura (CPU, memória, rede), dados de desempenho de aplicações (latência, taxas de erro, throughput) e logs. Para aplicações LLM, ele pode ingerir uso de tokens, custo por solicitação, latência do modelo e sinais relacionados à segurança, como tentativas de injeção de prompt.
Recursos de monitoramento do Datadog
- Observabilidade ampla e sistêmica em infraestrutura, aplicações e cargas de trabalho de IA
- Grande ecossistema de integrações (900+ integrações) que permite correlacionar o comportamento da IA com a saúde da infraestrutura
Mais adequado para: Organizações que desejam correlacionar o comportamento de LLM com a infraestrutura subjacente e o desempenho das aplicações, em vez de inspecionar o raciocínio do agente ou o prompt
Prometheus
Casos de uso: Monitorar o desempenho do sistema, acompanhar métricas de aplicações e configurar alertas para problemas de infraestrutura.
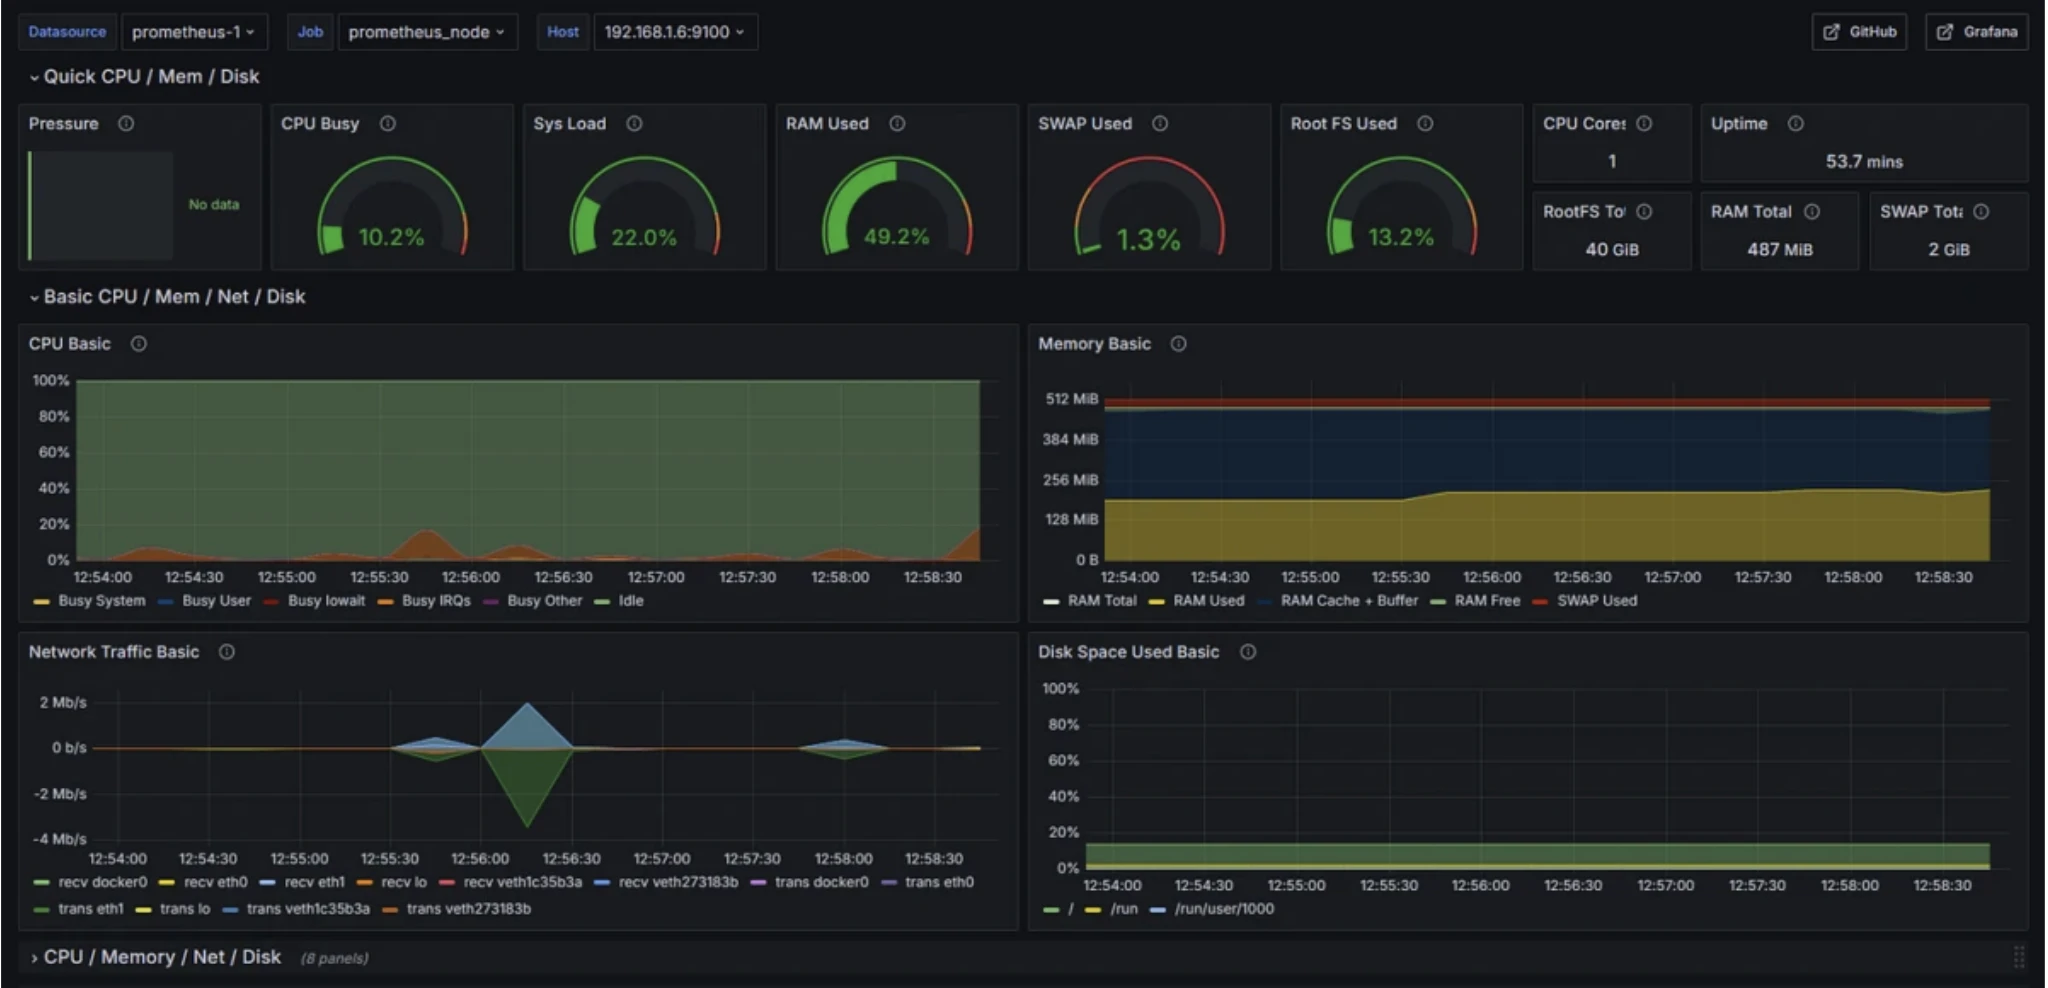
O Prometheus é um sistema de monitoramento open-source que coleta métricas de séries temporais de endpoints HTTP em intervalos regulares para acompanhar métricas de infraestrutura, aplicações, bancos de dados, contêineres e métricas de negócios personalizadas.
Recursos de monitoramento do Prometheus
- Coleta de métricas de séries temporais via scraping baseado em pull
- PromQL para consultas, agregações e condições de alerta
- Ecossistema de exportadores (por exemplo, Node Exporter) para ampla cobertura do sistema
Mais adequado para: Monitoramento de infraestrutura e aplicações com alertas baseados em regras.
Grafana
Casos de uso: Visualizar métricas, criar painéis e rotear alertas entre dados de LLM, agentes e infraestrutura.
O Grafana é uma plataforma open-source de visualização e análise que se integra a fontes de dados como Prometheus, OpenTelemetry e Datadog para fornecer painéis de observabilidade unificados.
Recursos de monitoramento do Grafana
- Painéis para métricas, logs e rastreamentos
- Correlação entre sistemas para sinais de LLM, agentes e infraestrutura
- Roteamento de alertas e gerenciamento de notificações.
Mais adequado para: Visualização centralizada de observabilidade e resposta a incidentes.
Tutorial: Observabilidade do LangChain com Langfuse
Construímos uma pipeline LangChain de múltiplas etapas com três estágios:
- análise da pergunta
- geração da resposta
- verificação da resposta
Depois de configurar a pipeline, nós a conectamos ao Langfuse para monitorar e acompanhar a execução em tempo real. Ao fazer isso, pudemos explorar como o Langfuse nos ajuda a coletar insights detalhados sobre o desempenho, os custos e o comportamento das aplicações de IA.
Veja o que observamos por meio do Langfuse:
Visão geral do painel
O Langfuse nos forneceu vários painéis que dão visibilidade a diferentes aspectos do desempenho da pipeline:
- Painel de custos: Acompanha os gastos em todas as chamadas de API, com análises detalhadas por modelo e período.
- Gerenciamento de uso: Monitora métricas de execução, como contagens de observações e alocação de recursos, ajudando a acompanhar como os recursos são usados durante a execução.
- Painel de latência: Este painel nos ajudou a analisar os tempos de resposta, detectar gargalos e visualizar tendências de desempenho.
Métricas de uso
O painel de métricas de uso nos deu os seguintes insights sobre o desempenho do sistema:
- Contagem total de rastreamentos: Acompanhamos oito rastreamentos, cada um representando um ciclo completo de pergunta e resposta na pipeline.
- Contagem total de observações: Em média, cada rastreamento teve 16 observações, refletindo a natureza de múltiplas etapas do processo.
Além disso, o Langfuse nos permite acompanhar padrões de uso, alocação de recursos e horários de pico nos últimos 7 dias, ajudando-nos a entender quando o sistema está mais ativo e como os recursos são distribuídos ao longo do tempo.
Inspeção de rastreamento
Ao analisar um rastreamento individual, pudemos ver informações detalhadas de execução:
- Linhas de rastreamento: Cada linha representa uma execução completa da pipeline com um ID de rastreamento exclusivo.
- Métricas de latência: O tempo de execução variou, indo de 0.00s a 34.08s.
- Contagens de tokens: O painel acompanhou o uso de tokens de entrada/saída, o que ajuda no gerenciamento de custos e eficiência.
- Filtragem por ambiente: Pudemos filtrar os rastreamentos com base nos ambientes de implantação (por exemplo, desenvolvimento, produção).
Detalhes individuais do rastreamento
Exploramos o rastreamento mais detalhadamente para entender a divisão da execução:
- Arquitetura de cadeia sequencial: O rastreamento exibiu um fluxo visual mostrando cada etapa, começando de SequentialChain → LLMChain → ChatOpenAI, com estrutura hierárquica.
- Acompanhamento de entrada/saída: A pergunta original, “Quais são os benefícios de usar o Langfuse para observabilidade de agentes de IA?”, foi rastreada em cada etapa, junto com as respectivas saídas produzidas pela IA em cada passo.
- Análise de tokens: Observamos que foram usados 1.203 tokens para entrada e 1.516 tokens para saída, o que tem implicações de custo relacionadas ao uso de tokens e ajuda a otimizar o gerenciamento de recursos.
- Dados de tempo: A latência total do rastreamento completo foi de 34.08s, dividida entre cada componente:
- SequentialChain → 14.02s
- LLMChain → 10.25s
- ChatOpenAI → 9.81s
- Informações do modelo: O Langfuse confirmou o uso do modelo Anthropic Claude-Sonnet-4, com detalhes sobre as configurações específicas, incluindo a configuração de temperatura.
- Saída formatada: Foram fornecidas as visualizações Preview e JSON para depuração, dando insights sobre a resposta do modelo em formato legível por humanos e em formato legível por máquina.
Análise automatizada
O Langfuse também forneceu avaliações automatizadas das nossas respostas:
- Avaliação de qualidade: O sistema avaliou a estrutura, a coerência e a completude das respostas, destacando seções bem organizadas, mas sugerindo que as respostas poderiam ser mais concisas.
- Sugestões de melhoria: Identificou seções com redundância, sugerindo onde a formulação poderia ser aprimorada, e combinou pontos relacionados para tornar a resposta mais transparente e eficiente.
- Insights de desempenho: O sistema deu feedback sobre o uso de tokens e a relevância das respostas, ajudando-nos a otimizar a eficiência e, ao mesmo tempo, garantir que a saída permaneça útil e dentro do tópico.
- Feedback estruturado: O feedback foi organizado em categorias, permitindo-nos tratar áreas específicas de melhoria de forma direcionada.
Análises de usuários
O Langfuse rastreia interações detalhadas entre os usuários e o agente de IA:
- Linha do tempo de atividade do usuário: Exibe a primeira e a última interação de cada usuário, ajudando a identificar usuários ativos versus inativos. Podemos ver quando os usuários interagiram com o sistema pela primeira e pela última vez.
- Acompanhamento de volume de eventos: Acompanha o número de eventos acionados por cada usuário. Por exemplo, alguns usuários geraram mais de 2.000 eventos, mostrando seu nível de engajamento com o sistema.
- Análise de consumo de tokens: Monitora o número total de tokens consumidos por cada usuário. O uso de tokens variou de 6.59K a 357K tokens, fornecendo insights sobre o uso de recursos.
- Atribuição de custos: Detalha os custos associados a cada usuário, facilitando o acompanhamento de gastos e a otimização da alocação de orçamento para uso de recursos.
- Identificação do usuário: Usa IDs de usuário anonimizados para manter a privacidade enquanto rastreia as interações individuais, ajudando na análise de uso sem comprometer a confidencialidade do usuário.
A visualização de sessão nos permite acompanhar detalhes granulares das interações dos usuários:
- Fluxo completo da conversa: Mostra a interação completa de pergunta e resposta, facilitando o acompanhamento de toda a conversa do início ao fim.
- Visibilidade da implementação: Exibe o código Python real usado durante a sessão, fornecendo insights sobre a implementação técnica.
- Correlação de entrada/saída: Vincula as perguntas dos usuários às respostas correspondentes do sistema, ajudando-nos a solucionar problemas e identificar onde podem ter ocorrido falhas na conversa.
- Metadados da sessão: Inclui detalhes técnicos, como tempo, contexto do usuário e dados específicos da implementação, oferecendo uma visão abrangente da execução da sessão.
Quando não usar ferramentas de observabilidade
- Desenvolvimento em estágio inicial: Se você ainda está validando o ajuste produto-mercado ou criando seus primeiros fluxos de trabalho de agentes, o foco deve estar na funcionalidade principal, e não em observabilidade extensa.
- Gargalos de API: Se os principais problemas são custos de API, latência ou cache, a prioridade imediata deve ser otimizar essas áreas, não acompanhar métricas no nível do sistema.
- Otimização de modelos: Se as melhorias são impulsionadas principalmente pela seleção de modelos, fine-tuning ou engenharia de prompts, as ferramentas de observabilidade para drift e viés podem ainda não ser necessárias.
Quando usar ferramentas de observabilidade
- Produção em escala: Quando você opera com vários modelos, agentes ou cadeias, as ferramentas de observabilidade são essenciais para monitorar o desempenho e garantir a saúde do sistema.
- Aplicações empresariais ou voltadas ao cliente: Para aplicações em que confiabilidade, segurança e conformidade são inegociáveis, as ferramentas de observabilidade fornecem a visibilidade e o controle necessários.
- Monitoramento contínuo: Quando você precisa monitorar drift, viés, desempenho e problemas de segurança ao longo do tempo, o que não pode ser facilmente capturado com scripts básicos ou verificações manuais, as ferramentas de observabilidade são cruciais.
- Cenários de alto risco: Em ambientes onde o custo da falha (por exemplo, alucinações, saídas inseguras) é significativo, a observabilidade garante que os riscos sejam minimizados e os problemas detectados precocemente.
Metodologia do benchmark
Para avaliar a sobrecarga de desempenho das plataformas de observabilidade em aplicações LLM em produção, desenvolvemos uma abordagem sistemática de benchmarking usando um fluxo de trabalho agêntico do mundo real.
Aplicação de teste
Construímos um sistema sequencial multiagente de planejamento de viagens usando LangChain que processa solicitações de viagem em linguagem natural por meio de cinco etapas:
- Agente parser: Extrai dados estruturados (origem, destino, datas, duração) da entrada do usuário
- Agente localizador de voos: Recupera voos disponíveis por meio da API Amadeus
- Agente repórter de clima: Busca previsões do tempo do destino usando a WeatherAPI
- Agente recomendador de atividades: Sugere atividades com base nas condições climáticas
- Agente planejador de viagens: Sintetiza todas as saídas em um itinerário abrangente
O sistema usa Claude 4 Haiku via OpenRouter para todas as chamadas de LLM e integra APIs externas para dados em tempo real.
Design do benchmark
Estabelecimento da linha de base: Primeiro medimos o desempenho da aplicação sem nenhuma instrumentação de observabilidade, executando 100 consultas idênticas para estabelecer uma linha de base para comparação.
Integração da plataforma: Em seguida, integramos cinco plataformas líderes de observabilidade (LangSmith, Laminar, AgentOps, Langfuse) uma de cada vez, instrumentando os mesmos pontos de rastreamento em todas as plataformas para manter a consistência.
Execução sequencial: Cada plataforma foi testada de forma independente, executando todas as 100 consultas consecutivamente antes de passar para a próxima plataforma. Essa abordagem minimiza a variabilidade de fatores externos, como condições de rede ou limites de taxa de API.
Ambiente controlado: Todos os testes foram executados na mesma infraestrutura de servidor com conjuntos de consultas idênticos para garantir uma comparação justa. Para isolar a sobrecarga das variações de latência induzidas por LLM, configuramos o modelo com temperature=0 e prompts estruturados para minimizar a variabilidade das respostas entre as execuções.
Métricas coletadas
Para cada plataforma, medimos a latência média e calculamos a sobrecarga como a latência adicional introduzida em comparação com a linha de base: ((Platform Latency - Base Latency) / Base Latency) × 100
Perguntas frequentes
Observabilidade é a capacidade de entender o funcionamento interno de um agente de IA examinando sinais externos, como logs, métricas e rastreamentos.
Para agentes de IA, isso envolve monitorar ações, uso de ferramentas, interações com modelos e respostas para solucionar problemas e melhorar o desempenho.
A observabilidade de agentes é crucial para acompanhar e melhorar o desempenho da IA ao possibilitar:
Entender os trade-offs: Ajuda a medir métricas-chave, como precisão e custo, facilitando o equilíbrio entre desempenho e uso de recursos.
Medir a latência: O acompanhamento da latência em tempo real oferece insights sobre os tempos de resposta, ajudando a otimizar o desempenho do agente.
Detectar entradas maliciosas: A observabilidade ajuda a identificar linguagem prejudicial e injeções de prompt, permitindo intervenção imediata para evitar problemas.
Monitoramento do feedback do usuário: Ao observar as interações e o feedback dos usuários, a observabilidade fornece dados valiosos para a melhoria contínua e o fine-tuning dos agentes.
Os principais componentes incluem:
– Acompanhamento de ações: Monitorar cada etapa executada pelo agente.
– Uso de ferramentas: Observar as ferramentas e os recursos que o agente usa.
– Medição de latência: Monitorar os tempos de resposta para otimizar o desempenho.
– Avaliações: Avaliar o comportamento do agente e o desempenho do modelo.
– Detecção de entradas maliciosas: Identificar prompts prejudiciais ou ataques.
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{15 Ferramentas de Observabilidade de Agentes de IA: AgentOps e Langfuse}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/agentic-monitoring}},
  note   = {AIMultiple. Acessado em 3 junho 2026}
}Resultados e carimbos de data/hora de 35 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 5 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
8 atualizaçõesAtualizada a seção "Potenciais razões por trás das diferenças de desempenho" com novas explicações e exemplos.
Expandida a seção 'Plataformas de observabilidade de agentes de IA' com possíveis razões para as diferenças de desempenho.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

A seguir, leia
Top 10 softwares MSP tudo-em-um comparados: recursos e preços


Principais Arreios de Agente: Claude Code vs Codex

Benchmark de Plataformas de Agentes de IA: Claude Managed Agents vs Google Vertex Agent Engine
















Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.