


Pesquisa aprofundada de IA: Codex vs Claude vs Grok vs Exa

Uma ferramenta de pesquisa aprofundada responde a uma pergunta com um relatório escrito em vez de uma página de links. Executamos cinco maneiras de produzir um relatório sobre os mesmos 20 briefings de pesquisa de negócios e pontuamos cada relatório de acordo com regras definidas antes das execuções para encontrar a melhor ferramenta para pesquisa aprofundada. Quatro das cinco são agentes de codificação, ferramentas de linha de comando criadas para trabalho de software que também podem pesquisar e ler a web; a quinta, Exa Agent, é criada para pesquisa.
Resultados do DR-20 Bench
Cada uma das cinco ferramentas produziu um relatório para cada uma das 20 tarefas, 100 relatórios no total, avaliados às cegas com base em regras definidas antes das execuções. Veja mais detalhes na metodologia.
O único produto de pesquisa aprofundada criado especificamente para isso terminou abaixo de três dos quatro agentes de codificação. O Exa Agent pontuou 0.584, e cada uma dessas três diferenças sobrevive à correção de Holm em todas as dez comparações pareadas. Nesses briefings, o Codex CLI, o Claude Code e o Grok CLI pontuaram acima do produto criado para essa função.
O Exa Agent e o Gemini CLI não apresentaram diferença estatisticamente significativa nas pontuações de requisitos.
Não encontramos diferença estatisticamente significativa entre o Codex CLI e o Claude Code nessas 20 tarefas. A diferença é de 0.015 em uma escala de 0 a 1, com um p não ajustado de 0.67 e 0.96 após a correção de Holm. Em 10.000 amostras bootstrap, ambos tiveram um intervalo de classificação de 95% de 1 a 2. Eles lideram em medidas diferentes: o Codex CLI nos requisitos escritos por 0.015, o Claude Code na reprodução de fatos por 1.2 pontos percentuais.
Fatos exatos reproduzidos
O Claude Code reproduziu integralmente 202 dos 434 itens factuais exigidos, o Codex CLI 198 e o Exa Agent 89. Nenhuma ferramenta atingiu metade. Um item recebia crédito somente quando o relatório incluía corretamente todos os detalhes exigidos. Essa verificação abrangeu uma lista de fatos predefinida; não auditamos cada afirmação dos relatórios.
Custo e qualidade da pesquisa
O Grok CLI pontuou 0.699 a US$ 1.91 por tarefa; os dois líderes custaram de US$ 13.38 a US$ 18.35, sete a dez vezes mais. O Grok ficou atrás do Claude Code por 0.076, com um p ajustado por Holm de 0.006. Sua diferença de 0.091 para o Codex CLI não foi significativa após a correção, em 0.072.
As duas ferramentas mais baratas também tiveram as menores pontuações. O Gemini CLI custou US$ 0.58 por tarefa e pontuou 0.565; o Exa Agent custou US$ 1.00 e pontuou 0.584, uma diferença com um p ajustado por Holm de 0.958.
O Codex CLI, o Claude Code e o Grok CLI rodaram com assinaturas aqui; seus números são equivalentes de tabela de API. Veja os preços de LLM para saber quanto custam essas assinaturas e suas tarifas de API. O Exa foi cobrado como uso de API e US$ 20.00 é o gasto real. O custo de US$ 0.58 por tarefa do Gemini cobre apenas tokens e exclui o search grounding, cuja contagem faturável de consultas não foi capturada.
Tempo de tarefa e qualidade da pesquisa
Os dois líderes também são os dois mais lentos. A tarefa mediana do Codex CLI levou 42 minutos para uma pontuação de 0.790, e a do Claude Code levou 36 minutos para 0.775, contra 13 minutos do Grok CLI para 0.699. O tempo de execução não ordena os demais. O Gemini CLI levou 1.5 minutos a mais que o Exa Agent e pontuou 0.019 a menos.
Comprimento do relatório e trabalho feito
O contraexemplo mais claro de que mais longo não é melhor está no topo da tabela. No relatório mediano, o Claude Code usa 271 palavras por requisito atendido, e o Codex CLI 137, e os dois pontuam com diferença de 0.015 entre si. O Exa Agent é o mais econômico, com 91 palavras por requisito, para uma pontuação de 0.584.
Amplitude e qualidade das fontes se separam. O relatório mediano do Claude Code cita 28 sites distintos, contra 16 do Codex CLI, enquanto uma fatia maior das citações do Codex CLI aponta para páginas oficiais e primárias, 34,8% contra 25,8%. O Gemini CLI cita com menor densidade, com 4.2 links por 1.000 palavras.
Alguns links citados estavam quebrados. Contamos URLs que retornaram um erro 404 ou 410 ou tinham um formato inválido. Os totais em 20 relatórios por ferramenta foram:
- Gemini CLI: 63
- Claude Code: 26
- Grok CLI: 16
- Codex CLI: 14
- Exa Agent: 14
Desenvolvimentos em ferramentas de pesquisa aprofundada de IA
A pesquisa aprofundada chegou à API do Gemini
O Google adicionou o Deep Research à API do Gemini como um agente que os desenvolvedores chamam diretamente, junto com o recurso que já vem no aplicativo Gemini.1 Ele é disponibilizado em duas versões: deep-research-preview-04-2026 para velocidade, e deep-research-max-preview-04-2026 para abrangência.
O Google precifica o recurso no modelo pay-as-you-go sobre os modelos e ferramentas subjacentes e estima uma tarefa típica entre US$ 1 e US$ 3 para a versão padrão e entre US$ 3 e US$ 7 para a Max. Uma tarefa é executada em segundo plano e é limitada a 60 minutos, com a maioria terminando em até 20.
Exa indexou publicações acadêmicas
A Exa lançou a busca semântica em artigos acadêmicos em 23 de julho de 2026, abrangendo cerca de 350 milhões de publicações e 30 milhões de autores.2 A proposta é encontrar um artigo a partir de uma memória vaga, em vez de um título exato.
A Exa relata 86,4% de recall em seu benchmark de recuperação, contra 66,8% do Perplexity e 28,0% do Google Scholar. Esses são os números do próprio fornecedor em seu próprio benchmark, portanto trate-os como uma indicação, e não como uma classificação consolidada; o mesmo artigo cita duas latências médias diferentes, o que é um motivo para aguardar uma verificação independente.
O Deep Lookup da Bright Data responde a uma pergunta diferente
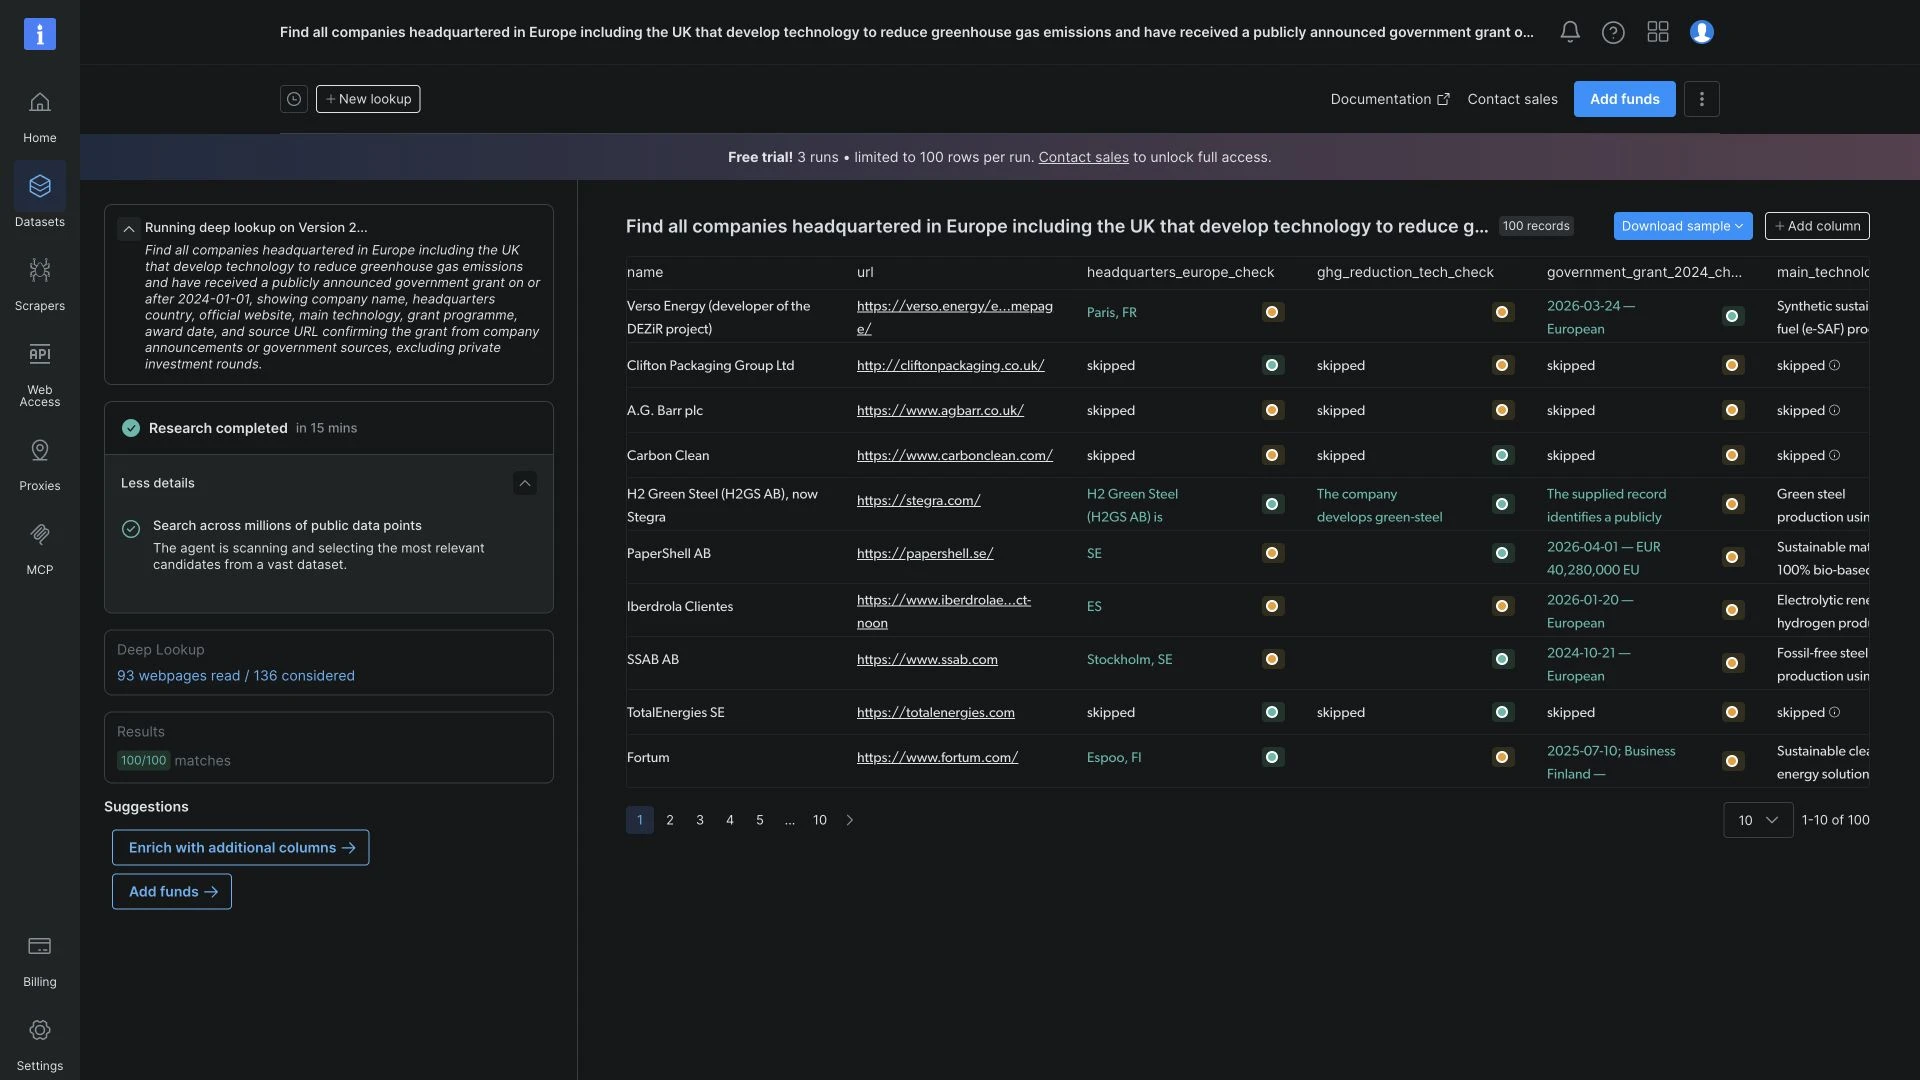
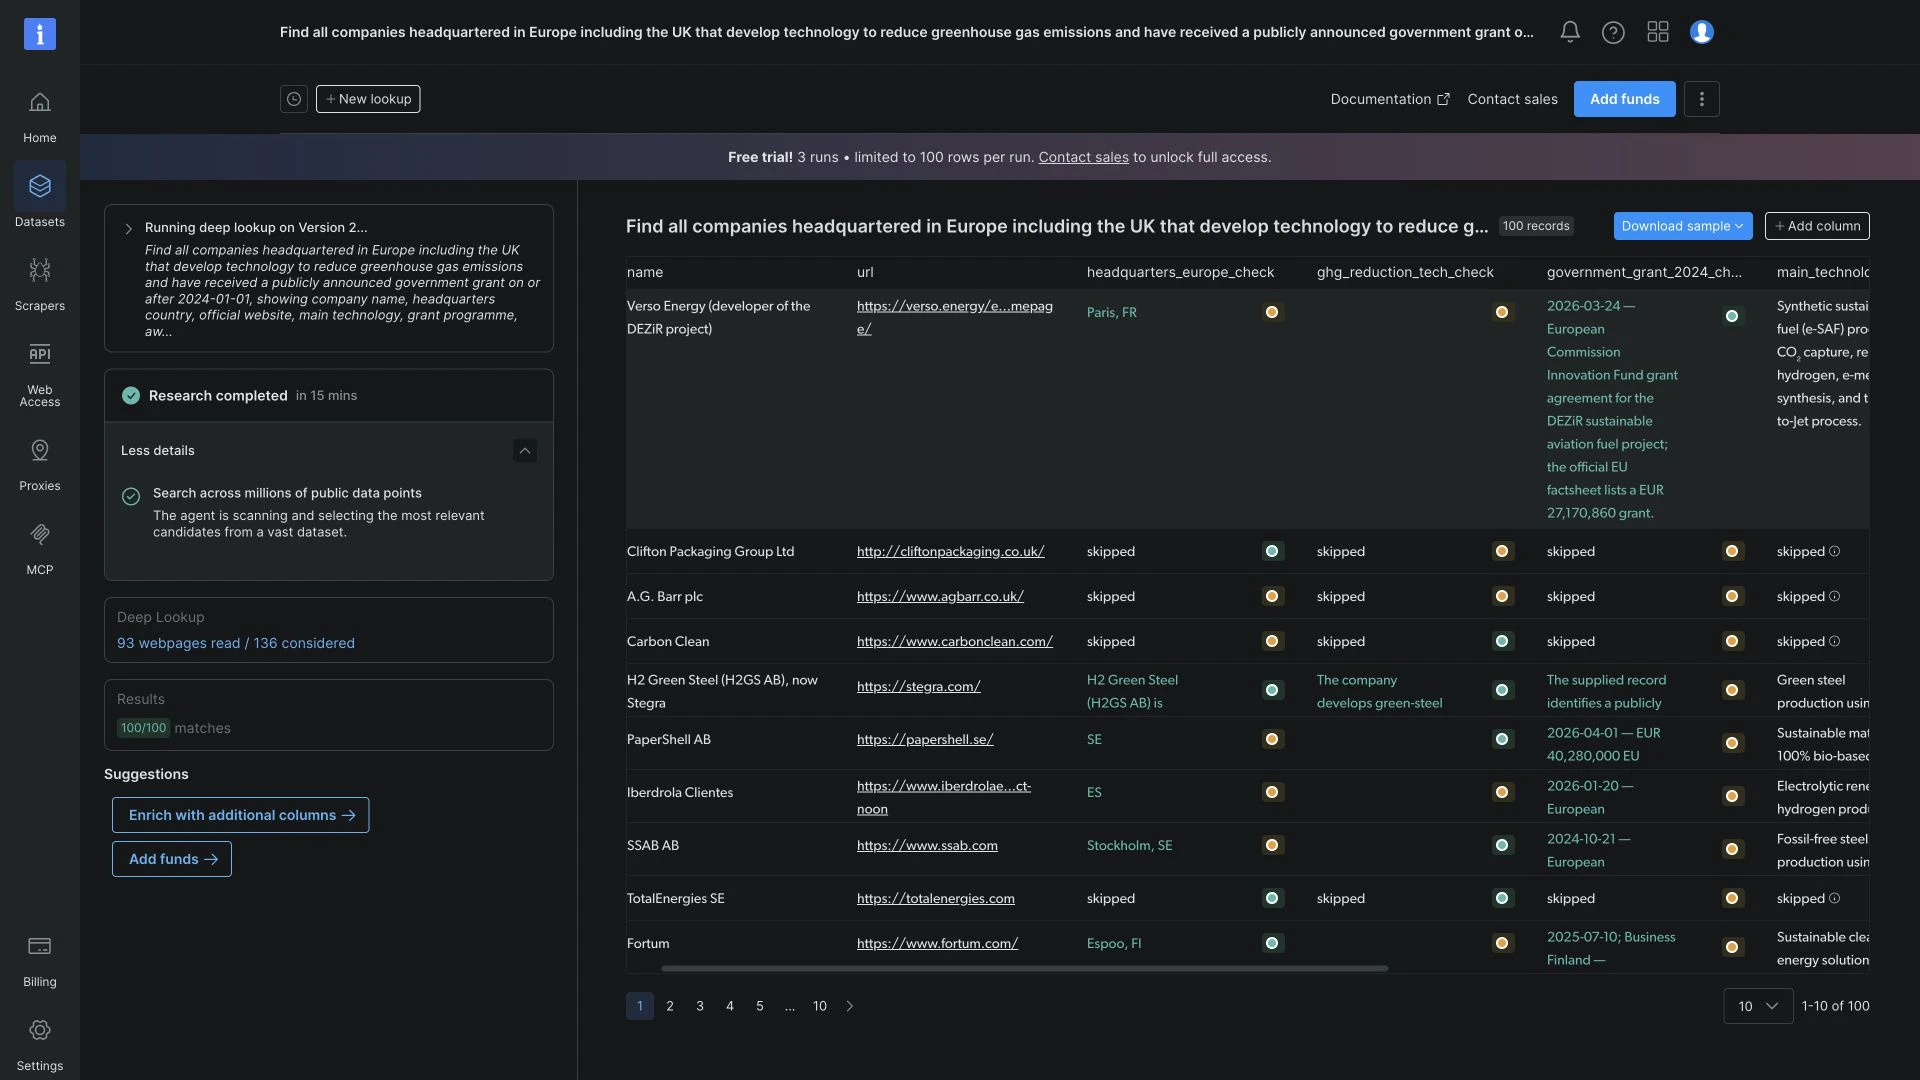
O Deep Lookup da Bright Data retorna linhas de entidades, não um relatório de pesquisa escrito. Cada linha representa uma empresa, pessoa ou produto. Os usuários podem criar listas para prospecção de vendas, pesquisa de investimentos ou recrutamento.3
Pesquisamos empresas europeias que desenvolvem tecnologia para reduzir emissões de gases de efeito estufa. A consulta incluiu o Reino Unido e exigiu um subsídio governamental anunciado publicamente desde 1 de janeiro de 2024.
O Deep Lookup criou uma coluna separada para cada condição. Ao expandir uma linha, eram exibidas explicações mais longas, com indicadores de confiança coloridos ao lado de detalhes individuais. A interface relatou uma execução de 15 minutos que atingiu o limite de 100 registros do teste.
Colunas adicionais continham descrições de tecnologia, programas de subsídios, datas de concessão e links de fontes. Os links nos permitiram verificar as alegações de subsídios em relação aos anúncios. O menu de download oferecia os formatos CSV e JSON.3
Equipes de vendas podem usar o Deep Lookup para encontrar empresas em um setor e região-alvo. Investidores podem identificar negócios que desenvolvem uma tecnologia específica ou recebem financiamento público. Recrutadores podem pesquisar profissionais com funções e experiência relevantes.3
Combinar várias condições de pesquisa com colunas de resultados personalizadas permite que as equipes criem listas com base em seus próprios critérios e comparem os detalhes em um só lugar.
A ferramenta Deep Research do Azure traz um aviso de limite de dados
A Microsoft oferece o Deep Research no Azure AI Foundry Agent Service, acessível a partir dos SDKs de Python, C# e JavaScript, e agora documentado em suas ferramentas clássicas de agentes.4
O motivo para ler essa página antes de adotá-la está na própria página: a Microsoft afirma que a consulta de pesquisa do Bing, os parâmetros da ferramenta e a chave do recurso são transferidos para fora do limite de conformidade do Azure para o Grounding with Bing Search. As equipes que escolheram o Azure para que nada saia do limite devem verificar quais partes de uma execução de pesquisa o cruzam.
Benefícios das ferramentas de pesquisa aprofundada de IA
Um relatório de pesquisa com fontes em minutos
Em nosso benchmark, os tempos medianos das tarefas variaram de 5.5 a 42 minutos, dependendo da ferramenta. Cada execução produziu um relatório de pesquisa com links de fontes. Não medimos quanto tempo uma pessoa levaria para concluir as mesmas tarefas.
As pontuações de requisitos chegaram a 0.790 no topo entre as cinco ferramentas e 20 briefings. Os requisitos cobrem todo o relatório, das seções solicitadas à aritmética na tabela de custos, portanto uma pontuação nesse nível significa que a maior parte do briefing foi respondida na forma solicitada.
Amplitude em uma única passada
Um agente de pesquisa pode reunir material de vários sites para uma comparação de fornecedores, uma revisão de mudanças em uma norma do setor ou uma introdução a um tópico de pesquisa desconhecido. O relatório resultante oferece ao leitor uma visão geral inicial e fontes para investigar mais a fundo.
Um rascunho de pesquisa editável
O resultado é um documento, portanto pode ser editado, questionado e executado novamente. Esse é um modo de trabalho diferente de uma página de resultados de pesquisa. Um documento com aparência de finalizado também é o risco: ele convida a menos verificação do que uma lista de links.
 Adicionar como fonte preferencial
Desafios e limitações das ferramentas de pesquisa aprofundada de IA
Os fatos são o ponto fraco, não a estrutura
A maioria das pessoas sabe que um LLM pode inventar uma resposta e verifica o que ele produz. Um relatório de pesquisa aprofundada convida menos a essa verificação, porque é longo, tem fontes e é bem organizado, então parece já verificado.
Um relatório pode atender aos requisitos de seções, tabelas e cálculos e, ainda assim, omitir ou distorcer fatos exigidos.
Antes de usar um relatório para tomar uma decisão, verifique as datas, números e conclusões regulatórias relevantes nas fontes originais.
Citações não significam que a fonte diz isso
Nossa auditoria de citações verificou se os links funcionavam e classificou suas fontes. Ela não verificou se cada página apoiava a afirmação associada a ela. Mesmo um link funcional para uma fonte oficial precisa dessa verificação: a página pode discutir o tópico sem apoiar o número ou a conclusão específica do relatório.
Comprimento não é profundidade
O relatório mediano do Claude Code continha 11.449 palavras, contra 5.734 do Codex CLI, sem diferença estatisticamente significativa nas pontuações de requisitos.
Os leitores devem considerar quanto material precisarão revisar em conjunto com o tempo de execução e o preço da ferramenta.
Viés, privacidade e dependência excessiva
Os dados de treinamento carregam os vieses do que foi escrito, e uma etapa de síntese pode endurecê-los em algo que soa como uma conclusão. Com uma ferramenta hospedada, qualquer documento interno enviado para contexto sai dos seus sistemas, o que vale a pena verificar nos termos do fornecedor antes que se torne rotina. O risco mais difícil de medir é o último: um relatório polido que ninguém verifica corrói o hábito de verificar.
Metodologia
Ambiente de teste
Executamos as quatro ferramentas CLI a partir de um servidor Linux na nuvem e acessamos o Exa Agent por meio de sua API. Cada uma usou suas próprias ferramentas de pesquisa.
Tarefas e procedimento de teste
- Escrevemos 20 briefings que cobrem seleção de fornecedores, planejamento de migração, modelos de custo e pesquisa regulatória. Cada um especificava uma data-limite de relatório e tinha respostas de referência construídas a partir de fontes primárias.
- Cada ferramenta recebeu os mesmos prompts de tarefa. Avaliamos um relatório por ferramenta por tarefa, totalizando 100 relatórios entre cinco ferramentas.
- Fixamos os prompts, as configurações de modelo e as regras de pontuação antes da produção. Nenhuma tarefa foi executada novamente para melhorar uma pontuação baixa.
Critérios de pontuação
- Requisitos: Cada tarefa tinha de 42 a 74 verificações de aprovação/reprovação. Por exemplo, uma tabela de custos pode precisar do preço unitário e da fonte.
- Penalidades: Defeitos predefinidos reduziam a pontuação, como tratar uma questão como resolvida depois de chamá-la de não resolvida em outro lugar do relatório. Pontuação = máx(0, (requisitos aprovados − penalidades acionadas) / total de requisitos). A pontuação geral de cada ferramenta é a média das pontuações de suas 20 tarefas. Também verificamos uma fórmula alternativa que deduz 0.1 por penalidade da fração de requisitos aprovados, com pontuação mínima de zero. Essa é a opção Penalidade alternativa do gráfico. A ordem das cinco ferramentas permaneceu inalterada.
- Detalhes factuais: Uma lista de verificação separada continha 434 fatos exigidos. Um item recebia crédito somente quando o relatório incluía corretamente todos os detalhes exigidos dentro da tolerância declarada. Respostas parciais não recebiam crédito. Essas verificações não contribuíram para a pontuação de requisitos. As porcentagens de fatos dão peso igual a cada tarefa. As contagens combinam os acertos em todos os 434 itens.
Juízes de modelo
- Removemos metadados de identificação e caminhos de arquivos locais antes da avaliação. Ambos os juízes receberam o mesmo relatório, regras de tarefa, fatos de referência e auditoria de citações.
- O GPT-5.6 Sol e o Grok 4.6 avaliaram cada relatório de forma independente. Para cada requisito e penalidade, cada juiz registrou um motivo ligado ao relatório antes de atribuir um veredito de aprovação/reprovação. Eles também verificaram cada item factual.
- O Claude Opus 5 resolveu divergências usando as mesmas evidências. As decisões nas quais os dois primeiros juízes concordaram permaneceram inalteradas. Os dois juízes iniciais concordaram em 93,3% dos vereditos de regras e 89,1% das decisões sobre itens factuais.
Análise estatística
Usamos testes pareados nas 20 tarefas e aplicamos a correção de Holm em todas as dez comparações pareadas de ferramentas. Estimamos intervalos de classificação de 95% reamostrando as tarefas 10.000 vezes.
Limitações
- Um relatório por ferramenta por tarefa não mede o quanto as respostas da mesma ferramenta variam entre execuções.
- Verificamos a disponibilidade dos links e o tipo de fonte, mas não verificamos se cada página citada apoiava a afirmação associada. As verificações que exigiam essa confirmação receberam veredito de reprovação em todas as ferramentas: verificações positivas não ganharam crédito e verificações negativas não acionaram penalidade.
- Refinamos oito tarefas após um piloto anterior. Mantemos os briefings não publicados para avaliações futuras.
Perguntas frequentes
A pesquisa com IA usa ferramentas de IA para encontrar, analisar e resumir informações. Uma ferramenta de pesquisa aprofundada vai além de uma resposta de chat: ela é executada por minutos, abre muitas fontes e produz um relatório com citações.
No que ela é boa, em nossa própria medição, é na forma da resposta. No que ela é fraca, é nos detalhes específicos. A mais forte das cinco ferramentas que testamos reproduziu 202 dos 434 valores, datas e nomes exigidos, e a mais fraca reproduziu 89.
É por isso que um relatório de pesquisa aprofundada precisa ser verificado antes que algo seja publicado. O relatório pode parecer finalizado mesmo que os números estejam errados. Benchmarks relacionados: codificação com IA.
As ferramentas de IA podem auxiliar em vários aspectos das revisões de literatura, incluindo a identificação de artigos relevantes, o resumo das principais descobertas e a organização de temas de pesquisa. Essas ferramentas podem processar grandes volumes de literatura acadêmica rapidamente e ajudar pesquisadores a identificar lacunas ou padrões entre estudos. No entanto, a IA não pode substituir totalmente o julgamento humano na avaliação da qualidade das fontes, na síntese de argumentos complexos ou na análise crítica. Os pesquisadores ainda precisam revisar, verificar e interpretar o conteúdo gerado por IA para garantir precisão e manter o rigor acadêmico em suas revisões de literatura.
As ferramentas de IA podem auxiliar na análise de dados e no trabalho estatístico limpando datasets, realizando testes estatísticos, criando visualizações e identificando padrões em grandes datasets. Essas ferramentas podem sugerir métodos estatísticos apropriados com base no tipo de dados e nas perguntas de pesquisa. No entanto, os pesquisadores devem entender o contexto dos dados e validar os resultados, pois a IA pode não perceber nuances específicas do domínio ou fazer suposições inadequadas.
A maioria das ferramentas modernas de pesquisa de IA usa interfaces de linguagem natural que não exigem habilidades de programação. No entanto, noções básicas de letramento de dados e compreensão de conceitos fundamentais de pesquisa ajudam os usuários a formular melhores consultas e interpretar os resultados de forma mais eficaz. Aplicações avançadas podem se beneficiar de conhecimento técnico para análises personalizadas ou fluxos de trabalho especializados.
Abra cada fonte usada para uma afirmação importante e verifique se ela apoia os números, datas e conclusões do relatório. Confirme que a fonte se aplica ao período e ao contexto relevantes. A lista de verificação de fatos do nosso benchmark cobriu detalhes predefinidos, portanto suas pontuações não estabelecem a precisão de cada afirmação em um relatório.
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{Pesquisa aprofundada de IA: Codex vs Claude vs Grok vs Exa}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-deep-research}},
  note   = {AIMultiple. Acessado em 11 setembro 2026}
}Resultados e carimbos de data/hora de 10 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 2 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
8 atualizaçõesSubstituído o resumo de Agentes versus Modelos de Pesquisa Profunda pela constatação de que os agentes igualam sua precisão a menor custo.
Adicionada uma seção de benchmark Agentes vs. Modelos de Pesquisa Profunda comparando seis ferramentas em cinco tarefas.
Adicionada uma seção de metodologia do benchmark detalhando as cinco tarefas de pesquisa, as fontes de referência, a pontuação e as interfaces das ferramentas.
Adicionado o DR-2T (Deep Research 2 Task) Bench à seção de benchmark de pesquisa profunda de IA.
Links de referência








Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.