


AIM-Text-to-SQL Benchmark: Precisão de SQL em mais de 70 LLMs
We evaluated SQL answers from 70+ LLMs on a 759-question BIRD-SQL subset. Each model selected a database from 11 candidates, then produced a query.

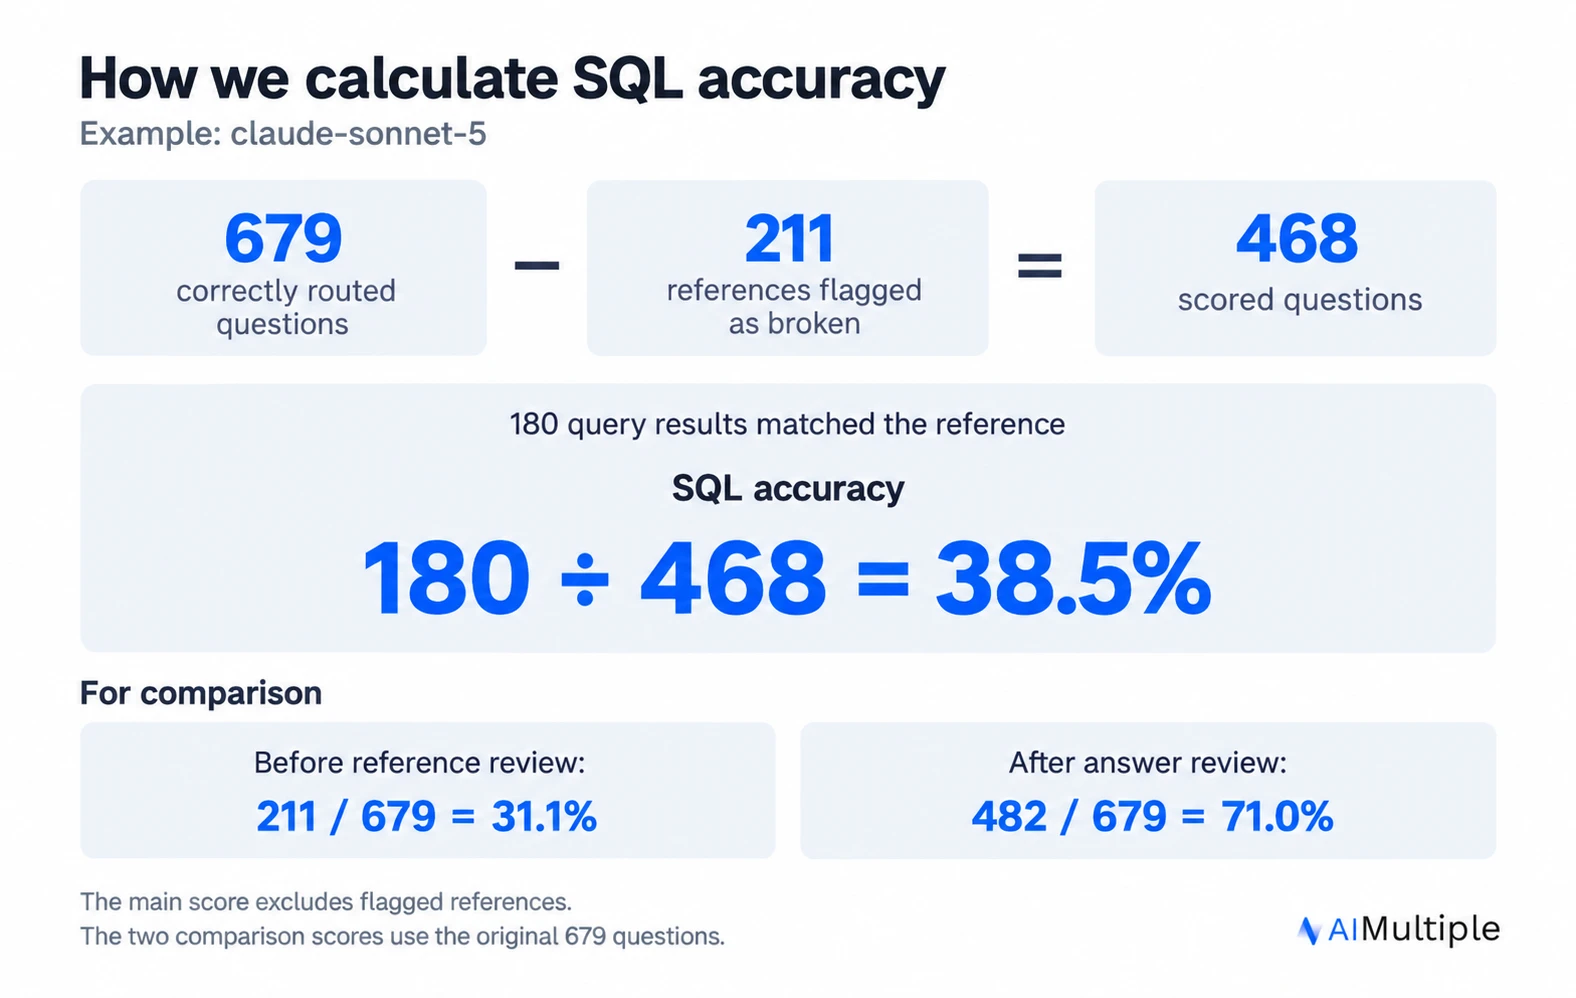
Precisão de SQL é a porcentagem de consultas pontuadas que retornam o resultado de referência. Rotas incorretas e referências sinalizadas como quebradas são excluídas. Uma consulta de referência é o SQL fornecido como a resposta esperada.
Cada modelo alcança um conjunto diferente de perguntas SQL porque a pontuação depende de suas escolhas de banco de dados. As diferenças nesses subconjuntos e na configuração de execução limitam as comparações.
Descobertas de Text-to-SQL
Opus 5.5 registrou 87,8% de precisão de SQL
claude-opus-5.5 correspondeu ao resultado de referência em 444 de 506 perguntas pontuadas. gemini-4-argon veio em seguida com 78,6% (407 de 518), depois gemini-3.8-flash com 77,2% (342 de 443). Essas foram as três maiores pontuações de precisão de SQL no painel de 76 modelos. Muse Wonder registrou 56,4% (285 de 505).
A pontuação exclui escolhas incorretas de banco de dados e referências sinalizadas como quebradas. Opus 5.5 usou Claude Code. Gemini 4 Argon e Gemini 3.8 Flash usaram OpenRouter. O ranking reflete tanto as condições de execução quanto as diferenças nas perguntas que cada modelo roteou corretamente.
Três variantes Pro pontuaram abaixo dos modelos base
gpt-6.1-sol-pro registrou 63,6% de precisão de SQL, em comparação com 65,1% para gpt-6.1-sol. gpt-6-sol-pro marcou 53,6% contra 53,8% para gpt-6-sol. gpt-6-luna-pro marcou 44,2% contra 45,4% para gpt-6-luna.
Todos os seis modelos usaram OpenRouter. Essas pontuações vêm de uma execução por modelo e de diferentes subconjuntos de perguntas roteadas corretamente. Execuções repetidas com as mesmas perguntas SQL seriam necessárias para avaliar se as pequenas lacunas persistem.
Custo vs. precisão de SQL
O custo de execução cobre as respostas de roteamento e SQL retidas da execução de benchmark de cada modelo. A meta era 759 perguntas. Sete execuções têm menos respostas retidas. Testes de fumaça separados, tentativas de repetição descartadas e chamadas do júri são excluídos. A precisão de SQL usa as perguntas roteadas corretamente de cada modelo após excluir referências sinalizadas como quebradas.
gemini-3-flash-preview registrou 67,7% de precisão de SQL a $7,67 por execução. gemini-3.8-flash alcançou 77,2% a $26.48. A pontuação de 87,8% do Opus 5.5 está associada a um custo estimado equivalente de API de $188.71. Gemini 4 Argon alcançou 78,6% a $41,41 em custos de execução retidos. Muse Wonder alcançou 56,4% a $77,44 em custos de execução retidos.
Os 73 modelos de API usam custos medidos. Opus 5.5, Fable 5.1 e GPT-6 Astra têm estimativas rotuladas separadamente com base em seus tokens CLI registrados e nos preços da OpenRouter verificados em 1º de outubro de 2026, com o uso de cache registrado preservado.
Os custos incluem exploração de banco de dados, e as pontuações SQL cobrem diferentes subconjuntos de perguntas. Esta comparação, portanto, descreve o custo e a precisão do fluxo de trabalho combinado do benchmark. Os custos isolados de geração de SQL não foram medidos. O benchmark de RAG agêntico relata a seleção de banco de dados separadamente.
Resultados de precisão de SQL
Antes da revisão de referência mede a correspondência exata de resultados em todas as perguntas roteadas corretamente. Depois da revisão de respostas adiciona crédito para respostas aceitas pelo júri. Ambas as colunas de comparação usam o denominador original, enquanto a precisão de SQL exclui referências sinalizadas.
Condições que afetam a precisão de SQL
As dicas do BIRD aumentaram a precisão de Gemini Flash em SQL em 8.7 pontos
Repetimos gemini-3-flash-preview com as evidências suplementares do BIRD. Nas perguntas roteadas corretamente em ambas as condições, a precisão de SQL subiu de 67,5% para 76,2%. A precisão estrita, antes da revisão de referência, subiu de 55,0% para 61,6%.
Este foi um experimento com um único modelo. Ele não estabelece uma melhora comum para o painel de 74 modelos. O painel principal omite as dicas porque elas também podem revelar qual banco de dados selecionar.
Modelos alcançaram conjuntos diferentes de perguntas SQL
As escolhas de banco de dados de cada modelo determinam quais perguntas chegam à pontuação de SQL. Para claude-opus-5, o denominador estrito contém 717 perguntas, incluindo 156 do grupo de roteamento mais difícil. Para nova-lite-v1, contém 285 perguntas, incluindo 22 desse grupo. As participações são 21,8% e 7,7%.
As porcentagens de SQL deles, portanto, combinam o desempenho de escrita de consultas com a dificuldade dos casos que chegaram à pontuação. Uma comparação controlada de SQL forneceria a cada modelo o banco de dados correto para as mesmas perguntas. Esse experimento não foi executado.
A seleção de perguntas também importa ao comparar benchmarks de IA que fornecem esquemas, dicas ou orçamentos de ferramentas diferentes.
Descobertas da revisão de referência e de respostas
A auditoria de referência sinalizou 236 de 759 consultas
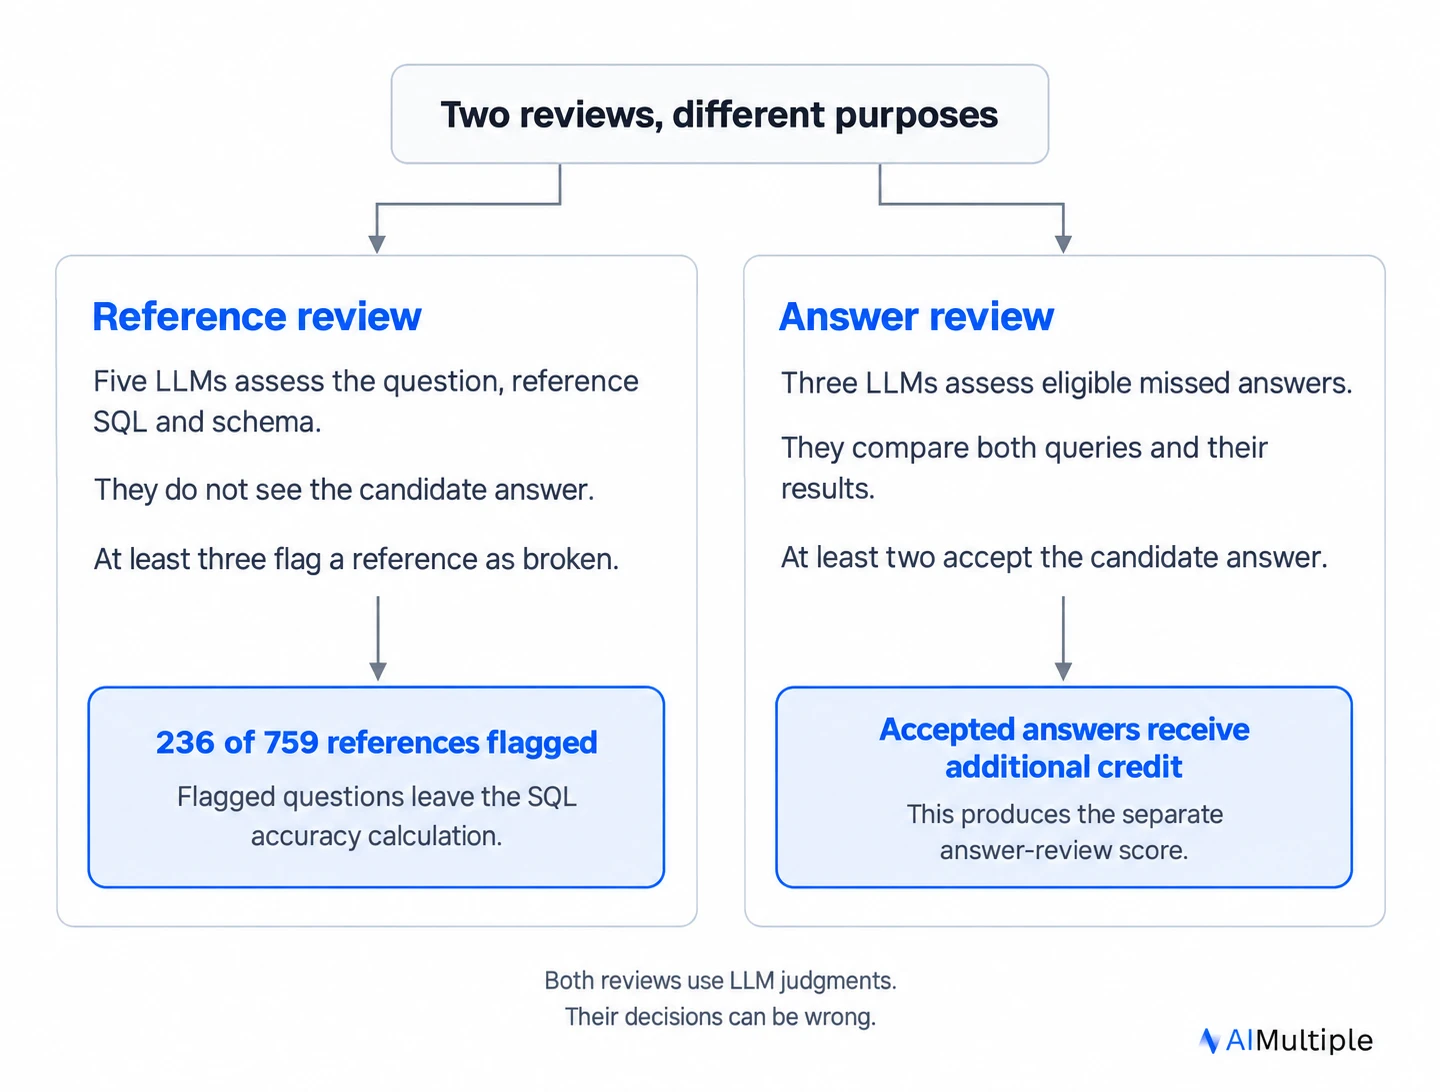
Cinco modelos avaliaram cada consulta de referência em relação à sua pergunta e às informações de esquema disponíveis. Eles não viram nenhuma resposta candidata do modelo. Uma maioria de pelo menos três marcou 236 referências como quebradas, ou 31,1% do conjunto.
Após a auditoria, o proprietário do benchmark revisou as sinalizações. Anotadores humanos independentes não repetiram essa revisão. Essas porcentagens descrevem o subconjunto auditado. Elas não devem ser generalizadas para todo o BIRD.
Respostas equivalentes adicionaram 22.7 pontos à pontuação de claude-sonnet-5
claude-sonnet-5 passou em 211 de 679 perguntas pontuadas estritamente, ou 31,1%. Um júri aceitou outras 154 respostas como equivalentes à referência. Essas contribuíram com 22.7 pontos percentuais.
Outras 117 respostas receberam crédito porque o júri aceitou a consulta do modelo e rejeitou a referência. Essas contribuíram com 17.2 pontos. Together, as duas categorias elevaram a pontuação para 71,0%, um aumento de 39.9 pontos.
Respostas equivalentes podem retornar as informações solicitadas com uma coluna extra ou uma projeção diferente. A comparação estrita pode rejeitar esse resultado mesmo quando um revisor o aceita como resposta à pergunta. Do aumento, 22.7 pontos vêm das decisões do júri sobre esses casos. Defeitos de referência respondem pelos 17.2 pontos restantes.
Metodologia do benchmark de Text-to-SQL
Questions and execution
BIRD-SQL fornece perguntas em linguagem natural, referências SQL e conteúdos de banco de dados.1 Usamos uma seleção congelada de 759 perguntas de 11 bancos de dados, cobrindo 560 exemplos de treino e 199 exemplos de dev.
Os modelos receberam descrições curtas de banco de dados e ferramentas para listar tabelas, ler definições de colunas e executar SQL. Cada pergunta permitiu até nove chamadas com ferramentas e uma resposta final contendo o banco de dados escolhido e o SQL. O limite de visualização do esquema era de 4.000 caracteres, e as visualizações de consulta foram limitadas a 50 linhas.
A consulta candidata final e a referência foram executadas no mesmo arquivo de banco de dados. A pontuação estrita comparou seus resultados, incluindo um modo sensível à ordem para perguntas que solicitam uma resposta ordenada. Consultas candidatas ausentes, malformadas e com falha de execução não receberam crédito estrito em perguntas elegíveis e roteadas corretamente.
Para as 46 execuções do OpenRouter, solicitamos temperatura 0. Vinte e nove usaram a camada de recuperação de chamadas de ferramentas v3, 15 a antecederam e duas combinaram registros das duas versões. GPT-6 Astra rodou por meio do Codex CLI. Opus 5.5 e Fable 5.1 usaram Claude Code. Todas as três execuções de CLI usaram esforço de raciocínio médio. As execuções de GPT-6 Luna, Luna Pro, Sol e Sol Pro e GPT-5.2 usaram OpenRouter. Essas diferenças de execução impedem atribuir uma lacuna de pontuação somente ao modelo.
Sete execuções completaram menos de 759 perguntas. Os registros ausentes estão fora dos denominadores de pontuação. A tabela relata os tamanhos reais de amostra para as pontuações principal e suplementares. As dez adições de API completaram, cada uma, todas as 759 perguntas após repetições de solicitações com falha, preservando as respostas bem-sucedidas anteriores.
Pontuação de SQL
A pontuação principal exclui perguntas sinalizadas tanto do numerador quanto do denominador. Três referências marcadas como incertas permanecem no cálculo. Os arquivos de resultados chamam esta métrica de ex_gold_clean.
Duas pontuações suplementares mostram como a revisão altera o resultado:
Antes da revisão de referência, a pontuação estrita mede a correspondência exata de execução em todas as perguntas roteadas corretamente. Ela inclui perguntas com referências sinalizadas.
Depois da revisão de respostas, a pontuação adiciona crédito quando um júri separado aceita uma resposta perdida elegível. Ela usa o mesmo denominador da pontuação estrita. Os arquivos de resultados chamam isso de precisão adjudicada.
O tamanho da amostra (n) é o número de perguntas pontuadas. A pontuação principal usa um subconjunto menor do que as duas pontuações suplementares.
Para claude-sonnet-5, excluir referências sinalizadas reduziu as respostas aceitas de 211 para 180 e as perguntas pontuadas de 679 para 468. Sua precisão de SQL foi 38,5%.
A exclusão altera ambas as contagens. A revisão de respostas, em vez disso, mantém o denominador original e adiciona crédito para respostas perdidas aceitas.
Revisão de referência e de respostas
Auditar referências e revisar respostas candidatas exigem insumos diferentes.
Os auditores de referência foram claude-opus-4.8, gpt-5.6-sol, gemini-3.1-pro-preview, grok-4.5 e deepseek-v4-pro. As respostas candidatas foram ocultadas para manter as sinalizações independentes do modelo que estava sendo pontuado.
O julgamento de respostas usou três jurados de famílias de modelos diferentes da família da candidata. As consultas de referência e candidata apareceram em posições A/B aleatórias sem rótulos revelando seus papéis. Casos ambíguos e casos com votos válidos insuficientes não receberam crédito adicional.
A cobertura da revisão é assimétrica. Aprovações estritas permanecem aceitas, enquanto omissões elegíveis recebem outra avaliação. Consequentemente, o julgamento pode reter falsos positivos da pontuação estrita e adicionar falsos positivos próprios. É uma estimativa suplementar, sem garantia de correção nem limite superior garantido para a precisão verdadeira.
Uma omissão se qualificou para julgamento quando a consulta candidata foi executada e a sobreposição de F1 entre suas linhas de resultado e a referência ficou abaixo de 0.5. O F1 combina a proporção de linhas candidatas encontradas na referência com a proporção de linhas de referência recuperadas pela candidata.
Por exemplo, gemini-3.5-flash-lite teve 346 omissões estritas. Destas, 314 se qualificaram para revisão. O júri aceitou a candidata em 144 casos: 92 com referência rejeitada e 52 com ambas as respostas aceitas. Classificou 105 como erros do modelo e deixou 65 ambíguos. As outras 32 omissões compreenderam 27 com maior sobreposição de resultados e cinco falhas de execução.
Os 144 casos aceitos são 45,9% das omissões revisadas, não de todas as respostas com falha.
 Adicionar como fonte preferencial
Limitações
Erros de referência permanecem incertos. A auditoria de cinco modelos inspecionou colunas de tabelas usadas por cada consulta de referência, portanto pode não ver uma resposta localizada em uma tabela diferente. A auditoria também pode rejeitar uma referência válida. Uma revisão repetida por anotadores humanos independentes é necessária para estimar os dois tipos de erro.
Os julgamentos do júri dependem da interpretação do LLM. Nenhuma revisão humana independente verificou todos os veredictos de julgamento. No controle nova-lite-v1, a precisão subiu de 18,9% sob pontuação estrita para 31,6% após o julgamento, mostrando que a revisão não produziu automaticamente uma pontuação alta. Esse controle por si só não pode estabelecer a precisão do júri.
A comparação estrita pode falhar em ambas as direções. Colunas extras ou ordem diferente de colunas podem rejeitar uma resposta útil. A normalização de maiúsculas e o arredondamento de valores de ponto flutuante para seis algarismos significativos podem aceitar diferenças que importam.
Intervalos de amostragem de perguntas estão disponíveis para pontuações estritas e precisão de SQL na exportação de resultados. Eles omitem a incerteza dos rótulos de referência, o erro do júri e a variação entre execuções repetidas de SQL. Nenhuma análise repetida de SQL é relatada aqui.
Estes são resultados para uma carga de trabalho selecionada e gratuito de dicas, com um requisito de roteamento de banco de dados. Eles não são diretamente comparáveis com o leaderboard do BIRD. Os dados públicos de treino também deixam um risco de sobreposição de dados de treinamento, como discutido no artigo de roteamento.
Conclusão
claude-opus-5.5 liderou a precisão de SQL com 87,8%, seguido por gemini-4-argon com 78,6% e gemini-3.8-flash com 77,2%.
Cada pontuação de SQL reflete as perguntas que o modelo roteou corretamente e as referências retidas após a revisão. Uma comparação controlada de SQL daria a todos os modelos as mesmas perguntas e informações de banco de dados, com verificações independentes dos rótulos de referência e das decisões do júri.
Leitura adicional
- Benchmark Agêntico de RAG: Roteamento de Múltiplos Bancos de Dados
- Mais de 800 benchmarks líderes de IA
- HALC-Bench: Alucinação de LLM em Benchmark de Recuperação de Contexto Longo
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Text-to-SQL Benchmark: Precisão de SQL em mais de 70 LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/text-to-sql}},
  note   = {AIMultiple. Acessado em 1 outubro 2026}
}Resultados e carimbos de data/hora de 1.5 mil pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 5 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
9 atualizaçõesSubstituídos os resultados do benchmark text-to-SQL por um painel de 36 modelos avaliado por correspondência de execução strict, gold-clean e adjudicated.
Adicionado um changelog à seção de benchmark RAG Agente: roteamento multi-banco de dados e geração de consultas.
Substituída a seção de metodologia por um resumo e uma referência a outro artigo.
Links de referência




Comentários 1
Compartilhe suas ideias
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.
Curious, how much of the context engineering and specific prompting did you apply in your benchmarks. Or, was it to review the models only? I have found much higher return of correct and consistent responses. A higher fidelity. To do that, I needed to provide a most sophisticated prompt that fed the context window as the question was being asked. Not perfect, but better than those scores represented in this article when using the Grok 4.x .
Great point. This benchmark intentionally uses zero-shot, minimal prompting with temperature=0. No few-shot examples, no domain-specific instructions, no iterative refinement. The goal was to measure each model's baseline text-to-SQL capability. So your experience with Grok 4 getting higher fidelity through sophisticated context engineering is completely expected. A well-crafted prompt with detailed schema descriptions, few-shot examples, and domain-specific rules will improve any model's performance significantly. What this benchmark isolates is how well the model performs out-of-the-box when given only the raw question and retrieved schema, which helps compare the models' inherent SQL reasoning abilities on a level playing field. We'll make this clearer in the methodology section. Thanks for raising it.