


AIM-Agentic RAG Benchmark: Roteamento entre 11 bancos de dados SQL
We benchmarked 70+ LLMs on 759 questions that require choosing among 11 SQL databases. The benchmark measures whether each model identifies the right database, explores alternatives and states a final choice.
A precisão de roteamento é a porcentagem de perguntas pontuadas para as quais o model nomeia explicitamente o banco de dados correto em sua resposta final. O destaque usa as 184 perguntas sinalizadas como difíceis tanto pelo nosso teste de similaridade quanto por um júri de três LLMs. Declarações explícitas ausentes não recebem crédito.
Descobertas sobre roteamento de bancos de dados
Gemini 4 Argon registrou a maior precisão de roteamento, com 94,0%
gemini-4-argon selecionou o banco de dados correto para 173 de 184 perguntas difíceis. claude-opus-5.5 seguiu com 90,2% (166 de 184). Muse Wonder registrou 86,4% (159 de 184). GPT-6.1 Terra registrou 83,7% (154 de 184). MiniMax M3.1 Flash registrou 81,5% (150 de 184). Kimi K3.1 Pro registrou 84,8% (156 de 184). Muse Spark Open registrou 81,0% (149 de 184), e DeepSeek V4.1 Flash 1017 registrou 77,2% (142 de 184).
Gemini 4 Argon liderou em todas as perguntas com 98,4% (747 de 759). Foi executado por meio do OpenRouter. As pontuações observadas refletem tanto o model quanto as condições de execução.
DeepSeek V4 Flash 0731 registrou 82,1% de precisão de roteamento a $1,37
DeepSeek V4 Flash 0731 respondeu corretamente a 151 de 184 perguntas difíceis. Suas respostas retidas em todas as 759 perguntas custaram $1.37. Qwen3.8 Flash marcou 79,3% a $2,08, enquanto MiMo-V2.6-Pro alcançou 82,6% a $4.17.
Esses custos somam as respostas bem-sucedidas retidas em cada arquivo de resultado. Tentativas reprovadas e substituídas são excluídas. Esses totais dependem dos provedores e das condições de cache usados durante a medição. O gráfico de custos inclui 78 totais de API medidos e três estimativas equivalentes ao OpenRouter rotuladas separadamente para Opus 5.5, Fable 5.1 e GPT-6 Astra. Essas estimativas aplicam os preços de API de 1º de outubro de 2026 aos tokens de CLI registrados e ao uso de cache. Elas não medem gastos com assinaturas.
Grok 4.6 ganhou 41.8 pontos após sua primeira escolha de banco de dados
A precisão de roteamento em perguntas difíceis do Grok 4.6 subiu de 38,0% na primeira verificação para 79,9% na declaração final. O GPT-6 Sol Pro ganhou 34.2 pontos em sua execução. O Nova Lite perdeu 14.0 pontos.
Essas mudanças usam perguntas com um único banco de dados no primeiro turno. Elas descrevem trajetórias registradas. Nenhuma intervenção separada isolou o benefício de chamadas adicionais.
Entre todos os 81 models, 8.203 registros de perguntas difíceis incluíram uma troca de banco de dados:
Esta tabela considera o primeiro banco de dados na ordem de chamada registrada, incluindo primeiros turnos com vários bancos de dados. O crédito final exige uma declaração correta explícita. As mudanças em pontos percentuais acima usam o subconjunto mais restrito de primeira escolha única.
Resultados de roteamento de banco de dados
Os models são classificados por precisão de roteamento, do maior para o menor. A metodologia identifica diferenças no software usado para executá-los. Essas condições são importantes ao interpretar pequenas diferenças de pontuação.
Os intervalos estimam a incerteza da amostragem de perguntas. Os custos registrados cobrem os registros bem-sucedidos em cada execução. Eles refletem os provedores e as condições de cache usados no momento da medição.
Condições que afetam a seleção do banco de dados
Bancos de dados semelhantes reduziram a precisão de roteamento em cerca de 20 pontos
Testamos o método de seleção de banco de dados em um experimento separado com 128 perguntas. Cada pergunta manteve seu banco de dados correto, enquanto os outros 10 candidatos vieram do nosso grupo selecionado ou de um sorteio aleatório.
No subconjunto difícil, o claude-opus-4.8 marcou 71,3% com candidatos semelhantes e 92,0% com candidatos aleatórios. O gemini-3.5-flash marcou 77,0% e 96,6%. Ambas as diferenças tiveram valores-p abaixo de 0.001 em testes pareados.
Este experimento usou descrições e uma resposta do model por pergunta, sem o loop de ferramentas agêntico. Ele apoia a descoberta mais restrita de que selecionar candidatos semelhantes torna a escolha do banco de dados mais difícil. A diferença medida não deve ser apresentada como o efeito da exploração agêntica.
Os nomes sozinhos produziram 68,8% e 71,1% de precisão em um piloto
Em outro piloto com 128 perguntas, o claude-opus-4.8 selecionou o banco de dados correto 68,8% das vezes apenas com os nomes. Sua pontuação com nomes e descrições foi de 67,2%. O gemini-3.5-flash marcou 71,1% apenas com nomes e 75,0% com o catálogo completo.
Nomes como california_schools e toxicology revelam o assunto diretamente. Para o benchmark principal, substituímos os nomes dos bancos de dados por aliases de db_01 a db_11. As descrições ainda explicam o domínio de cada banco de dados, e as respostas das ferramentas expõem seus nomes de tabelas e colunas.
Confiabilidade das comparações de roteamento e custo
Execuções repetidas alteraram a precisão de roteamento em 1.6 a 2.7 pontos
O claude-opus-5 selecionou o banco de dados correto para 156 de 184 perguntas difíceis na primeira execução e 151 na repetição. Sua precisão caiu de 84,8% para 82,1%. O qwen3.8-max passou de 153 respostas corretas para 150, uma queda de 83,2% para 81,5%.
Ambas as repetições usaram as mesmas perguntas, anonimização, temperatura e configurações de provedor das execuções originais. O qwen3.8-max mudou sua resposta em 13 perguntas difíceis, embora seu total tenha mudado em três. Melhorias em algumas perguntas anularam erros em outras.
Essas repetições mostram que pequenas diferenças de pontuação podem desaparecer em outra execução. Uma repetição por model não pode estabelecer uma distribuição de resultados, e os outros 79 models não têm medição repetida.
Os custos registrados dependem do provedor e das configurações de cache
O cache de prompt reutiliza entradas processadas anteriormente para reduzir os custos cobrados de entrada. A execução do claude-opus-5 custou $62,78, em comparação com uma estimativa de $105,54 às taxas de tabela sem cache para o mesmo uso registrado. Essa estimativa implica uma economia de 40,5%. É uma comparação contábil, sem uma execução separada de precisão sem cache.
Agentic RAG e seleção de banco de dados
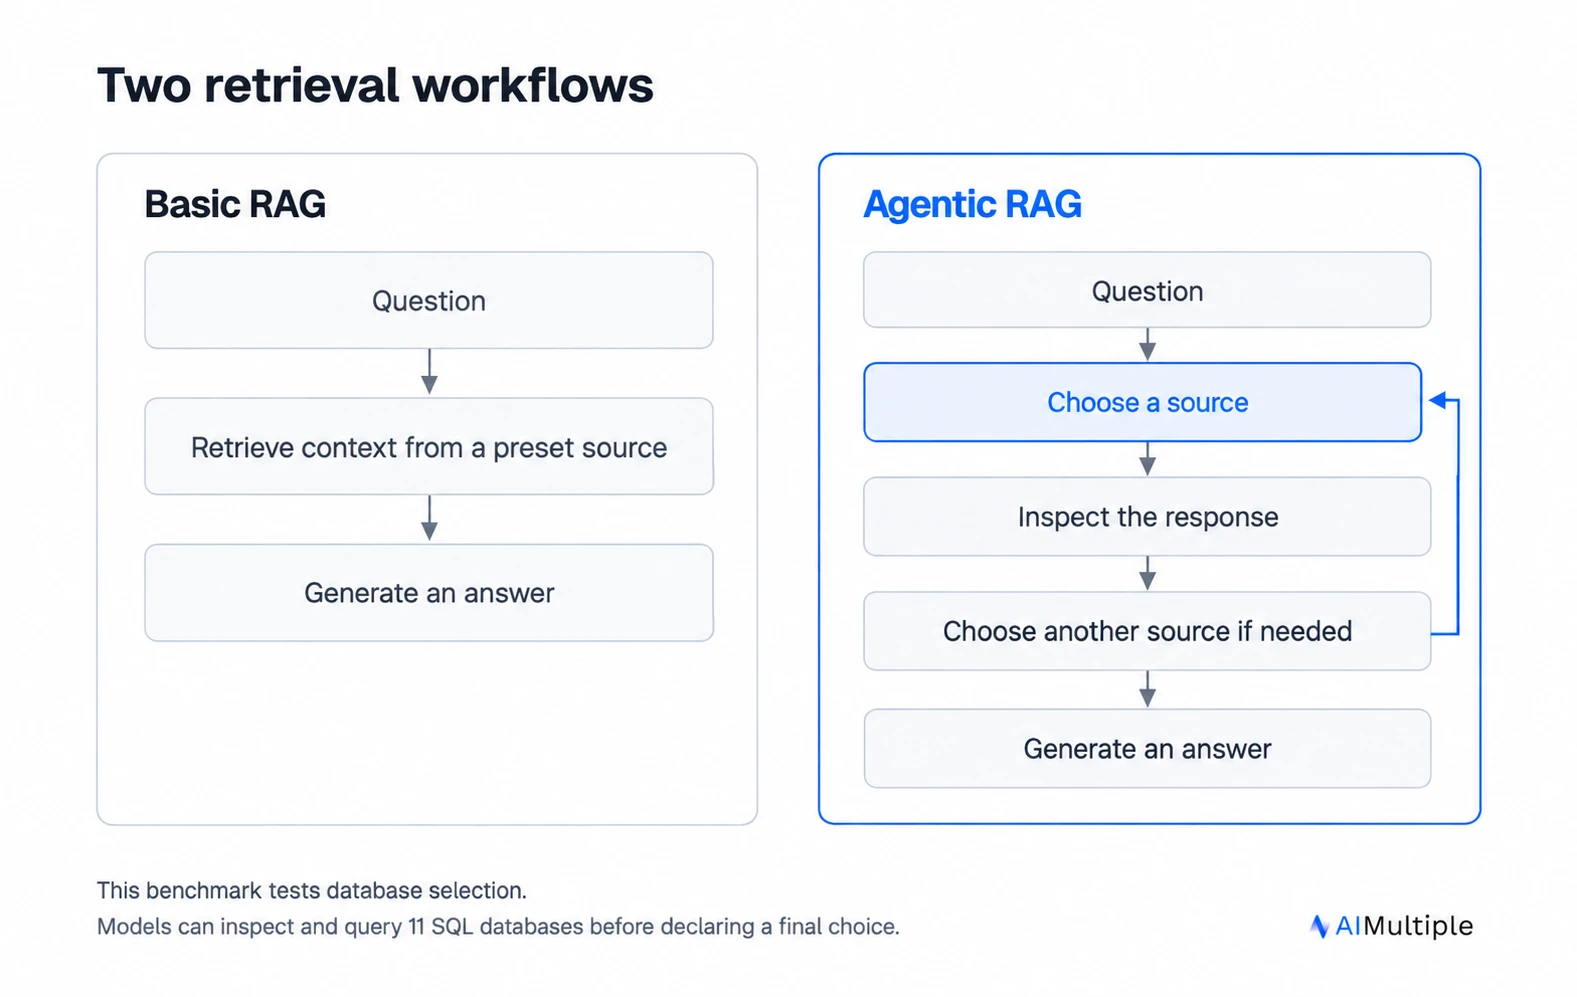
Agentic RAG dá a um model controle sobre as decisões de recuperação. Ele pode escolher uma fonte, inspecionar a resposta e fazer outra solicitação. Um RAG pipeline simples recupera contexto por meio de uma sequência predeterminada antes de gerar uma resposta.
Este benchmark testa a seleção de fontes por meio de ferramentas de banco de dados SQL. Ele não contém índice de documentos, passagens recuperadas ou pontuação de fundamentação de respostas. Os resultados, portanto, descrevem uma parte de um sistema de recuperação agêntico. A pesquisa documental é abordada separadamente em nosso benchmark de busca agêntica.
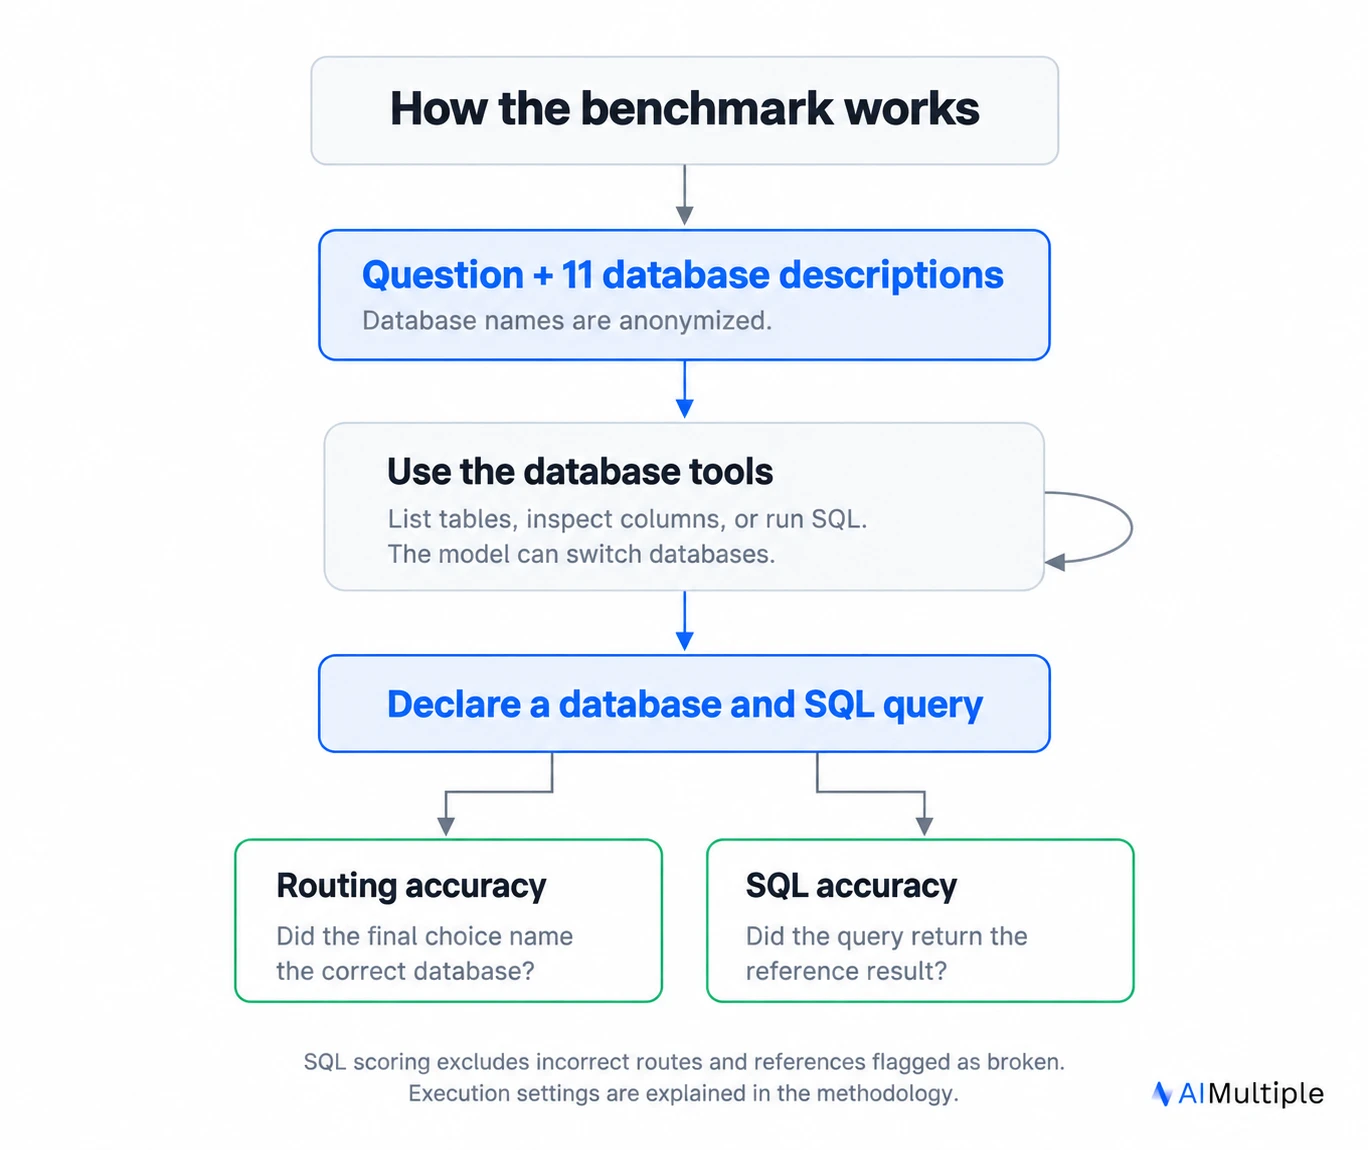
Um model começa com descrições curtas de bancos de dados. Ele pode solicitar listas de tabelas, inspecionar colunas, executar SQL e mudar de banco de dados. Sua resposta final contém uma escolha de banco de dados e uma consulta. Nosso benchmark de texto para SQL relata a precisão de SQL e duas pontuações de revisão suplementares.
Metodologia do benchmark Agentic RAG
O conjunto de perguntas é um subconjunto congelado do BIRD-SQL, que combina perguntas em linguagem natural com consultas de referência SQL.1
Dois sinais definem a dificuldade. O teste de similaridade conta quantos dos 20 vizinhos mais próximos de uma pergunta pertencem a outros bancos de dados. Três LLMs avaliam se a pergunta é confusa entre bancos de dados. A participação no grupo mais difícil exige pelo menos cinco vizinhos entre bancos de dados e um rótulo de júri confuso.
O roteamento usa o banco de dados nomeado no campo explícito selected_database. Uma rota inferida da prosa é excluída do destaque. A correção de SQL é pontuada separadamente e não determina o crédito de roteamento.
O harness é o software que apresenta ferramentas e registra as respostas do model. O painel contém 78 execuções no OpenRouter, duas execuções no Claude Code e uma execução no Codex CLI. Entre as execuções de API, 61 usaram a v3, 15 usaram uma versão anterior e duas combinaram registros de ambas as versões. Na v3, uma camada de recuperação analisa formatos alternativos de chamada de ferramenta suportados. Para o llama-4-maverick, a parcela registrada de formato não nativo foi de 97,9%, portanto esse resultado depende fortemente do adaptador. O minimax-m2.7 foi excluído porque não emitiu as chamadas de ferramenta de banco de dados exigidas pela tarefa.
O GPT-6 Astra foi executado dentro do Codex CLI. O Opus 5.5 e o Fable 5.1 foram executados por meio do Claude Code. Todos os três usaram esforço de raciocínio médio e concluíram 759 perguntas. As execuções do Claude Code usaram assinaturas, e o Astra não relatou custo em dólares. O gráfico de custos inclui estimativas equivalentes ao OpenRouter, rotuladas separadamente, para essas três execuções de CLI. As execuções do GPT-6 Luna, Luna Pro, Sol e Sol Pro e GPT-5.2 usaram o OpenRouter.
 Adicionar como fonte preferencial
Limitações
O subconjunto difícil concentra-se em comércio. Quatro bancos de dados contribuem com 171 de suas 184 perguntas, ou 92,9%. Cinco dos 11 bancos de dados não contribuem com nenhuma. Isso apoia conclusões sobre a escolha entre bancos de dados semelhantes dentro de um domínio, com evidências limitadas para outras combinações de domínios. O GPT-6.1 Terra, o MiniMax M3.1 Flash e o Kimi K3.1 Pro concluíram, cada um, todas as 759 perguntas por meio do OpenRouter em 27 de outubro. Respostas anteriores bem-sucedidas foram retidas. Os resultados de novas tentativas podem depender de mudanças na disponibilidade do serviço. O DeepSeek V4.1 Flash 1017 e o Muse Spark Open concluíram, cada um, todas as 759 perguntas por meio do OpenRouter em 30 de outubro.
Os dados de benchmark público podem ter aparecido no treinamento dos models. Controles usando 138 paráfrases validadas e 65 perguntas recém-elaboradas não encontraram declínio de precisão nos models de menor custo testados. A cobertura deles foi limitada a seis e três bancos de dados, respectivamente. Eles não resolvem a contaminação para o painel completo, e nenhum controle usou bancos de dados lançados após os cortes de treinamento dos models.
O truncamento de esquema pode ocultar tabelas úteis. Em works_cycles, o limite de 4.000 caracteres deixa 26 de 66 tabelas visíveis na listagem inicial do esquema. O model pode solicitar mais detalhes, mas a visão inicial fica incompleta.
Conclusão
O gemini-4-argon registrou a maior pontuação de roteamento em perguntas difíceis, com 94,0%. O DeepSeek V4 Flash 0731 alcançou 82,1% com $1,37 em custos de respostas retidas ao longo de toda a execução.
A configuração de execução, as novas tentativas e os preços dos provedores limitam as comparações. Esses resultados medem a seleção de banco de dados entre fontes SQL semelhantes. A recuperação de documentos e a geração de respostas fundamentadas exigem avaliações separadas.
Leitura adicional
- Texto para SQL: Comparação da precisão de LLM
- Frameworks de RAG: LangChain vs LangGraph vs LlamaIndex
- Melhores ferramentas, frameworks e bibliotecas de RAG
- Busca agêntica em 2026: Benchmark de 8 APIs de busca para agentes
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Agentic RAG Benchmark: Roteamento entre 11 bancos de dados SQL}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/agentic-rag}},
  note   = {AIMultiple. Acessado em 27 outubro 2026}
}Resultados e carimbos de data/hora de 1.1 mil pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 7 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
16 atualizaçõesA seção 'O que torna uma pergunta difícil neste benchmark?' foi atualizada com novo conteúdo.
A metodologia foi atualizada para esclarecer como as perguntas mais difíceis são distribuídas entre os bancos de dados.
A seção de metodologia de benchmark RAG Agentic foi substituída por uma nova que abrange 36 LLMs e 11 bancos de dados.
Adicionados novos modelos ao benchmark: Claude Fable 5, Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, Claude Opus 4.7.
A seção de metodologia foi atualizada com novos detalhes sobre o ambiente do banco de dados, a arquitetura do agente e o processo de avaliação.
Adicionada uma seção sobre modelos de contexto longo versus RAG agêntico.
Métricas agenticas adicionais removidas da metodologia.
Links de referência








Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.