Benchmarks independentes de IA e software empresarial
AIM Indices


Compare a conformidade dos assistentes de codificação de IA com as especificações e a segurança do código.
Identifique as GPUs em nuvem mais baratas para treinamento e inferência.
Meça o desempenho da GPU sob alta carga de requisições paralelas.
Compare a eficiência de escalonamento em configurações com múltiplas GPUs.
Analise as funcionalidades e os custos das principais soluções de gateway de IA.
Compare a latência dos LLMs
Comparar os custos de entrada e saída dos modelos LLM
Avalie a precisão e a confiabilidade dos LLMs na conversão de linguagem natural em SQL.
Compare as taxas de viés dos modelos lineares (LLMs).
Avalie as taxas de alucinação dos principais modelos de IA.
Avaliar roteamento em múltiplos bancos de dados e geração de consultas em RAG com agentes
Compare a precisão e a velocidade dos modelos de incorporação.
Avalie a precisão e a velocidade dos principais modelos de incorporação de código aberto.
Compare soluções de geração aumentada por recuperação
Compare o desempenho, os preços e os recursos dos bancos de dados vetoriais para RAG.
Comparar a latência e o uso de tokens de conclusão para frameworks agentivos.
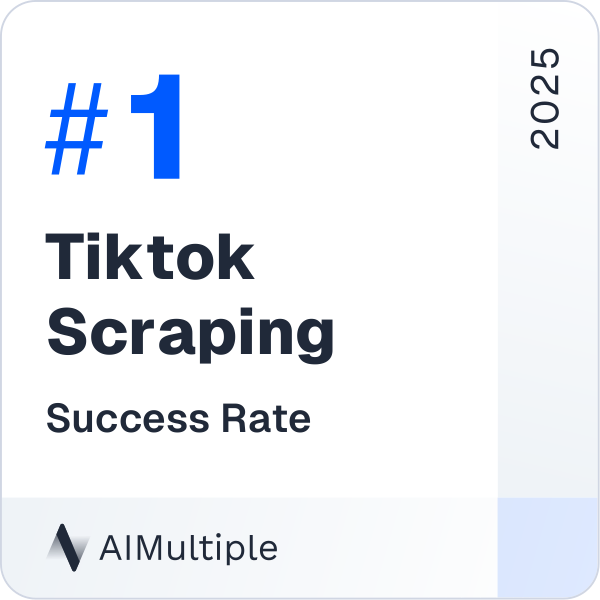
Analise o desempenho das APIs de raspagem de TikTok
Avalie a eficácia das soluções de desbloqueio da web.
Analisar o desempenho das APIs do Video Scraper
Analise o desempenho de editores de código com inteligência artificial.
Compare APIs de extração de dados para comércio eletrônico
Compare as capacidades e os resultados dos principais modelos de linguagem de grande porte.
Veja os mecanismos de OCR e LLMs mais precisos para automação de documentos.
Compare as taxas de sucesso e os preços das APIs de extração de dados de mecanismos de busca.
Compare os OCRs no reconhecimento de escrita manual.
Comparar modelos de aprendizado tabular com diferentes conjuntos de dados
Compare BF16, FP8, INT8 e INT4 em termos de desempenho e custo.
Comparação de incorporações multimodais para raciocínio imagem-texto
Compare a eficiência do vLLM, LMDeploy e SGLang no H100.
Compare o desempenho dos raspadores LLM
Compare as habilidades de raciocínio visual dos LLMs
Compare o desempenho de orquestração de frameworks agentivos.
Compare a latência dos provedores de IA
Compare modelos de incorporação multilíngues para RAG
Compare modelos de rerankers para recuperação densa
Compare LLMs em diferentes tarefas de desenvolvimento de software
Compare como os modelos de aterramento de UI são fortes
Boletim informativo AIMultiple
Receba um e-mail gratuito por semana com as últimas notícias de tecnologia B2B e insights de especialistas para impulsionar o seu negócio.
Benchmarks mais recentes
AIM-Text-to-SQL Benchmark: Precisão de SQL em mais de 60 LLMs
A precisão de SQL é a porcentagem de consultas pontuadas que retornam o resultado de referência. Rotas incorretas e referências sinalizadas como quebradas são excluídas. Uma consulta de referência é o SQL fornecido como resposta esperada. Cada modelo alcança um conjunto diferente de perguntas SQL porque a pontuação depende de suas escolhas de banco de…
LLM Parâmetros: GPT-5 High, Médio, Baixo e Mínimo
Alguns LLMs, como a família GPT-5 da OpenAI, vêm em versões diferentes (por exemplo, GPT-5, GPT-5-mini e GPT-5-nano) e com várias configurações de parâmetros, incluindo alto, médio, baixo e mínimo. A seguir, exploramos as diferenças entre essas versões de models, reunindo o desempenho em benchmarks e os custos para executar os benchmarks. Usamos a família…
Benchmark de RAG agêntico: roteamento entre 11 bancos de dados SQL
A precisão de roteamento é a porcentagem de perguntas pontuadas nas quais o modelo nomeia explicitamente o banco de dados correto em sua resposta final. O resultado principal usa as 184 perguntas marcadas como difíceis tanto por nosso teste de similaridade quanto por um júri de três LLMs. Declarações explícitas ausentes não recebem crédito. O…
Benchmark de mais de 80 LLMs em Finanças: Claude Opus 5.5 & GPT-6 Astra
O conjunto de teste é o subconjunto difícil do benchmark FinanceReasoning (Tang et al.), com 238 perguntas. A precisão é a porcentagem de perguntas respondidas corretamente. Respostas numéricas recebem uma tolerância relativa de 0,2%. Os tokens de saída são os tokens gerados nas 238 respostas. Os tokens de entrada são contados separadamente no cálculo do…
Ver todos os artigos sobre IAÚltimas informações
O Futuro dos Large Language Models
Veja o futuro dos large language models explorando abordagens promissoras, como autotreinamento, verificação de fatos e especialização esparsa, que poderiam resolver as limitações do LLM. Comparação da taxa de sucesso dos LLM’s Claude Sonnet 4.6 liderou o benchmark com uma pontuação geral de 0.748, com as variantes base e thinking empatadas até a terceira casa…
IA generativa empresarial: 11 casos de uso e melhores práticas
IA generativa (GenAI) apresenta novas oportunidades para grandes empresas em comparação com empresas de médio porte ou startups, incluindo: No entanto, a IA generativa traz desafios únicos para grandes organizações. Por exemplo: Explore nossos casos de uso de IA empresariais práticos para saber como grandes empresas podem criar, implantar e governar seus próprios modelos de…
Cloud LLM vs Local LLMs: Exemplos & Benefícios
Os LLMs na nuvem, alimentados por modelos avançados como GPT-5.5 e Claude Opus 4.7, oferecem escalabilidade e acessibilidade. Por outro lado, os LLMs locais, impulsionados por modelos de código aberto como Llama 4, DeepSeek V4 e Qwen3.6-Plus, garantem maior privacidade e personalização. Explore o que são LLMs na nuvem, pontos fortes e fracos, estudos de…
Chatbot vs ChatGPT: Diferenças e Recursos
Os chatbots tradicionais recuperam respostas pré-escritas de uma base de conhecimento fixa. O ChatGPT gera respostas do zero usando um grande modelo de linguagem treinado com dados em escala de internet. Essa única diferença arquitetural é o motivo pelo qual eles resolvem problemas completamente diferentes e por que escolher o errado custa tempo e dinheiro.…
Ver todos os artigos sobre IADistintivos dos benchmarks mais recentes
Quadro de Líderes em Tecnologia Empresarial
Os 3 primeiros resultados são exibidos; para mais informações, consulte os artigos de pesquisa.
Fornecedor | Referência | Métrica | Valor |
|---|---|---|---|
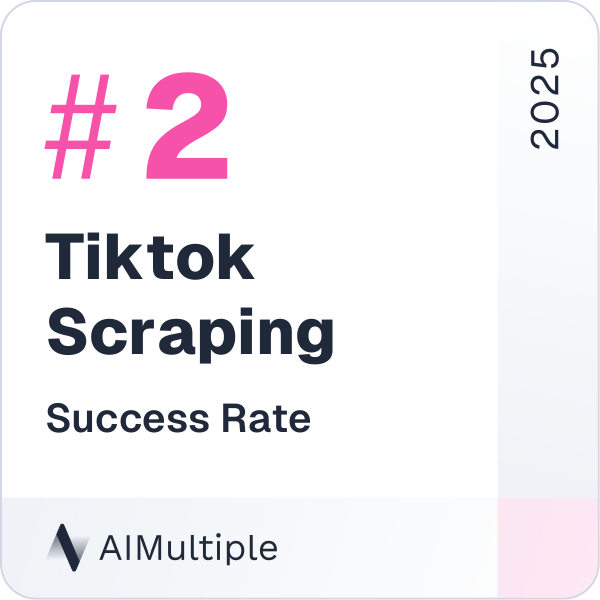
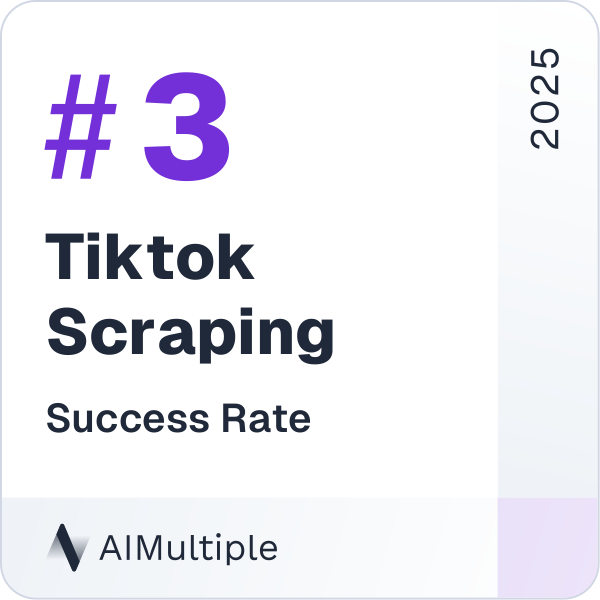
 Bright Data | 1st Success Rate | 100 % | |
 Apify | 2nd Success Rate | 99 % | |
 Decodo | 3rd Success Rate | 95 % | |
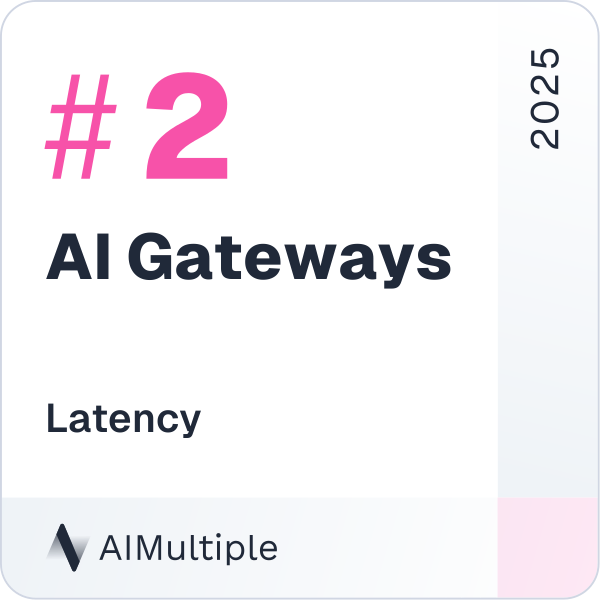
 Groq | 1st Latency | 2.00 s | |
 SambaNova | 2nd Latency | 3.00 s | |
 Together.ai | 3rd Latency | 11.00 s | |
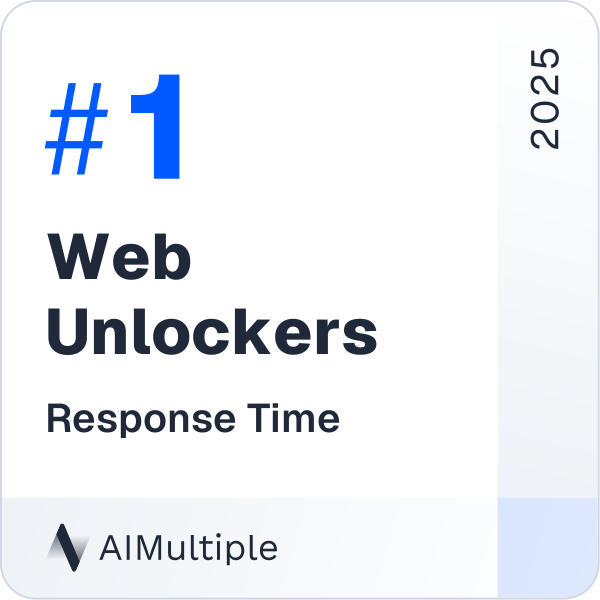
 Zyte | 1st Response Time | 1.75 s | |
Bright Data | 2nd Response Time | 2.38 s | |
Decodo | 3rd Response Time | 3.43 s | |
Bright Data | 1st Overall | Líder |
Decisões baseadas em dados e respaldadas por indicadores de desempenho.
Análises baseadas em 102.800 horas de engenharia por ano
60% das empresas da Fortune 500 dependem da AIMultiple mensalmente
Empresas da lista Fortune 500 confiam na AIMultiple para orientar suas decisões de compras todos os meses. Segundo a Similarweb, 4 milhões de empresas utilizam a AIMultiple anualmente.
Veja como a IA empresarial se comporta na vida real.
A avaliação comparativa de IA baseada em conjuntos de dados públicos é propensa a manipulação de dados e leva a expectativas infladas. Os conjuntos de dados de validação da AIMultiple garantem resultados de avaliação comparativa realistas. Veja como testamos diferentes soluções tecnológicas.
Aumente sua confiança nas decisões tecnológicas
Somos independentes, 100% propriedade dos funcionários e divulgamos todos os nossos patrocinadores e conflitos de interesse. Consulte nossos compromissos com a pesquisa objetiva.