


Top 3 Geradores de Documentos Sintéticos em Benchmark

Geradores de documentos sintéticos criam imagens de documentos anotadas e realistas que ajudam a treinar e avaliar models de machine learning sem depender de grandes datasets rotulados manualmente.
Fizemos um benchmark de 3 geradores de documentos sintéticos, Genalog, DocCreator e Tonic Textual, criando mais de 2.500 documentos sintéticos e comparando sua eficácia em layouts realistas, dados numéricos precisos e datasets de treinamento para tarefas de análise de documentos.
Resultados do benchmark de geração de documentos
Os resultados mostram que
- Genalog e DocCreator têm forte desempenho em utilidade e fidelidade, com o Genalog ligeiramente melhor em precisão numérica.
- Tonic Textual se destaca pelo realismo do layout visual, mas fica atrás nas demais áreas, o que o torna mais adequado para tarefas que exigem documentos realistas.
Para mais informações sobre as métricas, leia a metodologia do benchmark.
- Utilidade mede o quão bem os models treinados com dados sintéticos se saem em documentos reais.
- Fidelidade de layout mede o quão bem o arranjo espacial dos elementos nos documentos sintéticos corresponde aos reais.
- Fidelidade numérica verifica se os valores numéricos nos documentos sintéticos se assemelham aos dados reais.
Comentário sobre os resultados: Para entender melhor as diferenças de desempenho, o benchmark também foi conduzido usando o conjunto de treinamento em vez do conjunto de teste separado. Esta avaliação secundária teve como objetivo determinar se fornecer aos models material de treinamento melhoraria sua capacidade de reproduzir saídas estruturadas e numericamente precisas.
Os resultados mostram que, mesmo quando avaliados nos dados de treinamento, os models alcançaram pontuações ligeiramente mais altas. Isso indica que os resultados refletem o quão bem as ferramentas lidam com a própria tarefa. Os resultados moderados provavelmente são influenciados por limitações na qualidade do OCR e na capacidade do model treinado, e não pelo procedimento de benchmark em si.
Genalog
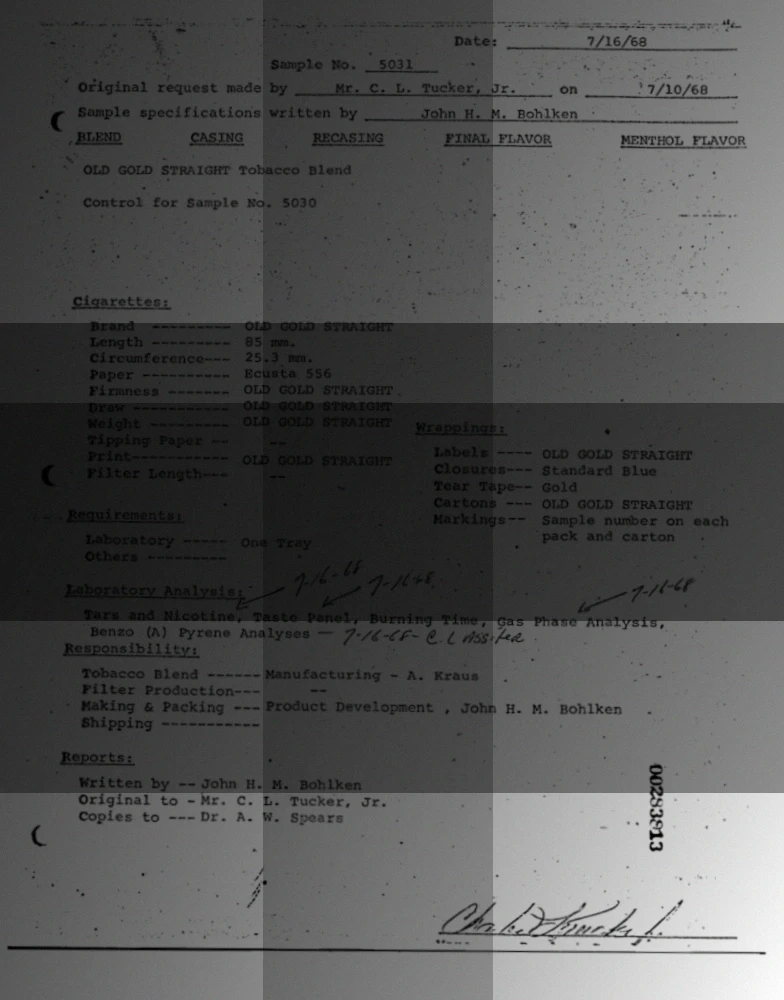
O Genalog teve o melhor desempenho geral. Seus documentos sintéticos foram eficazes para o treinamento de models e mantiveram um bom equilíbrio entre elementos realistas de layout e precisão numérica. Os documentos gerados refletiram de perto a estrutura e o espaçamento de formulários e recibos reais, o que os torna adequados para diversas tarefas de análise de documentos.
DocCreator
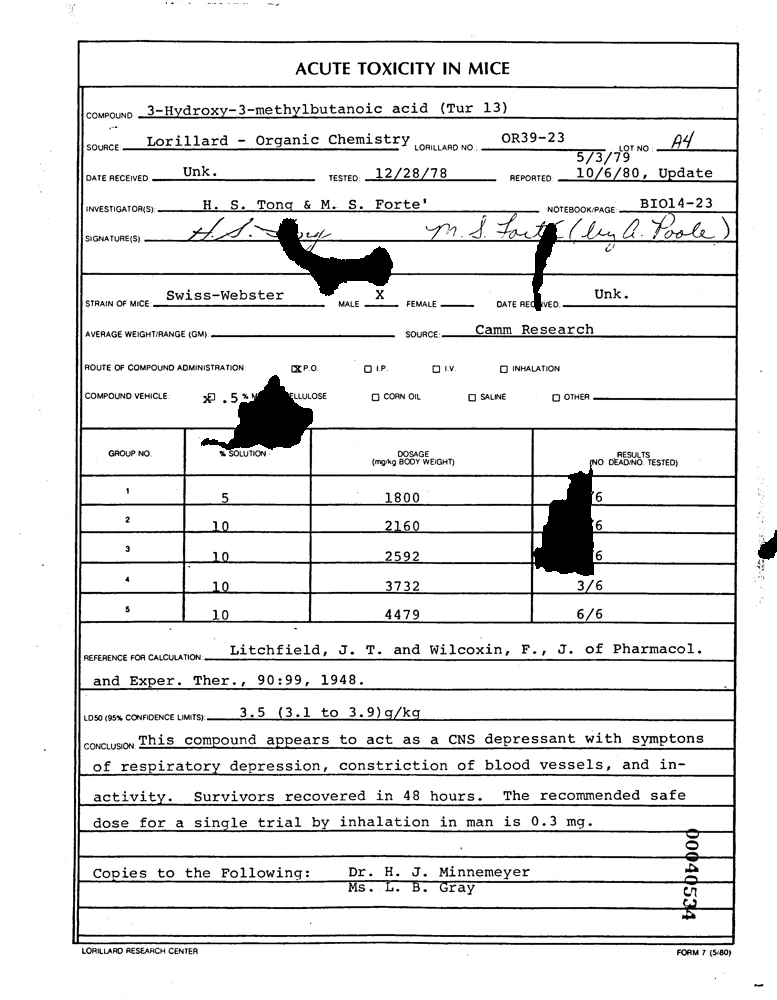
O DocCreator também produziu resultados de alta qualidade. Os documentos desse gerador de documentos foram quase tão úteis para treinamento quanto os do Genalog. Os layouts eram realistas e os documentos sintéticos preservaram as propriedades estatísticas dos números. A força do DocCreator está em combinar uma geração diversificada de layouts com seus models de degradação, tornando os resultados visualmente semelhantes a documentos digitalizados do mundo real.
Tonic Textual

O Tonic Textual apresentou resultados mistos. Embora esse gerador de documentos sintéticos tenha produzido layouts limpos e consistentes, os documentos foram menos eficazes para treinar models. Além disso, os números sintéticos nem sempre foram estatisticamente semelhantes aos dados reais. Isso sugere que o Tonic Textual é mais adequado para tarefas focadas na aparência do documento ou na substituição de PII com preservação de privacidade, em vez de treinamento em larga escala para estrutura de layout e tarefas de extração de informações.
Em março de 2026, o Tonic Textual trocou seu componente de vinculação de entidades de um model baseado em LLM para um model baseado em BERT para melhorar a taxa de transferência.1 A mesma versão (v391) também adicionou filtragem e ordenação aprimoradas na página Datasets.1
Visão geral
Genalog é a ferramenta mais equilibrada, oferecendo layouts realistas e números precisos.
DocCreator é forte para layouts complexos e diversificados e para degradação de documentos, com pequenas imprecisões numéricas.
Tonic Textual é ideal para tarefas focadas em layout, mas não para tarefas que exigem dados numéricos precisos.
Visão geral da metodologia
Métricas de avaliação
Cada dataset gerado foi pontuado em comparação com os dados originais usando as seguintes métricas:
Pontuação de utilidade
(KIE F1 Score): Uma pontuação entre 0 e 1, em que quanto maior, melhor. É definida pela pontuação F1 do model LayoutLMv3 treinado nos dados sintéticos quando avaliado no conjunto de teste real. Uma pontuação alta indica que os dados sintéticos são um substituto altamente eficaz para os dados reais.
Pontuações de fidelidade
Essas métricas medem o quão de perto os documentos sintéticos se assemelham aos reais.
- Fidelidade de layout (pontuação EMD): A Distância do Movimento de Terra (dEMD) mede a diferença entre a distribuição dos pontos centrais das caixas delimitadoras nos documentos reais em comparação com os sintéticos. É um valor de 0 a 1, em que quanto menor, melhor. Uma pontuação baixa significa que os elementos espaciais do layout estão bem preservados.
- Fidelidade numérica (distância K-S): A Distância de Kolmogorov-Smirnov (DKS) mede a diferença máxima entre as funções de distribuição acumulada (CDFs) dos valores numéricos (por exemplo, preços, quantidades) nos dados reais e sintéticos. Ela varia de 0 a 1, em que quanto menor, melhor. Uma pontuação baixa significa que o gerador reproduz com precisão as propriedades estatísticas dos números.
Todas as métricas foram normalizadas durante o cálculo.
Datasets
FUNSD: uma coleção de 199 formulários digitalizados caracterizados por texto ruidoso, layouts complexos e diversificados e anotações manuscritas. Foi baixada mais de 1.500 vezes no mês passado. Isso testa a capacidade de um gerador de lidar com dados não estruturados e imperfeitos. 2
- Dividimos a amostra em duas partes: 80% dos dados são usados para treinar o model, enquanto os 20% restantes são reservados para testes após o treinamento.
- Cada ferramenta produziu entre três e seis documentos sintéticos para cada original, resultando em um total de mais de 2.500 documentos sintéticos.
Avaliação da tarefa
Para medir a utilidade, um model LayoutLMv3 popular com 22K estrelas no GitHub e mais de 750K downloads foi treinado com os dados sintéticos gerados por cada ferramenta geradora de documentos sintéticos. 3
O desempenho desse model foi então avaliado em um conjunto de teste separado de documentos reais dos datasets originais. Isso mede diretamente quão úteis os dados sintéticos são para uma tarefa do mundo real.
Ferramentas de geração sintética
Genalog
Uma biblioteca Python de código aberto da Microsoft para gerar imagens de documentos sintéticos com ruído sintético. Ela funciona pegando texto + templates de layout (escritos em HTML + CSS) e renderizando-os via WeasyPrint, aplicando depois efeitos de degradação (desfoque, vazamento de tinta, ruído sal-e-pimenta e operações morfológicas).4
DocCreator
Uma ferramenta multiplataforma de código aberto para gerar imagens de documentos sintéticos com verdade de referência associada. Ela tem sido amplamente usada em pesquisas de Análise e Reconhecimento de Imagens de Documentos (DIAR).5,6
Tonic Textual
Uma solução para tarjamento e síntese em formatos de documentos do mundo real (PDF, Word). Ela afirma escanear documentos não estruturados, identificar entidades nomeadas (por exemplo, PII), suprimir ou substituí-las por valores sintéticos e gerar documentos desidentificados em formatos semelhantes.
8 Métodos de degradação de documentos sintéticos
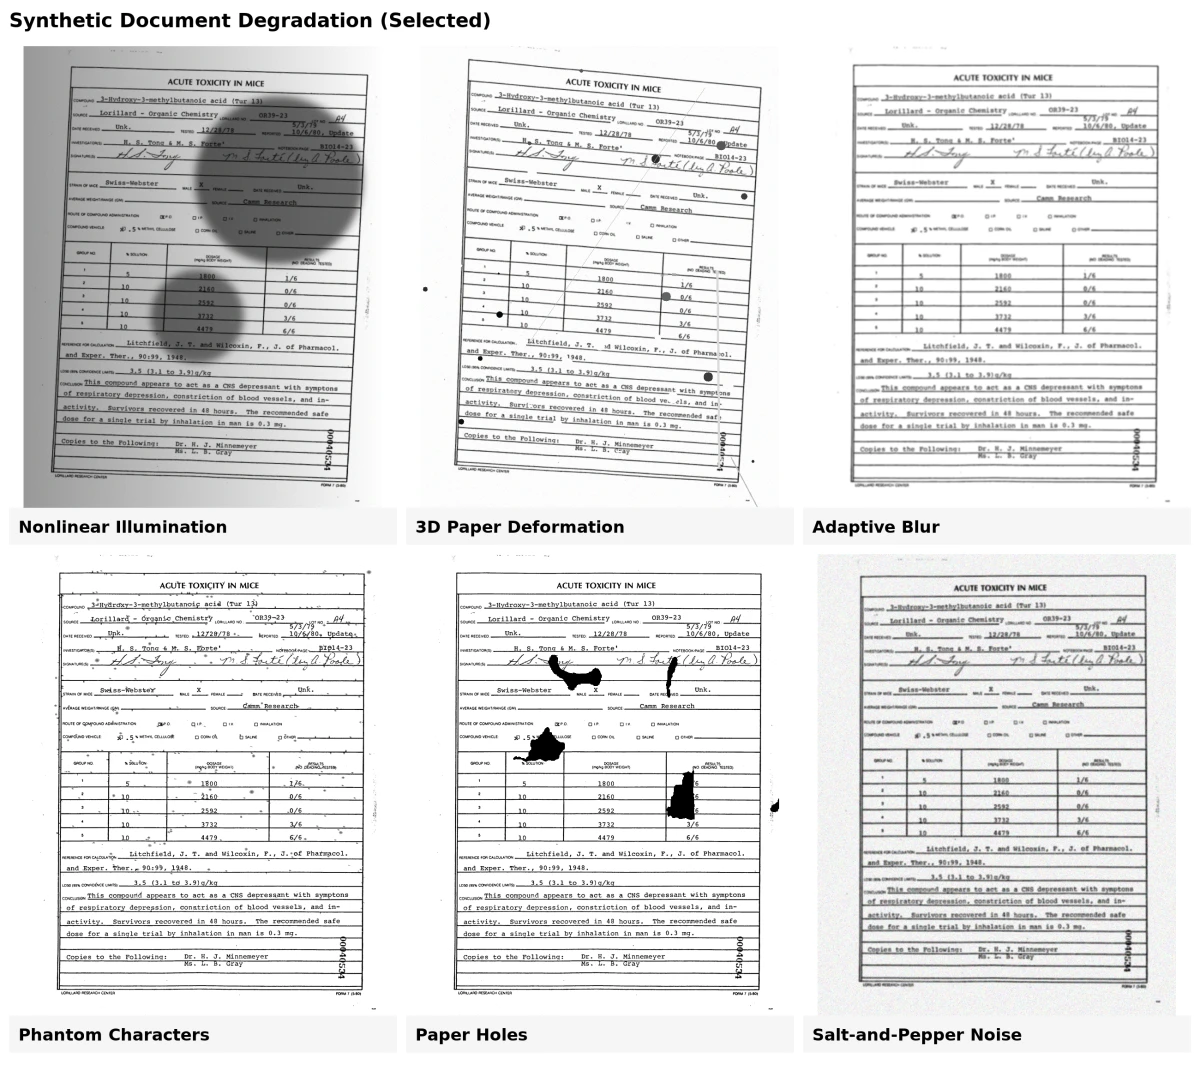
A geração de documentos sintéticos geralmente inclui a adição de defeitos realistas para fazer os dados artificiais se parecerem com documentos do mundo real. Esses defeitos, ou models de degradação, ajudam a treinar models com melhor desempenho em documentos ruidosos, envelhecidos ou digitalizados. Essas ferramentas aplicam várias transformações físicas e visuais para simular imperfeições comuns de documentos.6
1. Degradação de tinta
Este model simula desbotamento, manchas ou riscos causados pelo envelhecimento ou por impressão de baixa qualidade. Ele adiciona pequenos pontos de tinta ou remove partes de letras para imitar a deterioração real da tinta.
2. Caracteres fantasma
Ferramentas de impressão antigas geralmente deixavam contornos tênues ou marcas “fantasma” ao redor das letras. O model de caracteres fantasma recria essas marcas inserindo defeitos extraídos de digitalizações reais entre os caracteres impressos.
3. Furos de papel
Furos de diferentes formas e tamanhos são adicionados aleatoriamente aos documentos, replicando rasgos ou marcas de perfuração vistos em papéis desgastados.
4. Vazamento de tinta
Esse efeito imita a tinta que atravessa a página a partir do outro lado. Ele usa as imagens da frente e do verso de um documento para recriar a forma como a tinta é parcialmente transferida pelo papel.
5. Desfoque adaptativo
Escanear ou fotografar documentos geralmente cria um leve desfoque. Este model compara exemplos reais desfocados e aplica um desfoque semelhante usando filtros gaussianos, mantendo o resultado sutil e realista.
6. Deformação 3D do papel
Os documentos podem dobrar, enrugar ou curvar quando digitalizados ou fotografados. Usando malhas 3D de papéis reais, este model recria essas formas e efeitos de iluminação, ajudando a treinar models para análise de documentos baseada em câmera.
7. Iluminação não linear
A iluminação irregular durante a digitalização pode deixar um lado do documento mais escuro. Este model ajusta o brilho com base em ângulos de luz simulados e na curvatura da página, reproduzindo o efeito de iluminação inadequada.
8. Ruído sal-e-pimenta
Adiciona pixels aleatórios em preto e branco para simular poeira, textura de papel ou ruído sensor de digitalização. Esse efeito “sal-e-pimenta” ajuda a criar a aparência granulada de digitalizações envelhecidas ou de baixa qualidade.
 Adicionar como fonte preferencial
Geração de documentos sintéticos como solução para os desafios da análise de layout
O desafio da análise de layout
Entender a estrutura dos documentos é mais difícil do que ler o texto. As ferramentas de OCR podem extract palavras, mas não explicam o papel de cada bloco, como títulos, tabelas ou figuras.
Para lidar com esse desafio, foram desenvolvidos métodos:
Os primeiros métodos para análise de layout eram baseados em regras. Eles dependiam de regras geométricas e de análise de textura para dividir páginas em blocos. Embora úteis, essas abordagens exigiam muito ajuste manual e não generalizavam bem.
As abordagens de aprendizado de máquina, como Support Vector Machines (SVMs) e Gaussian Mixture Models (GMMs), melhoraram isso ao aprender com dados.7 No entanto, ainda dependiam de características criadas manualmente e tinham dificuldade com a diversidade dos documentos do mundo real.
O aprendizado profundo transformou a área. As redes neurais convolucionais (CNNs) tornaram possível tratar o reconhecimento de layout como detecção de objetos, identificando tabelas, figuras ou fórmulas da mesma forma que os models detectam objetos em imagens naturais.8 Alguns models também combinam características de texto e imagem para obter resultados mais precisos.
O desafio do aprendizado profundo: exige datasets grandes e rotulados para treinar.
Dados sintéticos como solução: O processo de geração de documentos sintéticos oferece uma forma escalável de criar dados de treinamento anotados sem o custo da rotulagem manual.
Os models generativos agora trazem possibilidades mais avançadas. Os autoencoders variacionais (VAEs), os models baseados em atenção e as GANs podem aprender padrões estruturais de documentos e produzir layouts realistas novos.9
Principais diferenças entre geradores de documentos sintéticos
Os três geradores de documentos sintéticos avaliados no benchmark diferem em foco, qualidade da saída e usabilidade:
- Genalog: Mais equilibrado em layouts realistas e precisão numérica. Seu fluxo de trabalho baseado em Python com templates em HTML/CSS e models de degradação o torna ideal para treinar models de aprendizado de máquina em diversas tarefas de análise de documentos.
- DocCreator: Forte na geração de documentos visualmente complexos e degradados, preservando a diversidade de layouts. Ligeiramente menos preciso numericamente do que o Genalog, mas eficaz para tarefas que exigem simulação realista de documentos digitalizados.
- Tonic Textual: Destaca-se em layouts limpos e visualmente consistentes e na síntese de dados com preservação de privacidade. Menos adequado para precisão numérica ou datasets completos de treinamento, sendo melhor para tarefas focadas em layout ou substituição de PII.
Essas diferenças refletem suas abordagens principais: o Genalog equilibra realismo e fidelidade dos dados, o DocCreator prioriza a variedade de layouts e a degradação de documentos, e o Tonic Textual prioriza a aparência e a privacidade. Isso ajuda os usuários a escolher a ferramenta certa com base em se a prioridade é eficácia do treinamento, realismo do layout ou desidentificação de dados.
Outros geradores de documentos sintéticos comumente usados
YData SDK: Oferece um gerador de documentos sintéticos capaz de produzir documentos sintéticos de alta qualidade nos formatos PDF, DOCX ou HTML, geralmente usado para contornar obstáculos de conformidade com a privacidade.10
DoGe: Uma ferramenta de código aberto projetada especificamente para sintetizar digitalizações realistas de documentos com texto, títulos e tabelas significativos para treinamento de Document IA.11
DocXPand: Especializada na geração de documentos de identidade (passaportes, carteiras de identidade) com base em padrões ISO, preenchendo templates com informações falsas e rostos gerados por IA.12
Leituras adicionais
- Benchmark de geração de dados sintéticos & melhores práticas
- Top 25 casos de uso de dados sintéticos
- Synthetic Users explicado: as 7 principais ferramentas de pesquisa de usuários com IA
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{arslan2026,
  author = {Arslan, Ezgi},
  title  = {{Top 3 Geradores de Documentos Sintéticos em Benchmark}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/synthetic-document-generator}},
  note   = {AIMultiple. Acessado em 3 junho 2026}
}Resultados e carimbos de data/hora de 9 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 3 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
2 atualizaçõesA introdução foi expandida com nomes de produtos específicos.
Links de referência
A seguir, leia
Top 10 Geradores de Documentos Word com IA: Avaliados e Testados
Principais ferramentas de geração de documentos com IA
Usuários Sintéticos Explicados: As 7 Melhores Ferramentas de Pesquisa de Usuários com IA


Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.