


Modelos de Embedding: 25 Modelos Avaliados para Recuperação

Avaliamos 25 modelos de embedding em 200 perguntas de recuperação em finanças, contratos legais, suporte técnico e literatura médica. Os quatro corpora continham 341.040 passagens de texto no total. Cada consulta pesquisou seu próprio domínio.
Resultados do benchmark de modelos de embedding
O nDCG@10 mede o quão alto as passagens relevantes registradas aparecem nos dez primeiros resultados. As pontuações variam de 0 a 1, com valores mais altos recompensando um melhor posicionamento.
O Recall@10 mede a proporção das passagens relevantes registradas de cada pergunta recuperadas nos dez primeiros resultados, calculada em média entre as perguntas. A precisão das respostas geradas ficou fora desta avaliação.
Os 95% intervalos de confiança (ICs) estimam a incerteza no nDCG@10 médio decorrente da amostragem de perguntas. Intervalos mais amplos indicam estimativas menos precisas.
As perguntas foram selecionadas porque o BM25 não encontrou as passagens com as respostas nos dez primeiros resultados. Sua pontuação zero reflete essa seleção e limita comparações com a recuperação por palavras-chave no tráfego comum.
Resultados de recuperação em 25 modelos
Voyage 4 Large registrou o maior nDCG@10 com 0.851
Seu 95% IC foi 0.817–0.884. Testes pareados não encontraram diferença significativa em relação a Cohere Embed 5 Pro, Cohere Embed 5 Fast, Gemini Embedding 2, Voyage 4 ou Gemini Embedding 001 após correção para comparações múltiplas. O ranking permanece incerto. Um resultado não significativo não estabelece desempenho igual.
Cohere Embed 5 Pro e Fast pontuaram significativamente acima do Embed v4.0
O Pro marcou 0.850 e o Fast marcou 0.839, em comparação com 0.772 para o Cohere Embed v4.0. Seus ganhos de 0.078 e 0.067 no nDCG@10 foram significativos após correção entre todos os 300 pares de modelos. A diferença de 0.010 entre Pro e Fast não foi significativa.
Gemini Embedding 2 registrou o maior Recall@10 com 96,50%
Cohere Embed 5 Pro veio em seguida com 95,88% e Voyage 4 com 95,83%. Nenhuma das diferenças em relação ao Gemini Embedding 2 foi significativa após correção. Mover uma passagem relevante do quinto para o primeiro lugar melhora o nDCG sem alterar o recall.
PPLX Embed v1 4B liderou os modelos de pesos abertos com 0.741 nDCG@10
O PPLX Embed v1 0.6B veio em seguida com 0.698. O modelo de 4B pontuou significativamente acima de nove dos outros dez modelos de pesos abertos. Sua diferença para 0.6B não foi significativa. A comparação de modelos de embedding de código aberto cobre esse subconjunto.
Resultados por domínio para finanças, contratos, suporte e medicina
As seis maiores pontuações de nDCG@10 em cada domínio. Cada filtro reordena os modelos concluídos nas 50 perguntas daquele domínio.
Cada domínio contribui igualmente para a média geral. O Cohere Embed 5 Fast registrou a maior pontuação CUAD com 0.762, e o Pro registrou a maior pontuação TechQA com 0.894. O MedRAG produziu a maior nDCG@10 de todos os modelos. Com 50 perguntas por domínio, pequenas diferenças nessas pontuações permanecem incertas.
Custo de embedding e qualidade de recuperação
Calculamos o custo de API para gerar embeddings das mesmas 341.040 passagens e 200 consultas para cada modelo.
O PPLX Embed v1 0.6B teve o menor custo de embedding a $0,13 e marcou 0.698 nDCG@10. O Voyage 4 Lite custou $0,62 e marcou 0.793. A $1,87, o Voyage 4 alcançou 0.829.
Cohere Embed 5 Fast custou $2,52 e marcou 0.839, enquanto o Pro custou $3,40 e marcou 0.850. O custo de embedding do Fast foi 26% menor nesta carga de trabalho. A diferença nas pontuações de recuperação deles não foi estatisticamente significativa após correção para comparações múltiplas.
Voyage 4 Large custou $3,74 e registrou a maior pontuação com 0.851. O Gemini Embedding 2 teve o maior custo a $6,68 e marcou 0.830. Gastar mais em embeddings não produziu consistentemente uma pontuação de recuperação maior neste teste.
Os custos cobrem chamadas de embedding bem-sucedidas usadas na avaliação. Os totais do Cohere usam os tokens de entrada relatados multiplicados pela tarifa registrada. O custo de $3,72 do Embed v4.0 é uma estimativa porque sua tarifa direta de API não foi verificada. Retentativas, diagnósticos, taxas de conta, armazenamento e computação de busca estão excluídos. Esses valores descrevem a carga de trabalho testada e as rotas de API. Os custos de produção dependerão do volume de texto, da tokenização e do preço do provedor.
Como os embeddings de texto apoiam a recuperação
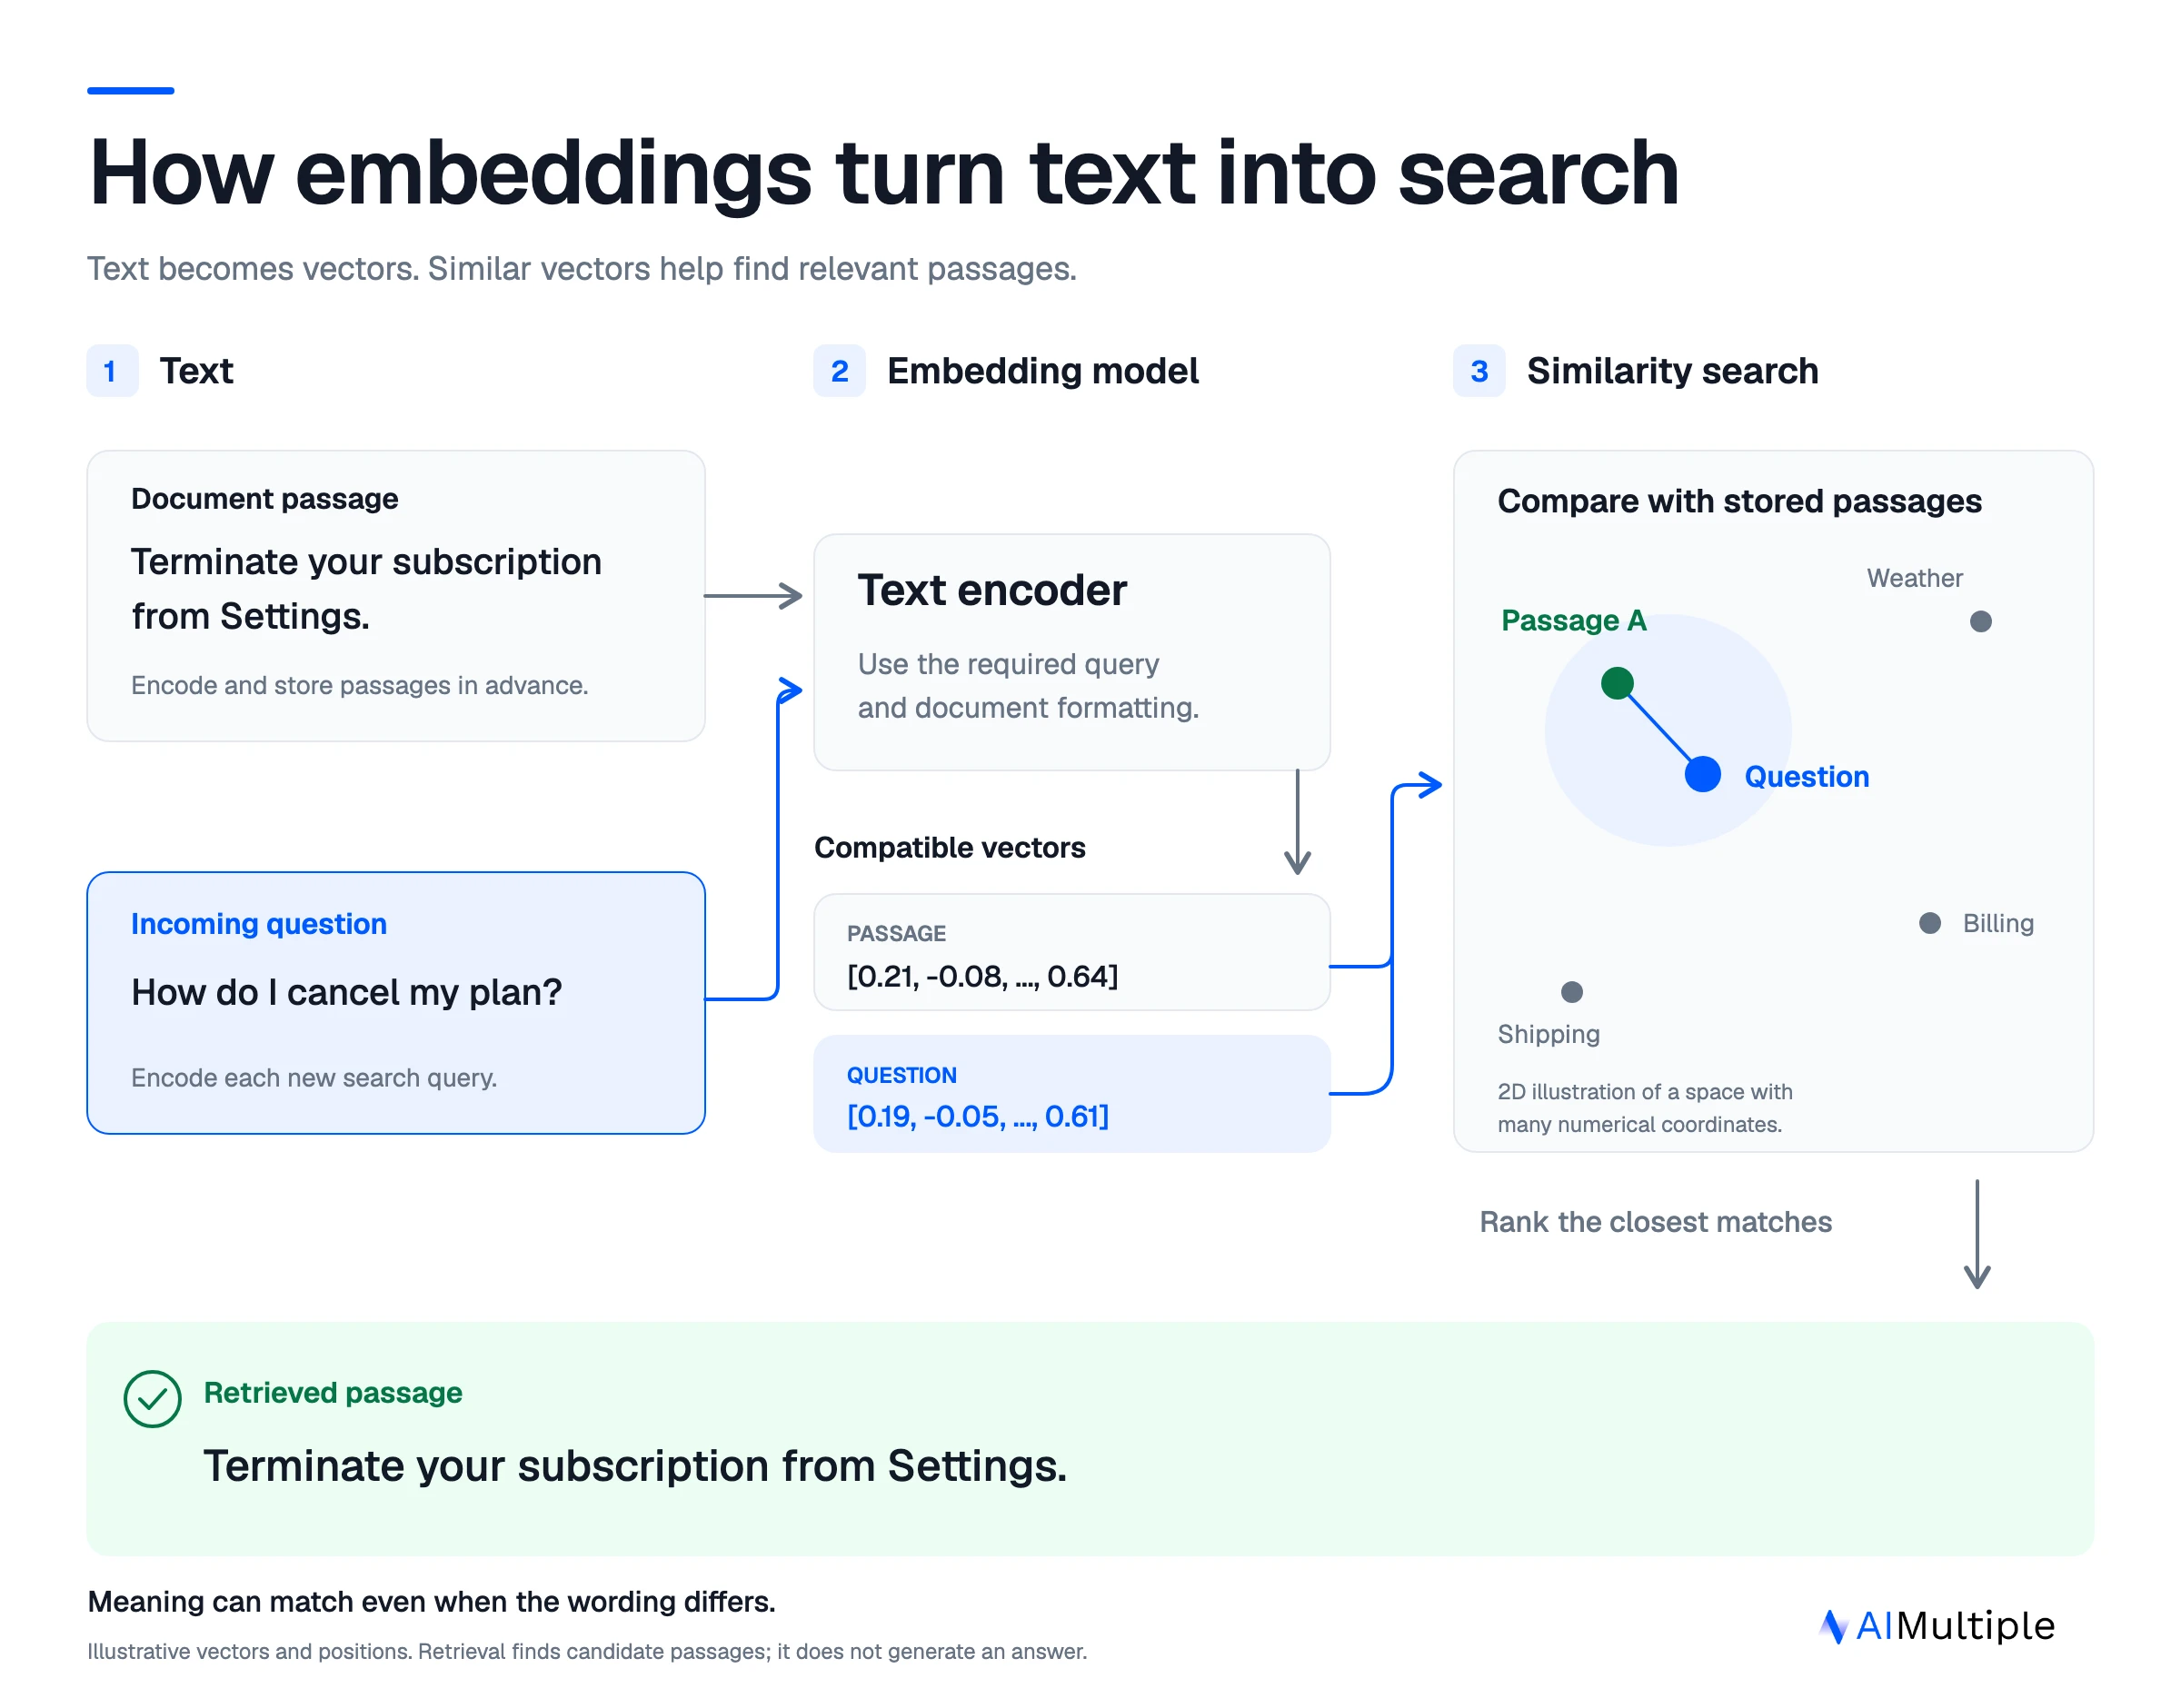
Um modelo de embedding converte texto em um vetor, uma lista de valores numéricos que pode ser comparada com outros vetores de um modelo compatível. Na recuperação semântica, as passagens de documentos são codificadas antecipadamente. No momento da busca, o sistema codifica a consulta e classifica as passagens armazenadas por similaridade vetorial.1
Por exemplo, uma pergunta sobre cancelar um plano pode estar próxima de uma passagem sobre encerrar uma assinatura, apesar da redação diferente. O treinamento do modelo determina quais relações os vetores preservam.2 O diagrama comprime essa ideia em duas dimensões. Os embeddings implantados geralmente contêm muito mais coordenadas.
A formatação de consulta e documento também importa. Um modelo pode esperar papéis ou prefixos de recuperação separados, mesmo quando ambas as saídas ocupam um espaço vetorial compatível. Aplicamos a formatação de consulta e documento exigida por cada modelo.
Um banco de dados vetorial armazena e pesquisa vetores, enquanto o modelo de embedding determina as representações pesquisadas. As passagens recuperadas podem então se tornar contexto para um gerador de respostas. Este benchmark termina na recuperação de passagens e não avalia as respostas geradas.
Metodologia do benchmark de modelos de embedding
Todos os modelos pesquisaram as mesmas passagens usando as mesmas 200 perguntas e 225 pares pergunta-passagem relevantes registrados. As perguntas e os rótulos foram congelados antes de comparar as pontuações de embedding. As entradas de consulta continham apenas a pergunta original.
As passagens financeiras vieram de relatórios anuais da FinQA e as passagens jurídicas de contratos do CUAD v1.34 O suporte técnico usou notas técnicas do TechQA, e a literatura médica usou uma amostra de resumos do PubMed do MedRAG.56
As passagens eram parágrafos inteiros, tabelas com contexto, cláusulas de contratos ou resumos com títulos. Excluímos unidades com mais de 256 tokens segundo o tokenizador all-MiniLM-L6-v2. As passagens aceitas foram mantidas intactas, e os modelos de 512 tokens receberam no máximo 459 tokens por passagem. Portanto, este benchmark avalia passagens curtas.
Os LLMs de fronteira redigiram as perguntas a partir das passagens de origem. Um membro da equipe verificou 20% das perguntas (40 de 200). Os LLMs também julgaram as 20 principais passagens do BM25 por pergunta, adicionando 25 passagens relevantes às 200 passagens de origem originais.
Análise estatística e de recuperação
A recuperação comparou cada consulta com todas as passagens do seu domínio. Usamos similaridade de cosseno para 21 modelos e produto escalar para o MultiQA MPNet Base Dot v1. O BGE-M3 usou seus vetores densos.7 As entradas de consulta e documento usaram os papéis ou prefixos de recuperação configurados de cada modelo.
Ambas as métricas são médias entre as perguntas. Calculamos 95% ICs com 10.000 amostras bootstrap, reamostrando 50 perguntas dentro de cada domínio. As comparações pareadas usaram testes de inversão de sinal pareados com correção de Holm entre todos os 231 pares de modelos para cada métrica e escopo. Consideramos as diferenças significativas com um valor-p corrigido abaixo de 0.05.
IDs de modelo testados, dimensões e limites de entrada
Os 22 modelos originais rodaram pelo OpenRouter, com um provedor de backend fixo por modelo e fallbacks desativados. Os três modelos Cohere rodaram pela Cohere API usando papéis nativos de documento e consulta (search_document e search_query). A tabela registra os identificadores de API, as dimensões de saída e os limites de entrada usados, incluindo limites conservadores.
Os identificadores de API não garantem um snapshot imutável do modelo. As revisões do tokenizador foram fixadas quando disponíveis. Os pesos dos modelos hospedados não foram verificados de forma independente. Os comprimentos de entrada do Gemini e do Cohere foram verificados usando estimativas conservadoras. As passagens curtas não testaram a recuperação de contexto longo.
 Adicionar como fonte preferencial
Escopo e limitações
As perguntas formam um conjunto de desenvolvimento selecionado pelo BM25. Os resultados em consultas comuns de produção podem ser diferentes. Os julgamentos de relevância limitaram-se às passagens de origem e às 20 principais do BM25. Em todos os 25 modelos, 87% dos pares distintos pergunta-passagem recuperados entre os dez primeiros não foram julgados e não receberam crédito de relevância.
Cada modelo foi executado uma vez. Os ICs refletem a amostragem de perguntas e excluem a variação entre execuções de API ou a incerteza decorrente de rótulos incompletos. A contaminação por dados de treinamento não foi testada.
Esta avaliação cobre a recuperação de texto. A precisão das respostas geradas, a recuperação híbrida, o reranking, a latência e o custo de serving ficaram fora do escopo. O benchmark de reranker, a comparação de embeddings multilíngues e a comparação de embeddings multimodais cobrem cargas de trabalho separadas.
Conclusão
Voyage 4 Large registrou o maior nDCG@10, sem diferença significativa para Cohere Embed 5 Pro ou Fast. Ambos os modelos Cohere pontuaram significativamente acima do Embed v4.0. O Gemini Embedding 2 liderou em recall, e o PPLX Embed v1 4B liderou o grupo de pesos abertos.
Use os resultados por domínio para escolher candidatos e depois compare-os em consultas representativas com rótulos de relevância revisados. Avalie a latência e o custo de serving de ponta a ponta separadamente.
Leitura adicional
- Benchmark de modelos de embedding de código aberto
- Modelos de embedding multilíngues para RAG
- Modelos de embedding multimodais
- Benchmark de banco de dados vetorial de código aberto
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Modelos de Embedding: 25 Modelos Avaliados para Recuperação}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/embedding-models}},
  note   = {AIMultiple. Acessado em 1 outubro 2026}
}Resultados e carimbos de data/hora de 132 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 5 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
5 atualizaçõesAdicionada a definição da métrica Top-1 hit à metodologia do benchmark de embeddings.
Substituído o benchmark por 15 modelos e uma linha de base BM25 testados em corpora jurídicos, de suporte ao cliente e de saúde.
Links de referência





Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.