


LLM Preços: Top 15+ Provedores Comparados

Acompanhamos os preços de lançamento de mais de 160 LLMs, do GPT-3.5 Turbo em março de 2023 aos lançamentos mais recentes, agrupados por classe de tamanho. Também comparamos os preços de API dos models atuais com seus resultados de benchmark e analisamos os planos de assinatura dos principais provedores.
LLM tendências de preços de lançamento
- Claude os preços de lançamento do Opus caíram de $30,00 (Opus 4.1, agosto de 2025) para $8,00 (Opus 5.5, setembro de 2026).
- Claude Fable 5 foi lançado a $20,00 em junho de 2026, o dobro do preço do Claude Opus 4.8 duas semanas antes. O OpenAI’s GPT-6 Astra seguiu a $20,00 em setembro.
- GPT-6 Sol foi lançado a $4,00 em setembro de 2026, 64% abaixo do $GPT-5.6 Sol’s 11.25 em julho. GPT-6 Luna foi lançado a $0,20, contra $2,25 do GPT-5.6 Luna.
- O preço médio de lançamento dos models fechados pequenos subiu de $0,53 em 2024 para $0,85 em 2025. Em 2026, o Flash do Gemini 3.5 a 3.8 foi lançado a $3,00 a $3.38.
- Em 2025, o preço médio de lançamento dos models abertos de grande porte ficou abaixo de um quarto da mediana dos models fechados de nível intermediário. O Moonshot’s Kimi K3 foi lançado a $6,00 em julho de 2026, acima do Claude Sonnet 5’s $4.00.
Os preços são por milhão de tokens, misturando três partes de entrada para uma parte de saída, e excluem promoções por tempo limitado. Os models de pesos abertos têm pesos publicamente divulgados; para aqueles sem uma API própria, o preço é a tarifa de um provedor de hospedagem próxima ao lançamento. Novos lançamentos ainda podem alterar as médias do trimestre atual.
LLM API avaliação de preços
Existem duas maneiras de pagar por um LLM: planos de assinatura com preços de LLM com taxa fixa dos principais provedores, ou um model de API pré-pago cobrado por uso de tokens.
Clique nos nomes dos models para ver seus resultados de benchmark, latência no mundo real e preços, a fim de avaliar a eficiência e o custo-benefício de cada model.
Ranking: Os models são classificados pela posição média em todos os benchmarks.
Você pode verificar as taxas de alucinação e o desempenho de raciocínio dos principais LLMs em nossos benchmarks.
Comparando planos de assinatura de LLM
Os usuários não técnicos podem preferir usar a interface do usuário em vez da API. Em 2026, a maioria das assinaturas de provedores inclui muito mais do que uma interface de chat. Agentes de codificação como Claude Code, Codex, Kimi Code e Mistral Vibe vêm incluídos nos planos Pro. Para desenvolvedores e usuários avançados, a assinatura certa de $10–$200 geralmente substitui o que de outra forma seria uma assinatura separada de IDE de codificação, um orçamento de API por token e uma ferramenta de vídeo ou pesquisa combinados.
OpenAI
O plano Free inclui chats de texto diários ilimitados com o GPT-5.6 Luna, modo de voz padrão, uploads limitados e geração básica de imagens. Anúncios contextuais alcançam cerca de 40 mercados em agosto de 2026, incluindo os EUA e a maior parte da Europa, e aparecem apenas nos planos Free e Go.
- ChatGPT Go ($8/mês) é um plano de baixo custo que pode incluir anúncios. Os chats de texto são ilimitados, assim como no Free; a atualização amplia os limites superiores de upload de arquivos, criação de imagens, voz e memória, tudo no GPT-5.6 Luna.
- ChatGPT Plus ($20/mês) inclui limites de uso estendidos, acesso ao GPT-5.6 Sol, Terra e Luna, modo de voz avançado, agente Codex, geração de imagens e recursos de acesso antecipado.
O plano Pro tem dois níveis a partir de abril de 2026:
- ChatGPT Pro ($100/mês) fornece a mesma linha de models do nível de $200 (incluindo o GPT-5.6 Sol) com limites de uso aproximadamente 5x superiores aos do Plus.
- ChatGPT Pro ($200/mês) fornece os maiores limites de uso individuais (cerca de 20x o Plus), a maior cota de Deep Research, voz avançada com vídeo e compartilhamento de tela, Codex com aumento máximo de uso e Sora.
Ambos os níveis Pro incluem acesso prioritário nos horários de pico. O preço do Codex no Plus, Pro e Business mudou de cobrança por mensagem para uso alinhado a tokens de API em abril de 2026.
O ChatGPT Work, agente da OpenAI para projetos de múltiplas etapas de longa duração (lançado em 9 de julho de 2026), está incluído nos planos pagos, e o aplicativo para desktop que reúne Chat, Work e Codex está disponível em todos os planos, incluindo o Free.
- Plano Business ($20/usuário/mês anual ou $25/usuário/mês mensal) é o plano da OpenAI para equipes pequenas e médias (anteriormente ChatGPT Team, renomeado em agosto de 2025). Ele adiciona limites maiores de mensagens, console administrativo, SSO, dados da equipe excluídos de treinamento e pools de crédito compartilhados para recursos avançados. Aplicativos incluídos: Codex com créditos de espaço de trabalho compartilhados. Os assentos exclusivos do Codex foram fechados para novos workspaces em 24 de junho de 2026; a OpenAI anunciou assentos Premium a $100/usuário/mês anual ($125 mensal) com uso 5x o Standard. O plano exige pelo menos 2 assentos.
- O plano Enterprise (preço personalizado) fornece acesso a models em alta velocidade, janelas de contexto expandidas, controles de dados de nível empresarial, verificação de domínio, análises e registros de auditoria. Aplicativos incluídos: Codex com pool de crédito compartilhado e assentos opcionais exclusivos do Codex.
Anthropic (Claude)
O plano Free inclui acesso web e mobile, análise básica, acesso ao Claude Sonnet 5 e ao Haiku, e upload de documentos. O uso diário é limitado, e os models Opus e Fable não estão disponíveis.
- Plano Pro ($20/mês ou $17/mês com cobrança anual) fornece acesso ao Opus 5, Sonnet 5 e Haiku, cerca de 5x mais uso que o Free, organização de projetos e acesso prioritário nos horários de pico. O Fable 5 não faz parte dos limites de uso do Pro; ele é cobrado conforme as taxas de API por meio de créditos de uso pré-pago. Aplicativos incluídos: Claude Code (agente de codificação da Anthropic no terminal e na IDE), Cowork, Claude Design e Claude para Microsoft 365, todos compartilhando o mesmo pool de uso do chat.
- Plano Max 5x ($100/mês) fornece cerca de 5x mais uso que o Pro, acesso prioritário aos recursos e models mais recentes e acesso completo ao Claude Code no nível de uso Max mais alto.
- Plano Max 20x ($200/mês) fornece cerca de 20x mais uso que o Pro, acesso prioritário máximo e acesso completo ao Claude Code. Projetado para usuários avançados diários que executam cargas de trabalho do Claude Code. Ambos os níveis Max incluem o Fable 5, o model de preço mais alto da Anthropic; seu uso pode consumir até metade do limite de uso semanal do plano.
O plano Team oferece dois tipos de assento e suporta de 2 a 150 membros:
- Assento Standard: $20/usuário/mês anual ($25/usuário/mês mensal). Inclui recursos básicos, limites de uso padrão e acesso ao Claude Code.
- Assento Premium: $100/usuário/mês anual ($125/usuário/mês mensal). Tudo do Standard, mais limites de uso maiores para usuários avançados que executam cargas mais pesadas do Claude Code.
Aplicativos incluídos: Claude Code e Cowork estão incluídos em cada assento do Team (Standard e Premium); a diferença está na cota de uso, não no acesso. Ambos os tipos de assento incluem cobrança centralizada, ferramentas de colaboração e controles administrativos.
- Plano Enterprise ($20/assento/mês mais uso conforme taxas de API no nível self-serve; preço personalizado com vendas) fornece janelas de contexto expandidas, SSO, captura de domínio, acesso baseado em funções, SCIM, registros de auditoria e integrações de dados. Aplicativos incluídos: nos planos Enterprise novos e self-serve, Claude Code e Cowork estão incluídos em cada assento; contratos Enterprise antigos podem distinguir entre assentos somente Chat e assentos Chat + Claude Code com cobrança baseada em uso.
Google (Gemini)
O plano gratuito fornece acesso ao Gemini 3.6 Flash e acesso variável ao Gemini 3.1 Pro, geração básica de imagens, Deep Research, Gemini Live, Canvas e Gems. Aplicativos incluídos: Gemini Notebook (anteriormente NotebookLM) e Flow com acesso limitado ao Nano Banana Pro.
O Google usa preços regionais, então os preços podem variar por região.
- Google IA Plus ($4,99/mês, EUA) é o nível pago de entrada com limites de uso 2x os do Free. Aplicativos incluídos: mais acesso ao Gemini 3.1 Pro no chat, geração de imagens com Nano Banana Pro, geração de vídeo com Gemini Omni Flash, 200 créditos Flow, Gemini Notebook com mais Audio Overviews, Gemini no Gmail, Docs e Vids, e Gemini no Chrome com acesso antecipado. Inclui 400 GB de armazenamento.
- Google IA Pro ($19,99/mês, EUA) fornece limites de uso 4x os do Free e 5 TB de armazenamento. Aplicativos incluídos: Jules (agente de codificação assíncrono), Google Antigravity (plataforma de desenvolvimento agêntico), limites expandidos do IA Studio, $40/mês em créditos do Google Cloud, Gemini Notebook com 5x Audio Overviews, Deep Research, 1.000 créditos Flow, YouTube Premium Lite e Google Home Premium (plano Standard).
- Google IA Ultra (EUA) custa $99,99/mês para limites de uso 5x os do IA Pro ou $199,99/mês para 20x. Aplicativos incluídos: raciocínio Deep Think, Gemini Agent (somente EUA), Gemini Spark, Project Genie (model de mundo interativo), Jules nos limites mais altos, Antigravity de nível superior, 10.000 ou 25.000 créditos Flow, Google Home Premium (plano Advanced) e uma assinatura individual do YouTube Premium. O armazenamento começa em 20 TB.
Microsoft Copilot
O plano gratuito (Copilot Chat) está disponível sem custo adicional para todos os usuários do Microsoft Entra com uma assinatura qualificada do Microsoft 365. Ele inclui chat básico do Copilot em aplicativos Microsoft sem os recursos mais profundos dentro de documentos.
- Microsoft 365 Premium ($19,99/mês ou $199,99/ano) agora é o plano Copilot para consumidores. Ele reúne os aplicativos do Office, até 6 TB de armazenamento (1 TB cada para até seis pessoas) e os maiores limites do Copilot para consumidores; os recursos de IA se aplicam apenas ao titular da assinatura. O antigo Copilot Pro ($20/mês) está fechado para novas compras, e os assinantes existentes podem mantê-lo ou migrar para o Premium.
- Microsoft 365 Copilot Business ($21/usuário/mês anual; $18/usuário/mês no primeiro ano para compras até 30 de setembro de 2026; $25,20/usuário/mês mensal) adiciona o Copilot em aplicativos Microsoft 365, integração com Teams e controles administrativos. Aplicativos incluídos: Copilot Studio Lite para criar agentes leves, Copilot no SharePoint e Copilot Pages para rascunhos colaborativos. Limitado a organizações com até 300 usuários.
- Microsoft 365 Copilot Enterprise ($30/usuário/mês anual ou $31,50/usuário/mês com cobrança mensal; exige uma licença qualificada do Microsoft 365) fornece segurança avançada, conformidade e análises sobre os recursos do Business. Aplicativos incluídos: criação de agentes com o Copilot Studio (agentes de dados de trabalho e pré-criados podem ser medidos; o Copilot Studio autônomo é vendido separadamente), Copilot no Microsoft Purview e Intune para fluxos de trabalho de TI e segurança, e governança sobre agentes implantados.
xAI (Grok)
O plano gratuito oferece acesso limitado ao Grok.
- SuperGrok Lite ($10/mês) é o nível pago de entrada. Inclui conversas 2x mais longas, limites de taxa maiores e criação de imagens e vídeos com IA. Aplicativos incluídos: Grok Build (agente de criação de aplicativos da xAI, também gratuito na web desde agosto de 2026) e Grok Imagine para geração de imagens e vídeos.
- SuperGrok ($30/mês ou $300/ano) inclui raciocínio aprimorado com Grok 4.6, conversas 5x mais longas, uploads de arquivos mais longos, modo de voz para chat falado e 20x mais gerações de imagem e vídeo do Grok Imagine, incluindo vídeo HD de 720p e 30 segundos.
- SuperGrok Plus ($100/mês) adiciona acesso ao Grok Bot, geração de vídeo 1080p, limites de uso maiores, respostas mais rápidas e acesso prioritário.
- SuperGrok Heavy ($300/mês) fornece tudo do Plus, uma equipe de agentes para trabalho paralelo, limites de taxa máximos, prévias antecipadas de recursos futuros da xAI e uma assinatura X Premium+. Em julho de 2026, a xAI também lançou suplementos para Excel, Outlook e Google Workspace, além de Automações agendadas; a maioria é gratuito, com o suplemento do Outlook e Automações acionadas por e-mail reservadas para usuários pagos.
O Grok também está incluído nas assinaturas do X: X Premium ($8/mês) é o caminho pago mais barato para o Grok dentro do aplicativo X e inclui status verificado e menos anúncios. X Premium+ ($40/mês) remove anúncios em todo o X e tem os maiores limites de uso do Grok, além de monetização completa para criadores.
Moonshot IA (Kimi)
Os planos de consumo do Kimi recebem nomes de indicações de andamento musical, do mais lento ao mais rápido. Os preços internacionais são em USD; usuários chineses pagam em CNY com tarifas mais baixas. Em agosto de 2026, novas compras estão em lista de espera. A página de preços anuncia planos futuros que separam os benefícios do Kimi e do Kimi Code, e o aviso de 20 de julho da Moonshot cita restrições de capacidade de computação para o atraso no lançamento, quatro dias após o lançamento do K3. Os assinantes existentes mantêm seus planos e podem renovar.
- Adagio (Free) fornece conversas básicas ilimitadas com 6 usos de agente, consultas limitadas ao Deep Research e tarefas básicas do agente OK Computer.
- Moderato ($19/mês) adiciona o Kimi K3 no chat e nas tarefas de agente, além de sessões expandidas do Deep Research. Aplicativos incluídos: Kimi Code (agente de codificação IA com terminal-first; estimativa de 300 a 1.200 solicitações por janela de 5 horas, cobradas do pool de crédito compartilhado), além das ferramentas de autoria Slides e Websites.
- Allegretto ($39/mês) fornece uso maior em tudo do Moderato. Aplicativos incluídos: Agent Swarm (orquestração paralela de subagentes, até 4 subtarefas paralelas neste nível), implantação na nuvem Kimi Claw para grupos heterogêneos de agentes com memória persistente e 2x os créditos de agente do Moderato.
- Allegro ($99/mês) fornece 5x os créditos de agente, Agent Swarm com até 8 subtarefas paralelas e chat K3 com até 1M tokens de contexto.
- Vivace ($199/mês) fornece 10x os créditos de agente, 4 tarefas concorrentes, Agent Swarm com até 8 subtarefas paralelas e chat K3 com até 1M tokens de contexto, voltado para cargas de trabalho intensas de pesquisa e agênticas.
A assinatura inclui chaves de API do Kimi Code para uso em ferramentas de codificação de terceiros; a API separada da Kimi Open Platform é cobrada por token.
MiniMax
A MiniMax vende um único Token Plan unificado sobre seus models M3 e M2.7. Ele substituiu os antigos planos separados de crédito de agente e o Coding Plan em meados de 2026.
Token Plan da MiniMax (uma cota para agentes, codificação e trabalho multimodal):
- Plus ($20/mês): janelas contínuas de 5 horas e semanais de cota, suficientes para 3 a 4 agentes de codificação executando em paralelo; para projetos pessoais e prototipagem.
- Max ($50/mês): as mesmas janelas para 4 a 5 agentes paralelos; para codificação diária com agentes e trabalho multimodal.
- Ultra ($120/mês): 6 a 7 agentes paralelos; para fluxos de trabalho pesados com agentes e sessões estendidas.
- Pacotes de crédito: $5 por 5.000 créditos, $25 por 25.000, $100 por 100.000 (1.000 créditos = $1, válidos por 365 dias), utilizáveis por cima de qualquer plano.
O Token Plan cobre toda a linha de models (M3, M2.7, imagem e fala) em uma única cota, sendo um dos caminhos mais baratos para um model de codificação de fronteira quando combinado com uma CLI como Cline ou Kilo Code.
Mistral AI
O plano Free do Mistral Vibe (antigo Le Chat) inclui navegação na web, análise básica de arquivos, geração de imagens, sessões limitadas de codificação, 100+ conectores e $10/mês em créditos de API.
- Plano Pro ($14,99/usuário/mês) inclui mais mensagens e buscas na web, mais raciocínio estendido e relatórios Deep Research, 15 GB de armazenamento de documentos, até 1.000 projetos, geração de imagens e $30/mês em créditos de API. Aplicativos incluídos: modo Code do Mistral Vibe na CLI, IDE ou web, com pagamento conforme o uso além da cota incluída. Estudantes verificados obtêm o Pro por $5,99/mês.
- Plano Team ($24,99/usuário/mês) inclui tudo do Pro com até 30 GB de armazenamento por usuário, cobrança central, controle de acesso baseado em funções, verificação de nome de domínio e exportação de dados. Aplicativos incluídos: Mistral Vibe no nível de uso da equipe com controles administrativos compartilhados.
- Plano Enterprise (preço personalizado) fornece opções seguras de implantação, incluindo self-hosted e nuvem privada, SAML SSO, registros de auditoria, suporte premium e análises detalhadas. Aplicativos incluídos: Mistral Vibe com opções de implantação on-premise para cargas de trabalho regulamentadas.
DeepSeek
A DeepSeek não oferece planos de assinatura tradicionais. O acesso via web e chat mobile aos models mais recentes (atualmente DeepSeek V4-Flash e V4-Pro) é gratuito para todos os usuários, com limitação de uso justo.
O acesso à API é pago por token com tarifas de pico e fora de pico desde 16 de agosto de 2026. Fora do pico, o V4-Flash custa $0,22 por milhão de tokens de entrada (cache miss) e $0,66 por milhão de tokens de saída; as tarifas de pico são o dobro ($0,44 e $1,32). O V4-Pro custa $0,66 e $1,98 fora do pico. Acertos de cache custam cerca de 3% da taxa de cache miss, e os horários de pico são das 01:00 às 04:00 e das 06:00 às 10:00 UTC em dias úteis.
A DeepSeek também entrou no ferramental de agentes. O DeepSeek Harness, um kit de ferramentas de código aberto baseado em plugins para criar e executar agentes de IA, está em preview de desenvolvedor com código-fonte público. Ele não tem preço próprio e é agnóstico de model; o uso é cobrado pela API do model que o agente chamar.
Meta (Muse Spark)
O Meta IA continua gratuito no WhatsApp, Instagram, Facebook, Messenger, no aplicativo Meta IA e nos óculos Ray-Ban Meta, movido pelo Muse Spark (lançado em 8 de abril de 2026, agora na versão 1.2). A Meta começou testes limitados de assinaturas pagas Meta One. Os planos Plus e Premium aumentam a cota mensal de uso de IA e o acesso ao modo Thinking, com preços relatados de $7,99 e $19,99 por mês.1
A Meta Model API está em preview público, self-serve e compatível com o SDK da OpenAI. O preço pré-pago do Muse Spark 1.2 começa em $1,25 por milhão de tokens de entrada e $4,25 por milhão de tokens de saída, com uma janela de contexto de 1M tokens. O Muse Code, um agente de codificação de terminal, foi lançado em beta em 5 de agosto de 2026.
Entendendo os preços de LLM
Tokens: a unidade fundamental de preços
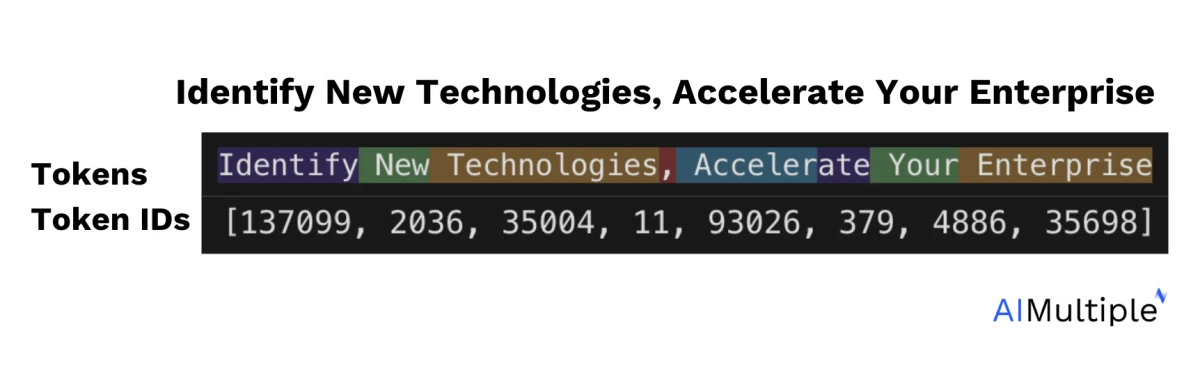
Figura 1: Exemplo de tokenização usando o tokenizer do GPT-4o & GPT-4o mini para a frase “Identifique Novas Tecnologias, Acelere Sua Empresa.”2
Embora os provedores ofereçam uma variedade de estruturas de preços, o preço por token é o mais comum. Os métodos de tokenização diferem entre os models; exemplos incluem:
- Byte-Pair Encoding (BPE): divide palavras em unidades de subpalavras frequentes, equilibrando tamanho do vocabulário e eficiência.3
- Exemplo: “inacreditável” → [“in”, “acredit”, “ável”]
- WordPiece: semelhante ao BPE, mas otimiza a probabilidade do model de linguagem, usado no BERT.4
- Exemplo: “tokenização” → [“token”, “##ização”]. “token” é uma palavra isolada; “##ização” é um sufixo.
- SentencePiece: tokeniza o texto sem depender de espaços, eficaz para models multilíngues como o T5.5
- Exemplo: “linguagem natural” → [” natural”, ” lan”, “guagem”] ou [” natu”, “ral”, ” linguagem”].
Observe que as subpalavras exatas dependem dos dados de treinamento e do processo BPE/WordPiece. Para entender melhor esses métodos de tokenização, assista ao vídeo abaixo:
Depois de compreender a tokenização, um preço médio pode ser estimado com base no comprimento do token do projeto. A Tabela 2 descreve faixas de tokens por tipo de conteúdo, incluindo prompts de interface, trechos de e-mail, blogs de marketing, relatórios detalhados e artigos de pesquisa, e observa que a contagem de tokens varia entre os models. Uma vez escolhido um model, seu tokenizer pode ser usado para estimar a contagem média de tokens do conteúdo.
Tabela 2: Tipos de conteúdo típicos, suas faixas de tamanho e considerações empresariais (as faixas são estimativas e podem variar).
Implicações da janela de contexto
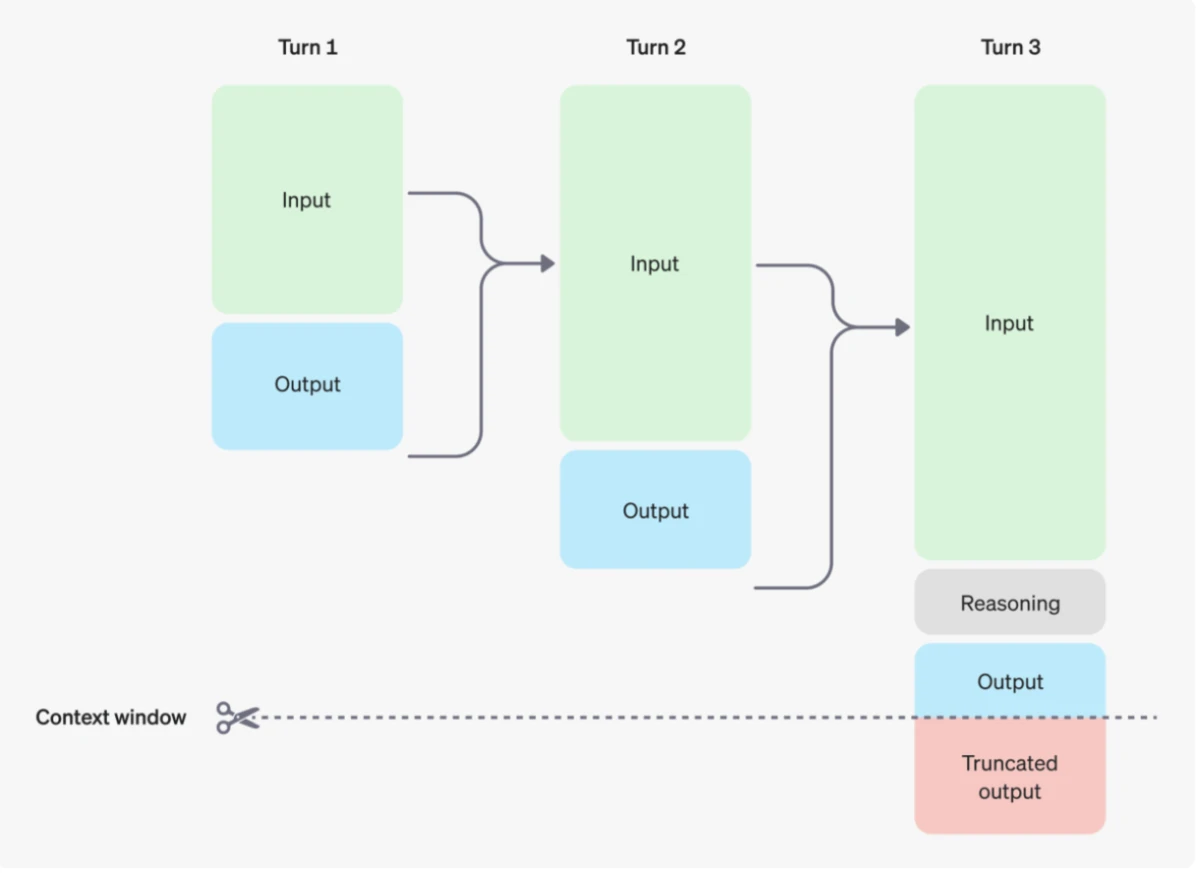
A janela de contexto impõe um limite rígido ao número de tokens de entrada e saída por chamada, incluindo quaisquer tokens usados por models de raciocínio para raciocínio em cadeia de pensamento. Se o total exceder esse limite, a resposta é truncada ou a solicitação falha completamente.
Figura 2: Ilustração das limitações da janela de contexto levando ao truncamento da saída em uma conversa de múltiplos turnos.6
Para aplicações que mantêm conversas longas, cada turno adicional empurra mais histórico para a entrada. Sem intervenção, os tokens de entrada crescem linearmente com o comprimento da conversa, e a conta também. Os usuários de API normalmente resolvem isso de uma das três maneiras:
- Cache de prompts. OpenAI, Anthropic, Google e DeepSeek armazenam em cache prefixos de prompt repetidos no servidor e cobram acertos de cache a uma fração da tarifa padrão de entrada, tipicamente de 3 a 10 por cento do preço de cache miss. Para aplicações que reutilizam um prompt de sistema longo ou prefixo de conversa, o cache pode reduzir o custo de entrada em uma ordem de grandeza.
- Janela deslizante ou geração aumentada por recuperação (RAG). Descarte os turnos mais antigos quando um limite for atingido, ou recupere apenas mensagens passadas relevantes de um armazenamento vetorial a cada chamada.
- Sumarização. Condense periodicamente turnos mais antigos em um resumo em vez de reenviá-los literalmente.
Para cargas de trabalho agênticas, como sessões de codificação ou pesquisa profunda, os agentes de codificação modernos lidam com isso automaticamente na sessão. O Claude Code, por exemplo, vem com compactação de contexto: quando a conversa se aproxima do limite, ele resume mensagens mais antigas em uma versão condensada, mantendo os turnos recentes intactos. Os turnos subsequentes enviam apenas o resumo mais o contexto recente de volta ao model.
O impacto no preço é direto. Em APIs por token, a compactação limita o quanto a entrada de cada chamada cresce e o cache reduz o preço do prefixo repetido, de modo que o custo por turno permanece previsível em sessões longas. Em assinaturas de taxa fixa como Claude Pro, ChatGPT Plus ou Kimi Moderato, a compactação estende os limites de uso diários e semanais porque cada chamada carrega menos contexto. Uma sessão de codificação que, de outra forma, queimaria um limite de taxa de 5 horas pode durar mais quando os turnos antigos são comprimidos.
A contrapartida é que qualquer forma de sumarização tem perdas. O resumo pode omitir detalhes que depois se mostram importantes, forçando o usuário a fornecê-los novamente.
Máximo de tokens de saída
O máximo de tokens de saída limita o comprimento da resposta de um model. Embora muitas documentações mencionem que isso pode ser ajustado usando o parâmetro max_tokens, é crucial revisar a documentação da API específica que está sendo usada para identificar o parâmetro correto. Ele deve ser ajustado de acordo com as necessidades específicas:
Se configurado muito baixo, pode resultar em saídas incompletas, fazendo com que o model corte as respostas antes de entregar a resposta completa.
Se configurado muito alto, dependendo da temperatura (um parâmetro que controla a criatividade da resposta), pode levar a saídas desnecessariamente prolixas, tempos de resposta mais longos e custo maior.
Portanto, é um parâmetro que exige consideração cuidadosa para otimizar o uso de recursos, equilibrando qualidade da saída, custo e desempenho.
Tabela 3: Exemplos de prompts de entrada e estimativas de contagem de tokens por tipo de conteúdo.
*Isso pressupõe que cada model produza respostas com um número igual de tokens de saída, embora a contagem de tokens de entrada e saída possa variar de acordo com a tokenização de cada model; o número foi mantido constante aqui para cada model.
Combinando as faixas de tokens da Tabela 2 com as tarifas por token de um model, obtém-se o custo esperado por tipo de conteúdo; os prompts de exemplo da Tabela 3 mostram os tamanhos de entrada e saída por trás dessas estimativas.
Usando múltiplos models de linguagem
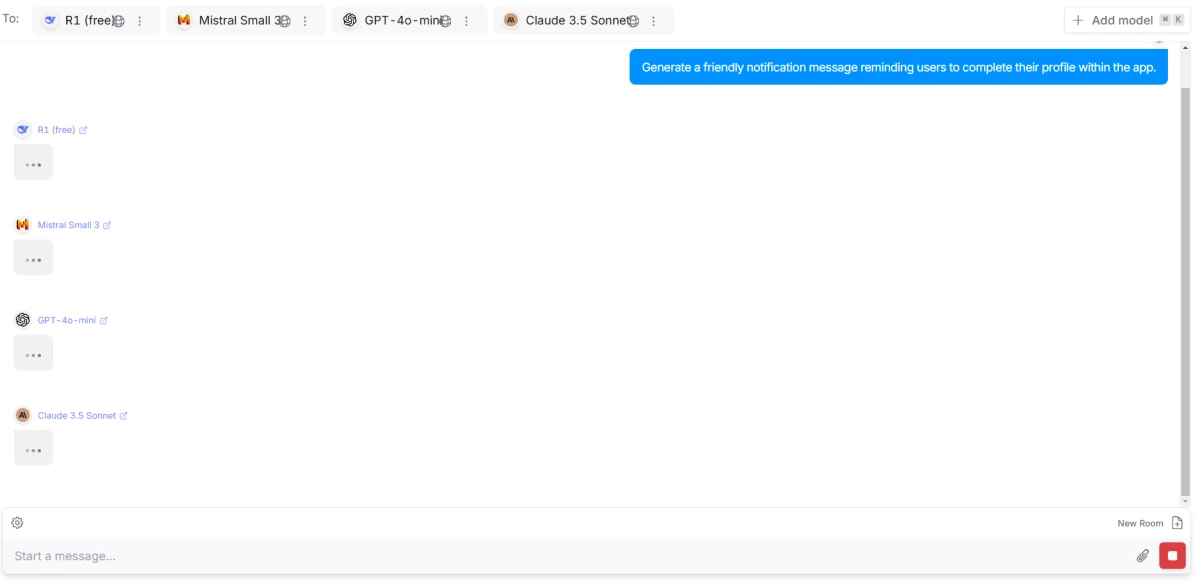
Um gateway de IA como o OpenRouter permite que o mesmo prompt seja enviado a vários models simultaneamente. As respostas, o consumo de tokens, o tempo de resposta e os preços podem então ser comparados para determinar qual model é mais adequado para a tarefa.
Figura 3: Interface mostrando um prompt enviado a vários Large Language Models via OpenRouter.7
Benefícios e desafios
- Maior adaptabilidade e eficiência: A orquestração aumenta a capacidade de resposta, permitindo avaliação em tempo real da eficiência do model e identificação de um model custo-efetivo e possíveis economias.
- Sensibilidade e otimização de prompts: Prompts idênticos podem gerar saídas muito diferentes entre os models, exigindo engenharia de prompts adaptada a cada model para alcançar os resultados desejados, aumentando a complexidade de desenvolvimento e manutenção.
Mecânica de preços e custos ocultos
Tokens de raciocínio vs. tokens de saída
Um número crescente de provedores introduziu models de raciocínio que gastam computação adicional para realizar raciocínio em cadeia de pensamento internamente. OpenAI, Anthropic e Google cobram esses tokens de raciocínio como tokens de saída à tarifa de saída padrão do model, então o aumento de custo vem do volume, não de um preço por token mais alto.
Models como GPT-5.5 Pro, Claude Opus 5 com raciocínio estendido ou Gemini 3.1 Pro Deep Think geram rastros internos de raciocínio
mesmo quando você não os solicita explicitamente. Esses tokens internos contam para sua conta e podem aumentar substancialmente o custo, especialmente em tarefas analíticas longas, como revisão jurídica, análise de dados ou raciocínio de várias etapas.
Isso torna essencial:
- Escolher um model de raciocínio somente quando a precisão superar substancialmente o custo.
- Desativar a cadeia de pensamento ou definir uma contagem máxima de tokens de saída menor quando possível.
- Testar a mesma tarefa em models sem raciocínio para ver se o desempenho é comparável por uma fração do preço.
Como um model de raciocínio pode emitir de 10 a 30 vezes mais tokens de saída do que o mesmo prompt produziria sem raciocínio, é fundamental entender essa distinção para o planejamento de custos.
Diferenças de preço orientadas pela arquitetura
As arquiteturas de LLM influenciam diretamente a eficiência do model e, portanto, o preço da API. Por exemplo:
- Mixture-of-Experts (MoE) ativa apenas um subconjunto de parâmetros por solicitação, reduzindo o custo computacional e permitindo que os provedores ofereçam tarifas por token mais baixas.
- Decodificação especulativa combina um model de rascunho menor com um maior, melhorando o throughput e reduzindo o custo para tarefas determinísticas.
- Variantes quantizadas (por exemplo, 4 bits ou 8 bits) podem executar inferência com menor precisão, permitindo preços mais baixos para versões implantadas localmente ou hospedadas na nuvem.
Compreender essas escolhas de arquitetura ajuda os usuários a prever não apenas diferenças de preços, mas também latência, qualidade e como um model escala sob cargas de trabalho de produção.
Custos operacionais além das taxas de API
Embora o preço por token seja o principal direcionador de custo, muitas implantações em produção incorrem em custos adicionais além do uso da API:
- Embeddings e bancos de dados vetoriais: armazenar e recuperar vetores (por exemplo, Pinecone, Weaviate, ChromaDB) adiciona custo por consulta e por GB de armazenamento.
- Models de reranking e pós-processamento: muitas aplicações usam models menores para sumarização, filtragem ou classificação antes de enviar uma solicitação final a um model maior.
- Camadas de cache: provedores como OpenAI agora oferecem cache em nível de prompt, mas a infraestrutura local de cache pode exigir computação adicional.
- Logging, monitoramento e auditoria: as empresas frequentemente incorrem em custos de monitoramento em nível de token, rastreamento de latência e auditorias de segurança.
Esses custos ocultos geralmente representam de 20 a 40% das despesas operacionais totais com LLM e devem ser considerados ao avaliar estruturas de preços.
 Adicionar como fonte preferencial
Considerações de preços específicas para empresas
Muitos fornecedores de LLM cobram taxas adicionais por recursos de segurança e conformidade de nível empresarial, como:
- Implantações de locatário único
- Clusters de GPU dedicados
- SLAs aprimorados (por exemplo, garantias de uptime e latência)
- Residência de dados e controles regionais
- Modos de conformidade SOC2, HIPAA ou GDPR
Essas ofertas podem aumentar significativamente os custos, mas são essenciais para setores regulamentados, como saúde, finanças, serviços jurídicos e instituições públicas.
Tendências futuras nos preços de LLM
Três coisas definiram os preços de LLM em 2025: os models de commodity ficaram baratos, quase todos os principais provedores lançaram uma assinatura de chat e os models de raciocínio continuaram caros. A lacuna é estrutural e provavelmente aumentará: um milhão de tokens de saída custa $0,66 no DeepSeek V4-Flash (fora do pico) e $180 no GPT-5.5 Pro. As questões interessantes para 2026 em diante são sobre o que muda em cima dessa base.
A cobrança por token dá lugar ao preço por tarefa
Os agentes agora impulsionam a maior parte do uso pesado de LLM. Uma única tarefa de codificação com Claude Code, uma rodada de pesquisa com Cowork ou uma sessão de navegação autônoma com Operator pode fazer centenas de chamadas sequenciais a models. A cobrança por token torna-se imprevisível tanto para o comprador quanto para o vendedor.
Em resposta, os provedores estão trocando medidores de token por cotas de tarefas e sessões. A Moonshot estima de 300 a 1.200 solicitações do Kimi Code por janela de 5 horas a partir de um pool de crédito compartilhado. O Claude Code limita o uso por sessão de 5 horas em vez de por mensagem. A MiniMax define as cotas do seu Token Plan como janelas contínuas de 5 horas e semanais, dimensionadas pelo número de agentes de codificação paralelos. O Kimi define limites específicos por nível para subagentes paralelos do Agent Swarm.
Harnesses de agentes entre provedores, como OpenClaw e MaxHermes, vão além. Eles ficam entre os usuários e várias APIs de models, e seus preços cada vez mais acompanham o throughput por tarefa em vez de por milhão de tokens. Espere mais provedores publicando SKUs por tarefa ou por sessão no próximo ano.
Models pequenos de raciocínio vão para o dispositivo
O Apple Intelligence executa inferência no dispositivo para consultas rotineiras, recorrendo ao Private Cloud Compute apenas para solicitações complexas. Os PCs Microsoft Copilot+ vêm com um model local. Dispositivos Pixel executam o Gemini Nano. Models pequenos recentes, como o Phi-4 da Microsoft e o Gemma 3 do Google, são capazes de raciocínio em tamanhos que cabem na unidade de processamento neural de um telefone ou laptop.
A implicação de preços é um mercado consumidor de dois níveis. O trabalho rotineiro roda gratuito no token marginal no dispositivo. As assinaturas de nuvem competem no que o local não pode fazer: raciocínio de fronteira, contexto grande, geração multimodal e orquestração de agentes. O piso free-local empurra as assinaturas somente de chat para zero, deixando os aplicativos incluídos como o verdadeiro motivo para pagar.
Contexto longo e memória decidem quem vence o trabalho agêntico
Tarefas agênticas de longo horizonte falham quando os models perdem o controle de instruções anteriores ou alucinam fatos que deveriam lembrar. O trabalho agêntico sustentado depende de três coisas: uma grande janela de contexto, memória persistente e uma baixa taxa de alucinação.
Em um ano, três capacidades de fronteira colapsaram para a linha de base. Claude Opus 5, Gemini 3.1 Pro, GPT-5.6 e Kimi K3 oferecem janelas de contexto de 1M tokens. No OpenAI, Anthropic, Google e DeepSeek, os acertos de cache custam de 3 a 10 por cento dos cache misses. ChatGPT e Claude agora incluem memória persistente em seus níveis gratuito.
Models agênticos especializados estão surgindo no topo desse mercado. Em junho de 2026, a Anthropic lançou o Claude Fable 5, um model de classe Mythos geralmente disponível8, com preço de $10 de entrada e $50 de saída por milhão de tokens, o dobro da tarifa do Opus 5. O Fable 5 tem como alvo codificação agêntica, uso de computador e pesquisa de longo horizonte; o Claude Mythos 5, o mesmo model com salvaguardas removidas em algumas áreas, permanece limitado a parceiros aprovados pelo mesmo preço.
A questão competitiva muda de “quão grande é a janela de contexto” para “quão barata e confiavelmente o model consegue sustentar uma tarefa agêntica longa?” Os provedores que resolverem isso bem cobrarão prêmios. Aqueles que não resolverem perderão cargas de trabalho agênticas independentemente do preço de token anunciado.
Perguntas frequentes
Acessar Large Language Models (LLMs) por meio de uma Interface de Programação de Aplicações (API) concede a você acesso remoto aos models de IA. Esse acesso está sujeito a uma taxa, muitas vezes chamada de “API fee”, cobrada pelo provedor de serviços. Essa taxa é uma consideração crítica ao integrar LLMs em suas aplicações.
Ela representa o custo associado a cada consulta, solicitação ou tarefa realizada por meio da API do provedor. Como as estruturas de preços podem variar amplamente (com base em fatores como uso de tokens, volume de chamadas de API, utilização de recursos ou models de assinatura), entender como os provedores calculam esses custos é essencial.
O preço de LLM API pode ser complexo devido a fatores como consumo de tokens, comprimento de contexto e escolha do model. Os procedimentos de tokenização variam entre os models; alguns usam Byte-Pair Encoding (BPE), WordPiece ou SentencePiece, cada um influenciando como o texto é dividido em tokens e impactando a eficiência de custos. Compreender essas diferenças ajuda a otimizar o uso e o preço da API.
Os custos de LLM são determinados principalmente pelo uso de tokens (entrada e saída), volume de chamadas de API e pelo model de preços (por exemplo, por token ou assinatura).
Compare os preços de tokens de entrada e saída, limites de janela de contexto e quaisquer taxas adicionais. Ferramentas como o OpenRouter permitem enviar o mesmo prompt para vários models e comparar diretamente resultados, uso de tokens, velocidade e preços. Considere o comprimento típico do seu conteúdo e padrões de uso para estimar custos gerais.
Tokens de entrada são os tokens no prompt que você envia ao LLM, enquanto tokens de saída são os tokens na resposta gerada. Para models de raciocínio, os tokens gerados durante o próprio processo de raciocínio também são contados como tokens de saída, impactando o custo final. Tanto a entrada quanto a saída contribuem para o custo geral.
Solicitações de texto maiores exigem mais processamento, aumentando o tempo de resposta e os custos. Otimize os tamanhos de entrada e use uma calculadora de preços de LLM API para estimar contagens de tokens e gerenciar seu orçamento de forma eficaz.
A comunidade de LLM desenvolveu várias ferramentas e benchmarks para ajudar os usuários a entender e otimizar os preços de LLM. Esses recursos geralmente incluem calculadoras e quadros comparativos que oferecem insights sobre o poder e a eficiência de diferentes models.
Plataformas como Hugging Face e GitHub hospedam ferramentas e códigos desenvolvidos pela comunidade para analisar desempenho e custos de models. Muitos serviços oferecem suporte da comunidade por meio de fóruns ou recursos de chat.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM Preços: Top 15+ Provedores Comparados}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/llm-pricing}},
  note   = {AIMultiple. Acessado em 26 agosto 2026}
}Resultados e carimbos de data/hora de 285 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 6 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
8 atualizaçõesAtualizada a descrição do gráfico na introdução.
Adicionado um gráfico à seção de tipos de preços LLM.
Removida a seção 'Compreendendo os preços do LLM'.
Expandida a seção "Implicações da janela de contexto" com estratégias para gerenciar o uso de tokens em conversas longas.
Adicionado ChatGPT Go à seção OpenAI.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.




Comentários 1
Compartilhe suas ideias
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.
"Really well-written and timely article! Your analysis of how different large language model (LLM) providers compare - based on token pricing, context window, and performance - really helps demystify an often opaque cost structure. I found the detailed breakdown of token-based billing (input vs output tokens), context-window implications, and the built-in “price calculator” particularly useful for anyone trying to realistically estimate LLM usage