


Migliori strumenti IA di web scraping messi a benchmark

Abbiamo testato i migliori strumenti di web scraping IA con 25.000 richieste, 5.000 per strumento, su 500 URL su ciascuno dei 10 domini più visitati per vedere le loro prestazioni, e abbiamo anche confrontato come ciascuno sfrutta l'IA.
Benchmark di web scraping IA
Consulta la sezione metodologia del benchmark per maggiori dettagli sul processo di test.
Confronto tra completezza e accuratezza
Per ogni dominio abbiamo richiesto i campi che contano su quel tipo di pagina: prezzo e valuta sulle pagine e-commerce, testo del post, Mi piace e autore su quelle social. Per misurare le prestazioni di questi strumenti, abbiamo usato tre metriche: successo, completezza e accuratezza. Ne servono tre perché uno strumento può restituire qualcosa senza restituire tutto, e tutto senza che nulla sia corretto.
Successo: la quota di richieste che sono tornate con almeno uno dei campi richiesti.
Completezza: la quota dei campi richiesti che sono effettivamente tornati, media sulle richieste.
Accuratezza: la quota dei campi verificabili che sono tornati con un valore corretto, verificata rispetto a un riferimento o rispetto a ciò su cui gli altri strumenti concordavano. Un campo che non è mai tornato conta come errato.
Metodologia statistica
Gli intervalli di confidenza sono stati calcolati utilizzando il ricampionamento percentile bootstrap:
Ricampionamenti: 10.000
Livello di confidenza: 95%
Unità di ricampionamento: URL, con tutti e cinque i fornitori ricampionati nella stessa estrazione
Metriche: tasso di successo, completezza, accuratezza e tempo di completamento
Dimensione del campione: N = 5.000 URL per fornitore (500 su ciascuno dei 10 domini)
I punteggi per dominio vengono calcolati prima, poi mediati sui dieci domini
Risultati del benchmark di web scraping IA
Su 5.000 URL sui 10 domini, abbiamo chiamato ogni strumento nel modo in cui è costruita la sua API. Bright Data, Apify e Firecrawl accettano una lista di URL in una singola richiesta, quindi abbiamo inviato 100 URL per richiesta. Oxylabs e ScrapingBee accettano un URL per richiesta, quindi li abbiamo inviati uno alla volta. La concorrenza era la stessa per ogni strumento, cinque richieste parallele, quindi l'unica differenza è ciò che supporta ciascuna API.
- Bright Data ha ottenuto il punteggio più alto su tutte e tre le misure di qualità: 85% di successo, 76% di completezza, 60% di accuratezza.
- L'accuratezza più alta nel campo è stata del 60%. Due campi verificabili su cinque sono tornati mancanti o errati.
- La completezza variava dal 76% di Bright Data fino al 32% di Apify, con Oxylabs al 59%, Firecrawl al 53% e Scraping Bee al 41%.
- Firecrawl è stato il più veloce con meno di mezzo secondo per URL contro i 4,6 secondi di Bright Data, e 22 punti in meno di accuratezza. Oxylabs è stato il più lento con 35 secondi.
Ogni fornitore adotta un approccio diverso all'IA, e il nostro obiettivo era confrontare questi approcci e i compromessi che comportano.
Risultati chiave sugli strumenti di web scraping IA dal benchmark
- I fallimenti possono sembrare dati. Quando uno strumento non riesce a leggere un prezzo, spesso perché la pagina ha incontrato un muro anti-bot, può restituire 0 invece di un fallimento. Un null può essere ritentato o saltato, ma uno 0 passa la validazione senza essere notato. Apify e Oxylabs hanno restituito null in questi casi. La documentazione di Firecrawl consiglia di aggiungere “Restituisci null se non trovato nella pagina” a ogni campo dello schema affinché il modello non indovini un valore.
- Campi extra: un prompt che chiede prezzo e valuta può anche restituire marchio, descrizione o URL delle immagini. Uno schema limita la risposta ai campi che nomini. Bright Data blocca lo schema di output in fase di costruzione, così ogni chiamata restituisce gli stessi campi.
- Elemento errato: sulle pagine che mostrano un prezzo scontato e uno originale, prezzi con e senza tasse, o opzioni di prezzo regionali, uno strumento può extract il numero sbagliato.
- Numeri modificati: gli strumenti prompt-to-JSON possono aggiungere decimali, troncare valori o restituire approssimazioni convertite di valuta che non compaiono sulla pagina.
- La posizione cambia il prezzo: alcuni siti impostano i prezzi in base alla posizione IP del visitatore, quindi uno strumento su proxy statunitensi vede un prezzo diverso rispetto a un utente europeo.
Lo schema e la regione del proxy sono i parametri che ti permettono di intercettare la maggior parte di questo prima che raggiunga i tuoi dati.
Prezzi degli strumenti di web scraping IA
Kadoa non è nel grafico dei prezzi perché non pubblica tariffe. Kadoa offre un livello Flex basato sul consumo e un livello Enterprise con prezzi tramite vendita.
Confronto degli strumenti di web scraping IA
Tempo per il primo scraper: Per gli strumenti che costruiscono uno scraper che poi chiami per ID, quanto dura la configurazione. “Singola chiamata HTTP” significa che non c'è alcun passaggio di costruzione.
Schema di output definito dall'utente: Se puoi impostare i campi di output e i loro tipi tu stesso prima che lo scraping venga eseguito, invece di descriverli in un prompt e lasciare che il LLM decida la struttura a runtime.
Endpoint costruisci-una-volta, chiama-più-volte: Se lo scraper viene costruito una volta, memorizzato lato fornitore, e poi chiamato solo con un URL. Qui il LLM (o, per gli strumenti basati su registrazione, il tuo click-through) viene eseguito al momento della costruzione e il suo output viene congelato in uno scraper che possiedi e puoi modificare sul posto, a cui si legano pianificazioni, webhook e integrazioni. Dove questo manca, l'estrazione viene rielaborata a ogni chiamata e la definizione completa viaggia con ogni richiesta.
Scraper salvato con auto-riparazione: Se uno scraper salvato viene riparato quando il sito di destinazione cambia, senza ricostruirlo da zero. La correzione si applica allo stesso scraper memorizzato sotto il suo identificatore esistente, così trigger, pianificazioni e integrazioni continuano a funzionare.
* Kadoa memorizza lo scraper e lo chiama per ID, ma gli URL di destinazione vengono vincolati alla creazione del flusso di lavoro. Puntarlo a un nuovo URL richiede un aggiornamento separato dei metadati prima dell'esecuzione.
Gli strumenti che eseguono un LLM sulla pagina a ogni chiamata non sono conteggiati qui: non c'è una logica di estrazione persistente da riparare, il che li rende tolleranti ai cambiamenti di layout ma significa anche che non c'è alcun artefatto da ispezionare, versionare o approvare. Nemmeno le cache interne senza un identificatore a cui puntare, poiché di nuovo non c'è nulla da ispezionare, versionare o approvare.
Al di là di aspetti come le pagine che cambiano costantemente, nelle pipeline agentiche spesso hai bisogno di una semplice API che puoi chiamare: dai un URL, ricevi dati strutturati. Ma non puoi sempre trovare un'API di scraper pronta per ogni dominio che devi raschiare regolarmente; e quando la trovi, i campi che desideri potrebbero non esserci, oppure devi personalizzare lo schema in base alle tue esigenze. Ci sono diversi approcci che affrontano questi problemi.
Piattaforme di web scraping IA costruisci-una-volta, chiama-più-volte
Se costruisci il tuo scraper, devi scrivere il crawler, collegare i proxy, eseguire browser headless e gestire code, tentativi e anti-bot da solo.
Gli strumenti di web scraping IA riducono quel lavoro. Le piattaforme costruisci-una-volta, chiama-più-volte come Bright Data Scraper Studio, Browse IA e Kadoa costruiscono uno scraper una volta, da un prompt o da una registrazione click-through, e lo memorizzano così puoi chiamarlo con un URL.
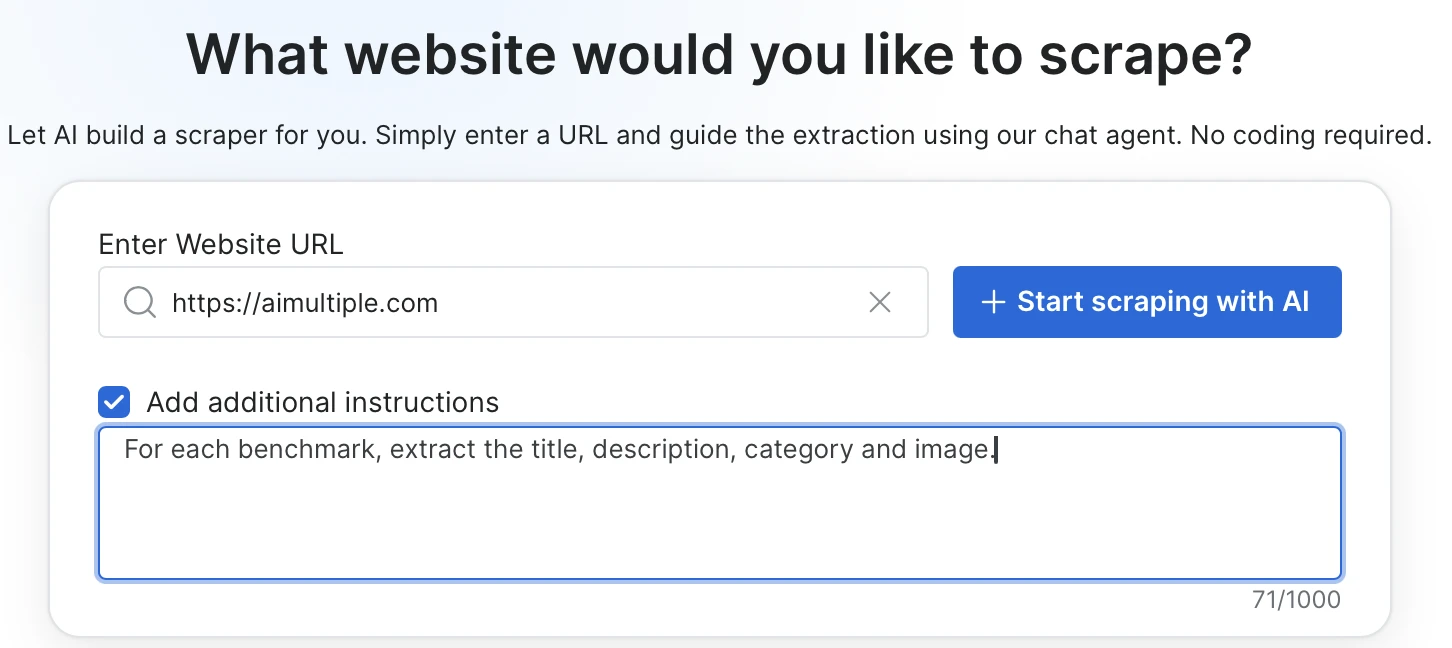
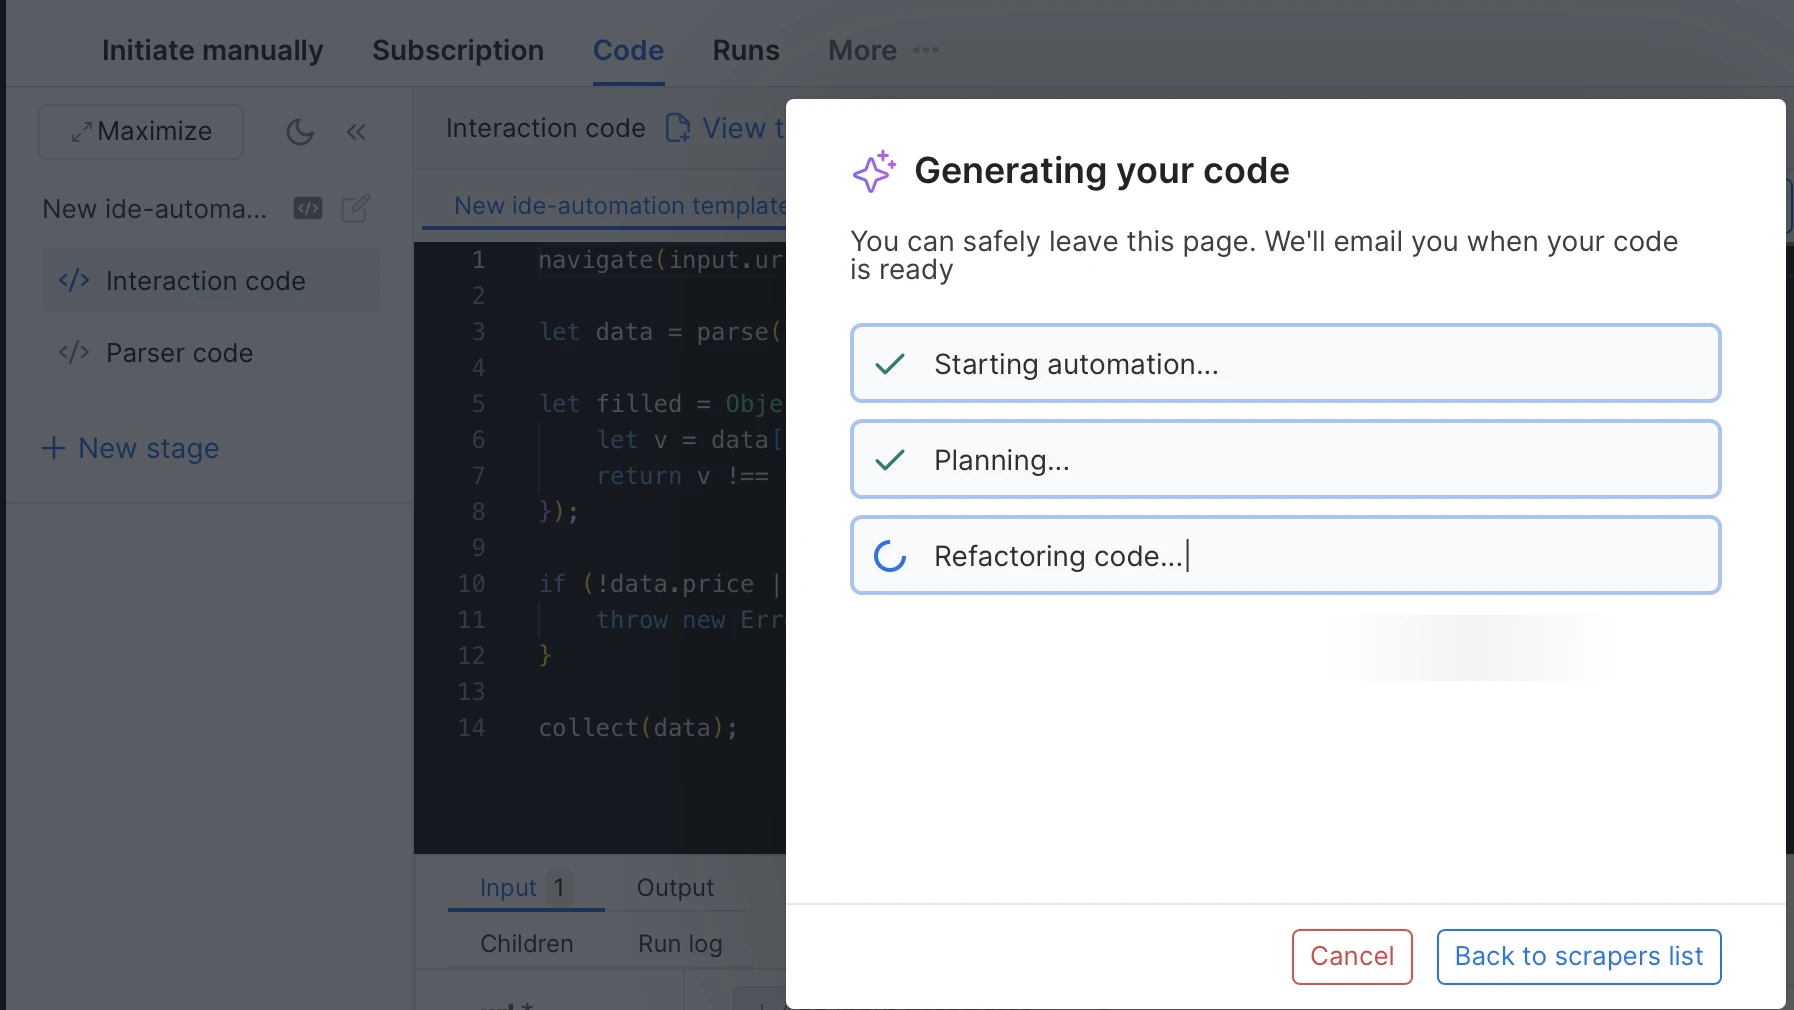
Bright Data Scraper Studio costruisce uno scraper da un prompt e poi lo serve come API stabile. Dopo la configurazione una tantum, ogni chiamata richiede solo un URL.
Descrivi i campi che vuoi extract in linguaggio semplice, e puoi opzionalmente aggiungere selettori CSS, azioni richieste sulla pagina o comportamento di caricamento della pagina.
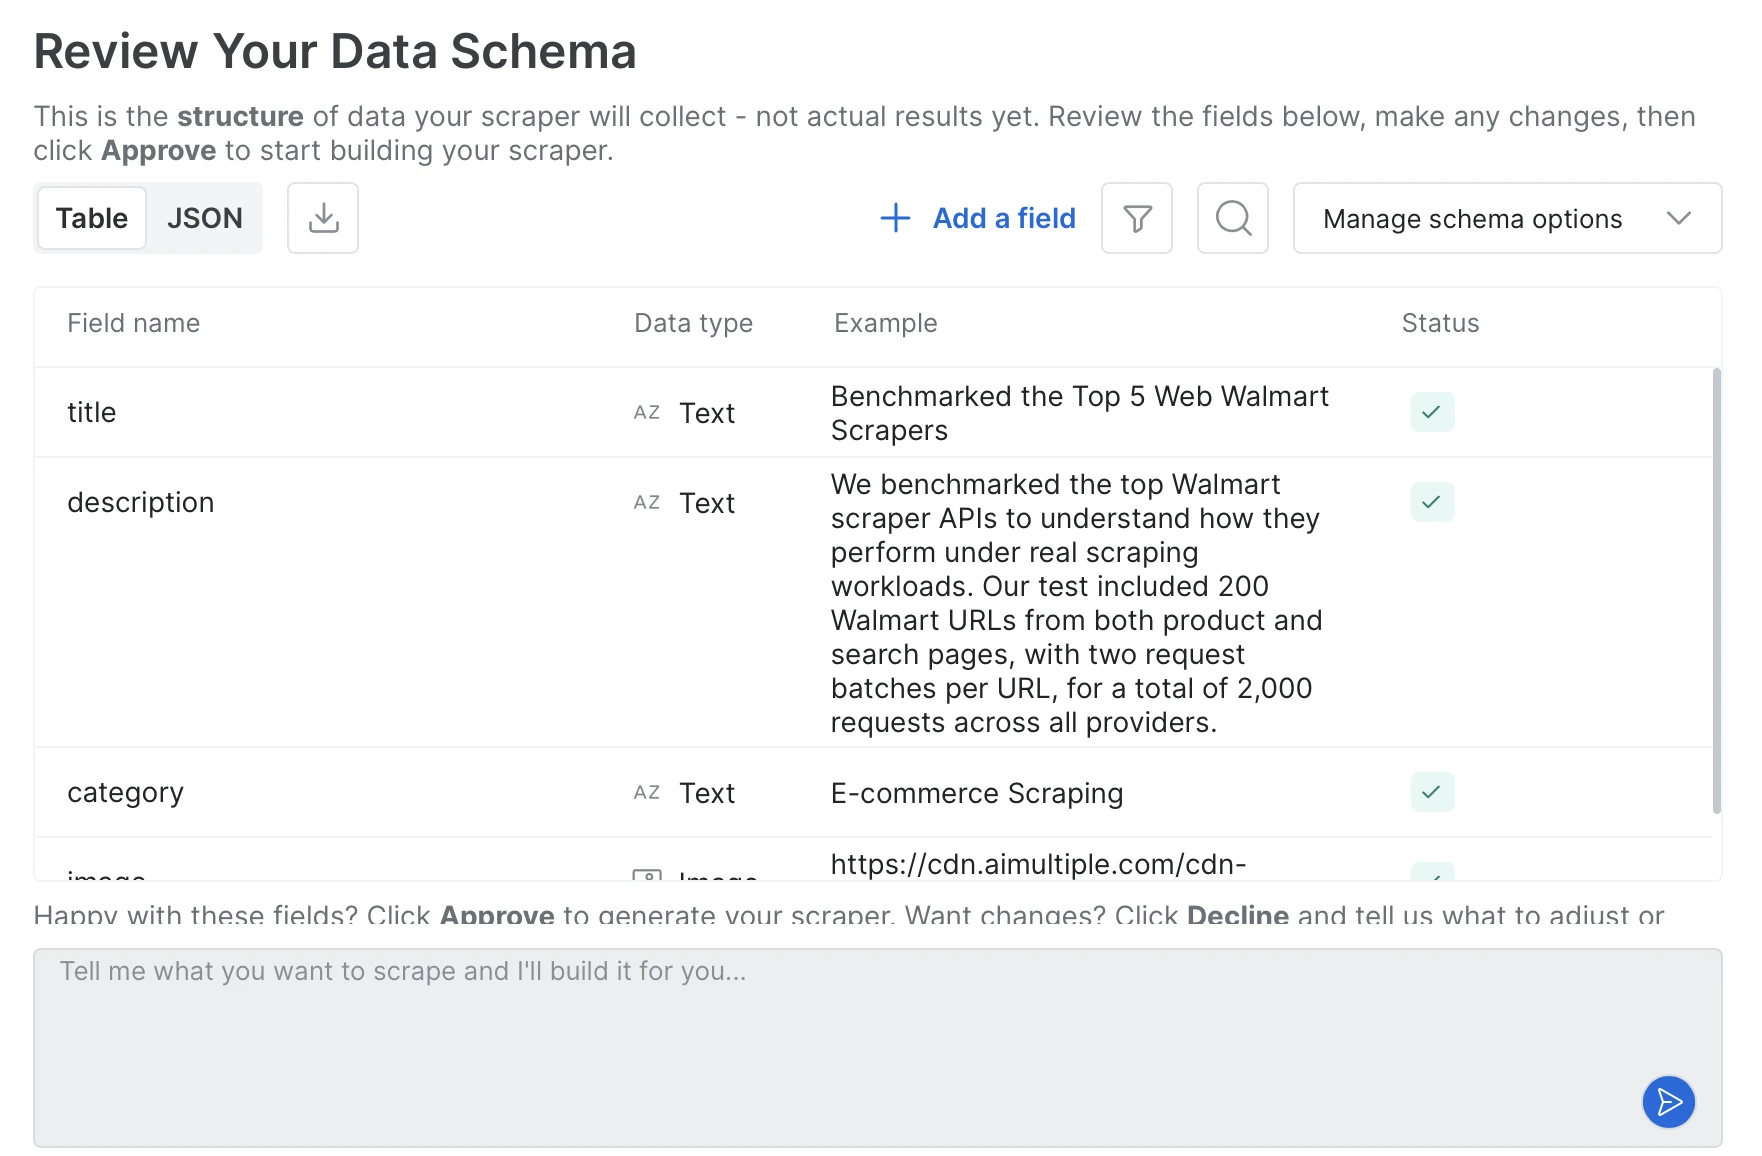
L'agente di Scraper Studio genera lo schema di output dal prompt. Rivedi lo schema, aggiungi o rimuovi campi o cambi tipi, e l'agente poi scrive il codice dello scraper.
- Endpoint costruisci-una-volta, chiama-più-volte: Una volta approvato lo schema, lo scraper viene registrato come endpoint a lunga vita con un identificatore fisso. Ogni chiamata colpisce lo stesso endpoint con solo un URL, e lo schema di output rimane lo stesso tra le chiamate. Nei nostri test, costruire uno scraper dedicato ha richiesto in media circa 10 minuti.
- Due metodi di costruzione: Puoi chattare con l'Agente nel browser, o usare la CLI di Bright Data per costruire lo scraper dal tuo terminale con un singolo comando che accetta un URL e un prompt. Entrambi producono lo stesso scraper.
- Flusso di lavoro coding-agent: I comandi da terminale vengono eseguiti invariati all'interno di Claude Code, Cursor e Codex, così l'agente può costruire, eseguire o auto-riparare uno scraper senza lasciare l'editor. Puoi anche fissare l'identificatore dello scraper nel file delle regole dell'agente così le sessioni future lo riutilizzano.
- Consegna: API, SDK, CLI, webhook, o consegna diretta allo storage cloud su S3, GCS, Azure o OSS.
- Combinato con scraper pre-costruiti: Bright Data mantiene una libreria di scraper pronti per siti popolari come Amazon, LinkedIn e Zillow.
Auto-riparazione automatizzata
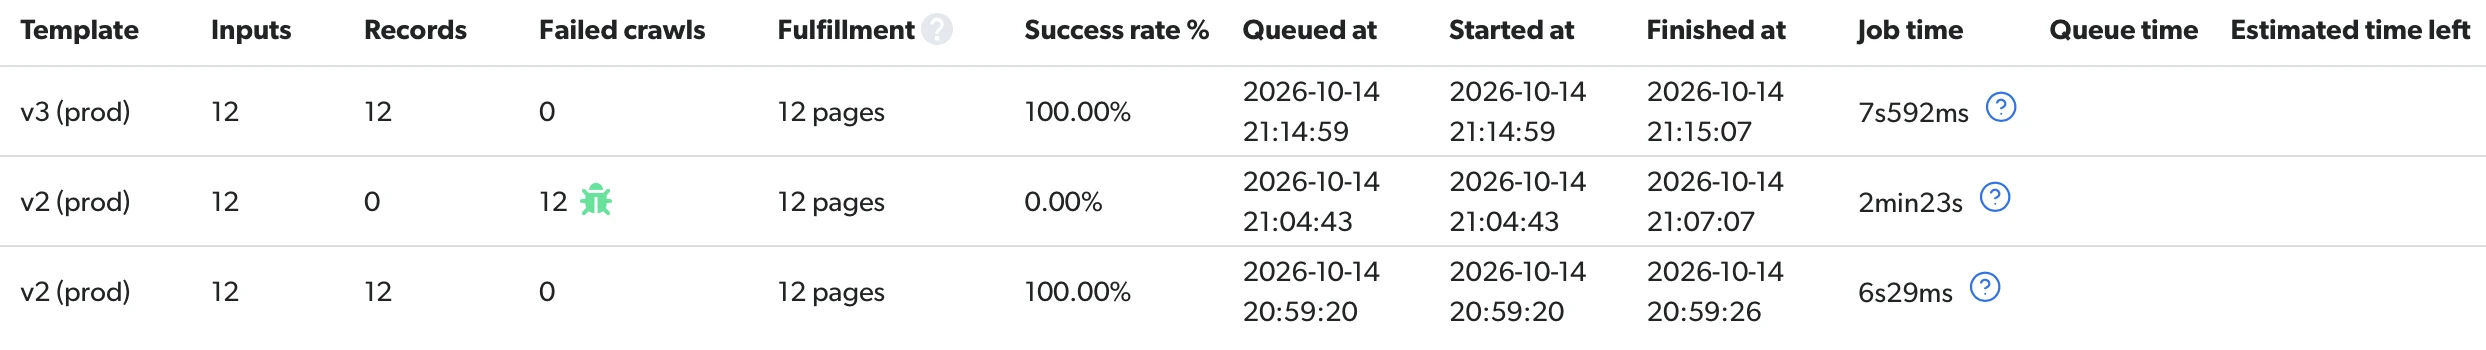
Lo Scraper Studio di Bright Data può riparare da solo uno scraper salvato. Lo abbiamo testato su pagine di prodotto che ospitiamo, chiedendo titolo, prezzo, valuta, venditore e disponibilità. La prima esecuzione ha restituito record con 100% di successo.
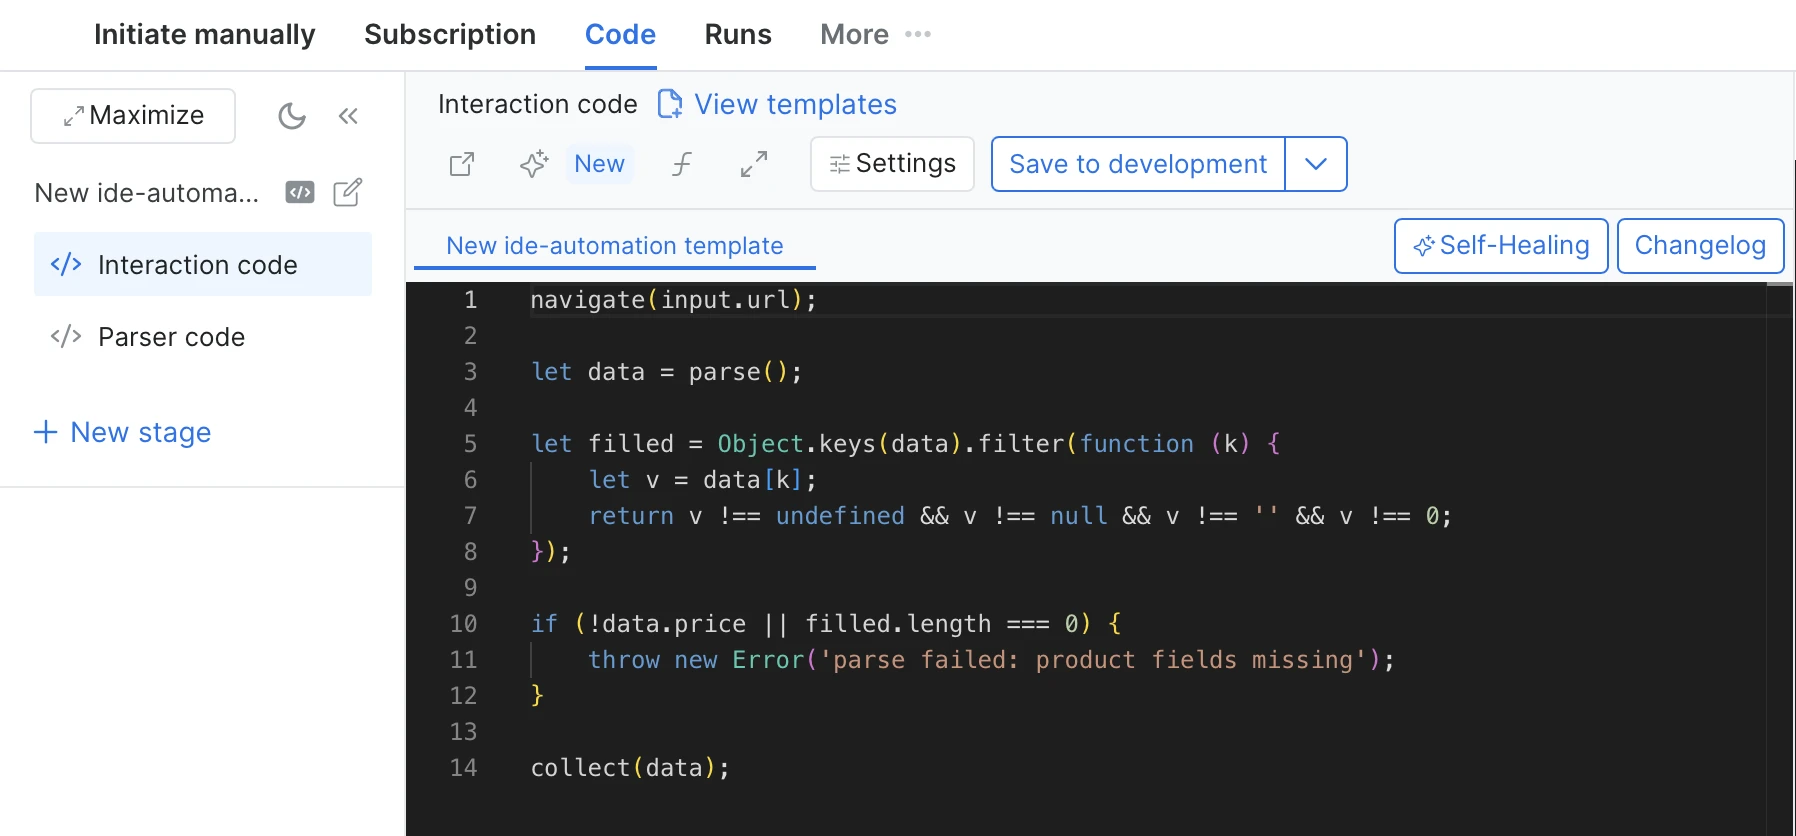
Abbiamo aggiunto un controllo al codice generato. Se il prezzo manca, o se non torna alcun campo, l'esecuzione genera un errore invece di raccogliere un record vuoto.
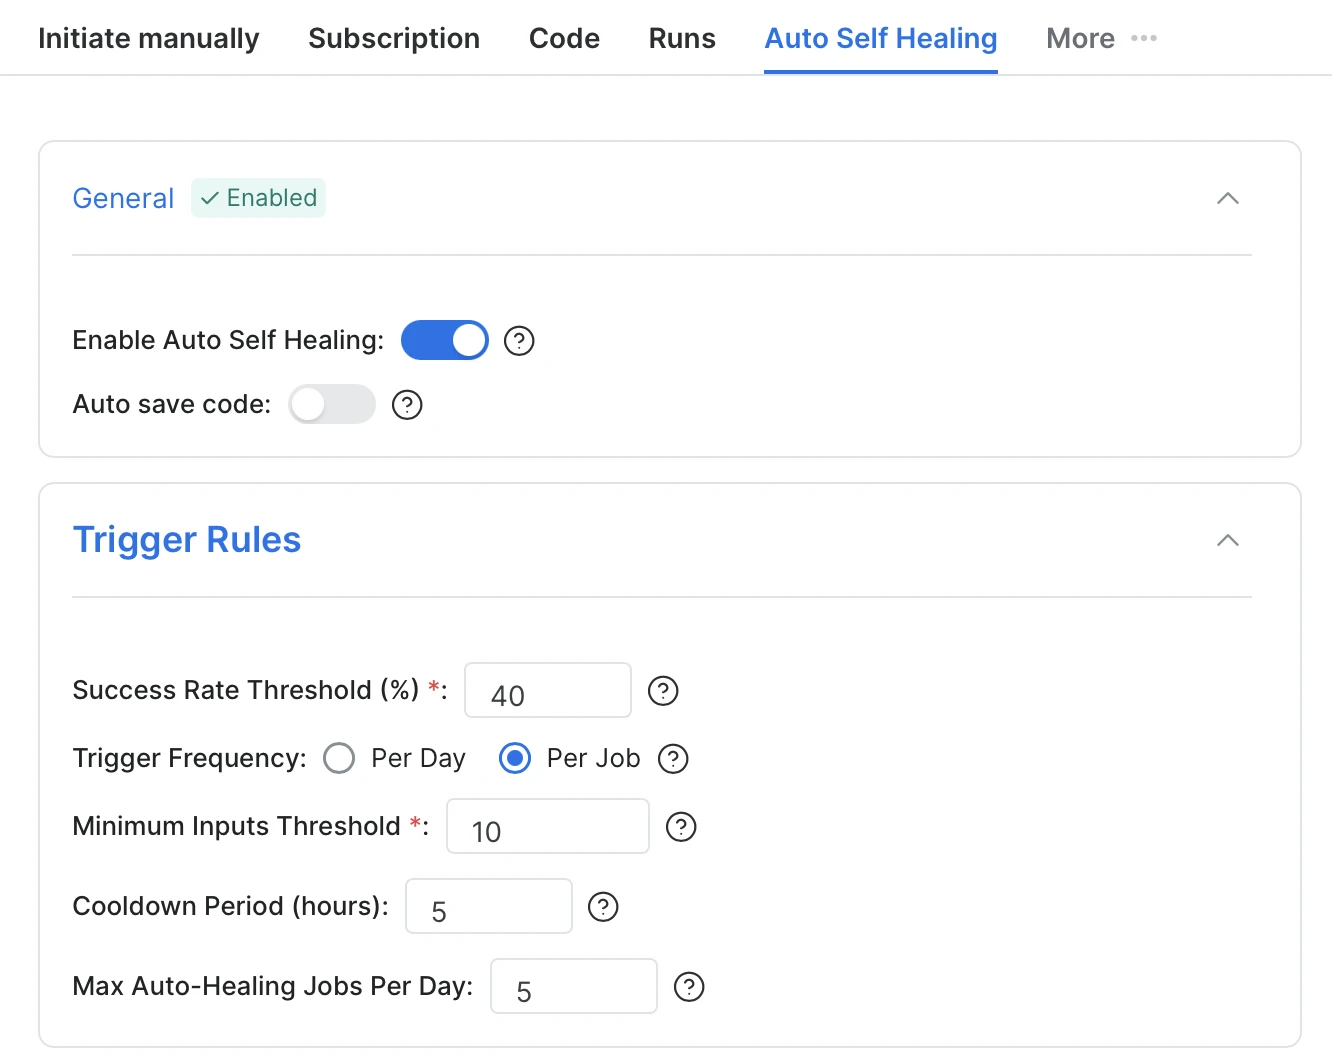
Abbiamo abilitato l'Auto Self-Healing con le regole di attivazione predefinite: la riparazione inizia quando il tasso di successo scende sotto il 40%, controllato dopo ogni job, su esecuzioni con almeno 10 input. Abbiamo lasciato disattivato il salvataggio automatico del codice, così qualsiasi riscrittura avrebbe atteso l'approvazione.
Abbiamo poi ridisegnato le pagine dietro gli stessi URL, cambiando tag e nomi di classe lasciando ogni valore nell'HTML come testo semplice. L'esecuzione successiva ha riportato 12 crawl falliti e 0% di successo, e la riparazione è iniziata senza che la chiedessimo.
La versione riparata ha restituito tutti i record al 100% sugli stessi URL.
Gli stessi URL hanno ottenuto il 100% sul layout originale, 0% dopo il redesign, e di nuovo 100% dopo che l'Auto Self-Healing ha riscritto il collector.
Questo è importante per gli scraper che tieni in una pipeline: quando il sito cambia layout, lo scraper che hai costruito si ripara da solo e riprende, finché il fallimento fa scendere il tasso di successo sotto la soglia che hai impostato.
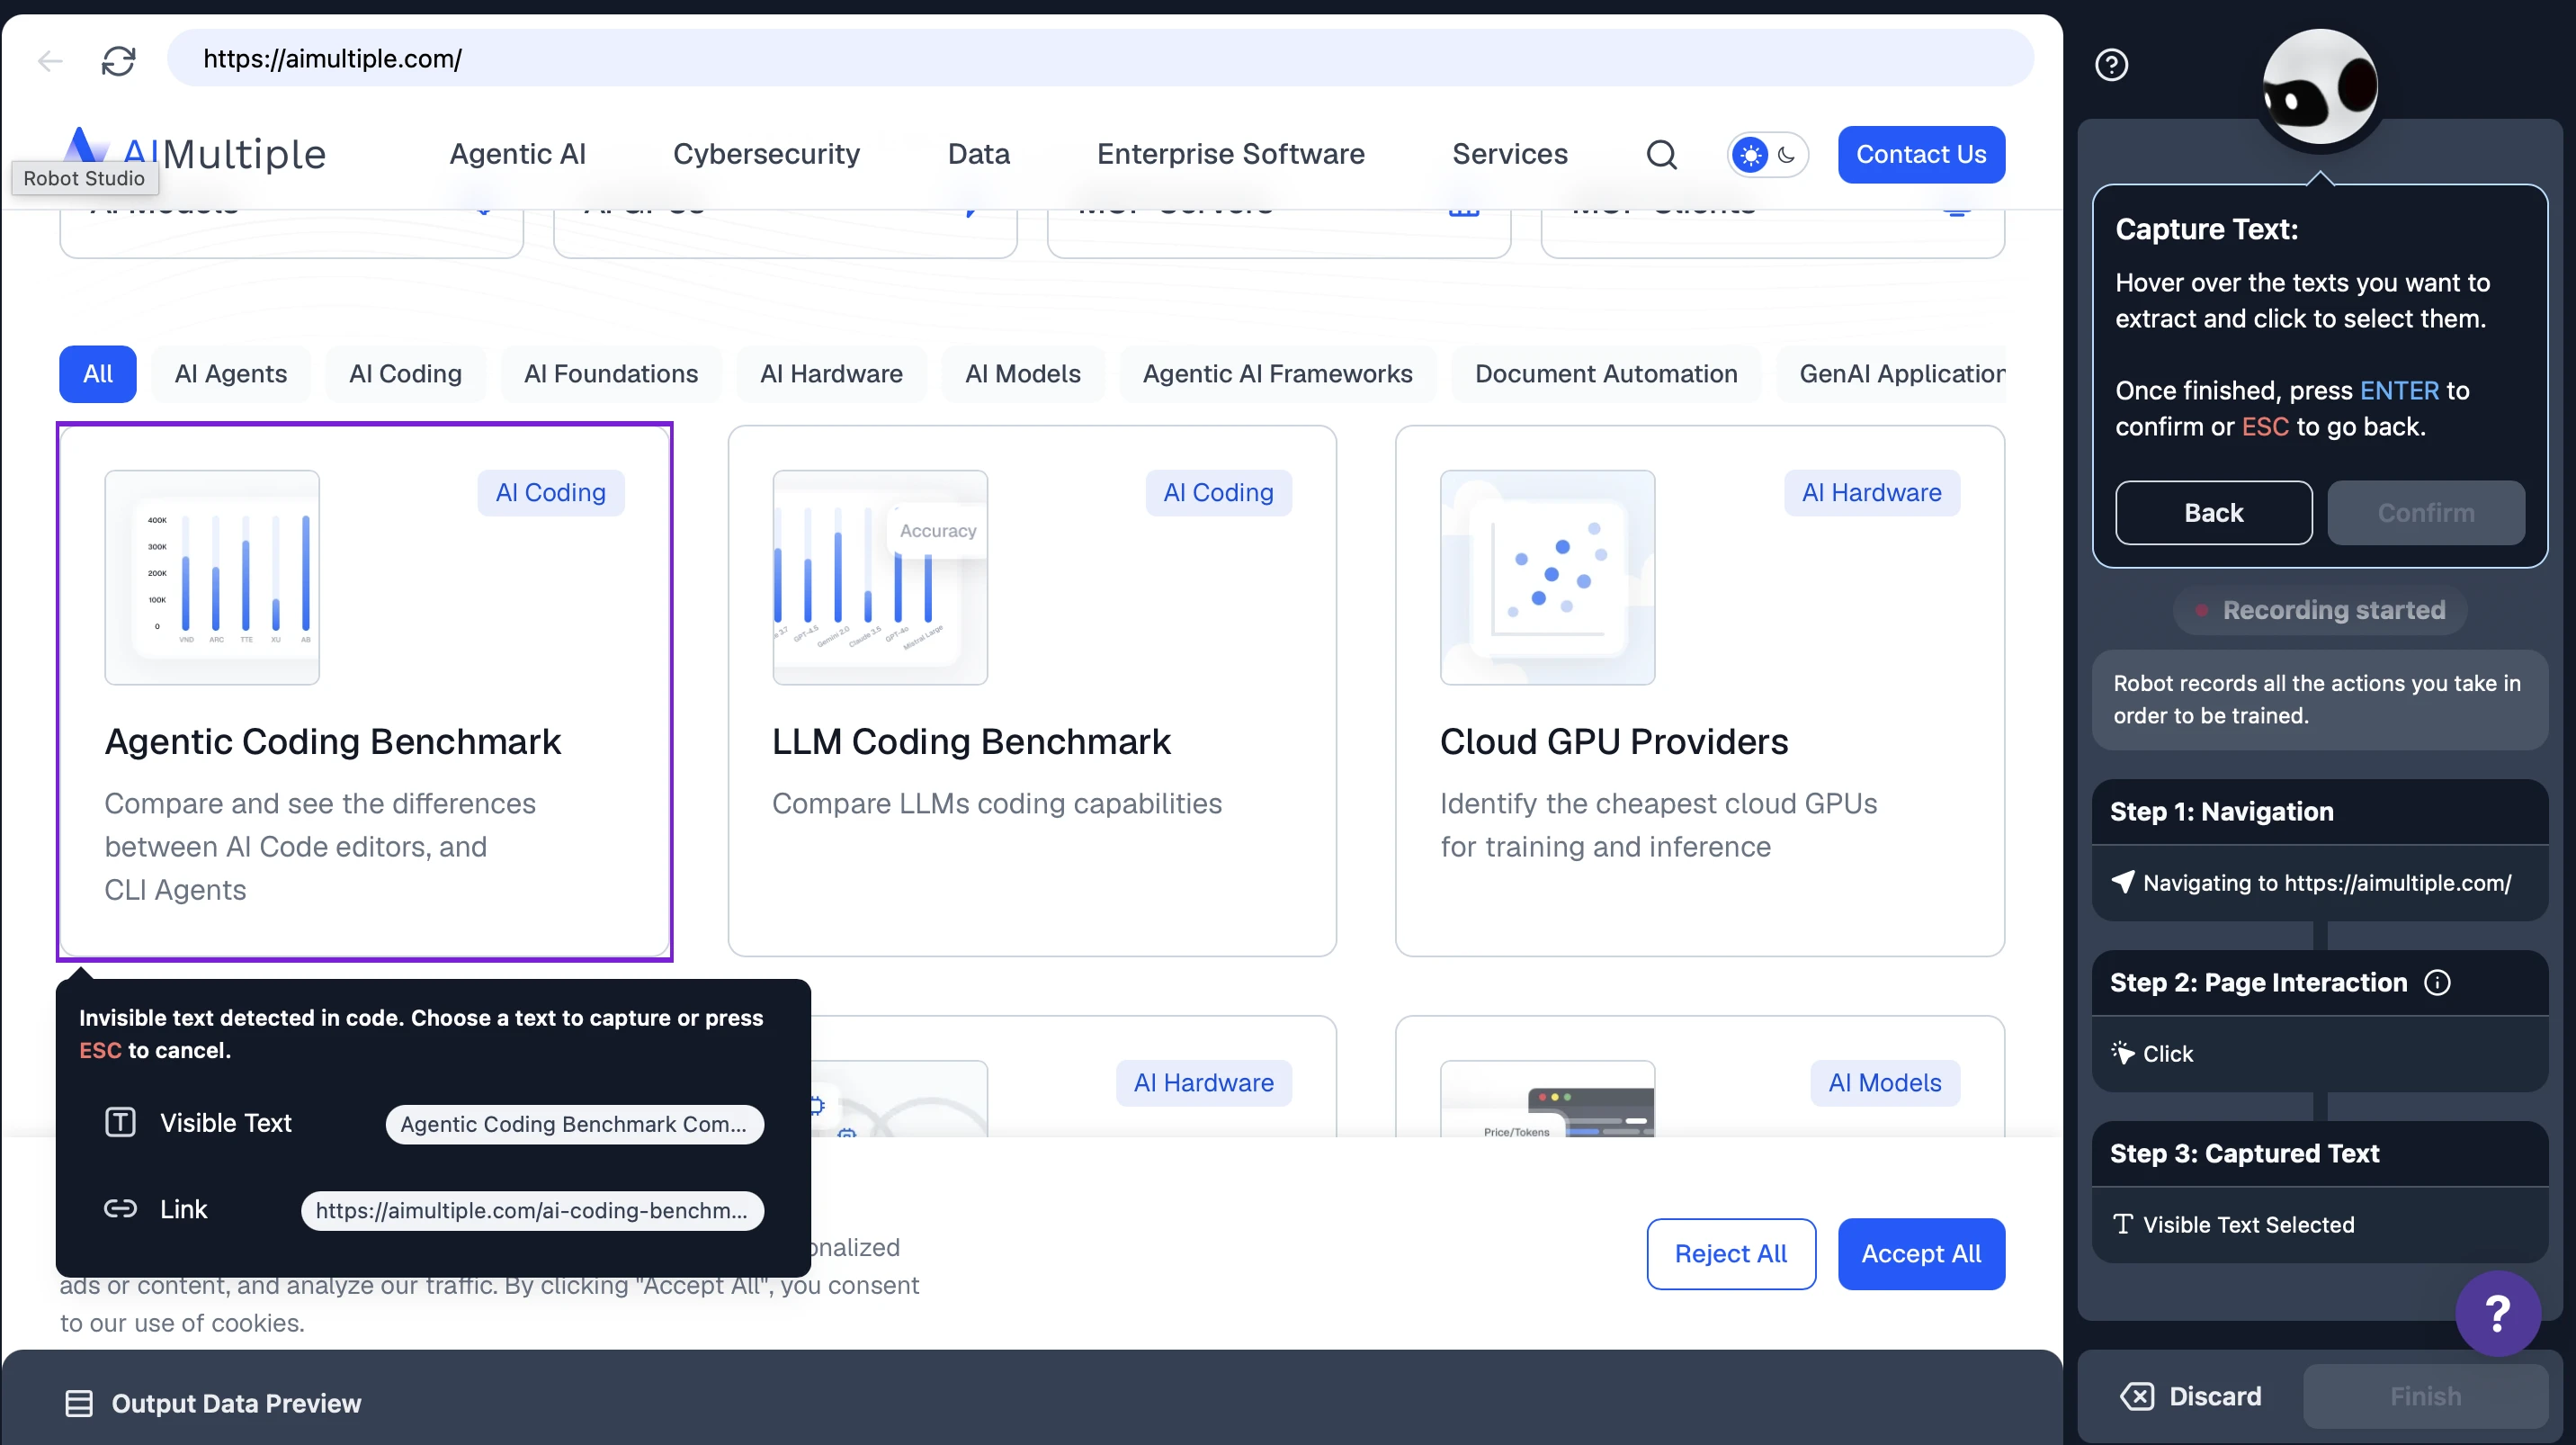
Browse IA costruisce scraper, chiamati robot, da una registrazione visiva. Apri la pagina di destinazione e clicchi sui campi da catturare. Il robot salva i passaggi di navigazione e i campi selezionati come registrazione e la riproduce a ogni esecuzione.
- Configurazione visiva con Robot Studio: Gli scraper vengono costruiti con un flusso clic → cattura campo → salva.
- Monitoraggio e avvisi integrati: Pianificazioni orarie, giornaliere o settimanali, rilevamento dei cambiamenti e avvisi email o webhook nello stesso prodotto.
- Lo schema è formato dai campi catturati: Viene aggiunto un passaggio di cattura separato per ogni campo; nessun prompt-to-schema.
- Adattamento automatico: Il motore di Browse IA adatta il codice di scraping quando un sito cambia, e la maggior parte dei robot continua a funzionare senza intervento. Quando l'adattamento non basta, riaddestri il robot, il che preserva la sua cronologia, le esecuzioni e i flussi di lavoro.
Kadoa costruisce uno scraper, chiamato workflow, da un prompt e lo memorizza come codice generato, così c'è un artefatto concreto da monitorare e riparare.
- Endpoint costruisci-una-volta, chiama-più-volte: Un workflow salvato riceve un ID persistente e viene chiamato con
PUT /v4/workflows/{id}/run. La richiesta trasporta solo variabili e un limite di righe; lo schema e il codice di estrazione restano lato Kadoa. Puntare lo stesso workflow a un URL diverso significa aggiornarne prima i metadati, quindi non è una singola chiamata con un URL al suo interno. - Prompt a schema tipizzato: Descrivi i dati nel prompt di configurazione e Kadoa propone uno schema che modifichi in una vista visuale o JSON. I campi portano tipi come STRING, NUMBER, MONEY, DATE e LINK, e possono essere contrassegnati come chiavi.
- Scraper salvato con auto-riparazione: La riparazione è attivata da un'esecuzione fallita piuttosto che da una pianificazione. Kadoa rigenera il codice di estrazione e lo valida rispetto ai dati estratti in precedenza, sotto lo stesso ID workflow, così pianificazioni e integrazioni continuano a funzionare. Non c'è un passaggio di approvazione prima che la correzione vada in produzione. Quando il ripristino automatico fallisce, un ticket va al team operativo di Kadoa.
- Flusso di lavoro coding-agent: Un server MCP ospitato con 40+ strumenti, più SDK Node e Python di prima parte e una CLI (
kadoa create,kadoa run,kadoa export). - Consegna: API, SDK, CLI, MCP e Google Sheets per il pull; S3, GCS, Azure Blob, webhook, WebSocket, email e Slack per il push; Snowflake e Databricks per la condivisione. I connettori di storage cloud vengono configurati tramite supporto piuttosto che self-service.
API di estrazione IA one-shot
Le API di estrazione IA one-shot non memorizzano alcuno scraper. Ogni chiamata invia un URL con un prompt o uno schema, e lo strumento recupera la pagina ed esegue l'estrazione LLM al momento della richiesta. Oxylabs IA Studio, l'Actor IA Web Scraper di Apify, Firecrawl e ScrapingBee funzionano in questo modo.
Lo Studio di Oxylabs IA è una suite di cinque applicazioni IA separate sotto un unico SDK (pip install oxylabs-ai-studio): AiScraper, AiCrawler, BrowserAgent, AiSearch e AiMap. Nulla viene persistito lato server, ogni chiamata di scraping esegue un fetch nuovo più l'estrazione LLM.
- Flusso AiScraper: generate_schema(prompt=…) chiama opzionalmente il LLM per produrre uno schema JSON, poi scrape(url, schema) recupera la pagina ed esegue l'estrazione LLM. Puoi mantenere e riutilizzare lo schema dalla tua parte, ma il server non registra uno scraper a lunga vita.
- Cinque applicazioni, un SDK: AiScraper per l'estrazione strutturata da singolo URL, AiCrawler per l'attraversamento del sito guidato da prompt, BrowserAgent per le azioni sulla pagina, AiSearch per la ricerca in linguaggio naturale più estrazione, e AiMap per mappe URL filtrate di un sito.
- Formati di output: markdown (predefinito), json, csv, toon (un formato ottimizzato per token), screenshot e html (solo browser agent).
- Schemi scritti a mano:
generate_schemaè opzionale. Il parametroschemaaccetta qualsiasi JSON Schema tu scriva, e gli esempi di Oxylabs passano un modello Pydantic scritto a mano. Uno schema è obbligatorio per l'output JSON, CSV e TOON. - Parametri notevoli: render_javascript=”auto” lascia che il servizio decida se è necessario il rendering JS, geo_location accetta un codice paese ISO o un nome per la posizione del proxy, e max_credits imposta un limite di spesa per richiesta.
Apify offre un ecosistema aperto per sviluppatori dove gli “Actor”, programmi eseguibili di scraping e automazione, vengono costruiti ed eseguiti sulla sua piattaforma. Puoi scrivere il tuo Actor da zero, iniziare da un modello pronto, o usare Actor che altri hanno pubblicato nello Store di Apify.
- Actor di estrazione IA: Apify ha anche un Actor pronto apify/ai-web-scraper che accetta un prompt in linguaggio naturale e restituisce JSON strutturato da qualsiasi URL. Reinserisci il prompt a ogni esecuzione, e l'output JSON non è garantito rimanga coerente tra le chiamate, comportamento comune per gli strumenti guidati da prompt.
- Solo prompt: L'input dell'Actor ha cinque campi:
startUrls,extractionMode,prompt,maxPagesToVisitemaxCrawlDepth. Non c'è un parametro per uno schema di output definito dall'utente. - Costruisci il tuo actor: Se non esiste uno scraper pronto per il tuo sito di destinazione o nessuno di essi estrae i campi dati che desideri, scrivi il tuo Actor e decidi quali campi extract, dove si trovano sulla pagina e come gestire il resto. Quanto tempo richiede dipende dalle tue capacità di programmazione e dalla complessità del sito. Se preferisci non costruirlo da solo, puoi anche ottenere aiuto dai servizi professionali di Apify.
- Combinato con scraper pre-costruiti: lo Store di Apify elenca gli Actor che gli sviluppatori pubblicano. La maggior parte degli scraper per siti popolari sono pubblicati e mantenuti da sviluppatori terzi.
- Servizi della piattaforma: Gli Actor includono pianificazione, monitoraggio, storage dei dataset, pool di proxy e accesso API pronti all'uso.
- Accesso agente: Il server MCP di Apify consente a un coding agent di cercare ed eseguire gli Actor, ma non ha un flusso integrato per costruire o mantenere un Actor dall'interno dell'agente.
- Proprietà della manutenzione: Se hai costruito tu l'Actor, lo ripari quando il sito cambia. Se ne usi uno dallo Store, aspetti che il proprietario dell'Actor rilasci la correzione secondo i suoi tempi.
Firecrawl trasforma un URL più un prompt o uno schema JSON in JSON in una singola chiamata sincrona. Ogni richiesta esegue la pipeline di estrazione nel momento in cui viene effettuata la chiamata.
- Prompt o schema: Uno schema fissa i nomi e i tipi dei campi prima della chiamata, così la risposta contiene solo i campi che hai nominato. Un prompt lascia la struttura al modello, che è più veloce da scrivere ma può variare tra le chiamate.
- Formati per tipo di pagina:
product,menu,branding,audioevideorestituiscono una struttura fissa impostata da Firecrawl.productcopre titolo, prezzo, disponibilità, varianti e prezzo di vendita. Non accettano parametri e vengono eseguiti senza un LLM. deterministicJson: Accetta uno schema e memorizza nella cache un estrattore generato per sito, così gli scraping ripetuti saltano il LLM. Non può essere combinato con il formatojson.- Esecuzione per richiesta: Ogni chiamata porta il proprio prompt o schema e viene eseguita al momento della richiesta, così l'output riflette la pagina come appare in quel momento e non c'è nulla da registrare in anticipo.
- Supporto coding-agent: Server MCP e CLI ufficiali, con guide rapide per Claude Code, Cursor, Codex CLI e Gemini CLI, più un plugin ufficiale per Claude.
- Agent: Firecrawl offre anche un prodotto Agent in cui l'URL è opzionale. Descrivi cosa vuoi e l'agente naviga nel web per trovarlo.
ScrapingBee è un'API di estrazione one-shot come Firecrawl: ogni chiamata è indipendente e non memorizza nulla. ScrapingBee si differenzia per come descrivi i dati che desideri.
- Tre modalità di estrazione: ai_query per un singolo campo in linguaggio naturale (restituisce una stringa), ai_extract_rules per uno schema JSON in cui ogni campo ha la propria descrizione, e una forma avanzata dello stesso con tipi, enum e output annidati.
- ai_selector: Passa un selettore CSS per focalizzare il LLM su una parte specifica della pagina. Più veloce e più accurato che lasciargli leggere l'intero DOM.
- Scraping classico nella stessa chiamata: render_js per siti con molto JS, screenshot, extract_rules per estrazione CSS/XPath senza IA, e json_response per ottenere HTML, cookie, XHR e iframe in un unico pacchetto.
Come scegliere lo strumento giusto per la tua pipeline?
Lo strumento giusto dipende da quanto spesso la tua pipeline raschia gli stessi siti e da chi mantiene lo scraper:
Scraping una tantum o occasionale
Per lo scraping una tantum o occasionale, le API di estrazione IA one-shot come Firecrawl, ScrapingBee e Oxylabs IA Studio sono l'opzione più veloce. Invia un prompt o uno schema con ogni chiamata, e non c'è alcuno scraper da costruire.
Scraping ripetuto in una pipeline
Per lo scraping ripetuto, o quando hai bisogno di campi dati personalizzati, una piattaforma costruisci-una-volta, chiama-più-volte come Bright Data Scraper Studio, Browse IA o Kadoa si adatta meglio. Lo scraper memorizzato restituisce lo stesso schema a ogni chiamata, e la tua pipeline passa solo URL.
Quanto dura la configurazione
Il tempo di costruzione varia a seconda dell'approccio. Scrivere uno scraper o un actor da zero richiede in genere da giorni a settimane, poiché il crawler, il cablaggio dei proxy e i tentativi sono a carico tuo. Le piattaforme basate su prompt generano lo schema e il codice in minuti. Anche gli strumenti basati su registrazione arrivano in minuti, con una configurazione point-and-click invece di un prompt. Le API di estrazione IA one-shot saltano il passaggio di costruzione; la prima risposta arriva in una singola chiamata HTTP.
Sito già coperto da uno scraper pronto
Uno scraper pronto per un sito popolare è di solito più veloce che costruirne uno proprio, ma chi lo mantiene funzionante dipende da dove proviene. Una libreria mantenuta dal fornitore, come quella di Bright Data, viene aggiornata dal fornitore quando il sito cambia. Uno scraper di terze parti, come la maggior parte degli Actor di siti popolari nello Store di Apify, viene corretto secondo i tempi del suo proprietario.
Sito non coperto da nulla di pronto
Per i siti senza uno scraper pronto, la domanda è chi ripara lo scraper quando il layout cambia. Se lo costruisci tu, lo mantieni tu. Con uno strumento basato su registrazione come Browse IA, il robot si adatta da solo alla maggior parte dei cambiamenti, e lo riaddestri quando non può. Con l'auto-riparazione IA, lo strumento ripara il tuo scraper memorizzato sotto lo stesso ID: Bright Data mostra la correzione per la tua approvazione prima che vada in produzione, mentre Kadoa la applica automaticamente.
Costruire con coding agent
Se il tuo flusso di lavoro passa attraverso Claude Code, Cursor o Codex, importa se lo strumento espone una CLI o un'integrazione MCP che l'agente può pilotare end-to-end, oppure se l'agente può solo chiamare una semplice HTTP API.
 Aggiungi come fonte preferita
Metodologia del benchmark di web scraping IA
Domini del benchmark:
I dieci domini nel benchmark di web scraping IA provengono dalla classifica di Semrush dei siti più visitati. Cinque sono e-commerce (amazon, ebay, etsy, aliexpress, walmart) e cinque sono social (facebook, instagram, reddit, tiktok, x). Abbiamo raccolto 500 URL da ciascuno, 5.000 in totale, e li abbiamo inviati tutti a tutti e cinque gli strumenti, il che equivale a 25.000 richieste.
Prompt:
Ogni strumento ha ricevuto esattamente lo stesso prompt per un dato tipo di pagina, senza alcuna ottimizzazione specifica per lo strumento:
- E-commerce: Extract prezzo e valuta del prodotto e restituisci json
- Social: Extract il testo del post, il numero di Mi piace e il nome utente dell'autore del post e restituisci json
Bright Data porta il prompt un passo prima rispetto agli altri. Invece di fare scraping da un prompt a ogni chiamata, gli dai il prompt una volta e lui costruisce uno scraper, restituendo un ID collector che poi chiami ripetutamente. Quel passaggio di costruzione non è scraping, è lo strumento che genera un'API, e avviene una volta per dominio prima che inizi qualsiasi benchmarking, quindi non è incluso nei tempi. Abbiamo misurato dall'ID collector in poi, dove il processo corrisponde agli altri quattro. Per mantenerlo zero shot, lo schema generato da Bright Data è stato accettato automaticamente così come è tornato dall'API, senza revisione e senza correzione.
Ogni strumento è stato chiamato nel modo in cui è costruita la sua API. Bright Data, Apify e Firecrawl sono progettati per accettare una lista di URL in una richiesta, quindi abbiamo inviato 100 URL per richiesta. Oxylabs e ScrapingBee non sono costruiti in quel modo, le loro API accettano un URL alla volta, quindi è così che li abbiamo chiamati. La concorrenza era la stessa per ogni strumento, cinque richieste parallele.
Metriche:
Il successo è la quota di richieste che sono tornate con almeno uno dei campi richiesti. Le stringhe vuote, gli zeri al posto di un numero e le risposte che ripetono il prompt non contano come campo.
La completezza è quanti dei campi richiesti sono tornati, mediata sulle richieste. Una pagina social in cui arriva solo l'autore ottiene un punto su tre.
L'accuratezza è la quota di valori verificabili che erano corretti. Un campo che lo strumento non ha mai restituito conta come errato, perché a valle un valore mancante e un valore errato costano lo stesso.
Ogni misura viene calcolata per dominio, poi mediata sui dieci.
Stabilire la risposta corretta
Abbiamo usato due metodi. Dove era disponibile la verità di base, abbiamo valutato rispetto ad essa: alcune risposte si trovano nell'URL stesso, come l'handle dell'autore in un link x.com o tiktok.com, e per altre abbiamo raccolto un riferimento indipendente al di fuori dei cinque strumenti, come i prezzi dei prodotti e i conteggi dei voti di Reddit.
Dove non esisteva una verità di base, abbiamo valutato per consenso. Un campo viene risolto in questo modo solo quando almeno quattro dei cinque strumenti hanno risposto. Poi mettiamo da parte lo strumento in valutazione e guardiamo il resto: se lo stesso valore appare in più della metà di essi, e in almeno due, quel valore diventa il riferimento. Uno strumento non vota mai sulla propria risposta, e un campo su cui gli altri non riuscivano a concordare viene lasciato fuori dal punteggio di accuratezza.
I numeri non devono corrispondere esattamente. Un valore conta come corretto entro il 10% dal riferimento, con un piccolo margine assoluto in aggiunta, così un post con 5 Mi piace non fallisce per una differenza di uno, mentre un post con 90.000 viene ancora giudicato sulla percentuale.
Intervalli di confidenza
Tutte le cifre portano intervalli di confidenza del 95% da 10.000 ricampionamenti bootstrap a livello di URL. I dati per richiesta dietro ogni numero sono pubblicati con i risultati.
FAQ
Sì. Le librerie open-source come Crawl4AI, Skyvern e Browser Use sono gratuito da self-hostare, e la maggior parte degli strumenti commerciali, tra cui Browse IA, Firecrawl e Thunderbit, offrono un livello gratuito con limiti di utilizzo.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Migliori strumenti IA di web scraping messi a benchmark}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Consultato il 2 ottobre 2026}
}Risultati e timestamp di 25.1 mila punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 7 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
5 aggiornamentiAggiunta una sezione di benchmark che confronta gli strumenti di web scraping AI sui principali siti e-commerce.
Sostituito l'elenco degli strumenti con voci dedicate a Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern e altri, e aggiunta una sezione FAQ.
Sostituita l'introduzione agli strumenti di web scraping AI con una descrizione degli agenti AI autonomi, dello scraping basato sulla visione (VLM) e degli scraper auto-riparanti.
Prossimo da leggere
Le 5 Migliori Estensioni Chrome Gratuite per il Web Scraping

Il web scraping è legale? Leggi e migliori pratiche
Web Scraping su Larga Scala: 7 Fornitori Confrontati


Migliori librerie Python per il web scraping
Abbiamo confrontato i migliori strumenti di web scraping
Web Scraping per Reclutatori: I Migliori Strumenti e Tecniche





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.