


Qualità dei dati nell'IA: sfide e best practice

Una scarsa qualità dei dati ritarda il successo dell'implementazione dei progetti di IA e ML. 1 Anche gli algoritmi di intelligenza artificiale più avanzati possono produrre risultati errati se i dati sottostanti sono di bassa qualità.
Esplora l'importanza della qualità dei dati nell'IA, le sfide che le organizzazioni incontrano e le best practice per garantire dati di alta qualità:
Qual è l'importanza della qualità dei dati nell'IA?
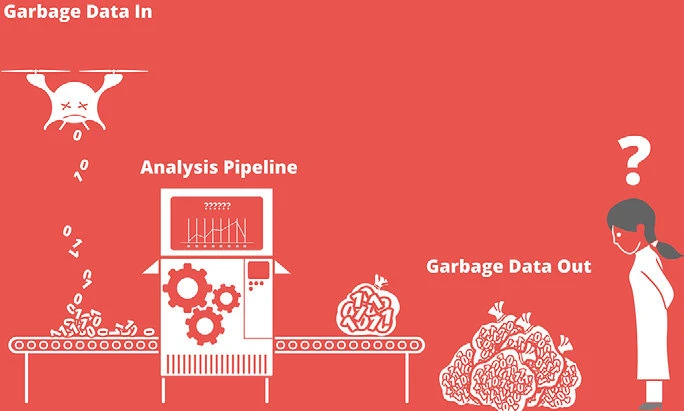
La qualità dei dati è essenziale per l'intelligenza artificiale, poiché influenza direttamente le prestazioni, l'accuratezza e l'affidabilità dei modelli di IA. Dati di alta qualità consentono ai modelli di fare previsioni migliori e produrre risultati più affidabili. L'impatto della scarsa qualità dei dati nell'IA è illustrato nella Figura 1.
Figura 1: Impatto della scarsa qualità dei dati e dell'analisi
Fonte: SnapLogic2
Affrontare i bias nei dati è fondamentale per garantire la qualità dei dati. Ciò evita il perpetuarsi e l'amplificarsi dei bias negli output generati dall'IA, contribuendo a ridurre al minimo il trattamento ingiusto di gruppi o individui specifici.
Inoltre, un dataset diversificato e rappresentativo migliora la capacità di un modello di IA di generalizzare bene in diverse situazioni e con diversi input, garantendo prestazioni e rilevanza in vari contesti e gruppi di utenti.
Come afferma Andrew Ng, professore di IA presso la Stanford University e fondatore di DeepLearning.IA: “Se l'80 percento del nostro lavoro è la preparazione dei dati, garantire la qualità dei dati è il compito più critico per un team di machine learning.”
Perché evitare il problema del “garbage in, garbage out” è cruciale per la qualità dei dati?
“Garbage in, garbage out” (GIGO) è un principio semplice ma efficace che sottolinea l'importanza della qualità dei dati in ingresso. Significa che se i dati immessi in un sistema, come un modello o un algoritmo di IA, sono di scarsa qualità, inaccurati o irrilevanti, anche l'output del sistema sarà di scarsa qualità, inaccurato o irrilevante.
Figura 2: Qualità e standard dei dati: dati “garbage in”, risultati “garbage out”.
Fonte: Shakoor et al. 3
Questo concetto è particolarmente significativo nel contesto dell'IA, poiché i modelli di IA, inclusi i modelli di machine learning e deep learning, dipendono fortemente dai dati utilizzati per l'addestramento e la validazione. Il modello di IA produrrà probabilmente risultati inaffidabili o distorti se i dati di addestramento sono distorti, incompleti o contengono errori.
Per evitare il problema GIGO, è fondamentale garantire che i dati utilizzati nei sistemi di IA siano accurati, rappresentativi e di alta qualità. Ciò spesso comporta pulizia dei dati, preelaborazione e augmentation, insieme all'uso di metriche di valutazione robuste per valutare le prestazioni del modello di IA.
Quali sono le componenti chiave della qualità dei dati nell'IA?
Accuratezza: Dati accurati sono fondamentali per gli algoritmi di IA, perché consentono di produrre risultati corretti e affidabili. Gli errori nei dati in ingresso possono portare a decisioni errate o insight fuorvianti, con potenziali danni per organizzazioni e individui.
Coerenza: Garantisce che i dati seguano un formato e una struttura standard, facilitando un'elaborazione e un'analisi efficienti. Dati incoerenti possono causare confusione e interpretazioni errate, compromettendo le prestazioni dei sistemi di IA.
Completezza: Dataset incompleti possono far sì che gli algoritmi di IA non colgano pattern e correlazioni essenziali, portando a risultati incompleti o distorti. Garantire la completezza dei dati è fondamentale per addestrare i modelli di IA in modo accurato e completo.
Tempestività: La freschezza dei dati gioca un ruolo significativo nelle prestazioni dell'IA. Dati obsoleti potrebbero non riflettere l'ambiente o le tendenze attuali, portando a output irrilevanti o fuorvianti.
Rilevanza: I dati rilevanti contribuiscono direttamente al problema in esame, aiutando i sistemi di IA a concentrarsi sulle variabili e sulle relazioni più importanti. I dati irrilevanti possono appesantire i modelli e causare inefficienze.
Quali sono le sfide nel garantire la qualità dei dati nell'IA?
1-Raccolta dei dati
Poiché gli sviluppi nell'IA portano benefici a settori come finanza, sanità, manifattura e intrattenimento, le organizzazioni affrontano la sfida di raccogliere dati da varie fonti mantenendone la qualità. Molte si affidano ai web scraper per automatizzare e garantire che tutti i dati seguano gli stessi standard.
2-Etichettatura dei dati
Gli algoritmi di IA si affidano a dati etichettati per l'addestramento, ma l'etichettatura manuale è sia lunga sia soggetta a errori. Ottenere etichette accurate che riflettano le condizioni del mondo reale è spesso difficile.
3-Archiviazione e sicurezza dei dati
Garantire la qualità dei dati implica proteggerli da accessi non autorizzati e da potenziali alterazioni. È essenziale che le organizzazioni dispongano di un'archiviazione dei dati sicura e affidabile, ma ciò può essere difficile.
4-Governance dei dati
Le organizzazioni spesso incontrano difficoltà nell'implementare framework di governance dei dati che affrontino efficacemente i problemi di qualità dei dati. La mancanza di una governance dei dati adeguata può portare a dati isolati, incoerenze ed errori.
5-Avvelenamento dei dati
L'avvelenamento dei dati è un attacco mirato ai sistemi di IA in cui gli aggressori introducono informazioni dannose o fuorvianti nel dataset. Questi dati avvelenati possono distorcere l'addestramento del modello, portando a risultati inaffidabili o persino dannosi. Per mitigare questo rischio, è fondamentale mantenere l'integrità dei dati tramite audit regolari e rilevamento delle anomalie.
6-Cicli di feedback dei dati sintetici
Reinserire dati generati dall'IA nei modelli di IA può creare cicli di feedback che degradano la qualità del modello. Ad esempio, quando i dati sintetici vengono utilizzati ripetutamente, il modello potrebbe apprendere pattern troppo artificiali e divergere dalle condizioni del mondo reale. Ciò può far sì che i modelli ottengano prestazioni scadenti sui dati reali, amplificando potenzialmente bias o errori. Bilanciare dati sintetici e reali è essenziale per mantenere la robustezza del modello.
Casi di studio reali
Caso di studio 1: Mayo Clinic – La gestione dei dati prima dell'IA
La Mayo Clinic, con circa 76.000 dipendenti in tre campus, considera la prontezza dei dati il primo passo di qualsiasi progetto di IA.4
La sfida: La responsabilità dei dati è distribuita tra molte unità cliniche e aziendali. Il chief data and analytics officer Ajai Sehgal afferma che quando nessuno è responsabile della gestione dei dati, i problemi relativi ai dati sono inevitabili, e l'IA in ambito sanitario non può permettersi output di bassa qualità.
La soluzione: Mayo ha reso i team clinici e aziendali che conoscono meglio i dati i loro steward, responsabili di preparare i dati per l'analisi. Un team centrale mantiene una libreria di dati che collega ogni elemento di dato ai relativi metadati e alle regole cliniche associate. La pratica chirurgica di Mayo, ad esempio, sta avviando il proprio lavoro di IA preparando i dati e ha proposto un team di dati e analytics autofinanziato.
Caso di studio 2: JPMorgan Chase – Rilevamento delle frodi su dati interni verificati
JPMorgan Chase utilizza modelli linguistici di grandi dimensioni per rilevare frodi come la compromissione delle email aziendali.5
La sfida: Ryan Schmiedl, che dirige il rilevamento delle frodi, lo screening delle sanzioni e i controlli know-your-customer della banca, ha avvertito nel 2023 che i modelli addestrati su dati provenienti da tutta Internet, come ChatGPT, possono presentare affermazioni non verificate come fatti.
La soluzione: La banca addestra i suoi LLMs solo su dati provenienti dal proprio ecosistema e prima si assicura che tali dati siano stati verificati e convalidati. Utilizza inoltre l'IA per extract i nomi di aziende e persone da dati non strutturati e analizzarli per il rischio di frode.
Caso di studio 3: Walmart – Pulizia dei dati del catalogo prodotti con LLMs
Walmart ha utilizzato l'IA generativa per migliorare i dati del catalogo prodotti alla base delle sue pagine di ricerca e dei prodotti.6
La sfida: Mantenere i dati del catalogo completi e accurati su scala Walmart è laborioso. Il CEO Doug McMillon ha affermato che senza l'IA generativa, il lavoro avrebbe richiesto “quasi 100 volte l'organico attuale”.
La soluzione: Walmart ha utilizzato più modelli linguistici di grandi dimensioni per creare o migliorare oltre 850 milioni di elementi di dati del catalogo, ha detto McMillon nella conference call sugli utili del 15 agosto 2024. Il CEO di Walmart U.S., John Furner, ha affermato che il miglioramento dei dati aiuta l'azienda ad allineare il catalogo a ciò che i clienti cercano.
Best practice per garantire la qualità dei dati nell'IA
1-Implementare policy di governance dei dati
Un framework di governance dei dati dovrebbe definire standard, processi e ruoli per la qualità dei dati. Ciò contribuirà a creare una cultura della qualità dei dati e a garantire che le pratiche di gestione dei dati siano allineate agli obiettivi organizzativi.
Esempio reale: Airbnb
Airbnb ha lanciato la “Data University” per migliorare l'alfabetizzazione sui dati in tutta la sua forza lavoro, offrendo corsi personalizzati che integrano dati e strumenti specifici di Airbnb. Dal suo avvio nel Q3 2016, la Data University ha aumentato il coinvolgimento con gli strumenti interni di data science di Airbnb, portando gli utenti attivi settimanali dal 30% al 45%.
Con oltre 500 dipendenti partecipanti, l'iniziativa sottolinea l'importanza di allineare gli sforzi di governance dei dati con gli obiettivi organizzativi, promuovendo una cultura aziendale della qualità dei dati e di decisioni informate. Il programma esemplifica come framework di governance dei dati personalizzati possano sviluppare competenze sui dati e favorire l'allineamento con gli obiettivi di business.
2-Utilizzare strumenti per la qualità dei dati
Gli strumenti per la qualità dei dati possono automatizzare i processi di pulizia, convalida e monitoraggio dei dati, garantendo ai modelli di IA un accesso costante a dati di alta qualità.
Esempio reale: General Electric
Un esempio reale e pertinente di utilizzo di strumenti per la qualità dei dati è l'implementazione da parte di General Electric (GE) della propria strategia di governance dei dati e gestione della qualità, in particolare all'interno della sua piattaforma Predix per l'analisi dei dati industriali. Per supportare la trasformazione digitale e le iniziative di IA, GE ha investito in un solido set di strumenti per la qualità dei dati al fine di mantenere standard elevati sui dati in tutto il suo ecosistema IoT industriale.
GE ha implementato strumenti automatizzati per la pulizia, la convalida e il monitoraggio continuo dei dati per gestire gli enormi volumi di dati generati dalle sue apparecchiature industriali, come turbine e motori a reazione. Questi strumenti hanno aiutato GE a garantire che i dati che alimentano i suoi modelli di IA fossero accurati, coerenti e affidabili, riducendo la necessità di interventi manuali e consentendo insight in tempo reale basati sui dati.
Esempi di soluzioni per la qualità dei dati
Pandada IA, lanciata all'inizio del 2026, è una piattaforma basata sull'IA per la pulizia e l'analisi automatizzata dei dati. Può importare file di dati (CSV, fogli di calcolo Excel, PDF e persino immagini) e generare report e presentazioni analitiche strutturate e condivisibili.7 La piattaforma include funzionalità intelligenti di pulizia dei dati (rimozione dei duplicati, standardizzazione del formato, rilevamento dei valori mancanti) che correggono automaticamente i problemi nei dati, riducendo il lavoro manuale di preparazione dei dati.8
Sieve è una piattaforma di pulizia dei dati di una startup di Y Combinator della primavera 2025 che combina l'elaborazione basata sull'IA con una revisione umana opzionale.9 Fornisce un'API e un add-in per Excel per la pulizia automatizzata dei dati, instradando automaticamente eventuali problemi segnalati agli operatori umani per la convalida.9
3-Creare un team per la qualità dei dati
Creare un team dedicato responsabile della qualità dei dati garantirà un monitoraggio e un miglioramento continui dei processi relativi ai dati. Il team può anche formare e sensibilizzare gli altri dipendenti sull'importanza della qualità dei dati.
4-Collaborare con i fornitori di dati
Stabilire relazioni solide con i fornitori di dati e garantire il loro impegno verso la qualità dei dati può ridurre al minimo il rischio di ricevere dati di bassa qualità.
5-Monitorare continuamente le metriche della qualità dei dati
Misurare e monitorare regolarmente le metriche della qualità dei dati può aiutare le organizzazioni a identificare e affrontare potenziali problemi prima che incidano sulle prestazioni dell'IA.
 Aggiungi come fonte preferita
Cosa sono i dati IA?
I dati IA si riferiscono in senso ampio a qualsiasi dato utilizzato nello sviluppo o nel funzionamento dei sistemi di intelligenza artificiale. Di conseguenza, includono, a titolo esemplificativo ma non esaustivo, i dataset usati per addestrare i modelli, i dati di input in tempo reale usati per le previsioni e i dati sintetici generati per arricchire gli esempi del mondo reale, tra gli altri. Pur non essendo un termine tecnico formale, “IA data” è comunemente usato per descrivere le informazioni che alimentano i sistemi di machine learning e deep learning.
FAQ
Secondo una ricerca di Gartner, la scarsa qualità dei dati costa alle organizzazioni in media 12.9 milioni di dollari all'anno. Tuttavia, il costo reale va oltre l'impatto finanziario diretto. La scarsa qualità dei dati porta a progetti di IA fallita; i report di settore suggeriscono che fino all'85% dei progetti di IA e ML non riesce a mantenere le promesse iniziali, spesso a causa di problemi di qualità dei dati. I costi aggiuntivi includono tempo sprecato, poiché i data scientist trascorrono dal 60-80% del loro tempo nella pulizia dei dati anziché nello sviluppo dei modelli, opportunità di ricavi perse a causa di previsioni inesatte e di esperienze cliente scadenti, e rischi di conformità, in particolare nei settori regolamentati in cui i problemi di qualità dei dati possono comportare sanzioni significative.
La ricerca di fonti del settore indica che il 70-85% dei fallimenti dei progetti di IA è dovuto a problemi legati ai dati, con la qualità dei dati come principale colpevole. L'analisi delle implementazioni di IA di VentureBeat ha rilevato che l'87% dei progetti di data science non arriva mai in produzione, con dati inadeguati o di scarsa qualità come causa principale. Un sondaggio di Dimensional Research ha rivelato che il 96% delle organizzazioni incontra problemi di qualità dei dati durante l'addestramento dei modelli di IA. Questi fallimenti si manifestano in vari modi, tra cui modelli che funzionano bene nei test ma falliscono in produzione a causa della deriva dei dati, risultati distorti derivanti da dati di addestramento non rappresentativi e l'incapacità di scalare perché le pipeline di dati non riescono a mantenere la qualità ai volumi di produzione.
Sebbene strettamente correlate, la qualità dei dati e la governance dei dati hanno scopi diversi. La qualità dei dati si riferisce alle caratteristiche dei dati stessi, concentrandosi sull'accuratezza, completezza, coerenza, tempestività e rilevanza dei dati. Riguarda la condizione e l'usabilità dei dati per lo scopo previsto. La qualità dei dati è generalmente misurata tramite metriche come tassi di errore, percentuali di completezza e conteggi di duplicati.
La governance dei dati, d'altra parte, è il framework di policy, procedure, ruoli e responsabilità che garantisce una corretta gestione dei dati in un'organizzazione. La governance definisce chi possiede i dati, chi può accedervi, come devono essere utilizzati, quali standard devono rispettare e come deve essere mantenuta la qualità.
Pensa alla governance dei dati come alla struttura organizzativa e al regolamento, mentre la qualità dei dati è il risultato che si cerca di ottenere. Una buona governance favorisce una buona qualità, ma servono entrambe per avere successo nelle iniziative di IA. La governance fornisce la struttura sostenibile che garantisce che la qualità dei dati non sia una pulizia una tantum, ma una pratica continua.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Qualità dei dati nell'IA: sfide e best practice}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/data-quality-ai}},
  note   = {AIMultiple. Consultato il 23 ottobre 2026}
}
Registro delle modifiche
6 aggiornamentiAggiunti Pandada AI e Sieve alla sezione "Esempi di soluzioni per la qualità dei dati".
Aggiunta la sezione FAQ.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.





Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.