


Il futuro dei modelli linguistici di grandi dimensioni

Scopri il futuro dei modelli linguistici di grandi dimensioni confrontando approcci, come l'auto-addestramento, la verifica dei fatti e l'expertise sparsa, che potrebbero affrontare i limiti degli LLM.
Tendenze future dei modelli linguistici di grandi dimensioni
1- Verifica dei fatti in tempo reale con dati live
Gli LLM accedono a fonti esterne durante le conversazioni invece di affidarsi ai dati di addestramento. Il modello interroga database esterni, recupera informazioni aggiornate e fornisce citazioni.
Limite: Commette ancora errori. Le citazioni non garantiscono l'accuratezza; i modelli a volte citano le fonti in modo errato o interpretano male i contenuti citati.
Microsoft Copilot: Microsoft e OpenAI hanno annunciato che GPT-6 Astra è disponibile in Copilot Cowork e Copilot Studio, oltre che in Microsoft Foundry e GitHub Copilot. L'agente Researcher combina GPT per la ricerca iniziale con la revisione degli output da parte di Anthropic Claude per l'accuratezza e la qualità delle citazioni prima della consegna, un miglioramento del 13,8% sul benchmark di ricerca approfondita DRACO rispetto ai sistemi autonomi.1
- ChatGPT: Effettua ricerche sul web quando gli vengono chieste informazioni su eventi recenti. Cita le fonti nelle risposte.
- Perplexity: Creato appositamente per la ricerca con citazioni. Ogni risposta include link alle fonti.
2- Sintetici dati di addestramento
I modelli generano i propri dataset di addestramento invece di richiedere dati etichettati da esseri umani.
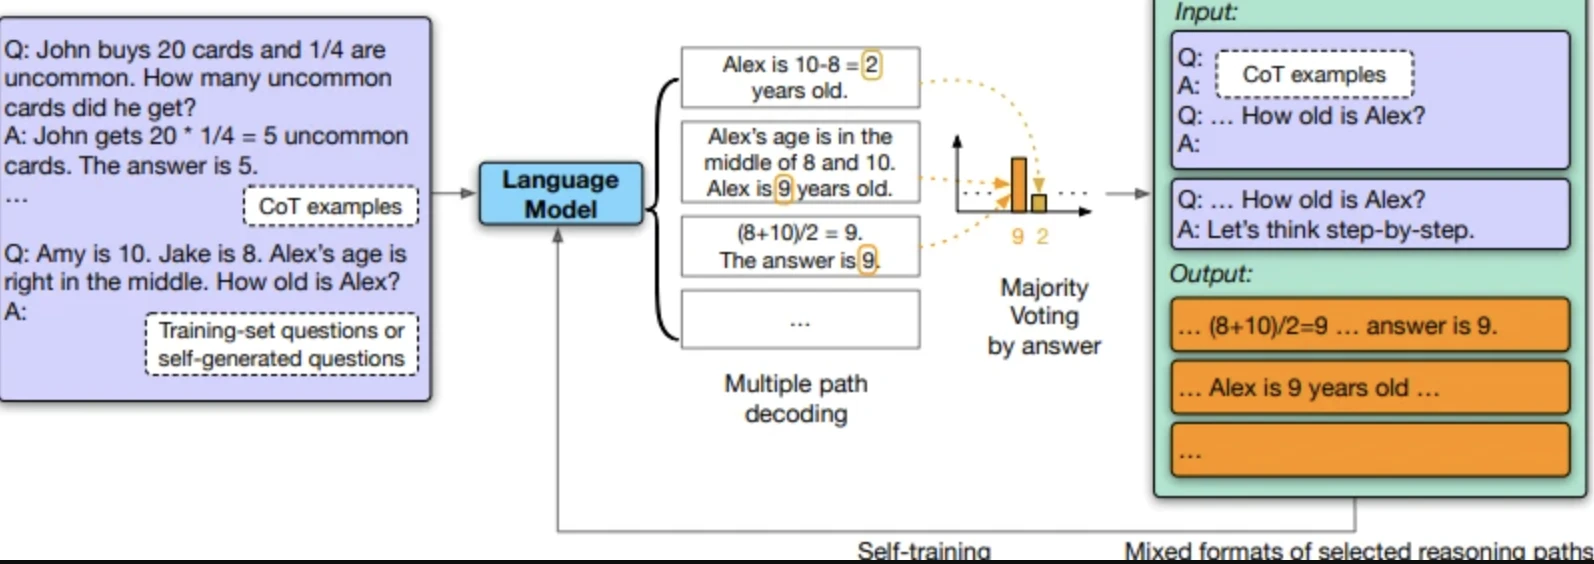
Il modello auto-migliorante di Google (ricerca del 2023):
- Il modello crea domande
- Seleziona le risposte
- Effettua il fine-tuning sui dati generati
Prestazioni migliorate: dal 74,2% al 82,1% nei problemi matematici GSM8K, dal 78,2% al 83,0% nella comprensione della lettura DROP.
OpenAI, Anthropic e Google stanno tutte usando dati sintetici per integrare i dataset etichettati da esseri umani. Questo riduce i costi di etichettatura dei dati ma introduce nuovi rischi di bias; i modelli possono amplificare i propri errori.
Fonte: “Large Language Models Can Self-Improve”
Un sondaggio di marzo 2026 ha rilevato che il 76% dei ricercatori di IA ritiene che i guadagni derivanti dall'aumento di potenza di calcolo e dati abbiano raggiunto un plateau, con i principali laboratori che segnalano rendimenti decrescenti nonostante investimenti massicci. Il risultato suggerisce che il prossimo salto nelle capacità degli LLM derivi più probabilmente dall'innovazione architettonica, come una migliore efficienza di addestramento, architetture sparse o miglioramenti del ragionamento, piuttosto che dall'ulteriore potenziamento degli approcci esistenti.2
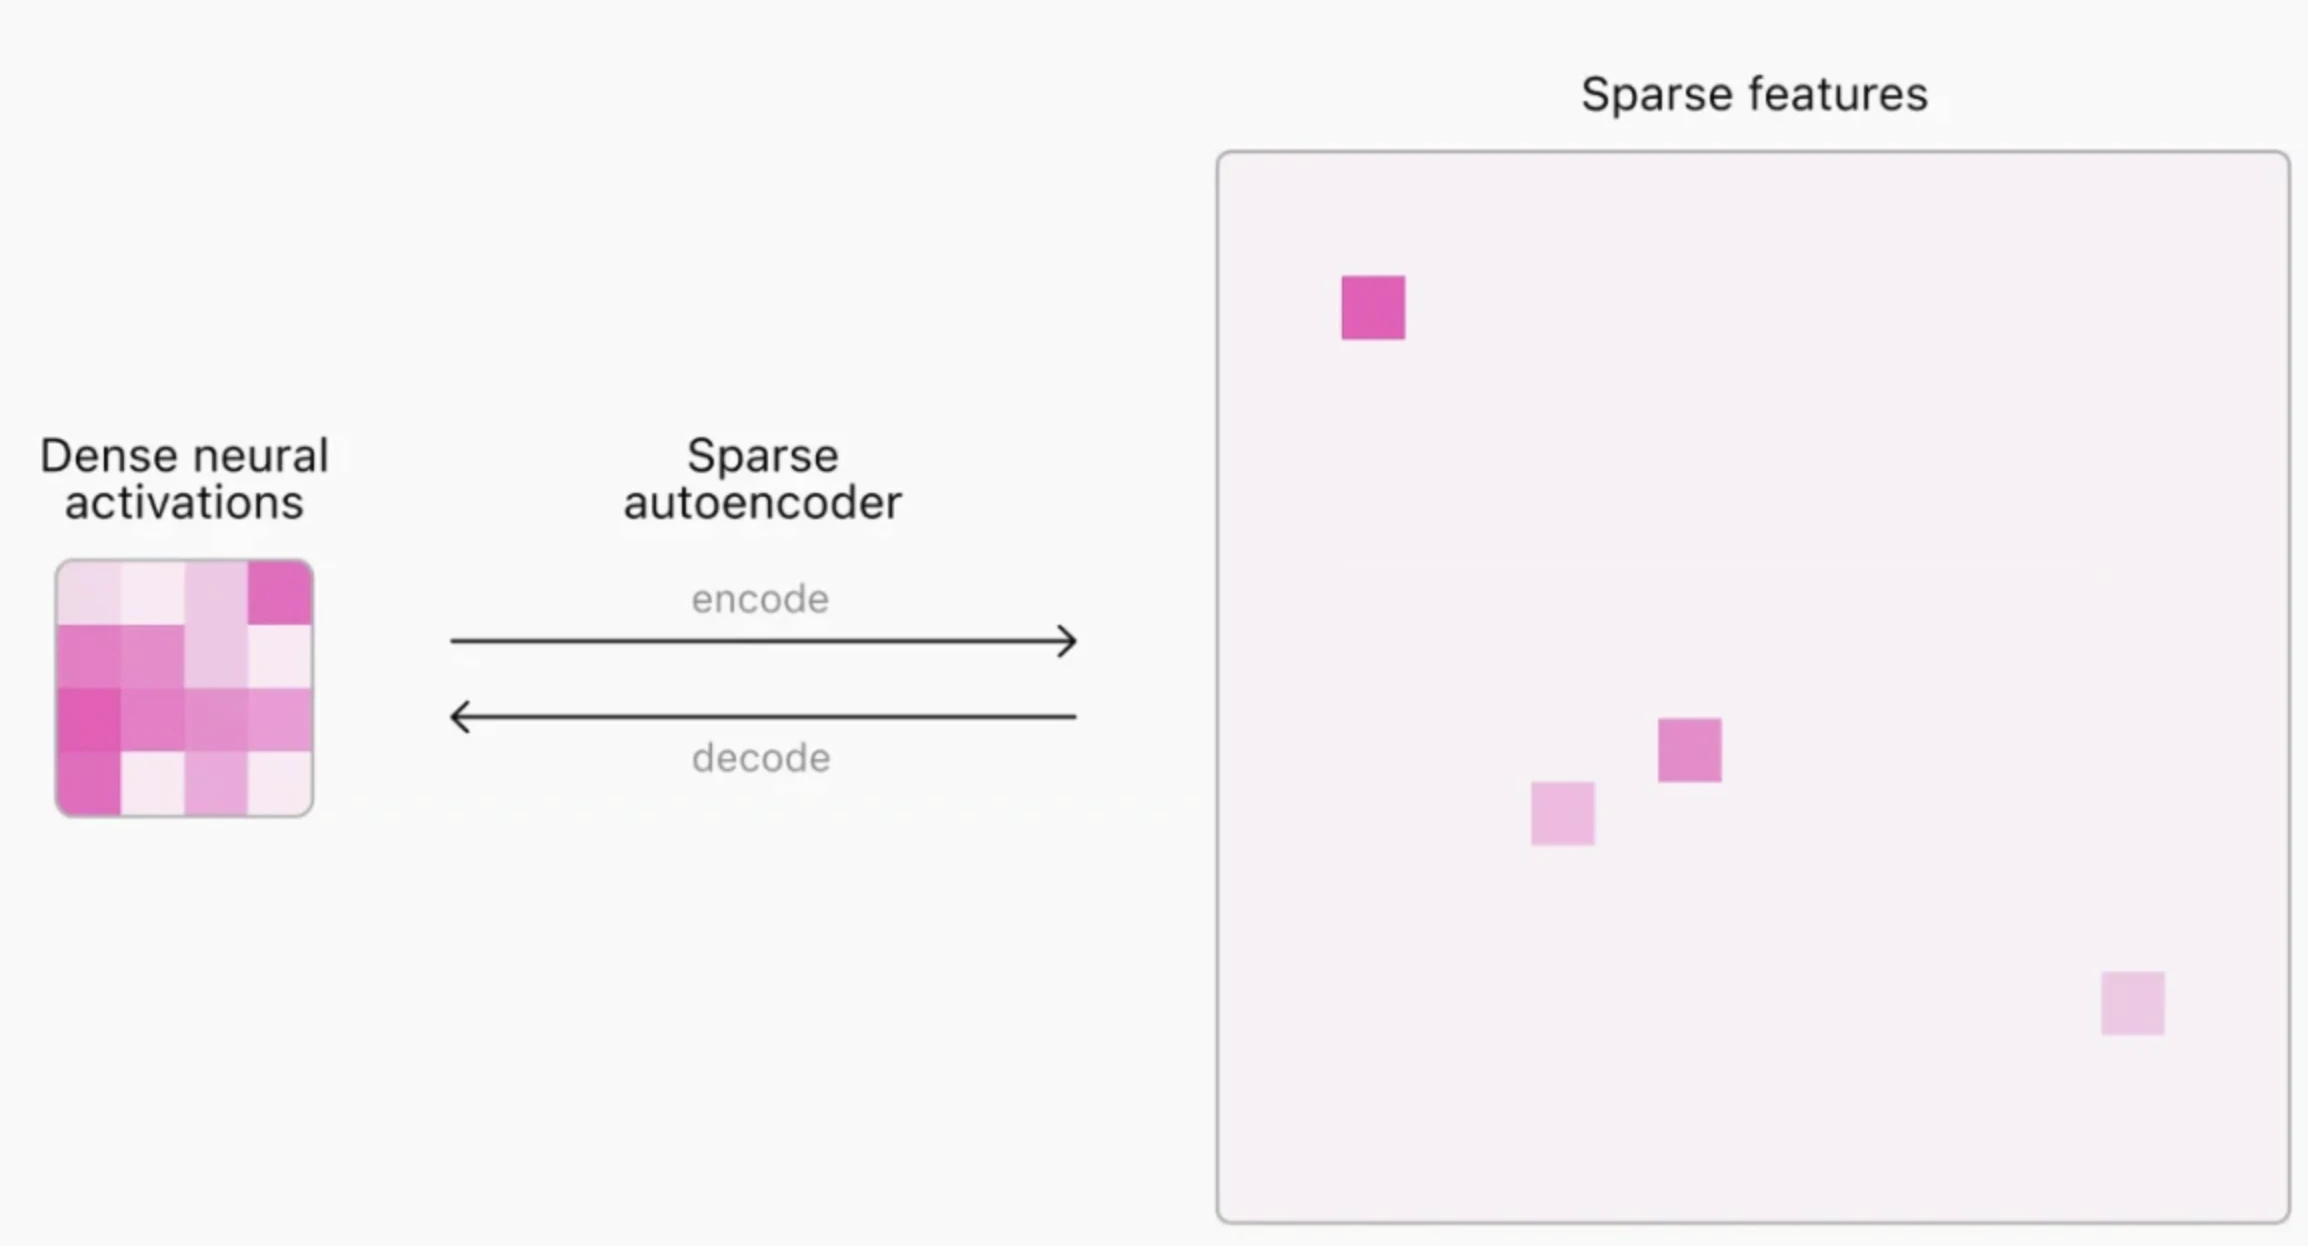
3- Modelli esperti sparsi (Mixture of Experts)
Invece di attivare l'intera rete neurale per ogni input, si attiva un sottoinsieme rilevante di parametri, a seconda del compito. Il modello instrada l'input verso “esperti” specializzati all'interno della rete. Solo gli esperti attivati elaborano la richiesta.
Esempi reali:
- DeepSeek V4-Pro: Un modello Mixture-of-Experts con 1.6T parametri totali e 49B attivati, accanto al più piccolo DeepSeek-V4-Flash con 284B parametri (13B attivati); entrambi supportano un contesto da un milione di token.3
- Qwen3.8-Max (Alibaba): Basato sull'architettura Qwen 3.5, arriva a 2.4 trilioni di parametri con 95B attivi ed è il primo modello Qwen di classe Max i cui pesi Alibaba si è impegnata a rendere open source.
- Mistral Devstral 2: Progettato appositamente per l'ingegneria del software. 123B parametri, finestra di contesto da 256K token, 72,2% su SWE-bench.4Una variante più piccola, Devstral Small 2 (24B parametri), gira localmente con licenza Apache 2.0. Il modello più recente di Mistral è Mistral Large 4, un modello multimodale MoE open-weight con una finestra di contesto da 1M, lanciato in anteprima pubblica il 6 ottobre 2026, con i pesi previsti entro la fine del mese.
4- Integrazione nei flussi di lavoro aziendali
Gli LLM sono integrati direttamente nei processi aziendali invece di essere usati come strumenti autonomi.
Esempi reali:
- Salesforce Agentforce (in precedenza Einstein Copilot): Integra gli LLM nelle operazioni CRM. Risponde alle richieste dei clienti, genera contenuti ed esegue azioni in Salesforce, basandosi sui dati e sui metadati CRM dell'organizzazione attraverso l'Einstein Trust Layer.5
- Microsoft 365 Copilot: Integrato in Word, Excel, PowerPoint e Outlook. Redige documenti, analizza fogli di calcolo, genera presentazioni e riassume thread di posta elettronica, attingendo ai dati aziendali tramite Microsoft Graph per ancorare le risposte al contesto organizzativo.6 L'agente Researcher utilizza un'architettura multi-modello in cui GPT gestisce la ricerca iniziale e Claude esamina gli output prima della consegna, la prima implementazione commerciale confermata di fornitori di IA concorrenti all'interno di un singolo prodotto aziendale.
- Anthropic Claude for Enterprise: La separazione della memoria basata sui progetti mantiene distinti i contesti di lavoro tra i team. Claude Opus 4.6 ha introdotto team di agenti, consentendo a più agenti Claude di suddividere compiti più ampi in flussi di lavoro paralleli, e ha integrato Claude in PowerPoint come pannello laterale nativo. La raccomandazione di Anthropic è di iniziare con Claude Opus 5.5 per la maggior parte dei carichi di lavoro e di usare Claude Fable 5.1 per il ragionamento complesso e il lavoro agentico di lungo periodo.7
5- LLM ibridi con capacità multimodali
I grandi modelli multimodali integrano più forme di dati, come testo, immagini e audio, consentendo loro di comprendere e generare contenuti su diversi tipi di media.
- Gemini 3.8 Flash: Google lo descrive come il suo modello Flash più intelligente, pensato per l'ingegneria del software di lungo periodo, gli agenti autonomi e i flussi di lavoro aziendali complessi. Il prezzo introduttivo è di $0,75 per milione di token in input e $3,75 per milione di token in output fino al 31 dicembre 2026; il prezzo standard di $1,50 e $7,50 inizia il 1° gennaio 2027. Google ha limitato i precedenti modelli Gemini 2.5 agli utenti che li hanno già usati e indirizza i nuovi progetti verso 3.5 Flash-Lite o 3.8 Flash.8
- Meta Muse Spark 1.3 e Muse Glimmer: Muse Spark, presentato l'8 aprile 2026, ha sostituito la linea Llama di Meta. Muse Spark 1.3 ha una finestra di contesto da 1M token e i suoi pesi restano chiusi, sebbene Meta preveda un rilascio open-weight nella propria roadmap.9Per i pesi aperti, Muse Glimmer è un modello da 30 miliardi di parametri con un encoder di percezione dedicato, distillato da Muse Spark e progettato per compiti agentici su hardware consumer, rilasciato sotto Apache 2.0.10
La capacità multimodale è ormai standard tra i modelli di frontiera. La sfida rimanente è la coerenza: i modelli funzionano bene sulle combinazioni comuni immagine-testo ma peggiorano nei contesti visivi rari, negli input a bassa risoluzione e nel ragionamento cross-modale che richiede di collegare prove visive e testuali.
6- Modelli di ragionamento
Modelli che riflettono sui problemi passo dopo passo invece di generare risposte immediate.
Questo passaggio dalla previsione al ragionamento è fondamentale per consentire:
- Comportamento agentico, in cui i modelli pianificano, eseguono e adattano i compiti in autonomia.
- IA interpretabile, in cui gli output sono passo dopo passo e logicamente solidi.
- Famiglia Claude 5.5 e Fable 5.1 (Anthropic): Tutti e quattro i modelli offrono una finestra di contesto da 1M token, output massimo di 128K, pensiero adattivo e una data di conoscenza affidabile a giugno 2026. Prezzi API per milione di token: Fable 5.1 a $10 input / $50 output, Opus 5.5 a $4 / $20, Sonnet 5.5 a $2 / $10 e Haiku 5.5 a $0,10 / $0,50 per prompt fino a 100.000 token.11
- GPT-6 Astra (OpenAI): Il prezzo API standard è di $10 per milione di token in input e $50 per milione di token in output; una modalità Fast è fino a 2x più veloce a 2x il prezzo.12
7- Modelli specifici per dominio sottoposti a fine-tuning
Modelli addestrati su dati specializzati per settori specifici invece di un addestramento generico.
Google, Microsoft e Meta hanno tutti rilasciato importanti modelli proprietari specifici per dominio e sottoposti a fine-tuning, destinati a casi d'uso aziendali specifici, in aggiunta alle loro offerte general-purpose.
Questi LLM specializzati possono ridurre le allucinazioni e aumentare l'accuratezza sfruttando il pre-addestramento specifico per dominio, l'allineamento del modello e il fine-tuning supervisionato.
GitHub Copilot: Sottoposto a fine-tuning su repository di codice. A luglio 2025, 20 milioni di sviluppatori usano GitHub Copilot, con un aumento del 400% anno su anno, e il 90% delle aziende Fortune 100 lo utilizza. Completa automaticamente il codice, genera funzioni e suggerisce correzioni di bug.13
BloombergGPT: 50-miliardi di parametri LLM addestrato su un dataset da 363 miliardi di token di documenti finanziari Bloomberg, che supera modelli di dimensioni comparabili nei benchmark NLP finanziari, tra cui analisi del sentiment, riconoscimento di entità nominali e risposta alle domande.14
Google Med-PaLM 2: Sottoposto a fine-tuning su dataset medici, ha raggiunto un'accuratezza superiore all'85% su domande in stile U.S. Medical Licensing Examination (USMLE), primo LLM a raggiungere prestazioni di livello esperto in questo benchmark. Alimenta MedLM, la famiglia di modelli di base per la sanità di Google Cloud.15
ChatLAW: Un modello linguistico open source addestrato specificamente su dataset del dominio giuridico cinese.16
8- IA etica e mitigazione del bias
- Anthropic e OpenAI hanno condotto una valutazione reciproca dell'allineamento a metà 2025, testando i rispettivi modelli pubblici per rilevare adulazione, tendenze alla segnalazione di illeciti e comportamenti di autoconservazione. L'esercizio ha rilevato adulazione in tutti i modelli testati, inclusi casi in cui i modelli convalidavano decisioni dannose provenienti da utenti simulati con convinzioni deliranti. Anthropic ha successivamente sviluppato il framework di test Bloom appositamente per valutare questo comportamento nei nuovi modelli.
- Anthropic ha anche rilasciato Claude Mythos Preview (Project Glasswing), un modello solo su invito messo a disposizione di un piccolo gruppo di organizzazioni appositamente per individuare e correggere vulnerabilità di sicurezza informatica nei principali sistemi operativi e browser web. Anthropic ha dichiarato di non prevedere di rendere disponibile questo modello. L'approccio ad accesso controllato rappresenta un nuovo framework per distribuire modelli specialistici altamente capaci laddove il profilo di rischio richieda un rilascio limitato. La pagina dei prezzi API di Anthropic elenca anche Claude Mythos 5.1 tra i modelli aggiuntivi, a $10 input / $50 output per milione di token.
- Google DeepMind: Ha pubblicato “L'etica degli assistenti IA avanzati”, offrendo la prima trattazione sistematica delle questioni etiche e sociali sollevate dagli agenti IA, coprendo allineamento dei valori, rischi di manipolazione, antropomorfismo, privacy ed equità. La valutazione IA responsabile dell'azienda ha incluso oltre 350 esercizi avversari di red team e ha introdotto un nuovo Critical Capability Level specificamente per la manipolazione dannosa, trattandolo come un rischio di frontiera al pari di attacchi informatici e minacce CBRN.
Limiti dei modelli linguistici di grandi dimensioni (LLM)
1- Allucinazioni
I modelli generano informazioni plausibili ma errate.
La classifica delle allucinazioni di Vectara è il benchmark di riassunto fondato più ampiamente citato del settore. Sul dataset Vectara originale, i modelli Gemini di Google occupano costantemente le prime posizioni, con le varianti Gemini Flash che raggiungono tassi di allucinazione inferiori all'1%. La famiglia GPT di OpenAI si colloca tra lo 0,8% e il 2,0%.
Vectara ha lanciato un benchmark significativamente più difficile alla fine del 2025: 7.700 articoli (rispetto a 1.000), documenti più lunghi fino a 32K token e contenuti che spaziano tra diritto, medicina, finanza e tecnologia. I risultati sul nuovo dataset rivelano uno schema controintuitivo: i modelli di ragionamento e thinking che eccellono nei compiti complessi spesso allucinano di più nel riassunto fondato rispetto a modelli più piccoli e veloci. La maggior parte dei modelli di classe thinking mostra tassi di allucinazione superiori al 10% sul dataset più difficile, mentre modelli più leggeri come le varianti Gemini Flash mantengono tassi inferiori.17
Nota: Nessun singolo benchmark fornisce un “tasso di allucinazione” definitivo per alcun modello. Una valutazione responsabile incrocia almeno due benchmark che misurano cose diverse: un compito fondato (Vectara), un compito di conoscenza aperto, e specifica la versione esatta del modello e le condizioni di chiamata.
Tutti i modelli allucinano. La frequenza si è ridotta notevolmente, passando da circa il 21% nel 2021 a meno del 5% per i migliori nei benchmark standard, ma non è stata eliminata. Le applicazioni critiche richiedono ancora una verifica umana.
2- Bias
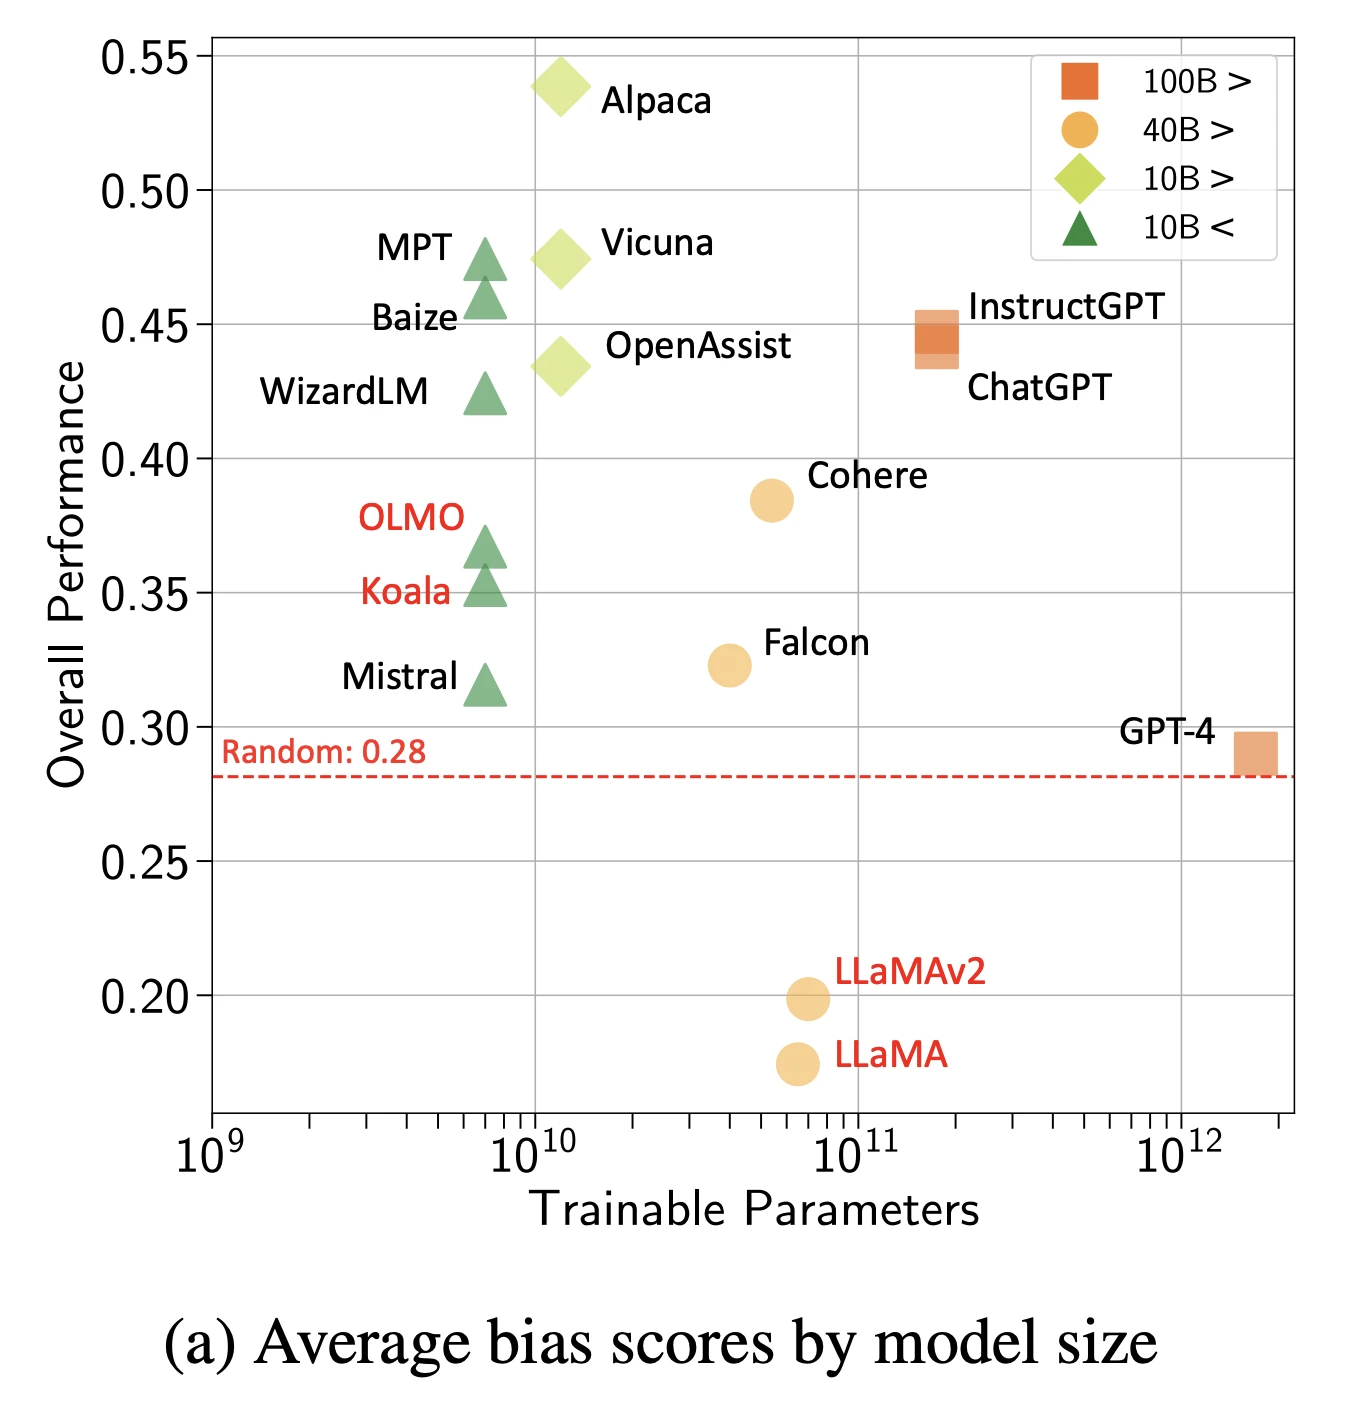
I modelli assorbono e amplificano i bias sociali presenti nei dati di addestramento.
Fonte: Punteggi complessivi di bias per modelli e dimensioni.18
Tipi di bias osservati:
- Bias di genere nei suggerimenti professionali
- Bias razziale nelle simulazioni di screening dei curriculum
- Bias di età nelle raccomandazioni sanitarie
- Bias socioeconomico nei contenuti educativi
3- Tossicità
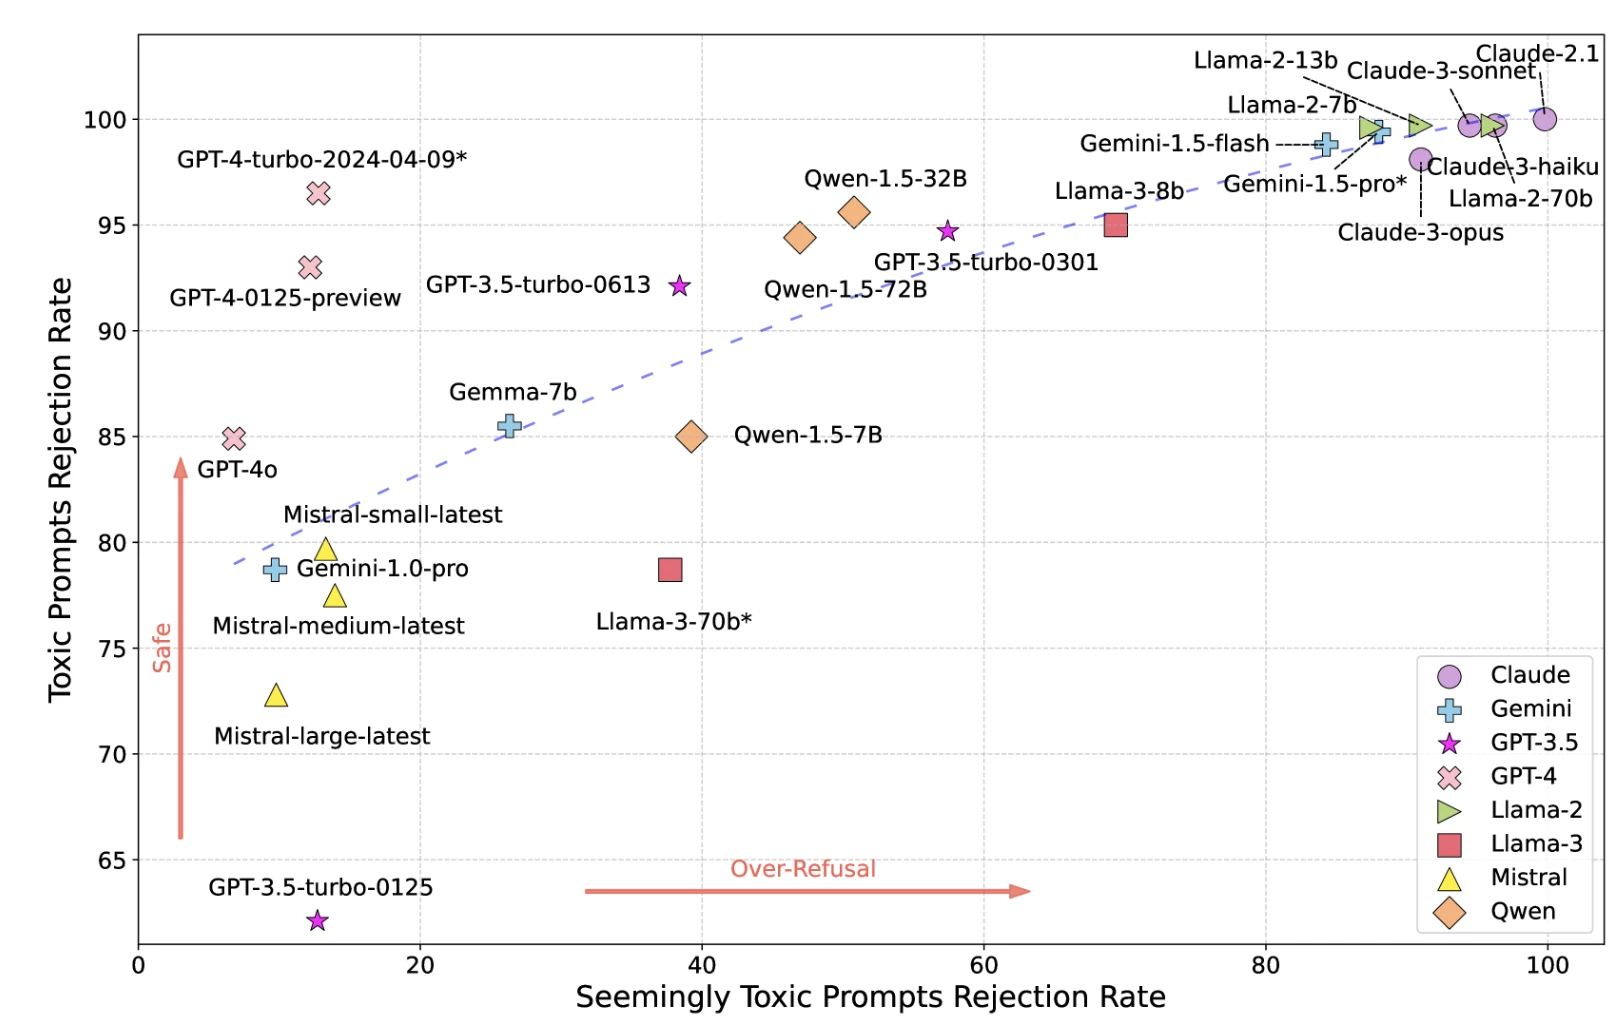
I modelli possono generare contenuti dannosi, offensivi o tossici nonostante le misure di sicurezza.
Fonte: mappa della tossicità degli LLM dai ricercatori di UCLA e UC Berkeley19
*GPT-4-turbo-2024-04-09*, Llama-3-70b* e Gemini-1.5-pro* sono usati come moderatore; i risultati potrebbero essere distorti su questi 3 modelli.
Misure di sicurezza rigorose riducono la tossicità ma aumentano i falsi positivi (rifiuto di richieste innocue). Misure permissive lasciano passare la tossicità.
4- Limiti della finestra di contesto
Ogni modello ha una capacità di memoria fissa, ovvero il numero di token che può elaborare in una singola sessione. Superato tale limite, il modello tronca i contenuti precedenti o rifiuta la richiesta. Il divario pratico tra i modelli è abbastanza ampio da avere importanza per i carichi di lavoro reali.
- Llama 4 Scout (Meta): 10M token, la finestra di contesto più ampia tra le principali versioni open-weight. Meta ha nel frattempo spostato il proprio lavoro di frontiera sulla linea Muse, quindi Scout non viene più aggiornato.
- Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1: finestra di contesto da 1M token e output massimo di 128K in tutti e quattro. Claude 4.6 e i modelli successivi (tranne Haiku 5.5) addebitano l'intera finestra da 1M alle tariffe standard.
- GPT-6.1 Sol: finestra di contesto da 1.050.000 token. OpenAI applica tariffe più elevate per le richieste a contesto lungo sui suoi modelli di punta.20
- Gemini 4 Argon: Google ha aumentato il limite di token in output a 1M token, rispetto a 64K.21
- DeepSeek V4.1 Flash e V4-Pro: contesto da 1M, output fino a 384K.22
Una finestra di contesto ampia non garantisce automaticamente prestazioni migliori su tutta la sua lunghezza. Il richiamo degrada verso la metà dei contesti lunghi nella maggior parte dei modelli, e i costi crescono con la lunghezza dell'input: elaborare 1M token costa molto di più che elaborare 10K token sullo stesso modello. Per la maggior parte dei carichi di lavoro in produzione, la domanda pratica non è quale modello abbia la finestra più ampia, ma quale modello recuperi in modo affidabile alle lunghezze di contesto che il proprio caso d'uso richiede davvero.
5- Cutoff statico delle conoscenze
I modelli si basano su conoscenze pre-addestrate con una data limite specifica. Non hanno accesso alle informazioni successive all'addestramento, a meno che non siano collegati a fonti esterne.
Problemi:
- Informazioni obsolete sugli eventi attuali
- Incapacità di gestire gli sviluppi recenti
- Minore rilevanza nei domini dinamici (tecnologia, finanza, medicina)
Soluzione: Integrazione con la ricerca web. ChatGPT, Claude e Perplexity offrono tutti una ricerca in tempo reale. Ma la ricerca non elimina le allucinazioni; i modelli a volte interpretano male i risultati della ricerca.
Principali piattaforme LLM
GPT-6
GPT-6 Astra è diventato disponibile al grande pubblico il 4 settembre 2026; GPT-6 Sol e GPT-6 Luna sono seguiti il 22 settembre 2026.
I suoi maggiori miglioramenti riguardano coding, uso del computer, ragionamento scientifico e sicurezza informatica, con guadagni particolarmente ampi nei benchmark difficili di risoluzione dei problemi. Segue inoltre le istruzioni in modo più affidabile e commette meno errori.
GPT-6.1 Sol è disponibile per gli utenti Plus, Pro, Business, Enterprise ed Edu tramite ChatGPT Work e Codex, ma non ancora nelle normali conversazioni di ChatGPT; gli sviluppatori vi accedono come gpt-6.1-sol.
Prezzi API (standard, per milione di token): gpt-6-astra $10 input / $50 output; gpt-6.1-sol $2 / $10; gpt-6-luna $0,10 / $0.50.
Limiti: Astra condivide il prezzo base più alto di questo elenco con Claude Fable 5.1, pari a $10 / $50 per milione di token. OpenAI afferma che Astra soddisfa la soglia critica di cybersecurity nell'ambito del suo Preparedness Framework e che la versione di lancio rifiuta compiti informatici avanzati come la scrittura di exploit proof-of-concept. Presenta ancora allucinazioni e richiede ancora la ricerca web per qualsiasi cosa successiva al cutoff di addestramento.12
Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5
Anthropic posiziona Fable 5.1 per il ragionamento complesso e il lavoro agentico di lungo periodo, Opus 5.5 per il coding agentico di lunga durata e il lavoro sulla conoscenza, Sonnet 5.5 come equilibrio tra velocità e intelligenza, e Haiku 5.5 per attività ad alto volume e sensibili alla latenza come classificazione e routing.
Prezzi per milione di token: Fable 5.1 $10/$50, Opus 5.5 $4/$20, Sonnet 5.5 $2/$10, Haiku 5.5 a partire da $0,10/$0.50.
Limiti: Claude 4.7 e i modelli successivi usano un tokenizzatore più recente che produce circa il 30% di token in più per lo stesso testo, il che aumenta il costo effettivo rispetto ai prezzi di listino.
Gemini 3.8 Flash / Gemini 4 Argon
Google ha introdotto Gemini 3.8 Flash, un modello più veloce ed economico incentrato su coding complesso, flussi di lavoro autonomi e ragionamento, insieme a Flash Cyber, un modello specializzato in sicurezza informatica.
Flash ottiene il 54,9% su HLE-Verified e costa $0,75 per milione di token in input e $3,75 per milione di token in output fino alla fine del 2026, anche se i compiti complessi possono consumare più token.
Flash Cyber raggiunge oltre il 70% di successo nel benchmark interno di individuazione delle vulnerabilità di Google e il 47,2% in un benchmark esterno di applicazione di patch, con accesso limitato a difensori fidati.
Prezzi: $0,75 per milione di token in input e $3,75 per milione di token in output .23
Google Gemini 4 Argon si concentra su compiti complessi e di lunga durata in ingegneria del software, finanza, lavoro legale e sicurezza informatica. Supporta fino a 1 milione di token in output, ottiene il 77,9% su DeepSWE e il 51,3% su AutomationBench e può individuare e correggere autonomamente le vulnerabilità di sicurezza. Google riferisce di usarlo internamente per migrazioni di codice su larga scala e ottimizzazioni dei data center.
Prezzi a partire da $2 per milione di token in input e $10 per milione di token in output, con un raddoppio dopo il periodo introduttivo. L'accesso è attualmente limitato a tester fidati e difensori della sicurezza informatica.21
Meta Muse Spark 1.3 / Muse Glimmer
Meta Muse Spark 1.3 si concentra sul miglioramento degli agenti IA per flussi di lavoro lunghi e complessi e attività di coding. Rispetto alla versione 1.2, i test di ingegneria interni di Meta mostrano il 20% di chiamate agli strumenti in meno e il 25% di token in meno per le attività di coding. Meta riferisce inoltre una migliore resistenza alle injection di prompt e un giudizio migliore riguardo alle azioni irreversibili.
Il modello è disponibile tramite Muse Code e la Meta Model API, con pesi aperti previsti per una versione futura.24
Pesi aperti: Muse Glimmer è un modello aperto da 30B parametri, con licenza Apache 2.0, che gira su una singola GPU ed è ottimizzato per l'uso di strumenti, compiti lunghi e recupero dai guasti.
Chi lo usa: Muse Spark è adatto ai team già nell'ecosistema di Meta che desiderano accesso via API. Muse Glimmer è adatto a distribuzioni on-premise e locali e agli sviluppatori che vogliono evitare il lock-in del fornitore.
Limiti: I pesi di Muse Spark sono chiusi. I modelli Llama 4 restano scaricabili ma non sono più la linea di frontiera di Meta.
DeepSeek V4
V4-Pro è un modello Mixture-of-Experts con 1.6T parametri totali e 49B attivati, con un contesto da un milione di token.
Il 10 settembre 2026, DeepSeek ha rilasciato V4.1-Flash, il modello più piccolo della sua famiglia di architetture, con comprensione visiva multimodale nativa. V4.1 Flash supporta la visione, ma V4-Pro no.25
API pricing (per milione di token, ore di punta): V4.1 Flash costa $0,30 input (cache miss) e $1,20 output; V4-Pro costa $1,32 input e $3,96 output. Le tariffe non di punta sono la metà delle tariffe di punta.22
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Il futuro dei modelli linguistici di grandi dimensioni}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/future-of-large-language-models}},
  note   = {AIMultiple. Consultato il 25 giugno 2026}
}
Registro delle modifiche
12 aggiornamentiRimosso il grafico di benchmark delle allucinazioni per gli LLM più diffusi.
Aggiunta una sezione di metodologia del benchmark con i modelli testati e il punteggio.
Sostituiti GPT-5.2, Gemini 3.1 Pro e DeepSeek V3.2 con GPT-5.5, Gemini 2.5 Pro, DeepSeek V4 e Claude Opus 4.7.
Aggiornati i dati degli 'Esempi reali' nella sezione 'Domain-Specific Fine-Tuned Models'.
Aggiornata la sezione "Tendenze future dei modelli linguistici di grandi dimensioni" con nuovi esempi di verifica dei fatti in tempo reale.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.




Commenti 1
Condividi i tuoi pensieri
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.
Insightful read! The future of large language models looks incredibly promising. It’s exciting to see how they’ll keep transforming the way we work and communicate. Loved the detailed explanation in the article.