


Agenti IA locali: Goose, Observer IA, AnythingLLM

Gli agenti IA locali sono spesso descritti come offline, on-device o completamente locali. Abbiamo trascorso tre giorni a mappare l'ecosistema degli agenti IA locali che operano in modo autonomo su hardware personale senza dipendere da API esterne o servizi cloud.
La nostra analisi classifica le soluzioni principali in tre aree chiave, basandosi su test pratici su agenti per sviluppatori, strumenti di automazione e assistenti di produttività.
Classificazione degli agenti IA locali
Categoria | Strumenti/Framework | Casi d'uso principali (Locale / Offline) |
|---|---|---|
Agenti sviluppatore e di sistema | Goose, Localforge, Devika, Roo Code (Boomerang Mode), Continue.dev, Cursor, CodeGenie, SuperCoder, Aider, Cline, Kilo Code | Codifica locale, debug, automazione di file/processi, attività DevOps locali |
Agenti di automazione e controllo locale | Observer IA, Browser-Use, DeepBrowser | Controllo locale del browser, automazione dei file, interazione con le app, flussi di lavoro on-device |
Agenti di conoscenza e produttività | AnythingLLM (Desktop), LocalGPT (Single-User), PrivateGPT | Domande e risposte su documenti offline, riassunto, ricerca locale/RAG |
Vedi le descrizioni delle categorie.
1. Agenti sviluppatore e di sistema
*Tipi di esecuzione:
- Completamente locale: Lo strumento viene eseguito nativamente su hardware personale utilizzando runtime locali. Strumenti in grado di operare completamente offline.
- Ibrido locale: Il modello principale o l'esecuzione delle attività avviene localmente, ma alcune funzionalità, come l'integrazione con l'IDE, l'indicizzazione del contesto, la sincronizzazione o il ragionamento, si affidano ancora a servizi cloud o API.
** Spiegazione della colonna on-machine:
- Completamente on-device: L'intera operazione offline — inferenza, ragionamento ed esecuzione — si svolge localmente.
- Inferenza locale, assistita dal cloud: Il modello principale viene eseguito localmente, ma le funzionalità dell'IDE o di gestione utilizzano servizi online.
- Esecuzione locale, ragionamento remoto: Il codice viene eseguito localmente, ma API esterne alimentano il ragionamento o i passaggi di pianificazione.
Goose
Goose è un agente di sviluppo open source progettato per operare interamente su hardware locale.1
Capacità principali:
- Utilizza runtime LLM locali per il ragionamento e la generazione del codice
- Esegue attività multi-step come scrittura, test e debug del codice
- Interagisce direttamente con il file system locale e gli strumenti di sviluppo
- Non richiede connettività di rete quando è configurato con modelli locali.
Goose soddisfa una definizione rigorosa di agente autonomo locale, poiché osservazione, ragionamento e azione avvengono on-device.
Roo Code(Boomerang Mode)
Roo Code è un assistente di codifica integrato nell'IDE che enfatizza il raffinamento iterativo.
- La modalità Boomerang consente l'esecuzione locale delle azioni
- Il ragionamento si basa generalmente su modelli cloud
- Le funzionalità di coordinamento e gestione dell'IDE non sono completamente locali
Di conseguenza, Roo Code dovrebbe essere classificato come agente sviluppatore ibrido con human-in-the-loop, piuttosto che come sistema completamente locale.
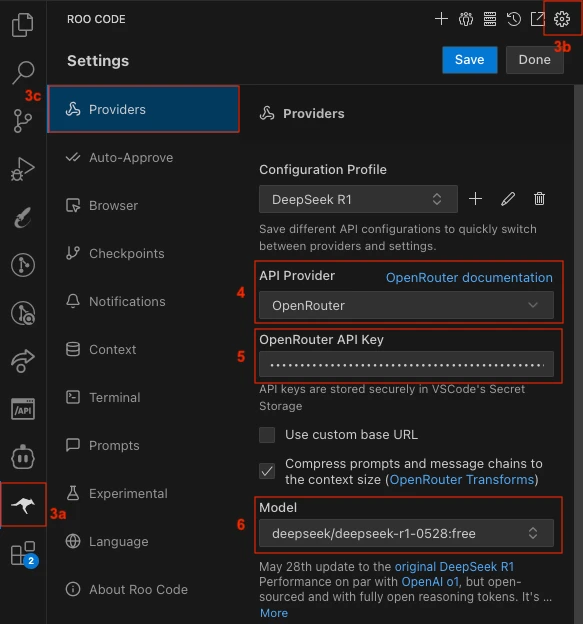
Configurazione dell'agente IA locale in Roo Code:
Roo Code consente agli sviluppatori di creare profili di configurazione personalizzati che definiscono come connettersi a diversi modelli di IA, inclusi LLM ospitati localmente.
Da Impostazioni → Provider, puoi aggiungere profili tramite OpenRouter o altri provider supportati, quindi scegliere un modello locale eseguito con Ollama o LM Studio.
Ogni profilo di configurazione può memorizzare i propri parametri, tra cui temperatura, profondità di ragionamento e limiti di token. Ciò consente di passare da modelli cloud leggeri a runtime completamente locali per l'inferenza on-device.
Cursor
Cursor consente l'uso di LLM locali per l'inferenza, ma rimane dipendente dai servizi cloud per:
- Indicizzazione del codice
- Applicazione delle modifiche
- Coordinamento del flusso di lavoro
Pertanto, Cursor supporta l'inferenza locale, ma non un loop agente completamente locale e non può funzionare offline.
Come utilizzare un LLM locale in Cursor:
Fonte:Logan Hallucinates2
Aider
Aider è un assistente di codifica IA open source basato sulla riga di comando, progettato per lavorare direttamente con repository Git locali. Modifica il codice generando patch e commit invece di operare tramite un'interfaccia IDE.
Aider viene spesso utilizzato con modelli ospitati nel cloud, ma:
- Lo strumento stesso viene eseguito localmente
- Se abbinato a un runtime di modello locale, può funzionare completamente on-device
La capacità offline è quindi condizionata dalla scelta del modello, non intrinseca allo strumento.
2. Agenti di automazione e controllo locale
Observer IA
Observer IA è un framework agente di automazione locale open source.
Funzionalità principali:
- Esegue agenti utilizzando LLM locali
- Osserva lo stato dello schermo tramite OCR o screenshot
- Esegue codice Python tramite un ambiente di esecuzione integrato
- Non richiede connettività cloud
Observer IA fornisce l'infrastruttura per il comportamento degli agenti piuttosto che una policy agente fissa, ed è meglio descritto come framework di controllo locale a ciclo chiuso.
Browser-Use
Browser-Use consente l'interazione con il browser guidata dall'IA tramite Playwright.
- Le azioni del browser vengono eseguite localmente
- Il ragionamento può essere eseguito utilizzando modelli locali o remoti
- Il funzionamento offline è possibile se abbinato all'inferenza locale
Ciò colloca Browser-Use saldamente nella categoria di automazione ibrida per impostazione predefinita.
Come usare un LLM locale con Browser-Use:
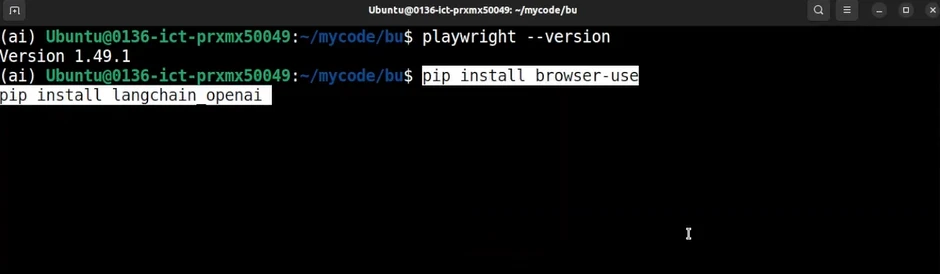
Un metodo per installarlo consiste nell'usare il comando pip install browser-use, che configura sia l'interfaccia Python sia il controllo locale del browser sulla stessa macchina.
Quando viene eseguito in seguito (ad esempio, con python -m browser_use), aprirà e controllerà un'istanza del browser localmente, eseguendo azioni e ragionamento tramite un LLM locale (ad es. tramite Ollama) o tramite API collegate:
Configurare Browser-Use localmente3
Per chi desidera vedere la configurazione completa in azione, ecco una guida video passo che mostra come installare ed eseguire Browser-Use su una macchina locale:
La guida copre tutto, dall'installazione di dipendenze come Playwright e LangChain al collegamento di Browser-Use con un modello locale tramite Ollama.3
3. Agenti di conoscenza e produttività
AnythingLLM (Desktop)
Quando è configurato con modelli locali, AnythingLLM Desktop:
- Esegue l'indicizzazione dei documenti localmente
- Esegue il ragionamento dell'agente on-device
- Supporta capacità di azione limitate (ad es. scrittura di file)
- Non richiede connettività cloud
Sebbene la sua autonomia sia limitata rispetto agli agenti di sistema, si qualifica come agente di produttività locale secondo una definizione ristretta delle attività.
Un esempio d'uso di un agente IA locale
Abbiamo testato AnythingLLM Desktop per vedere come funziona un agente locale on-device dalla configurazione all'output finale.
1. Configurazione dell'area di lavoro
Abbiamo aperto le impostazioni dell'area di lavoro e siamo andati su Configurazione agente.
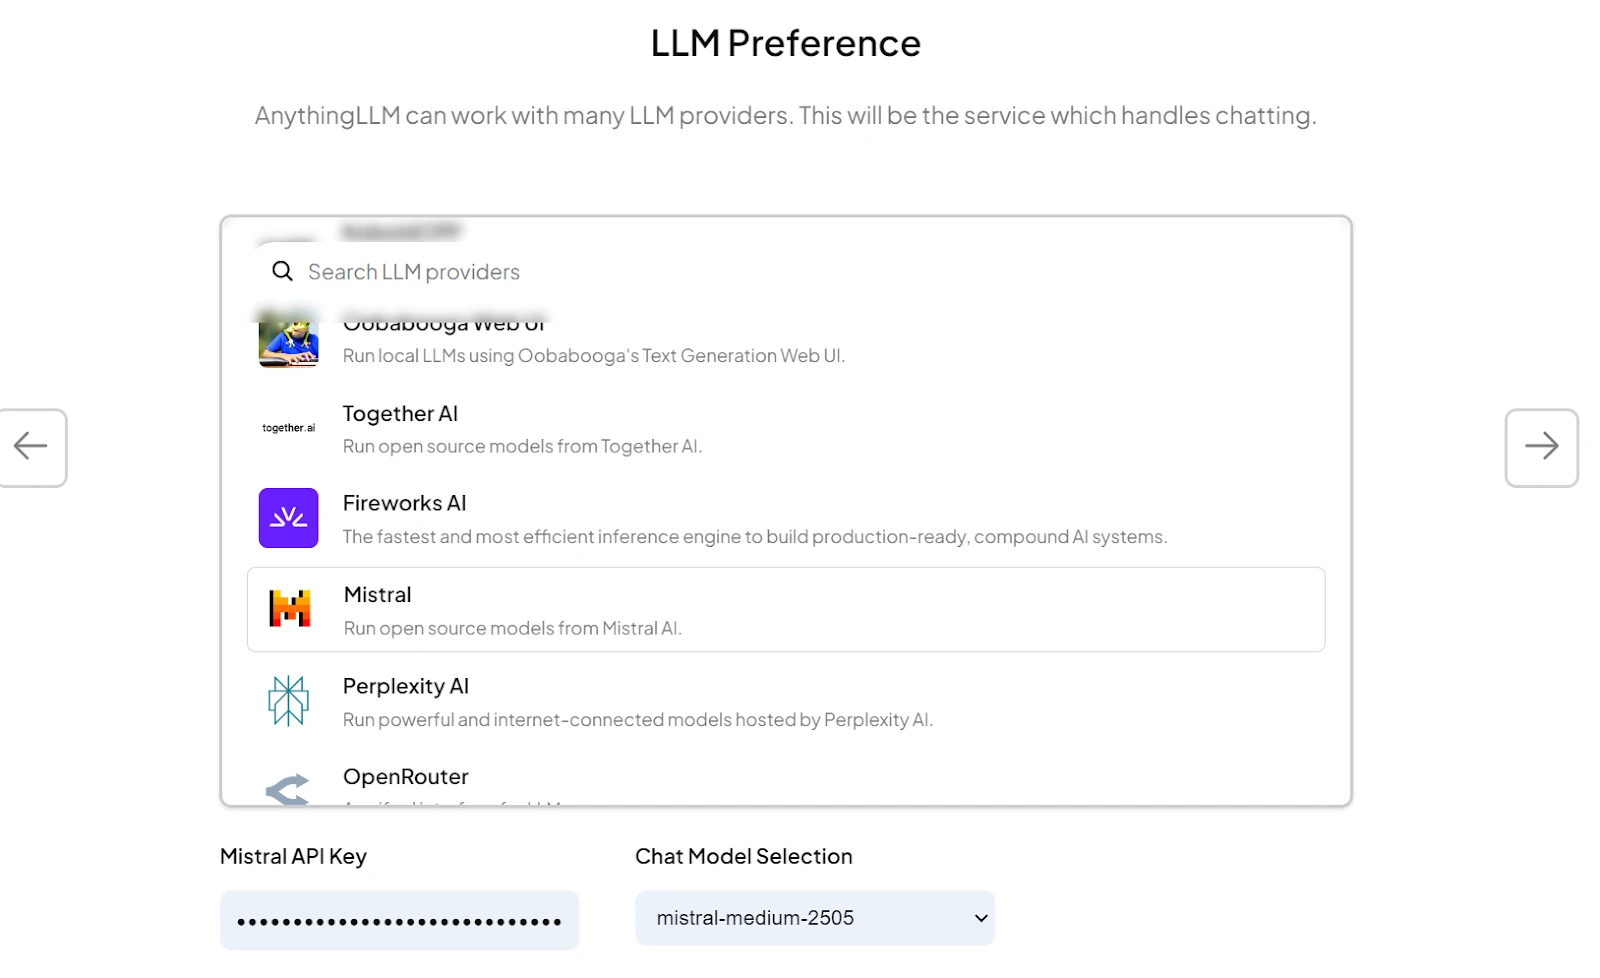
Lì, abbiamo scelto un provider LLM e selezionato il modello mistral-medium-2505.
Dopo aver cliccato su Aggiorna agente area di lavoro, l'area di lavoro ha confermato che la configurazione era completa.
2. Abilitazione delle competenze dell'agente
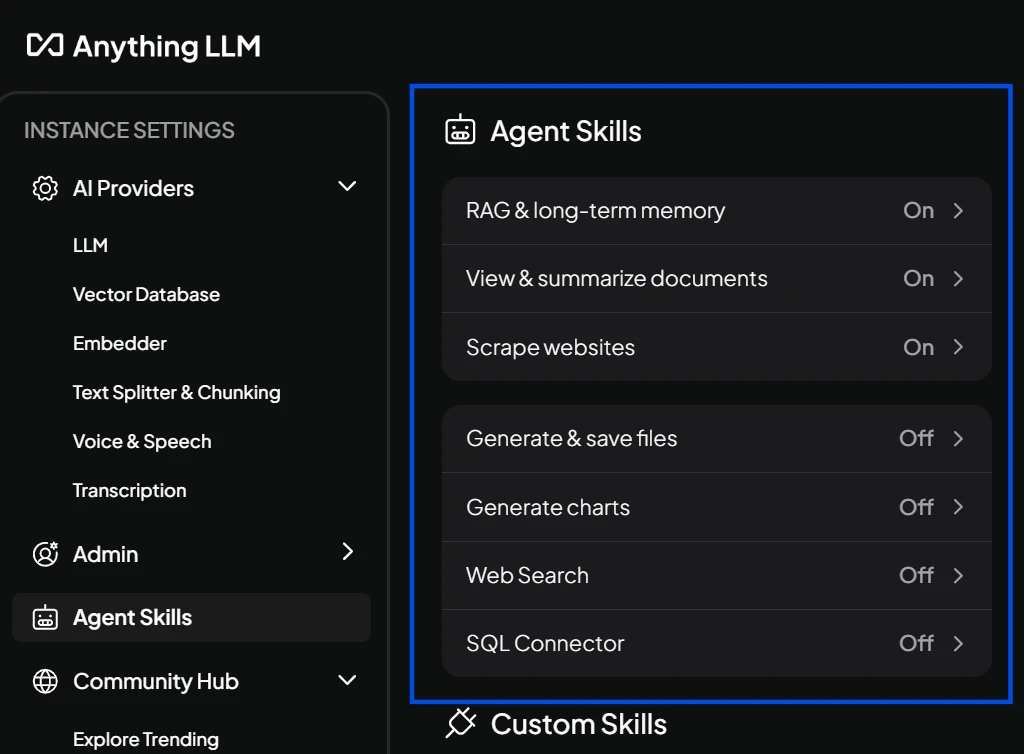
Successivamente, abbiamo aperto il pannello Configura competenze agente.
Questo menu consente di abilitare le funzionalità integrate dell'agente con un solo clic. Non è richiesta alcuna codifica.
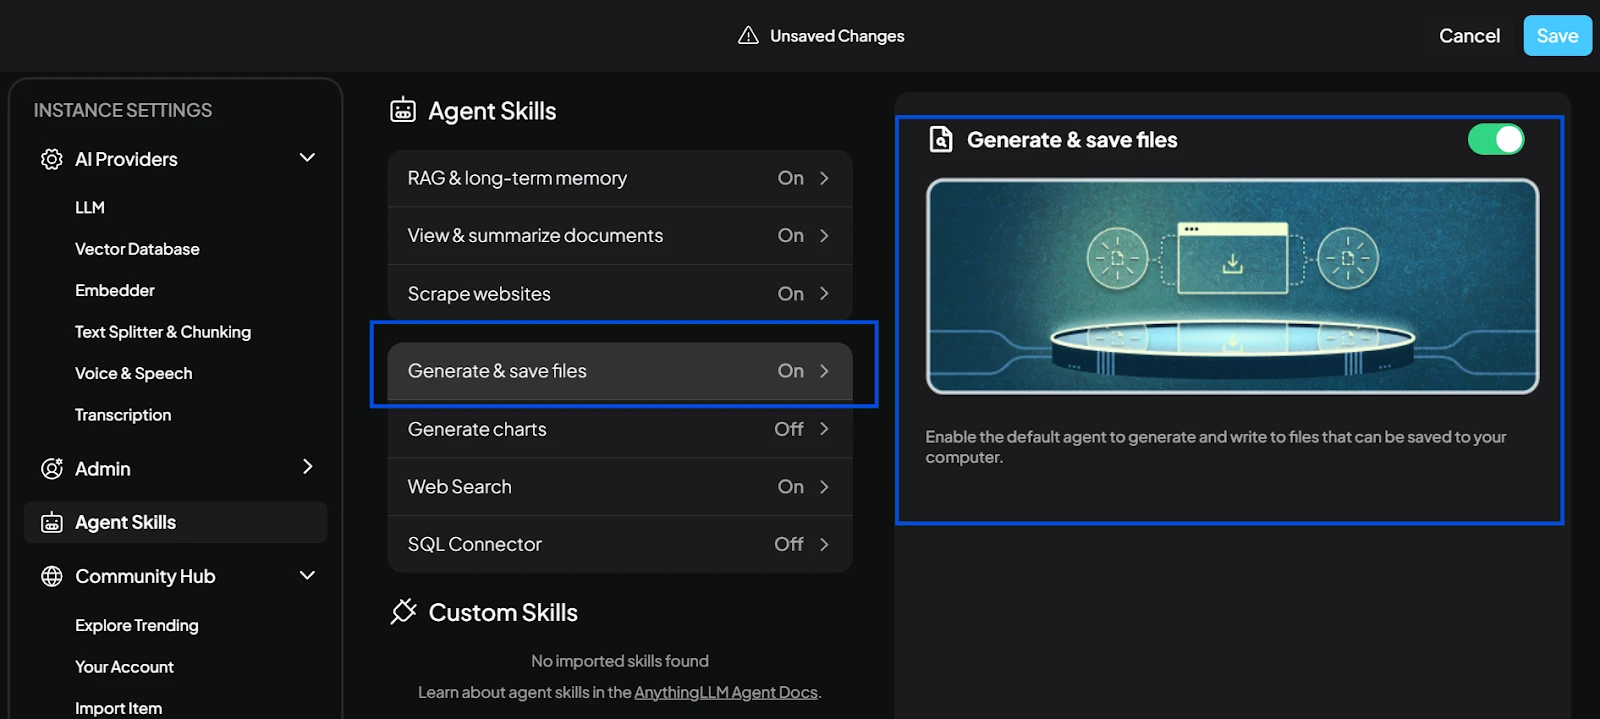
3. Test della competenza «Salva Files»
Abbiamo abilitato la competenza Salva Files, consentendo all'agente di scrivere gli output direttamente sulla macchina locale.
Dopo averla attivata e salvato la modifica, l'agente era pronto.
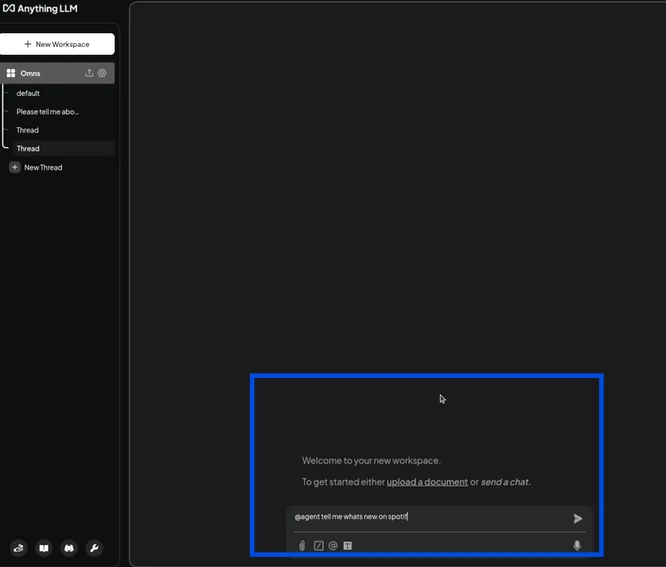
Per testarla, siamo tornati alla finestra di chat e abbiamo usato uno dei prompt di esempio della documentazione.
Ciò ha confermato che l'agente poteva generare un file e prepararlo per il salvataggio locale.
4. Esecuzione dell'agente in chat
Abbiamo chiesto all'agente di summarize un argomento storico e lo abbiamo invocato usando @agent.
Abbiamo modificato il comando per salvare l'output come semplice file di testo invece di un PDF.
Il sistema ha confermato che la modalità Agent Chat Mode era attiva e ha mostrato come uscire dal ciclo.
L'agente ha prodotto il riassunto e preparato il file per il salvataggio.
5. Salvataggio del file in locale
Per salvare l'output, abbiamo usato il comando di esempio della documentazione di AnythingLLM:
«@agent puoi salvare queste informazioni come PDF nella cartella del desktop?»
Abbiamo eseguito la stessa struttura in chat, ma per un file di testo.
Si è aperta una finestra del browser di file e abbiamo salvato l'output sul dispositivo.
Il file è apparso nella cartella Download, indicando che l'intero processo, ragionamento, esecuzione e salvataggio sono stati eseguiti interamente on-device.
Descrizioni delle categorie di agenti IA locali
- Agenti sviluppatore e di sistema (livello azione): Agenti che vengono eseguiti direttamente sul dispositivo per svolgere attività di codifica, di sistema e di automazione del flusso di lavoro localmente.
- Agenti di automazione e controllo locale: Agenti che automatizzano azioni reali sulla macchina controllando browser, UI o sistema operativo.
- Agenti di conoscenza e produttività: Assistenti locali per chat, riassunto e gestione dei documenti senza inviare dati al cloud.
Livelli architetturali nello stack agente locale
- Livello azione (agenti): Sistemi che osservano lo stato, invocano strumenti e agiscono sull'ambiente locale.
- Livello di ragionamento e orchestrazione (framework): Librerie come LangGraph o LlamaIndex che supportano pianificazione, memoria e coordinamento. Queste non sono di per sé agenti.
- Livello di esecuzione (runtime locali): Runtime di modelli come Ollama o LM Studio che consentono l'inferenza locale.
Hardware: cosa serve realmente agli agenti locali
Il modello e il framework sono solo metà della storia. L'hardware decide cosa è effettivamente possibile. Per eseguire modelli linguistici localmente, due numeri contano di più: quanta memoria hai e quanto è veloce quella memoria.
La RAM (o VRAM) stabilisce il tetto alla dimensione del modello
Un modello deve entrare in memoria prima di poter essere eseguito. Una guida approssimativa per modelli quantizzati a 4 bit: un modello 3B richiede circa 2 GB, un modello 7–8B richiede circa 5–6 GB, un modello 13B richiede circa 8–10 GB e un modello 70B richiede circa 40–48 GB. Aggiungi margine per il contesto, il sistema operativo e qualsiasi altra applicazione in esecuzione. In pratica, la memoria è il collo di bottiglia più spesso del calcolo e, sui PC Copilot+, l'obiettivo consigliato per un uso confortevole di LLM locali è di almeno 32 GB di RAM.4
La larghezza di banda della memoria determina la velocità
Una volta che un modello entra in memoria, la velocità con cui genera i token dipende principalmente da quanto velocemente il sistema può leggere i pesi del modello dalla memoria. Ecco perché l'elevata larghezza di banda della memoria di Apple Silicon (fino a 800 GB/s su M4 Max) è il vantaggio pratico per l'inferenza LLM, non il numero di motori neurali.5
I TOPS della NPU contano meno di quanto il marketing suggerisca
Un'unità di elaborazione neurale è un chip progettato per i calcoli dell'IA e la sua valutazione è espressa in TOPS (trilioni di operazioni al secondo). La certificazione PC Copilot+ di Microsoft richiede almeno 40 TOPS. Tale soglia è orientata alle funzionalità on-device di Microsoft (sottotitoli in tempo reale, effetti immagine, Recall) piuttosto che all'esecuzione di un LLM stile chat. Per i carichi di lavoro LLM, RAM e larghezza di banda dominano. Le prestazioni della NPU sono un utile fattore di spareggio, non il numero principale.
Una regola pratica:
- Per modelli assistenti di classe 3B, un laptop attuale con 16 GB di memoria unificata o RAM è sufficiente.
- Per modelli 7–8B con velocità confortevole, punta a 32 GB di RAM e larghezza di banda di memoria elevata. Apple Silicon, serie Snapdragon X e gli attuali PC Copilot+ Intel/AMD funzionano tutti; le differenze si vedono nei token al secondo, non nella capacità di eseguire il modello.
- Per modelli più grandi (30B e superiori), le opzioni si dividono. Apple Silicon ad alta memoria (configurazioni Mac Studio o MacBook Pro con 64–192 GB di memoria unificata) può eseguire modelli di grandi dimensioni che nessuna GPU discreta consumer può contenere. L'alternativa è una workstation con una o più GPU discrete ad alta VRAM. Entrambe le strade funzionano; hanno profili di costo e consumo energetico diversi.
 Aggiungi come fonte preferita
Guida pratica
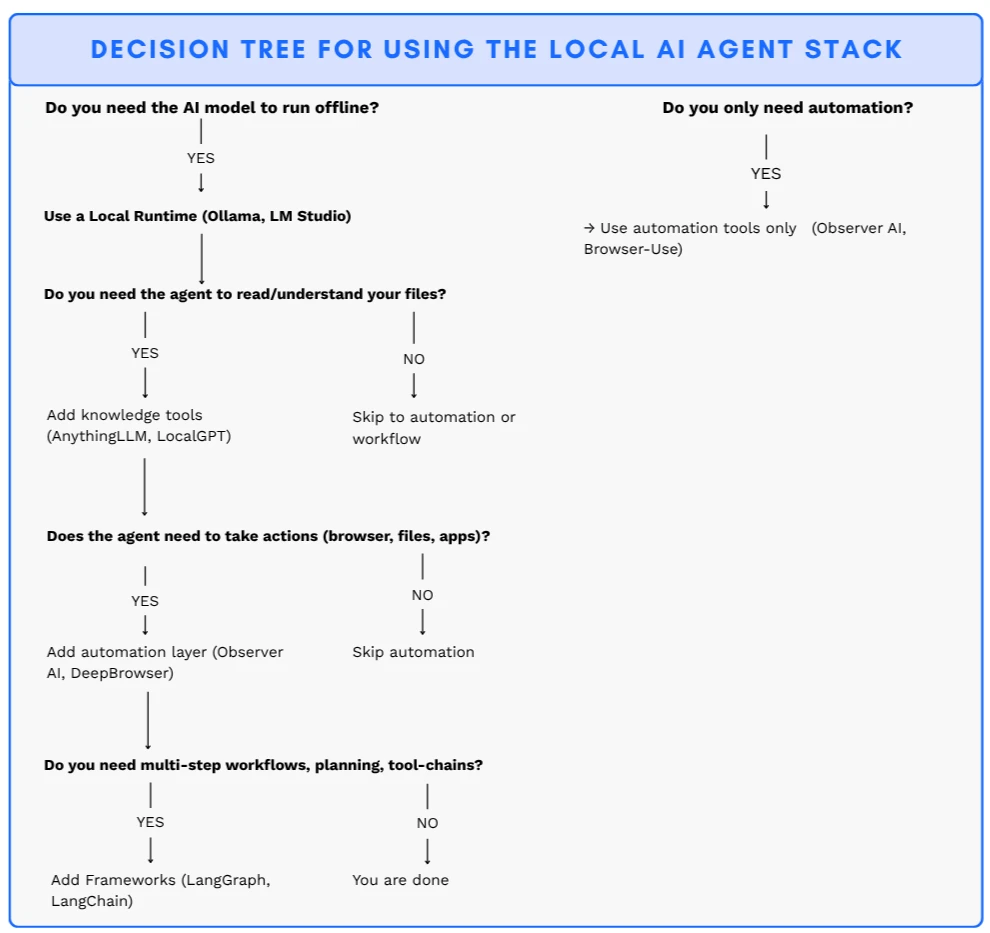
I sistemi di IA locale dovrebbero essere assemblati in modo incrementale:
- Inizia con un runtime locale se è richiesta l'inferenza offline.
- Aggiungi un livello di conoscenza quando è necessaria la comprensione dei documenti.
- Introduci agenti di automazione o controllo quando sono richieste azioni nel mondo reale.
- Usa framework di orchestrazione per flussi di lavoro complessi e multi-step.
Nella maggior parte dei casi, uno stack completamente stratificato non è necessario.
Come approcciare lo stack di agenti IA locali
Inizia con il set minimo di livelli richiesto dal tuo caso d'uso. Se il tuo agente ha bisogno di ragionamento offline, inizia con un runtime locale come Ollama o LM Studio. Se deve comprendere i tuoi file, aggiungi un livello di conoscenza come AnythingLLM o LocalGPT. Per gli agenti che devono compiere azioni (aprire app, controllare il browser, gestire i file), aggiungi un livello di automazione locale. Usa framework come LangGraph o LlamaIndex quando hai bisogno di flussi di lavoro multi-step, cicli di pianificazione o toolchain complesse.
Perché eseguire un agente in locale
La privacy è una questione legale, non una preferenza
Ai sensi del Digital Omnibus, gli obblighi ad alto rischio dell'EU IA Act si applicano ora dal 2 dicembre 2027 per i sistemi autonomi (Allegato III) e dal 2 agosto 2028 per l'IA nei prodotti regolamentati; gli obblighi di trasparenza ai sensi dell'Articolo 50 si applicano dal 2 agosto 2026.6 Le sanzioni possono raggiungere €15 milioni o il 3% del fatturato annuo globale. Un modello eseguito sul proprio hardware elabora i dati nel proprio ambiente, senza trasmetterli a un provider cloud. Il rischio di trasferimento transfrontaliero dei dati scompare.7
Latenza
Le chiamate API cloud aggiungono 200–500 ms di ritardo di rete prima che appaia il primo token. L'inferenza on-device lo riduce a meno di 20 ms. Per agenti vocali, completamento del codice e tutto ciò che interagisce con un'interfaccia utente in tempo reale, questa è la differenza tra fluido e laggoso
Costo in volume
Le chiamate cloud sono economiche per singola richiesta e costose in grandi volumi. Un modello locale ha un costo hardware fisso e nessun addebito per token. Il compromesso è comunque reale: gli agenti locali sono limitati dal modello che entra in memoria e dall'hardware sulla scrivania. Le prossime sezioni coprono entrambi.
FAQ
Gli agenti IA locali operano autonomamente su hardware personale senza fare affidamento su API esterne o infrastrutture cloud.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Agenti IA locali: Goose, Observer IA, AnythingLLM}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/local-ai-agent}},
  note   = {AIMultiple. Consultato il 30 luglio 2026}
}Risultati e timestamp di 19 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 4 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
3 aggiornamentiAggiunte le sezioni "Perché eseguire un agente in locale" e requisiti hardware locali.
Rimosse le sezioni 'Frameworks' e 'Local runtimes & infrastructure'.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

Prossimo da leggere
Confronta 10+ strumenti di gestione delle password aziendali: funzionalità e prezzi

Alternative a OpenClaw: Hermes vs ZeroClaw vs Grok Bot

Analisi dei 5 migliori software per la gestione delle modifiche ai firewall


Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.