


Confronta i modelli di IA multimodali sul ragionamento visivo

Abbiamo valutato tramite benchmark 40 principali modelli di IA multimodali sul ragionamento visivo utilizzando 200 domande basate su elementi visivi. La valutazione era composta da due percorsi: 100 domande di comprensione dei grafici che testano l'interpretazione della visualizzazione dei dati e 100 domande di logica visiva che valutano il riconoscimento di schemi e il ragionamento spaziale.
Benchmark sul ragionamento visivo
Consulta la nostra metodologia di benchmark per conoscere le nostre procedure di test.
Ogni modello ottiene un punteggio più basso nella logica visiva che nella comprensione dei grafici. Il divario è minimo per qwen3.8-flash (58% contro 78%) e massimo per claude-sonnet-4.5 (35% contro 77%).
- gemini-4-argon ha il punteggio più alto in entrambe le categorie: 62% nella logica visiva e 87% nella comprensione dei grafici. Si classifica inoltre al primo posto in assoluto con 74,5%, 1 punto davanti a gemini-3.7-flash e claude-opus-5.5 (73,5% ciascuno). Si tratta di una differenza di 2 domande su 200, quindi i primi tre sono separati da poche domande l'uno dall'altro.
- gemini-3.5-flash-lite (36,5%) e llama-4-maverick (38,5%) sono ultimi in assoluto a causa della logica visiva. Rispondono correttamente rispettivamente al 22% e al 19% di queste domande, mentre claude-haiku-4.5 risponde al 20%. Tutti e tre sono vicini al 20% che si ottiene tirando a caso con cinque opzioni. Nei grafici gli stessi tre modelli si classificano ultimi anche qui, con un punteggio dal 51% al 61%.
Confronto tra costi e latenza
Domande del benchmark su dove gli LLM eccellono e hanno maggiori difficoltà
Domanda sui grafici con il tasso di successo più basso degli LLM
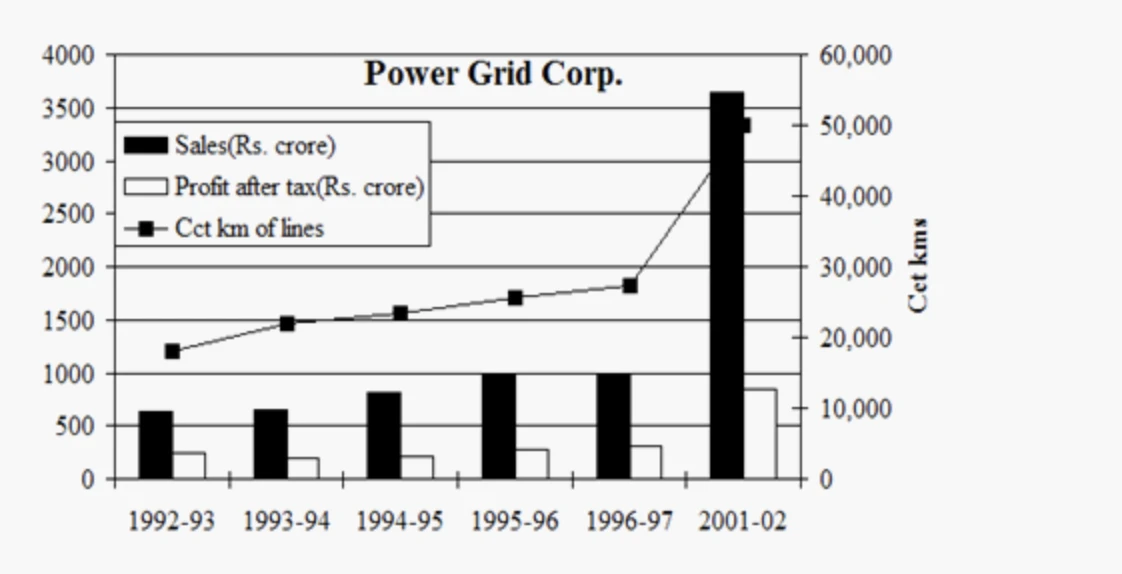
Figura 1: Grafico a barre di Power Grid Corp. che mostra Vendite (barre nere) e Profitto al netto delle imposte (barre bianche) per gli anni 1992-93, 1996-97 e 2001-02, con una linea per i chilometri di circuito delle linee su un secondo asse y.
Nota: tutti i grafici sono stati ottenuti da Hitbullseye.1
Domanda: La redditività (Profitto / Vendite) è più alta nel: A. 1992-93 B. 1993-94 C. 2001-02 D. 1996-97
Nessuno dei 40 modelli ha risposto correttamente (la risposta è D, 1996-97) e 38 di loro hanno scelto il 1992-93. Il calcolo è una singola divisione per anno, quindi la difficoltà sta nella lettura del grafico.
Le barre del profitto sono piccole e bianche, solo poche centinaia di crore su un asse 0-4.000 con griglie ogni 500. Le differenze tra gli anni si riducono a pochi pixel. Il secondo asse y e la linea sovrapposta aggiungono confusione. I modelli hanno dovuto confrontare queste barre bianche corte con barre nere molto più alte, e un piccolo errore di lettura dell'altezza delle barre era sufficiente per cambiare la risposta.
Domanda sui grafici con il tasso di successo più alto degli LLM
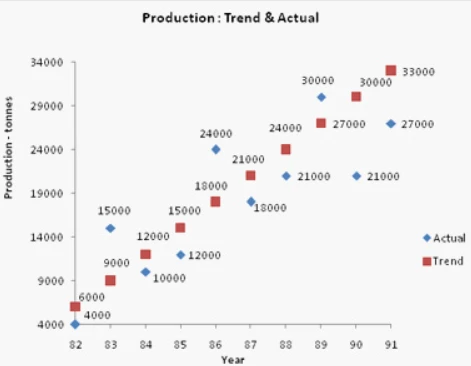
Figura 2: Grafico a dispersione che mostra la produzione effettiva e di trend (in tonnellate) dal 1982 al 1991. I rombi blu indicano i valori effettivi, i quadrati rossi indicano i valori di trend e ogni punto è etichettato con il proprio valore.
Domanda: Il trend è stato stabilito come: A. La produzione di quest'anno è una volta e mezza quella dell'anno scorso. B. La produzione di quest'anno è il doppio di quella dell'anno scorso. C. La produzione di quest'anno è tremila tonnellate in più rispetto a quella dell'anno scorso. D. La produzione di quest'anno è quattromilacinquecento tonnellate in più rispetto a quella dell'anno scorso.
Tutti i modelli hanno risposto correttamente a questa domanda. I punti del trend aumentano della stessa quantità ogni anno (6.000, 9.000, 12.000 e così via fino a 33.000). Poiché ogni punto riporta il proprio valore come etichetta, i modelli hanno potuto leggere i numeri direttamente invece di stimare le posizioni rispetto all'asse.
Il grafico Power Grid richiedeva di confrontare le altezze di barre piccole. Qui non è necessaria alcuna stima delle altezze: le etichette forniscono valori esatti e l'unico passaggio rimasto è una semplice sottrazione.
Domanda di logica visiva con il tasso di successo più alto degli LLM
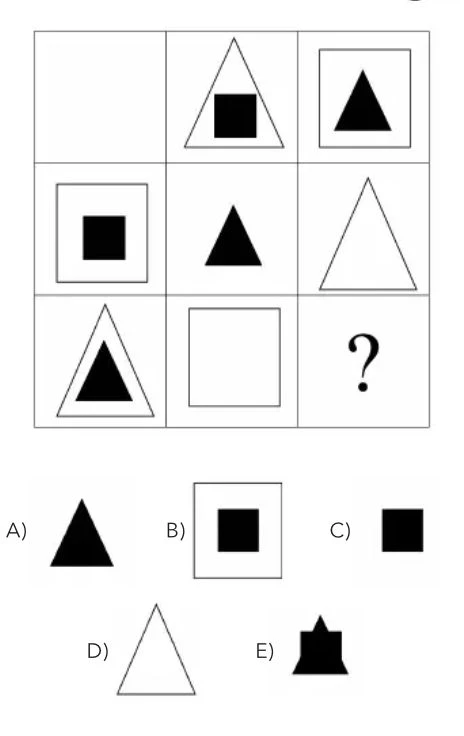
Figura 4: Una griglia 3×3 in cui ogni cella contiene un triangolo o un quadrato bianco o nero, da solo o annidato l'uno dentro l'altro. La cella in basso a destra è mancante e vengono fornite cinque opzioni.
Domanda: Quale opzione completa la griglia?
38 dei 40 modelli hanno risposto correttamente (la risposta è C, un quadrato nero). Solo claude-haiku-4.5 e llama-4-maverick l'hanno sbagliata. Ogni riga e colonna contiene un triangolo bianco, un quadrato bianco, un triangolo nero e un quadrato nero esattamente una volta. Il pezzo mancante può quindi essere trovato elencando ciò che è già presente.
Nella griglia di esagoni, la regola dipendeva da come le forme erano suddivise in regioni. Qui ogni elemento è una forma separata e disegnata chiaramente che i modelli possono identificare e contare.
Domanda di logica visiva con il tasso di successo più basso degli LLM
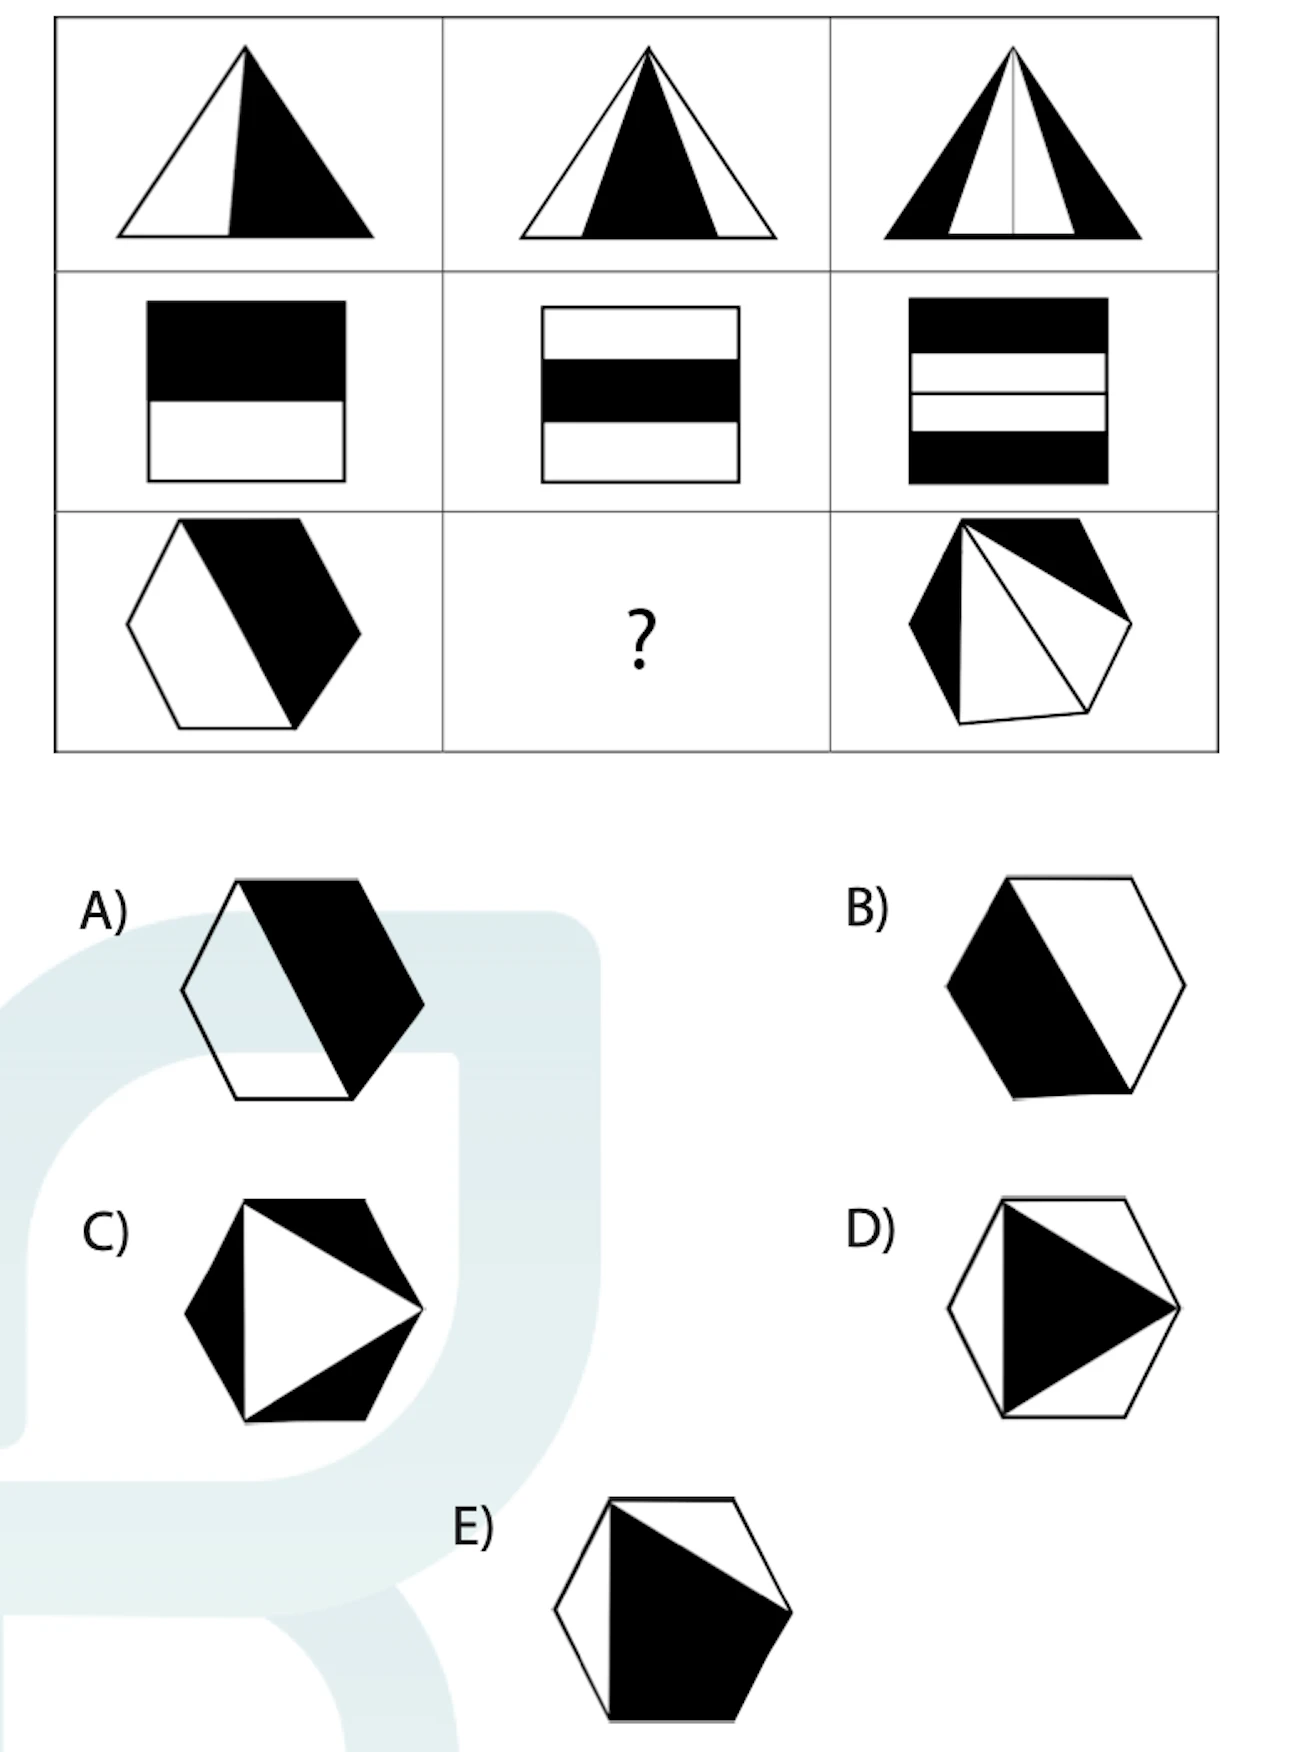
Figura 3: Una griglia 3×3 di forme: triangoli nella prima riga, rettangoli nella seconda ed esagoni nella terza. Ogni forma è divisa in regioni nere e bianche e l'esagono centrale è mancante. Vengono forniti cinque esagoni come opzioni.
Domanda: Quale opzione completa la griglia?
Nessuno dei 40 modelli ha risposto correttamente. La domanda non presenta numeri o calcoli; l'unico compito è vedere come cambiano le regioni nere e bianche in ogni riga.
Metodologia di benchmark
Abbiamo valutato 40 modelli con capacità visive su 200 domande a scelta multipla basate su immagini.
- Ragionamento: Ogni modello è stato impostato sul massimo sforzo di ragionamento supportato (max, xhigh o high, a seconda del modello). Per alcuni modelli non è stato accettato alcun parametro di sforzo di ragionamento, quindi si è applicato il valore predefinito del provider:
- gemini-3.1-pro-preview, gemini-3.6-flash, gemini-3.7-flash, gemini-3.8-flash, gpt-5.2-pro e qwen3.8-flash hanno comunque ragionato per impostazione predefinita. claude-haiku-4.5 e gemini-3.5-flash-lite non hanno prodotto alcun token di ragionamento. kimi-k2.5 ha ragionato solo su 34 delle sue 200 chiamate.
- Temperatura: Non impostata, quindi si è applicato il valore predefinito di ciascun provider.
- Token massimi: Impostati su 1.000.000 affinché la lunghezza dell'output non limitasse il ragionamento. Se un provider rifiutava questo valore, veniva utilizzato il limite massimo di output del modello.
- Esecuzioni: Ogni domanda è stata eseguita una volta per ciascun modello, per un totale di 7.600 chiamate.
- Tentativi: Le chiamate non riuscite sono state ritentate fino a 3 volte, a distanza di 60 secondi. Su 4 domande di logica visiva, muse-wonder non ha mai restituito una risposta: il suo provider ha chiuso la connessione dopo circa 6.5 minuti a ogni tentativo. Queste 4 domande vengono considerate errate, quindi nessuna domanda è stata esclusa.
- Costo e latenza: Il costo è il costo fatturato riportato dal gateway per ogni chiamata. La latenza è la durata della chiamata riuscita, esclusi i tempi di attesa dei tentativi.
Il benchmark consisteva in 200 domande suddivise in due categorie: Comprensione dei grafici (100 domande) e Logica visiva (100 domande). Le domande sui grafici inviano il grafico come immagine, con la domanda e le opzioni come testo. Le domande di logica visiva inseriscono l'intera domanda, incluse le opzioni, all'interno dell'immagine. La maggior parte delle domande sui grafici ha quattro opzioni (89 su 100) e le restanti ne hanno cinque o meno. Le domande di logica visiva hanno cinque opzioni (A-E).
Domande:
- Comprensione dei grafici (100 domande). Abbiamo valutato la capacità dei modelli di extract, interpretare e analizzare le informazioni dalle visualizzazioni dei dati:
- Grafici a barre (40): grafici a barre singoli, raggruppati e a doppio asse
- Grafici a dispersione (26): lettura di valori e trend da punti etichettati
- Grafici a torta (14): distribuzioni percentuali e ragionamento proporzionale
- Grafici a linee (10): trend a serie singola e multipla nel tempo
- Visualizzazioni combinate (10): un grafico mostrato insieme a un secondo grafico o a una tabella di dati
- Logica visiva (100 domande). Abbiamo valutato il ragionamento astratto e l'intelligenza spaziale attraverso:
- Riconoscimento di schemi: identificazione di sequenze e completamento di schemi visivi
- Ragionamento spaziale: trasformazioni di forme e sovrapposizione di figure
- Logica matematica: schemi numerici, ragionamento algebrico e calcolo combinatorio
- Pensiero astratto: manipolazione di simboli, deduzione logica e inferenza di regole
 Aggiungi come fonte preferita
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Confronta i modelli di IA multimodali sul ragionamento visivo}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/visual-reasoning}},
  note   = {AIMultiple. Consultato il 14 ottobre 2026}
}Risultati e timestamp di 22.9 mila punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 4 file CSV e un README.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
6 aggiornamentiAggiornato il numero di modelli benchmark nella sezione benchmark di ragionamento visivo.
Sostituita l'impostazione del parametro max tokens nella metodologia di benchmark.
Collegamenti di riferimento




Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.