


Agentes de IA locais: Goose, Observer IA, AnythingLLM

Os agentes de IA locais são frequentemente descritos como offline, no dispositivo ou totalmente locais. Passamos três dias mapeando o ecossistema de agentes de IA locais que funcionam de forma autônoma em hardware pessoal sem depender de APIs ou serviços em nuvem.
Nossa análise categoriza as principais soluções em três áreas-chave, com base em testes práticos em agentes de desenvolvimento, ferramentas de automação e assistentes de produtividade.
Categorização de agentes de IA locais
Categoria | Ferramentas/Frameworks | Casos de uso primários (Local / Offline) |
|---|---|---|
Agentes de desenvolvimento e sistema | Goose, Localforge, Devika, Roo Code (Boomerang Mode), Continue.dev, Cursor, CodeGenie, SuperCoder, Aider, Cline, Kilo Code | Codificação local, depuração, automação de arquivos/processos, tarefas locais de DevOps |
Agentes locais de automação e controle | Observer IA, Browser-Use, DeepBrowser | Controle local do navegador, automação de arquivos, interação com aplicativos, fluxos de trabalho no dispositivo |
Agentes de conhecimento e produtividade | AnythingLLM (Desktop), LocalGPT (Single-User), PrivateGPT | Perguntas e respostas de documentos offline, sumarização, pesquisa local/RAG |
Veja as descrições das categorias.
1. Agentes de desenvolvimento e sistema
*Tipos de execução:
- Totalmente local: A ferramenta é executada nativamente no hardware pessoal usando runtimes locais. Ferramentas capazes de operar totalmente offline.
- Local híbrido: O model principal ou a execução da tarefa ocorre localmente, mas alguns recursos, como integração ao IDE, indexação de contexto, sincronização ou raciocínio, ainda dependem de serviços em nuvem ou APIs.
** Explicação da coluna na máquina:
- Totalmente no dispositivo: Operação offline completa: inferência, raciocínio e execução ocorrem localmente.
- Inferência local, com auxílio da nuvem: O model principal é executado localmente, mas os recursos de IDE ou gerenciamento usam serviços online.
- Execução local, raciocínio remoto: O código é executado localmente, mas APIs externas alimentam as etapas de raciocínio ou planejamento.
Goose
Goose é um agente de desenvolvimento de código aberto projetado para operar totalmente em hardware local.1
Principais capacidades:
- Usa runtimes de LLM locais para raciocínio e geração de código
- Executa tarefas de várias etapas, como escrita, teste e depuração de código
- Interage diretamente com o sistema de arquivos local e as ferramentas de desenvolvimento
- Não requer conectividade de rede quando configurado com models locais.
O Goose atende a uma definição estrita de agente autônomo local, pois a observação, o raciocínio e a ação ocorrem no dispositivo.
Roo Code(Boomerang Mode)
O Roo Code é um assistente de codificação integrado ao IDE com ênfase no refinamento iterativo.
- O modo Boomerang permite a execução local de ações
- O raciocínio geralmente depende de models baseados na nuvem
- Os recursos de coordenação e gerenciamento do IDE não são totalmente locais
Como resultado, o Roo Code deve ser classificado como um agente de desenvolvimento híbrido com supervisão humana, em vez de um sistema totalmente local.
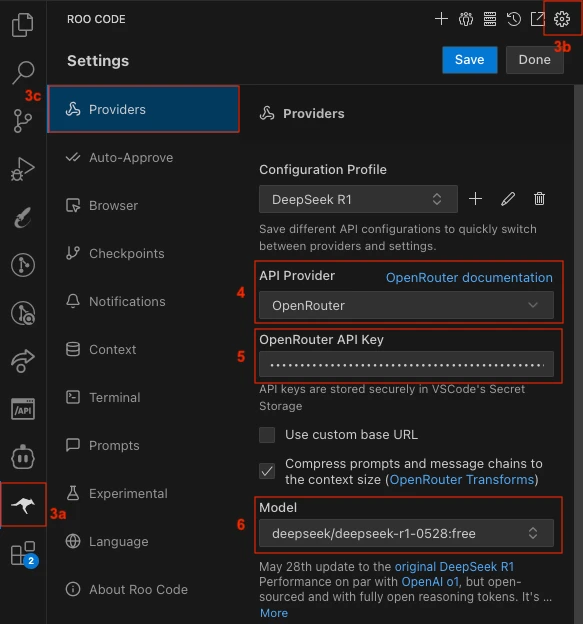
Configuração de agente de IA local no Roo Code:
O Roo Code permite que os desenvolvedores criem perfis de configuração personalizados que definem como ele se conecta a diferentes models de IA, incluindo LLMs hospedados localmente.
Em Configurações → Provedores, você pode adicionar perfis por meio do OpenRouter ou de outros provedores compatíveis e, em seguida, escolher um model local executado via Ollama ou LM Studio.
Cada perfil de configuração pode armazenar seus próprios parâmetros, incluindo temperatura, profundidade de raciocínio e limites de tokens. Isso permite alternar entre models leves na nuvem e runtimes totalmente locais para inferência no dispositivo.
Cursor
O Cursor permite o uso de LLMs locais para inferência, mas continua dependente de serviços em nuvem para:
- Indexação de código
- Aplicação de edições
- Coordenação de fluxo de trabalho
Portanto, o Cursor oferece suporte à inferência local, mas não a um ciclo de agente totalmente local, e não pode operar offline.
Como usar um LLM local no Cursor:
Fonte: Logan Hallucinates2
Aider
O Aider é um assistente de codificação de IA de código aberto, baseado em linha de comando, projetado para trabalhar diretamente com repositórios Git locais. Ele modifica o código gerando patches e commits em vez de operar por meio de uma interface IDE.
O Aider é frequentemente usado com models hospedados na nuvem, mas:
- A própria ferramenta é executada localmente
- Quando combinado com um runtime de model local, ele pode operar totalmente no dispositivo
A capacidade offline é, portanto, condicional à escolha de model, e não intrínseca à ferramenta.
2. Agentes locais de automação e controle
Observer IA
O Observer IA é um framework de agente local de automação de código aberto.
Principais recursos:
- Executa agentes usando LLMs locais
- Observa o estado da tela via OCR ou capturas de tela
- Executa código Python por meio de um ambiente de execução embutido
- Não requer conectividade com a nuvem
O Observer IA fornece a infraestrutura para o comportamento do agente, em vez de uma política fixa de agente, e é mais bem descrito como um framework local de loop de controle.
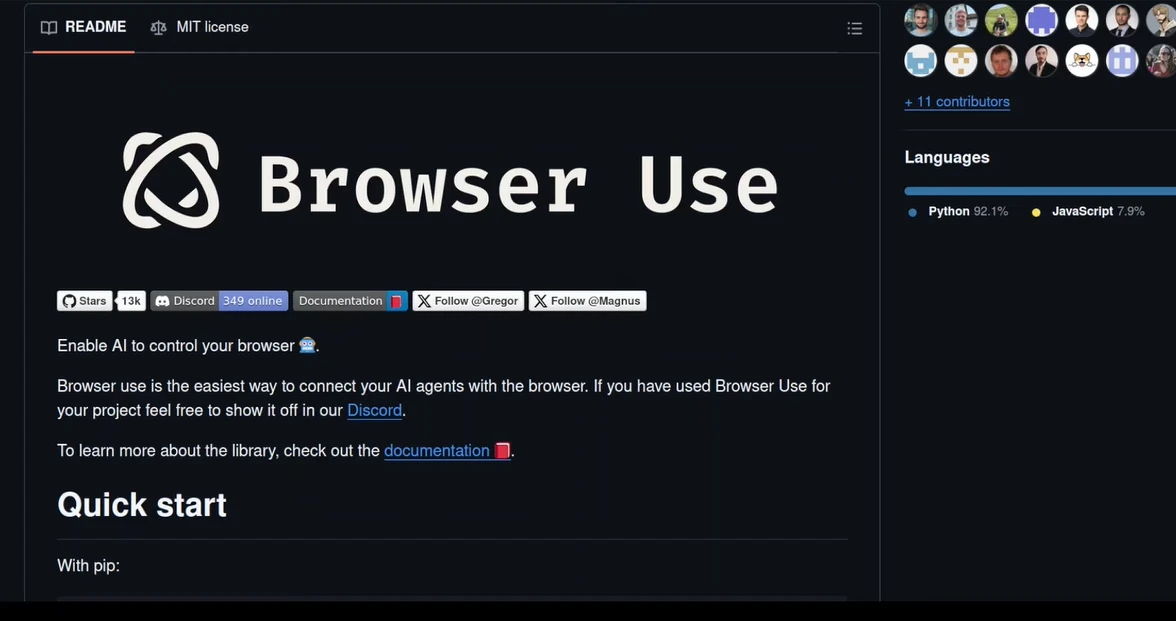
Browser-Use
O Browser-Use permite interação com o navegador orientada por IA por meio do Playwright.
- As ações do navegador são executadas localmente
- O raciocínio pode ser realizado usando models locais ou remotos
- A operação offline é possível quando combinada com inferência local
Isso coloca o Browser-Use firmemente na categoria de automação híbrida por padrão.
Como usar um LLM local no Browser-Use:
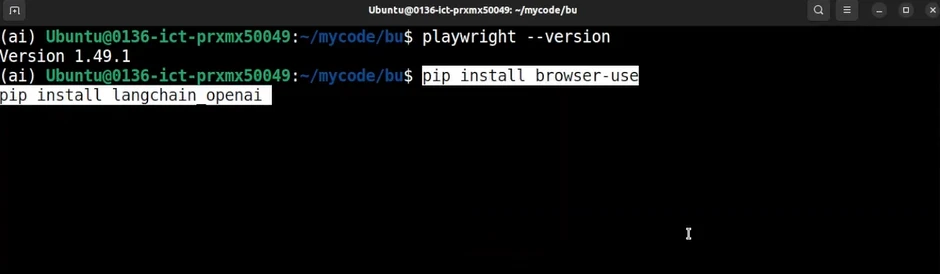
Um método para instalá-lo é usar o comando pip install browser-use, que configura tanto a interface Python quanto o controle local do navegador na mesma máquina.
Quando executado posteriormente (por exemplo, com python -m browser_use), ele abrirá e controlará uma instância do navegador localmente, executando ações e raciocínio por meio de um LLM local (por exemplo, via Ollama) ou por meio de APIs conectadas:
Configurando o Browser-Use localmente3
Para quem deseja ver a configuração completa em ação, aqui está um guia em vídeo passo a passo mostrando como instalar e executar o Browser-Use em uma máquina local:
O passo a passo cobre tudo, desde a instalação de dependências como Playwright e LangChain até a conexão do Browser-Use com um model local via Ollama.3
3. Agentes de conhecimento e produtividade
AnythingLLM (Desktop)
Quando configurado com models locais, o AnythingLLM Desktop:
- Realiza indexação de documentos localmente
- Executa o raciocínio do agente no dispositivo
- Oferece suporte a capacidades de ação limitadas (por exemplo, escrita de arquivos)
- Não requer conectividade com a nuvem
Embora sua autonomia seja limitada em comparação com agentes de sistema, ele se qualifica como um agente de produtividade local sob uma definição restrita de tarefa.
Um uso exemplar de um agente de IA local
Testamos o AnythingLLM Desktop para ver como um agente local, no dispositivo, funciona desde a configuração até o resultado final.
1. Configurando o espaço de trabalho
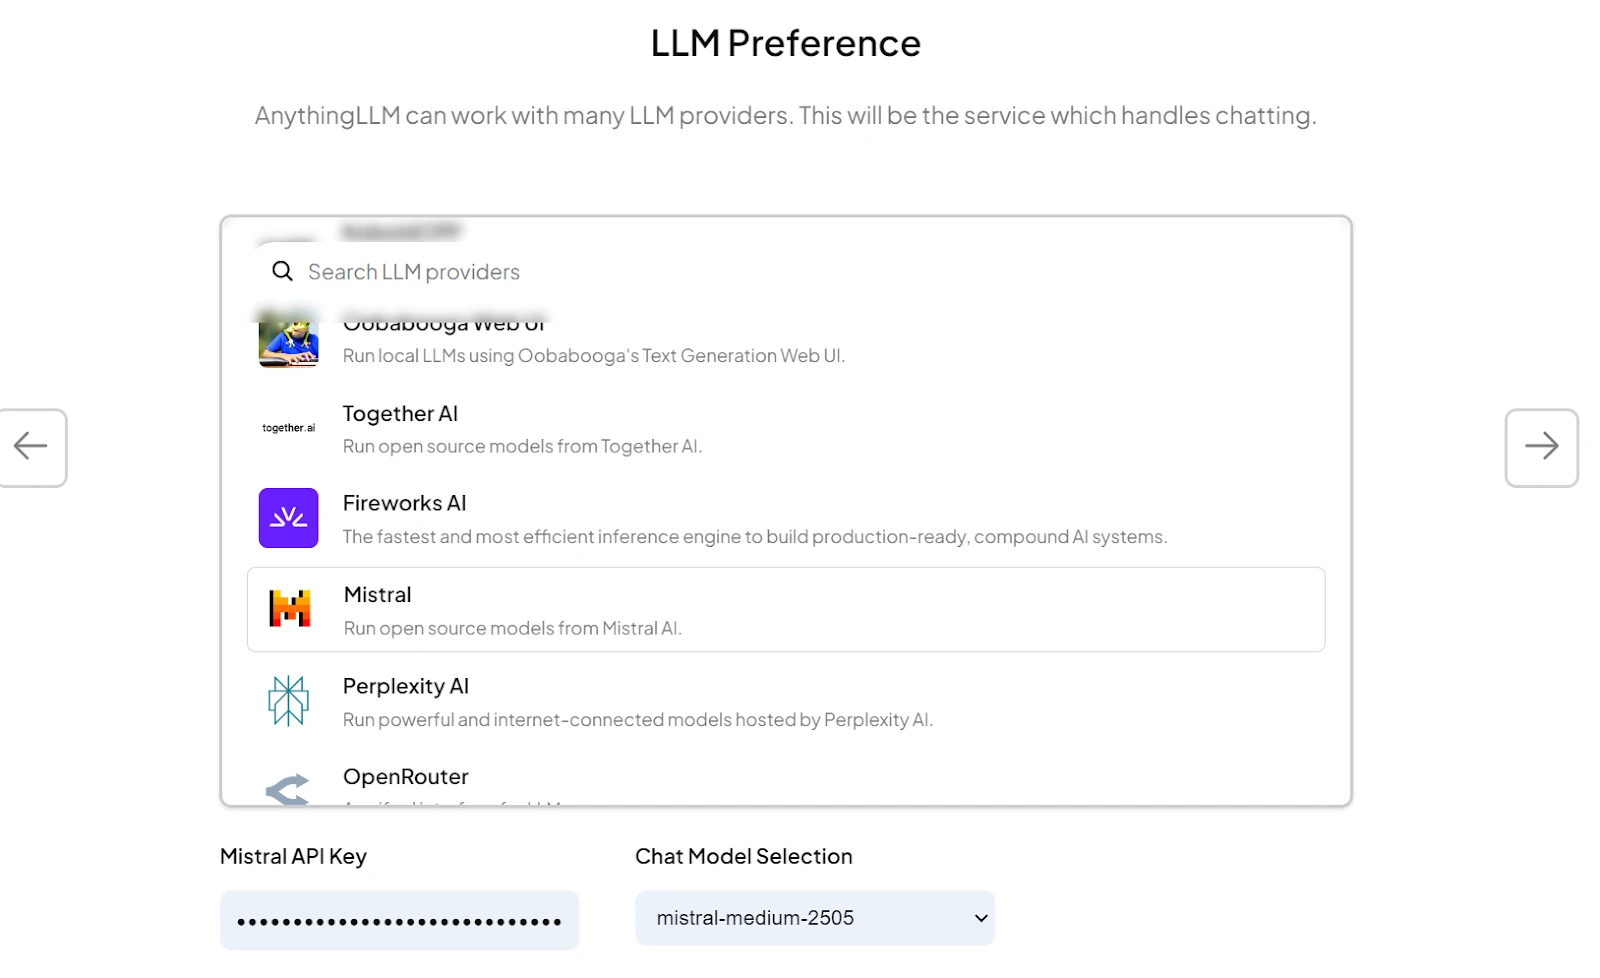
Abrimos as configurações do espaço de trabalho e fomos para Agent Configuration.
Lá, escolhemos um provedor de LLM e selecionamos o model mistral-medium-2505.
Após clicar em Update Workspace Agent, o espaço de trabalho confirmou que a configuração estava concluída.
2. Habilitando as habilidades do agente
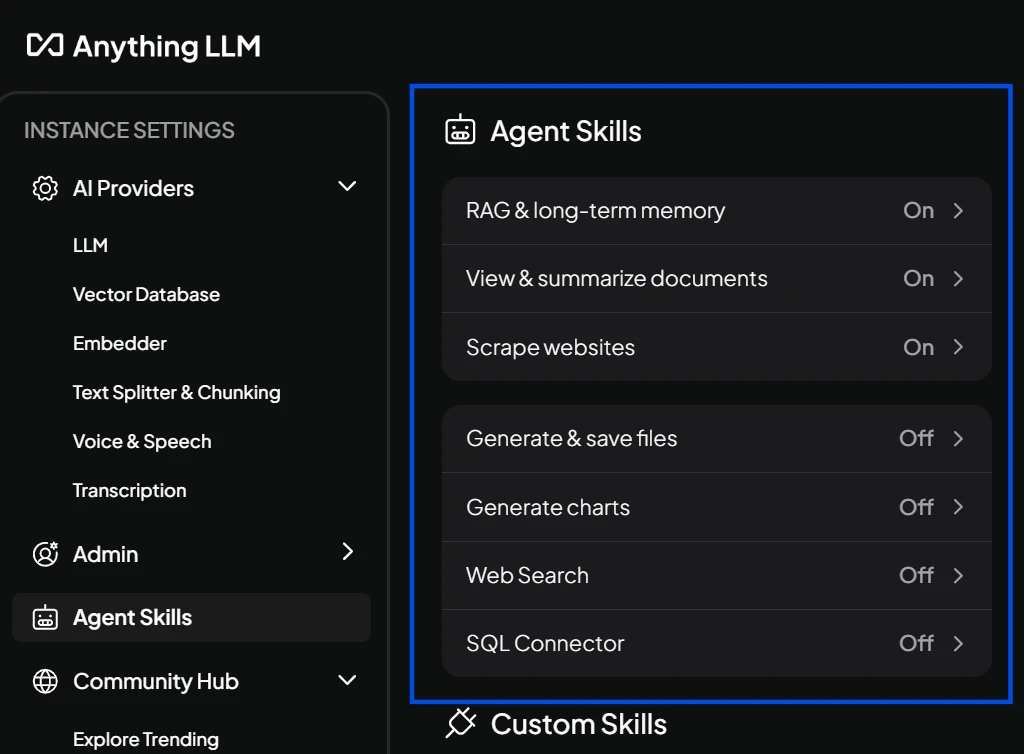
Em seguida, abrimos o painel Configure Agent Skills.
Este menu permite habilitar capacidades internas do agente com um único clique. Nenhuma codificação é necessária.
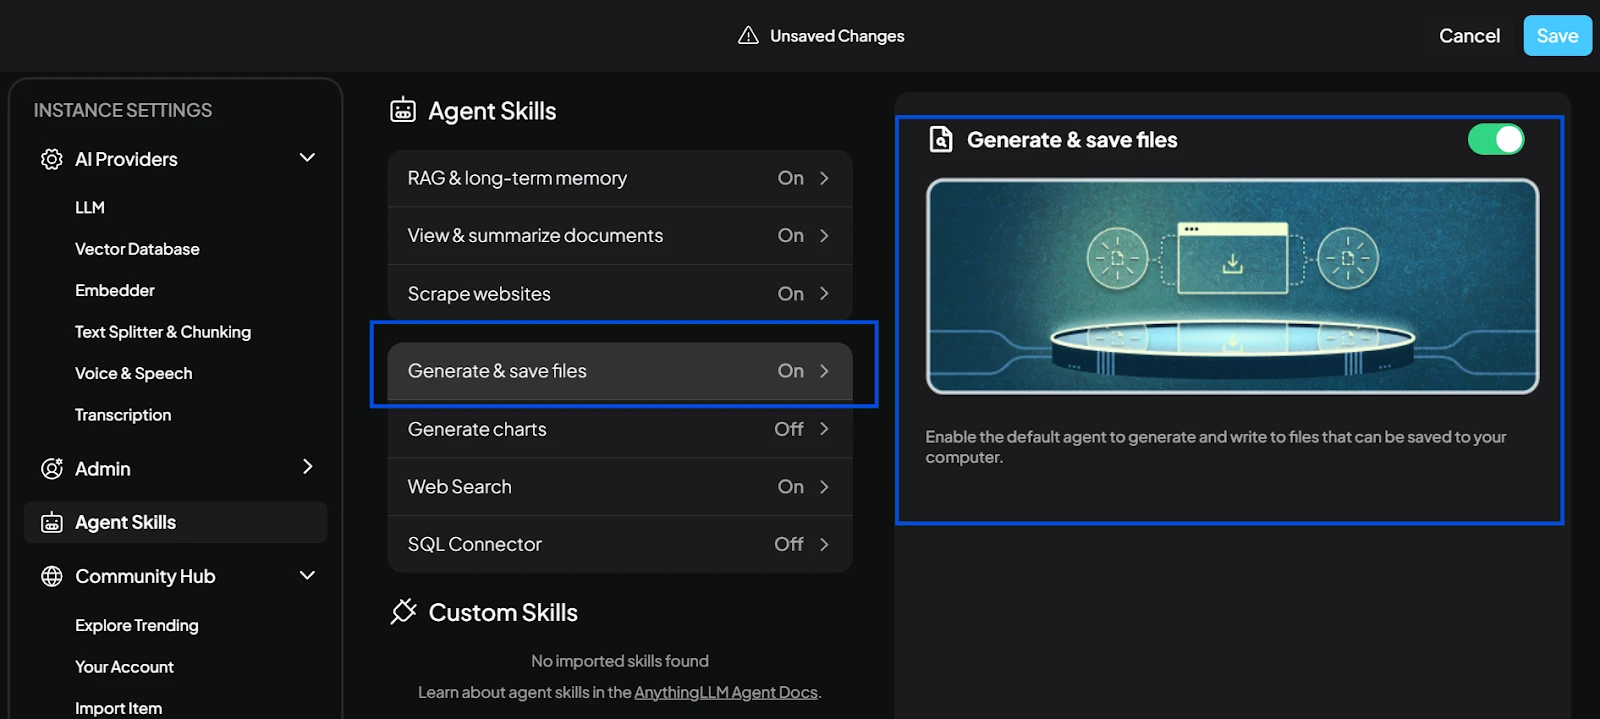
3. Testando a habilidade “Salvar Files”
Habilitamos a habilidade Salvar Files, permitindo que o agente gravasse os resultados diretamente na máquina local.
Depois de ativá-la e salvar a alteração, o agente estava pronto.
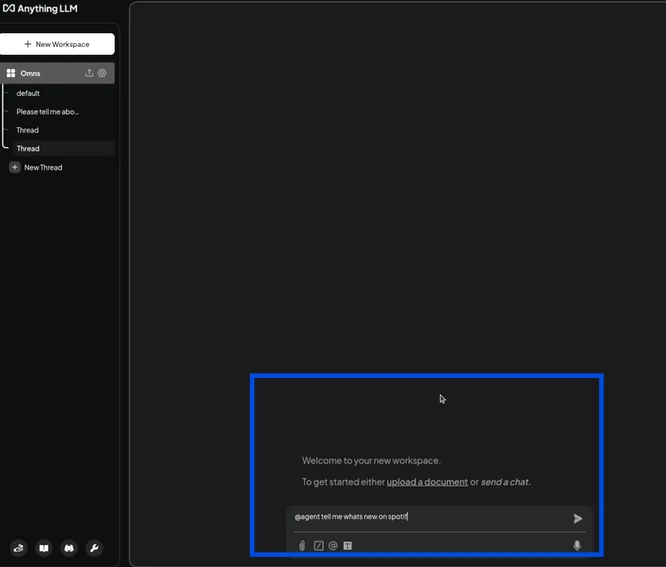
Para testá-la, voltamos à janela de chat e usamos um dos prompts de exemplo da documentação.
Isso confirmou que o agente poderia gerar um arquivo e prepará-lo para salvamento local.
4. Executando o agente no chat
Pedimos ao agente para summarize um tópico histórico e o invocamos usando @agent.
Modificamos o comando para salvar o resultado como um arquivo de texto simples em vez de um PDF.
O sistema confirmou que o modo de chat do agente estava ativo e mostrou como sair do loop.
O agente produziu o resumo e preparou o arquivo para salvamento.
5. Salvando o arquivo localmente
Para salvar o resultado, usamos o comando de exemplo da documentação do AnythingLLM:
“@agent pode salvar essas informações como um PDF na minha pasta da área de trabalho?”
Executamos a mesma estrutura no chat, mas para um arquivo de texto.
Uma janela do navegador de arquivos abriu, e salvamos o resultado no dispositivo.
O arquivo apareceu na pasta Downloads, indicando que todo o processo — raciocínio, execução e salvamento — foi realizado totalmente no dispositivo.
Descrições das categorias de agentes de IA locais
- Agentes de desenvolvimento e sistema (camada de ação): Agentes executados diretamente no seu dispositivo para realizar tarefas de codificação, sistema e automação de fluxo de trabalho localmente.
- Agentes locais de automação e controle: Agentes que automatizam ações do mundo real em sua máquina controlando o navegador, a UI ou o SO.
- Agentes de conhecimento e produtividade: Assistentes locais para chat, sumarização e manipulação de documentos sem enviar dados para a nuvem.
Camadas arquiteturais na pilha de agente local
- Camada de ação (agentes): Sistemas que observam o estado, invocam ferramentas e atuam no ambiente local.
- Camada de raciocínio e orquestração (frameworks): Bibliotecas como LangGraph ou LlamaIndex que oferecem suporte a planejamento, memória e coordenação. Elas não são agentes em si.
- Camada de execução (runtimes locais): Runtimes de model, como Ollama ou LM Studio, que permitem inferência local.
Hardware: o que os agentes locais realmente precisam
O model e o framework são metade da história. O hardware decide o que é realmente possível. Para executar language models localmente, dois números são mais importantes: quanta memória você tem e quão rápida é essa memória.
RAM (ou VRAM) define o teto do tamanho do model
Um model precisa caber na memória antes de poder ser executado. Um guia aproximado para models quantizados de 4 bits: um model 3B precisa de cerca de 2 GB, um model de 7–8B precisa de cerca de 5–6 GB, um model 13B precisa de cerca de 8–10 GB, e um model 70B precisa de cerca de 40–48 GB. Adicione folga para o contexto, o SO e qualquer outro aplicativo em execução. Na prática, a memória é o gargalo com mais frequência do que a computação e, em PCs Copilot+, o alvo recomendado para uso confortável de LLM local é de pelo menos 32 GB de RAM.4
A largura de banda da memória define a velocidade
Depois que um model cabe, a rapidez com que ele gera tokens depende principalmente da rapidez com que o sistema consegue ler os pesos do model na memória. É por isso que a alta largura de banda de memória do Apple Silicon (até 800 GB/s no M4 Max) é a vantagem prática para a inferência de LLM, e não o número de neural engines.5
Os TOPS da NPU importam menos do que o marketing sugere
Uma unidade de processamento neural é um chip projetado para cálculos de IA, e sua classificação é dada em TOPS (trilhões de operações por segundo). A certificação Copilot+ PC da Microsoft exige pelo menos 40 TOPS. Esse limite é voltado para os recursos no dispositivo da própria Microsoft (legendas ao vivo, efeitos de imagem, Recall), em vez de executar um LLM no estilo chat. Para cargas de trabalho de LLM, a RAM e a largura de banda dominam. O desempenho da NPU é um critério de desempate útil, não o número principal.
Uma regra prática:
- Para models assistentes da classe 3B, um laptop atual com 16 GB de memória unificada ou RAM é suficiente.
- Para models de 7–8B com velocidade confortável, busque 32 GB de RAM e alta largura de banda de memória. Apple Silicon, Snapdragon X-series e PCs Copilot+ atuais com Intel/AMD funcionam; as diferenças aparecem em tokens por segundo, não em se o model é executado.
- Para models maiores (30B e acima), as opções se dividem. O Apple Silicon com muita memória (configurações Mac Studio ou MacBook Pro com 64–192 GB de memória unificada) pode executar models grandes que nenhuma GPU discreta de consumo consegue acomodar. A alternativa é uma estação de trabalho com uma ou mais GPUs discretas de alta VRAM. Ambos os caminhos funcionam; eles têm perfis de custo e energia diferentes.
 Adicionar como fonte preferencial
Orientação prática
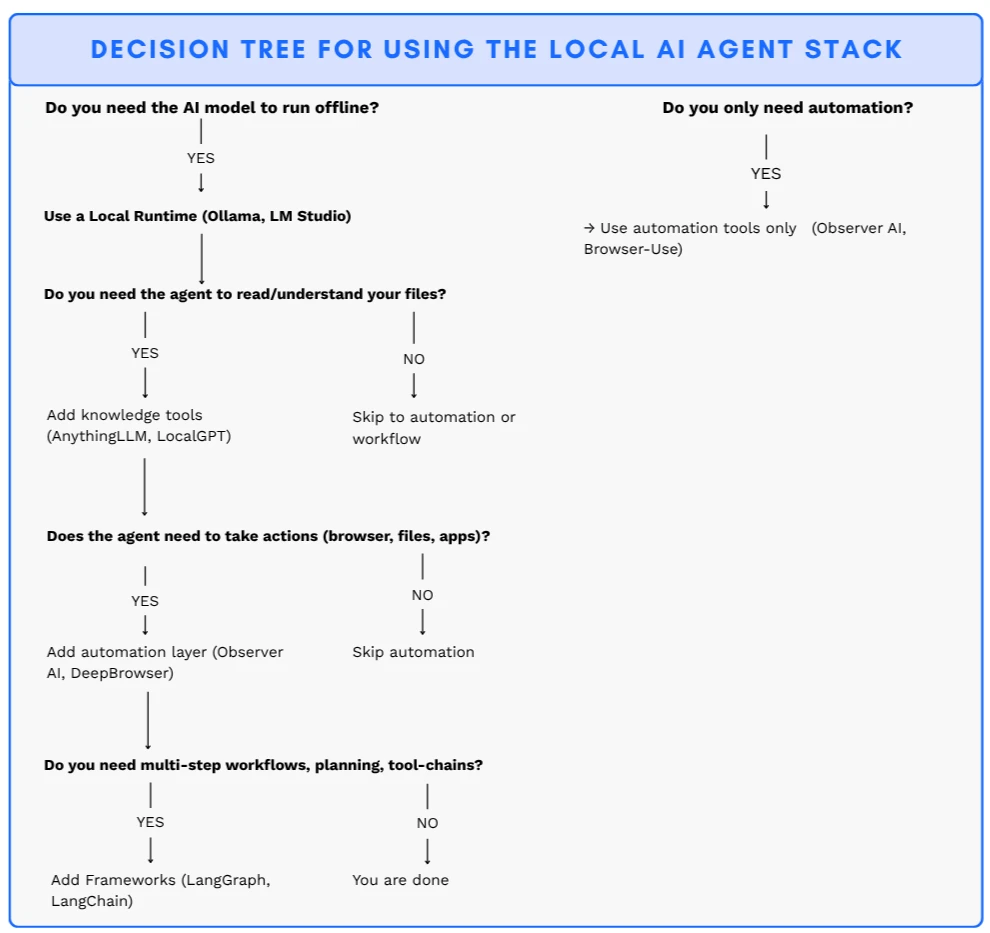
Os sistemas de IA locais devem ser montados incrementalmente:
- Comece com um runtime local se a inferência offline for necessária.
- Adicione uma camada de conhecimento quando a compreensão de documentos for necessária.
- Introduza agentes de automação ou controle quando ações do mundo real forem necessárias.
- Use frameworks de orquestração para fluxos de trabalho complexos e de várias etapas.
Na maioria dos casos, uma pilha totalmente em camadas é desnecessária.
Como abordar a pilha de agente de IA local
Comece com o menor conjunto de camadas que seu caso de uso exige. Se seu agente precisar de raciocínio offline, comece com um runtime local como Ollama ou LM Studio. Se ele precisar entender seus arquivos, adicione uma camada de conhecimento, como AnythingLLM ou LocalGPT. Para agentes que precisam realizar ações (abrir aplicativos, controlar o navegador, gerenciar arquivos), adicione uma camada de automação local. Use frameworks como LangGraph ou LlamaIndex quando precisar de fluxos de trabalho de várias etapas, loops de planejamento ou toolchains complexas.
Por que executar um agente localmente
Privacidade é uma questão legal, não uma preferência
Sob o Digital Omnibus, as obrigações de alto risco do EU IA Act agora se aplicam a partir de 2 de dezembro de 2027 para sistemas autônomos (Anexo III) e a partir de 2 de agosto de 2028 para IA em produtos regulamentados; as obrigações de transparência nos termos do Artigo 50 se aplicam desde 2 de agosto de 2026.6 As penalidades podem chegar a €15 milhões ou 3% do faturamento anual global. Um model executado em seu próprio hardware processa dados em seu ambiente, sem transmiti-los a um provedor de nuvem. O risco de transferência transfronteiriça de dados desaparece.7
Latência
Chamadas de API na nuvem adicionam 200–500ms de atraso de rede antes de o primeiro token aparecer. A inferência no dispositivo reduz isso para menos de 20ms. Para agentes de voz, conclusão de código e qualquer coisa que toque uma UI em tempo real, essa é a diferença entre fluido e lento
Custo em volume
As chamadas na nuvem são baratas por solicitação e caras em volume. Um model local tem um custo fixo de hardware e nenhuma cobrança por token. O trade-off ainda é real: os agentes locais são limitados pelo model que cabe na memória e pelo hardware disponível. As próximas seções abordam ambos.
Perguntas frequentes
Os agentes de IA locais operam de forma autônoma em hardware pessoal sem depender de APIs externas ou infraestrutura em nuvem.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Agentes de IA locais: Goose, Observer IA, AnythingLLM}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/local-ai-agent}},
  note   = {AIMultiple. Acessado em 30 julho 2026}
}Resultados e carimbos de data/hora de 19 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 4 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
3 atualizaçõesAdicionadas as seções "Por que executar um agente localmente" e requisitos de hardware local.
Removidas as seções 'Frameworks' e 'Local runtimes & infrastructure'.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

A seguir, leia
Benchmark de Plataformas de Agentes de IA: Claude Managed Agents vs Google Vertex Agent Engine

Como criar agentes pessoais de IA + 18 plataformas e ferramentas de agentes

Construindo Agentes de IA com Padrões Componíveis


Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.