


OCR Benchmark: Extração de Texto / Precisão de Captura
OCR A precisão do OCR é essencial para muitas tarefas de processamento de documentos, e os LLMs multimodais de última geração (SOTA) agora estão oferecendo uma alternativa ao OCR. Fizemos o benchmark dos principais serviços de OCR no DeltOCR Bench para identificar seus níveis de precisão em diferentes tipos de documentos:
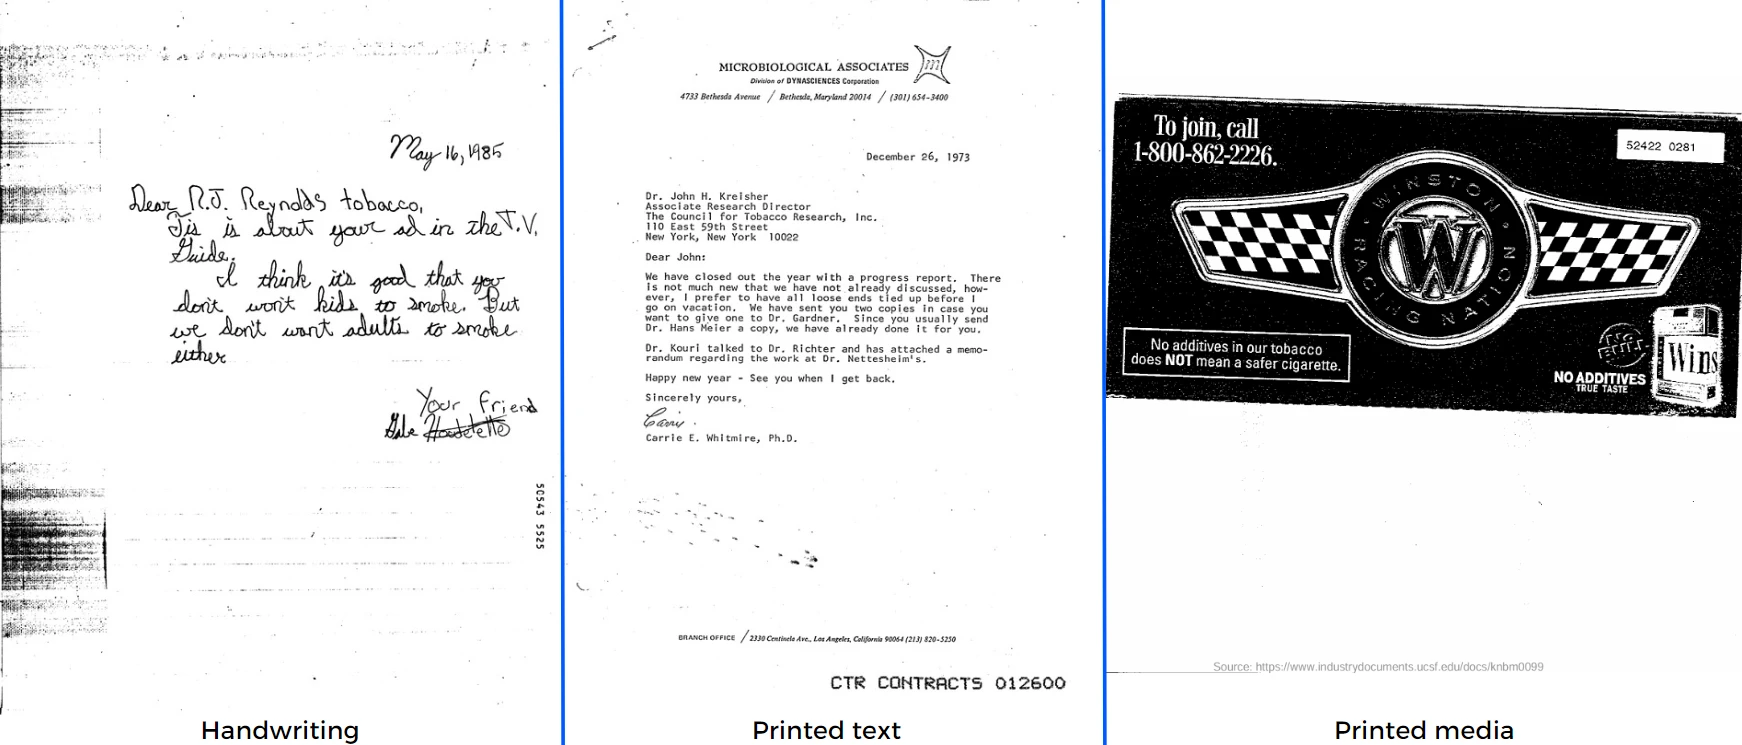
- Escrita à mão: GPT-5 (95%) se destaca como o modelo mais forte, seguido de perto por olmOCR-2-7B (94%) e Gemini 2.5 Pro (93%).
- Mídia impressa: Gemini 2.5 Pro, Google Vision e Claude Sonnet 4.5 lideram esta categoria com a maior pontuação (85%)
- Texto impresso: Microsoft Azure Document Intelligence API lidera com uma pontuação de 96%.
OCR Benchmark: DeltOCR Bench
Os nomes completos dos produtos acima e suas versões em uso em novembro de 2025 estão listados abaixo. Nosso estudo abrange tanto serviços de API facilmente acessíveis quanto soluções que exigem infraestrutura local, comparando os principais modelos do mercado em um ambiente de teste aprofundado.
- Escrita à mão:
- Faixa de precisão: uma ampla faixa de 46% a 95%.
- Destaques: GPT-5 (95%), olmOCR-2-7B (94%) e Gemini 2.5 Pro (93%) apresentam o desempenho mais alto. Essas pontuações altas demonstram o extraordinário potencial de precisão dos LLMs multimodais, como GPT-5 e Gemini 2.5 Pro, nesse domínio.
- Recomendação: para reconhecer manuscritos altamente complexos, as principais soluções de LLM, como GPT-5 ou Gemini 2.5 Pro, são recomendadas devido à acessibilidade de sua API e à facilidade de integração.
- Mídia impressa:
- Faixa de precisão: uma faixa de 54% a 85%.
- Destaques: soluções como Gemini 2.5 Pro, Google Vision e Claude Sonnet 4.5 compartilham a maior pontuação (85%). Esta categoria é altamente competitiva entre LLMs e serviços tradicionais de OCR baseados em nuvem (Azure, Dots OCR, Amazon Textract). O GPT-5 fica atrás de outros LLMs líderes nesta categoria (77%).
- Recomendação: para documentos com layouts visuais complexos (várias fontes, baixa resolução etc.), recomenda-se LLMs como Gemini 2.5 Pro, ou serviços baseados em nuvem como Google Vision, ou Microsoft Azure Document Intelligence API.
- Texto impresso:
- Faixa de precisão: uma faixa alta de 55% a 96%, embora a maioria das soluções líderes tenha alcançado pontuações de 94% ou mais.
- Destaques: Microsoft Azure Document Intelligence API (96%) assume a liderança, seguido de perto por soluções como GPT-5, Gemini 2.5 Pro, Gemini 3 Pro Preview, Google Vision e Amazon Textract, todas com pontuação de 95%. Esta categoria é uma área em que todas as soluções SOTA alcançam níveis extremamente altos de precisão.
- Recomendação: para textos impressos simples que exigem alta precisão, soluções de nuvem estabelecidas como Microsoft Azure Document Intelligence API ou Google Vision, ou LLMs de alta pontuação (Gemini/GPT-5), podem ser usadas com confiança.
Soluções de API
Os modelos a seguir foram incluídos em nossa lista de benchmark devido tanto à facilidade de acesso quanto ao desempenho.
- Claude Sonnet 4.5
- OpenAI GPT-5
- Gemini 2.5 Pro
- Gemini 3 Pro Preview
- Amazon Textract API
- Google Cloud Vision API
- Microsoft Azure Document Intelligence API
- Moondream OCR
- Mistral OCR 3
- Mistral OCR 2
Microsoft Azure Document Intelligence API faz parte da família Azure Cognitive Services.
Modelos implantados localmente
Testar esses modelos é mais desafiador do que as soluções de API devido à instalação, ao gerenciamento de dependências e aos requisitos de hardware. Todos os testes locais foram realizados em um ambiente de servidor dedicado.
- olmOCR-2-7B
- PaddleOCR-VL
- Nanonets-OCR2-3B
- Deepseek-OCR
- Dots-OCR
Calculamos a precisão dos resultados como a pontuação de similaridade de cosseno para texto impresso, mídia impressa e escrita à mão. Cada pontuação visível no gráfico representa o desempenho do modelo correspondente naquela categoria.
Durante nossos testes, observamos que o modelo Nanonets-OCR2-3B apresentou o desempenho mais fraco no benchmark, alcançando as pontuações mais baixas. De modo geral, descobrimos que alguns modelos tiveram dificuldades especialmente com caligrafia cursiva e layouts de texto desorganizados (ordenação de linhas misturada, capitalização inconsistente). Problemas de desempenho semelhantes também surgiram na categoria de mídia impressa, especialmente com imagens de baixa resolução e aquelas contendo vários estilos de fonte.
Dataset
Usamos um total de 300 documentos neste benchmark, com 100 documentos por categoria em 3 categorias:
Texto impresso inclui cartas, capturas de tela de sites, e-mails, relatórios etc.
Mídia impressa inclui pôsteres, capas de livros, anúncios etc. Nosso objetivo era ver o sucesso das ferramentas de OCR em diferentes fontes de texto e posicionamentos.
Os Files nessas 2 categorias foram obtidos da Industry Documents Library (IDL).1
Escrita à mão: Na categoria de manuscritos, como alguns documentos do IDL não eram fáceis de ler, nossa equipe gerou documentos semelhantes aos documentos do IDL. Preparamos manualmente amostras de escrita legível por humanos. Todas as amostras estavam em estilo de caligrafia cursiva.
Metodologia do DeltOCR Bench
Este benchmark se concentra na precisão da extração de texto dos produtos.
O pré-processamento é realizado somente para a categoria de escrita à mão. Tiramos fotos de documentos manuscritos com nossos smartphones e usamos um aplicativo de scanner móvel:
- As fotos foram convertidas para preto e branco
- O contraste foi aumentado e o fundo foi removido.
OCR: Executamos todos os produtos no mesmo dataset e geramos saídas de texto como arquivos de texto bruto (.txt). Em seguida, preparamos manualmente a verdade de referência incluindo o texto correto em todos esses arquivos. A verdade de referência foi verificada duas vezes por humanos.
Comparação: Medimos a precisão das soluções de OCR comparando suas saídas com os textos originais. Para isso, usamos o framework Sentence-BERT (SBERT) para calcular as pontuações de similaridade de cosseno. No benchmark, usamos o modelo multilingue de paráfrase de alto desempenho, MiniLM-L12-v2, para calcular a pontuação de similaridade entre a saída de cada produto e os textos de referência. Essa pontuação representa o nível de precisão do texto.
A função de similaridade usa a métrica de distância de cosseno para calcular a similaridade entre dois textos. Não usamos a distância de Levenshtein para este benchmark porque diferentes produtos geram textos em ordens diferentes.2
Embora a distância de Levenshtein leve em conta essas diferenças, estamos apenas avaliando a precisão com que o texto é detectado, e não onde ele está localizado. A distância de cosseno tem penalidades insignificantes para esses casos, então decidimos usá-la neste benchmark.
Seleção de produtos
Existem muitos produtos de OCR no mercado. Precisamos nos concentrar naqueles que podem gerar resultados de texto bruto. Os produtos para este benchmark são escolhidos com base em:
- Capacidade de extract texto. Não incluímos soluções que apenas extract dados legíveis por máquina (ou seja, dados estruturados) nesta comparação
- Sua popularidade no mercado
Esta não é uma análise de mercado abrangente e podemos ter excluído alguns produtos com capacidades significativas. Se for o caso, deixe um comentário e teremos prazer em expandir o benchmark.
Limitações
Capacidades avançadas, como detecção de localização de texto, pareamento chave-valor e classificação de documentos, não foram avaliadas neste benchmark.
O tamanho da amostra será aumentado na próxima iteração. Se você está procurando OCR para manuscritos, veja nosso benchmark de OCR para manuscritos com 50 amostras.
Perguntas frequentes
Reconhecimento Óptico de Caracteres (OCR) é um campo de aprendizado de máquina especializado em distinguir caracteres em imagens como documentos digitalizados, livros impressos ou fotografias. Embora seja uma tecnologia madura, ainda não existem produtos de OCR que consigam reconhecer todos os tipos de texto com 100% de precisão. Entre os produtos que avaliamos, apenas alguns conseguiram produzir resultados bem-sucedidos em nosso conjunto de teste.
As ferramentas de OCR são usadas por empresas para identificar textos e suas posições em imagens, classificar documentos empresariais de acordo com os assuntos ou realizar pareamento chave-valor dentro de documentos. Com base nos resultados de OCR, outras empresas de tecnologia criam aplicações como automação de documentos. Para todos esses casos de negócio, o reconhecimento preciso de texto é essencial para um produto de OCR.
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{alper2026,
  author = {Alper, Şevval},
  title  = {{OCR Benchmark: Extração de Texto / Precisão de Captura}},
  year   = {2026},
  month  = jul,
  howpublished    = {\url{https://aimultiple.com/ocr-accuracy}},
  note   = {AIMultiple. Acessado em 29 julho 2026}
}Resultados e carimbos de data/hora de 60 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 4 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
9 atualizaçõesSubstituído Azure Cognitive Service por Microsoft Azure Document Intelligence API na seção Destaques.
Links de referência
Şevval se concentra em ferramentas de codificação de IA, agentes de IA e tecnologias quânticas.




Comentários 8
Compartilhe suas ideias
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.
Did you ever think of oncluding multimodal llms in your comparison, like gpt4o, llama 3.2. gemini, claude etc.?
Hi Serhat and thank you for your comment, Yes, we added those for which we have API access like Claude and GPT-4o.
Just stumbled on this milestone assessment update. Could you kindly elaborate further on the three revised datasets: Thanks for this work. Character Sets When someone refers to 'handriting', that can mean many things: 'handwriting style' typefaces (per Docusign, etc.), and hand-printed (block printing and mixed-case printing) as often found in combs and box delineators, and finally, cursive or longhand writing (exclusive of signatures). Character Context Structured content, semi-structured content, and unstructured content. Image Qualities (bitonal, greyscale, full colour, spatial dpi, from a scanner/cell-phone/native rendering, image 'enhancements' prior to OCR (thickening, local gamma, background dropout, sharpening, smoothing, noise removal, etc.) These can have significant impacts, and some don't realize the importance of including these benchmark differentiators.
Hi there, thank you for the detailed comment, we are updating the article to include these details.
Hello, great work! Just curious, did you use a trained Tesseract when making these testing?
Hi, Webster. Glad you enjoyed the article. The tools we tested were: ABBYY FineReader 15 Amazon Textract Google Cloud Platform Vision API Microsoft Azure Computer Vision API Tesseract OCR Engine Hope this answers your question.
The graph images are not working for me at the moment. Otherwise great
Thank you Bobby! We have a glitch in the CMS and we are fixing it. Apologies for the issue, it should be fixed next week.
Thanks for sharing, can you add a free OCR for everyone to use? https://www.geekersoft.com/ocr-online.html
Hi Samsun, unfortunately, we don't share all OCR providers on this page, there are thousands of them. We tried to put together the largest ones in terms of market presence. If you have evidence that your solution is one of the top 10 globally, please share it with us at info@aimultiple.com so we can consider it.
What version of Tesseract did you test with? They recently released v5.
Hi Scott, we did the benchmarking before Tesseract 5. We will redo it soon and include the versions in the methodology section as well.
This is very informative, nice work. I assume your tests used documents/images in English? I've been experimenting with OCR tools on other languages and finding relatively poor accuracy.
Exactly, all text were in English. I hear similar things about OCR on non-Latin characters. We have an Arabic speaker in the team who claims that accuracy in Arabic is much lower compared to English. We can do a benchmark on non-Latin characters if there is demand for it.
interesting post!!! do you have any suggestion about improving accuracy on scanned image ? i'm using tesseract right now. anyway , great work!
Thank you for the comment. There are pre-processing approaches that can be implemented to improve image quality. But such approaches may already be used in Tesseract. A detailed research into Tesseract image processing would be helpful in your case.