


LLM Guia de Fine-Tuning para Empresas
Siga os links para obter soluções específicas para os desafios de saída do seu LLM. Se o seu LLM:
- Não tem acesso aos fatos necessários no seu domínio: treine um novo LLM, mude para um específico do domínio ou use RAG para recuperar fatos.
- Tem fatos relevantes, mas precisa responder em um estilo e tom diferentes, seguir determinados formatos de saída ou usar certas ferramentas, então:
- Primeiro, use engenharia de prompt ou encadeamento de prompts para melhorar os resultados.
- Se eles não funcionarem, o LLM fine-tuning é a abordagem correta. Você pode usar o serviço do provedor de LLM ou fazer fine-tuning de LLMs open source on-prem.
A adoção generalizada dos large language models (LLMs) melhorou nossa capacidade de processar a linguagem humana. No entanto, o treinamento genérico deles geralmente resulta em desempenho abaixo do ideal para tarefas específicas.
Para superar essa limitação, métodos de fine-tuning são empregados para adaptar LLMs aos requisitos exclusivos de diferentes áreas de aplicação.
O que é o fine-tuning de LLM?
O fine-tuning de um large language model ajusta um model pré-treinado para executar tarefas específicas ou atender a um domínio específico de forma mais eficaz. O processo envolve treinar ainda mais o model em um dataset menor e direcionado, relevante para a tarefa ou assunto desejado.
O large language model original é pré-treinado em grandes quantidades de dados de texto diversos, o que o ajuda a aprender compreensão geral da linguagem, gramática e contexto. O fine-tuning aproveita esse conhecimento geral e refina o model para obter melhor desempenho e compreensão em um domínio específico.
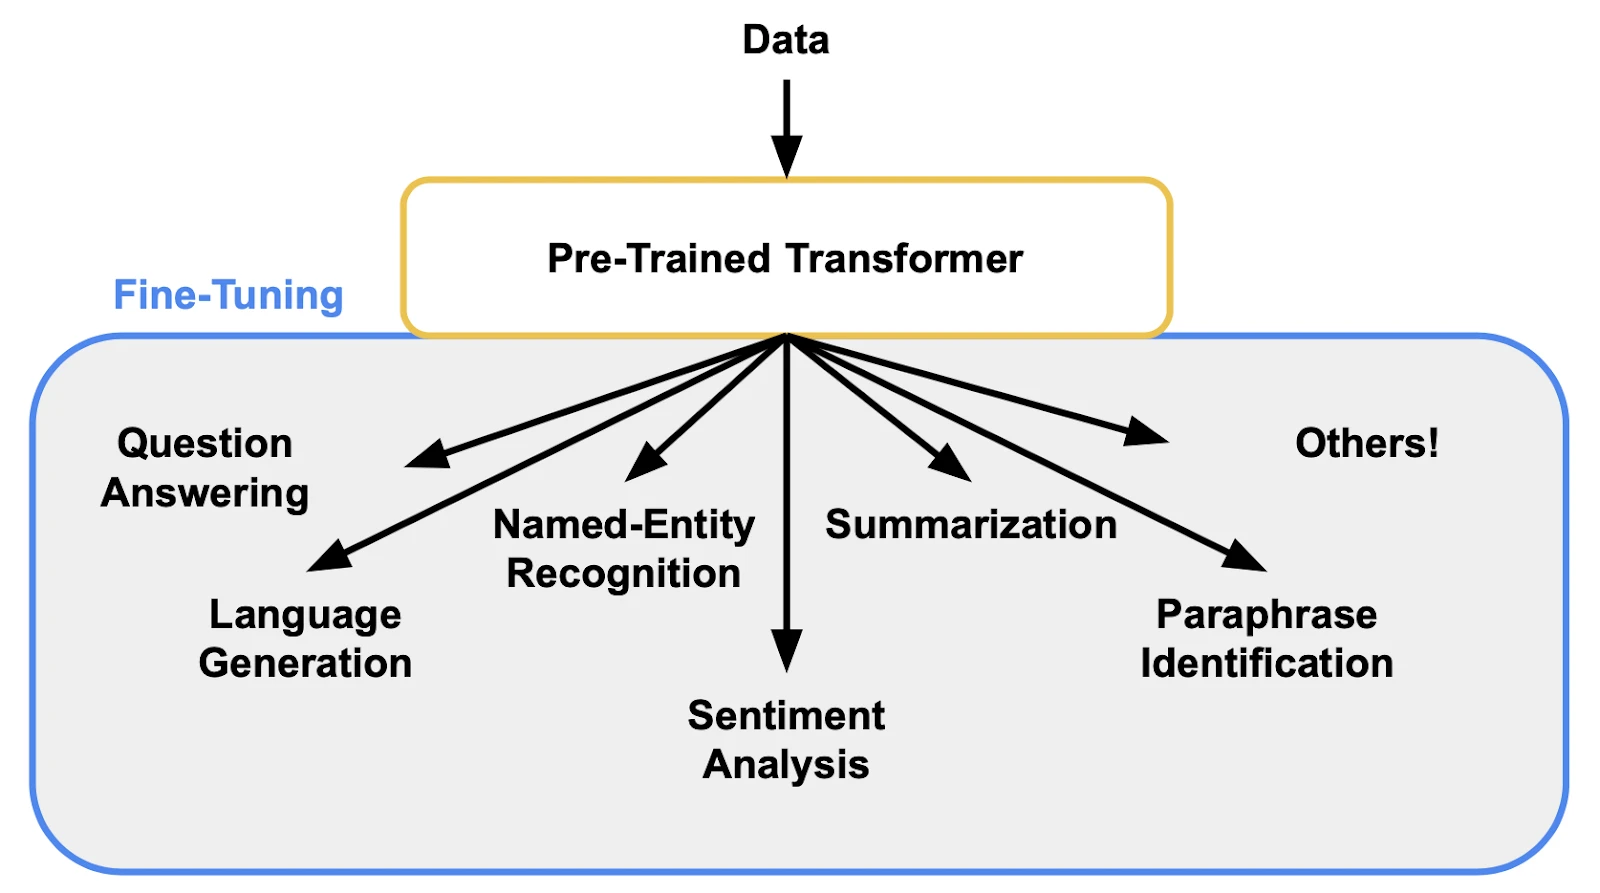
Figura 2: Capacidades de um LLM após o fine-tuning.1
Por exemplo, um large language model pode ser fine-tuned para tarefas como análise de sentimentos em avaliações de produtos, prever preços de ações com base em notícias financeiras ou identificar sintomas de doenças em textos médicos.
Esse processo personaliza o comportamento do model, permitindo que ele gere resultados mais precisos e contextualmente relevantes para tarefas como:
- Análise de sentimentos.
- Desenvolvimento de chatbot.
- Resposta a perguntas.
Como fazer fine-tuning de LLMs
1. Preparando o dataset
Como os LLMs são pré-treinados em um dataset fixo, eles não estão cientes de eventos em tempo real. Para manter esses models atualizados e melhorar seu desempenho em tópicos específicos e em evolução, as empresas usam dados da web em tempo real. Esses dados são essenciais por dois motivos principais: ajudam no alinhamento de domínio e reduzem a alucinação.
1.1. Alinhamento e relevância de domínio:
Usar dados obtidos da web permite que as empresas façam fine-tuning de LLMs com as informações mais atuais e relevantes para seu setor. Por exemplo, uma empresa de tecnologia jurídica poderia usar web crawlers para coletar decisões judiciais recentes e blogs jurídicos.
Esses dados específicos do domínio garantem que o model fine-tuned entenda a terminologia atualizada e o contexto do setor, que muitas vezes está ausente dos datasets públicos estáticos. Esse processo é fundamental para tornar um model pré-treinado de uso geral um especialista em um campo específico.
1.2. Reduzindo a alucinação:
Alucinação ocorre quando um LLM gera informações plausíveis, mas factualmente incorretas. Ao fazer fine-tuning de um LLM com dados do mundo real de alta qualidade da web, você fornece a ele uma fonte confiável de verdade.
Isso torna o model menos propenso a inventar informações durante a inference e o ajuda a gerar respostas mais precisas e confiáveis.
As empresas usam ferramentas internas de web scraping ou provedores terceirizados para coletar dados de sites. Esses dados de treinamento coletados são então preparados e usados para fazer o fine-tuning do LLM.
Ao incorporar continuamente novos dados da web, as empresas podem garantir que seus models fine-tuned permaneçam relevantes e precisos, proporcionando uma vantagem competitiva significativa.
2. Escolhendo um foundation model e um método de fine-tuning
A seleção do model base e do método de fine-tuning apropriados depende da tarefa específica e dos dados disponíveis. Existem vários provedores de LLM para escolher, incluindo Alphabet e Meta, cada um com seus próprios pontos fortes e fracos. O método de fine-tuning também pode variar de acordo com a tarefa e os dados, como transfer learning, fine-tuning sequencial ou fine-tuning específico da tarefa.
Ao escolher o model base, você deve considerar:
- Se a infraestrutura técnica é adequada ao poder de computação necessário para o fine-tuning
- Se o model se adapta à sua tarefa específica
- Tamanho de entrada e saída do model
- O tamanho do seu dataset
3. Fine-tuning
O fine-tuning adapta LLMs pré-treinados a tarefas específicas ou necessidades organizacionais, seja por meio de serviços gerenciados oferecidos por provedores de model, seja pela modificação direta de models open source usando dados específicos da tarefa e ferramentas de MLOps.
Fine-tuning como serviço para models de código fechado
Os principais provedores de LLM oferecem fine-tuning gerenciado, embora o cenário tenha mudado em 2026. Google (Gemini via Vertex AI) e Anthropic (Claude via Amazon Bedrock) continuam sendo as principais opções de código fechado para novas cargas de trabalho de fine-tuning. OpenAI, que historicamente oferecia fine-tuning em models GPT, está encerrando sua plataforma de fine-tuning, o que significa que está fechada para novos usuários, e os usuários existentes têm uma janela limitada para criar novos trabalhos de treinamento.2
Por exemplo, o Vertex AI oferece suporte a várias abordagens de tuning de model, permitindo aos desenvolvedores flexibilidade na forma como personalizam o comportamento do model além do fine-tuning básico:
- Fine-tuning supervisionado: Treine um model com exemplos rotulados para que ele aprenda a produzir as saídas desejadas para tarefas específicas.
- Preference tuning: Uma abordagem de tuning distinta que se baseia no fine-tuning supervisionado usando dados de preferência humana para ensinar os models a gerar saídas mais preferidas com base em feedback pareado, em vez de rótulos explícitos.
- Checkpoints de tuning & tuning contínuo: Ferramentas para salvar o progresso ou estender um model tuned existente com mais dados ou passagens de treinamento.3
Preço: O fine-tuning gerenciado geralmente é precificado por token de treinamento, com a inference precificada separadamente com um valor adicional sobre o model base.
Fine-tuning de models open source
Como os pesos do model estão disponíveis em models open source, as empresas podem fazer fine-tuning de models open source on-prem sem expor seus datasets aos provedores de LLM.
As etapas para fazer fine-tuning de models open source incluem:
- Carregar o model pré-treinado: Uma vez selecionados o LLM e o método de fine-tuning, o model pré-treinado precisa ser carregado na memória.
- Esta etapa inicializa os pesos do model com base nos valores pré-treinados, o que acelera o processo de fine-tuning e garante que o model tenha aprendido a compreensão geral da linguagem.
- Fine-tuning envolve treinar o LLM pré-treinado no dataset específico da tarefa. O processo de treinamento envolve otimizar os pesos e parâmetros do model para minimizar a função de perda e melhorar seu desempenho na tarefa.
O processo de fine-tuning normalmente envolve rodadas iterativas de treinamento. Para otimizar o desempenho, os desenvolvedores devem ajustar configurações como learning rate ou batch size. Ferramentas como Weights & Biases (Sweeps) automatizam essa busca de hiperparâmetros, visualizando como diferentes variáveis impactam a convergência do model para que as equipes possam selecionar a melhor configuração sem tentativa e erro manual.
Por exemplo, os models Llama podem passar por fine-tuning de forma econômica com abordagens de Parameter Efficient Fine Tuning (PEFT).4
As empresas podem aproveitar suas plataformas de MLOps ou plataformas de LLMOps para fazer fine-tuning de models.
Por exemplo, usar uma plataforma que atua como sistema de registro (como Weights & Biases) permite que as empresas rastreiem cada execução de treinamento, registrem métricas do sistema (uso de GPU) e versionem os checkpoints de model resultantes em um registro central. Isso garante que, mesmo ao treinar models open source on-premise, o fluxo de trabalho permaneça reproduzível e colaborativo.
Fine-tuning de models open weights
Os models de pesos abertos estão publicamente disponíveis para os usuários baixarem e executarem localmente (ou em sua infraestrutura de nuvem) sem depender de uma API.
Eles diferem dos models open source porque open source normalmente implica que o código de treinamento completo, os detalhes dos dados e os termos de licenciamento permitem modificação e redistribuição. Os models de pesos abertos podem liberar os pesos, mas manter partes do pipeline de treinamento, do dataset ou dos direitos de uso restritas.
Como os pesos são acessíveis, os models de pesos abertos podem ser fine-tuned diretamente, continuando o treinamento em datasets personalizados (por exemplo, fine-tuning supervisionado, métodos LoRA/PEFT), permitindo que as organizações personalizem o comportamento enquanto mantêm os dados e a implantação totalmente sob seu controle.
Por exemplo, a família LFM2.5 da Liquid IA serve como um conjunto de foundation models de pesos abertos. Eles são lançados para implantações de IA on-device e edge IA, com checkpoints disponíveis no Hugging Face e na plataforma Liquid IA LEAP.
A série inclui variantes como LFM2.5-1.2B-Base (um model base pré-treinado) e LFM2.5-1.2B-Instruct, que recebeu fine-tuning supervisionado e reinforcement learning em seu pipeline de pós-treinamento.
Como os pesos são publicamente acessíveis, os desenvolvedores podem pegar o checkpoint base e realizar seu próprio fine-tuning: treinar o model em datasets proprietários, adaptando-o a tarefas específicas de idioma ou domínio, ou experimentar outros métodos de treinamento (como fine-tuning supervisionado com adaptadores ou alinhamento de preferências).
O LFM2.5 é altamente adequado para personalização específica de tarefas em hardware local ou dispositivos edge, onde controlar o fluxo de trabalho de treinamento e inference é importante.5
Outro exemplo é o Tinker do Thinking Machines Lab, que é uma API projetada para tornar o fine-tuning de language models de pesos abertos mais acessível para pesquisadores e desenvolvedores.
O Tinker permite que os usuários adaptem uma ampla variedade de models de pesos abertos, de arquiteturas menores a grandes models mixture-of-experts como Qwen-235B-A22B. Os usuários podem aplicar fine-tuning baseado em LoRA ou outros métodos de pós-treinamento para adaptar models a tarefas específicas, seja por meio de aprendizado supervisionado ou abordagens do tipo reinforcement.
Após o tuning, os desenvolvedores podem baixar os checkpoints resultantes e usá-los de forma independente, permitindo controle sobre o model e o comportamento personalizado.6
4. Avaliando models fine-tuned
Uma vez concluído o processo de fine-tuning, o desempenho do model precisa ser avaliado no conjunto de teste. Esta etapa ajuda a garantir que o model esteja generalizando bem para novos dados e tenha um bom desempenho na tarefa específica. As métricas comuns usadas para avaliação incluem acurácia, precisão, recall e F1 score.
No entanto, para tarefas generativas, as métricas tradicionais geralmente são insuficientes. A avaliação moderna exige tracing do raciocínio do model e verificação da qualidade do texto gerado. Ferramentas como W&B Weave permitem isso ao possibilitar que os desenvolvedores rastreiem entradas e saídas, depurem prompts e executem avaliações sistemáticas (usando um LLM-as-a-judge) para pontuar o model fine-tuned em nuances como tom, fidelidade e segurança.
5. Implantação
Uma vez avaliado o model fine-tuned, ele pode ser implantado em ambientes de produção. O processo de implantação pode envolver a integração do model em um sistema maior, a configuração da infraestrutura necessária e o monitoramento do desempenho do model em cenários do mundo real.
Quais são os métodos usados no processo de fine-tuning de LLMs?
Métodos de fine-tuning
O fine-tuning é um processo que envolve adaptar um model pré-treinado a uma tarefa ou domínio específico, treinando-o ainda mais em um dataset menor e específico da tarefa. Vários métodos de fine-tuning podem ser usados para ajustar os pesos e parâmetros de um model pré-treinado e melhorar seu desempenho na tarefa alvo:
- Transfer learning envolve reutilizar os pesos e a arquitetura de um model pré-treinado para uma nova tarefa ou domínio. O model pré-treinado geralmente é treinado em um dataset grande e geral, e a abordagem de transfer learning permite uma adaptação eficiente e eficaz a tarefas ou domínios específicos.
- Fine-tuning sequencial: O model pré-treinado é fine-tuned em várias tarefas ou domínios relacionados sequencialmente. Isso permite que o model aprenda padrões de linguagem mais sutis e complexos em diferentes tarefas, levando a uma melhor generalização e desempenho.
- Fine-tuning específico da tarefa: O model pré-treinado é fine-tuned em uma tarefa ou domínio específico usando um dataset específico da tarefa. Esse método exige mais dados e tempo do que transfer learning, mas pode resultar em maior desempenho na tarefa específica.
- Multi-task learning: O model pré-treinado é fine-tuned em várias tarefas simultaneamente. Essa abordagem permite que o model aprenda e aproveite as representações compartilhadas entre diferentes tarefas, levando a melhor generalização e desempenho.
- Adapter training envolve treinar módulos leves que são conectados ao model pré-treinado, permitindo o fine-tuning em uma tarefa específica sem afetar o desempenho do model original em outras tarefas.
Reinforcement Fine-Tuning (RFT)
Reinforcement Fine-Tuning (RFT) é uma técnica de personalização de model que adapta um language model pré-treinado usando feedback orientado por recompensa em vez de exemplos de treinamento rotulados tradicionais.
Em vez de treinar com saídas fixas/corretas, o RFT usa um sinal de recompensa ou uma função de avaliador para avaliar as respostas do model e otimizar iterativamente o model para maximizar essas recompensas.
Essa abordagem tem raízes nos princípios de reinforcement learning, nos quais o model se comporta como um agente que aprende quais tipos de saídas levam a pontuações de recompensa mais altas e ajusta seus parâmetros de acordo. Ao contrário do fine-tuning supervisionado, o RFT se destaca em cenários em que saídas precisas e corretas são difíceis de definir, mas a qualidade pode ser julgada ou pontuada.
Por exemplo, a capacidade de reinforcement fine-tuning do Amazon Bedrock automatiza esse processo para que os desenvolvedores personalizem models com base em sinais de feedback (funções de recompensa).
No Bedrock, os usuários definem o que torna uma resposta precisa por meio de funções de recompensa baseadas em regras ou em IA, e o model é treinado para maximizar essas recompensas.7
Outro exemplo é o RFT da OpenAI. Ele permite que os desenvolvedores adaptem reasoning models definindo um avaliador programável que pontua respostas candidatas. Durante o treinamento, o model é atualizado para que saídas com pontuação alta se tornem mais prováveis em gerações futuras.
Isso torna o RFT particularmente útil para tarefas em que a qualidade da saída é subjetiva ou melhor julgada por pontuação do que por respostas de referência exatas.8
Método de few-shot learning
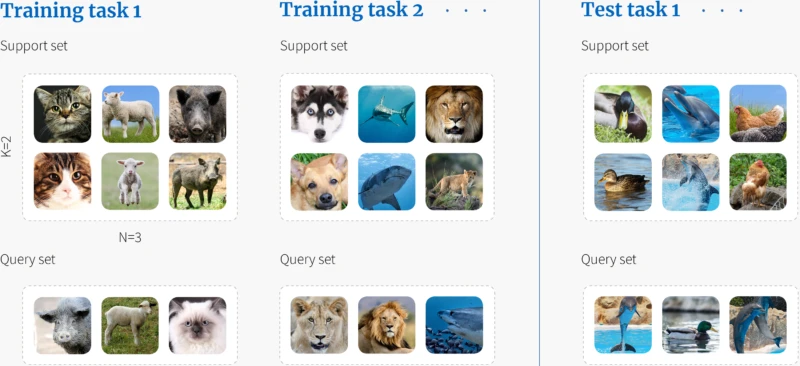
Few-shot learning (FSL) envolve melhorar o desempenho do model sem alterar seus pesos. Nessa abordagem, o model recebe um número limitado de exemplos (ou seja, “few shots”) da nova tarefa e usa essa informação para se adaptar e ter melhor desempenho nessa tarefa. Pode ser considerado como
- Uma alternativa de menor custo ao fine-tuning. O custo são os tokens de entrada de alguns exemplos.
- Um problema de Meta-learning no qual o model aprende a aprender a resolver o problema dado.
Figura 3: Cenário de few-shot learning em que o model aprende a classificar um conjunto de imagens a partir das tarefas em que foi treinado.9
Isso é particularmente útil quando não há dados suficientes disponíveis para o aprendizado supervisionado tradicional. No contexto de LLMs, o fine-tuning com um dataset pequeno relacionado à nova tarefa é um exemplo de few-shot learning.
Diferenças entre few-shot learning & fine-tuning
A principal diferença é a quantidade de dados específicos da tarefa necessária para que o model se adapte a uma nova tarefa ou domínio. Os métodos de fine-tuning exigem uma quantidade moderada de dados específicos da tarefa para otimizar o desempenho do model, enquanto os métodos de few-shot learning podem adaptar models a novas tarefas ou domínios com alguns exemplos rotulados.
Exemplos de fine-tuning
Fine-tuning alcançou aumentos significativos de desempenho em finanças
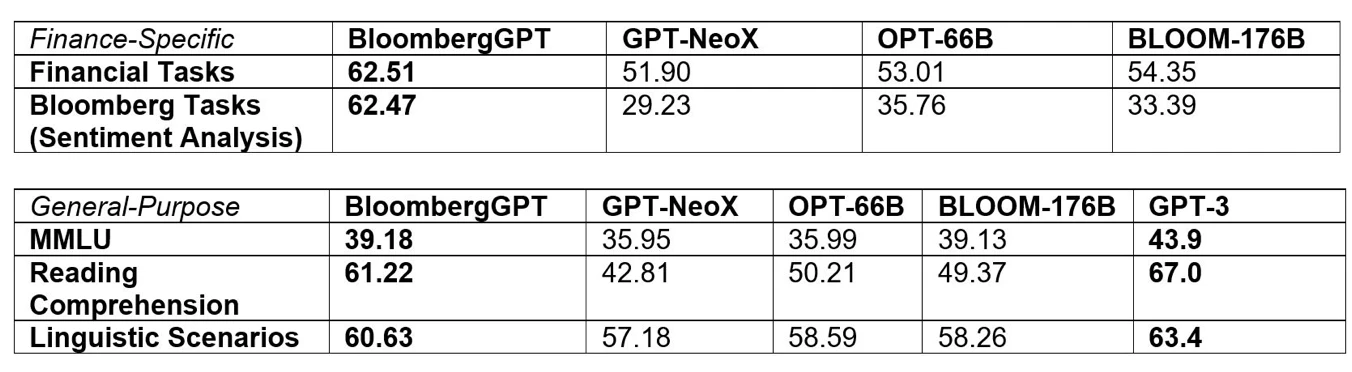
A Bloomberg desenvolveu o BloombergGPT, um large language model em grande escala adaptado para o setor financeiro. Esse model se concentra em tarefas de processamento de linguagem natural financeira, como análise de sentimentos, reconhecimento de entidades nomeadas e classificação de notícias.
O BloombergGPT foi criado usando uma combinação de datasets financeiros e de propósito geral, e levou a altas pontuações em testes de benchmark (Figura 4).
Figura 4: Imagem mostrando como o BloombergGPT se desempenha em duas categorias amplas de tarefas de NLP: específicas de finanças e de propósito geral.10
Por que ou quando sua empresa precisa de um LLM fine-tuned?
As empresas podem precisar de large language models fine-tuned por vários motivos, dependendo de seus requisitos específicos, setor e objetivos. Aqui estão alguns motivos comuns:
1. Personalização
As empresas geralmente têm necessidades e objetivos exclusivos que um language model genérico pode não atender. O fine-tuning permite que elas adaptem o comportamento do model para atender aos seus objetivos específicos, como gerar conteúdo de marketing personalizado ou entender o conteúdo gerado pelo usuário em sua plataforma.
Descubra como o fine-tuning de LLMs permite a criação de produtos e estratégias de marketing personalizados, aprimorando, em última análise, a experiência de IA generativa em varejo, marketing e seguros.
2. Sensibilidade de dados e conformidade
Empresas que lidam com dados sensíveis ou operam sob ambientes regulatórios rigorosos podem precisar fazer fine-tuning no model para garantir que ele respeite os requisitos de privacidade, siga as diretrizes de conteúdo e gere respostas apropriadas que estejam em conformidade com as regulamentações do setor.
3. Linguagem específica do domínio
Muitos setores usam jargões, termos técnicos e vocabulário especializado que podem não estar bem representados nos dados gerais de treinamento de um large language model. Fazer fine-tuning no model com dados específicos do domínio permite que ele entenda e gere respostas precisas dentro do contexto do setor da empresa.
4. Desempenho aprimorado
O fine-tuning melhora o desempenho do model em tarefas ou aplicações específicas relevantes para o negócio, como:
- Análise de sentimentos
- Classificação de documentos
- Extração de informações
Isso pode levar a melhores decisões, maior eficiência e melhores resultados.
5. Habilitando capacidades de IA agêntica
O fine-tuning é fundamental para o desenvolvimento de sistemas de IA agêntica, projetados para agir de forma autônoma, tomar decisões e interagir com ferramentas ou ambientes externos para alcançar objetivos específicos.
Ao fazer fine-tuning em um LLM, as empresas podem aprimorar sua capacidade de realizar function calling, permitindo que o model selecione e execute as ferramentas apropriadas (por exemplo, APIs, bancos de dados) com parâmetros precisos.
Por exemplo, um LLM fine-tuned pode alimentar uma IA agêntica que gerencia de forma autônoma as consultas dos clientes integrando-se a um sistema de CRM ou recupera dados em tempo real por meio de APIs da web. Essa personalização garante que o model entenda contextos específicos do domínio e interações com ferramentas, tornando a IA agêntica mais eficaz e confiável em aplicações empresariais.
6. Melhor experiência do usuário
Um model fine-tuned pode oferecer uma melhor experiência do usuário gerando respostas mais precisas, relevantes e conscientes do contexto, levando a uma maior satisfação do cliente, em aplicações como:
- Chatbots
- Assistentes virtuais
- Sistemas de suporte ao cliente
 Adicionar como fonte preferencial
O que é um large language model (LLM)?
Um large language model é um sistema avançado de inteligência artificial (IA), mais especificamente um IA generativa empresarial model, projetado para processar, entender e gerar texto semelhante ao humano com base em grandes quantidades de dados. Esses models são normalmente construídos usando deep learningtécnicas, como redes neurais. Eles são treinados em datasets extensos que incluem textos de uma ampla variedade, como livros e sites, para processamento de linguagem natural.
Um dos principais aspectos de um large language model é sua capacidade de entender o contexto e gerar respostas coerentes e relevantes com base na entrada fornecida. O tamanho do model, em termos de número de parâmetros e camadas, permite capturar relações e padrões intrincados no texto. Isso permite que ele execute várias tarefas, como:
- Responder perguntas
- Geração de texto
- Resumir texto
- Tradução
- Escrita criativa
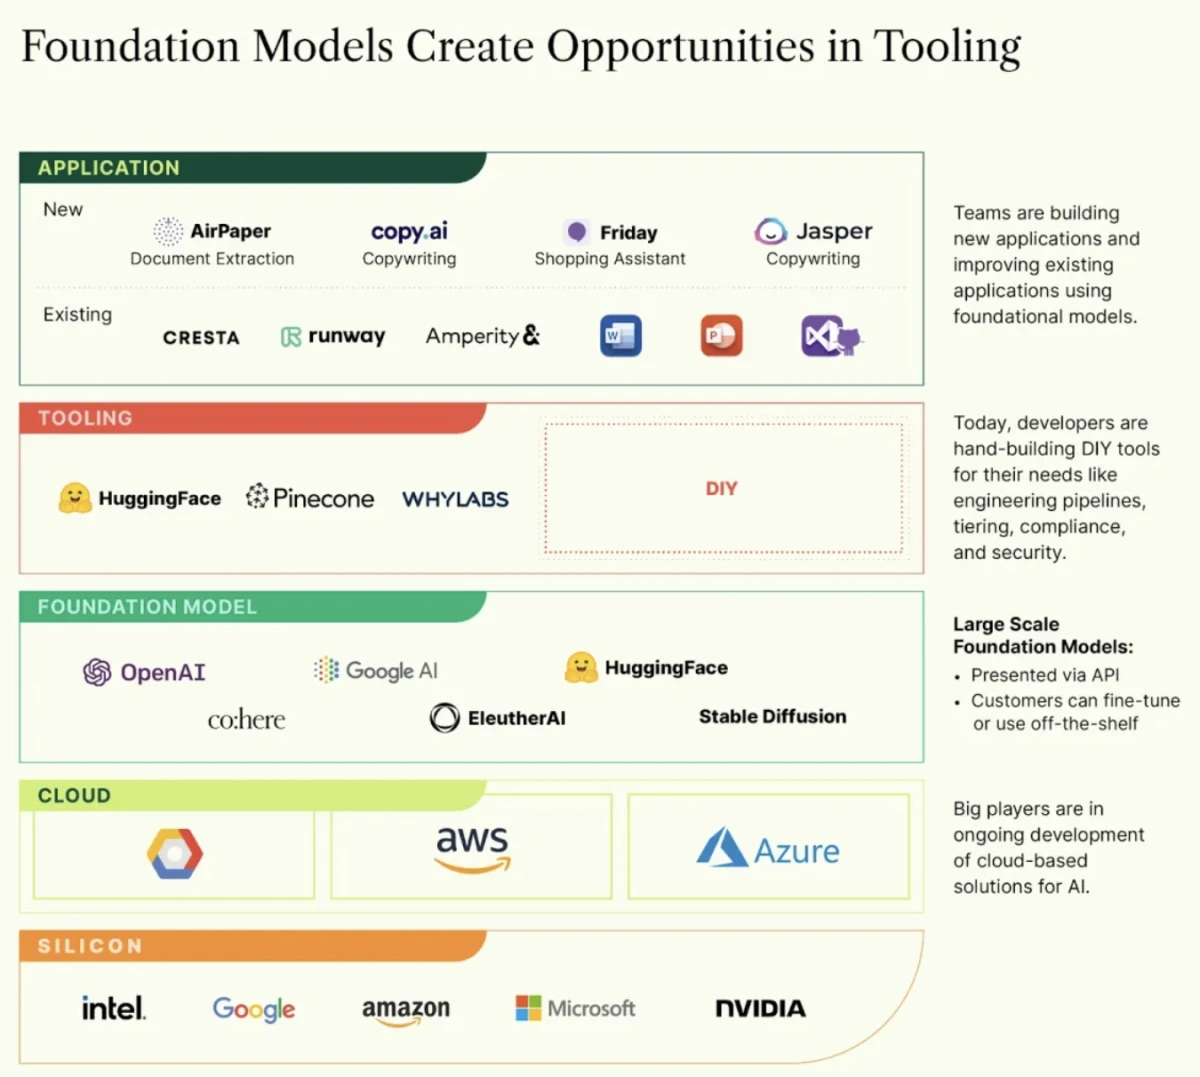
Foundation models, como large language models, são um componente central da pesquisa e das aplicações de IA. Eles fornecem uma base para a construção de models mais especializados e fine-tuned para tarefas ou domínios específicos.
Figura 5: Exemplos de foundation models.11
Leitura adicional
- Embora o fine-tuning melhore a eficácia dos large language models, é essencial abordar os Riscos da IA Generativa.
- O fine-tuning de large language models envolve considerações legais. Explore o cenário legal em torno desses sistemas avançados de IA em direitos autorais de IA generativa.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{LLM Guia de Fine-Tuning para Empresas}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/llm-fine-tuning}},
  note   = {AIMultiple. Acessado em 22 junho 2026}
}
Registro de alterações
10 atualizaçõesRemovido a OpenAI da seção de serviços de fine-tuning de código fechado, deixando Google Vertex AI e Anthropic no Bedrock.
Removida a Figura 1 da seção Introdução.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.



Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.