


O Futuro dos Grandes Modelos de Linguagem

Veja o futuro dos grandes modelos de linguagem comparando abordagens, como autotreinamento, verificação de fatos e especialização esparsa, que podem resolver as limitações dos LLM.
Tendências futuras dos grandes modelos de linguagem
1- Verificação de Fatos em Tempo Real com Dados ao Vivo
Os LLMs acessam fontes externas durante as conversas, em vez de depender dos dados de treinamento. O modelo consulta bancos de dados externos, recupera informações atuais e fornece citações.
Limitação: Ainda comete erros. As citações não garantem precisão; os modelos às vezes citam fontes incorretamente ou interpretam mal o conteúdo citado.
Microsoft Copilot: Microsoft e OpenAI anunciaram que o GPT-6 Astra está disponível no Copilot Cowork e no Copilot Studio, bem como no Microsoft Foundry e no GitHub Copilot. O agente Researcher combina o GPT para pesquisa inicial com o Claude da Anthropic revisando os resultados quanto à precisão e à qualidade das citações antes da entrega, uma melhoria de 13,8% no benchmark de pesquisa aprofundada DRACO em relação a sistemas isolados.1
- ChatGPT: Pesquisa na web quando perguntado sobre eventos recentes. Cita fontes nas respostas.
- Perplexity: Criado especificamente para busca com citações. Cada resposta inclui links das fontes.
2- Dados de treinamento sintéticos
Os modelos geram seus próprios conjuntos de dados de treinamento em vez de exigir dados rotulados por humanos.
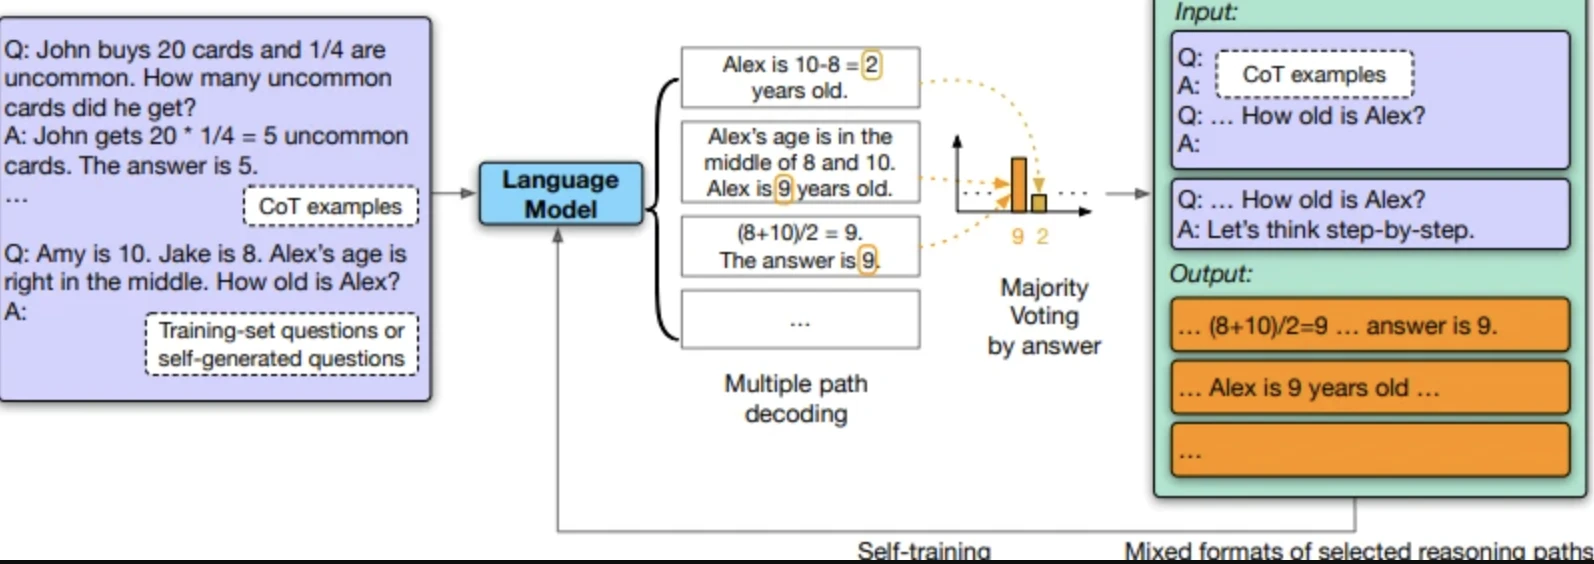
Modelo autoaperfeiçoado do Google (pesquisa de 2023):
- O modelo cria perguntas
- Faz a curadoria das respostas
- Ajusta-se finamente com os dados gerados
Desempenho melhorado: de 74,2% para 82,1% em problemas de matemática GSM8K, e de 78,2% para 83,0% em compreensão de leitura DROP.
OpenAI, Anthropic e Google estão todos usando dados sintéticos para complementar conjuntos de dados rotulados por humanos. Isso reduz os custos de rotulagem de dados, mas introduz novos riscos de viés; os modelos podem amplificar seus próprios erros.
Fonte: “Grandes Modelos de Linguagem Podem se Autoaperfeiçoar”
Uma pesquisa de março de 2026 descobriu que 76% dos pesquisadores de IA acreditam que os ganhos com a expansão da computação e dos dados se estabilizaram, com grandes laboratórios relatando retornos decrescentes apesar dos investimentos massivos. A descoberta sugere que o próximo salto na capacidade dos LLM tem mais probabilidade de vir da inovação arquitetural, como maior eficiência de treinamento, arquiteturas esparsas ou melhorias de raciocínio, do que da ampliação adicional das abordagens existentes.2
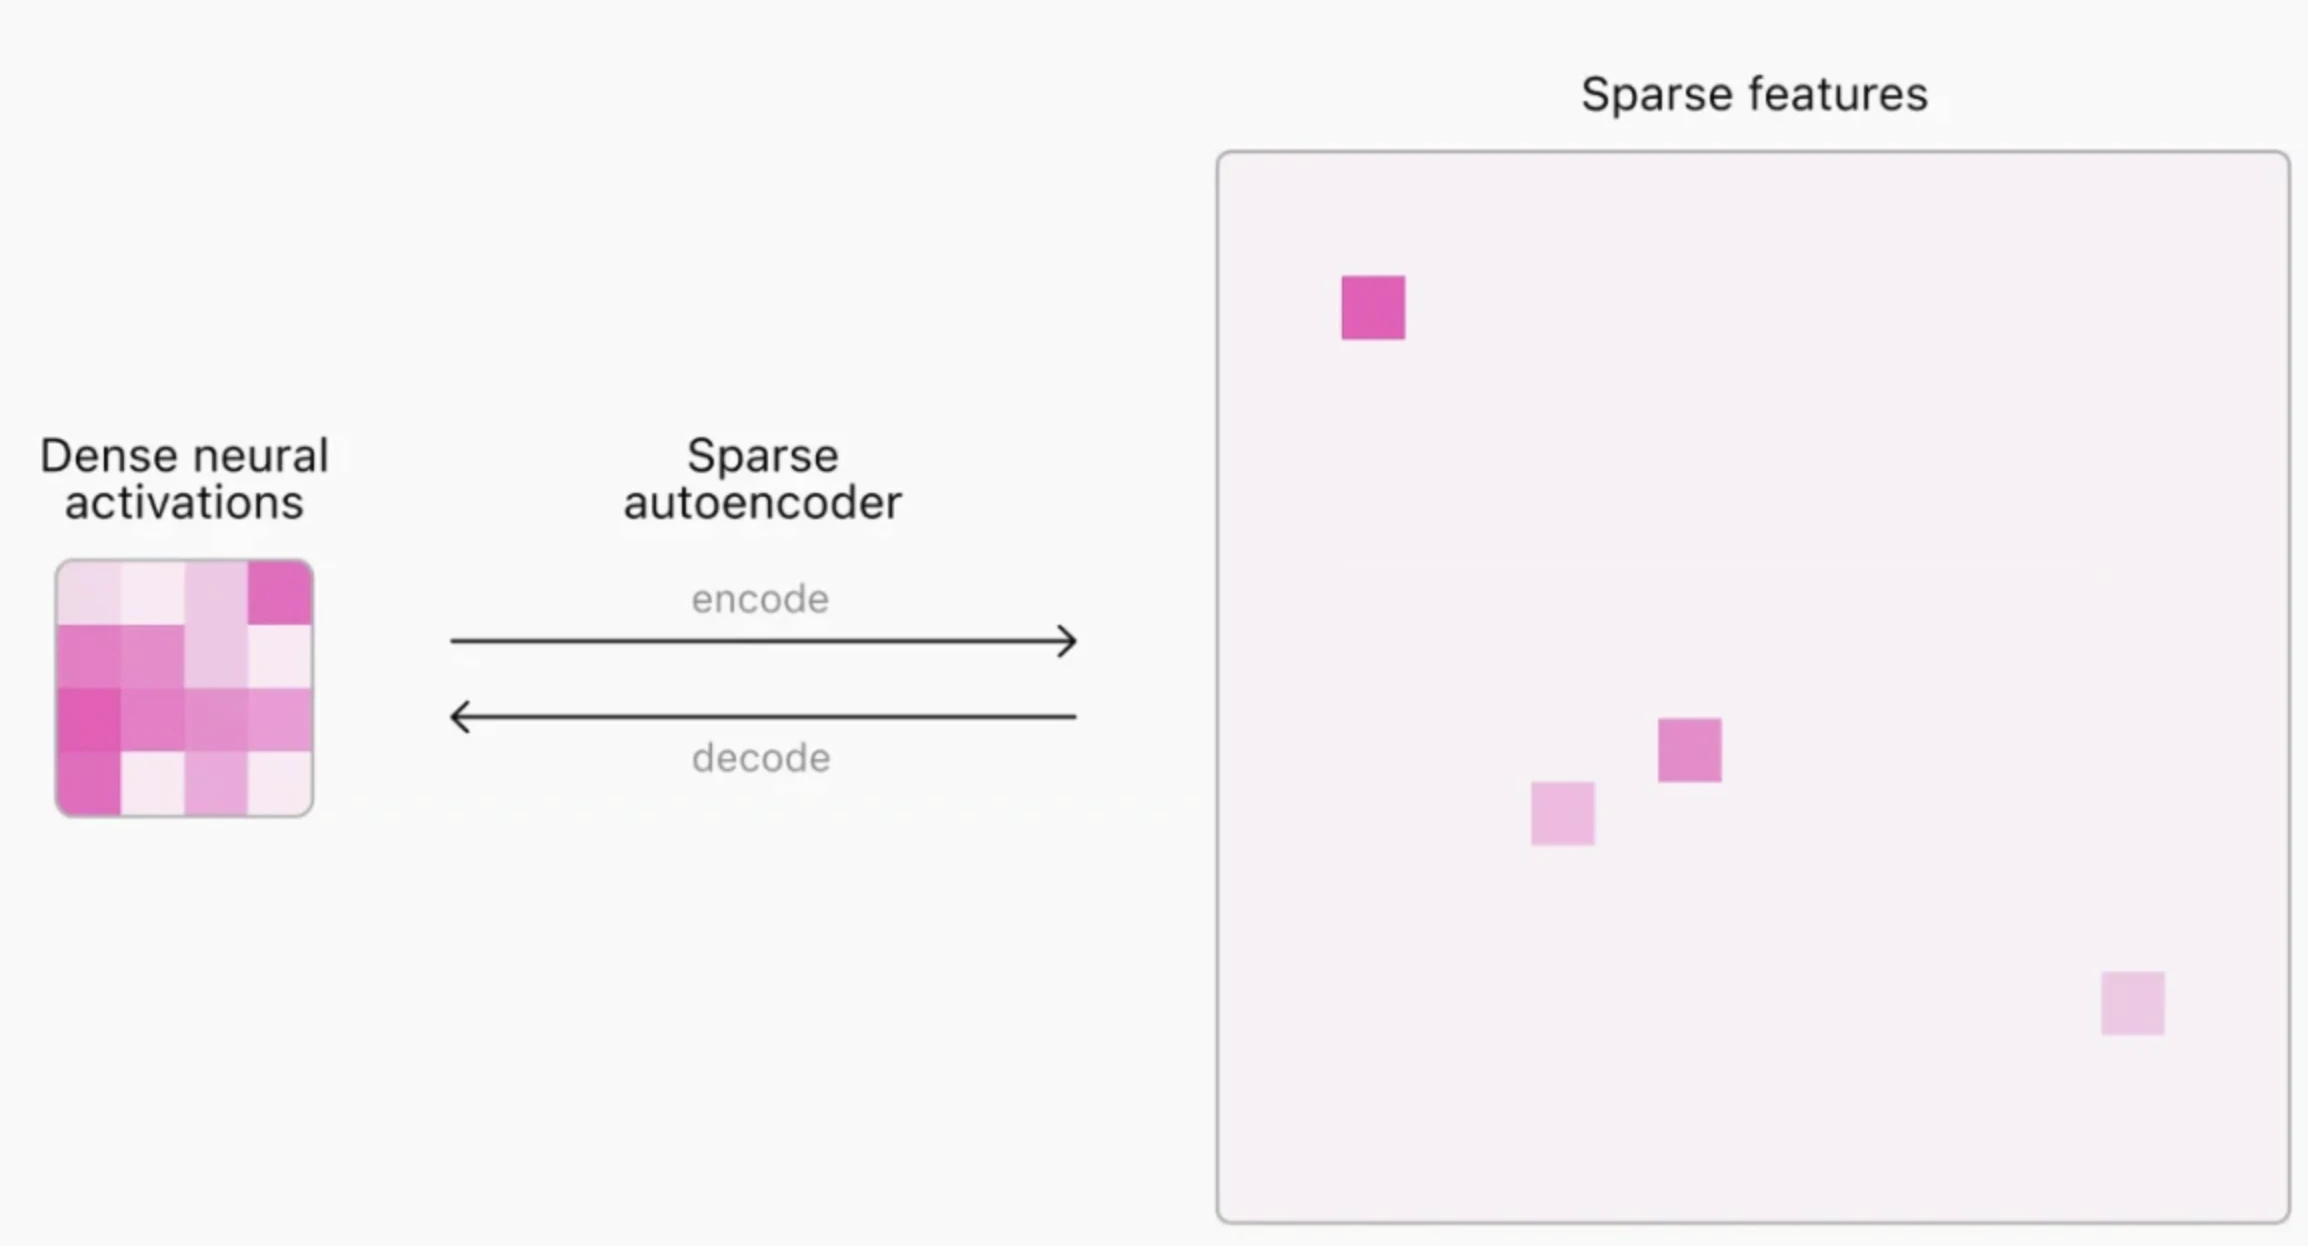
3- Modelos de Especialistas Esparsos (Mistura de Especialistas)
Em vez de ativar toda a rede neural para cada entrada, um subconjunto relevante de parâmetros é ativado, dependendo da tarefa. O modelo encaminha a entrada para “especialistas” especializados dentro da rede. Apenas os especialistas ativados processam a consulta.
Exemplos da vida real:
- DeepSeek V4-Pro: Um modelo de Mistura de Especialistas com 1.6T de parâmetros totais e 49B ativados, juntamente com o menor DeepSeek-V4-Flash com 284B de parâmetros (13B ativados), ambos suportando um contexto de um milhão de tokens.3
- Qwen3.8-Max (Alibaba): Construído sobre a arquitetura Qwen 3.5, escala para 2.4 trilhões de parâmetros com 95B ativos e é o primeiro modelo Qwen da classe Max cujos pesos a Alibaba se comprometeu a abrir o código-fonte.
- Mistral Devstral 2: Criado especificamente para engenharia de software. 123B parâmetros, janela de contexto de 256K tokens, 72,2% no SWE-bench.4Uma variante menor, Devstral Small 2 (24B parâmetros), é executada localmente sob Apache 2.0. O modelo mais novo da Mistral é o Mistral Large 4, um modelo multimodal MoE de pesos abertos com janela de contexto de 1M, lançado em pré-visualização pública em 6 de outubro de 2026, com pesos previstos para o final deste mês.
4- Integração com Fluxos de Trabalho Empresariais
Os LLMs são incorporados diretamente aos processos de negócios, em vez de serem usados como ferramentas autônomas.
Exemplos da vida real:
- Salesforce Agentforce (antigo Einstein Copilot): Integra LLMs às operações de CRM. Responde a consultas de clientes, gera conteúdo e executa ações no Salesforce, fundamentado nos dados e metadados de CRM da organização por meio da Einstein Trust Layer.5
- Microsoft 365 Copilot: Integrado no Word, Excel, PowerPoint e Outlook. Redige documentos, analisa planilhas, gera apresentações e resume conversas de e-mail, usando dados da empresa por meio do Microsoft Graph para fundamentar as respostas no contexto organizacional.6 O agente Researcher usa uma arquitetura com vários modelos, em que o GPT faz a pesquisa inicial e o Claude revisa os resultados antes da entrega, a primeira implantação comercial confirmada de fornecedores de IA concorrentes dentro de um único produto empresarial.
- Anthropic Claude para Empresas: A separação de memória baseada em projetos mantém distintos os contextos de trabalho entre as equipes. O Claude Opus 4.6 introduziu equipes de agentes, permitindo que vários agentes Claude dividam tarefas maiores em fluxos de trabalho paralelos, e integrou o Claude ao PowerPoint como um painel lateral nativo. A recomendação da Anthropic é começar com o Claude Opus 5.5 para a maioria das cargas de trabalho e usar o Claude Fable 5.1 para raciocínio exigente e trabalho agêntico de longo horizonte.7
5- LLMs híbridos com capacidades multimodais
Grandes modelos multimodais integram várias formas de dados, como texto, imagens e áudio, permitindo que entendam e gerem conteúdo em diferentes tipos de mídia.
- Gemini 3.8 Flash: O Google o descreve como seu modelo Flash mais inteligente, criado para engenharia de software de longo horizonte, agentes autônomos e fluxos de trabalho empresariais complexos. O preço de lançamento é de $0,75 por milhão de tokens de entrada e $3,75 por milhão de tokens de saída até 31 de dezembro de 2026; o preço padrão de $1,50 e $7,50 começa em 1º de janeiro de 2027. O Google restringiu os modelos mais antigos Gemini 2.5 aos usuários que já os usaram e direciona novos projetos para o 3.5 Flash-Lite ou o 3.8 Flash.8
- Meta Muse Spark 1.3 e Muse Glimmer: O Muse Spark, lançado em 8 de abril de 2026, substituiu a linha Llama da Meta. O Muse Spark 1.3 tem uma janela de contexto de 1M tokens, e seus pesos permanecem fechados, embora a Meta liste um lançamento de pesos abertos em seu roteiro.9Para pesos abertos, o Muse Glimmer é um modelo de 30 bilhões de parâmetros com um codificador de percepção dedicado, destilado do Muse Spark e projetado para tarefas agênticas em hardware de consumo, lançado sob Apache 2.0.10
A capacidade multimodal é padrão nos modelos de fronteira. O desafio restante é a consistência: os modelos têm bom desempenho em combinações comuns de imagem e texto, mas degradam em contextos visuais raros, entradas de baixa resolução e raciocínio intermodal que exige conectar evidências visuais e textuais.
6- Modelos de raciocínio
Modelos que pensam nos problemas passo a passo, em vez de gerar respostas imediatas.
Essa mudança da previsão para o raciocínio é fundamental para permitir:
- Comportamento agêntico, em que os modelos planejam, executam e adaptam tarefas de forma autônoma.
- IA interpretável, em que as saídas são passo a passo e logicamente consistentes.
- Família Claude 5.5 e Fable 5.1 (Anthropic): Todos os quatro modelos oferecem uma janela de contexto de 1M tokens, saída máxima de 128K, pensamento adaptativo e um corte de conhecimento confiável de junho de 2026. Preço da API por milhão de tokens: Fable 5.1 a $10 entrada / $50 saída, Opus 5.5 a $4 / $20, Sonnet 5.5 a $2 / $10 e Haiku 5.5 a $0,10 / $0,50 para prompts de até 100.000 tokens.11
- GPT-6 Astra (OpenAI): O preço padrão da API é de $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída; o modo Fast é executado até 2x mais rápido pelo 2x do preço.12
7- Modelos Ajustados Especificamente para Domínios
Modelos treinados em dados especializados para setores específicos, em vez de treinamento de propósito geral.
Google, Microsoft e Meta lançaram grandes modelos proprietários específicos de domínio e ajustados para casos de uso empresariais, além de suas ofertas de propósito geral.
Esses LLMs especializados podem resultar em menos alucinações e maior precisão ao aproveitar pré-treinamento específico de domínio, alinhamento de modelo e ajuste fino supervisionado.
GitHub Copilot: Ajustado em repositórios de código. Em julho de 2025, 20 milhões de desenvolvedores usam o GitHub Copilot, um aumento de 400% ano a ano, e 90% das empresas Fortune 100 o utilizam. Ele autocompleta código, gera funções e sugere correções de bugs.13
BloombergGPT: 50 bilhões de parâmetros LLM treinado em um conjunto de dados de 363 bilhões de tokens de documentos financeiros da Bloomberg, superando modelos de tamanho comparável em benchmarks de PLN financeira, incluindo análise de sentimentos, reconhecimento de entidades nomeadas e resposta a perguntas.14
Med-PaLM 2 do Google: Ajustado em conjuntos de dados médicos, alcançou precisão de 85%+ em questões no estilo do Exame de Licenciamento Médico dos EUA (USMLE), o primeiro LLM a atingir desempenho de nível especialista nesse benchmark. Ele alimenta o MedLM, a família de modelos de base de saúde do Google Cloud.15
ChatLAW: Um modelo de linguagem de código aberto treinado especificamente em conjuntos de dados do domínio jurídico chinês.16
8- IA ética e mitigação de viés
- Anthropic e OpenAI conduziram uma avaliação de alinhamento mútua em meados de 2025, testando os modelos públicos uma da outra quanto a bajulação, tendências a denúncias e comportamentos de autopreservação. O exercício encontrou bajulação em todos os modelos testados, incluindo casos em que os modelos validaram decisões prejudiciais de usuários simulados que exibiam crenças delirantes. Posteriormente, a Anthropic desenvolveu o framework de testes Bloom especificamente para avaliar esse comportamento em novos modelos.
- Anthropic também lançou o Claude Mythos Preview (Project Glasswing), um modelo somente para convidados disponibilizado a um pequeno grupo de organizações especificamente para encontrar e corrigir vulnerabilidades de segurança cibernética em grandes sistemas operacionais e navegadores web. A Anthropic afirmou que não planeja disponibilizar esse modelo. A abordagem de acesso controlado representa um novo framework para implantar modelos especialistas altamente capazes quando o perfil de risco exige um lançamento restrito. A página de preços da API da Anthropic também lista o Claude Mythos 5.1 entre seus modelos adicionais, a $10 entrada / $50 saída por milhão de tokens.
- Google DeepMind: Publicou “A Ética dos Assistentes de IA Avançados”, oferecendo o primeiro tratamento sistemático das questões éticas e sociais levantadas por agentes de IA, cobrindo alinhamento de valores, riscos de manipulação, antropomorfismo, privacidade e equidade. A avaliação de IA Responsável da empresa incluiu mais de 350 exercícios adversariais de red team e introduziu um novo Nível de Capacidade Crítica especificamente para manipulação prejudicial, tratando-o como um risco de nível de fronteira ao lado de ataques cibernéticos e ameaças CBRN.
Limitações dos grandes modelos de linguagem (LLMs)
1- Alucinações
Os modelos geram informações que parecem plausíveis, mas são incorretas.
O leaderboard de alucinações da Vectara é o benchmark de sumarização fundamentada mais amplamente referenciado do setor. No conjunto de dados original da Vectara, os modelos Gemini do Google ocupam consistentemente as primeiras posições, com as variantes Gemini Flash alcançando taxas de alucinação abaixo de 1%. A família GPT da OpenAI se concentra entre 0,8% e 2,0%.
A Vectara lançou um benchmark significativamente mais difícil no final de 2025 com 7.700 artigos (acima dos 1.000), documentos mais longos de até 32K tokens e conteúdo abrangendo direito, medicina, finanças e tecnologia. As descobertas no novo conjunto de dados revelam um padrão contraintuitivo: modelos de raciocínio e pensamento que se destacam em tarefas complexas frequentemente alucinam mais em sumarização fundamentada do que modelos menores e mais rápidos. A maioria dos modelos da classe thinking mostra taxas de alucinação acima de 10% no conjunto de dados mais difícil, enquanto modelos mais leves como as variantes Gemini Flash mantêm taxas mais baixas.17
Observação: Nenhum benchmark isolado fornece uma “taxa de alucinação” definitiva para qualquer modelo. Uma avaliação responsável cruza pelo menos dois benchmarks que medem coisas diferentes: uma tarefa fundamentada (Vectara), uma tarefa de conhecimento aberta, e especifica a versão exata do modelo e as condições de chamada.
Todos os modelos alucinam. A frequência foi reduzida substancialmente, de aproximadamente 21% em 2021 para menos de 5% para os melhores desempenhos em benchmarks padrão, mas não foi eliminada. Aplicações críticas ainda exigem verificação humana.
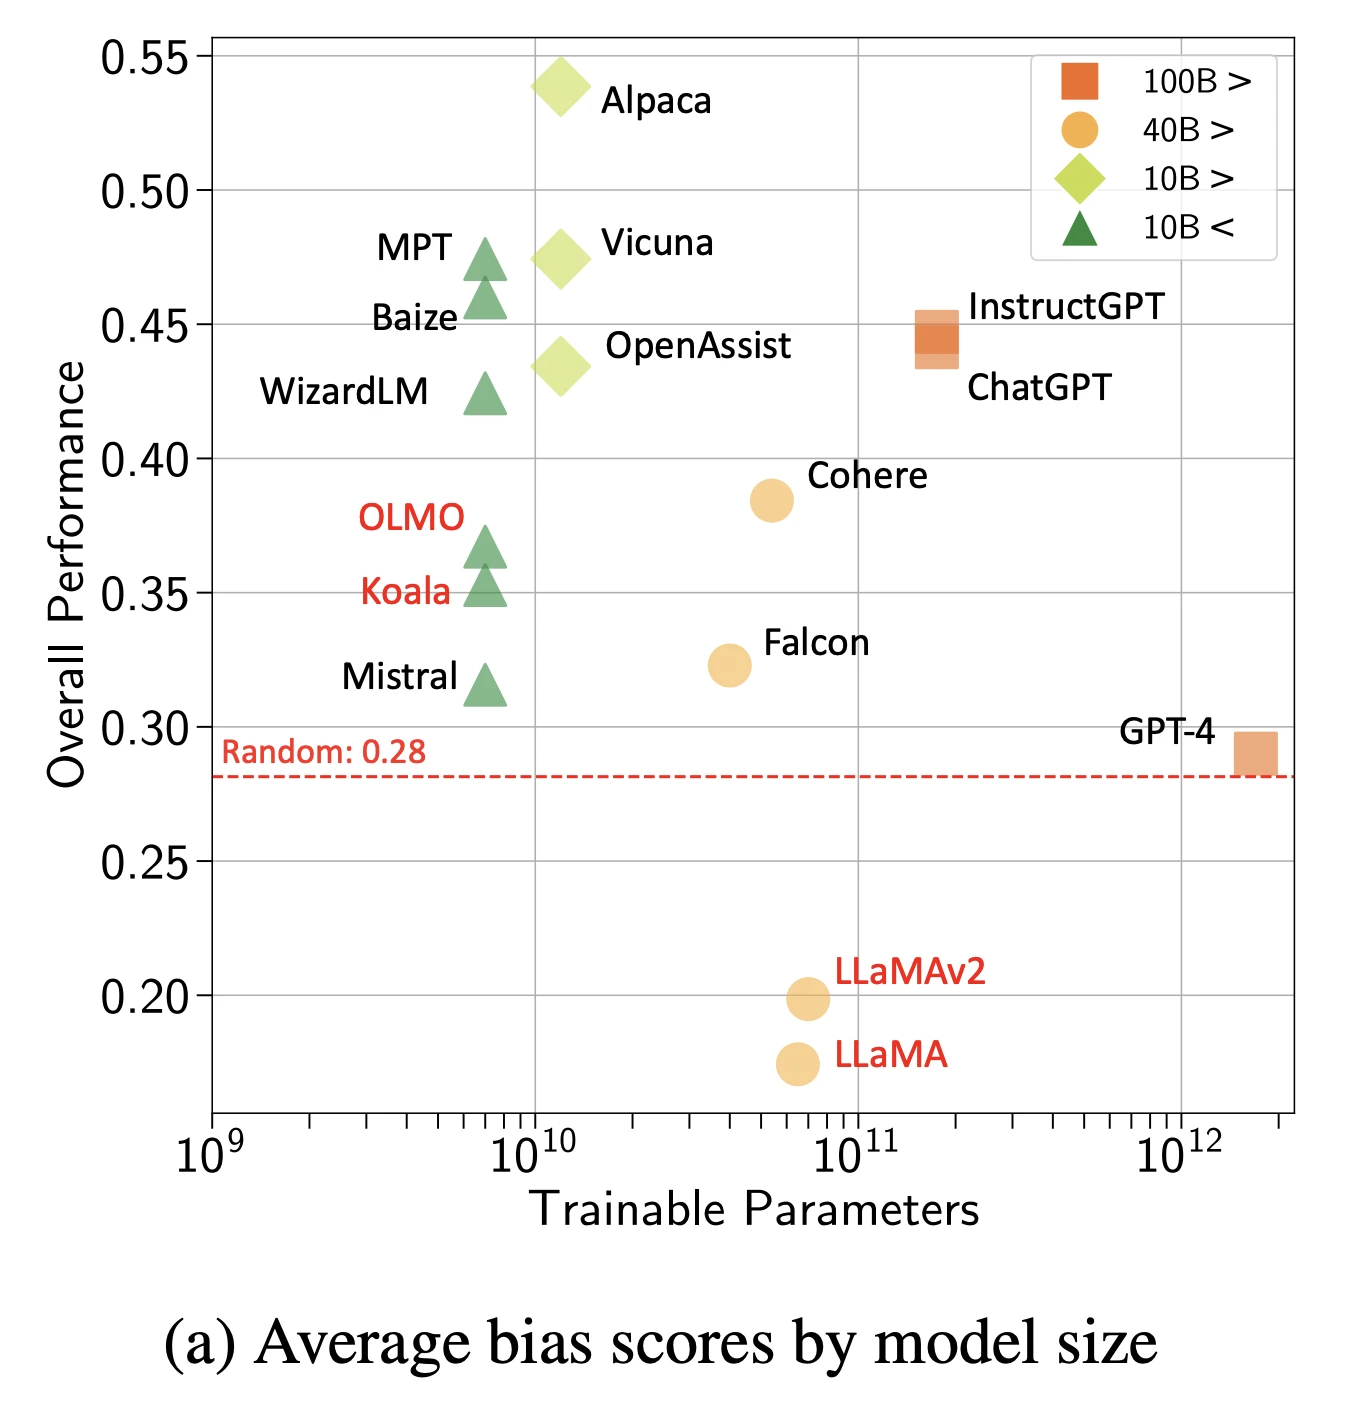
2- Viés
Os modelos absorvem e amplificam vieses sociais dos dados de treinamento.
Fonte: Pontuações gerais de viés por modelos e tamanho.18
Tipos de viés observados:
- Viés de gênero em sugestões de ocupação
- Viés racial em simulações de triagem de currículos
- Viés etário em recomendações de saúde
- Viés socioeconômico em conteúdo educacional
3- Toxicidade
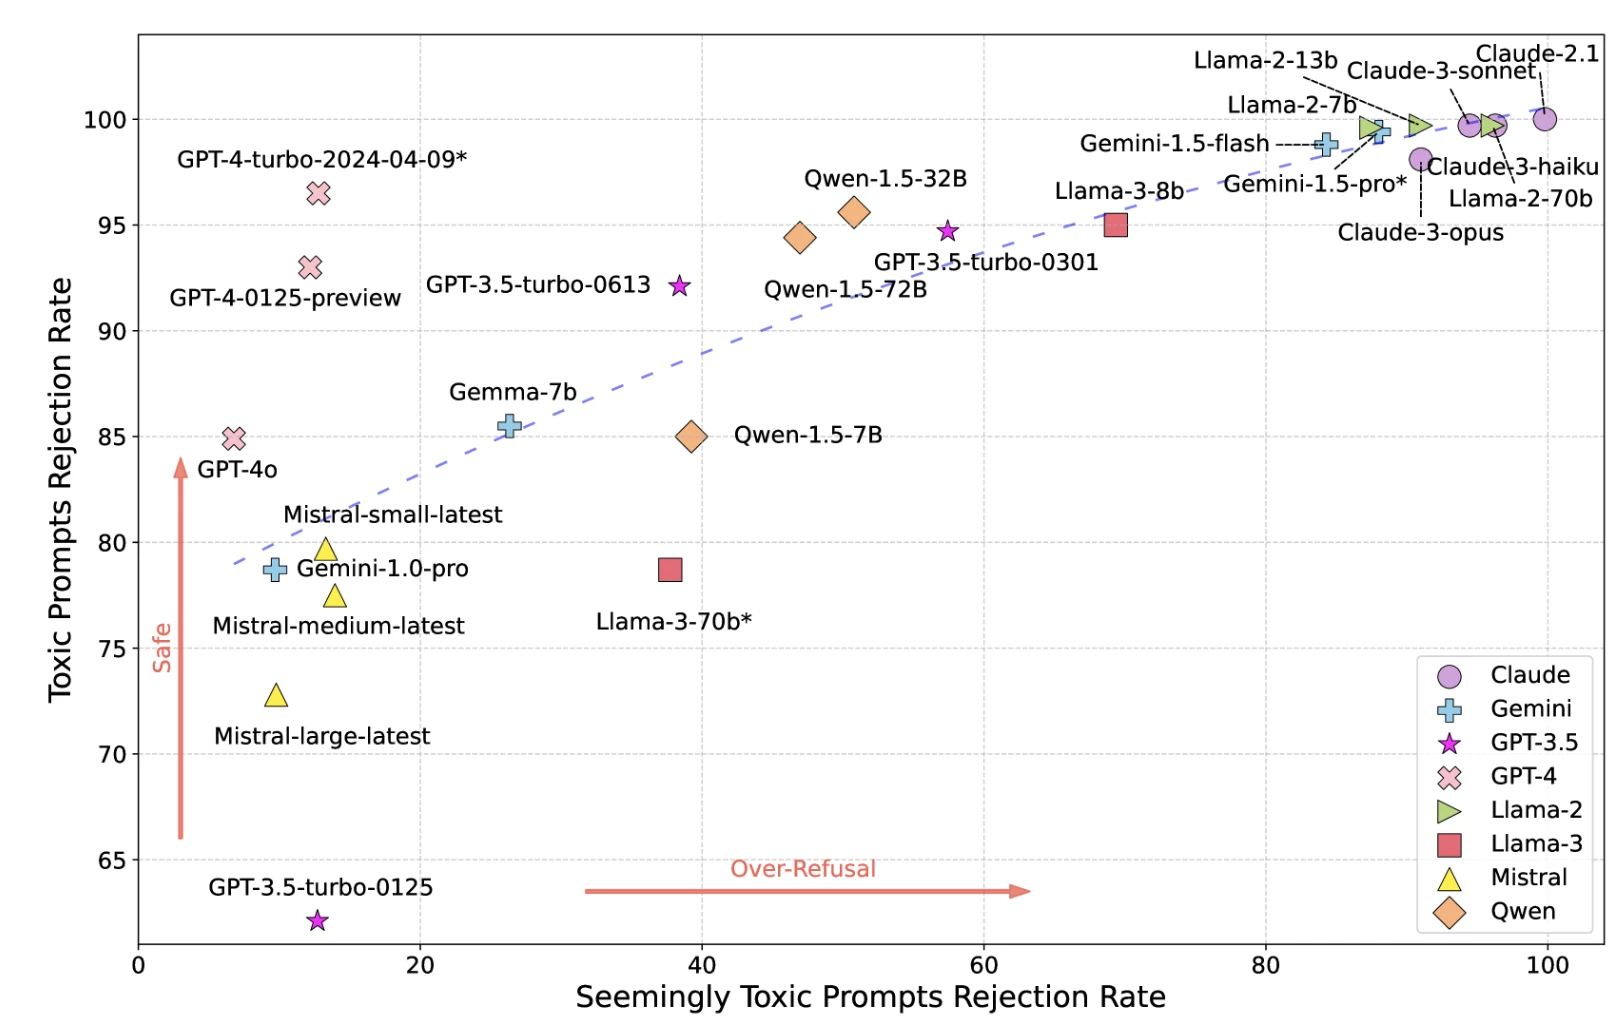
Os modelos podem gerar conteúdo prejudicial, ofensivo ou tóxico, apesar das medidas de segurança.
Fonte: mapa de toxicidade dos LLMs de pesquisadores da UCLA e da UC Berkeley19
*GPT-4-turbo-2024-04-09*, Llama-3-70b* e Gemini-1.5-pro* são usados como moderador, os resultados podem ser enviesados nesses 3 modelos.
Medidas de segurança rígidas reduzem a toxicidade, mas aumentam os falsos positivos (recusa de solicitações inofensivas). Medidas frouxas permitem a passagem de toxicidade.
4- Limitações da Janela de Contexto
Cada modelo tem uma capacidade de memória fixa, o número de tokens que pode processar em uma única sessão. Se esse limite for excedido, o modelo trunca o conteúdo anterior ou recusa a solicitação. A diferença prática entre os modelos é grande o suficiente para importar em cargas de trabalho reais.
- Llama 4 Scout (Meta): 10M tokens, a maior janela de contexto entre os principais lançamentos de pesos abertos. Desde então, a Meta transferiu seu trabalho de fronteira para a linha Muse, portanto o Scout não está mais sendo atualizado.
- Claude Opus 5.5, Sonnet 5.5, Haiku 5.5, Fable 5.1: Janela de contexto de 1M tokens e saída máxima de 128K em todos os quatro. O Claude 4.6 e modelos posteriores (exceto o Haiku 5.5) cobram a janela completa de 1M com tarifas padrão.
- GPT-6.1 Sol: Janela de contexto de 1.050.000 tokens. A OpenAI cobra tarifas mais altas por solicitações de contexto longo em seus modelos principais.20
- Gemini 4 Argon: O Google aumentou o limite de tokens de saída para 1M tokens, acima dos 64K.21
- DeepSeek V4.1 Flash e V4-Pro: Contexto de 1M, saída de até 384K.22
Uma janela de contexto grande não significa automaticamente melhor desempenho em toda a sua extensão. A recuperação se degrada em direção ao meio de contextos longos na maioria dos modelos, e os custos aumentam com o comprimento da entrada; processar 1M tokens custa significativamente mais do que processar 10K tokens no mesmo modelo. Para a maioria das cargas de trabalho em produção, a questão prática não é qual modelo tem a maior janela, mas qual modelo recupera de forma confiável nos comprimentos de contexto que seu caso de uso realmente exige.
5- Corte Estático de Conhecimento
Os modelos dependem de conhecimento pré-treinado com uma data de corte específica. Não têm acesso a informações após o treinamento, a menos que estejam conectados a fontes externas.
Problemas:
- Informações desatualizadas sobre eventos atuais
- Incapacidade de lidar com desenvolvimentos recentes
- Menos relevância em domínios dinâmicos (tecnologia, finanças, medicina)
Solução: Integração com busca na web. ChatGPT, Claude e Perplexity oferecem busca em tempo real. Mas a busca não elimina as alucinações; às vezes os modelos interpretam mal os resultados da busca.
Principais Plataformas de LLM
GPT-6
O GPT-6 Astra ficou disponível para o público em geral em 4 de setembro de 2026; o GPT-6 Sol e o GPT-6 Luna vieram em seguida, em 22 de setembro de 2026.
Suas maiores melhorias estão em programação, uso de computador, raciocínio científico e segurança cibernética, com ganhos particularmente grandes em benchmarks difíceis de resolução de problemas. Ele também segue instruções de forma mais confiável e comete menos erros.
O GPT-6.1 Sol está disponível para usuários Plus, Pro, Business, Enterprise e Edu por meio do ChatGPT Work e do Codex, mas ainda não nas conversas regulares do ChatGPT; os desenvolvedores o acessam como gpt-6.1-sol.
Preços da API (padrão, por milhão de tokens): gpt-6-astra $10 entrada / $50 saída; gpt-6.1-sol $2 / $10; gpt-6-luna $0,10 / $0.50.
Limitações: O Astra compartilha o preço base mais alto desta lista com o Claude Fable 5.1, a $10/$50 por milhão de tokens. A OpenAI afirma que o Astra atende ao limite crítico de segurança cibernética de acordo com sua Preparedness Framework, e a versão de lançamento recusa tarefas cibernéticas avançadas, como escrever exploits de prova de conceito. Ainda alucina e ainda precisa de busca na web para qualquer coisa após seu corte de treinamento.12
Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 / Haiku 5.5
A Anthropic posiciona o Fable 5.1 para raciocínio exigente e trabalho agêntico de longo horizonte, o Opus 5.5 para codificação agêntica de longa duração e trabalho de conhecimento, o Sonnet 5.5 como o equilíbrio entre velocidade e inteligência, e o Haiku 5.5 para tarefas de alto volume e sensíveis à latência, como classificação e roteamento.
Preço por milhão de tokens: Fable 5.1 $10/$50, Opus 5.5 $4/$20, Sonnet 5.5 $2/$10, Haiku 5.5 a partir de $0,10/$0.50.
Limitações: O Claude 4.7 e modelos posteriores usam um tokenizador mais novo que produz cerca de 30% mais tokens para o mesmo texto, o que aumenta o custo efetivo em comparação com os preços de tabela.
Gemini 3.8 Flash / Gemini 4 Argon
O Google lançou o Gemini 3.8 Flash, um modelo mais rápido e de menor custo focado em codificação complexa, fluxos de trabalho autônomos e raciocínio, juntamente com o Flash Cyber, um modelo especializado em segurança cibernética.
O Flash pontua 54,9% no HLE-Verified e custa $0,75 por milhão de tokens de entrada e $3,75 por milhão de tokens de saída até o final de 2026, embora tarefas complexas possam consumir mais tokens.
O Flash Cyber alcança mais de 70% de sucesso no benchmark interno de descoberta de vulnerabilidades do Google e 47,2% em um benchmark externo de aplicação de correções, com acesso restrito a defensores confiáveis.
Preço: $0,75 por milhão de tokens de entrada e $3,75 por milhão de tokens de saída tokens.23
O Gemini 4 Argon do Google se concentra em tarefas complexas e de longa duração em engenharia de software, finanças, trabalho jurídico e segurança cibernética. Ele suporta até 1 milhão de tokens de saída, pontua 77,9% no DeepSWE e 51,3% no AutomationBench, e pode descobrir e corrigir vulnerabilidades de segurança de forma autônoma. O Google relata usá-lo internamente para migrações de código em larga escala e otimizações de data centers.
Preço começa em $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, dobrando após o período introdutório. O acesso está atualmente restrito a testadores confiáveis e defensores de segurança cibernética.21
Meta Muse Spark 1.3 / Muse Glimmer
O Muse Spark 1.3 da Meta se concentra em melhorar os agentes de IA para fluxos de trabalho longos e complexos e tarefas de codificação. Em comparação com a versão 1.2, os testes internos de engenharia da Meta mostram 20% menos chamadas de ferramentas e 25% menos tokens para tarefas de codificação. A Meta também relata maior resistência a injeções de prompts e melhor julgamento em torno de ações irreversíveis.
O modelo está disponível por meio do Muse Code e da API de Modelos da Meta, com pesos abertos planejados para um lançamento futuro.24
Pesos abertos: O Muse Glimmer é um modelo aberto de 30B parâmetros, licenciado sob Apache 2.0, que roda em uma única GPU e é ajustado para uso de ferramentas, tarefas longas e recuperação de falhas.
Quem usa: O Muse Spark é adequado para equipes que já estão no ecossistema da Meta e desejam acesso à API. O Muse Glimmer é adequado para implantações locais e on-premise, e para desenvolvedores que desejam evitar a dependência de fornecedores.
Limitações: Os pesos do Muse Spark são fechados. Os modelos Llama 4 continuam disponíveis para download, mas não são mais a linha de fronteira da Meta.
DeepSeek V4
O V4-Pro é um modelo de Mistura de Especialistas com 1.6T de parâmetros totais e 49B ativados, com contexto de um milhão de tokens.
Em 10 de setembro de 2026, a DeepSeek lançou o V4.1-Flash, o menor modelo em sua família de arquitetura, com compreensão visual multimodal nativa. O V4.1 Flash suporta visão, mas o V4-Pro não.25
Preços da API (por milhão de tokens, horários de pico): O V4.1 Flash custa $0,30 de entrada (cache miss) e $1,20 de saída; o V4-Pro custa $1,32 de entrada e $3,96 de saída. As tarifas fora de pico são metade das tarifas de pico.22
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{O Futuro dos Grandes Modelos de Linguagem}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/future-of-large-language-models}},
  note   = {AIMultiple. Acessado em 9 outubro 2026}
}
Registro de alterações
7 atualizaçõesAdicionada uma seção de metodologia de benchmark detalhando os modelos testados e a pontuação.
Substituídos GPT-5.2, Gemini 3.1 Pro e DeepSeek V3.2 por GPT-5.5, Gemini 2.5 Pro, DeepSeek V4 e Claude Opus 4.7.
Atualizados os dados de 'Exemplos da vida real' na seção 'Domain-Specific Fine-Tuned Models'.
Atualizada a seção "Tendências futuras dos grandes modelos de linguagem" com novos exemplos de verificação de fatos em tempo real.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

Ela trabalhou anteriormente como recrutadora em empresas de gerenciamento de projetos e consultoria. Sıla possui mestrado em Psicologia Social e bacharelado em Relações Internacionais.



Comentários 1
Compartilhe suas ideias
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.
Insightful read! The future of large language models looks incredibly promising. It’s exciting to see how they’ll keep transforming the way we work and communicate. Loved the detailed explanation in the article.