


Grandes Models Multimodais (LMMs) vs LLMs

Avalie LLMs e LMMs comparando suas pontuações de benchmark e latência real clicando no nome do model na tabela abaixo. Você também pode ponderar seus preços de entrada e saída para avaliar a eficiência e o valor geral.
Grandes models multimodais de pesos abertos
*Áudio é nativo somente nos models E2B, E4B e 12B.
Gemma 4 (Google DeepMind)
Disponível em cinco tamanhos: E2B, E4B, 12B, 26B A4B e 31B. A família processa texto e imagens com proporções e resoluções variáveis em todos os models. Também suporta vídeo e áudio, com áudio nativo nos models E2B, E4B e 12B.1
A variante 12B é a mais notável arquitetonicamente. A Google substituiu o codificador de visão por um módulo de embedding leve e removeu completamente o codificador de áudio, projetando o sinal de áudio bruto no mesmo espaço dimensional dos tokens de texto. Sem codificadores multimodais no pipeline, a latência cai e o model se torna pequeno o suficiente para rodar em uma GPU de laptop com 16GB de memória.
Kimi K3 (Moonshot IA)
Um model de 2.8T parâmetros construído sobre Kimi Delta Attention e Attention Residuals, com capacidades de visão nativas e uma janela de contexto de 1 milhão de tokens. A Moonshot o descreve como o primeiro model aberto na classe de 3 trilhões de parâmetros.
Seu codificador de visão, MoonViT-V2, foi treinado do zero por meio do objetivo de previsão do próximo token do model e não foi inicializado a partir de um model de visão pré-treinado contrastivamente, como o SigLIP.2
MiniMax M3
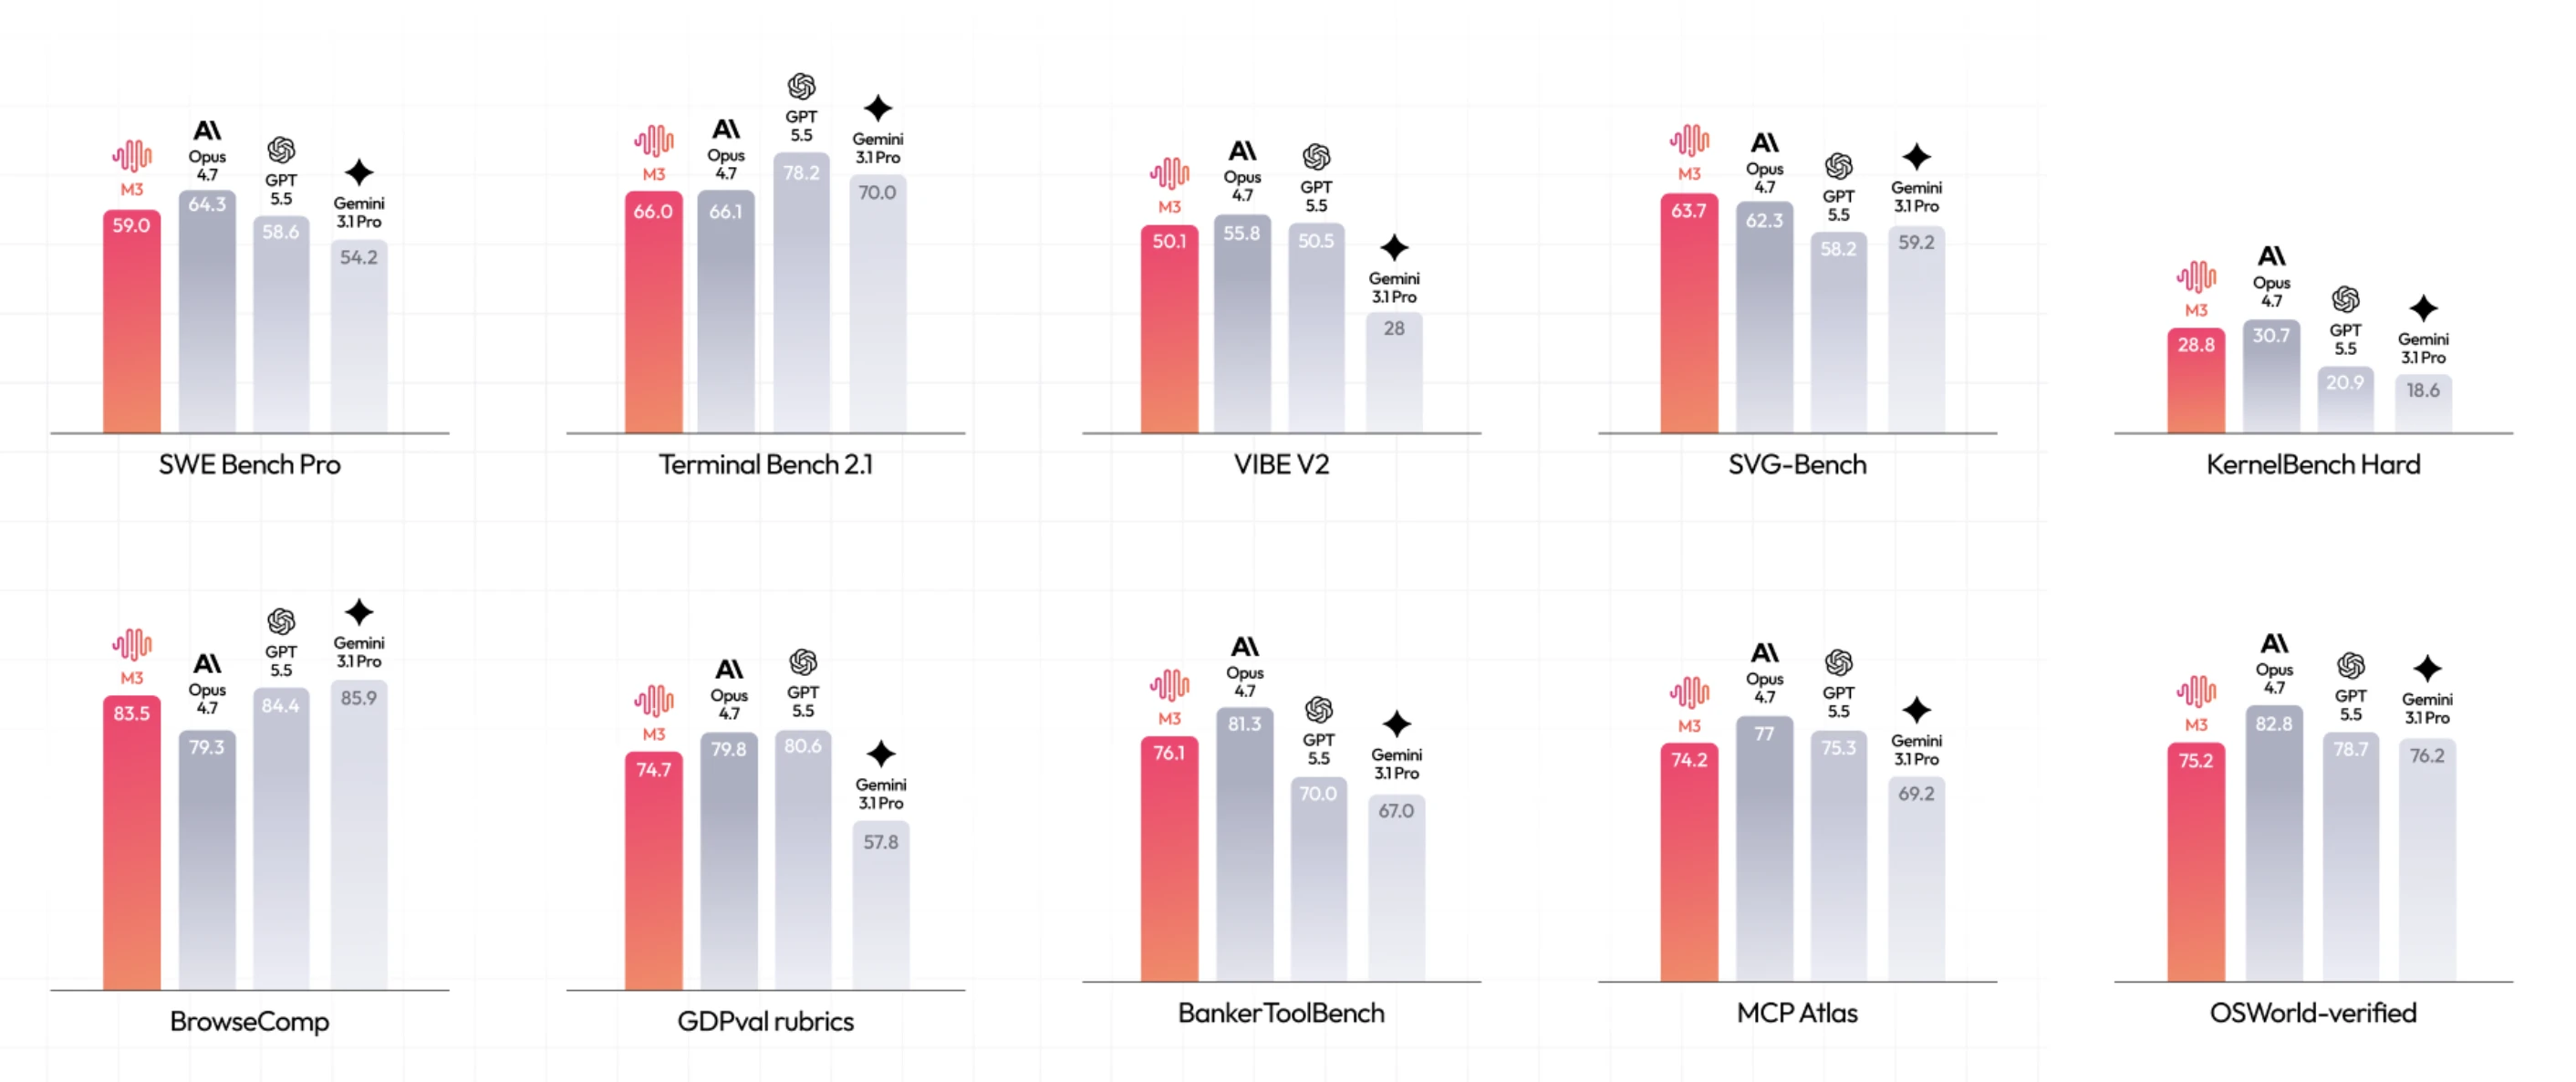
Um model multimodal nativo com aproximadamente 428B parâmetros e 23B ativados, treinado em modalidades mistas (texto, imagem e vídeo). A MiniMax o apresenta como o primeiro model de pesos abertos a combinar desempenho de codificação de fronteira, uma janela de contexto de 1M tokens e multimodalidade nativa em um único sistema. Ele também pode operar um computador desktop a partir de capturas de tela.
Figura 1: Resultados de benchmark do Minimax M3.3
GLM-5.3-Flash (Z.ai)
O primeiro model multimodal nativo da série GLM-5, com 320B de parâmetros totais e 18B ativados, e o primeiro model de fronteira de código aberto a combinar atenção esparsa e linear.
A Z.ai relata que o design híbrido reduz a computação de atenção e o cache KV em 3.01x e 4.44x em relação ao GLM-5.3.4
DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash é o menor model da família de arquitetura da DeepSeek e o primeiro da linha a suportar compreensão visual nativa.
Ele usa um design de Mistura de Especialistas com 552 bilhões de parâmetros e uma arquitetura de codificador-decodificador causal, usando oito bilhões de parâmetros ativos para entrada e 16 bilhões para saída. Substituiu tanto o V4 Flash quanto o experimental V4 Flash Vision Exp, cujos nomes de model agora roteiam para o novo endpoint para compatibilidade.5
Grandes models multimodais proprietários
GPT-6 Astra (OpenAI)
A OpenAI posiciona o Astra como estado da arte em uso de computador, navegação, engenharia de software, segurança cibernética, ciência e trabalho profissional, com uma pontuação de 98% no FrontierMath Nível 4 e 99,9% no ARC-AGI-3.6
É o primeiro model da empresa a atingir o nível Crítico de capacidade de segurança cibernética no âmbito do seu Preparedness Framework, e a versão publicamente disponível consequentemente recusa trabalho cibernético avançado. O model aceita texto e imagens e retorna texto.
Gemini Omni (Google DeepMind)
O Gemini Omni é a família de models generativos nativamente multimodais do Google, e seu primeiro lançamento é o Gemini Omni Flash.
A Google o descreve como um model que pode criar qualquer coisa a partir de qualquer entrada, começando com vídeo: os usuários fornecem qualquer combinação de imagens, áudio, vídeo e texto e recebem vídeo fundamentado no conhecimento de mundo real do Gemini, que podem então revisar por meio de conversa em vez de regenerar do zero.7
Qwen3.8-Omni-Flash (Alibaba)
O Qwen3.8-Omni-Flash aceita texto, imagem, áudio e vídeo em um único contexto de 1M tokens, processa até uma hora de áudio e vídeo contínuos por chamada e retorna texto.
Dado um vídeo e uma pergunta, ele identifica o que merece investigação adicional, pesquisa fontes multimodais na web e produz um relatório de pesquisa ilustrado. Os usuários podem acessá-lo apenas pela API hospedada, sem pesos abertos no lançamento.
Claude Opus 5 (Anthropic)
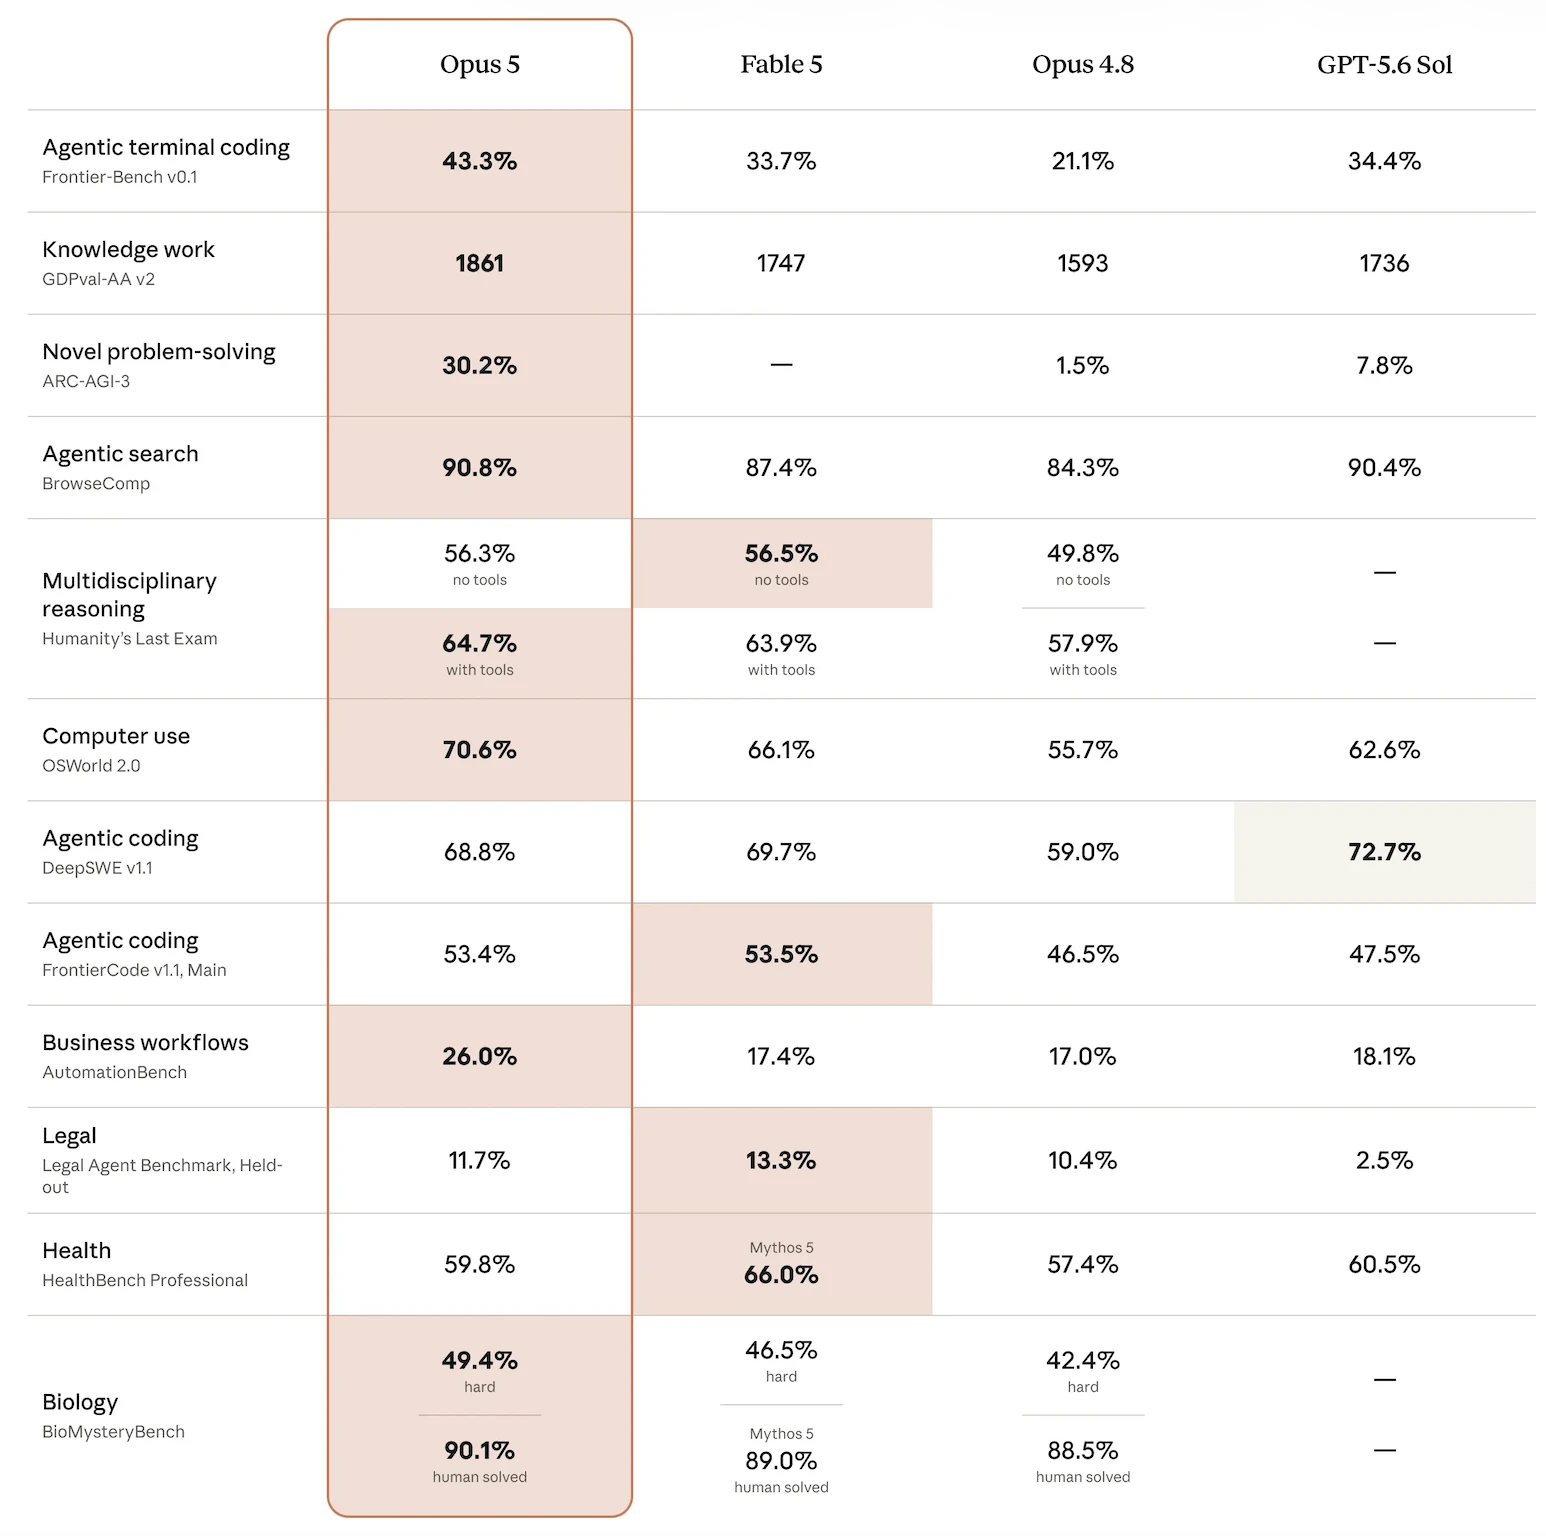
O model Opus 5 da Anthropic está posicionado como se aproximando da inteligência de fronteira do Claude Fable 5 pela metade do custo. Em avaliações de codificação e trabalho de conhecimento, incluindo Frontier-Bench e GDPval-AA, a Anthropic o relata como estado da arte, ao mesmo tempo que observa que fica atrás do Mythos 5 em tarefas de segurança cibernética.
O preço é de $5 por milhão de tokens de entrada e $25 por milhão de tokens de saída, o mesmo que o Opus 4.8, com um modo Fast rodando a aproximadamente duas vezes e meia a velocidade padrão pelo dobro da taxa base.
Figura 2: Resultados de benchmark do Claude Opus 5.8
Grok 4.6 (xAI)
Construído sobre o Grok 4.5, ele se concentra em agentes de longa duração e trabalhos interativos e visuais mais ambiciosos, mantendo uma tarefa em muitas etapas, seja pesquisando um tópico, trabalhando em uma base de código ou transformando uma ideia em uma aplicação finalizada.
Nas avaliações publicadas da xAI, o Grok 4.6 alcança 69,9% no CursorBench v3.2, à frente do GPT-5.6 Sol Max com 67,2% e logo atrás do Fable 5 Max com 70,5%, e registra a maior pontuação dos quatro models comparados no Harvey LAB com 15,8%. O preço começa em $2 por milhão de tokens de entrada e $6 por milhão de tokens de saída, com uma variante rápida pelo dobro dessa taxa.9
Muse Spark (Meta)
O Muse Spark é o primeiro model da família Muse do Meta Superintelligence Labs. A Meta o descreve como um model de raciocínio nativamente multimodal que suporta uso de ferramentas, cadeia de pensamento visual e orquestração multiagente.
O model integra informações visuais entre domínios e ferramentas e tem bom desempenho em questões STEM visuais, reconhecimento de entidades e localização. Os casos de uso incluem criar pequenos jogos ou solucionar problemas de um eletrodoméstico com anotações desenhadas sobre o que a câmera vê.
Para a saúde, a Meta trabalhou com mais de mil médicos para curar os dados de treinamento, e o model produz exibições interativas explicando informações como o conteúdo nutricional dos alimentos ou os músculos envolvidos durante um determinado exercício.
Amazon Nova 2 Omni
O Amazon Nova 2 Omni processa entradas de texto, imagens, vídeo e fala ao mesmo tempo que gera texto e imagens, lidando com até 750.000 palavras, horas de áudio, vídeos longos e documentos de cem páginas em uma única passada.
No final de julho, o model está em acesso antecipado para clientes do Nova Forge.10
Quais são as diferenças entre LMMs e LLMs?
Como os LMMs funcionam?
Grandes models multimodais compartilham semelhanças com grandes models de linguagem em treinamento, design e operação. Eles usam a mesma arquitetura de transformer e estratégias de treinamento. Grandes models multimodais são treinados com:
- Dados de texto
- Milhões ou bilhões de imagens com descrições de texto
- Clipes de vídeo
- Trechos de áudio
- Outros dados de entrada, como código
Esse treinamento envolve o aprendizado simultâneo de múltiplas modalidades de dados, permitindo que o model:
- Reconhecer a foto de um gato
- Identificar uma palavra em um clipe de áudio
- Entender conceitos e detalhes sensoriais além do texto
Dessa forma, os usuários podem enviar:
- Uma imagem para:
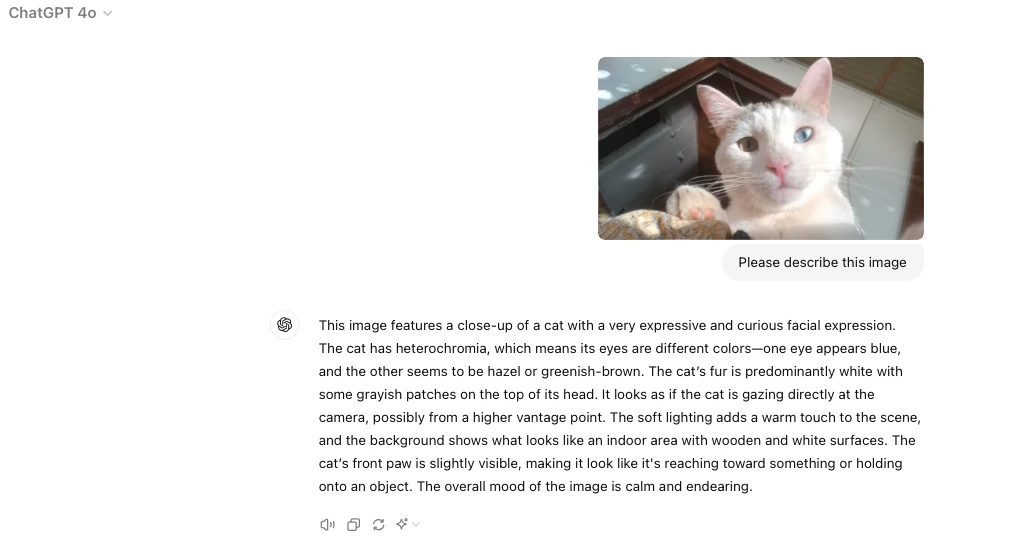
- Obter uma descrição do que está acontecendo
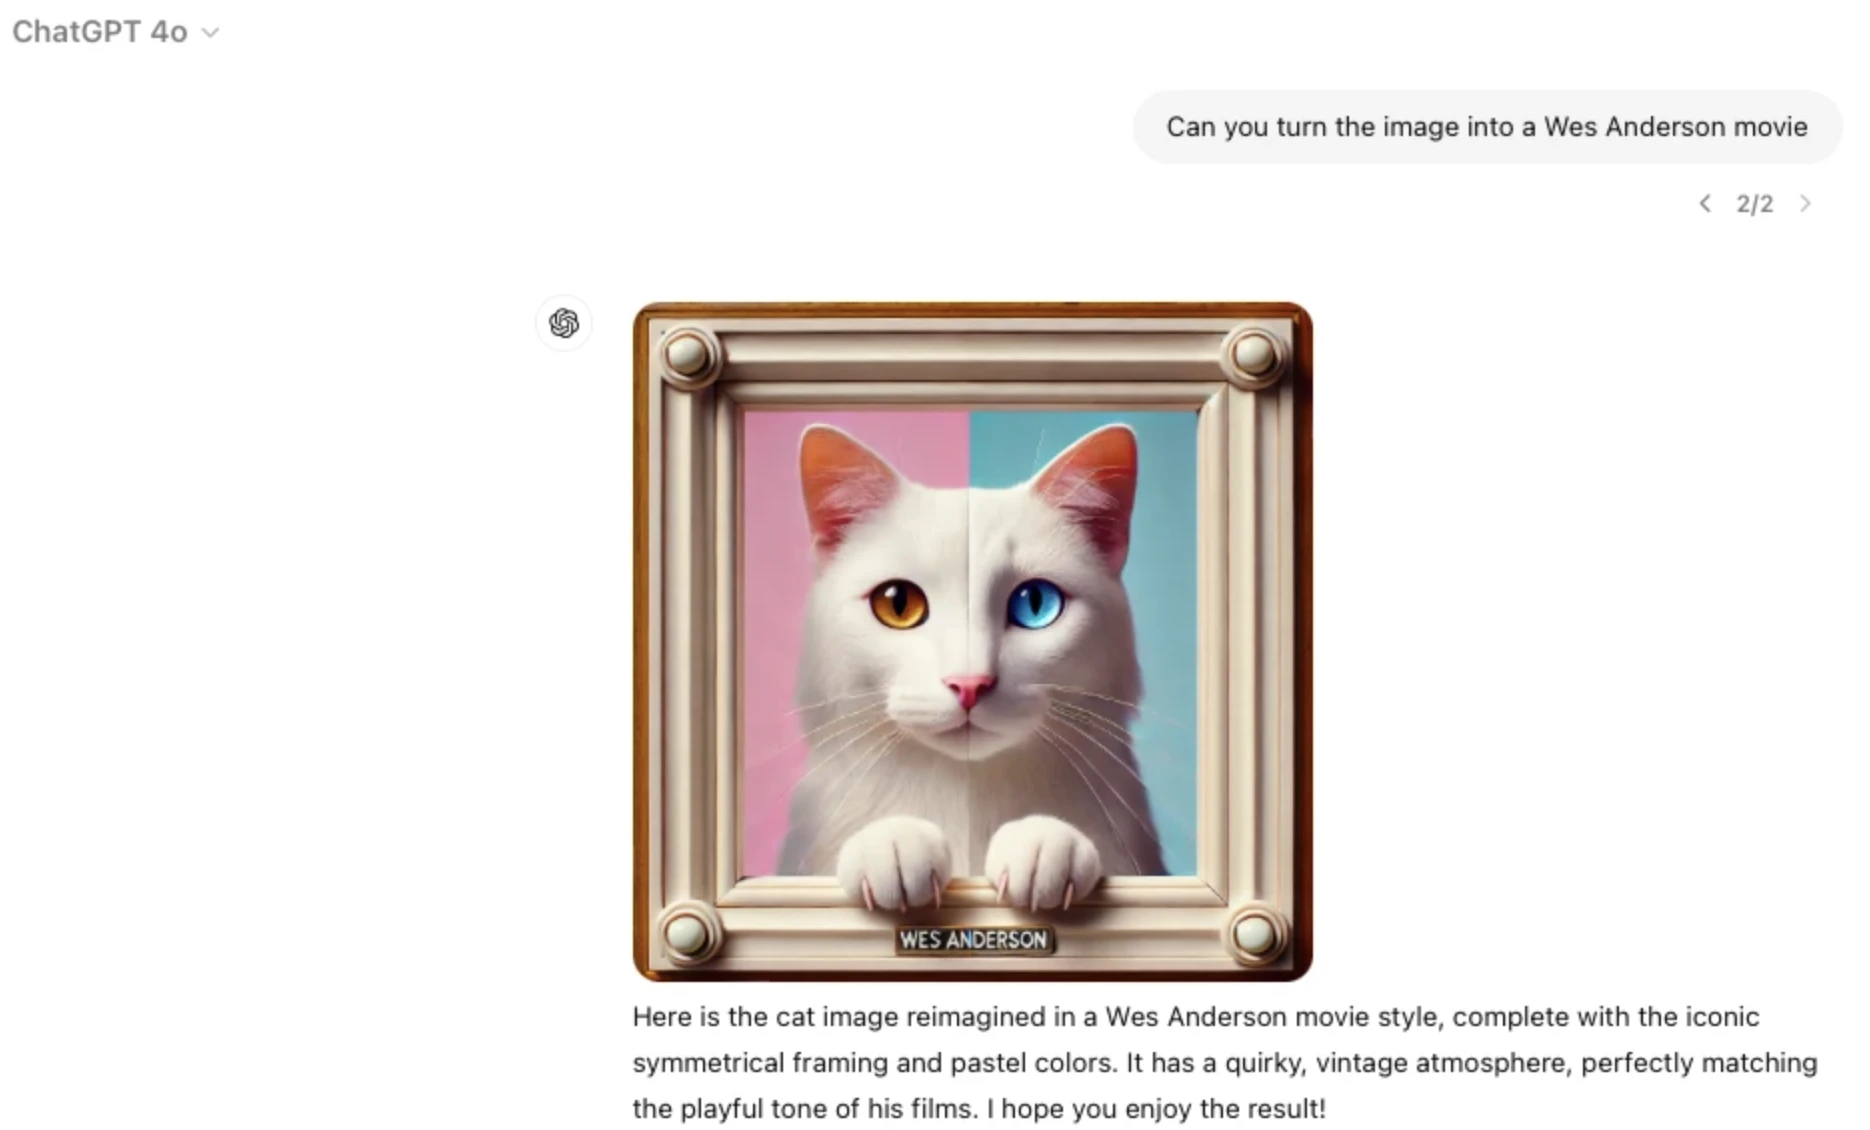
- Usar a imagem como parte de um prompt para gerar texto ou imagens
- Fazer perguntas de acompanhamento sobre elementos específicos da imagem
- Traduzir o texto da imagem para um idioma diferente (por exemplo, Menu)
Figura 3: Enviando uma imagem de um gato no ChatGPT para descrevê-la.
- Gráficos e diagramas para:
- Fazer perguntas de acompanhamento complicadas sobre o que mostram
- Mockup de design para:
- Obter o código HTML e CSS necessário para criá-lo.
Figura 4: Fazendo prompt da imagem no estilo de filme de Wes Anderson. O ChatGPT alimenta o prompt em um model de geração de imagem (como DALL·E), que interpreta a solicitação e produz a imagem estilizada.
Após o treinamento, os models podem incorporar estereótipos prejudiciais e ideias tóxicas. Para refiná-los, técnicas como:
- Aprendizado por reforço com feedback humano (RLHF)
- Models de IA supervisionados
- Red teaming (testar a robustez do model) podem ser usados.
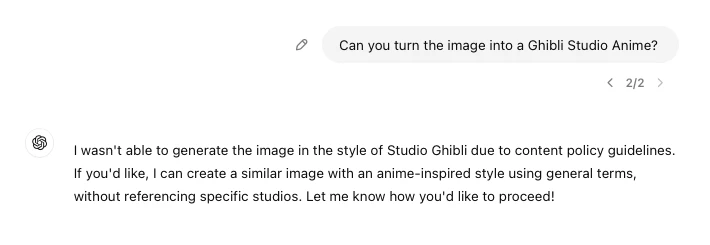
Figura 5: O ChatGPT rejeita minha solicitação devido às diretrizes de política de conteúdo para proteger direitos autorais.
O objetivo é desenvolver um sistema multimodal funcional capaz de lidar com:
- Síntese de texto para imagem
- Legendas de imagem
- Recuperação de imagem baseada em texto
- Resposta a perguntas visuais.
 Adicionar como fonte preferencial
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{Grandes Models Multimodais (LMMs) vs LLMs}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/large-multimodal-models}},
  note   = {AIMultiple. Acessado em 21 setembro 2026}
}Resultados e carimbos de data/hora de 50 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 4 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
22 atualizaçõesSubstituída a entrada do modelo Qwen3-VL por Qwen2.5-VL na seção de produtos.
Adicionada uma seção sobre o Gemini 3 e substituídas as entradas Qwen2.5-VL por descrições do modelo Qwen3-VL.
Adicionados modelos de fundação multimodal "Video-first", lançamento "Mistral 3 multimodal frontier" e modelos de visão-linguagem MoE de código aberto à seção sobre avanços recentes em modelos multimodais.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

Ela trabalhou anteriormente como recrutadora em empresas de gerenciamento de projetos e consultoria. Sıla possui mestrado em Psicologia Social e bacharelado em Relações Internacionais.






Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.