


Compare Models de IA Multimodais em Raciocínio Visual

Avaliamos 40 principais models de IA multimodais em raciocínio visual usando 200 perguntas baseadas em imagens. A avaliação consistiu em duas trilhas: 100 perguntas de compreensão de gráficos testando interpretação de visualização de dados, e 100 perguntas de lógica visual avaliando reconhecimento de padrões e raciocínio espacial.
Benchmark de raciocínio visual
Veja nossa metodologia de benchmark para conhecer nossos procedimentos de teste.
Todos os models pontuam mais baixo em lógica visual do que em gráficos. A diferença é menor para qwen3.8-flash (58% vs 78%) e maior para claude-sonnet-4.5 (35% vs 77%).
- gemini-4-argon tem a maior pontuação em ambas as categorias: 62% em lógica visual e 87% em compreensão de gráficos. Também ocupa o primeiro lugar geral com 74,5%, 1 ponto à frente de gemini-3.7-flash e claude-opus-5.5 (73,5% cada). Isso representa uma diferença de 2 perguntas em 200, então os três primeiros estão a poucas perguntas uns dos outros.
- gemini-3.5-flash-lite (36,5%) e llama-4-maverick (38,5%) estão em último lugar geral por causa da lógica visual. Eles acertam 22% e 19% dessas perguntas, e claude-haiku-4.5 acerta 20%. Todos os três estão próximos dos 20% que o chute aleatório proporciona com cinco opções. Em gráficos, os mesmos três models também ficam em último lugar, com 51% a 61%.
Comparação de custo & latência
Perguntas de benchmark sobre onde os LLMs se destacam e têm mais dificuldade
Pergunta de gráfico com a menor taxa de sucesso de LLM
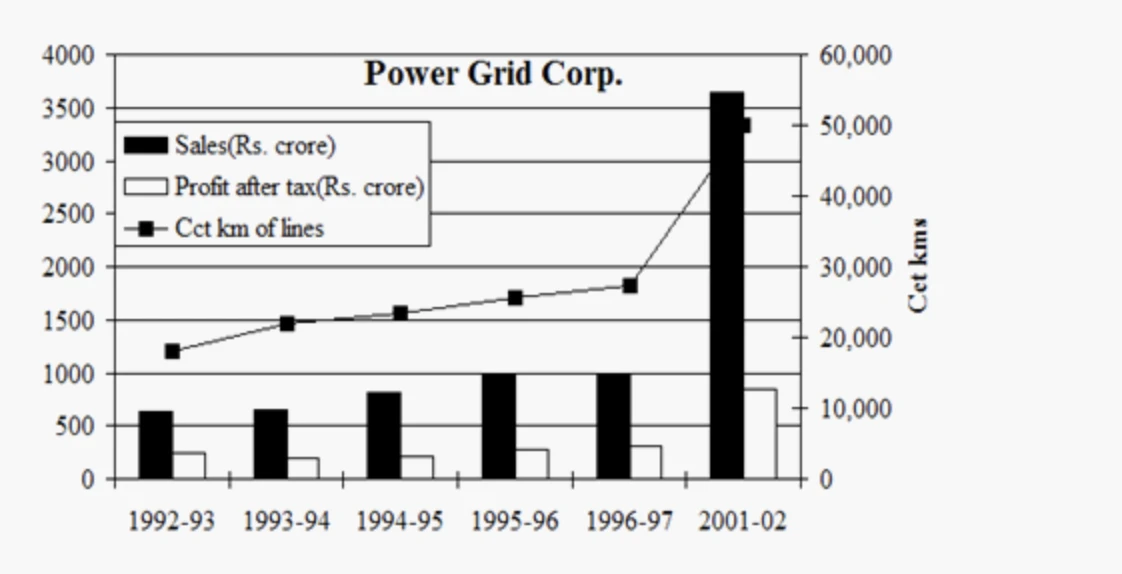
Figura 1: Gráfico de barras da Power Grid Corp. mostrando Vendas (barras pretas) e Lucro após impostos (barras brancas) de 1992-93 a 1996-97 e 2001-02, com uma linha para km de circuito de linhas em um segundo eixo y.
Nota: Todos os gráficos foram obtidos do Hitbullseye.1
Pergunta: A lucratividade (Lucro / Vendas) é a mais alta em: A. 1992-93 B. 1993-94 C. 2001-02 D. 1996-97
Nenhum dos 40 models respondeu corretamente (a resposta é D, 1996-97), e 38 deles escolheram 1992-93. O cálculo é uma única divisão por ano, portanto a dificuldade está na leitura do gráfico.
As barras de lucro são pequenas e brancas, apenas algumas centenas de crore em um eixo de 0-4.000 com linhas de grade a cada 500. As diferenças entre os anos se resumem a alguns pixels. O segundo eixo y e a linha sobreposta adicionam poluição visual. Os models tiveram que comparar essas barras brancas curtas com as pretas muito mais altas, e um pequeno erro na leitura da altura da barra foi suficiente para mudar a resposta.
Pergunta de gráfico com a maior taxa de sucesso de LLM
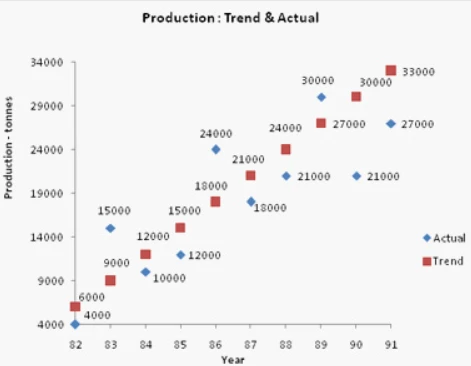
Figura 2: Gráfico de dispersão mostrando a produção real e de tendência (em toneladas) de 1982 a 1991. Losangos azuis marcam valores reais, quadrados vermelhos marcam valores de tendência, e cada ponto está rotulado com seu valor.
Pergunta: A tendência foi estabelecida como: A. A produção deste ano é uma vez e meia a do ano passado. B. A produção deste ano é o dobro da do ano passado. C. A produção deste ano é três mil toneladas a mais que a do ano passado. D. A produção deste ano é quatro mil e quinhentas toneladas a mais que a do ano passado.
Todos os models responderam a esta pergunta corretamente. Os pontos de tendência aumentam na mesma quantidade a cada ano (6.000, 9.000, 12.000 e assim por diante até 33.000). Como cada ponto traz seu valor como rótulo, os models podiam ler os números diretamente em vez de estimar posições em relação ao eixo.
O gráfico da Power Grid exigia comparar as alturas de barras pequenas. Aqui não é necessário estimar alturas: os rótulos fornecem valores exatos, e a única etapa restante é uma simples subtração.
Pergunta de lógica visual com a maior taxa de sucesso de LLM
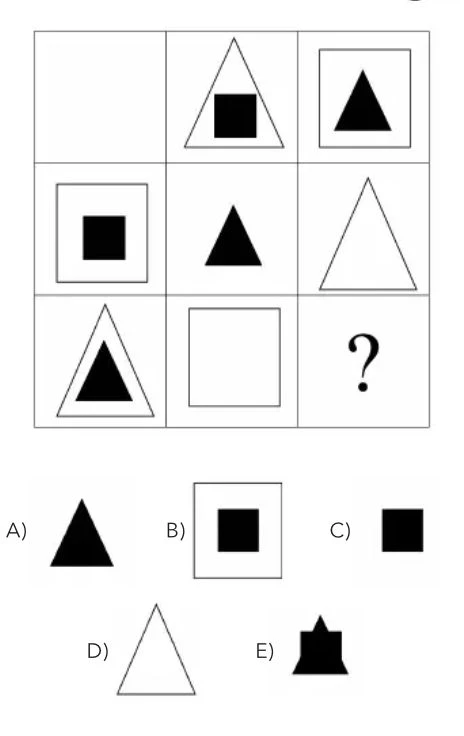
Figura 4: Uma grade 3×3 na qual cada célula contém um triângulo ou quadrado branco ou preto, sozinho ou aninhado dentro do outro. A célula inferior direita está faltando, e cinco opções são fornecidas.
Pergunta: Qual opção completa a grade?
38 dos 40 models responderam corretamente (a resposta é C, um quadrado preto). Apenas claude-haiku-4.5 e llama-4-maverick erraram. Cada linha e coluna contém um triângulo branco, um quadrado branco, um triângulo preto e um quadrado preto exatamente uma vez. A peça que falta pode, portanto, ser encontrada listando o que já está lá.
Na grade de hexágonos, a regra dependia de como as formas eram divididas em regiões. Aqui cada elemento é uma forma separada e claramente desenhada que os models podem identificar e contar.
Pergunta de lógica visual com a menor taxa de sucesso de LLM
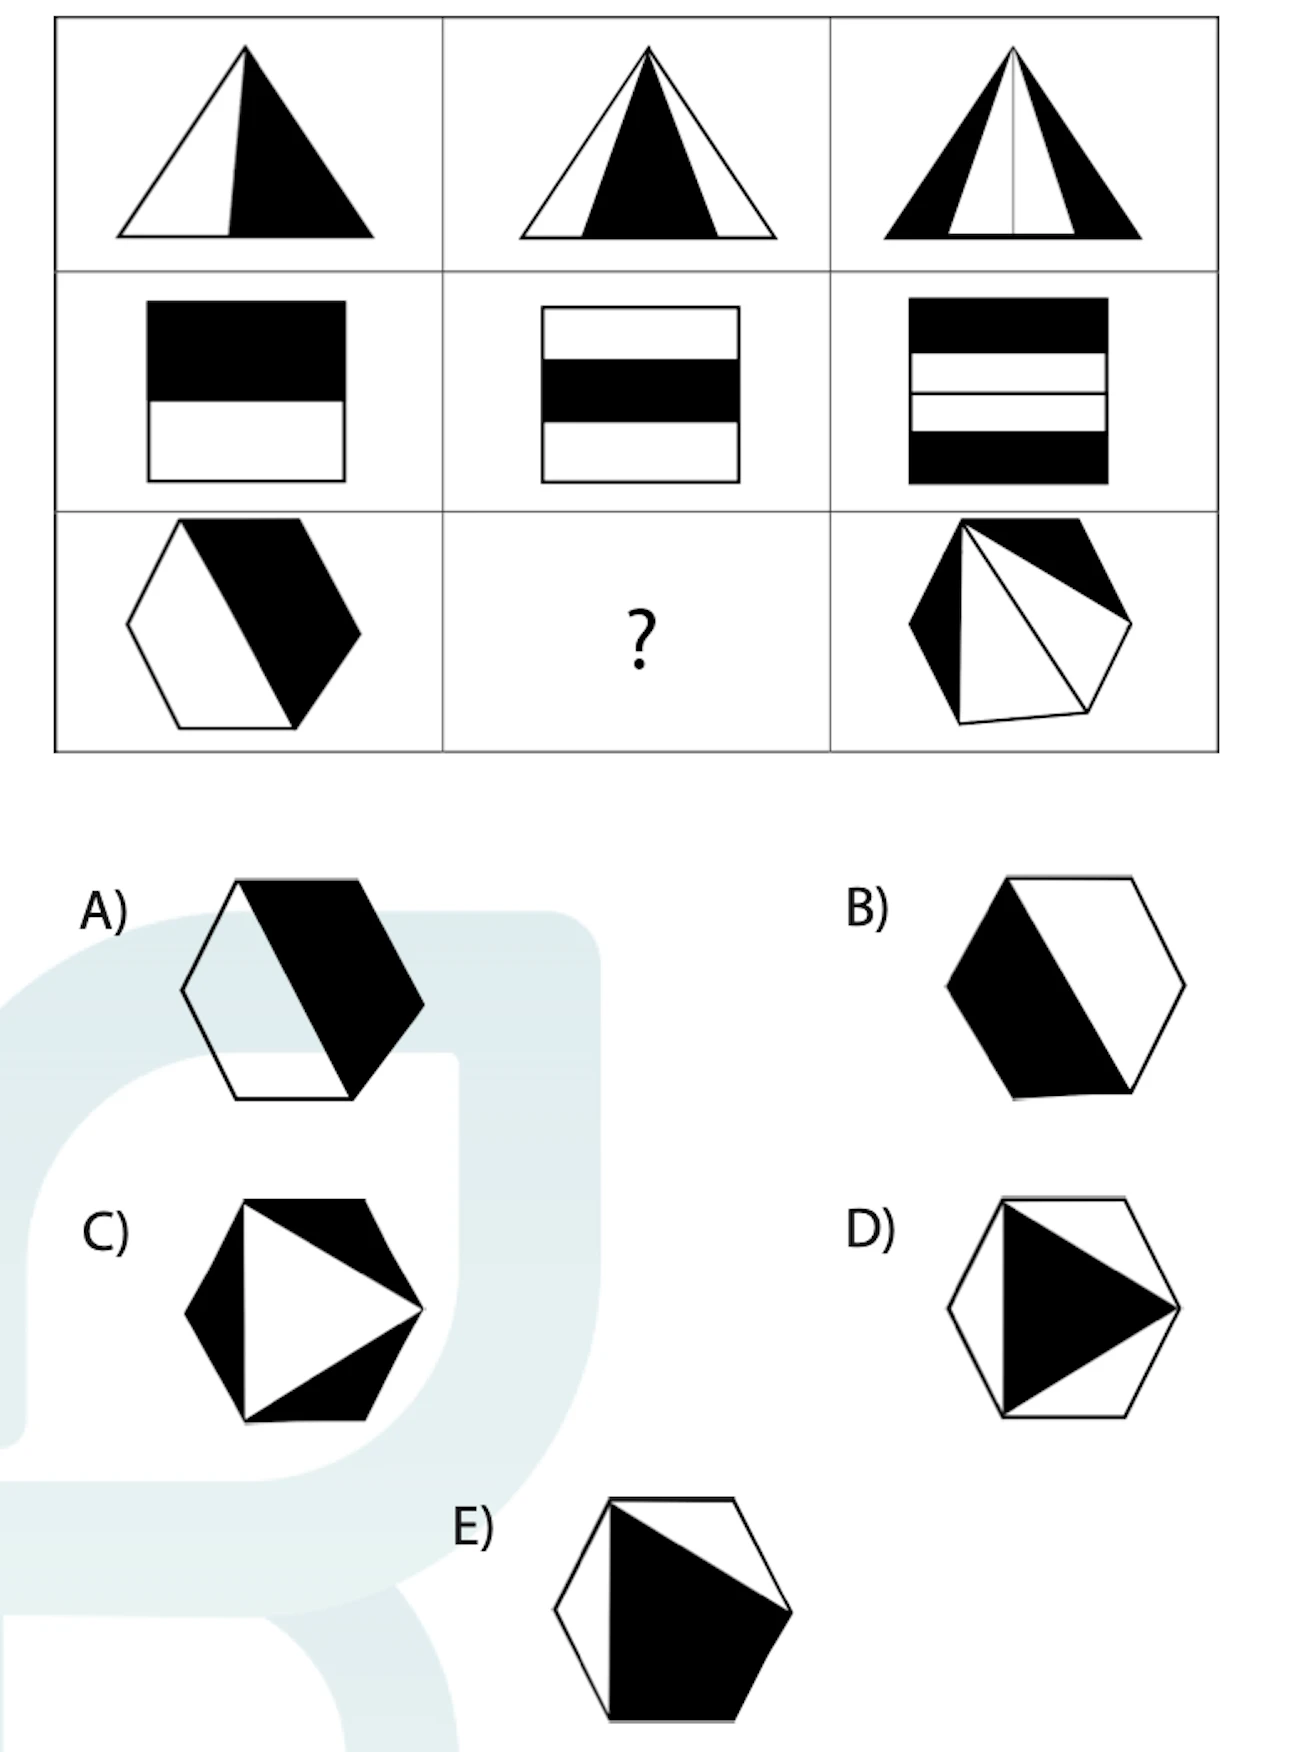
Figura 3: Uma grade 3×3 de formas: triângulos na primeira linha, retângulos na segunda e hexágonos na terceira. Cada forma é dividida em regiões pretas e brancas, e o hexágono central está faltando. Cinco hexágonos são fornecidos como opções.
Pergunta: Qual opção completa a grade?
Nenhum dos 40 models respondeu corretamente. A pergunta não tem números nem cálculos; a única tarefa é ver como as regiões pretas e brancas mudam em cada linha.
Metodologia do benchmark
Avaliamos 40 models com capacidade visual em 200 perguntas de múltipla escolha baseadas em imagens.
- Raciocínio: Cada model foi configurado para o maior esforço de raciocínio que suporta (max, xhigh ou high, dependendo do model). Para alguns models, nenhum parâmetro de esforço de raciocínio foi aceito, então o padrão do provedor foi aplicado:
- gemini-3.1-pro-preview, gemini-3.6-flash, gemini-3.7-flash, gemini-3.8-flash, gpt-5.2-pro e qwen3.8-flash ainda raciocinaram por padrão.claude-haiku-4.5 e gemini-3.5-flash-lite não produziram tokens de raciocínio.kimi-k2.5 raciocinou em apenas 34 de suas 200 chamadas.
- Temperatura: Não definida, então o padrão de cada provedor foi aplicado.
- Tokens máximos: Definido para 1.000.000 para que o comprimento da saída não limitasse o raciocínio. Se um provedor rejeitasse esse valor, o limite máximo de saída do próprio model era usado.
- Execuções: Cada pergunta foi executada uma vez por model, totalizando 7.600 chamadas.
- Repetições: Chamadas com falha foram repetidas até 3 vezes, com intervalos de 60 segundos. Em 4 perguntas de lógica visual, muse-wonder nunca retornou uma resposta: seu provedor fechou a conexão após cerca de 6.5 minutos em cada tentativa. Essas 4 perguntas contam como erradas, portanto nenhuma pergunta foi excluída.
- Custo e latência: O custo é o custo cobrado que o gateway relatou para cada chamada. A latência é a duração da chamada bem-sucedida, excluindo esperas de repetição.
O benchmark consistiu em 200 perguntas em duas categorias: Compreensão de gráficos (100 perguntas) e Lógica visual (100 perguntas). As perguntas de gráficos enviam o gráfico como imagem, com a pergunta e as opções em texto. As perguntas de lógica visual colocam a pergunta inteira, incluindo as opções, dentro da imagem. A maioria das perguntas de gráficos tem quatro opções (89 de 100), e as demais têm cinco ou menos. As perguntas de lógica visual têm cinco opções (A-E).
Perguntas:
- Compreensão de gráficos (100 perguntas). Avaliamos a capacidade dos models de extract, interpretar e analisar informações de visualizações de dados:
- Gráficos de barras (40): gráficos de barras simples, agrupados e de eixo duplo
- Gráficos de dispersão (26): leitura de valores e tendências a partir de pontos rotulados
- Gráficos de pizza (14): distribuições percentuais e raciocínio proporcional
- Gráficos de linha (10): tendências de série única e multisséries ao longo do tempo
- Exibições combinadas (10): um gráfico mostrado junto com um segundo gráfico ou uma tabela de dados
- Lógica visual (100 perguntas). Avaliamos raciocínio abstrato e inteligência espacial por meio de:
- Reconhecimento de padrões: identificar sequências e completar padrões visuais
- Raciocínio espacial: transformações de formas e sobreposição de figuras
- Lógica matemática: padrões numéricos, raciocínio algébrico e combinatória
- Pensamento abstrato: manipulação de símbolos, dedução lógica e inferência de regras
 Adicionar como fonte preferencial
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Compare Models de IA Multimodais em Raciocínio Visual}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/visual-reasoning}},
  note   = {AIMultiple. Acessado em 14 outubro 2026}
}Resultados e carimbos de data/hora de 22.9 mil pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 4 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
6 atualizaçõesAtualizado o número de modelos avaliados na seção de benchmark de raciocínio visual.
Substituída a configuração do parâmetro de tokens máximos na metodologia de Benchmark.
Links de referência




Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.