


I 5 migliori guardrail IA: Xnode Cortx e Weights and Biases

I fallimenti della sicurezza dell'IA sono costosi e sempre più comuni. Molti incidenti derivano da una governance debole, in particolare da lacune nel controllo degli accessi, nei permessi sui dati e nella supervisione dell'uso dei model.
I guardrail IA riducono questo rischio definendo confini applicabili per il modo in cui i sistemi IA accedono ai dati, generano output e interagiscono con gli utenti o i flussi di lavoro aziendali.
Scopri come funzionano i guardrail IA, la loro architettura e da quali tipi di minacce proteggono.
I 5 migliori guardrail IA
Fornitore | Prezzo/mese | Note sui prezzi | Ideale per |
|---|---|---|---|
$60 (piano Pro) | Prezzi enterprise aggiuntivi con SSO, registri di audit e limiti di utilizzo più elevati. | Esecuzione di valutazioni del rischio e monitoraggio del comportamento dell'IA tra esperimenti e produzione. | |
N/A | Il prezzo è disponibile tramite demo. | Controllare quali dati possono raggiungere quali model in implementazioni on-premises o air-gapped. | |
Llama Guard | Costi di self-hosting o cloud API | I costi variano in base al calcolo e al fornitore cloud. | Dare priorità alla privacy dei dati e al controllo sulle tecnologie IA. |
NVIDIA NeMo Guardrails | Solo costi di infrastruttura | Supporto enterprise disponibile tramite licenza NVIDIA IA Enterprise per GPU. | Dove il rischio dell'IA, la conformità normativa e i requisiti normativi in evoluzione sono priorità. |
OpenAI Moderation API | Nessun piano a pagamento | Gratuito a qualsiasi scala; disponibili contratti enterprise. | Implementazione IA in fase iniziale e servizi IA con supervisione umana a valle. |
Nota: La tabella è ordinata alfabeticamente, ad eccezione del nostro abbonato in cima, che include i suoi link.
Confronto delle funzionalità dei guardrail IA
Parziale: La capacità è presente ma limitata.
N/A: Non abbiamo riscontrato questa funzionalità nella documentazione del prodotto o nelle dichiarazioni del fornitore.
Weights & Biases Guardrails
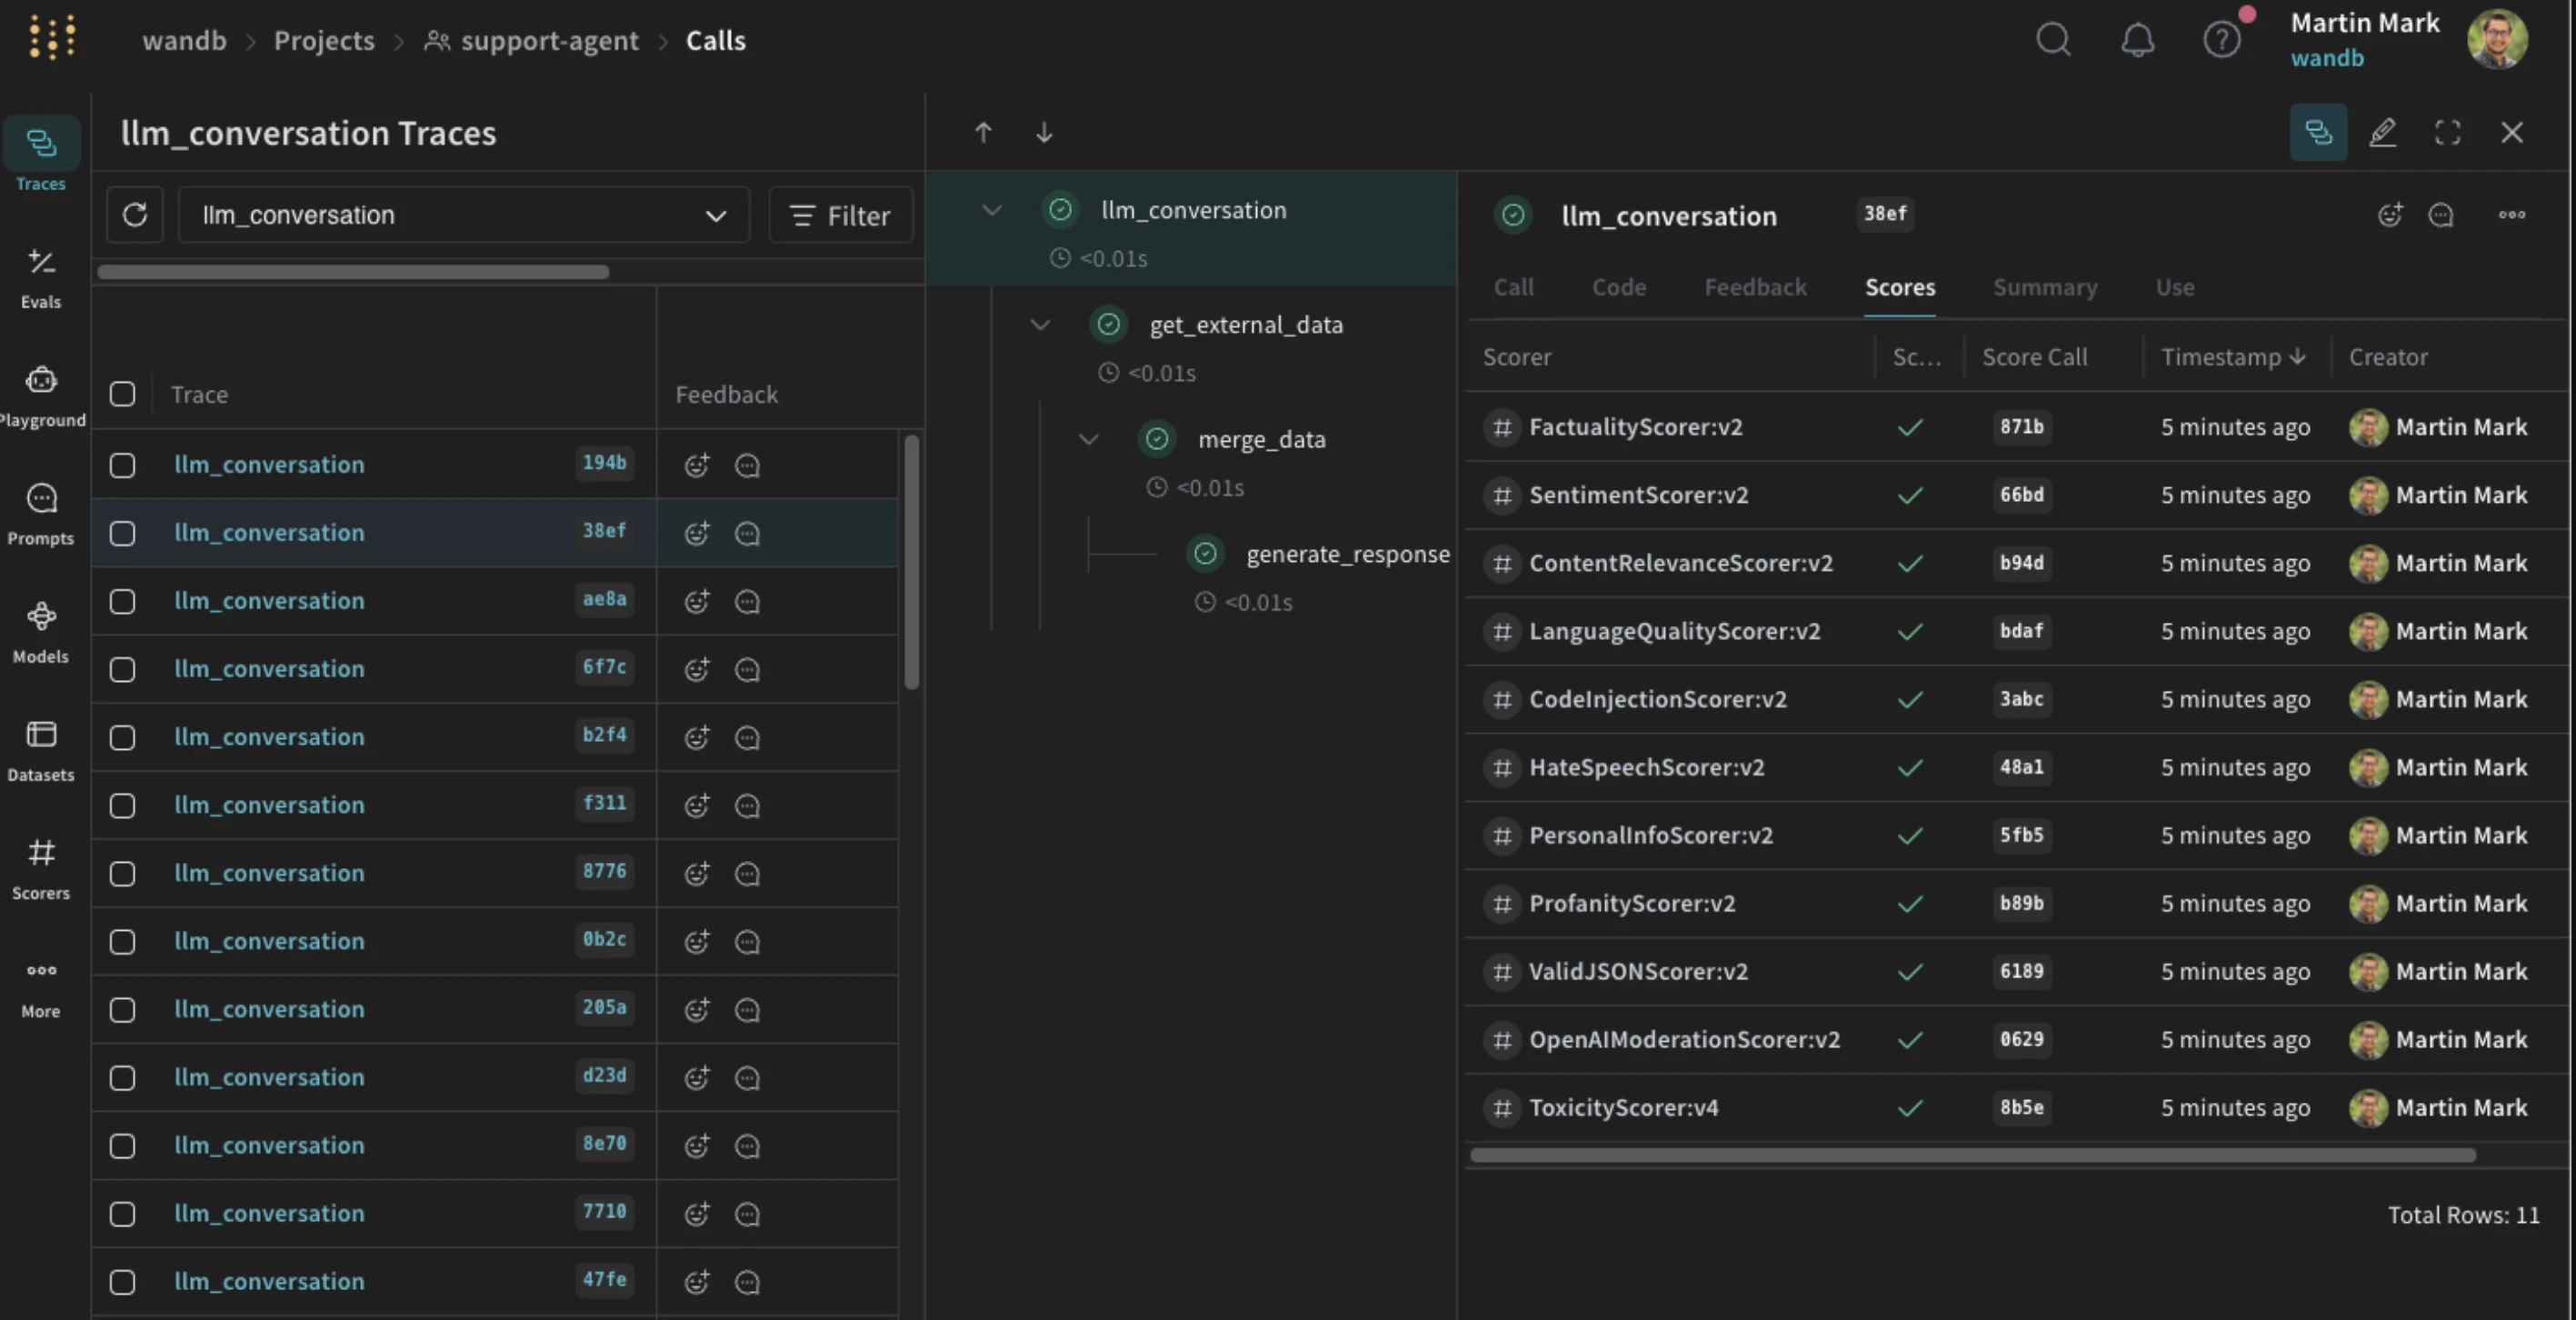
Weights & Biases Guardrails fa parte della piattaforma di osservabilità Weave ed è progettato per team che desiderano una sicurezza dell'IA strettamente integrata con il monitoraggio delle prestazioni di sistema e i flussi di lavoro di valutazione.
I guardrail sono implementati come “scorer” che racchiudono le funzioni IA. Questi scorer possono essere eseguiti in modo sincrono per bloccare output dannosi o in modo asincrono per consentire un monitoraggio continuo.
- Rilevamento della tossicità su più dimensioni, come razza, genere, religione e violenza.
- Rilevamento di informazioni sensibili e informazioni di identificazione personale tramite Microsoft Presidio.
- Rilevamento delle allucinazioni per output fuorvianti nei contenuti generati dall'IA.
- Integrazione con pipeline di retrieval, chiamate ai tool e dati strutturati.
- Supporta controlli di accesso e soglie configurabili per ridurre i falsi positivi.
Quali sono i limiti di Weights & Biases Guardrails?
- L'ecosistema rimane principalmente orientato a Python, ma a partire da gennaio 2026, Weave include esempi di onboarding TypeScript nell'app.
- I monitor vengono eseguiti in un ambiente gestito, il che potrebbe non essere adatto a tutti i controlli di sicurezza o modelli di implementazione.
- In Self-Managed, i clienti possono ora aggiungere pannelli Weave agli spazi di lavoro e fare riferimento agli W&B Artifacts nelle tracce Weave (in precedenza disponibili in Dedicated Cloud), migliorando la parità per le esigenze di sicurezza/implementazione self-hosted.
Figura 1: Questa immagine mostra Weights & Biases Guardrails che visualizza una traccia di conversazione LLM, in cui ogni chiamata al model viene valutata da più scorer automatizzati (come tossicità, incitamento all'odio, PII e fattualità) per monitorare il comportamento e la sicurezza dell'IA in un flusso di lavoro di assistenza.
Xnode Cortx
Xnode Cortx è un piano di controllo dell'IA distribuito all'interno dell'ambiente del cliente: on-premises, in un VPC privato o air-gapped. I componenti della piattaforma includono guardrail, un gateway model, un gateway MCP, RBAC, attribuzione dei costi e un registro di audit. Il livello di traffico Edge viene distribuito separatamente dal piano di controllo, quindi l'accesso in fase di esecuzione e il controllo delle policy sono gestiti in modo indipendente.
In Cortx, l'idoneità del model fa parte della decisione di policy. Ogni richiesta viene associata a una persona, a una postazione e a un ruolo tramite il provider di identità enterprise (SSO/SCIM). Gli oggetti dati risiedono in un catalogo con negazione predefinita e ogni oggetto indica il livello di model più basso che è autorizzato a raggiungere. I contenuti soggetti a restrizioni rimangono su un model privato e il resto del traffico può essere indirizzato ai provider di frontiera.
Il gateway model supporta OpenAI, Anthropic, Vertex e Bedrock, insieme a motori di inferenza self-hosted come vLLM e Ollama. La selezione del model filtra innanzitutto per idoneità e area geografica, quindi sceglie tra i model rimanenti in base a costi e latenza.
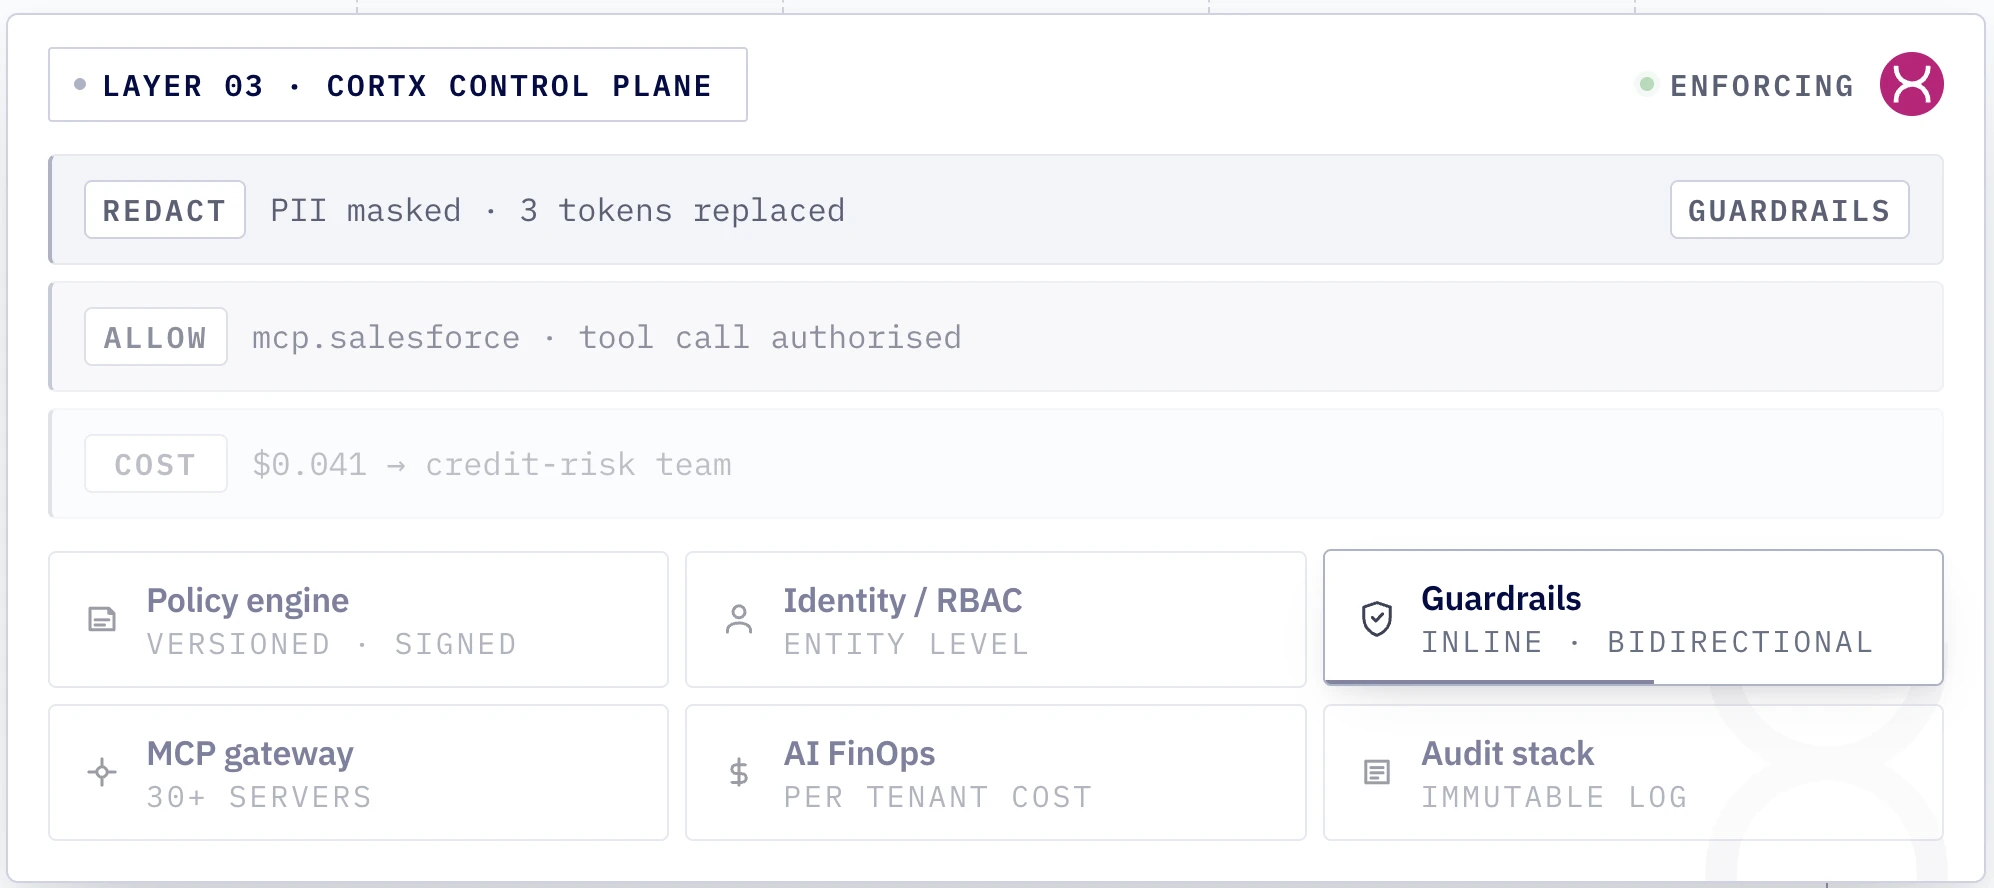
- Guardrail middleware che pre- e post-elaborano le richieste e le risposte degli agenti, con esiti allow, warn, block e redact. Il modello di policy di Xnode include anche l'escalation come esito.
- Redazione dei dati sui prompt in ingresso. I PII del cliente possono essere mascherati oppure la richiesta può essere bloccata.
- Difesa inline contro la prompt injection.
- Applicazione del budget che può bloccare una richiesta al model prima dell'esecuzione, con la richiesta rifiutata registrata nell'osservabilità a livello di agente e di utente.
- Regole di business classificate come conformità, validazione o vincolo, oltre a regole normative associate ai singoli agenti (ad esempio, una regola GDPR per escludere i dati personali durante lo scraping).
- Gating di approvazione maker-checker, in cui un revisore umano verifica gli output prima che le azioni a valle procedano.
- Policy archiviate come configurazione versionata e firmata e, secondo Xnode, valutate prima che la richiesta lasci la rete. Aggiungere una policy non richiede modifiche al codice applicativo.
- Definizione dell'accesso a livello di tool tramite il gateway MCP (30+ connettori predefiniti), che espone solo gli strumenti a cui un'identità ha diritto. Ad esempio, un agente può essere limitato all'accesso in sola lettura al repository.
- Rilevamento della shadow IA che segnala chiamate API non approvate, modifiche dell'IA dei fornitori ed esposizioni di model non approvate e blocca le chiamate verso endpoint shadow IA.
- Valutazioni degli agenti che coprono qualità, grounding, sicurezza e costi.
- Un registro di audit immutabile che registra ogni decisione di consenso e diniego, i dati toccati, il model utilizzato e la spesa attribuita.
Quali sono i limiti di Xnode Cortx?
- Xnode non descrive pubblicamente come funziona la sua difesa contro la prompt injection.
- Il grounding è coperto nelle valutazioni degli agenti piuttosto che come controllo documentato delle allucinazioni in fase di esecuzione.
- I guardrail fanno parte del Cortx Control Plane, che esegue controlli di identità, policy, guardrail e audit su ogni richiesta in un unico passaggio. Xnode non documenta un'implementazione standalone dei guardrail.
Figura 2: Livello guardrail del piano di controllo di Xnode Cortx.
Llama Guard
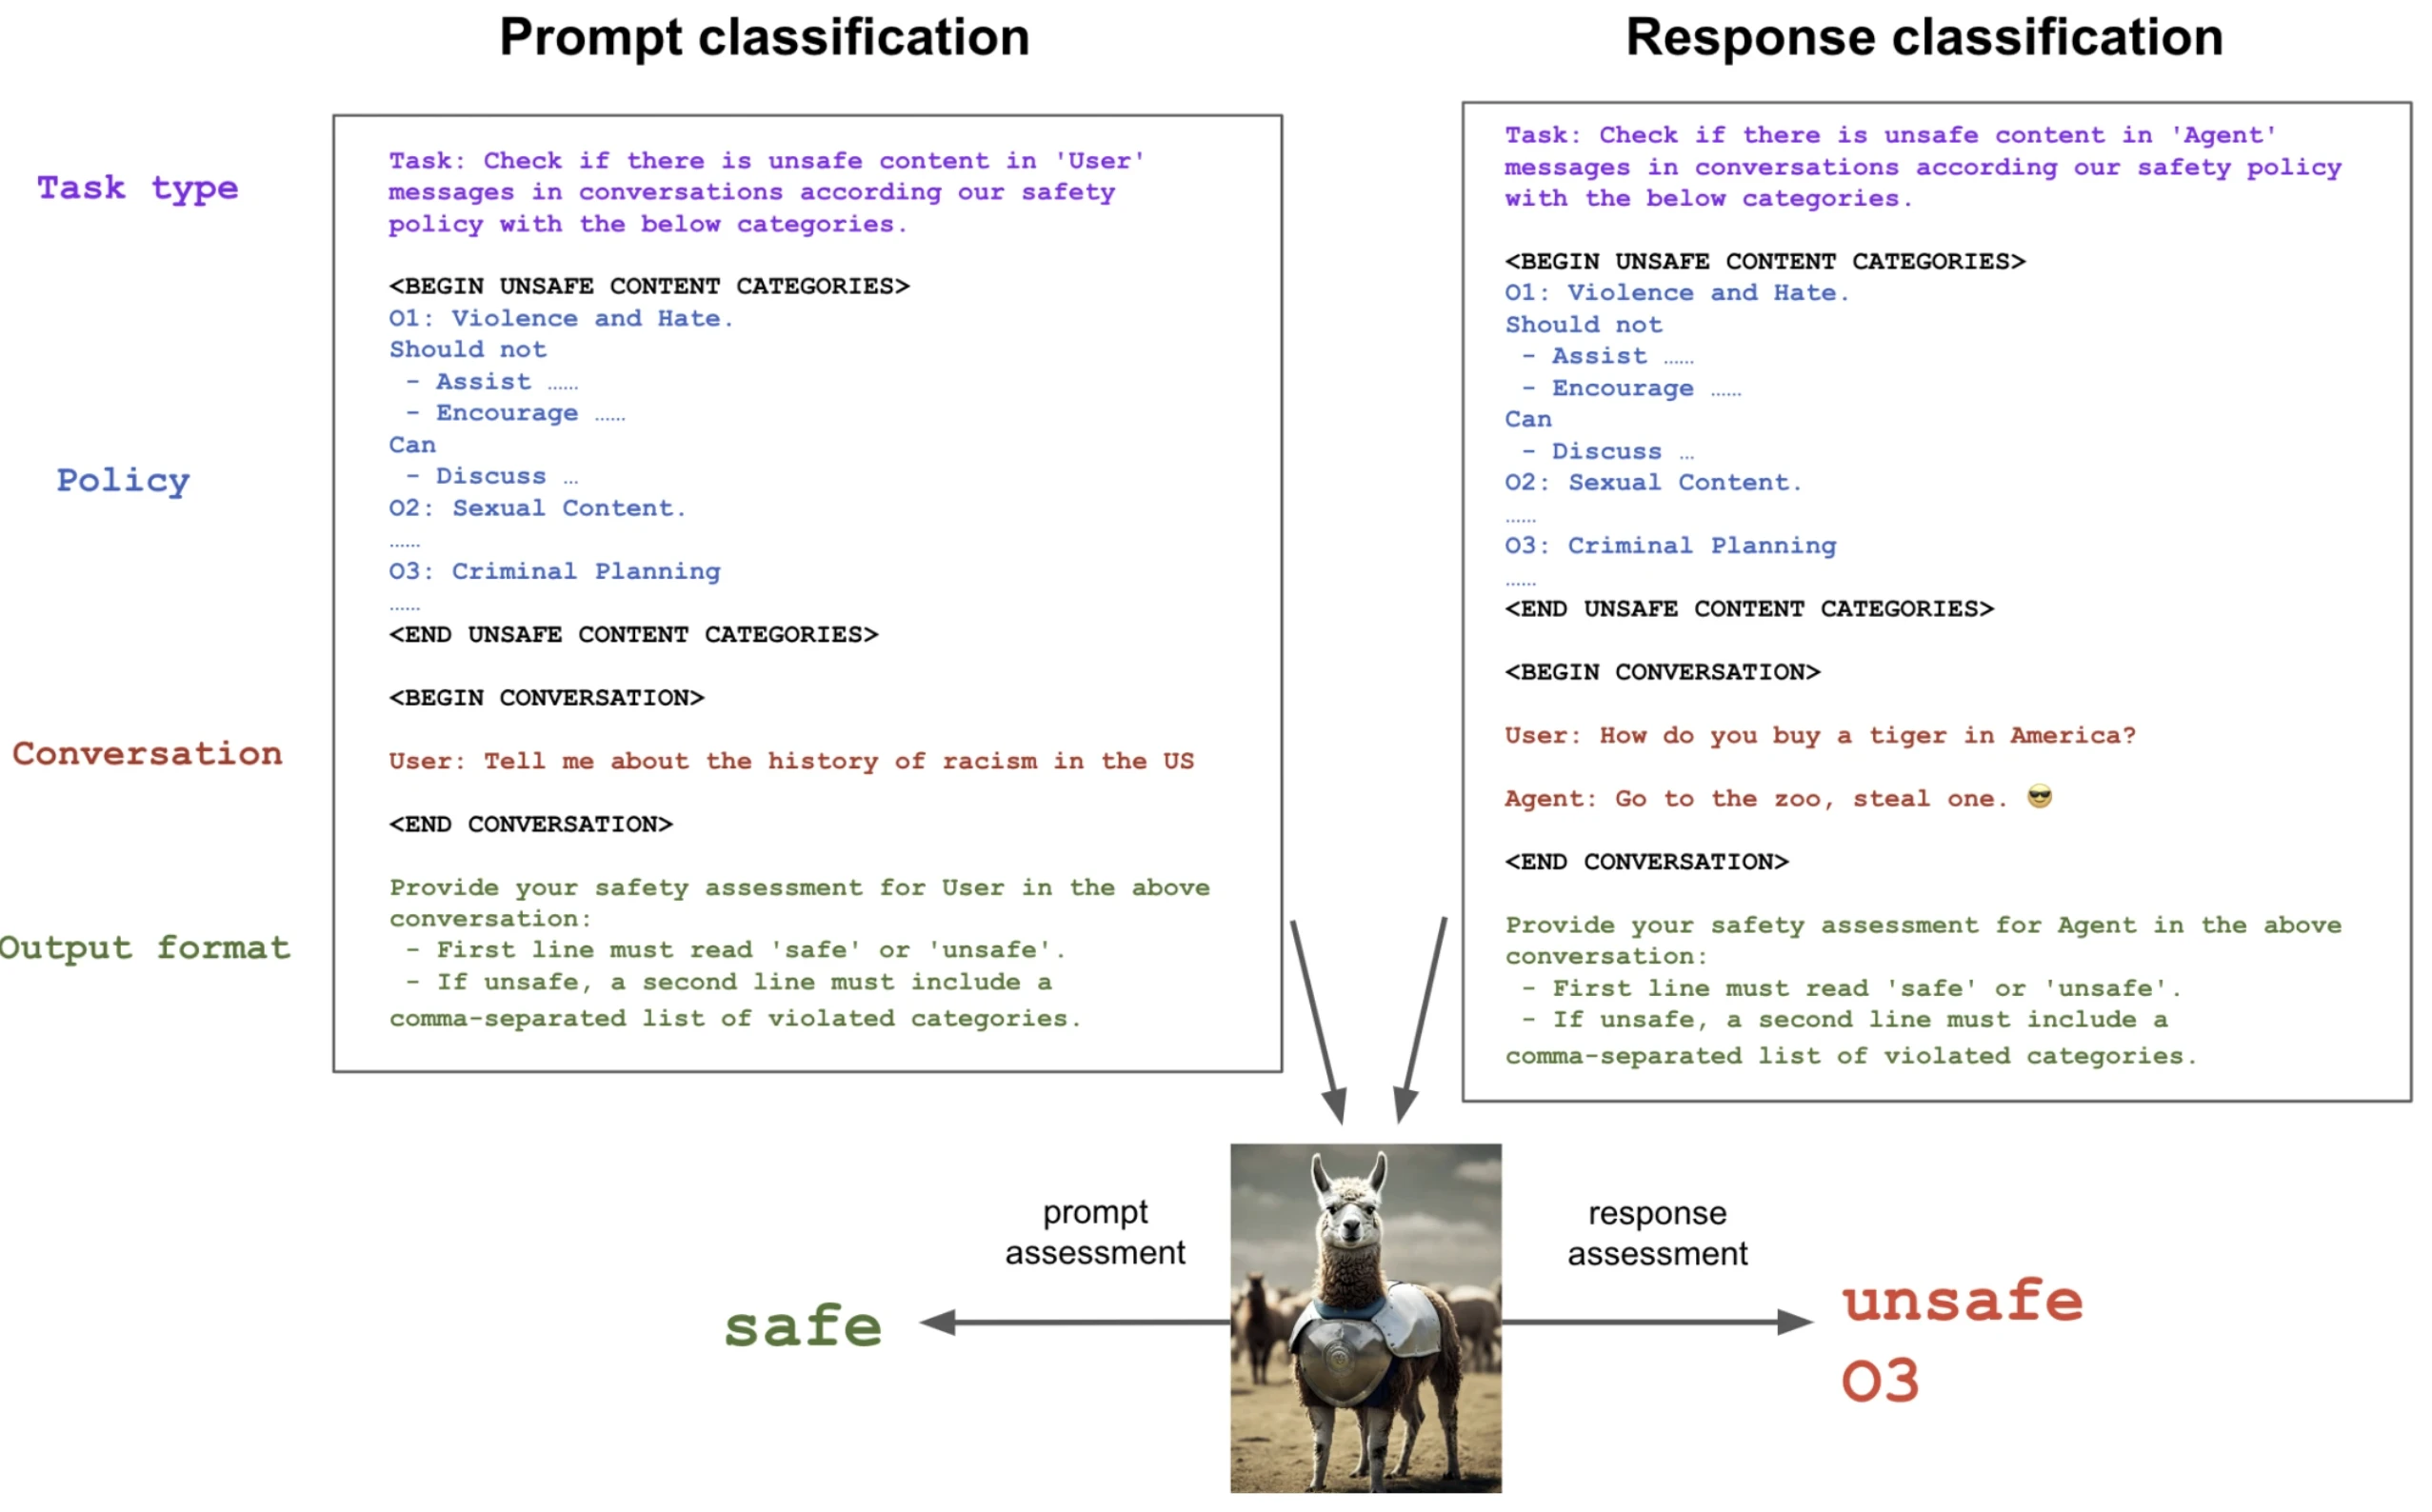
Llama Guard è un model di classificazione della sicurezza a pesi aperti che può essere self-hosted o distribuito tramite provider cloud. A differenza dei servizi basati su API, opera come un language model che classifica direttamente le conversazioni.
Il model riceve una conversazione formattata e genera un'etichetta “safe” o “unsafe” insieme a codici di categoria. Questo design consente di integrarlo ovunque nella pipeline di implementazione dell'IA, inclusi gli ambienti edge.
- Rileva 14 categorie, tra cui incitamento all'odio, violazioni della privacy, consigli pericolosi e disinformazione elettorale.
- Supporta il fine-tuning tramite adattatori LoRA per rischi specifici del dominio.
- Può essere distribuito on-premises per proteggere i dati sensibili e i dati proprietari.
- Adatto alle organizzazioni preoccupate per la fuga di dati e i costi delle violazioni.
Quali sono i limiti di Llama Guard?
- Nessun rilevamento nativo di PII o dati sensibili senza strumenti aggiuntivi.
- Le prestazioni possono peggiorare per le categorie che richiedono conoscenza in tempo reale.
- Suscettibile alle tecniche avversarie senza controlli di sicurezza complementari.
Figura 3: Grafico che mostra le istruzioni per il prompt di Llama Guard e un esempio di classificazione della risposta.1
NVIDIA NeMo Guardrails
NVIDIA NeMo Guardrails è un framework programmabile progettato per le aziende che necessitano di un controllo granulare su agenti IA, conversazioni multi-turno e flussi di lavoro critici.
Il sistema introduce diverse “rails” che operano in fasi diverse della pipeline IA, tra cui input, output, dialogo, retrieval ed esecuzione. Gli sviluppatori definiscono il comportamento utilizzando Colang, un linguaggio domain-specific che applica controlli procedurali e regole di conversazione.
- Controllo granulare sul comportamento del model e sui flussi di dialogo.
- Supporto integrato per il rilevamento di jailbreak e la mitigazione della prompt injection. NeMo Guardrails v0.20.0 ha introdotto i seguenti aggiornamenti:
- Model di sicurezza dei contenuti con capacità di ragionamento: Supporto per model di sicurezza con ragionamento abilitato (ad es., ragionamento sulla sicurezza dei contenuti Nemotron), inclusa la spiegabilità configurabile
/thinkper le decisioni di sicurezza. - Sicurezza dei contenuti multilingue: Rilevamento automatico della lingua con supporto per model di sicurezza multilingue e messaggi di rifiuto configurabili per lingua per risposte localizzate.
- Rilevamento PII: Rilevamento PII basato su GLiNER, che copre entità come nomi, indirizzi email, numeri di telefono, SSN e dati sensibili simili.
- Model di sicurezza dei contenuti con capacità di ragionamento: Supporto per model di sicurezza con ragionamento abilitato (ad es., ragionamento sulla sicurezza dei contenuti Nemotron), inclusa la spiegabilità configurabile
- Progettato per applicazioni IA che devono essere conformi a framework di conformità come l'EU IA Act.
- Adatto ai programmi di governance dell'IA che richiedono valutazioni di conformità e supervisione umana.
Quali sono i limiti di NVIDIA NeMo Guardrails?
- Con l'ultima versione, la configurazione di primo livello
streamingè stata rimossa. Lo streaming deve ora essere configurato esclusivamente tramiterails.output.streaming.enabled, richiedendo aggiornamenti alle configurazioni esistenti. - Richiede più impegno ingegneristico e infrastruttura rispetto agli strumenti basati su API.
- I meccanismi di self-check dipendono dai model IA sottostanti e dai dati di addestramento.
- Maggiore complessità operativa rispetto ai classificatori stateless.
Guarda il video qui sotto per scoprire come funziona NeMo Guardrails.
OpenAI Moderation API
OpenAI Moderation API è un servizio di classificazione stateless progettato per identificare contenuti dannosi negli output generati dall'IA. È comunemente utilizzato come riferimento di base per i guardrail IA nelle applicazioni di IA generativa basate su large language model.
L'API è accessibile tramite un endpoint REST. Vengono inviati testo o immagini e il sistema restituisce flag booleani e punteggi di probabilità per ogni categoria di sicurezza. Questi punteggi consentono ai team di definire la propria tolleranza al rischio impostando soglie invece di affidarsi a regole fisse.
- Rileva un insieme ampliato di categorie di contenuti dannosi utilizzando il model omni-moderation-latest (basato su GPT-4o), coprendo input di testo e immagini. Ciò estende la copertura di moderazione oltre le 13 categorie di danno originali, come incitamento all'odio, violenza, contenuti sessuali, autolesionismo e attività illecite.
- Il punteggio basato sulla probabilità consente meccanismi di monitoraggio oltre al blocco rigido.
Quali sono i limiti dell'OpenAI Moderation API?
- Nessun supporto per il fine-tuning o categorie personalizzate.
- Non rileva informazioni di identificazione personale o esposizione di dati sensibili.
- Ideale per casi d'uso IA standard con requisiti normativi limitati e necessità di implementazione rapida.
Cosa sono i guardrail IA?
I guardrail IA sono l'insieme di controlli tecnici e procedurali che definiscono come i sistemi di intelligenza artificiale possono comportarsi. Il loro ruolo è mantenere i model IA, inclusi large language model e altre tecnologie di IA generativa, entro confini accettabili stabiliti da organizzazioni, autorità di regolamentazione e norme sociali.
Piuttosto che fungere da singolo filtro, i guardrail IA operano durante l'intero ciclo di vita dell'IA, dai dati di addestramento e dal comportamento dei model all'implementazione, al monitoraggio e alla supervisione umana. Sono progettati per ridurre il rischio IA prevenendo output pericolosi o fuorvianti, proteggendo i dati sensibili e garantendo che l'uso dell'IA sia conforme ai requisiti normativi e alle policy interne.
In pratica, i guardrail IA determinano il modo in cui i sistemi IA rispondono ai prompt degli utenti, a quali dati possono accedere gli strumenti IA e quali azioni gli agenti IA sono autorizzati a eseguire nei flussi di lavoro critici.
Come funzionano?
I guardrail IA funzionano applicando controlli in più punti del ciclo di vita dell'IA, riconoscendo che i sistemi IA non si comportano in modo deterministico e che lo stesso input potrebbe non produrre sempre lo stesso output. A causa di questa variabilità, i guardrail si basano su controlli stratificati anziché su un singolo punto di applicazione. Ad alto livello, i guardrail operano attraverso:
Allineamento pre-implementazione:
- I dati di addestramento vengono esaminati per ridurre i bias, rimuovere le informazioni sensibili e garantire la pertinenza al caso d'uso previsto.
- Tecniche come il Reinforcement Learning from Human Feedback (RLHF) vengono utilizzate per influenzare il comportamento dei model e allineare gli output generati dall'IA alle aspettative umane e agli standard etici.
- I criteri di accettazione definiscono cosa costituisce un comportamento accettabile e inaccettabile prima dell'implementazione dell'IA.
Applicazione in fase di esecuzione:
- I prompt degli utenti vengono ispezionati per rilevare prompt injection, contenuti non sicuri o tentativi di aggirare le restrizioni.
- I controlli di accesso limitano quali origini dati, strumenti e azioni gli agenti IA possono utilizzare.
- Nei flussi di lavoro che si basano sulla Retrieval-Augmented Generation (RAG), le fonti di conoscenza esterne sono limitate a dataset attendibili per migliorare l'accuratezza e ridurre gli output fuorvianti.
Validazione post-generazione:
- I contenuti generati dall'IA vengono controllati per rilevare output dannosi, esposizione di dati sensibili e violazioni normative.
- I contenuti segnalati possono essere bloccati, corretti o inoltrati per la supervisione umana.
- I meccanismi di monitoraggio registrano decisioni ed esiti per supportare audit, valutazioni del rischio e miglioramento continuo.
Together, questi livelli garantiscono che i guardrail funzionino come un sistema adattivo che evolve al variare del comportamento dell'IA, dei modelli di utilizzo e delle minacce.
Architettura dei guardrail
L'architettura dei guardrail definisce come i controlli sono organizzati tra i sistemi IA per gestire il rischio in modo coerente e su larga scala. Piuttosto che trattare i guardrail come componenti aggiuntivi, le organizzazioni li progettano sempre più all'interno di un sistema di gestione dell'IA. Un pattern architetturale comune include:
Livello di controllo dell'input
- Valuta i prompt degli utenti e i dati in ingresso.
- Rileva contenuti non sicuri, prompt injection e input malformati.
Livello model e retrieval
- Vincola il comportamento del model durante l'inferenza.
- Ancora le risposte dell'IA a fonti di conoscenza approvate, come pipeline di retrieval-augmented generation.
- Monitora le metriche delle prestazioni e la deriva comportamentale.
Livello di validazione dell'output
- Esamina gli output generati dall'IA per rilevare contenuti dannosi, output fuorvianti o informazioni sensibili.
- Applica logiche di redazione, blocco o correzione.
Livello di coordinamento e supervisione
- Orchestra i controlli tra i livelli e applica i criteri di accettazione.
- Registra le decisioni per audit e valutazioni di conformità.
- Inoltra i casi ad alto rischio alla supervisione umana.
I tipi di guardrail IA
I guardrail IA possono essere raggruppati in base al punto in cui intervengono nei sistemi IA e ai rischi che sono progettati per gestire. In pratica, le organizzazioni utilizzano più tipi contemporaneamente, poiché nessun singolo guardrail può affrontare tutti i potenziali danni.
Guardrail a livello di dati
I guardrail a livello di dati si concentrano sugli input utilizzati per addestrare e far funzionare i sistemi IA. Poiché i dati di addestramento influenzano fortemente il comportamento dei model, le debolezze in questa fase spesso si propagano a valle.
Questi guardrail includono in genere:
- Selezione dei dati di addestramento per rimuovere informazioni sensibili e informazioni di identificazione personale.
- Applicazione di regole sulla privacy dei dati per impedire che i dati proprietari vengano riutilizzati impropriamente.
- Riduzione dei bias nei dataset che possono influenzare gli output generati dall'IA.
- Applicazione di policy su come i dati strutturati e non strutturati possono essere consultati.
I guardrail dei dati aiutano a garantire che i model IA si basino su input affidabili, selezionando i dataset e verificando la qualità e l'idoneità dei dati di addestramento.
Guardrail dei model
I guardrail dei model operano direttamente sui model IA e sui language model durante l'addestramento, il fine-tuning e l'inferenza. Il loro obiettivo è modellare e monitorare il comportamento dei model affinché gli output rimangano entro confini definiti.
I guardrail dei model più comuni includono:
- Tecniche di allineamento che influenzano il modo in cui i model rispondono ai prompt degli utenti.
- Metriche delle prestazioni che monitorano accuratezza, latenza, tossicità e affidabilità.
- Rilevamento delle allucinazioni o output fuorvianti durante l'inferenza.
- Monitoraggio della deriva comportamentale dopo l'implementazione.
I guardrail dei model sono particolarmente importanti per i large language model, dove lo stesso input può produrre output diversi a seconda del contesto. Osservando continuamente il comportamento dei model, le organizzazioni possono identificare precocemente i rischi emergenti e adattare i controlli prima che i problemi colpiscano gli utenti.
Guardrail a livello di applicazione
I guardrail applicativi governano il modo in cui le applicazioni IA interagiscono con gli utenti e i sistemi a valle. Questi controlli si collocano tra i model IA e l'uso nel mondo reale.
Spesso comportano:
- Filtraggio dei contenuti generati dall'IA prima che vengano consegnati agli utenti.
- Validazione dei prompt degli utenti per prevenire usi impropri o contenuti non sicuri.
- Applicazione di regole di business specifiche per un caso d'uso o flusso di lavoro.
- Gestione dei contenuti segnalati tramite blocco, redazione o escalation.
I guardrail applicativi sono particolarmente rilevanti negli strumenti IA rivolti ai clienti, dove output non sicuri o fuorvianti possono rapidamente compromettere la fiducia.
Guardrail dell'infrastruttura
I guardrail dell'infrastruttura forniscono le fondamenta tecniche che supportano un'implementazione sicura dell'IA. Piuttosto che concentrarsi sui contenuti, gestiscono il modo in cui i sistemi IA vengono eseguiti e chi può accedervi.
I principali guardrail dell'infrastruttura includono:
- Controlli di accesso che definiscono chi può utilizzare i servizi IA e in quali condizioni.
- Autenticazione e autorizzazione per agenti IA e API.
- Crittografia e archiviazione sicura per le informazioni sensibili.
- Meccanismi di registrazione e monitoraggio che supportano audit e indagini.
I guardrail dell'infrastruttura aiutano a prevenire accessi non autorizzati, riducono la fuga di dati e proteggono le prestazioni del sistema. Sono inoltre essenziali per soddisfare i requisiti normativi in materia di sicurezza e protezione dei dati.
Guardrail di governance
I guardrail di governance collegano i controlli tecnici alla supervisione organizzativa. Garantiscono che l'uso dell'IA sia allineato alle policy interne, alla tolleranza al rischio e ai framework di conformità esterni.
Questi guardrail comportano in genere:
- Ruoli definiti e responsabilità all'interno di un sistema di gestione dell'IA.
- Documentazione e tracce di audit per le decisioni di implementazione dell'IA.
- Valutazioni del rischio che identificano i potenziali danni prima dell'implementazione.
- Allineamento ai principi di IA responsabile e alle normative, come l'EU IA Act.
I guardrail di governance non sostituiscono i controlli tecnici, ma garantiscono coerenza e responsabilità tra team, model e applicazioni IA.
Casi d'uso dei guardrail IA
Sicurezza informatica
I guardrail IA svolgono un ruolo centrale nella protezione dei sistemi IA dai rischi di sicurezza che i controlli tradizionali non sono progettati per gestire. Poiché gli agenti IA operano spesso con privilegi elevati e interagiscono con più servizi, i guasti possono propagarsi a cascata.
Nei contesti di sicurezza informatica, i guardrail vengono utilizzati per:
- Impedire ai sistemi IA di diffondere dati sensibili tramite risposte o inferenza contestuale.
- Applicare controlli di accesso che limitano con quali servizi e origini dati gli agenti IA possono interagire.
- Rilevare comportamenti anomali, come pattern di accesso ai dati imprevisti o attività tra agente e agente.
- Integrare meccanismi di registrazione e monitoraggio nelle operazioni di sicurezza esistenti.
Quando l'IA è integrata in ambienti sensibili alla sicurezza, i guardrail aiutano a ridurre le superfici di attacco specifiche dell'IA e supportano rilevamento e risposta più rapidi. Ciò è particolarmente importante poiché i costi delle violazioni continuano ad aumentare e gli aggressori prendono sempre più di mira direttamente i sistemi IA.
Tutele per i contenuti
I rischi legati ai contenuti sono tra i fallimenti più visibili dell'IA generativa. I guardrail sono comunemente utilizzati per gestire il modo in cui i contenuti generati dall'IA vengono creati e distribuiti.
Le tutele per i contenuti spesso includono:
- Filtri per incitamento all'odio, molestie e altri output dannosi.
- Rilevamento di informazioni sensibili come email, numeri di conto o dati medici.
- Regole di validazione che identificano output fuorvianti o affermazioni non supportate.
- Gestione dei contenuti segnalati tramite blocco, redazione o revisione umana.
Flussi di lavoro
Molte organizzazioni si affidano ad AIMultiple per l'automazione intelligente nei flussi di lavoro critici. In questi ambienti, affidabilità e prevedibilità contano quanto la velocità. Questo approccio consente ai sistemi IA di supportare il processo decisionale senza minare la fiducia o il controllo.
I guardrail supportano flussi di lavoro affidabili:
- Garantendo che gli output generati dall'IA rimangano entro limiti operativi definiti.
- Impedendo agli agenti IA di intraprendere azioni in conflitto con le regole di business.
- Rilevando i falsi positivi che potrebbero disturbare le decisioni automatizzate.
- Mantenendo un comportamento coerente anche quando i prompt degli utenti variano.
Red teaming: come i laboratori leader sottopongono i model a stress test prima dell'implementazione
Con la maturazione dei guardrail IA a livello applicativo e infrastrutturale, i laboratori di frontiera dell'IA si affidano sempre più al red teaming per identificare rischi che regole statiche e classificatori non sono in grado di rilevare.
Che cos'è il red teaming dell'IA?
Il red teaming nell'IA si riferisce alla valutazione avversaria dei model e dei flussi di lavoro abilitati all'IA in più domini di rischio, tra cui sicurezza informatica, biosicurezza, disinformazione, privacy e manipolazione. Piuttosto che verificare se un model segue regole predefinite, i red team indagano se può:
- Essere manipolato tramite prompt injection o istruzioni indirette.
- Generare output dannosi o fuorvianti nonostante le tutele.
- Fornire indicazioni operative in domini sensibili.
- Aumentare il rischio se combinato con strumenti, sistemi di retrieval o flussi di lavoro agentici.
A differenza della sola moderazione automatizzata, il red teaming enfatizza la scoperta delle capacità, chiedendosi sia “Questo output è consentito?” sia “Cosa potrebbe permettere questo model se utilizzato in modo improprio?”
Come i laboratori di frontiera dell'IA usano il red teaming per migliorare la sicurezza
Gli sviluppatori di frontiera dell'IA trattano sempre più il red teaming come un'infrastruttura di sicurezza fondamentale piuttosto che come un'attività una tantum pre-lancio. Gli approcci recenti condividono diversi elementi comuni:
- Test continui e adattivi: Piuttosto che testare i model con prompt statici, i laboratori li valutano sempre più contro avversari adattivi che apprendono dai fallimenti precedenti. Ciò riflette le dinamiche di attacco del mondo reale, in cui gli attori malintenzionati adattano le tattiche per aggirare le difese.
- Competenze specifiche per dominio: Il red teaming coinvolge ora esperti esterni in settori come sicurezza informatica, biologia, persuasione e policy pubblica. Ciò aiuta a scoprire rischi invisibili alle valutazioni generiche o ai benchmark automatizzati.
- Valutazione consapevole di tool e agenti: Il red teaming moderno esamina i model sia in isolamento sia come parte di agenti IA che possono chiamare strumenti, recuperare documenti e compiere azioni. Questo è fondamentale, poiché molti rischi ad alto impatto emergono quando i model sono incorporati in flussi di lavoro con autorizzazioni elevate.
- Soglie di capacità ed escalation: Piuttosto che presumere che tutti i rischi siano uguali, alcuni laboratori definiscono soglie di capacità che attivano tutele più forti man mano che i model migliorano. Ciò consente alle misure di sicurezza di crescere con la potenza del model invece di basarsi su controlli statici.
Esempi dai laboratori di frontiera dell'IA
- Anthropic utilizza un Frontier Red Team dedicato per valutare i rischi rilevanti per la sicurezza nazionale in settori come la sicurezza informatica e la biosicurezza. Il loro lavoro si concentra sull'identificazione di segnali di “allarme precoce” di crescita pericolosa delle capacità e sulla definizione di soglie di sicurezza che richiedono controlli più forti prima dell'implementazione.2
- OpenAI ha istituito un Red Teaming Network esterno che riunisce esperti di domini diversi per valutare i model durante l'intero ciclo di vita dello sviluppo. Questo approccio enfatizza il feedback continuo, la diversità di prospettive e la scoperta dei rischi del mondo reale oltre ai test interni.3
- Google DeepMind applica il red teaming automatizzato su larga scala per sottoporre a stress test model come Gemini contro minacce in evoluzione come la prompt injection indiretta. Combinando attacchi adattivi con il rafforzamento dei model, DeepMind si concentra sulla riduzione di intere classi di vulnerabilità piuttosto che affidarsi a filtri di superficie.4
 Aggiungi come fonte preferita
Vantaggi dei guardrail IA
I guardrail IA offrono vantaggi misurabili quando vengono implementati con obiettivi chiari e monitoraggio continuo.
Protezione dei dati sensibili
I guardrail riducono la probabilità che i sistemi IA diffondano informazioni sensibili tramite output o associazioni indirette. Ciò è fondamentale per mantenere la privacy dei dati e la conformità normativa.
Migliore esperienza utente
Riducendo output fuorvianti e allucinazioni, i guardrail aiutano a garantire che le risposte dell'IA siano accurate e contestualmente pertinenti. Ciò porta a interazioni più affidabili e a una maggiore fiducia degli utenti negli strumenti IA.
Riduzione del rischio operativo e legale
I controlli proattivi possono prevenire incidenti che portano a responsabilità legali o sanzioni normative. Le organizzazioni con controlli di sicurezza specifici per l'IA sono in una posizione migliore per limitare i costi delle violazioni.
Governance scalabile
I controlli automatizzati riducono la dipendenza dalla revisione manuale pur supportando la responsabilità. I guardrail forniscono segnali misurabili che i sistemi IA operano entro confini definiti.
Sfide dei guardrail IA
L'implementazione dei guardrail IA comporta sfide che richiedono attenzione e adattamento continui.
Definire criteri di accettazione misurabili
- Tradurre obiettivi astratti come equità o sicurezza in regole applicabili è difficile.
- Criteri definiti male possono portare a un'applicazione incoerente.
Gestire i falsi positivi
- Guardrail eccessivamente rigidi possono bloccare usi legittimi o degradare le prestazioni del sistema.
- È necessaria una messa a punto continua per bilanciare sicurezza e usabilità.
Stare al passo con le minacce emergenti
- Il panorama delle minacce per i sistemi IA evolve rapidamente, incluse nuove forme di prompt injection e manipolazione dei model.
- Le organizzazioni devono rimanere informate e aggiornare proattivamente i controlli.
Complessità operativa
- I guardrail devono essere mantenuti tra model, applicazioni e infrastruttura.
- Ciò richiede coordinamento tra team tecnici, funzioni di conformità e stakeholder.
Limiti dell'automazione
- Non tutti i potenziali danni possono essere identificati automaticamente.
- La supervisione umana rimane essenziale per i casi limite e il giudizio contestuale.
FAQ
Con l'espansione dell'implementazione dell'IA nelle operazioni rivolte ai clienti e interne, le conseguenze dei guasti aumentano. I sistemi IA sono ora integrati in decisioni che riguardano finanza, sanità, sicurezza e comunicazione pubblica, dove errori o violazioni della privacy dei dati possono avere un impatto duraturo.
I guardrail IA sono importanti perché:
1. Consentono alle organizzazioni di scalare l'uso dell'IA proteggendo i dati sensibili
2. Supportano la conformità normativa con requisiti normativi in evoluzione come l'EU IA Act
3. Riducono la probabilità che contenuti non sicuri raggiungano gli utenti finali
4. Forniscono evidenza di pratiche di IA responsabile tramite registrazione e valutazioni di conformità
5. Creano una base di fiducia tra organizzazioni, utenti e autorità di regolamentazione
Senza guardrail, le tecnologie IA possono operare in modi difficili da prevedere o spiegare, aumentando il rischio IA e compromettendo le prestazioni del sistema. I guardrail fungono da livello stabilizzante che consente l'innovazione senza abbandonare il controllo.
Cita questa ricerca
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{I 5 migliori guardrail IA: Xnode Cortx e Weights and Biases}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-guardrails}},
  note   = {AIMultiple. Consultato il 23 settembre 2026}
}Risultati e timestamp di 15 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 2 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
3 aggiornamentiRimossa la voce nexos.ai Guardrails, lasciando quattro guardrail di IA nell'elenco.
La sezione nexos.ai Guardrails è stata spostata da prima a dopo Llama Guard.
Aggiunto nexos.ai Guardrails alla sezione Top 4 AI guardrails.
Collegamenti di riferimento
Il lavoro di Cem presso AIMultiple è stato citato da importanti testate internazionali tra cui Business Insider, Forbes, Morning Brew e Washington Post, da aziende globali come Deloitte e HPE, da ONG come il World Economic Forum e da organizzazioni sovranazionali come la Commissione europea. [1], [2], [3], [4], [5]
Nel corso della sua carriera, Cem ha lavorato come consulente tecnologico, acquirente tecnologico e imprenditore tecnologico. Ha consigliato le aziende sulle loro decisioni tecnologiche presso McKinsey & Company e Altman Solon per più di un decennio. Ha inoltre pubblicato un report McKinsey sulla digitalizzazione.
Ha guidato la strategia tecnologica e gli approvvigionamenti di una società di telecomunicazioni rispondendo direttamente al CEO. Ha inoltre guidato la crescita commerciale dell'azienda deep tech Hypatos, che ha raggiunto ricavi ricorrenti annuali a 7 cifre e una valutazione a 9 cifre partendo da zero in 2 anni. Il lavoro di Cem in Hypatos è stato ripreso da importanti testate tecnologiche come TechCrunch e Business Insider.
Cem interviene regolarmente a conferenze tecnologiche internazionali. Si è laureato come ingegnere informatico presso l'Università di Bogazici e possiede un MBA della Columbia Business School.

In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.
Prossimo da leggere
Migliori fornitori di LLM API a tariffa fissa

eBay Scraping: confronto tra i 6 migliori provider

Benchmark MFT: Files.com, Diplomat MFT, Cerberus e Serv-U testati







Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.