


Strumenti di rilevamento delle allucinazioni IA: W&B Weave e Comet

Abbiamo confrontato tre strumenti di rilevamento delle allucinazioni: W&B Weave HallucinationFree Scorer (parte di CoreWeave Forge, precedentemente Weights & Biases), Arize Phoenix HallucinationEvaluator e Comet Opik Hallucination Metric, su 100 casi di test.
Ogni strumento è stato valutato in termini di accuratezza, precisione, recall e latenza.
Benchmark degli strumenti di rilevamento delle allucinazioni IA
Abbiamo testato 100 risposte (50 corrette, 50 allucinate) provenienti da scenari fattuali di domande e risposte, confrontandole con il contesto di origine.
Confronto di accuratezza e latenza
Consulta la metodologia del benchmark. sezione per maggiori dettagli sul processo di test.
W&B Weave e Arize Phoenix hanno fornito un'accuratezza quasi identica, rispettivamente del 91% e del 90%. Entrambi gli strumenti hanno dimostrato prestazioni affidabili sull'intero dataset. Comet Opik è rimasto indietro con un'accuratezza del 72%, classificando correttamente solo 72 test su 100, un divario significativo dovuto al suo approccio conservativo.
In termini di velocità, Arize Phoenix è risultato il vincitore con 2 secondi per test, risultando adatto alle applicazioni in tempo reale. W&B Weave ha elaborato i test in 4 secondi, un valore ragionevole per la maggior parte dei casi d'uso in produzione. Comet Opik è stato notevolmente più lento, con 8,5 secondi per test, il che potrebbe influire sull'esperienza utente nelle applicazioni sensibili alla latenza.
Punteggio F1, precisione e recall
I punteggi F1 (media armonica di precisione e recall) hanno confermato questi andamenti: W&B Weave con 90,5% e Phoenix con 89,4% hanno ottenuto entrambi prestazioni solide ed equilibrate. Al confronto, il 61,1% di Opik riflette il compromesso tra precisione perfetta e recall debole. Gli zero falsi positivi di Opik sono stati ottenuti al costo di 28 falsi negativi, rendendolo adatto solo a scenari in cui i falsi allarmi sono più costosi delle mancate rilevazioni.
La recall (capacità di individuare le allucinazioni effettive) ha rivelato strategie distinte. W&B Weave è risultato in testa con una recall dell'86%, individuando 43 allucinazioni su 50 e mancandone solo 7. Phoenix ha seguito da vicino con l'84%, rilevando 42 allucinazioni e mancandone 8. La recall di Comet Opik è stata sostanzialmente inferiore, pari al 44%, individuando solo 22 allucinazioni e mancandone 28; più della metà di tutte le allucinazioni effettive non è stata rilevata.
La precisione (affidabilità degli avvisi) ha mostrato variazioni significative. Comet Opik ha raggiunto una precisione perfetta del 100% con zero falsi positivi: quando segnalava qualcosa come allucinazione, aveva sempre ragione. Sia Phoenix (95,5%) sia Weave (95,6%) hanno mostrato una precisione quasi identica, producendo ciascuno solo 2 falsi positivi su 50 risposte legittime, dimostrando una forte affidabilità senza essere eccessivamente conservativi.
Fattori che potrebbero influenzare le differenze di prestazione
Le differenze di prestazione osservate sono probabilmente dovute alla filosofia di progettazione, alla scelta delle soglie e all'interpretazione del grounding.
Differenze nelle strategie di rilevamento e negli obiettivi di ottimizzazione
- Gli strumenti sembrano essere ottimizzati per compromessi di errore diversi anziché per lo stesso obiettivo.
- W&B Weave e Arize Phoenix puntano a prestazioni equilibrate, mantenendo un'elevata precisione e catturando comunque la maggior parte delle allucinazioni.
- Comet Opik adotta una strategia altamente conservativa, dando priorità a zero falsi positivi anche se molte allucinazioni vengono mancate.
- Questa scelta strategica spiega direttamente la precisione perfetta di Opik e la sua recall sostanzialmente inferiore.
Compromessi precisione–recall incorporati nella progettazione degli strumenti
- Gli zero falsi positivi di Comet Opik indicano una soglia decisionale rigorosa, che segnala le allucinazioni solo quando la confidenza è molto alta.
- W&B Weave e Phoenix utilizzano soglie meno restrittive, consentendo alcuni falsi positivi in cambio di una recall molto più elevata.
- Queste differenze di soglia possono portare a:
- Precisione simile tra Weave e Phoenix
- Ampi divari di recall tra Opik e gli altri due strumenti
- Differenze corrispondenti nel punteggio F1 e nell'accuratezza complessiva
Variazioni nell'implementazione di LLM-as-a-judge
- Sebbene tutti e tre gli strumenti utilizzino un approccio LLM-as-a-judge, le loro implementazioni differiscono.
- W&B Weave enfatizza il ragionamento chain-of-thought, che può migliorare la sensibilità alle affermazioni sottili non supportate.
- Arize Phoenix incorpora output basati su etichette con punteggi di confidenza, supportando giudizi più sfumati.
- Comet Opik si concentra su decisioni binarie ad alta confidenza, il che riduce i falsi allarmi ma limita la sensibilità alle allucinazioni borderline.
Differenze di latenza dovute alla profondità della valutazione
- La minore latenza di Arize Phoenix suggerisce una pipeline di valutazione più leggera o più snella, adatta all'uso in tempo reale.
- La latenza moderata di W&B Weave è coerente con un ragionamento più ricco e la registrazione delle tracce.
- La maggiore latenza di Comet Opik riflette probabilmente un ragionamento interno o fasi di verifica più estesi, rafforzando la sua progettazione conservativa.
Strumenti di rilevamento delle allucinazioni IA
Lo HallucinationFree Scorer di W&B Weave
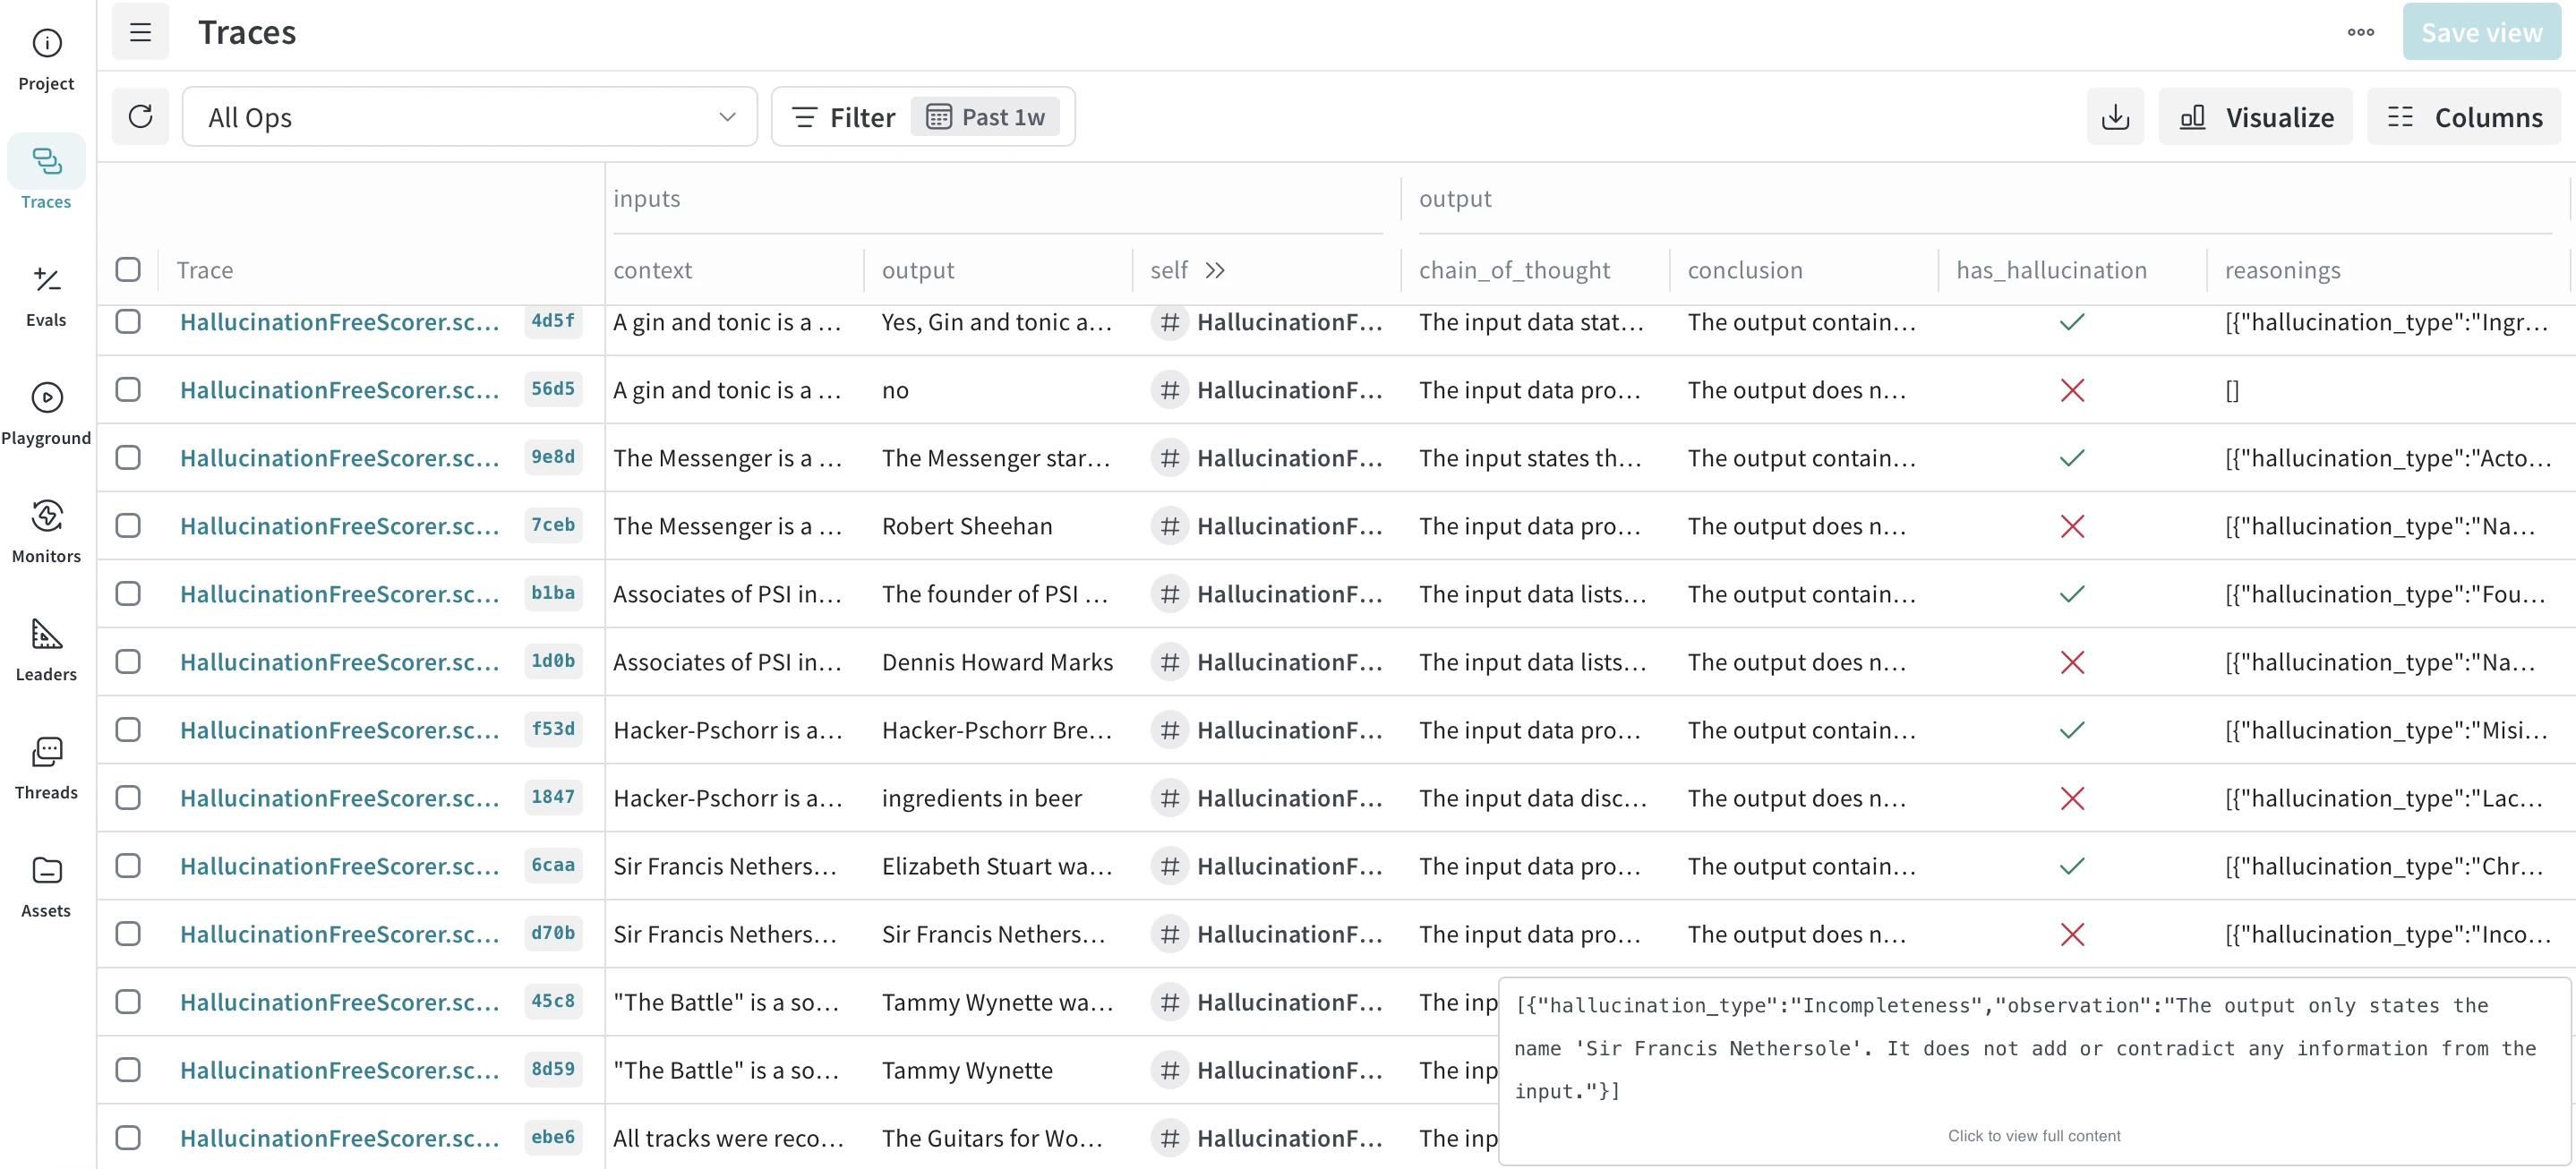
Figura 1: La dashboard delle tracce di W&B Weave.
CoreWeave Forge include un HallucinationFree Scorer che contrassegna gli output LLM che introducono affermazioni non presenti nel contesto di origine. Esegue un giudice LLM su ogni risposta e restituisce un verdetto grounded/ungrounded insieme al ragionamento che lo motiva.
Lo scorer accetta due input: il contesto (materiale di origine) e l'output (risposta generata da LLM). Utilizza poi un modello linguistico per analizzare se l'output introduce informazioni non presenti nel contesto. Il risultato include un flag booleano has_hallucination e il ragionamento che spiega la decisione.
Caratteristiche principali:
- Ragionamento chain-of-thought: ogni valutazione include una spiegazione del motivo per cui l'output è stato contrassegnato come allucinazione o meno.
- Classificazione binaria: restituisce decisioni chiare vero/falso con prove a supporto.
- Integrazione con il tracciamento di Weave: i risultati vengono registrati automaticamente nella dashboard di Weave per la visualizzazione.
- Modello personalizzabile: supporta diversi giudici LLM, tra cui OpenAI, Anthropic e altri provider.
HallucinationEvaluator di Arize Phoenix
Arize Phoenix include un HallucinationEvaluator che segnala le risposte che si discostano dal materiale di riferimento. Per ogni output, un giudice LLM decide se la risposta è fondata sul contesto fornito e assegna un punteggio di confidenza al proprio verdetto.
L'evaluator accetta tre input: la query dell'utente (input), il testo di riferimento (contesto) e la risposta del modello (output). Analizza se la risposta contiene informazioni che non possono essere derivate dal contesto, restituendo un risultato etichettato (“factual” o “hallucinated”) insieme a una spiegazione e a un punteggio di confidenza.
Caratteristiche principali:
- Prestazioni equilibrate: fornisce risultati su entrambe le metriche di precisione e recall
- Output basato su etichette: restituisce etichette categoriali (“factual” o “hallucinated”) anziché solo punteggi numerici
- Spiegazioni dettagliate: fornisce il ragionamento per ogni decisione di valutazione
Hallucination Metric di Comet Opik
La Hallucination Metric di Comet Opik valuta ogni risposta LLM rispetto al contesto di origine e restituisce un giudizio binario sull'aderenza dell'output a tale contesto. Il controllo viene eseguito tramite un giudice LLM calibrato per segnalare solo i casi ad alta confidenza di affermazioni non supportate.
La metrica accetta tre input: la query dell'utente (input), il materiale di origine (contesto) e la risposta del modello (output). Valuta se l'output introduce affermazioni non supportate dal contesto.
Il risultato include un punteggio binario (0 per nessuna allucinazione, 1 per allucinazione rilevata) e un ragionamento dettagliato che spiega la valutazione.
Caratteristiche principali:
- Spiegazioni dettagliate: ogni valutazione fornisce un ragionamento completo sul motivo per cui il contenuto è stato segnalato o approvato
- Analisi a tre input: considera insieme query, contesto e risposta per la valutazione
- Tracciamento degli esperimenti: i risultati vengono registrati automaticamente nel sistema di tracciamento degli esperimenti di Opik
- Approccio conservativo: progettato per ridurre al minimo i falsi positivi segnalando solo le allucinazioni ad alta confidenza
Galileo Luna-2
Galileo Luna-2 è un livello di rilevamento delle allucinazioni e di guardrail runtime integrato nella più ampia piattaforma di osservabilità IA di Galileo. 1
Il sistema è progettato per essere eseguito inline sui percorsi di inferenza in produzione, bloccando i contenuti non fondati prima che raggiungano l'utente, mentre Signals, il livello di analisi automatica dei guasti di Galileo, fa emergere le cause principali degli errori di produzione senza revisione manuale dei log.
Caratteristiche principali:
Rilevamento multi-metodo: combina la similarità degli embedding, l'analisi Chain-of-Thought e il punteggio di fattualità G-Eval anziché dipendere da un'unica strategia di giudizio.
Guardrail runtime: Luna-2 può bloccare o riscrivere gli output non fondati inline sul percorso di inferenza, non solo segnalarli a posteriori.
Osservabilità end-to-end: cattura input, output e tracce di ragionamento interne nei flussi di lavoro multi-step degli agenti, con Signals che automatizza l'analisi delle cause principali.
DeepEval
DeepEval è un framework di valutazione LLM open source di Confident IA, progettato per assomigliare a Pytest ma per le applicazioni LLM. Il suo HallucinationMetric utilizza un approccio LLM-as-a-judge per decidere se l'output del modello è fattualmente coerente con il contesto fornito, e il framework è progettato per essere eseguito all'interno di qualsiasi pipeline CI/CD.23
La metrica accetta tre input obbligatori: la query dell'utente (input), la risposta del modello (actual_output) e il materiale di riferimento (context). Valuta ogni output utilizzando la formula Allucinazione = (Numero di contesti contraddetti) / (Numero totale di contesti), dove punteggi più bassi indicano un migliore grounding. Un output supera il controllo quando il suo punteggio è pari o inferiore alla soglia configurata.
Caratteristiche principali:
- Flusso di lavoro di test familiare: i controlli sulle allucinazioni vengono scritti ed eseguiti come normali test unitari, quindi i team che già usano Pytest non devono imparare un nuovo strumento.
- Rigore regolabile: i team possono allentare o restringere la soglia di superamento, oppure passare a una modalità rigorosa superato/non superato per i contenuti ad alto rischio.
- Spiegazioni per ogni risultato: ogni verdetto include una motivazione, così è chiaro perché un output è stato segnalato.
Che cos'è un'allucinazione dell'IA?
Le allucinazioni dell'IA sono output che appaiono coerenti ma non sono fattuali. Il modello produce queste affermazioni con sicurezza anche quando il contesto di origine o i dati di addestramento non le supportano. Un'indagine sull'argomento attribuisce ciò al fatto che i modelli si affidano a priori linguistici invece che a prove verificabili ricavate dal contesto fornito.4 Il problema si manifesta in ambiti ad alto rischio come sanità, servizi legali, ricerca aziendale e assistenza clienti, motivo per cui il rilevamento degli output fondati è diventato una parte standard dell'implementazione diLLM.
Fonti e tassonomia delle allucinazioni
Le allucinazioni derivano da due grandi fonti. I fattori interni al modello includono l'eccessiva dipendenza da modelli statistici, lacune nei dati di addestramento e la natura probabilistica della generazione di sequenze; un'analisi sul rilevamento e la mitigazione delle allucinazioni osserva che le LLM spesso inferiscono probabili continuazioni invece di recuperare prove verificabili, il che produce output sicuri ma errati.5
I fattori contestuali comprendono errori di recupero nei RAG sistemi, prompt ambigui, grounding incompleto e, nei modelli multimodali, confusioni di oggetti o dettagli di scena inventati.
Rilevamento delle allucinazioni nei flussi di lavoro agentici
Gli agenti multi-step introducono rischi di allucinazione che i LLM a turno singolo non presentano: un'affermazione inventata in una fase iniziale si propaga alle chiamate successive agli strumenti, ai recuperi e agli output finali.
Sfide chiave nel rilevamento delle allucinazioni agentiche:
- Propagazione degli errori: un fatto inventato nella fase di pianificazione può influenzare la selezione degli strumenti, il recupero dei dati e le risposte finali
- Allucinazioni nelle chiamate agli strumenti: gli agenti possono invocare strumenti con parametri errati o interpretare male gli output degli strumenti
- Corruzione dello stato: le informazioni allucinate archiviate nella memoria dell'agente influenzano i passaggi di ragionamento futuri
- Complessità di attribuzione: identificare quale passaggio ha introdotto l'allucinazione richiede un tracciamento end-to-end
Approcci di rilevamento per i sistemi agentici:
- Verifica a livello di passaggio: convalidare ogni output intermedio prima che l'agente proceda all'azione successiva
- Validazione degli output degli strumenti: verificare in modo incrociato le risposte degli strumenti rispetto ai formati attesi e ai vincoli noti
- Analisi della traiettoria: esaminare l'intera sequenza di decisioni dell'agente per individuare dove il ragionamento si è allontanato dalle informazioni fondate
- Controlli di coerenza tra i passaggi: confrontare le affermazioni fatte in fasi diverse per rilevare contraddizioni
Lo HallucinationFree Scorer di W&B Weave e l'HallucinationEvaluator di Arize Phoenix possono essere applicati a ogni passaggio dell'agente, mentre le loro dashboard integrate mostrano l'intera traccia di esecuzione per l'analisi delle cause principali.
 Aggiungi come fonte preferita
Prevenzione delle allucinazioni in tempo reale
Il rilevamento post-generazione fa emergere i problemi ma non impedisce agli output errati di raggiungere gli utenti. La prevenzione in tempo reale esegue il controllo inline, prima che la risposta venga consegnata.
Meccanismi di prevenzione:
- Guardrail sugli output: filtri che analizzano il contenuto generato rispetto ai criteri di fattualità prima di restituirlo all'utente.
- Soglie di confidenza: bloccare o segnalare le risposte quando la confidenza interna del modello scende al di sotto di livelli accettabili.
- Gates di validazione del recupero: verificare che le affermazioni generate siano supportate dai documenti recuperati prima di finalizzare la risposta.
- Strategie di fallback: restituire una risposta predefinita sicura o passare alle code di revisione quando il rischio di allucinazione è elevato.
Capacità degli strumenti per la prevenzione in tempo reale:
- W&B Weave integra il punteggio di allucinazione nelle pipeline di produzione, consentendo controlli automatici prima che le risposte vengano servite.
- Arize Phoenix fornisce monitoraggio in tempo reale con capacità di avviso che segnalano gli output ad alto rischio per una revisione immediata.
- Comet Opik offre il tracciamento degli esperimenti con valutazione automatica, consentendo ai team di impostare quality gate che bloccano le risposte che superano le soglie di allucinazione.
Approcci al rilevamento delle allucinazioni
Tre approcci sono direttamente rilevanti per il funzionamento di Weave, Phoenix e Opik:
1. Metodi basati sulla coerenza
I metodi basati sulla coerenza valutano una risposta confrontandola con diverse generazioni alternative utilizzando la similarità semantica, la sovrapposizione di n-grammi o la verifica domanda-risposta. Quando le risposte si contraddicono a vicenda o contengono incongruenze logiche, la probabilità di allucinazione aumenta. Una tecnica correlata, l'entropia semantica, raggruppa le risposte per significato piuttosto che per formulazione e utilizza l'instabilità concettuale come segnale di allucinazione.
2. Rilevamento basato su probabilità e confidenza
Le probabilità a livello di token, i valori di entropia, le curve di calibrazione e le stime di confidenza basate sul margine rivelano la convinzione interna del modello sul proprio output. I segmenti a bassa confidenza sono spesso correlati a tassi di allucinazione più elevati. L'entropia grezza può essere fuorviante a causa della variabilità delle formulazioni, ma i segnali di confidenza restano utili se combinati con indicatori basati sulla coerenza. Arize Phoenix espone un punteggio di confidenza accanto alla propria etichetta, il che rientra in questa categoria.
3. Rilevamento basato su riferimenti o contesto
La valutazione basata sui riferimenti confronta l'output del modello con il contesto fornito o con fonti esterne, ed è il meccanismo alla base dei RAG controlli di qualità. Le tecniche tipiche includono modelli di implicazione che verificano se i documenti recuperati supportano la risposta, metodi di allineamento e grounding che convalidano il supporto delle prove e metriche di fattualità che misurano se le affermazioni corrispondono al testo di supporto. Tutti e tre gli strumenti sottoposti a benchmark operano principalmente in questa modalità: prendono un input di contesto e giudicano se l'output rimane al suo interno.
Tecniche e algoritmi per il rilevamento delle allucinazioni dell'IA
I metodi di rilevamento operano a tre livelli di granularità:
- Livello token: contrassegna le parti sospette all'interno di un output. Utilizza dataset di allucinazioni annotati da umani, la divergenza tra probabilità a priori e a posteriori dei token dato il contesto, o classificatori di etichettatura di sequenze.
- Livello frase: giudica intere affermazioni. I controlli di auto-coerenza basati sul campionamento confrontano più generazioni per rilevare instabilità, l'entropia semantica segnala l'incertezza concettuale senza etichette e i classificatori di implicazione individuano affermazioni non supportate o contraddittorie.
- Livello flusso di lavoro: traccia le pipeline multi-step utilizzando grafi di provenienza, controlli di implicazione a livello di passaggio, convalida del ragionamento intermedio e tracciamento delle dipendenze per compiti multi-hop.
I tre strumenti che abbiamo sottoposto a benchmark operano principalmente a livello di frase, con Weave e Phoenix che si estendono all'uso a livello di flusso di lavoro tramite le loro dashboard di tracciamento.
Modelli industriali e best practice
I team di produzione raramente si affidano a un unico metodo. I modelli comuni includono:
- Rilevamento a più livelli: controlli di coerenza, punteggio di probabilità e convalida dell'implicazione vengono eseguiti nella stessa pipeline.
- Monitoraggio in tempo reale: le dashboard tracciano il drift e i cambiamenti di confidenza nel tempo.
- Prompt tuning: i prompt vengono perfezionati per ridurre l'ambiguità che porta a output non fondati.
- Revisione esperta: riservata ai contenuti legali, medici o finanziari in cui gli errori hanno un costo reale.
- Integrazione CI/CD: i controlli di qualità automatici vengono eseguiti prima del deployment, così le regressioni emergono presto.
- Monitoraggio degli agenti: i plugin osservano le chiamate agli strumenti e i passaggi di ragionamento intermedi per individuare le anomalie non appena compaiono.
Metodologia del benchmark degli strumenti di rilevamento delle allucinazioni IA
Il benchmark ha utilizzato un dataset controllato di 50 elementi di conoscenza tratti da scenari fattuali di domanda e risposta. Ogni elemento includeva un contesto di origine, una domanda, una risposta corretta fondata su tale contesto e una risposta allucinata contenente informazioni inventate. Ad esempio, un test chiedeva la sede centrale del The Oberoi Group, dove la risposta corretta “Delhi” è stata confrontata con la risposta allucinata “Mumbai”.
Ogni elemento di conoscenza ha generato due casi di test: uno con la risposta corretta (atteso: nessuna allucinazione) e uno con la risposta allucinata (atteso: allucinazione rilevata). Ciò ha creato una suddivisione bilanciata 50/50 per un totale di 100 casi di test. Tutti e tre gli strumenti hanno elaborato gli stessi casi di test in sequenza, ricevendo ciascuno input identici (contesto, domanda e output).
Abbiamo misurato la latenza per ogni singolo caso di test per garantire un confronto equo, evitando le insidie dell'elaborazione parallela o della valutazione in batch che potrebbero distorcere i risultati. Le etichette di ground truth sono state verificate manualmente per garantire l'accuratezza nel calcolo di veri positivi, falsi positivi, veri negativi e falsi negativi.
Cita questo benchmark
Scegli il formato adatto a dove pubblicherai. Incollare la versione con link nel tuo CMS preserva il backlink.
@misc{ermut2026,
  author = {Ermut, Sıla and Şipi, Nazlı},
  title  = {{Strumenti di rilevamento delle allucinazioni IA: W&B Weave e Comet}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-hallucination-detection}},
  note   = {AIMultiple. Consultato il 18 giugno 2026}
}Risultati e timestamp di 0 punti dati. Scarica i dati di sintesi mostrati nei grafici e nelle tabelle di questo articolo come file ZIP contenente 0 file CSV.
Vuoi i dati granulari che ci stanno dietro? Passa a Premium
Registro delle modifiche
3 aggiornamentiAggiunti Galileo Luna-2 e DeepEval come nuove sezioni di strumenti accanto agli strumenti di rilevamento delle allucinazioni testati.
Aggiunta la sezione "Hallucination detection in agentic workflows" alla sezione "What is AI hallucination?".
Collegamenti di riferimento
In precedenza ha lavorato come reclutatrice in società di project management e consulenza. Sıla ha conseguito un Master of Science in Psicologia Sociale e un Bachelor of Arts in Relazioni Internazionali.






Sii il primo a commentare
Il tuo indirizzo email non verrà pubblicato. Tutti i campi sono obbligatori. I commenti vengono lasciati nella loro lingua originale.