


Qualidade dos Dados de IA: Desafios & Melhores Práticas

A má qualidade dos dados atrasa a implantação bem-sucedida de projetos de IA e ML. 1 Mesmo os algoritmos de IA mais avançados podem gerar resultados falhos se os dados subjacentes forem de baixa qualidade.
Explore a importância da qualidade dos dados na IA, os desafios que as organizações enfrentam e as melhores práticas para garantir dados de alta qualidade:
Qual é a importância da qualidade dos dados na IA?
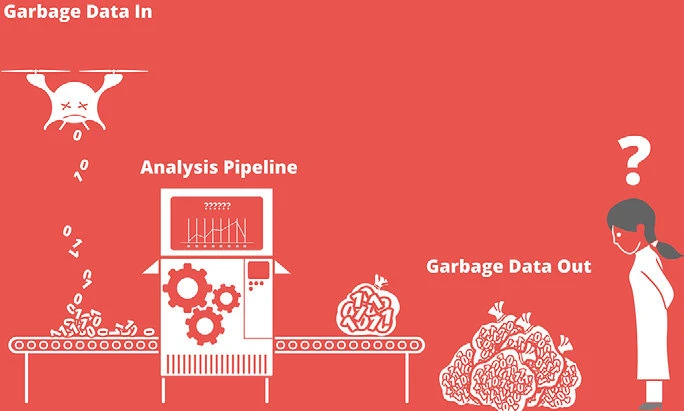
A qualidade dos dados é essencial para a inteligência artificial, pois influencia diretamente o desempenho, a precisão e a confiabilidade dos models de IA. Dados de alta qualidade permitem que os models façam previsões melhores e gerem resultados mais confiáveis. O impacto da má qualidade dos dados na IA é ilustrado na Figura 1.
Figura 1: Impacto da má qualidade dos dados e das análises
Fonte: SnapLogic2
Abordar os vieses dos dados é crucial para garantir a qualidade dos dados. Isso evita a perpetuação e a amplificação de vieses nos resultados gerados por IA, ajudando a minimizar o tratamento injusto de grupos ou indivíduos específicos.
Além disso, um dataset diverso e representativo aprimora a capacidade de um model de IA de generalizar bem em diferentes situações e entradas, garantindo seu desempenho e relevância em vários contextos e grupos de usuários.
Como Andrew Ng, professor de IA da Stanford University e fundador da DeepLearning.IA, afirma: “Se 80 por cento do nosso trabalho é preparação de dados, garantir a qualidade dos dados é a tarefa mais crítica para uma equipe de machine learning.”
Por que evitar o problema ‘entra lixo, sai lixo’ é crucial para a qualidade dos dados?
“Entra lixo, sai lixo” (GIGO) é um princípio simples, mas eficaz, que ressalta a importância da qualidade dos dados de entrada. Isso significa que, se os dados de entrada de um sistema, como um model ou algoritmo de IA, forem de baixa qualidade, imprecisos ou irrelevantes, a saída do sistema também será de baixa qualidade, imprecisa ou irrelevante.
Figura 2: Qualidade e padrões de dados: dados “entra lixo”, resultados “sai lixo”.
Fonte: Shakoor et al. 3
Esse conceito é particularmente significativo no contexto da IA, pois os models de IA, incluindo os models de machine learning e deep learning, dependem fortemente dos dados usados para treinamento e validação. É provável que o model de IA produza resultados não confiáveis ou enviesados se os dados de treinamento forem enviesados, incompletos ou contiverem erros.
Para evitar o problema GIGO, é crucial garantir que os dados usados nos sistemas de IA sejam precisos, representativos e de alta qualidade. Isso geralmente envolve limpeza de dados, pré-processamento e aumento de dados, juntamente com o uso de métricas de avaliação robustas para avaliar o desempenho do model de IA.
Quais são os principais componentes de dados de qualidade na IA?
Precisão: Dados precisos são cruciais para os algoritmos de IA, permitindo que eles produzam resultados corretos e confiáveis. Erros na entrada de dados podem levar a decisões incorretas ou insights equivocados, potencialmente prejudicando organizações e indivíduos.
Consistência: Garante que os dados sigam um formato e uma estrutura padrão, facilitando o processamento e a análise eficientes. Dados inconsistentes podem levar a confusão e má interpretação, prejudicando o desempenho dos sistemas de IA.
Completude: Datasets incompletos podem fazer com que os algoritmos de IA deixem de identificar padrões e correlações essenciais, levando a resultados incompletos ou enviesados. Garantir a completude dos dados é vital para treinar models de IA com precisão e de forma abrangente.
Tempestividade: O frescor dos dados desempenha um papel significativo no desempenho da IA. Dados desatualizados podem não refletir o ambiente ou as tendências atuais, levando a resultados irrelevantes ou enganosos.
Relevância: Dados relevantes contribuem diretamente para o problema em questão, ajudando os sistemas de IA a se concentrarem nas variáveis e nos relacionamentos mais importantes. Dados irrelevantes podem sobrecarregar os models e levar a ineficiências.
Quais são os desafios de garantir a qualidade dos dados na IA?
1-Coleta de dados
À medida que os avanços em IA beneficiam setores como finanças, saúde, manufatura e entretenimento, as organizações enfrentam o desafio de coletar dados de várias fontes, mantendo a qualidade. Muitas recorrem a web scrapers para automatizar e garantir que todos os pontos de dados sigam os mesmos padrões.
2-Rotulagem de dados
Os algoritmos de IA dependem de dados rotulados para treinamento, mas a rotulagem manual é demorada e propensa a erros. Obter rótulos precisos que reflitam as condições do mundo real costuma ser desafiador.
3-Armazenamento e segurança de dados
Garantir a qualidade dos dados envolve protegê-los contra acesso não autorizado e possível corrupção. É essencial que as organizações tenham armazenamento de dados seguro e confiável, mas isso pode ser difícil.
4-Governança de dados
As organizações frequentemente têm dificuldade em implementar frameworks de governança de dados que abordem efetivamente os problemas de qualidade dos dados. A falta de uma governança de dados adequada pode levar a dados isolados, inconsistência e erros.
5-Envenenamento de dados
O envenenamento de dados é um ataque direcionado a sistemas de IA no qual os atacantes introduzem informações maliciosas ou enganosas no dataset. Esses dados envenenados podem distorcer o treinamento do model, levando a resultados não confiáveis ou até mesmo prejudiciais. Para mitigar esse risco, é crucial manter a integridade dos dados por meio de auditorias regulares e detecção de anomalias.
6-Loops de feedback de dados sintéticos
Alimentar models de IA com dados gerados por IA pode criar loops de feedback que degradam a qualidade do model. Por exemplo, quando dados sintéticos são usados repetidamente, o model pode aprender padrões artificiais demais e divergir das condições do mundo real. Isso pode fazer com que os models tenham um desempenho ruim em dados reais, potencialmente amplificando vieses ou erros. Equilibrar dados sintéticos e reais é essencial para manter a robustez do model.
Estudos de caso do mundo real
Estudo de Caso 1: Mayo Clinic – Administração de dados antes da IA
A Mayo Clinic, com cerca de 76.000 funcionários em três campi, trata a prontidão dos dados como o primeiro passo de qualquer projeto de IA.4
O Desafio: A responsabilidade pelos dados está distribuída por muitas unidades clínicas e de negócios. O diretor de dados e análises, Ajai Sehgal, diz que, quando ninguém é responsável pela administração dos dados, surgem problemas de dados, e a IA na área da saúde não pode se dar ao luxo de ter resultados de baixa qualidade.
A Solução: A Mayo tornou as equipes clínicas e de negócios que melhor conhecem os dados suas administradoras, responsáveis por deixar seus dados prontos para análise. Uma equipe central mantém uma biblioteca de dados que vincula cada elemento de dados aos seus metadados e às regras clínicas relacionadas. A prática cirúrgica da Mayo, por exemplo, está iniciando seu trabalho de IA deixando seus dados prontos e propôs uma equipe autofinanciada de dados e análises.
Estudo de Caso 2: JPMorgan Chase – Detecção de fraudes em dados internos verificados
O JPMorgan Chase usa large language models para detectar fraudes, como o comprometimento de e-mails corporativos.5
O Desafio: Ryan Schmiedl, que dirige a detecção de fraudes, a triagem de sanções e as verificações de conheça seu cliente do banco, alertou em 2023 que models treinados com dados de toda a internet, como o ChatGPT, podem apresentar alegações não verificadas como fatos.
A Solução: O banco treina seus LLMs apenas com dados de seu próprio ecossistema e primeiro garante que esses dados tenham sido auditados e validados. Ele também usa IA para extract nomes de empresas e pessoas de dados não estruturados e rastreá-los quanto ao risco de fraude.
Estudo de Caso 3: Walmart – Limpeza de dados de catálogo de produtos com LLMs
O Walmart usou IA generativa para melhorar os dados de catálogo de produtos por trás de sua busca e das páginas de produtos.6
O Desafio: Manter os dados de catálogo completos e precisos na escala do Walmart é trabalhoso. O CEO Doug McMillon disse que, sem IA generativa, o trabalho teria exigido “quase 100 vezes o número atual de funcionários”.
A Solução: O Walmart usou vários large language models para criar ou melhorar mais de 850 milhões de itens de dados de catálogo, disse McMillon na teleconferência de resultados da empresa em 15 de agosto de 2024. O CEO do Walmart U.S., John Furner, disse que os dados melhorados ajudam a empresa a combinar o catálogo com o que os clientes estão buscando.
Melhores práticas para garantir a qualidade dos dados na IA
1-Implementar políticas de governança de dados
Um framework de governança de dados deve definir padrões, processos e papéis de qualidade de dados. Isso ajudará a criar uma cultura de qualidade de dados e a garantir que as práticas de gerenciamento de dados estejam alinhadas com os objetivos organizacionais.
Exemplo da vida real: Airbnb
O Airbnb lançou a “Data University” para melhorar a alfabetização em dados em toda a sua força de trabalho, oferecendo cursos personalizados que integram os dados e as ferramentas específicos do Airbnb. Desde sua criação no terceiro trimestre de 2016, a Data University aumentou o engajamento com as ferramentas internas de ciência de dados do Airbnb, elevando os usuários ativos semanais de 30% para 45%.
Com mais de 500 funcionários participando, a iniciativa destaca a importância de alinhar os esforços de governança de dados aos objetivos organizacionais, promovendo uma cultura de qualidade de dados e de tomada de decisão informada em toda a empresa. O programa exemplifica como frameworks de governança de dados personalizados podem impulsionar a competência em dados e promover o alinhamento com as metas de negócios.
2-Utilizar ferramentas de qualidade de dados
As ferramentas de qualidade de dados podem automatizar os processos de limpeza, validação e monitoramento de dados, garantindo que os models de IA tenham acesso consistente a dados de alta qualidade.
Exemplo da vida real: General Electric
Um exemplo real relevante de utilização de ferramentas de qualidade de dados é a implementação, pela General Electric (GE), da sua estratégia de governança e gerenciamento da qualidade de dados, especialmente dentro da sua plataforma Predix para análise de dados industriais. Para apoiar sua transformação digital e suas iniciativas de IA, a GE investiu em um conjunto robusto de ferramentas de qualidade de dados para manter altos padrões de dados em todo o seu ecossistema de IoT industrial.
A GE implementou ferramentas automatizadas para limpeza, validação e monitoramento contínuo de dados, a fim de gerenciar os enormes volumes de dados gerados por seus equipamentos industriais, como turbinas e motores a jato. Essas ferramentas ajudaram a GE a garantir que os dados que alimentam seus models de IA fossem precisos, consistentes e confiáveis, reduzindo a necessidade de intervenção manual e permitindo insights em tempo real orientados por dados.
Exemplos de soluções de qualidade de dados
Pandada IA, lançada no início de 2026, é uma plataforma orientada por IA para limpeza e análise automatizadas de dados. Ela pode ingerir arquivos de dados (CSVs, planilhas do Excel, PDFs e até imagens) e gerar relatórios e apresentações analíticas estruturadas e compartilháveis.7 A plataforma inclui recursos inteligentes de limpeza de dados (remoção de duplicatas, padronização de formatos, detecção de valores ausentes) que corrigem automaticamente problemas de dados, reduzindo o trabalho manual de preparação de dados.8
Sieve é uma plataforma de limpeza de dados de uma startup do Y Combinator Spring 2025 que combina processamento orientado por IA com revisão humana opcional.9 Ela fornece uma API e um suplemento do Excel para limpeza automatizada de dados, encaminhando automaticamente quaisquer problemas sinalizados a operadores humanos para validação.9
3-Desenvolver uma equipe de qualidade de dados
Desenvolver uma equipe dedicada responsável pela qualidade dos dados garantirá o monitoramento e a melhoria contínuos dos processos relacionados aos dados. A equipe também pode educar e treinar outros funcionários sobre a importância da qualidade dos dados.
4-Colaborar com provedores de dados
Estabelecer relacionamentos sólidos com provedores de dados e garantir o compromisso deles com a qualidade dos dados pode minimizar o risco de receber dados de baixa qualidade.
5-Monitorar continuamente as métricas de qualidade de dados
Medir e monitorar regularmente as métricas de qualidade de dados pode ajudar as organizações a identificar e resolver possíveis problemas antes que eles afetem o desempenho da IA.
 Adicionar como fonte preferencial
O que são dados de IA?
Dados de IA referem-se, de forma ampla, a quaisquer dados usados no desenvolvimento ou na operação de sistemas de inteligência artificial. Consequentemente, isso inclui, mas não se limita a, datasets usados para treinar models, dados de entrada em tempo real usados para previsões e dados sintéticos gerados para aumentar exemplos do mundo real, entre outros. Embora não seja um termo técnico formal, “dados de IA” é comumente usado para descrever as informações que alimentam sistemas de machine learning e deep learning.
Perguntas frequentes
De acordo com uma pesquisa do Gartner, a má qualidade dos dados custa às organizações, em média, 12.9 milhões de dólares por ano. No entanto, o custo real vai além do impacto financeiro direto. A má qualidade dos dados leva a IA fracassada; relatórios do setor sugerem que até 85% dos projetos de IA e ML não cumprem sua promessa inicial, muitas vezes devido a problemas de qualidade dos dados. Os custos adicionais incluem tempo desperdiçado, já que os cientistas de dados passam 60-80% de seu tempo na limpeza de dados em vez do desenvolvimento de models, perda de oportunidades de receita devido a previsões imprecisas e experiências ruins do cliente, e riscos de conformidade, principalmente em setores regulamentados onde falhas de qualidade dos dados podem resultar em multas significativas.
Pesquisas de fontes do setor indicam que 70-85% das falhas de projetos de IA se devem a problemas relacionados aos dados, sendo a qualidade dos dados a principal culpada. A análise da VentureBeat sobre implementações de IA constatou que 87% dos projetos de ciência de dados nunca chegam à produção, tendo dados inadequados ou de baixa qualidade como causa principal. Uma pesquisa da Dimensional Research revelou que 96% das organizações encontram problemas de qualidade de dados ao treinar models de IA. Essas falhas se manifestam de várias maneiras, incluindo models que têm um bom desempenho em testes, mas falham em produção devido à deriva de dados, resultados enviesados decorrentes de dados de treinamento não representativos e a incapacidade de escalar porque os pipelines de dados não conseguem manter a qualidade nos volumes de produção.
Embora intimamente relacionadas, qualidade de dados e governança de dados servem a propósitos diferentes. A qualidade de dados se refere às características dos próprios dados, com foco em saber se os dados são precisos, completos, consistentes, oportunos e relevantes. Trata-se da condição e da usabilidade dos dados para o propósito pretendido. A qualidade de dados normalmente é medida por meio de métricas como taxas de erro, percentuais de completude e contagens de duplicatas.
A governança de dados, por outro lado, é o framework de políticas, procedimentos, papéis e responsabilidades que garante o gerenciamento adequado dos dados em toda a organização. A governança define quem é o proprietário dos dados, quem pode acessá-los, como devem ser usados, quais padrões devem cumprir e como a qualidade deve ser mantida.
Pense na governança de dados como a estrutura organizacional e o livro de regras, enquanto a qualidade de dados é o resultado que você está tentando alcançar. Uma boa governança possibilita boa qualidade, mas você precisa de ambas para ter sucesso nas iniciativas de IA. A governança fornece a estrutura sustentável que garante que a qualidade dos dados não seja uma limpeza pontual, mas uma prática contínua.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Qualidade dos Dados de IA: Desafios & Melhores Práticas}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/data-quality-ai}},
  note   = {AIMultiple. Acessado em 23 outubro 2026}
}
Registro de alterações
6 atualizaçõesAdicionado Pandada AI e Sieve à seção "Exemplos de soluções de qualidade de dados".
Adicionada a seção de FAQs.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.





Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.