


LLM Orquestração: 21 frameworks e gateways

Otimizar a orquestração de LLM é fundamental para melhorar o desempenho e manter o uso de recursos sob controle. Para avaliar como diferentes abordagens de orquestração se comportam na prática, fizemos benchmarks:
- Frameworks de orquestração agêntica: usando um fluxo de trabalho idêntico de planejamento de viagem com cinco agentes, executado 100 vezes cada, medindo latência de pipeline, uso de tokens, transições agente a agente e lacunas de execução agente-ferramenta.
- Gateways de IA: OpenRouter, SambaNova, TogetherAI, Groq e IA/ML API testados em latência do primeiro token, latência total e contagem de tokens de saída com 300 testes de prompts curtos (≈18 tokens) e longos (≈203 tokens).
Conheça ferramentas selecionadas de orquestração de LLM, incluindo frameworks para desenvolvedores e gateways empresariais:
O que é orquestração em LLM?
A orquestração de LLM envolve gerenciar e integrar vários Grandes Modelos de Linguagem (LLMs) para executar tarefas complexas de forma eficiente. Ela garante a interação entre modelos, fluxos de trabalho, fontes de dados e pipelines, otimizando o desempenho como um sistema unificado. As organizações usam a orquestração de LLM para tarefas como geração de linguagem natural, tradução automática, tomada de decisão e chatbots.
Embora os LLMs possuam fortes capacidades fundamentais, eles são limitados na aprendizagem em tempo real, na retenção de contexto e na solução de problemas de múltiplas etapas. Além disso, gerenciar vários LLMs em diversas APIs de provedores adiciona complexidade à orquestração.
Os frameworks de orquestração de LLM abordam esses desafios ao simplificar a engenharia de prompts, as interações com APIs, a recuperação de dados e o gerenciamento de estado. Esses frameworks permitem que os LLMs colaborem de forma eficiente, melhorando sua capacidade de gerar resultados precisos e sensíveis ao contexto.
Qual é a melhor plataforma para orquestração de LLM?
Os frameworks de orquestração de LLM podem gerenciar, coordenar e otimizar o uso de Grandes Modelos de Linguagem (LLMs) em várias aplicações. Um sistema de orquestração de LLM permite a integração com diferentes componentes de IA, facilita a engenharia de prompts, gerencia fluxos de trabalho e aprimora o monitoramento de desempenho.
Eles são particularmente úteis para aplicações envolvendo sistemas multiagentes, geração aumentada por recuperação (RAG), IA conversacional e tomada de decisão autônoma.
Para facilitar a navegação, as ferramentas são divididas em duas categorias:
1. Plataformas baseadas em gateway
As plataformas de gateway são soluções focadas em empresas que centralizam o acesso aos LLMs, aplicam políticas de segurança, gerenciam conformidade e fornecem monitoramento de uso. Essas plataformas são ideais para organizações que precisam de implantação de LLM controlada, escalável e governada.
Aqui estão alguns dos gateways de IA e suas pontuações no GitHub:
Resultados do benchmark de gateway de IA
Nosso benchmark usou a latência do primeiro token (FTL) e a latência total com a saída de tokens para avaliar a eficiência com que os gateways selecionam provedores e entregam respostas. Aqui estão alguns dos nossos resultados:
- Melhores desempenhos:
- Groq: FTL mais rápido para prompts longos (0.14 s) e baixa latência total (2.7 s) com 1.900 tokens
- SambaNova: Empate como FTL mais rápido em prompts curtos (0.13 s) e segunda menor latência total (3 s) ao produzir a maior contagem de tokens (1.997)
- Desempenhos moderados:
- OpenRouter: FTL 0.40–0.45 s, latência total 25 s para prompts longos, saída de tokens moderada
- TogetherAI: FTL 0.43–0.45 s, latência total 11 s com 1.812 tokens
- Pior desempenho: IA/ML API, maior FTL (0.84–0.90 s) e latência total (13 s), apesar da saída moderada de tokens.
Para mais detalhes e metodologia, consulte nosso artigo de benchmark sobre gateway de IA.
Aqui está uma lista de plataformas baseadas em gateway para orquestração de LLM, em ordem alfabética:
Bifrost da Maxim IA
O Bifrost é um gateway de IA que unifica o acesso a 15+ provedores de LLM por meio de uma única OpenAI-compatível API, com suporte a failover automatizado, balanceamento de carga e políticas de governança centralizadas.
Recurso exclusivo: Integração com Model Context Protocol (MCP), permitindo streaming, monitoramento baseado em plugins e análises para LLMs de vários provedores.
Cloudflare IA Gateway
Cloudflare IA Gateway é um proxy de inferência de IA e plataforma de orquestração que oferece acesso a vários grandes modelos de linguagem, com cobrança unificada, monitoramento de custos e recursos automatizados de resiliência para cargas de trabalho técnicas de IA.
Recurso exclusivo: Failover entre vários provedores e buffering de streaming na borda, que protege as respostas de streaming de aplicações de longa duração contra desconexões ao armazenar em cache a saída de inferência diretamente na rede global da Cloudflare.
Kong
Kong IA Gateway é um gateway semântico de IA que centraliza e protege o tráfego de LLM, permitindo que as organizações integrem, governem e monitorem vários modelos de IA para conformidade e rastreamento de recursos.
Recurso exclusivo: Segurança semântica de prompts, incluindo sanitização de informações pessoais (PII) e modelos avançados de prompts para proteger informações sensíveis.
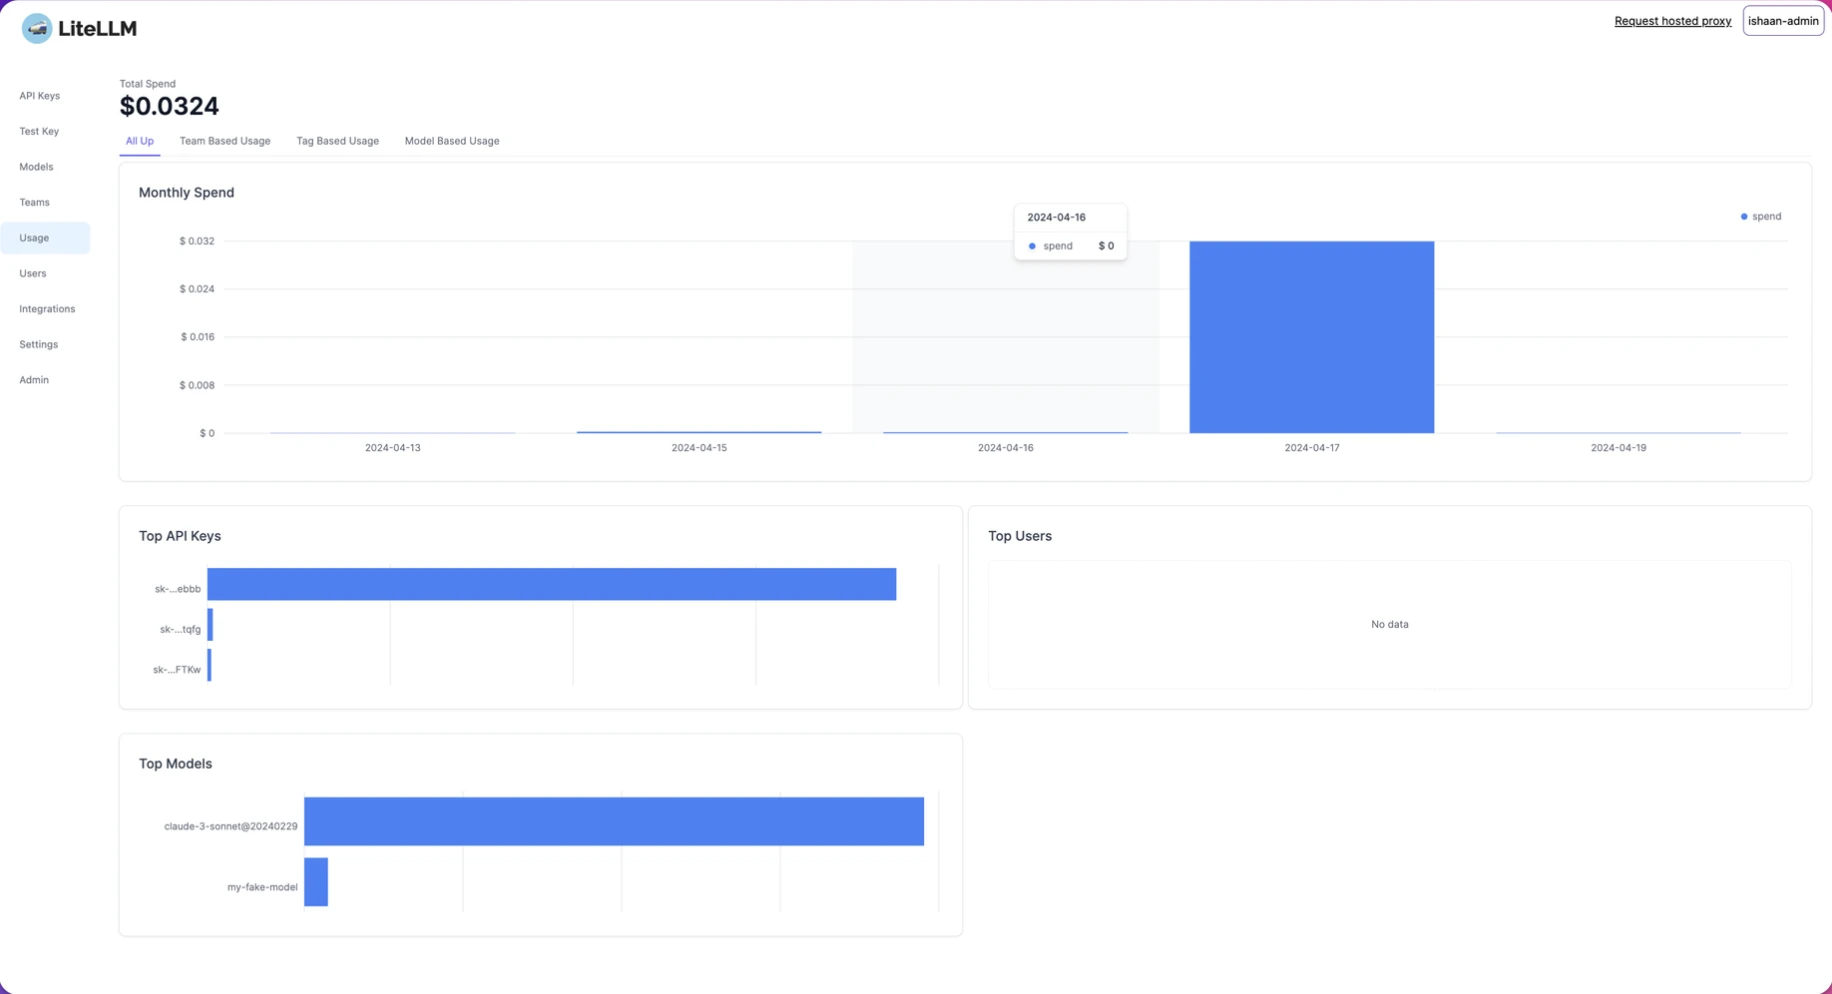
LiteLLM
LiteLLM oferece acesso a vários LLMs por meio de uma interface unificada, oferecendo um Proxy Server (LLM Gateway) e um SDK Python para gerenciamento centralizado e observabilidade do sistema.
Recurso exclusivo: Integração com SDK Python para gerenciamento programático de LLM e observabilidade, permitindo que desenvolvedores incorporem controles centralizados de IA diretamente no código.
Prisma AIRS IA Gateway (anteriormente Portkey)
O Prisma AIRS IA é um gateway de IA e plataforma de orquestração que conecta desenvolvedores a vários LLMs, com suporte a roteamento programático, failover, monitoramento de custos e recursos de implantação para equipes técnicas de IA.
Recurso exclusivo: Suporte a LLM multimodal, incluindo modelos de texto, imagem, áudio e visão com capacidades de fine-tuning para maior consistência na saída.
2. Frameworks para desenvolvedores
Os frameworks para desenvolvedores são projetados para engenheiros e desenvolvedores de IA que desejam controle total sobre a criação e orquestração de fluxos de trabalho de LLM. Eles fornecem SDKs, APIs e módulos pré-construídos para encadear modelos, gerenciar prompts e lidar com interações entre vários LLM.
Aqui está a lista completa de ferramentas de orquestração de LLM para desenvolvedores e suas estrelas no GitHub em ordem alfabética:
Resultados do benchmark
Principais conclusões do benchmark de frameworks de orquestração:
- LangGraph: Executa mais rápido com o gerenciamento de estado mais eficiente
- LangChain: Consome mais tokens devido ao maior uso de memória e gerenciamento de histórico
- AutoGen: Apresenta desempenho moderado com comportamento de coordenação consistente
- CrewAI: Registra os maiores atrasos devido à deliberação autônoma antes das chamadas de ferramentas.
Para a metodologia e uma análise mais detalhada do benchmark, consulte o benchmark de orquestração agêntica.
As ferramentas explicadas abaixo estão listadas em ordem alfabética:
Agency Swarm
O Agency Swarm é um framework de sistema multiagente (MAS) que fornece ferramentas para construir, orquestrar e gerenciar enxames de agentes de IA, usando o SDK de agentes da OpenAI.
Principais recursos:
- Suporta a coordenação multiagente, permitindo que vários agentes de IA troquem dados e executem fluxos de trabalho simultaneamente.
- Inclui ferramentas de simulação e visualização que ajudam a testar e monitorar as interações dos agentes em um ambiente simulado.
- Permite interações de IA baseadas no ambiente, pois os agentes de IA podem responder dinamicamente às condições em mudança.
AutoGen
O AutoGen, desenvolvido pela Microsoft, é um framework de orquestração multiagente de código aberto que simplifica a automação de tarefas de IA usando agentes conversacionais.
Principais recursos:
- Framework de conversação multiagente que permite que agentes de IA se comuniquem e coordenem tarefas.
- Funciona com vários provedores de modelos, incluindo OpenAI e Azure
- Arquitetura modular e configurável, uma configuração personalizável para várias aplicações de IA.
crewAI
O crewAI é um framework multiagente de código aberto. Ele permite que agentes de IA com papéis colaborem em tarefas estruturadas.
Principais recursos:
- Automação de fluxo de trabalho baseada em agentes que atribui funções específicas aos agentes de IA na execução de tarefas.
- Suporta usuários técnicos e não técnicos
- Versão Enterprise (crewAI+) disponível
Haystack
O Haystack é um framework Python de código aberto que permite a criação flexível de pipelines de IA usando uma abordagem baseada em componentes. Ele suporta recuperação de informações e aplicações de perguntas e respostas.
Principais recursos:
- Design de sistema de IA baseado em componentes que é uma abordagem modular para montar funções de IA.
- Integração com bancos de dados vetoriais e provedores de LLM, permitindo trabalhar com diversos armazenamentos de dados e modelos de IA.
- Suporta busca semântica e extração de informações, permitindo busca avançada e recuperação de conhecimento.
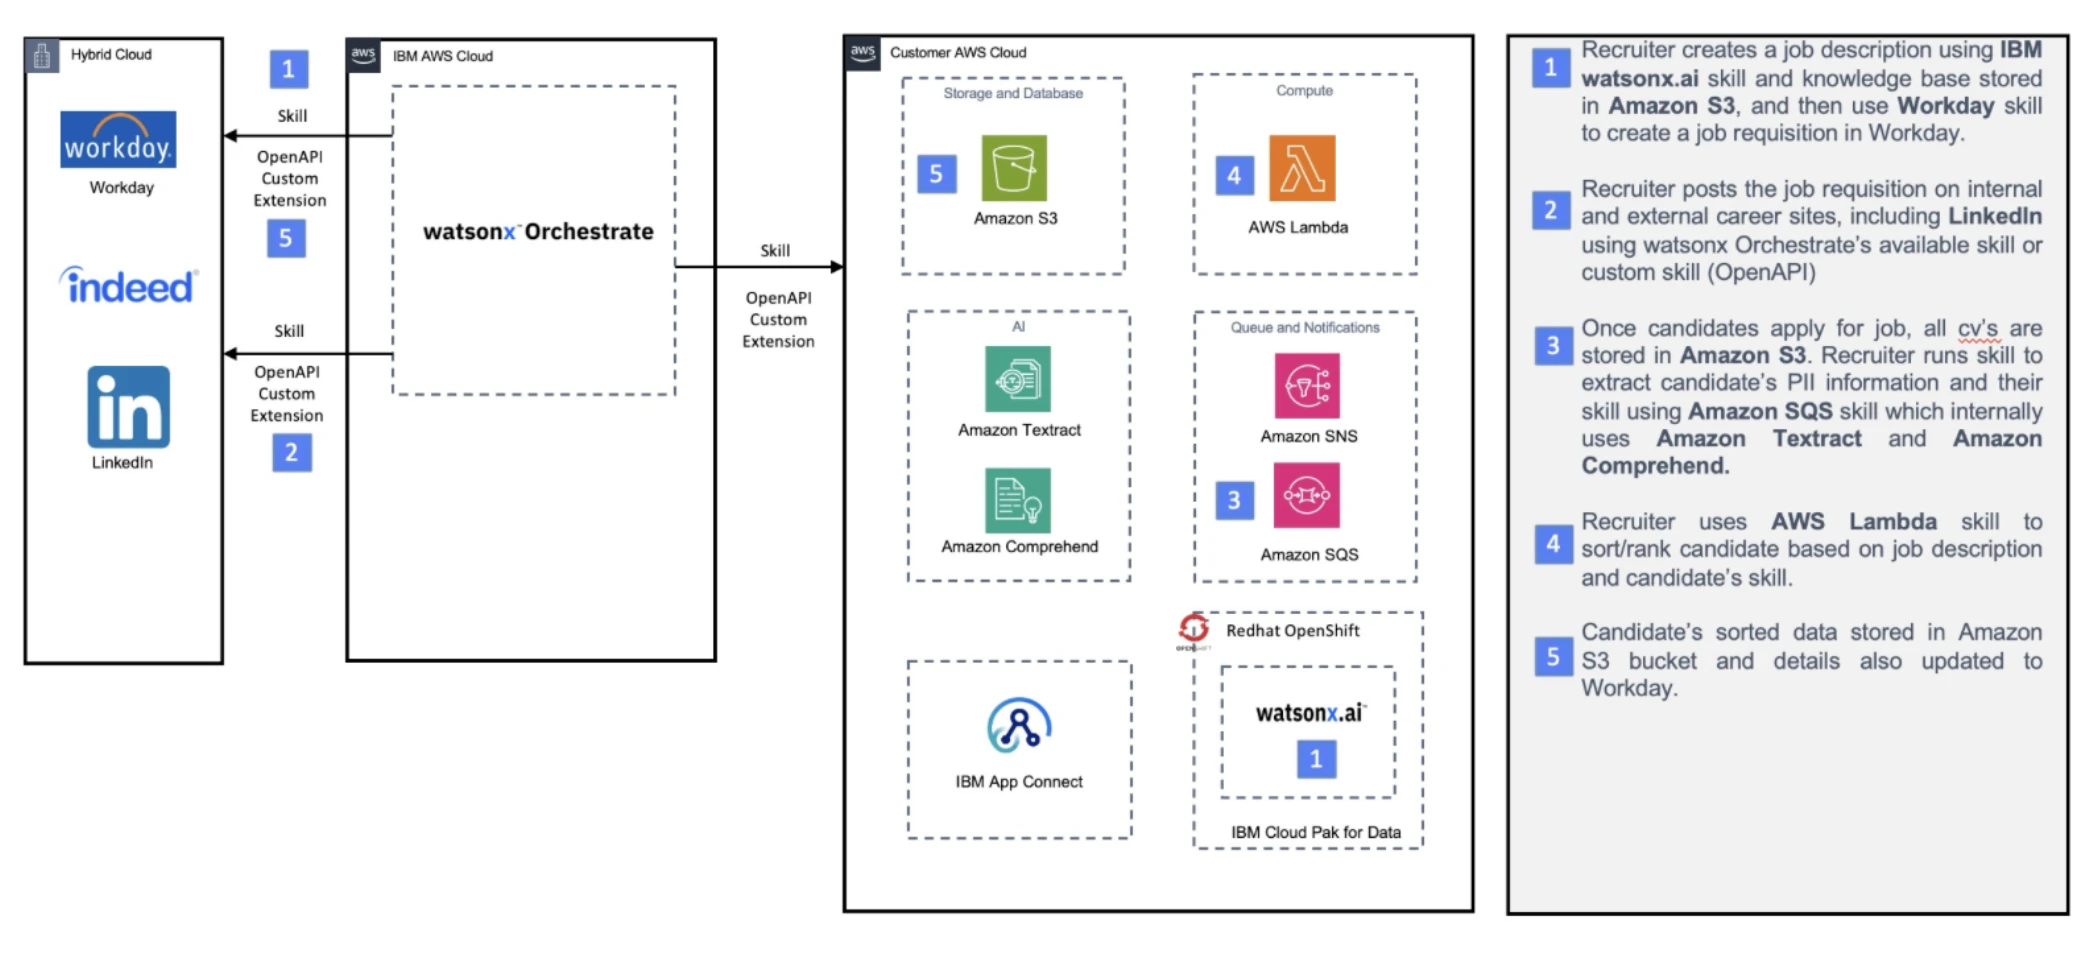
IBM watsonx orchestrate
IBM watsonx orchestrate é um framework proprietário de orquestração de IA que usa processamento de linguagem natural (NLP) para automatizar fluxos de trabalho empresariais.
Principais recursos:
- Automação de fluxo de trabalho com IA que pode automatizar processos de negócios repetitivos usando IA.
- Aplicações e conjuntos de habilidades pré-construídos, fornecendo ferramentas de IA prontas para uso em diferentes setores.
- Integração focada em empresas, conectando-se a softwares e fluxos de trabalho empresariais existentes.
LangChain
LangChain é um framework Python de código aberto para criar aplicações de LLM, com foco em aumento de ferramentas e orquestração de agentes. Ele fornece interfaces para modelos de embeddings, LLMs e armazenamentos vetoriais.
Principais recursos:
- RAG suporte
- Integração com vários componentes de LLM
- Framework ReAct para raciocínio e ação
LlamaIndex
O LlamaIndex é um framework de integração de dados de código aberto projetado para criar aplicações de LLM aumentadas por contexto. Ele permite a recuperação fácil de dados de várias fontes.
Principais recursos:
- Conectores de dados para mais de 160 fontes, permitindo que a IA acesse diversos dados estruturados e não estruturados.
- Suporte a Retrieval Augmented Generation (RAG)
- Conjunto de módulos de avaliação para acompanhamento de desempenho
LOFT
O LOFT, desenvolvido pela Master of Code Global, é um framework Large Language Model-Orchestrator projetado para otimizar interações com clientes baseadas em IA. Ele utiliza uma arquitetura baseada em filas, projetada para gerenciar solicitações concorrentes e implantações multiusuário.
Principais recursos:
- Framework agnóstico: Integra-se a qualquer sistema de backend sem dependências de frameworks HTTP.
- Prompts calculados dinamicamente: Suporta prompts gerados sob medida para interações personalizadas com usuários.
- Detecção e tratamento de eventos: Inclui mecanismos integrados para detectar e gerenciar eventos baseados em chat, incluindo filtragem de alucinações.
Microchain
O Microchain é um framework leve e de código aberto para orquestração de LLM, conhecido por sua simplicidade, mas não é mantido ativamente.
Principais recursos:
- Suporte a raciocínio por cadeia de pensamento que ajuda a IA a decompor problemas complexos passo a passo.
- Abordagem minimalista para orquestração de IA.
Orq IA
O Orq é uma plataforma colaborativa de IA generativa e ferramenta de LLMOps projetada para gerenciar o ciclo de vida de implantação de aplicações de LLM. Ele oferece recursos para equipes técnicas e não técnicas criarem, implantarem e monitorarem funcionalidades de IA.
Principais recursos:
- Orquestração serverless de LLM: Fornece infraestrutura de implantação usando uma API unificada, com roteamento integrado, controle de versão, fallbacks e novas tentativas.
- Observabilidade e avaliação: Oferece monitoramento em tempo real, rastreamentos, logs e avaliadores personalizados para garantir o desempenho e a qualidade da saída do LLM.
- Gateway de IA e RAG: Concede acesso centralizado a vários modelos e ferramentas de IA para criar pipelines de Retrieval Augmented Generation (RAG).
Semantic Kernel
O Semantic Kernel (SK) é um framework de orquestração de IA de código aberto da Microsoft. Ele ajuda os desenvolvedores a integrar grandes modelos de linguagem (LLMs) como o GPT da OpenAI à programação tradicional para criar aplicações baseadas em IA.
Principais recursos:
- Memória e gerenciamento de contexto: O SK permite o armazenamento e a recuperação de interações passadas, ajudando a manter o contexto ao longo das conversas.
- Embeddings e busca vetorial: Suporta buscas baseadas em embeddings, tornando-o compatível com casos de uso de geração aumentada por recuperação (RAG).
- Suporte multimodal: Funciona com texto, código, imagens e muito mais.
Como escolher o framework de orquestração de LLM certo?
O número de estrelas no GitHub pode indicar popularidade, mas a escolha ideal depende de vários fatores, incluindo a experiência técnica da sua equipe, a escala do projeto, o orçamento e as integrações desejadas.
Considere a experiência técnica da equipe:
- Para equipes altamente técnicas, como desenvolvedores e cientistas de dados que precisam de controle granular e flexibilidade, frameworks como LangChain, AutoGen e LlamaIndex são excelentes escolhas. Eles priorizam código e exigem um forte entendimento de Python e dos princípios de IA.
- Para usuários de negócios ou equipes com preferência por low-code/no-code, as plataformas com foco em interfaces declarativas são mais adequadas. O Loft e o crewAI oferecem fluxos de trabalho simplificados, permitindo prototipagem rápida sem codificação extensa.
Verifique a escala do projeto:
- Para sistemas multiagentes complexos, frameworks projetados especificamente para isso, como AutoGen, crewAI ou Agency Swarm, fornecem a arquitetura necessária para que os agentes se comuniquem e colaborem.
- Para aplicações empresariais de missão crítica em grande escala que exigem alto throughput, segurança e suporte dedicado, soluções proprietárias como IBM watsonx orchestrate costumam ser a opção preferida.
- Para aplicações leves de prova de conceito (POC), um framework minimalista pode ser suficiente, pois sua simplicidade reduz a sobrecarga.
Pense nas restrições orçamentárias:
- Frameworks de código aberto como LangChain e Haystack são gratuito para usar, mas trazem os “custos ocultos” da infraestrutura de nuvem, manutenção e uma equipe especializada.
- Soluções proprietárias podem oferecer uma estrutura de preços previsível que inclui suporte e podem ser mais econômicas para organizações sem uma equipe dedicada de MLOps.
Considere sua stack de tecnologia existente.
- Se sua empresa está investida em um ecossistema específico, remover frameworks que não funcionam com esse ecossistema é um passo útil. Por exemplo, o Semantic Kernel para ambientes Microsoft ou o Haystack para aplicações focadas em recuperação de documentos podem proporcionar integração.
Como funcionam as ferramentas de orquestração de LLM?
Os frameworks de orquestração de LLM gerenciam a interação entre diferentes componentes de aplicações baseadas em LLM, garantindo fluxos de trabalho estruturados e execução eficiente. A camada de orquestração desempenha um papel central na coordenação de processos como gerenciamento de prompts, alocação de recursos, pré-processamento de dados e interações entre modelos.
Camada de orquestração
A camada de orquestração atua como o sistema de controle central em uma aplicação baseada em LLM. Ela gerencia as interações entre vários componentes, incluindo LLMs, modelos de prompts, bancos de dados vetoriais e agentes de IA. Ao supervisionar esses elementos, a orquestração garante um desempenho coeso em diferentes tarefas e ambientes.
Principais tarefas de orquestração
Gerenciamento de cadeia de prompts
- O framework estrutura e gerencia as entradas do LLM (prompts) para otimizar a saída.
- Ele fornece um repositório de modelos de prompts, permitindo a seleção dinâmica com base no contexto e nas entradas do usuário.
- Ele sequencia os prompts de forma lógica para manter fluxos de conversa estruturados.
- Ele avalia as respostas para refinar a qualidade da saída, detectar inconsistências e garantir a adesão às diretrizes.
- Mecanismos de verificação de fatos podem ser implementados para reduzir imprecisões, com respostas sinalizadas encaminhadas para revisão humana.
Gerenciamento de recursos e desempenho do LLM
- Os frameworks de orquestração monitoram o desempenho do LLM por meio de testes de benchmark e painéis em tempo real.
- Eles fornecem ferramentas de diagnóstico para análise de causa raiz (RCA) para facilitar a depuração.
- Eles alocam recursos computacionais de forma eficiente para otimizar o desempenho.
Gerenciamento e pré-processamento de dados
- O orquestrador recupera dados de fontes especificadas usando conectores ou APIs.
- O pré-processamento converte dados brutos em um formato compatível com LLMs, garantindo a qualidade e a relevância dos dados.
- Ele refina e estrutura os dados para aumentar sua adequação ao processamento por diferentes algoritmos.
Integração e interação com LLM
- O orquestrador inicia as operações do LLM, processa a saída gerada e a encaminha ao destino apropriado.
- Ele mantém armazenamentos de memória que melhoram a compreensão contextual ao preservar interações anteriores.
- Mecanismos de feedback avaliam a qualidade da saída e refinam as respostas com base em dados históricos.
Medidas de observabilidade e segurança
- O orquestrador oferece suporte a ferramentas de monitoramento para acompanhar o comportamento do modelo e garantir a confiabilidade da saída.
- Ele implementa frameworks de segurança para mitigar riscos associados a saídas não verificadas ou imprecisas.
Melhorias adicionais
Integração de fluxo de trabalho
- Incorpora ferramentas, tecnologias ou processos aos sistemas operacionais existentes para melhorar a eficiência, a consistência e a produtividade.
- Garante transições suaves entre diferentes provedores de modelos, mantendo a qualidade dos prompts e da saída.
Troca de provedores de modelos
- Alguns frameworks permitem trocar de provedor de modelos com mudanças mínimas, reduzindo o atrito operacional.
- Atualizar importações de provedores, ajustar parâmetros de modelos e modificar referências de classes facilitam as transições.
Gerenciamento de prompts
- Mantém a consistência na elaboração de prompts enquanto ajuda os usuários a iterar e experimentar de forma mais produtiva.
- Integra-se a pipelines de CI/CD para agilizar a colaboração e automatizar o rastreamento de mudanças.
- Alguns sistemas rastreiam automaticamente as modificações de prompts, ajudando a detectar impactos inesperados na qualidade dos prompts.
Padrão emergente: engenharia de contexto
À medida que a orquestração de LLM evolui, uma nova disciplina surgiu: a engenharia de contexto. Ela se concentra em otimizar quais informações são incluídas na entrada de um LLM, especialmente ao combinar recuperação em tempo real, interações passadas e memória para melhorar a qualidade e a eficiência das respostas.
Essa prática pode ser enquadrada como um padrão de orquestração, onde o contexto se torna um recurso gerenciado que é recuperado, filtrado e moldado com precisão para corresponder à intenção do usuário e aos limites de tokens.
Os principais elementos desse padrão de orquestração incluem:
- Context broker: Uma unidade centralizada na camada de orquestração que coleta e normaliza entradas da memória, dos módulos de recuperação e das interações recentes. Ela garante consistência em todos os fluxos de trabalho sensíveis ao contexto.
- Módulos e vias: Componentes especializados (como resumidores, mecanismos de recuperação ou buscas em memória) são ativados seletivamente por mecanismos dinâmicos de despacho de ferramentas com base na natureza da consulta do usuário ou no estado do sistema.
- Empacotamento de contexto: O conteúdo recuperado e lembrado é classificado, compactado e organizado em prompts estruturados. Esse empacotamento seletivo garante que as informações de alto valor caibam na janela de entrada do LLM sem exceder as restrições de tokens.
- Guardrails e adaptação: Restrições integradas podem impor respostas somente por recuperação, e atualizações de memória de longo prazo garantem que o sistema refine a seleção de contexto.
Esse padrão é cada vez mais essencial em sistemas que usam geração aumentada por recuperação (RAG), colaboração multiagente e copilotos baseados em LLM, onde cada consulta deve acionar os módulos certos e trazer à tona as informações mais relevantes.
 Adicionar como fonte preferencial
4 práticas recomendadas de orquestração de LLM
1-Comece com uma arquitetura sólida e modular
- Decomposição de tarefas: Defina claramente seu fluxo de trabalho e divida o problema em etapas pequenas, distintas e testáveis. Projete seu pipeline para que funções-chave (por exemplo, criação de prompts, acesso à memória, lógica avançada) fiquem isoladas em seus próprios módulos.
- Design iterativo: Comece com o protótipo funcional mais simples (um “produto viável mínimo”) e adicione complexidade incrementalmente. Valide que cada etapa, da recuperação de dados à saída final, funcione isoladamente antes de integrá-la a uma cadeia complexa.
2-Roteamento e seleção dinâmica de modelos
- Otimize custo e velocidade: Evite usar o LLM mais caro e maior para todas as tarefas. Implemente lógica no orquestrador para rotear consultas simples (como classificação ou sumarização) para modelos menores e mais baratos e reserve os modelos de primeira linha para raciocínios complexos ou análises de várias etapas.
- Agnosticismo de fornecedor: Estruture sua camada de orquestração para permitir a troca fácil entre provedores de modelos (por exemplo, OpenAI, Anthropic, Google) para mitigar a dependência de fornecedor, gerenciar os limites de taxa da API e aproveitar os modelos de melhor desempenho à medida que o mercado evolui.
3-Implemente observabilidade e monitoramento robustos
- Registre tudo: Registre as entradas e saídas de cada etapa da cadeia, não apenas o resultado final. Isso é crucial para depurar fluxos conversacionais de várias etapas e realizar análise de causa raiz (RCA) sobre erros.
- Acompanhe métricas-chave: Monitore latência, throughput, consumo de tokens (para controle de custos) e taxas de erro do modelo em tempo real. Alertas automatizados devem ser configurados para sinalizar picos de alucinações ou falhas imediatamente.
4-Verifique as guardrails de governança e segurança
- Verificações de pré e pós-processamento: Envolva todas as chamadas de LLM com guardrails. Use verificações de pré-processamento (por exemplo, filtragem de conteúdo, lista negra de tópicos proibidos) na entrada do usuário e verificações de pós-processamento (por exemplo, verificação do formato estruturado da saída, verificações de segurança) na resposta do modelo antes da entrega.
- Conformidade: Para dados sensíveis, implemente camadas de permissão, anonimização e criptografia no início do processo de design para manter a conformidade (por exemplo, HIPAA, GDPR).
4 desafios da orquestração de LLM e estratégias de mitigação
Aqui estão alguns problemas associados à orquestração de LLM e os métodos para enfrentá-los: Principais desafios na orquestração de vários LLM
1. Coordenação e deadlocks de fluxo de trabalho
Devido à natureza não determinística do LLM, definir transferências claras entre funções especializadas de LLM é difícil. Isso resulta em sobreposição de tarefas (uso redundante de tokens) ou deadlocks de fluxo de trabalho (uma instância de LLM espera indefinidamente por uma saída ambígua de outra).
Mitigar com fluxo de trabalho estruturado e comunicação
- Use um controlador de fluxo de trabalho para decompor a meta em um Grafo Acíclico Dirigido (DAG) de subtarefas.
- Imponha um Protocolo de Comunicação Pydantic/JSON para todas as transferências de tarefas. Isso força o LLM a produzir dados legíveis por máquina e validados por esquema, tornando os sinais de progresso inequívocos e prevenindo ciclos.
2. Deriva contextual e inconsistência de memória
A janela de contexto fixa do LLM e a ausência inerente de estado o tornam propenso à deriva contextual, em que um papel de LLM esquece o objetivo geral ou fatos anteriores cruciais. Em uma configuração de vários LLM, isso cria decisões conflitantes e saídas gerais inconsistentes.
Mitigar usando uma base de conhecimento externalizada com RAG
- Implemente um sistema de memória externa (banco de dados vetorial ou grafo de conhecimento). Os papéis especializados de LLM registram fatos, decisões e resultados importantes como dados estruturados. Quando uma instância de LLM precisa de contexto, ela usa a Retrieval Augmented Generation (RAG) para consultar essa fonte externa, garantindo que recupere as informações mais relevantes e não redundantes.
3. Saída não determinística e alucinação em cascata
A saída probabilística do LLM significa que as respostas não são confiáveis. Quando uma instância de LLM (o produtor) fabrica informações (alucina), uma instância de LLM a jusante (o consumidor) as trata como fato, levando a uma falha em cascata completa do fluxo de trabalho de vários LLM.
Mitigar com mecanismos de consenso e validação
- Empregue um padrão de consenso para saídas críticas. O controlador de fluxo de trabalho encaminha a saída inicial para um papel validador secundário de LLM ou para um banco de dados externo/API para verificação de fatos. O fluxo de trabalho prossegue se a saída for verificada com sucesso, mitigando efetivamente o risco de erros não determinísticos do modelo.
4. Contenção de recursos e estouro de custos
Escalar fluxos de trabalho de vários LLM cria alta demanda pela API do LLM (um recurso caro e limitado por taxa). Isso resulta em falhas de limite de taxa (throttling de API) e consumo massivo de tokens (estouro de custos) decorrente de trabalho redundante ou loops.
Mitigar com enfileiramento assíncrono e guardrails de orçamento
- Utilize uma fila de tarefas assíncrona (por exemplo, Celery) com um limitador de taxa para controlar a concorrência de execução das chamadas de API.
- Implemente ferramentas de observabilidade para rastrear o uso de tokens por tarefa e defina orçamentos de tokens automatizados (disjuntores) que encerram ou pausam qualquer instância de LLM fora de controle, gerenciando o custo operacional em tempo real.
A orquestração é um componente-chave de LLM?
Sim. A orquestração é um componente-chave em sistemas baseados em LLM, mas não é um componente central do modelo como os pesos do modelo ou o tokenizador. Em vez disso, é uma capacidade em nível de sistema que torna os LLMs utilizáveis em aplicações do mundo real.
Entre os componentes essenciais, a orquestração normalmente fica ao lado de:
- Modelo LLM: Um modelo de linguagem de grande escala (LLM) processa grandes quantidades de dados para entender e gerar texto semelhante ao humano. Modelos de código aberto oferecem flexibilidade, enquanto os de código fechado proporcionam facilidade de uso e suporte. LLMs de uso geral lidam com várias tarefas, enquanto modelos específicos de domínio atendem a setores especializados.
- Prompts: Prompts eficazes orientam as respostas de LLM.
- Prompts zero-shot: Geram respostas sem exemplos prévios.
- Prompts few-shot: Usam algumas amostras para refinar a precisão. Saiba mais sobre prompting de few-shot learning e outros métodos de fine tuning de LLM.
- Prompts de cadeia de pensamento: Estimulam o raciocínio lógico para melhores respostas.
- Banco de dados vetorial: Armazena dados estruturados como vetores numéricos. LLMs usam buscas por similaridade para recuperar contexto relevante, melhorando a precisão e evitando respostas desatualizadas.
- Agentes e ferramentas: Estendem as capacidades do LLM ao executar buscas na web, executar código ou consultar bancos de dados. Eles aprimoram a automação orientada por IA e as soluções de negócios.
- Orquestrador (camada de controle): Integra LLMs, prompts, bancos de dados vetoriais e agentes em um sistema coeso. Garante uma coordenação suave para aplicações eficientes baseadas em IA.
- Monitoramento: Acompanha o desempenho, detecta anomalias e registra interações. Garante respostas de alta qualidade e ajuda a mitigar erros nas saídas de LLM.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{simsek2026,
  author = {Şimşek, Hazal},
  title  = {{LLM Orquestração: 21 frameworks e gateways}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/llm-orchestration}},
  note   = {AIMultiple. Acessado em 21 outubro 2026}
}Resultados e carimbos de data/hora de 212 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 5 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
9 atualizaçõesRemovida a seção de perguntas frequentes e a entrada Nexos.ai da lista de gateways de IA.
Adicionados resultados de benchmark à introdução e a uma nova seção.
Expandida a seção "Ferramentas de Orquestração LLM" com uma nova categorização de ferramentas em "Plataformas baseadas em Gateway" e "Frameworks de Desenvolvedor."
Links de referência










Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.