


Principais ferramentas LLMOps e compare-as ao MLOps

As plataformas LLMOps lidam com o lado operacional da execução de modelos de linguagem de grande porte: implantação, monitoramento, avaliação e gerenciamento de custos.
Examinamos as principais ferramentas LLMOps, seus recursos essenciais, modelos de preços e como elas diferem entre si para ajudar a identificar a melhor opção para vários casos de uso.
Comparação de ferramentas LLMOps
Ferramenta | Avaliação | Rastreamento de custos | Fine Tuning | Eng. de Prompt | Cons. de Pipeline | BLEU / ROUGE | Armazenamento de Dados e Versionamento |
|---|---|---|---|---|---|---|---|
✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |
MLflow | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
Lamini AI | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✕ |
TrueFoundry | ✓ | ✓ | ✓ | ✕ | ✓ | ✓ | ✕ |
Deepset AI | ✕ | ✕ | ✓ | ✓ | ✓ | ✕ | ✓ |
Nemo by NVIDIA | ✓ | ✕ | ✓ | ✓ | ✕ | ✓ | ✕ |
Fine-Tuner AI | ✓ | ✕ | ✓ | ✓ | ✕ | ✕ | ✓ |
ZenML | ✓ | ✕ | ✕ | ✕ | ✓ | ✓ | ✕ |
Snorkel AI | ✕ | ✕ | ✕ | ✓ | ✓ | ✕ | ✓ |
Comet | ✓ | ✓ | ✕ | ✕ | ✕ | ✓ | ✕ |
Uma análise detalhada de cada métrica é fornecida abaixo:
- Avaliação: Algumas ferramentas LLMOps incluem recursos integrados para avaliar os resultados dos modelos em relação a critérios específicos da tarefa, enquanto outras dependem de frameworks externos para análises mais personalizadas ou aprofundadas.
- Rastreamento de custos: A análise detalhada de custos e o monitoramento dos recursos usados durante o treinamento e a inferência são diretamente suportados pelas ferramentas ou obtidos por meio de integrações.
- Fine-tuning: Algumas ferramentas LLMOps realizam o fine-tuning de modelos de linguagem de grande porte por conta própria, enquanto outras se concentram em gerenciar ou orquestrar o processo de fine-tuning.
- Engenharia de prompt: O design e a otimização de prompts são tratados diretamente por algumas ferramentas, mas a maioria fornece infraestrutura para dar suporte a isso em vez de executá-los por conta própria.
- Construção de pipeline: Certas ferramentas automatizam fluxos de trabalho de LLM de ponta a ponta, incluindo preparação de dados, treinamento e avaliação. Enquanto isso, outras permitem a construção de pipelines por meio de integrações.
- BLEU / ROUGE: BLEU e ROUGE são métricas comuns de avaliação de linguagem usadas para avaliar a qualidade do texto; algumas ferramentas os suportam nativamente, enquanto outras dependem de bibliotecas externas.
- Armazenamento de dados e versionamento: O armazenamento seguro e o rastreamento de versões dos dados de treinamento são tratados diretamente por algumas ferramentas, enquanto outras se integram a soluções de armazenamento/versionamento de terceiros.
O que são plataformas LLMOps?
As plataformas LLMOps suportam o ciclo de vida dos LLMs ao permitir:
- Fine-tuning
- Versionamento
- Implantação
- Monitoramento
- Gerenciamento de prompts e experimentos
As plataformas LLMOps variam em abordagem:
- No-code/plataformas low-code: fáceis de usar, mas menos flexíveis.
- Code-first/plataformas orientadas à engenharia: exigem habilidades técnicas, mas oferecem maior personalização.
As ferramentas LLMOps podem ser agrupadas em três categorias principais:
1. Plataformas MLOps que se estendem para LLMOps
Certas plataformas de Machine Learning Operations (MLOps) incluem kits de ferramentas especializados, adaptados para operações de modelos de linguagem de grande porte (LLMOps).
MLOps é a disciplina focada em orquestrar todo o ciclo de vida do machine learning, do desenvolvimento à implantação e manutenção. Como os LLMs também são modelos de machine learning, os fornecedores de MLOps estão naturalmente se expandindo para esse domínio.
CoreWeave Forge
CoreWeave Forge, anteriormente Weights & Biases, é uma plataforma MLOps que se expandiu para LLMOps por meio do W&B Weave. Originalmente focada no rastreamento de experimentos e no monitoramento de modelos para ML tradicional, a plataforma adicionou recursos de LLM à medida que esses modelos se tornaram centrais para o desenvolvimento de IA.
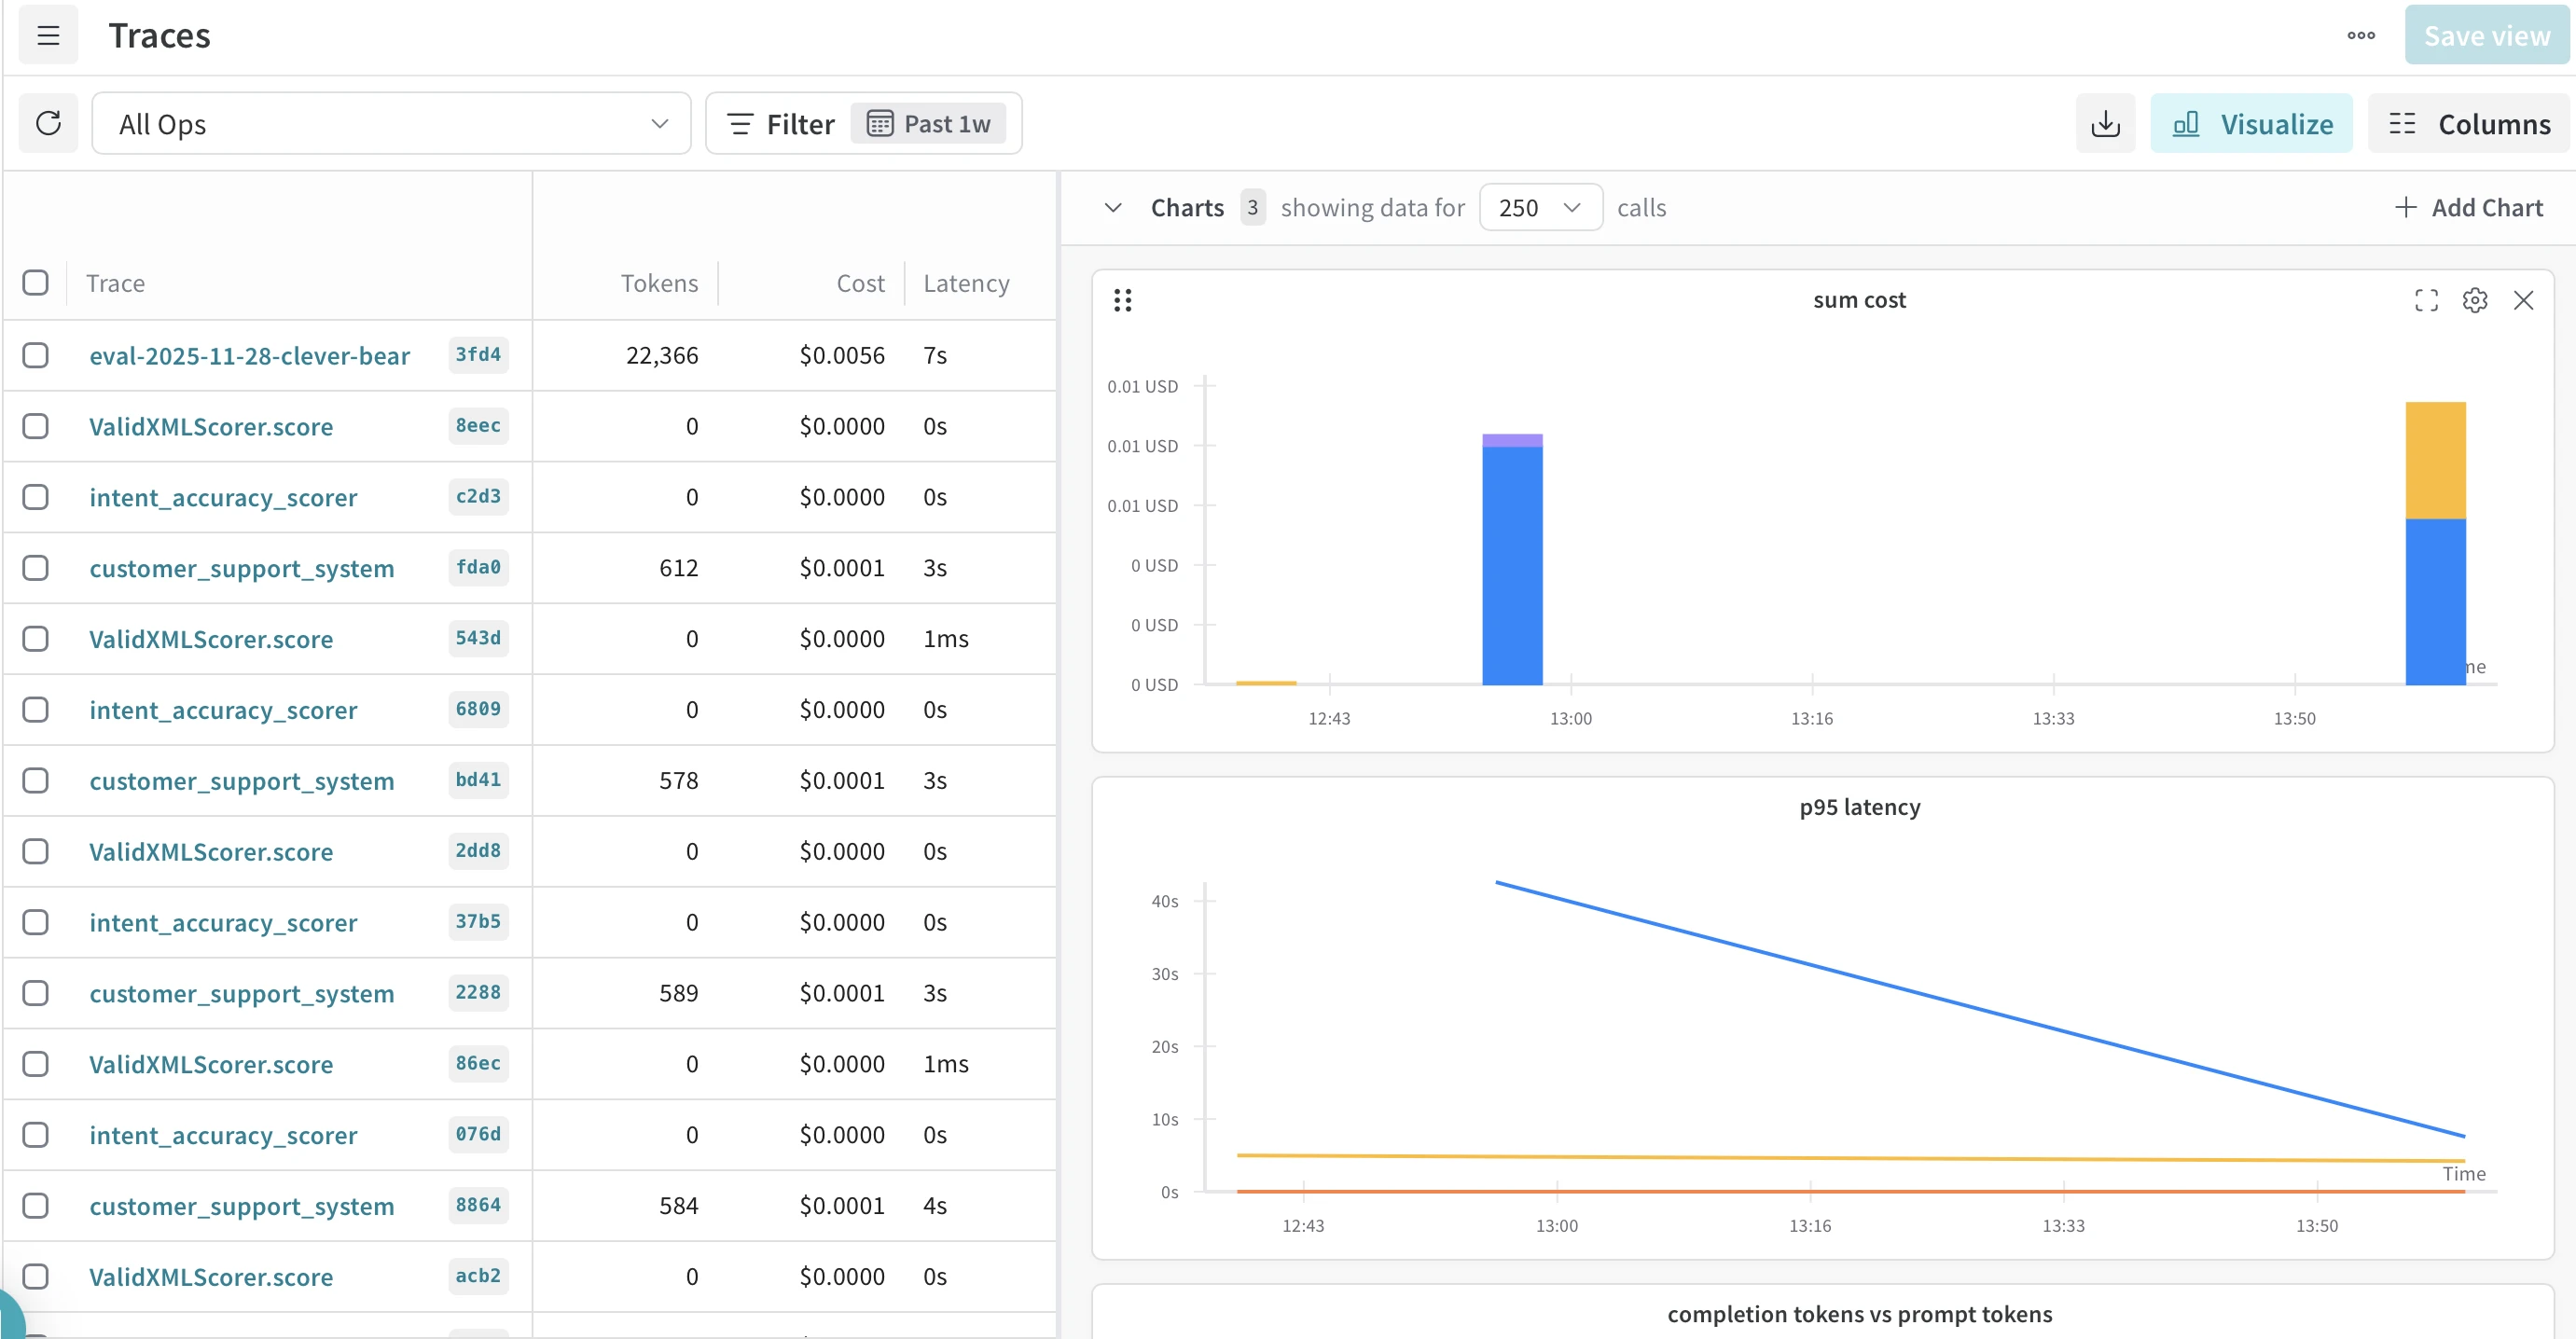
O W&B Weave oferece observabilidade de LLM com rastreamento automático, versionamento de prompts, frameworks de avaliação com pontuadores integrados e visualização de fluxo de trabalho multiagente. A plataforma rastreia custos e latência em níveis individuais e agregados, ajudando as equipes a identificar consultas caras e gargalos de desempenho. Para pipelines complexos com vários agentes ou chamadas de ferramentas, o W&B Weave cria árvores de rastreamento aninhadas mostrando o fluxo de execução completo, permitindo a depuração de fluxos de trabalho em várias etapas e a otimização de cada componente.
O CoreWeave Forge permite que as equipes usem a mesma plataforma para fine-tuning de LLMs (W&B Models), versionamento de dados e modelos (CoreWeave Registry) e monitoramento de aplicações em produção (W&B Weave).
Figura 1: Painel de rastreamentos do W&B Weave.
MLflow
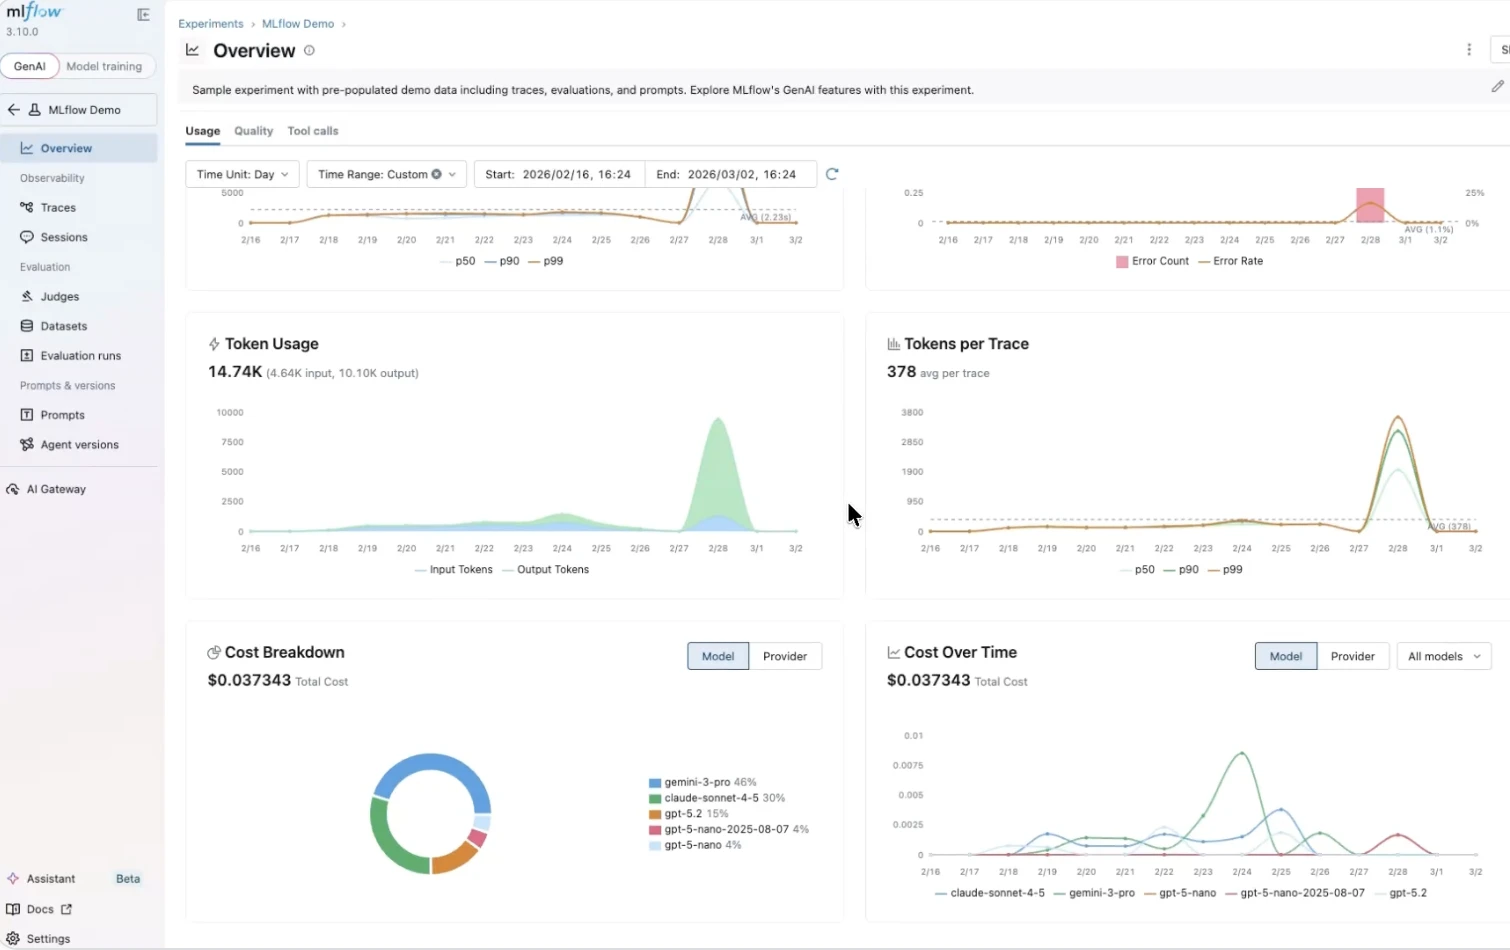
MLflow é uma plataforma de código aberto para gerenciar o ciclo de vida de LLM e agentes. Os principais recursos de LLMOps incluem:
- Tracing: captura prompts, recuperações e chamadas de ferramentas em fluxos de trabalho de agentes
- Avaliação: pontuação LLM-como-juiz com métricas pré-construídas para alucinação e relevância
- Gerenciamento de prompts: versionamento, otimização e rastreamento de linhagem
- IA Gateway: acesso centralizado a modelos e controle de custos
MLflow é compatível com OpenTelemetry e integra-se aos principais provedores de LLM e frameworks de agentes.
1Comet
Comet é uma plataforma de rastreamento de experimentos e observabilidade de modelos. Ela também suporta rastreamento de experimentos de LLM, versionamento de prompts e avaliação de LLM, tornando-a adequada para equipes que criam e otimizam aplicações de LLM.
Valohai
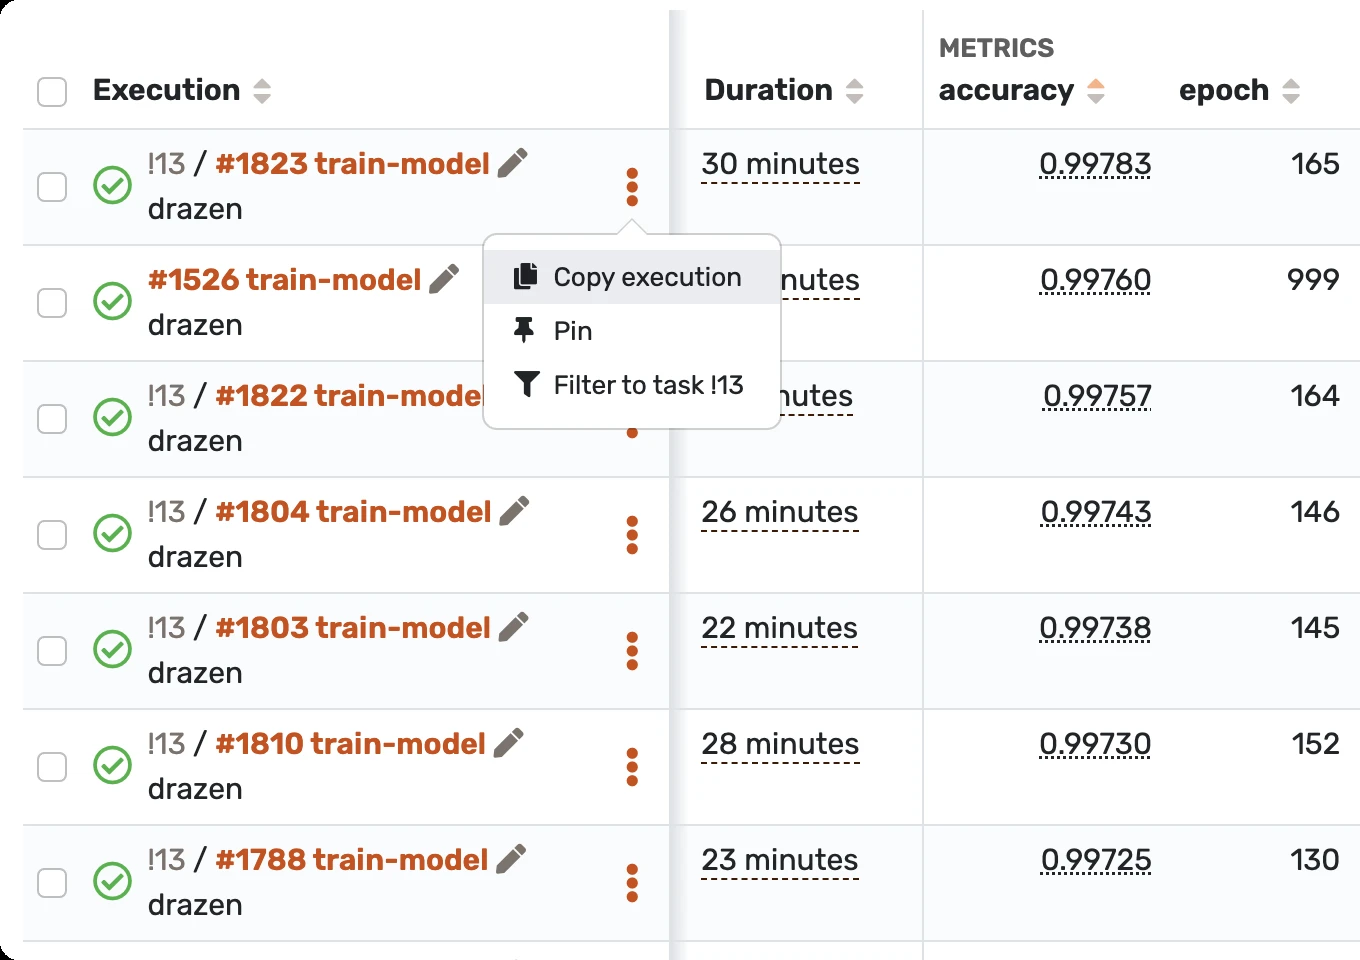
Valohai é uma plataforma MLOps que suporta pipelines reproduzíveis para processamento de dados, treinamento e implantação. Recentemente, adicionou recursos compatíveis com LLMOps, como rastreamento de metadados, versionamento de artefatos e orquestração de treinamento em larga escala.
Figura 2: Repositório de conhecimento da Valohai.2
TrueFoundry
TrueFoundry é uma plataforma de ML/LLM de ponta a ponta que simplifica a implantação, o finetuning e o monitoramento de modelos. Ela oferece infraestrutura otimizada para GPU, registro de modelos, gerenciamento de prompts e governança de nível empresarial.
ZenML
ZenML fornece um framework de pipeline pronto para produção para MLOps e LLMOps. Ele permite que os usuários criem pipelines reproduzíveis, conectem orquestradores (Airflow, Kubeflow) e integrem fluxos de trabalho de LLM, como RAG, finetuning e avaliação.
2. Plataformas de dados, nuvem e infraestrutura que oferecem LLMOps
As plataformas de dados, nuvem e infraestrutura estão cada vez mais oferecendo recursos de LLMOps que permitem que os usuários aproveitem seus próprios dados para criar e fazer fine-tuning de LLMs.
Por exemplo, Databricks oferece treinamento de LLM, fine-tuning e hospedagem de modelos (expandido após a aquisição da MosaicML).
Os líderes de nuvem Amazon, Azure e Google lançaram suas ofertas de LLMOps, que permitem aos usuários implantar modelos de diferentes provedores.
3. Frameworks e plataformas focados em LLM
Esta categoria inclui ferramentas que se concentram exclusivamente na otimização e no gerenciamento de operações de LLM. Aqui está uma análise das ferramentas e suas principais funções de LLMOps:
DeepLake
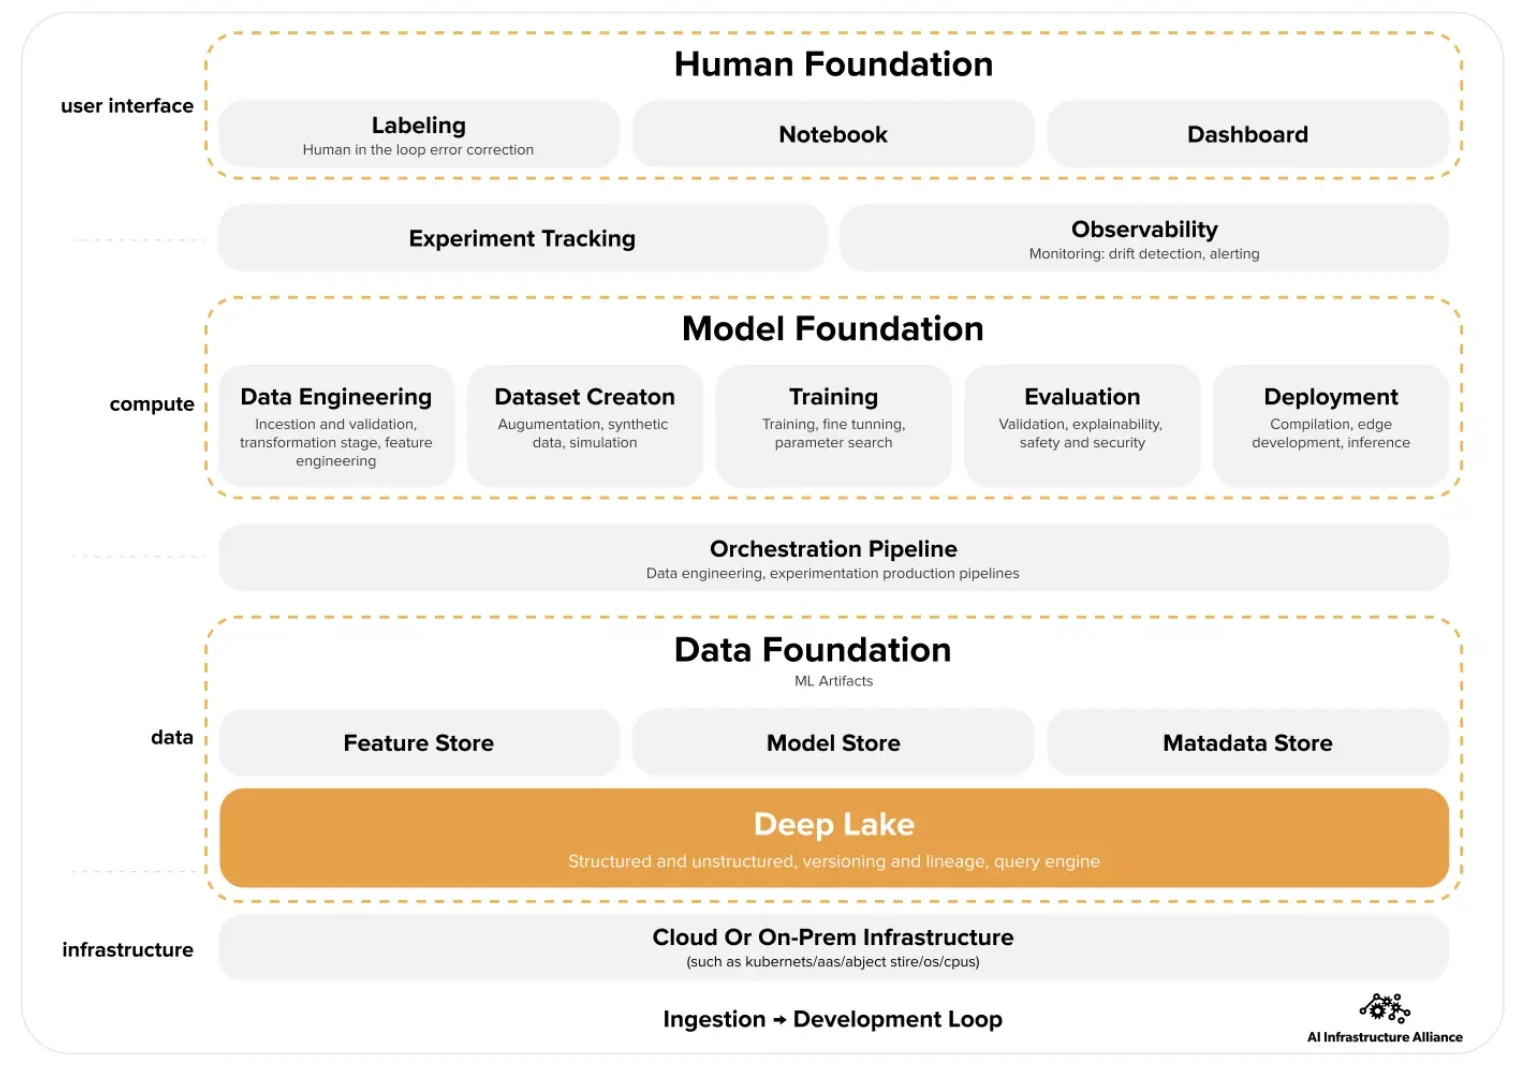
O Deep Lake oferece um data lake projetado para IA, fornecendo armazenamento, versionamento e um banco de dados vetorial. Ele suporta fluxos de trabalho para criação, inspeção e recuperação de datasets de LLM, funcionando perfeitamente com PyTorch e TensorFlow.
Figura 3: A imagem mostra o papel do Deep Lake em uma arquitetura MLOps3
Deepset AI
O Haystack da Deepset é um framework de RAG e busca que permite que as empresas criem aplicações alimentadas por LLM combinando armazenamentos de documentos, recuperadores e modelos de linguagem de grande porte. Ele suporta pipelines RAG multimodais, avaliação de modelos e implantação em produção.
Lamini AI
A Lamini oferece uma plataforma para criar LLMs personalizados, suportando tanto finetuning completo quanto ajuste leve. Ela é feita para empresas que precisam de LLMs específicos de domínio e fornece APIs e SDKs para integrar dados organizacionais.
Nemo by NVIDIA
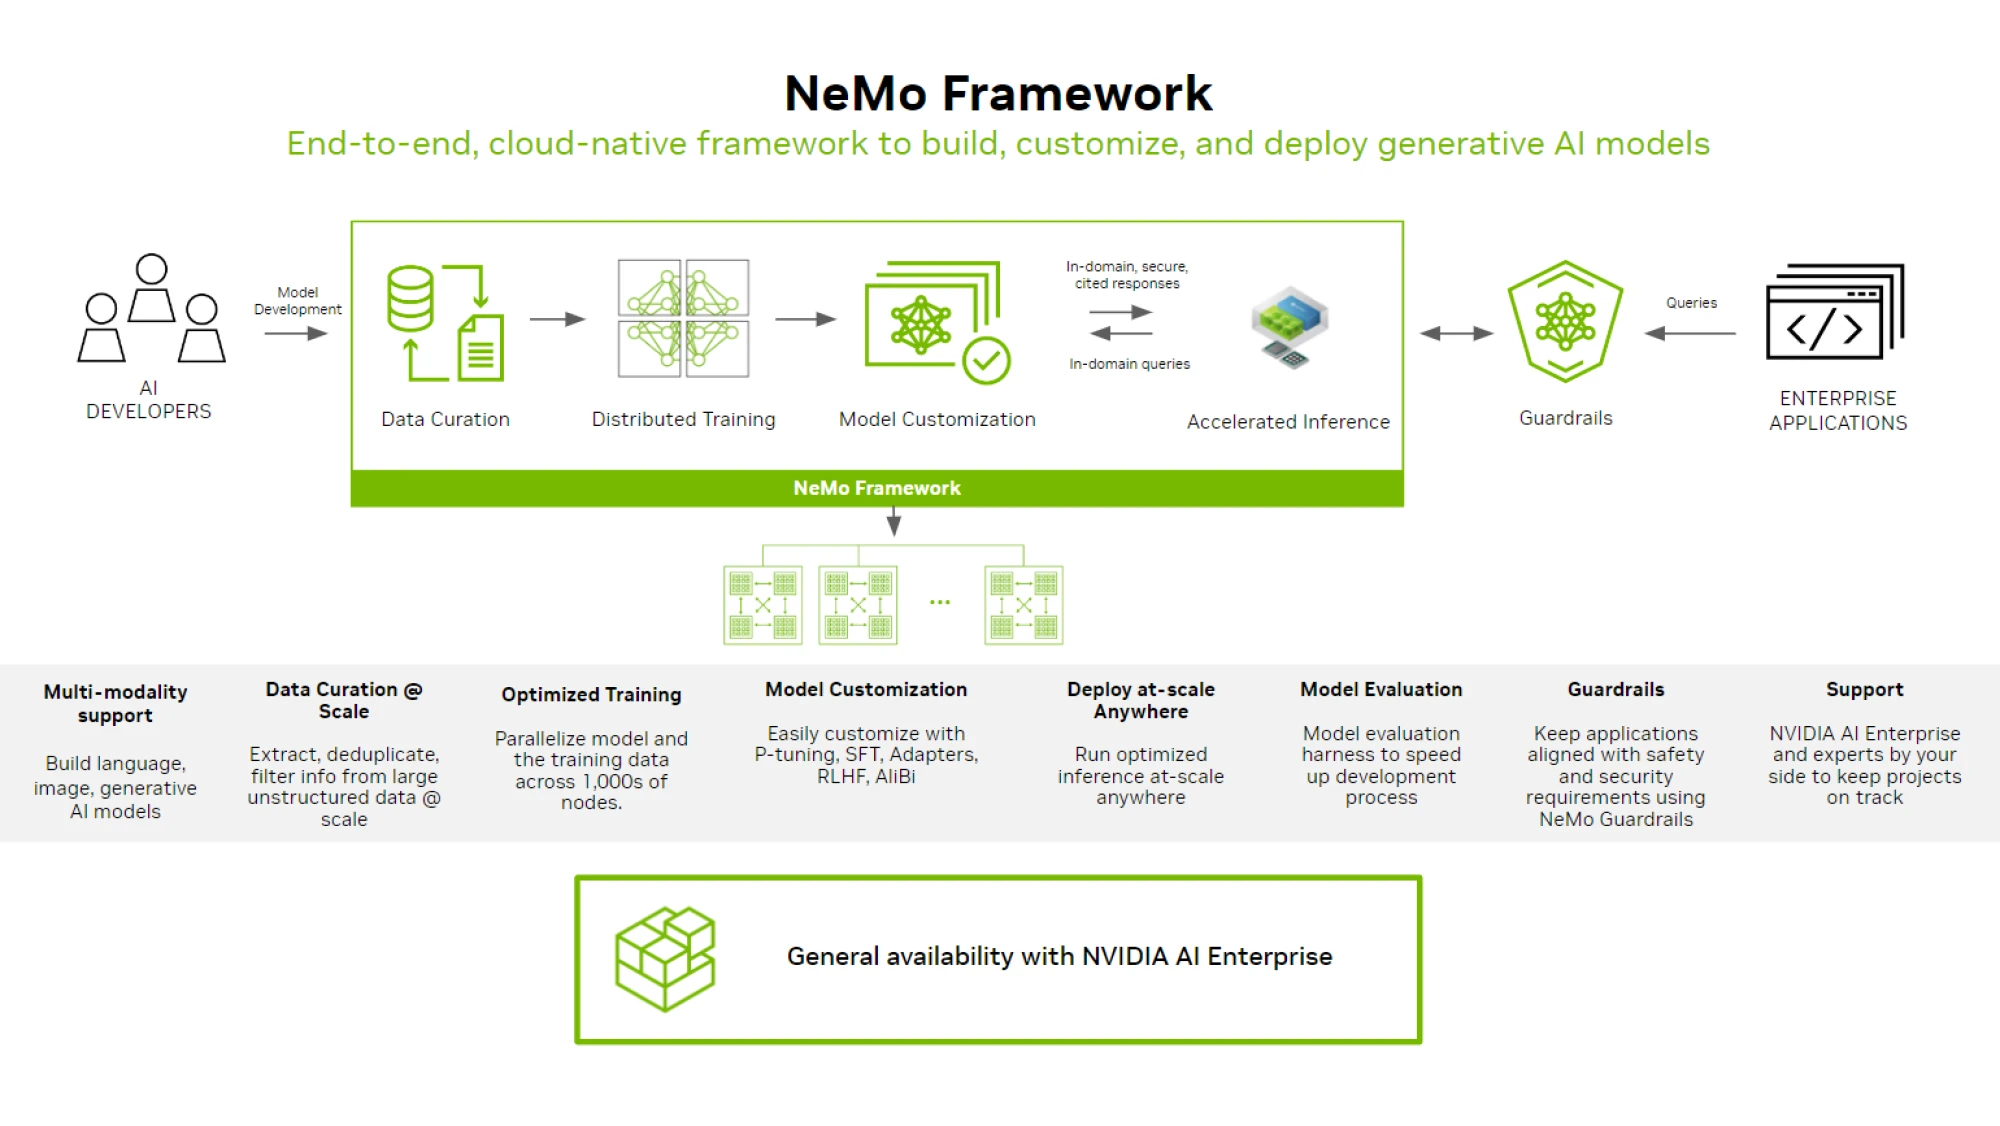
NeMo é um framework para criar, treinar e personalizar modelos de fundação, incluindo LLMs. Ele fornece componentes para finetuning supervisionado, ajuste por instruções, RAG, avaliação de modelos e implantação em NVIDIA GPUs.
Figura 4: Arquitetura do framework NeMo.4
Snorkel AI
A Snorkel AI fornece uma plataforma de desenvolvimento centrada em dados para rotulagem programática e curadoria de dados de treinamento. Agora, ela se estende à personalização de modelos de fundação, permitindo que as organizações adaptem LLMs com datasets rotulados automaticamente de alta qualidade.
TitanML
A TitanML concentra-se em inferência eficiente de LLM. Seu Titan Takeoff Server ajuda as equipes a executar LLMs on-premise com desempenho otimizado, requisitos reduzidos de GPU e latência aprimorada. Ele também fornece recursos de quantização e compactação.
Tecnologias de suporte a LLMOps
LLMs
Alguns provedores de LLM, como OpenAI, Anthropic e Google, oferecem recursos parciais do ciclo de vida de LLM (por exemplo, fine-tuning em modelos selecionados, painéis de monitoramento e ferramentas de avaliação).
Observação: Os provedores de LLM oferecem ferramentas para fine-tuning e integração, mas não são plataformas LLMOps completas. O LLMOps geralmente requer componentes adicionais, como monitoramento, governança, linhagem, sistemas de avaliação e gerenciamento de pipelines.
Frameworks de integração
Essas ferramentas são criadas para facilitar o desenvolvimento de aplicações de LLM, como analisadores de documentos e código, chatbots, etc.
Bancos de dados vetoriais
Os VDs armazenam embeddings vetoriais de alta dimensão gerados a partir de texto, imagens ou outros dados. Eles não armazenam registros brutos e confidenciais, como resultados de exames médicos; em vez disso, indexam os embeddings para permitir busca e recuperação semânticas.
Ferramentas de fine-tuning
As ferramentas de fine-tuning variam de bibliotecas de baixo nível a plataformas no-code, dependendo do nível de controle e da expertise técnica necessária.
Bibliotecas e frameworks
Os frameworks Hugging Face Transformers e baseados em PEFT/LoRA são as opções mais amplamente utilizadas para fine-tuning. Para cargas de trabalho em larga escala, mecanismos de treinamento como DeepSpeed e Megatron-LM lidam com o treinamento distribuído de forma eficiente.
Plataformas no-code
Unsloth Studio e Hugging Face AutoTrain fornecem interfaces da web para fine-tuning de LLMs sem escrever código.
Unsloth Studio é de código aberto e suporta métodos LoRA e QLoRA com integração direta com Hugging Face. O Hugging Face AutoTrain permite que os usuários façam fine-tuning de modelos enviando dados diretamente pelo ecossistema Hugging Face.
Ferramentas de RLHF
RLHF, abreviação de reinforcement learning from human feedback (aprendizado por reforço com feedback humano), permite que os sistemas de IA refinem suas decisões incorporando orientação humana.
No aprendizado por reforço, um agente melhora seu comportamento por tentativa e erro, guiado pelo feedback do ambiente na forma de recompensas ou punições.
Em contraste, o RLHF ajuda a melhorar o comportamento do modelo ao integrar dados de preferência humana no loop de treinamento. Ele não substitui a rotulagem em larga escala, mas depende de dados de comparação gerados por humanos. O RLHF apoia alinhamento, segurança, melhoria de qualidade e melhor aderência à intenção do usuário.
Ferramentas de teste de LLM
As ferramentas de teste de LLM avaliam os LLMs verificando o desempenho do modelo, as capacidades e os possíveis vieses em tarefas relacionadas à linguagem, como compreensão e geração de linguagem natural. As ferramentas de teste podem incluir:
- Frameworks de teste
- Datasets de benchmark
- Métricas de avaliação.
Por exemplo, o Promptfoo é uma CLI e biblioteca de código aberto que pontua automaticamente os resultados usando métricas personalizadas, executa comparações lado a lado entre vários modelos e provedores e realiza red-teaming automatizado para identificar vulnerabilidades. Ele se integra a pipelines de CI/CD e é executado completamente localmente.
Monitoramento e observabilidade de LLM
As ferramentas de monitoramento e observabilidade de LLM garantem o funcionamento adequado, a segurança do usuário e a proteção da marca. Diferentemente do ML tradicional, os resultados de LLM são inerentemente não determinísticos, o que significa que a mesma entrada pode gerar resultados diferentes, o que exige rastrear todo o contexto para detectar alucinações.5 Na prática, as melhorias vêm de atualizações iterativas de prompts e contexto, em vez de retreinamento.
O monitoramento de LLM inclui atividades como:
- Monitoramento funcional: Acompanhar fatores como tempo de resposta, uso de tokens, número de solicitações, custos e taxas de erro.
- Monitoramento de prompts: Verificar as entradas e prompts dos usuários para avaliar conteúdo tóxico nas respostas, medir distâncias de embeddings e identificar injeções maliciosas de prompts.
- Monitoramento de respostas: Analisar para descobrir comportamento alucinatório, divergência de tópico, tom e sentimento nas respostas.
OpenLLMetry é um exemplo de biblioteca de observabilidade de código aberto para aplicações de LLM criadas no OpenTelemetry. Ela rastreia chamadas de LLM em tempo de execução entre fluxos de trabalho, tarefas, agentes e invocações de ferramentas, capturando prompts e respostas de API. Os rastreamentos podem ser exportados para a plataforma Traceloop ou qualquer stack de observabilidade compatível com OpenTelemetry existente.6
Benchmark de plataformas gerenciadas vs configuração somente CPU
Fizemos o benchmark do TrueFoundry e do Amazon SageMaker em relação a uma configuração somente CPU para medir o impacto no desempenho das plataformas gerenciadas no tempo de treinamento e avaliação.
Ambas as plataformas reduziram o treinamento de 2.572 segundos para menos de 570, e a avaliação de 174 segundos para cerca de 40. Embora o SageMaker tenha sido ligeiramente mais rápido durante o treinamento e o TrueFoundry tenha sido ligeiramente mais rápido durante a avaliação, a diferença geral foi insignificante; ambos proporcionaram grandes melhorias em relação à configuração manual.
Veja nossa metodologia de benchmark.
Para casos de uso de LLMOps, como testes iterativos de prompts, atualizações frequentes de modelos e monitoramento em produção, a sobrecarga de uma configuração somente CPU se acumula rapidamente; as plataformas gerenciadas reduzem esse atrito ao lidar com a infraestrutura automaticamente.
Observabilidade de fluxo de trabalho agêntico no LLMOps
As aplicações de LLM não estão mais limitadas a ciclos simples de prompt-resposta. Em fluxos de trabalho agênticos, um LLM pode invocar várias ferramentas, tomar decisões autônomas e concluir tarefas em várias etapas de forma independente. Isso cria novos desafios de observabilidade para as equipes de LLMOps:
Principais desafios:
- Rastreamento de chamadas de ferramentas: Monitorar parâmetros de entrada/saída, duração e status de sucesso de cada invocação de ferramenta
- Registro de pontos de decisão: Registrar por que o agente escolheu uma ferramenta específica em cada ponto de decisão
- Detecção de loop: Identificar e encerrar automaticamente agentes presos em loops infinitos
- Atribuição de custos em várias etapas: Entender qual etapa consumiu quantos tokens em um fluxo de trabalho de 10 etapas
As plataformas LLMOps enfrentam esses desafios fornecendo rastreamento de ponta a ponta que captura cada invocação de ferramenta, visualiza árvores de decisão de agentes e sinaliza automaticamente anomalias como loops infinitos ou picos inesperados de latência.
Essas plataformas também permitem detalhamentos granulares de custos por etapa, ajudando as organizações a otimizar tanto o desempenho quanto os gastos em pipelines agênticos complexos.
Guardrails e camadas de segurança para observabilidade de LLM
As implantações de LLM em produção exigem camadas de segurança que filtram, monitoram e bloqueiam entradas e saídas prejudiciais em tempo real. Do ponto de vista de LLMOps, a observabilidade desses sistemas de guardrail é fundamental para manter a segurança e a conformidade:
Camadas de segurança essenciais:
- Guardrails de entrada: Detectar tentativas de injeção de prompt, técnicas de jailbreak e conteúdo malicioso antes do processamento
- Guardrails de saída: Pontuação para alucinações, mascaramento de PII (informações de identificação pessoal) e filtragem de respostas tóxicas
- Aplicação de políticas: Bloquear respostas que violem as políticas da empresa ou requisitos regulatórios
O monitoramento eficaz de guardrails exige rastrear solicitações bloqueadas e suas causas, medir taxas de falsos positivos para proteger a experiência do usuário, identificar regras acionadas com frequência e analisar tendências de segurança baseadas no tempo para detectar ameaças emergentes.
Ferramentas de guardrails para LLMOps:
- Guardrails AI: Validação de saída baseada em Pydantic com aplicação de saída estruturada e conformidade de schema
- Lakera Guard: Proteção contra injeção de prompt em tempo real com detecção e classificação de ameaças
- Rebuff: Sistema de defesa auto-reforçado que aprende com tentativas de injeção de prompt
- Protect AI: Varredura de segurança de modelos de ML com detecção de vulnerabilidades em todo o pipeline de implantação
- Invariant Guardrails: Sistema de aplicação em tempo de execução para agentes de LLM que intercepta as saídas do agente e as chamadas de ferramentas, bloqueando a exposição de segredos de API, filtrando conteúdo confidencial e aplicando políticas de chamada de ferramentas enquanto o agente executa.7
O que é LLMOps?
LLMOps significa Large Language Model Operations (Operações de Modelos de Linguagem de Grande Porte). Refere-se às práticas, ferramentas e infraestrutura usadas para gerenciar o ciclo de vida dos LLMs, como fine-tuning, implantação, monitoramento, avaliação, governança e melhoria contínua do modelo.
O LLMOps não automatiza todo o pipeline de IA, mas concentra-se especificamente na operacionalização de sistemas baseados em LLM.
Componentes-chave do LLMOps:
- Seleção de um modelo de fundação: Um ponto de partida dita refinamentos e fine-tuning subsequentes para fazer os modelos de fundação atenderem a domínios de aplicação específicos.
- Gerenciamento de dados: Gerenciar volumes extensos de dados torna-se essencial para a operação precisa de modelos de linguagem.
- Implantação e monitoramento de modelos: Garantir a implantação eficiente de modelos de linguagem e seu monitoramento contínuo assegura desempenho consistente.
- Engenharia de prompt: Criar templates de prompt eficazes para melhorar o desempenho do modelo.
- Monitoramento de modelos: Acompanhamento contínuo dos resultados do modelo, detecção de degradação de precisão e tratamento de drift de modelo.
- Avaliação e benchmarking: A avaliação rigorosa de modelos refinados em relação a benchmarks padronizados ajuda a medir a eficácia dos modelos de linguagem.
- Fine-tuning de modelos: Fazer fine-tuning de LLMs para tarefas específicas e refinar modelos para desempenho ideal.
Como o LLMOps é diferente do MLOps?
O LLMOps é especializado e centrado na utilização de modelos de linguagem de grande porte. Ao mesmo tempo, o MLOps tem um escopo mais amplo, abrangendo vários modelos e técnicas de machine learning.
Nesse sentido, o LLMOps é conhecido como MLOps para LLMs. Portanto, esses dois divergem em seu foco específico em modelos de fundação e metodologias:
O LLMOps concentra-se em sistemas orientados por prompts e não determinísticos, em vez de pipelines estáticos de treinamento e implantação. Diferentemente do ML convencional, onde as melhorias vêm do retreinamento, a otimização do LLMOps ocorre refinando prompts ou dados de recuperação e ajustando sistemas externos.
As principais preocupações operacionais incluem:
- Detecção e avaliação de alucinações
- Versionamento e gerenciamento de prompts
- Rastreamento de pipelines de recuperação
- Monitoramento de custo de tokens por consulta
Aprendizado por transferência
Diferentemente dos modelos de ML convencionais criados do zero, os LLMs geralmente começam com um modelo base, que é ajustado com dados novos para otimizar o desempenho em domínios específicos. Esse fine-tuning facilita resultados de última geração para aplicações específicas, utilizando menos dados e recursos computacionais.
Feedback humano
Os avanços no treinamento de modelos de linguagem de grande porte são atribuídos ao aprendizado por reforço com feedback humano (RLHF). Dada a natureza aberta das tarefas de LLM, a contribuição humana dos usuários finais tem valor considerável para avaliar o desempenho do modelo. Integrar esse loop de feedback aos pipelines de LLMOps simplifica a avaliação e coleta dados para o refinamento futuro do modelo.
Ajuste de hiperparâmetros
Embora o ML convencional se concentre principalmente no ajuste de hiperparâmetros para aumentar a precisão, os LLMs introduzem uma dimensão adicional ao reduzir os custos de treinamento e inferência. Ajustar parâmetros como tamanhos de lote e taxas de aprendizado pode influenciar substancialmente a velocidade e o custo do treinamento. Consequentemente, o rastreamento meticuloso do processo de ajuste e a otimização permanecem pertinentes tanto para modelos de ML clássicos quanto para LLMs, ainda que com focos variados.
Métricas de desempenho
Os modelos de ML tradicionais dependem de métricas bem definidas, como precisão, AUC e pontuação F1, que são relativamente simples de calcular. Em contraste, avaliar LLMs envolve uma série de métricas e sistemas de pontuação padrão distintos, como bilingual evaluation understudy (BLEU) e Recall-Oriented Understudy for Gisting Evaluation (ROUGE) que exigem atenção especializada durante a implementação.
Engenharia de prompt
Modelos que seguem instruções podem lidar com prompts ou conjuntos de instruções complexos. Criar esses templates de prompt é fundamental para obter respostas precisas e confiáveis dos LLMs. Uma engenharia de prompt eficaz mitiga os riscos de alucinação do modelo, manipulação de prompts, vazamento de dados e vulnerabilidades de segurança.
Construção de pipelines de LLM
Os pipelines de LLM encadeiam várias invocações de LLM e podem interagir com sistemas externos, como bancos de dados vetoriais ou buscas na web. Esses pipelines capacitam os LLMs a enfrentar tarefas complexas, como perguntas e respostas em bases de conhecimento ou responder a consultas de usuários com base em um conjunto de documentos. No desenvolvimento de aplicações de LLM, a ênfase geralmente muda para a construção e otimização desses pipelines, em vez de criar novos LLMs.
Além disso, modelos multimodais de grande porte estendem essas capacidades incorporando diversos tipos de dados, como imagens e texto, aumentando a flexibilidade e a utilidade dos pipelines de LLM.
Aqui está uma visão geral categorizada das principais ferramentas no cenário de LLMOps e MLOps:
 Adicionar como fonte preferencial
LLMOps ou MLOps: Qual se encaixa no seu projeto?
Os dois não são mutuamente exclusivos. Muitos sistemas de produção combinam ambos, e a escolha certa depende do que você está construindo.
O LLMOps é a melhor opção quando sua aplicação é construída sobre um modelo pré-treinado da OpenAI, Anthropic, Google ou alternativas de código aberto, como Llama, e seu trabalho se concentra em engenharia de prompt, pipelines de RAG ou orquestração de agentes. Também é mais relevante quando você precisa monitorar custos de tokens, alucinações e qualidade das respostas em produção.
O MLOps é mais apropriado quando você está treinando ou fazendo fine-tuning de modelos personalizados em dados específicos de domínio, ou quando sua aplicação exige resultados determinísticos e auditáveis, como detecção de fraudes ou classificação médica.
Se você está fazendo fine-tuning de um modelo de fundação e implantando-o em produção, ambos se aplicam: o MLOps cuida do pipeline de treinamento e o LLMOps cuida da inferência e do monitoramento.
Metodologia de benchmark de plataformas gerenciadas vs configuração somente CPU
Fizemos o benchmark dos tempos de treinamento e avaliação de um modelo de classificação de sentimento baseado em DistilBERT em três ambientes: uma configuração manual (somente CPU), TrueFoundry e Amazon SageMaker. Para garantir a consistência, usamos o mesmo codebase, o mesmo modelo pré-treinado (distilbert-base-uncased) e as primeiras 5.000 amostras do dataset Amazon Reviews em todas as execuções.
O dataset foi filtrado para incluir avaliações de 1 a 5, re-rotulado em cinco classes (0–4) e dividido em conjuntos estratificados de treinamento e validação 80/20. A tokenização foi realizada com um comprimento máximo de sequência fixo de 128.
O modelo foi treinado por uma época usando tamanhos de lote idênticos (16 para treinamento, 32 para avaliação). Tanto o TrueFoundry quanto o SageMaker usaram o mesmo tipo de instância de GPU, enquanto a configuração manual foi intencionalmente executada em CPU para refletir um ambiente local típico ou não especializado.
Esta configuração destaca não apenas as otimizações em nível de plataforma oferecidas pelas ferramentas LLMOps modernas, mas também os ganhos substanciais de desempenho do acesso contínuo a GPU. O benchmark ilustra como o uso de plataformas gerenciadas como TrueFoundry e SageMaker pode reduzir o tempo de treinamento e avaliação em comparação com a execução do mesmo código manualmente em uma CPU, especialmente em cenários reais com recursos limitados.
Perguntas frequentes
O LLMOps oferece vantagens significativas para projetos de machine learning que utilizam modelos de linguagem de grande porte:
1. Maior precisão: Garantir dados de alta qualidade para treinamento e implantação confiável aumenta a precisão do modelo.
2. Latência reduzida: Estratégias de implantação eficientes levam a uma latência reduzida nos LLMs, permitindo uma recuperação de dados mais rápida.
Observação: O impacto na precisão ou latência depende do tamanho do modelo, da infraestrutura e das ferramentas; o LLMOps melhora a gerenciabilidade e a confiabilidade dos LLMs, em vez de melhorar o desempenho inerente do modelo.
3. Promoção de justiça: Promover justiça em IA significa reduzir ativamente vieses de IA nos algoritmos para defender a equidade e prevenir violações de ética em IA.
Os desafios nas operações de modelos de linguagem de grande porte exigem soluções robustas para manter o desempenho ideal:
1.) Desafios de gerenciamento de dados: Lidar com vastos datasets e dados confidenciais exige coleta e versionamento eficientes de dados.
2.) Implantação escalável: Implantar infraestrutura escalável e utilizar tecnologias nativas da nuvem para atender aos requisitos de poder computacional.
3.) Otimização de modelos: Empregar técnicas de compactação de modelos e refinar modelos para aumentar a eficiência geral.
As ferramentas LLMOps são fundamentais para superar desafios e fornecer modelos de maior qualidade no cenário dinâmico dos modelos de linguagem de grande porte.
Em aplicações práticas, o LLMOps está moldando vários setores:
Geração de conteúdo: Aproveitar modelos de linguagem para automatizar a criação de conteúdo, incluindo sumarização, análise de sentimento e muito mais.
Suporte ao cliente: Aprimorar chatbots e assistentes virtuais com a proeza dos modelos de linguagem.
Análise de dados: Extrair insights de dados textuais, enriquecendo os processos de tomada de decisão.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{Principais ferramentas LLMOps e compare-as ao MLOps}},
  year   = {2026},
  month  = may,
  howpublished    = {\url{https://aimultiple.com/llmops-tools}},
  note   = {AIMultiple. Acessado em 18 maio 2026}
}Resultados e carimbos de data/hora de 78 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 5 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
15 atualizaçõesAdicionados MLflow, Promptfoo, OpenLLMetry e Invariant Guardrails às seções de ferramentas LLMOps.
Adicionada uma seção sobre observabilidade do fluxo de trabalho agêntico em LLMOps.
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

A seguir, leia
Melhores Ferramentas de Gerenciamento de Vulnerabilidades


Principais Ferramentas de IA Emocional Testadas

Principais ferramentas de reconhecimento de imagem comparadas

Os 25 Melhores Ferramentas de Controle de Versão
Compare as 20 melhores ferramentas de orquestração de contêineres

Top 6 Ferramentas de Varredura de Vulnerabilidades

Comentários 1
Compartilhe suas ideias
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.
This is a fantastic MLops overview and full of insight and immediate application to DevOps , Ai development at scale and how to implement design tools . Many thanks to Mr . Cem Dilmegani for his work .