


Ferramentas de Detecção de Alucinação de IA: W&B Weave e Comet

Avaliamos três ferramentas de detecção de alucinação: W&B Weave HallucinationFree Scorer (parte do CoreWeave Forge, anteriormente Weights & Biases), Arize Phoenix HallucinationEvaluator e Comet Opik Hallucination Metric, em 100 casos de teste.
Cada ferramenta foi avaliada quanto a acurácia, precisão, recall e latência.
Benchmark de ferramentas de detecção de alucinação de IA
Testamos 100 respostas (50 corretas, 50 alucinadas) de cenários factuais de perguntas e respostas em relação ao contexto de origem.
Comparação de acurácia e latência
Consulte a seção metodologia de benchmark. para mais detalhes sobre o processo de teste.
W&B Weave e Arize Phoenix apresentaram acurácia quase idêntica, de 91% e 90%, respectivamente. Ambas as ferramentas demonstraram desempenho confiável em todo o dataset. O Comet Opik ficou atrás, com acurácia de 72%, classificando corretamente apenas 72 de 100 testes, uma diferença significativa motivada por sua abordagem conservadora.
Em termos de velocidade, o Arize Phoenix foi o vencedor, com 2 segundos por teste, o que o torna adequado para aplicações em tempo real. O W&B Weave processou os testes em 4 segundos, o que é razoável para a maioria dos casos de uso em produção. O Comet Opik foi notavelmente mais lento, com 8,5 segundos por teste, o que pode afetar a experiência do usuário em aplicações sensíveis à latência.
F1 score, precisão e recall
As pontuações F1 (média harmônica de precisão e recall) confirmaram esses padrões: W&B Weave com 90,5% e Phoenix com 89,4% alcançaram desempenho forte e equilibrado. Em comparação, os 61,1% do Opik refletiram o equilíbrio entre precisão perfeita e recall fraco. Os zero falsos positivos do Opik vieram ao custo de 28 falsos negativos, tornando-o adequado apenas para cenários em que alarmes falsos custam mais do que detecções perdidas.
O recall (capacidade de detectar alucinações reais) revelou estratégias distintas. O W&B Weave liderou com recall de 86%, detectando 43 de 50 alucinações e perdendo apenas 7. O Phoenix ficou logo atrás, com 84%, detectando 42 alucinações e perdendo 8. O recall do Comet Opik foi substancialmente menor, de 44%, detectando apenas 22 alucinações e perdendo 28; mais da metade de todas as alucinações reais passou despercebida.
A precisão (confiabilidade dos alertas) apresentou variação significativa. O Comet Opik alcançou precisão perfeita de 100% com zero falsos positivos; quando sinalizou algo como alucinação, estava sempre correto. Tanto Phoenix (95,5%) quanto Weave (95,6%) apresentaram precisão quase idêntica, cada um produzindo apenas 2 falsos positivos entre 50 respostas legítimas, demonstrando forte confiabilidade sem ser excessivamente conservador.
Fatores que podem influenciar as diferenças de desempenho
As diferenças de desempenho observadas são possivelmente motivadas pela filosofia de design, pela seleção de limiares e pela interpretação de grounding.
Diferenças na estratégia de detecção e nos objetivos de otimização
- As ferramentas parecem ser otimizadas para diferentes compensações de erro, em vez do mesmo objetivo.
- O W&B Weave e o Arize Phoenix visam um desempenho equilibrado, mantendo alta precisão e ainda capturando a maioria das alucinações.
- O Comet Opik adota uma estratégia altamente conservadora, priorizando zero falsos positivos mesmo que muitas alucinações passem despercebidas.
- Essa escolha estratégica explica diretamente a precisão perfeita e o recall substancialmente menor do Opik.
Compensações entre precisão e recall incorporadas no design das ferramentas
- Os zero falsos positivos do Comet Opik indicam um limiar de decisão rigoroso, sinalizando alucinações apenas quando a confiança é muito alta.
- O W&B Weave e o Phoenix usam limiares menos restritivos, permitindo alguns falsos positivos em troca de um recall muito maior.
- Essas diferenças de limiar podem levar a:
- Precisão semelhante entre Weave e Phoenix
- Grandes lacunas de recall entre o Opik e as outras duas ferramentas
- Diferenças correspondentes no F1 score e na acurácia geral
Variações na implementação de LLM-as-a-judge
- Embora as três ferramentas usem uma abordagem de LLM-as-a-judge, suas implementações são diferentes.
- O W&B Weave enfatiza o raciocínio em cadeia de pensamento, o que pode melhorar a sensibilidade a alegações sutis não suportadas.
- O Arize Phoenix incorpora saídas baseadas em rótulos com pontuações de confiança, permitindo julgamentos mais sutis.
- O Comet Opik foca em decisões binárias de alta confiança, o que reduz alarmes falsos, mas limita a sensibilidade a alucinações limítrofes.
Diferenças de latência motivadas pela profundidade da avaliação
- A menor latência do Arize Phoenix sugere uma pipeline de avaliação mais leve ou mais otimizada, adequada para uso em tempo real.
- A latência moderada do W&B Weave é consistente com raciocínio mais rico e registro de rastreamento.
- A latência mais alta do Comet Opik provavelmente reflete raciocínio interno ou etapas de verificação mais extensas, reforçando seu design conservador.
Ferramentas de detecção de alucinação de IA
HallucinationFree Scorer do W&B Weave
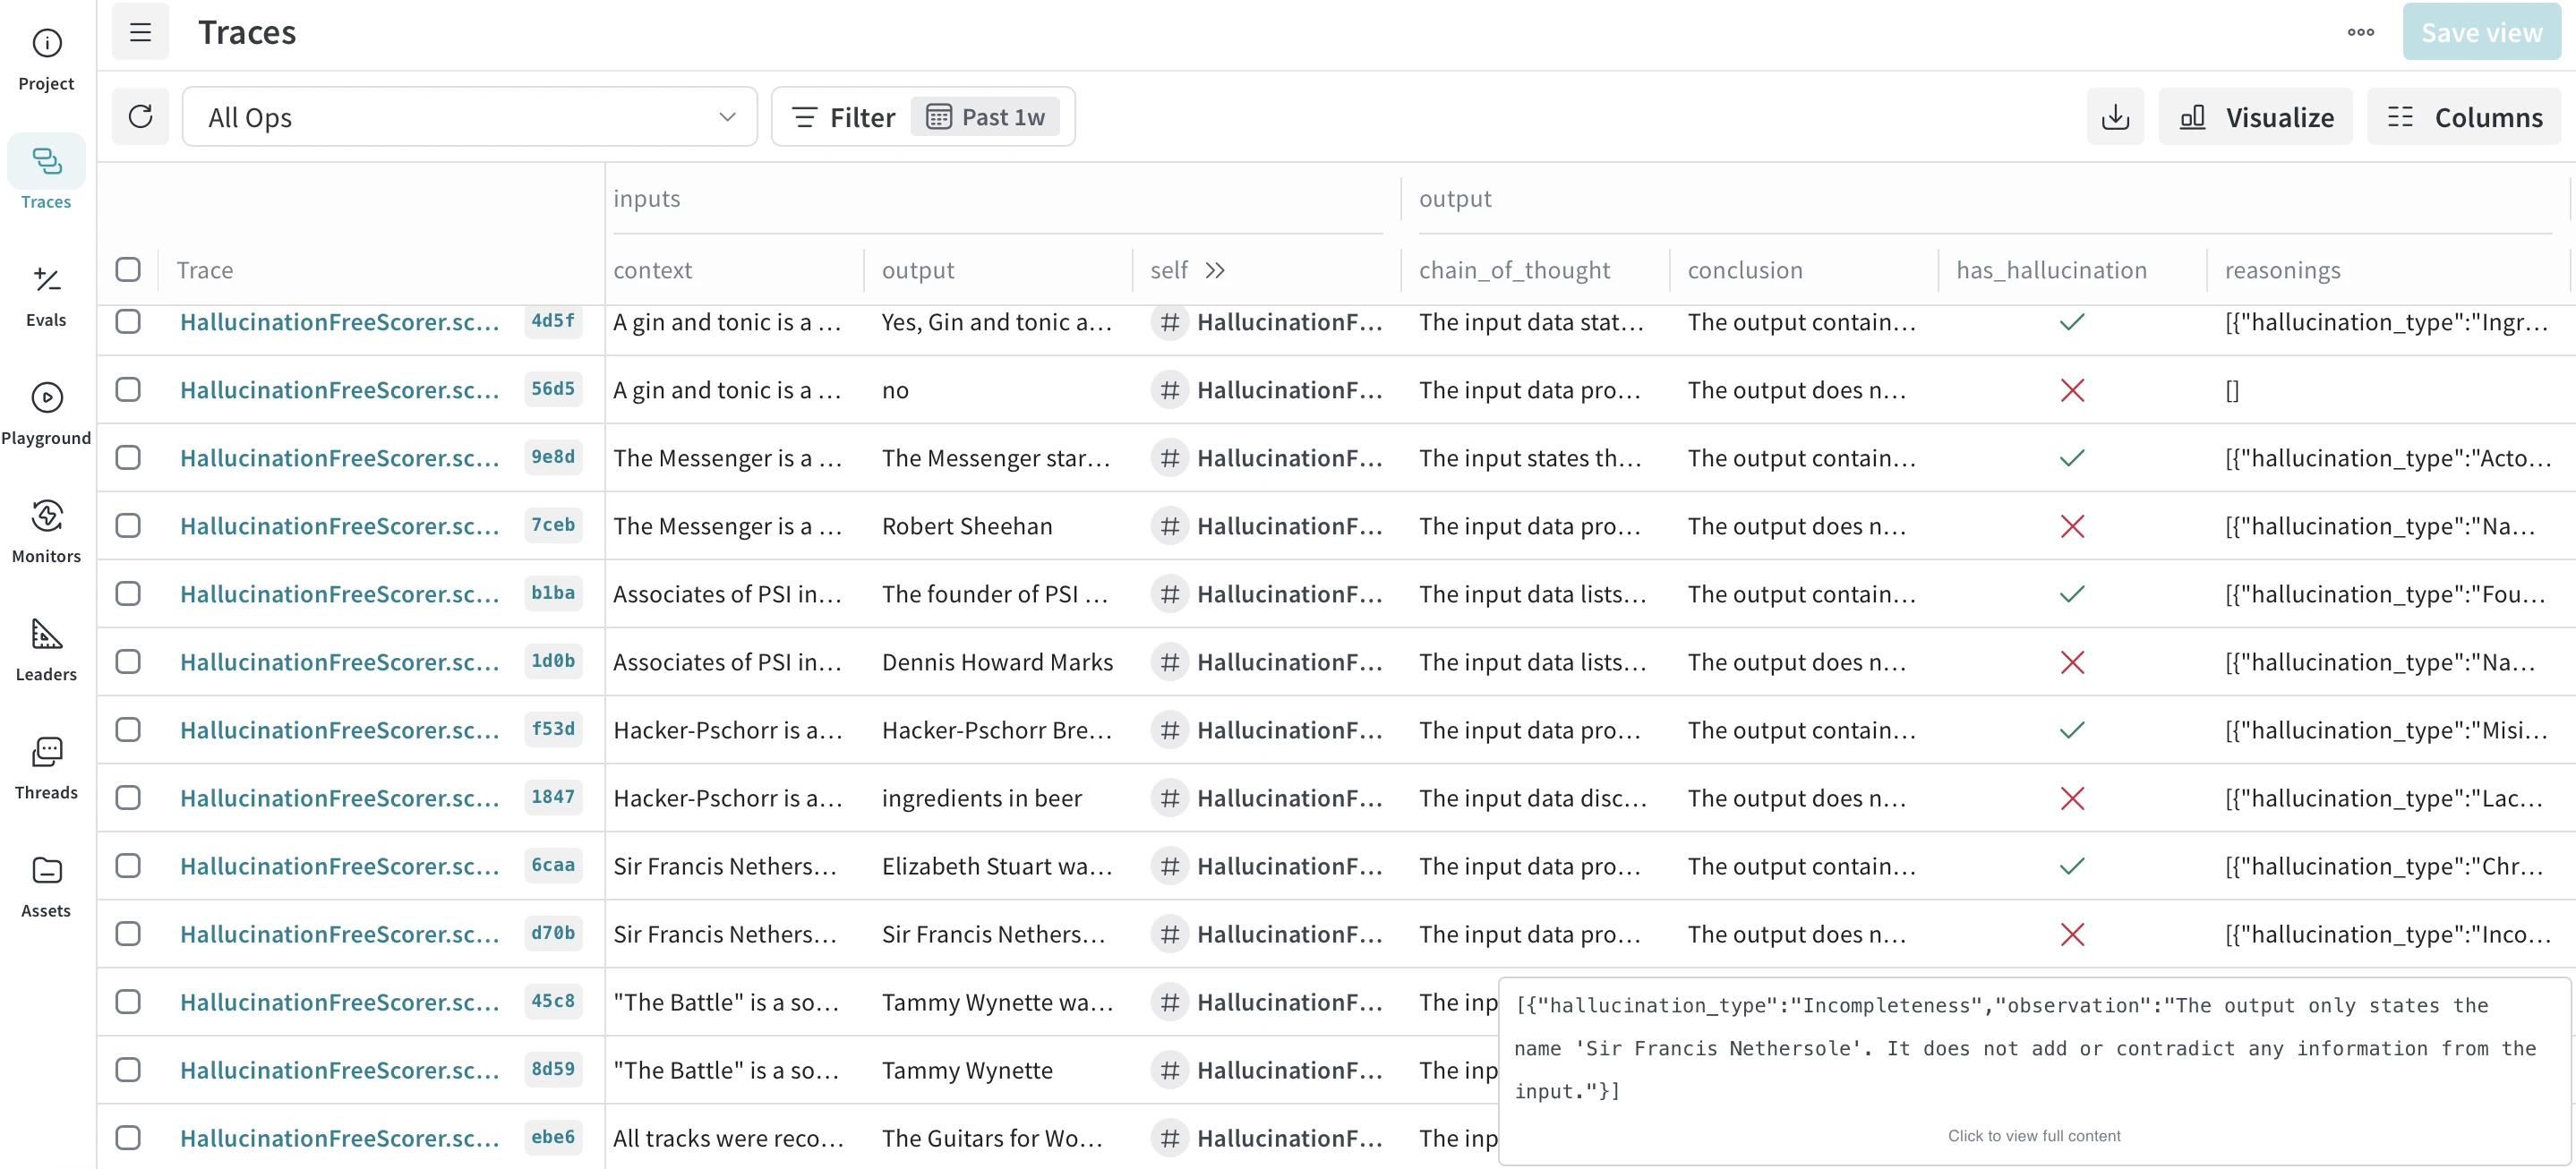
Figura 1: Painel de traces do W&B Weave.
CoreWeave Forge inclui um HallucinationFree Scorer que sinaliza saídas de LLM que introduzem alegações não encontradas no contexto de origem. Ele executa um juiz LLM em cada resposta e retorna um veredito grounded/ungrounded junto com o raciocínio por trás dele.
O scorer recebe duas entradas: o contexto (material de origem) e a saída (resposta gerada por LLM). Em seguida, usa um model de linguagem para analisar se a saída introduz informações não presentes no contexto. O resultado inclui um sinalizador booleano has_hallucination e um raciocínio explicando a decisão.
Principais recursos:
- Raciocínio chain-of-thought: Cada avaliação inclui uma explicação do motivo pelo qual a saída foi sinalizada como alucinação ou não.
- Classificação binária: Retorna decisões claras de verdadeiro/falso com evidências de apoio.
- Integração com o rastreamento do Weave: Os resultados são registrados automaticamente no painel do Weave para visualização.
- Model personalizável: Suporta diferentes juízes LLM, incluindo OpenAI, Anthropic e outros provedores.
HallucinationEvaluator do Arize Phoenix
O Arize Phoenix inclui um HallucinationEvaluator que sinaliza respostas que se afastam do material de referência. Para cada saída, um juiz LLM decide se a resposta está fundamentada no contexto fornecido e anexa uma pontuação de confiança ao seu veredito.
O avaliador recebe três entradas: a consulta do usuário (input), o texto de referência (contexto) e a resposta do model (saída). Ele analisa se a resposta contém informações que não podem ser derivadas do contexto, retornando um resultado rotulado (“factual” ou “hallucinated”) junto com uma explicação e uma pontuação de confiança.
Principais recursos:
- Desempenho equilibrado: Fornece resultados tanto em métricas de precisão quanto de recall
- Saída baseada em rótulos: Retorna rótulos categóricos (“factual” ou “hallucinated”) em vez de apenas pontuações numéricas
- Explicações detalhadas: Fornece raciocínio para cada decisão de avaliação
Hallucination Metric do Comet Opik
A Hallucination Metric do Comet Opik pontua cada resposta de LLM em relação ao seu contexto de origem e retorna um julgamento binário sobre se a saída é fiel a esse contexto. A verificação é executada por meio de um juiz LLM ajustado para sinalizar apenas casos de alta confiança de alegações não suportadas.
A métrica aceita três entradas: a consulta do usuário (input), o material de origem (contexto) e a resposta do model (saída). Ela avalia se a saída introduz alegações não suportadas pelo contexto.
O resultado inclui uma pontuação binária (0 para nenhuma alucinação, 1 para alucinação detectada) e um raciocínio detalhado explicando a avaliação.
Principais recursos:
- Explicações detalhadas: Cada avaliação fornece raciocínio abrangente sobre por que o conteúdo foi sinalizado ou aprovado
- Análise com três entradas: Considera a consulta, o contexto e a resposta juntos para a avaliação
- Rastreamento de experimentos: Os resultados são registrados automaticamente no sistema de rastreamento de experimentos do Opik
- Abordagem conservadora: Projetada para minimizar falsos positivos sinalizando apenas alucinações de alta confiança
Galileo Luna-2
O Galileo Luna-2 é uma camada de detecção de alucinação e guardrail em tempo de execução integrada à plataforma mais ampla de observabilidade de IA da Galileo. 1
O sistema foi projetado para ser executado inline nos caminhos de inference em produção, bloqueando conteúdo não fundamentado antes que chegue ao usuário, enquanto o Signals, a camada automatizada de análise de falhas da Galileo, revela as causas raiz dos erros de produção sem revisão manual de logs.
Principais recursos:
Detecção multimétodo: Combina similaridade de embedding, análise Chain-of-Thought e pontuação de factualidade G-Eval, em vez de depender de uma única estratégia de julgamento.
Guardrails em tempo de execução: O Luna-2 pode bloquear ou reescrever saídas não fundamentadas inline no caminho de inference, não apenas sinalizá-las depois do ocorrido.
Observabilidade ponta a ponta: Captura entradas, saídas e traces de raciocínio interno em fluxos de trabalho de agentes de várias etapas, com o Signals automatizando a análise de causa raiz.
DeepEval
O DeepEval é um framework de avaliação de LLM de código aberto da Confident IA, projetado para parecer com o Pytest, mas para aplicações de LLM. Sua HallucinationMetric usa um LLM-as-a-judge para decidir se a saída do model é factualmente consistente com o contexto fornecido, e o framework foi criado para ser executado dentro de qualquer pipeline de CI/CD.23
A métrica recebe três entradas obrigatórias: a consulta do usuário (input), a resposta do model (actual_output) e o material de referência (context). Ela pontua cada saída usando a fórmula Hallucination = (Número de Contextos Contraditórios) / (Número Total de Contextos), em que pontuações mais baixas indicam melhor grounding. Uma saída passa quando sua pontuação é igual ou inferior ao limiar configurado.
Principais recursos:
- Fluxo de trabalho de teste familiar: As verificações de alucinação são escritas e executadas como testes unitários comuns, para que equipes que já usam Pytest não precisem aprender uma nova ferramenta.
- Rigor ajustável: As equipes podem flexibilizar ou endurecer o limiar de aprovação ou alternar para um modo estrito de aprovação/reprovação para conteúdo de alto risco.
- Explicações para cada resultado: Cada veredito vem com um motivo, para que fique claro por que uma saída foi sinalizada.
O que é alucinação de IA?
Alucinações de IA são saídas que parecem coerentes, mas não são factuais. O model produz essas alegações com confiança mesmo quando o contexto de origem ou os dados de treinamento não as suportam. Uma pesquisa sobre o tema atribui isso ao fato de os models se apoiarem em priores linguísticos em vez de evidências verificáveis do contexto fornecido.4 O problema aparece em domínios de alto risco, como saúde, serviços jurídicos, busca empresarial e suporte ao cliente, razão pela qual a detecção de saídas fundamentadas se tornou uma parte padrão da implantação de LLM.
Fontes e taxonomia das alucinações
As alucinações decorrem de duas grandes fontes. Fatores internos do model incluem dependência excessiva de padrões estatísticos, lacunas nos dados de treinamento e a natureza probabilística da geração de sequências; uma análise sobre detecção e mitigação de alucinações observa que os LLMs frequentemente inferem continuações prováveis em vez de recuperar evidências verificáveis, o que produz saídas confiantes, mas incorretas.5
Fatores contextuais abrangem falhas de recuperação em RAG sistemas, prompts ambíguos, grounding incompleto e, em models multimodais, confusões de objetos ou detalhes de cena inventados.
Detecção de alucinação em fluxos de trabalho agentic
Agentes de várias etapas introduzem riscos de alucinação que os LLMs de turno único não apresentam: uma alegação fabricada em uma etapa inicial se propaga para chamadas de ferramenta, recuperações e saídas finais posteriores.
Principais desafios na detecção de alucinação em fluxos agentic:
- Propagação de erros: Um fato fabricado na fase de planejamento pode influenciar a seleção de ferramentas, a recuperação de dados e as respostas finais
- Alucinações em chamadas de ferramenta: Os agentes podem invocar ferramentas com parâmetros incorretos ou interpretar incorretamente as saídas ferramentas
- Corrupção de estado: Informações alucinadas armazenadas na memória do agente afetam etapas futuras de raciocínio
- Complexidade de atribuição: Identificar qual etapa introduziu a alucinação exige rastreamento ponta a ponta
Abordagens de detecção para sistemas agentic:
- Verificação por etapa: Validar cada saída intermediária antes de o agente prosseguir para a próxima ação
- Validação da saída de ferramentas: Verificar de forma cruzada as respostas das ferramentas em relação aos formatos esperados e às restrições conhecidas
- Análise de trajetória: Revisar a sequência completa de decisões do agente para identificar onde o raciocínio divergiu de informações fundamentadas
- Verificações de consistência entre etapas: Comparar alegações feitas em diferentes estágios para detectar contradições
O HallucinationFree Scorer do W&B Weave e o HallucinationEvaluator do Arize Phoenix podem ser aplicados em cada etapa do agente, enquanto seus painéis integrados exibem o trace completo de execução para análise de causa raiz.
 Adicionar como fonte preferencial
Prevenção de alucinação em tempo real
A detecção pós-geração revela problemas, mas não impede que saídas ruins cheguem aos usuários. A prevenção em tempo real executa a verificação inline, antes de a resposta ser entregue.
Mecanismos de prevenção:
- Guardrails de saída: Filtros que analisam o conteúdo gerado em relação aos critérios de factualidade antes de devolvê-lo ao usuário.
- Limiares de confiança: Bloquear ou sinalizar respostas quando a confiança interna do model cai abaixo de níveis aceitáveis.
- Portões de validação de recuperação: Verificar se as alegações geradas são suportadas pelos documentos recuperados antes de finalizar a resposta.
- Estratégias de fallback: Retornar uma resposta padrão segura ou escalar para filas de revisão quando o risco de alucinação é alto.
Capacidades das ferramentas para prevenção em tempo real:
- W&B Weave integra a pontuação de alucinação em pipelines de produção, permitindo verificações automatizadas antes de as respostas serem entregues.
- Arize Phoenix oferece monitoramento em tempo real com recursos de alerta que sinalizam saídas de alto risco para revisão imediata.
- Comet Opik oferece rastreamento de experimentos com avaliação automatizada, permitindo que as equipes definam portões de qualidade que bloqueiam respostas que excedam os limiares de alucinação.
Abordagens para detecção de alucinação
Três abordagens são diretamente relevantes para a forma como Weave, Phoenix e Opik operam:
1. Métodos baseados em consistência
Os métodos baseados em consistência avaliam uma resposta comparando-a com várias gerações alternativas usando similaridade semântica, sobreposição de n-gramas ou verificação pergunta-resposta. Quando as respostas se contradizem ou contêm inconsistências lógicas, a probabilidade de alucinação aumenta. Uma técnica relacionada, a entropia semântica, agrupa respostas por significado e não por formulação e usa a instabilidade conceitual como sinal de alucinação.
2. Detecção baseada em probabilidade e confiança
Probabilidades em nível de token, valores de entropia, curvas de calibração e estimativas de confiança baseadas em margem revelam a crença interna do model sobre sua própria saída. Segmentos de baixa confiança geralmente se correlacionam com taxas mais altas de alucinação. A entropia bruta pode ser enganosa devido à formulação variável, mas os sinais de confiança continuam úteis quando combinados com indicadores baseados em consistência. O Arize Phoenix expõe uma pontuação de confiança junto com seu rótulo, o que se encaixa nessa categoria.
3. Detecção baseada em referência ou contexto
A avaliação baseada em referência compara a saída do model com o contexto fornecido ou fontes externas e é o mecanismo central de RAG verificações de qualidade. As técnicas típicas incluem models de entailment que verificam se os documentos recuperados suportam a resposta, métodos de alinhamento e grounding que validam o suporte de evidências e métricas de factualidade que medem se as alegações correspondem ao texto de apoio. As três ferramentas avaliadas operam principalmente nesse modo: elas recebem um contexto e julgam se a saída permanece dentro dele.
Técnicas e algoritmos de detecção de alucinação de IA
Os métodos de detecção operam em três níveis de granularidade:
- Nível de token: Marca trechos suspeitos dentro de uma saída. Usa datasets de alucinação anotados por humanos, divergência entre probabilidades de token a priori e a posteriori dado o contexto ou classificadores de rotulação de sequência.
- Nível de sentença: Julga declarações inteiras. Verificações de autoconsistência baseadas em amostragem comparam múltiplas gerações em busca de instabilidade, a entropia semântica sinaliza incerteza conceitual sem rótulos e classificadores de entailment detectam alegações não suportadas ou contraditórias.
- Nível de workflow: Rastreia pipelines de várias etapas usando grafos de proveniência, verificações de entailment por etapa, validação de raciocínio intermediário e rastreamento de dependências para tarefas multi-hop.
As três ferramentas que avaliamos operam principalmente no nível de sentença, com Weave e Phoenix estendendo-se ao uso em nível de workflow por meio de seus painéis de rastreamento.
Padrões industriais e melhores práticas
Equipes de produção raramente dependem de um único método. Os padrões comuns incluem:
- Detecção em camadas: Verificações de consistência, pontuação de probabilidade e validação de entailment são executadas na mesma pipeline.
- Monitoramento em tempo real: Painéis monitoram drift e mudanças de confiança ao longo do tempo.
- Ajuste de prompts: Os prompts são refinados para reduzir a ambiguidade que leva a saídas não fundamentadas.
- Revisão especializada: Reservada para conteúdo jurídico, médico ou financeiro em que erros têm custo real.
- Integração com CI/CD: Verificações automáticas de qualidade são executadas antes da implantação para que regressões apareçam cedo.
- Monitoramento de agentes: Plugins observam chamadas de ferramenta e etapas intermediárias de raciocínio para detectar anomalias assim que surgem.
Metodologia de benchmark de ferramentas de detecção de alucinação de IA
O benchmark usou um dataset controlado de 50 itens de conhecimento extraídos de cenários factuais de perguntas e respostas. Cada item incluía um contexto de origem, uma pergunta, uma resposta correta fundamentada nesse contexto e uma resposta alucinada que continha informações fabricadas. Por exemplo, um teste perguntou sobre a localização da sede do The Oberoi Group, em que a resposta correta “Delhi” foi testada contra a resposta alucinada “Mumbai”.
Cada item de conhecimento gerou dois casos de teste: um usando a resposta correta (esperado: nenhuma alucinação) e outro usando a resposta alucinada (esperado: alucinação detectada). Isso criou uma divisão equilibrada de 50/50, totalizando 100 casos de teste. As três ferramentas processaram os mesmos casos de teste sequencialmente, cada uma recebendo entradas idênticas (contexto, pergunta e saída).
Medimos a latência de cada caso de teste individualmente para garantir uma comparação justa, evitando as armadilhas do processamento paralelo ou da avaliação em lote que poderiam distorcer os resultados. Os rótulos de ground truth foram verificados manualmente para garantir precisão no cálculo de verdadeiros positivos, falsos positivos, verdadeiros negativos e falsos negativos.
Cite este benchmark
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{ermut2026,
  author = {Ermut, Sıla and Şipi, Nazlı},
  title  = {{Ferramentas de Detecção de Alucinação de IA: W&B Weave e Comet}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-hallucination-detection}},
  note   = {AIMultiple. Acessado em 18 junho 2026}
}Resultados e carimbos de data/hora de 12 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 4 arquivos CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
3 atualizaçõesAdicionados Galileo Luna-2 e DeepEval como novas seções de ferramentas ao lado das ferramentas de detecção de alucinações avaliadas.
Adicionado "Hallucination detection in agentic workflows" à seção "What is AI hallucination?".
Links de referência
Ela trabalhou anteriormente como recrutadora em empresas de gerenciamento de projetos e consultoria. Sıla possui mestrado em Psicologia Social e bacharelado em Relações Internacionais.

A seguir, leia
Navegadores com IA: Guia de Seleção

Comparação dos 20 principais detectores de texto gerado por IA

Compare os 7 Principais Detectores de Imagens de IA

HALC-Bench: LLM Alucinação em Benchmark de Recuperação de Contexto Longo


Top 14 Ferramentas de Detecção e Prevenção de Intrusões (IDPS/IPS)
Top 20 Empresas de Tecnologia de Decepção

Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.