


Models de embedding de código abierto: 11 models evaluados para recuperación
We benchmarked 11 open-weight embedding models, 200 questions and 341,040 text passages across four corpora. Finance, legal contract, technical support and medical questions each searched their own domain's corpus.

nDCG@10 puntúa la posición de los pasajes relevantes registrados dentro de los primeros diez resultados de búsqueda. Una puntuación de 1 representa la clasificación ideal para los positivos registrados. Los pasajes más cercanos a la parte superior reciben más peso.
PPLX Embed v1 4B lideró la comparación con 0.741 nDCG@10, seguido de PPLX Embed v1 0.6B con 0.698. Multilingual E5 Large ocupó el tercer lugar con 0.628. La pequeña diferencia entre BGE Large y E5 Large queda oculta por el redondeo a tres decimales. Sus puntuaciones sin redondear determinan el orden.
Model | nDCG@10 | 95 % IC | Recall@10 |
|---|---|---|---|
PPLX Embed v1 4B | 0.741 | 0.700–0.782 | 90,46 % |
PPLX Embed v1 0.6B | 0.698 | 0.651–0.744 | 86,71 % |
Multilingual E5 Large | 0.628 | 0.578–0.680 | 79,38 % |
BGE Large EN v1.5 | 0.624 | 0.572–0.676 | 78,21 % |
E5 Large v2 | 0.624 | 0.572–0.675 | 78,88 % |
BGE-M3 (dense) | 0.614 | 0.562–0.666 | 79,50 % |
GTE Large | 0.612 | 0.563–0.660 | 77,71 % |
All-MPNet Base v2 | 0.608 | 0.556–0.661 | 77,33 % |
GTE Base | 0.596 | 0.547–0.645 | 76,21 % |
E5 Base v2 | 0.586 | 0.534–0.640 | 75,21 % |
Recall@10 es la fracción media de pasajes relevantes registrados de cada pregunta que se encuentran en los primeros diez resultados. Mide la cobertura de pasajes y no evalúa si una respuesta generada es correcta.
Los 95 % intervalos de confianza (IC) estiman la incertidumbre en el nDCG@10 promedio derivada del muestreo de preguntas. Unos intervalos más amplios indican estimaciones menos precisas.
Las preguntas se seleccionaron para desafiar a BM25, que obtuvo una puntuación de cero en este conjunto. Informamos de esa línea base junto con el procedimiento de selección. El rendimiento en el tráfico de búsqueda ordinario sigue sin probarse. La inference se realizó a través de endpoints alojados.
Hallazgos de recuperación dentro de los models de pesos abiertos
PPLX Embed v1 4B registró el nDCG@10 más alto con 0.741
PPLX Embed v1 0.6B le siguió con 0.698. El 4B model obtuvo puntuaciones significativamente superiores a las de nueve de los otros diez models de pesos abiertos tras corregir las comparaciones múltiples. Su diferencia con 0.6B no fue significativa. Sus puntuaciones de Recall@10 fueron 90,46 % y 86,71 %, también sin una diferencia significativa. Estas pruebas no establecen un rendimiento equivalente.
BGE Large registró la puntuación más alta en finanzas con 0.604
PPLX 4B obtuvo 0.596 en las mismas 50 preguntas de finanzas. Esa diferencia no fue significativa tras la corrección. BGE Large ocupó el cuarto lugar general, lo que ilustra cómo cambia el orden observado entre dominios.
GTE Large recuperó todos los positivos registrados de MedRAG dentro de los diez primeros resultados
GTE Large alcanzó un 100 % Recall@10 en las 50 preguntas médicas. Su nDCG@10 fue 0.894, en comparación con PPLX 4B, cuyo 0.954. Recuperar los positivos registrados y clasificarlos primero son resultados distintos. Estas puntuaciones se refieren a la recuperación de pasajes y no miden la precisión de las respuestas médicas.
Comparaciones por dominio de los once models
nDCG@10 a nivel de dominio. Las vistas de Finance, CUAD, TechQA y MedRAG conservan los once models y los ordenan por la puntuación del dominio seleccionado.
BGE-M3 alcanzó 0.616 en CUAD y 0.743 en MedRAG. Esas cifras describen la configuración de vectores densos utilizada aquí. BGE-M3 también admite recuperación dispersa y multivectorial. Esos modos y las combinaciones híbridas quedaron fuera de este experimento.1
Los cuatro dominios tienen el mismo peso en el resultado global. Un buen rendimiento en MedRAG de un model puede compensar una recuperación financiera más débil en ese promedio, aunque los casos de uso financiero y médico requieren evidencia diferente.
Representaciones de embedding y opciones de despliegue
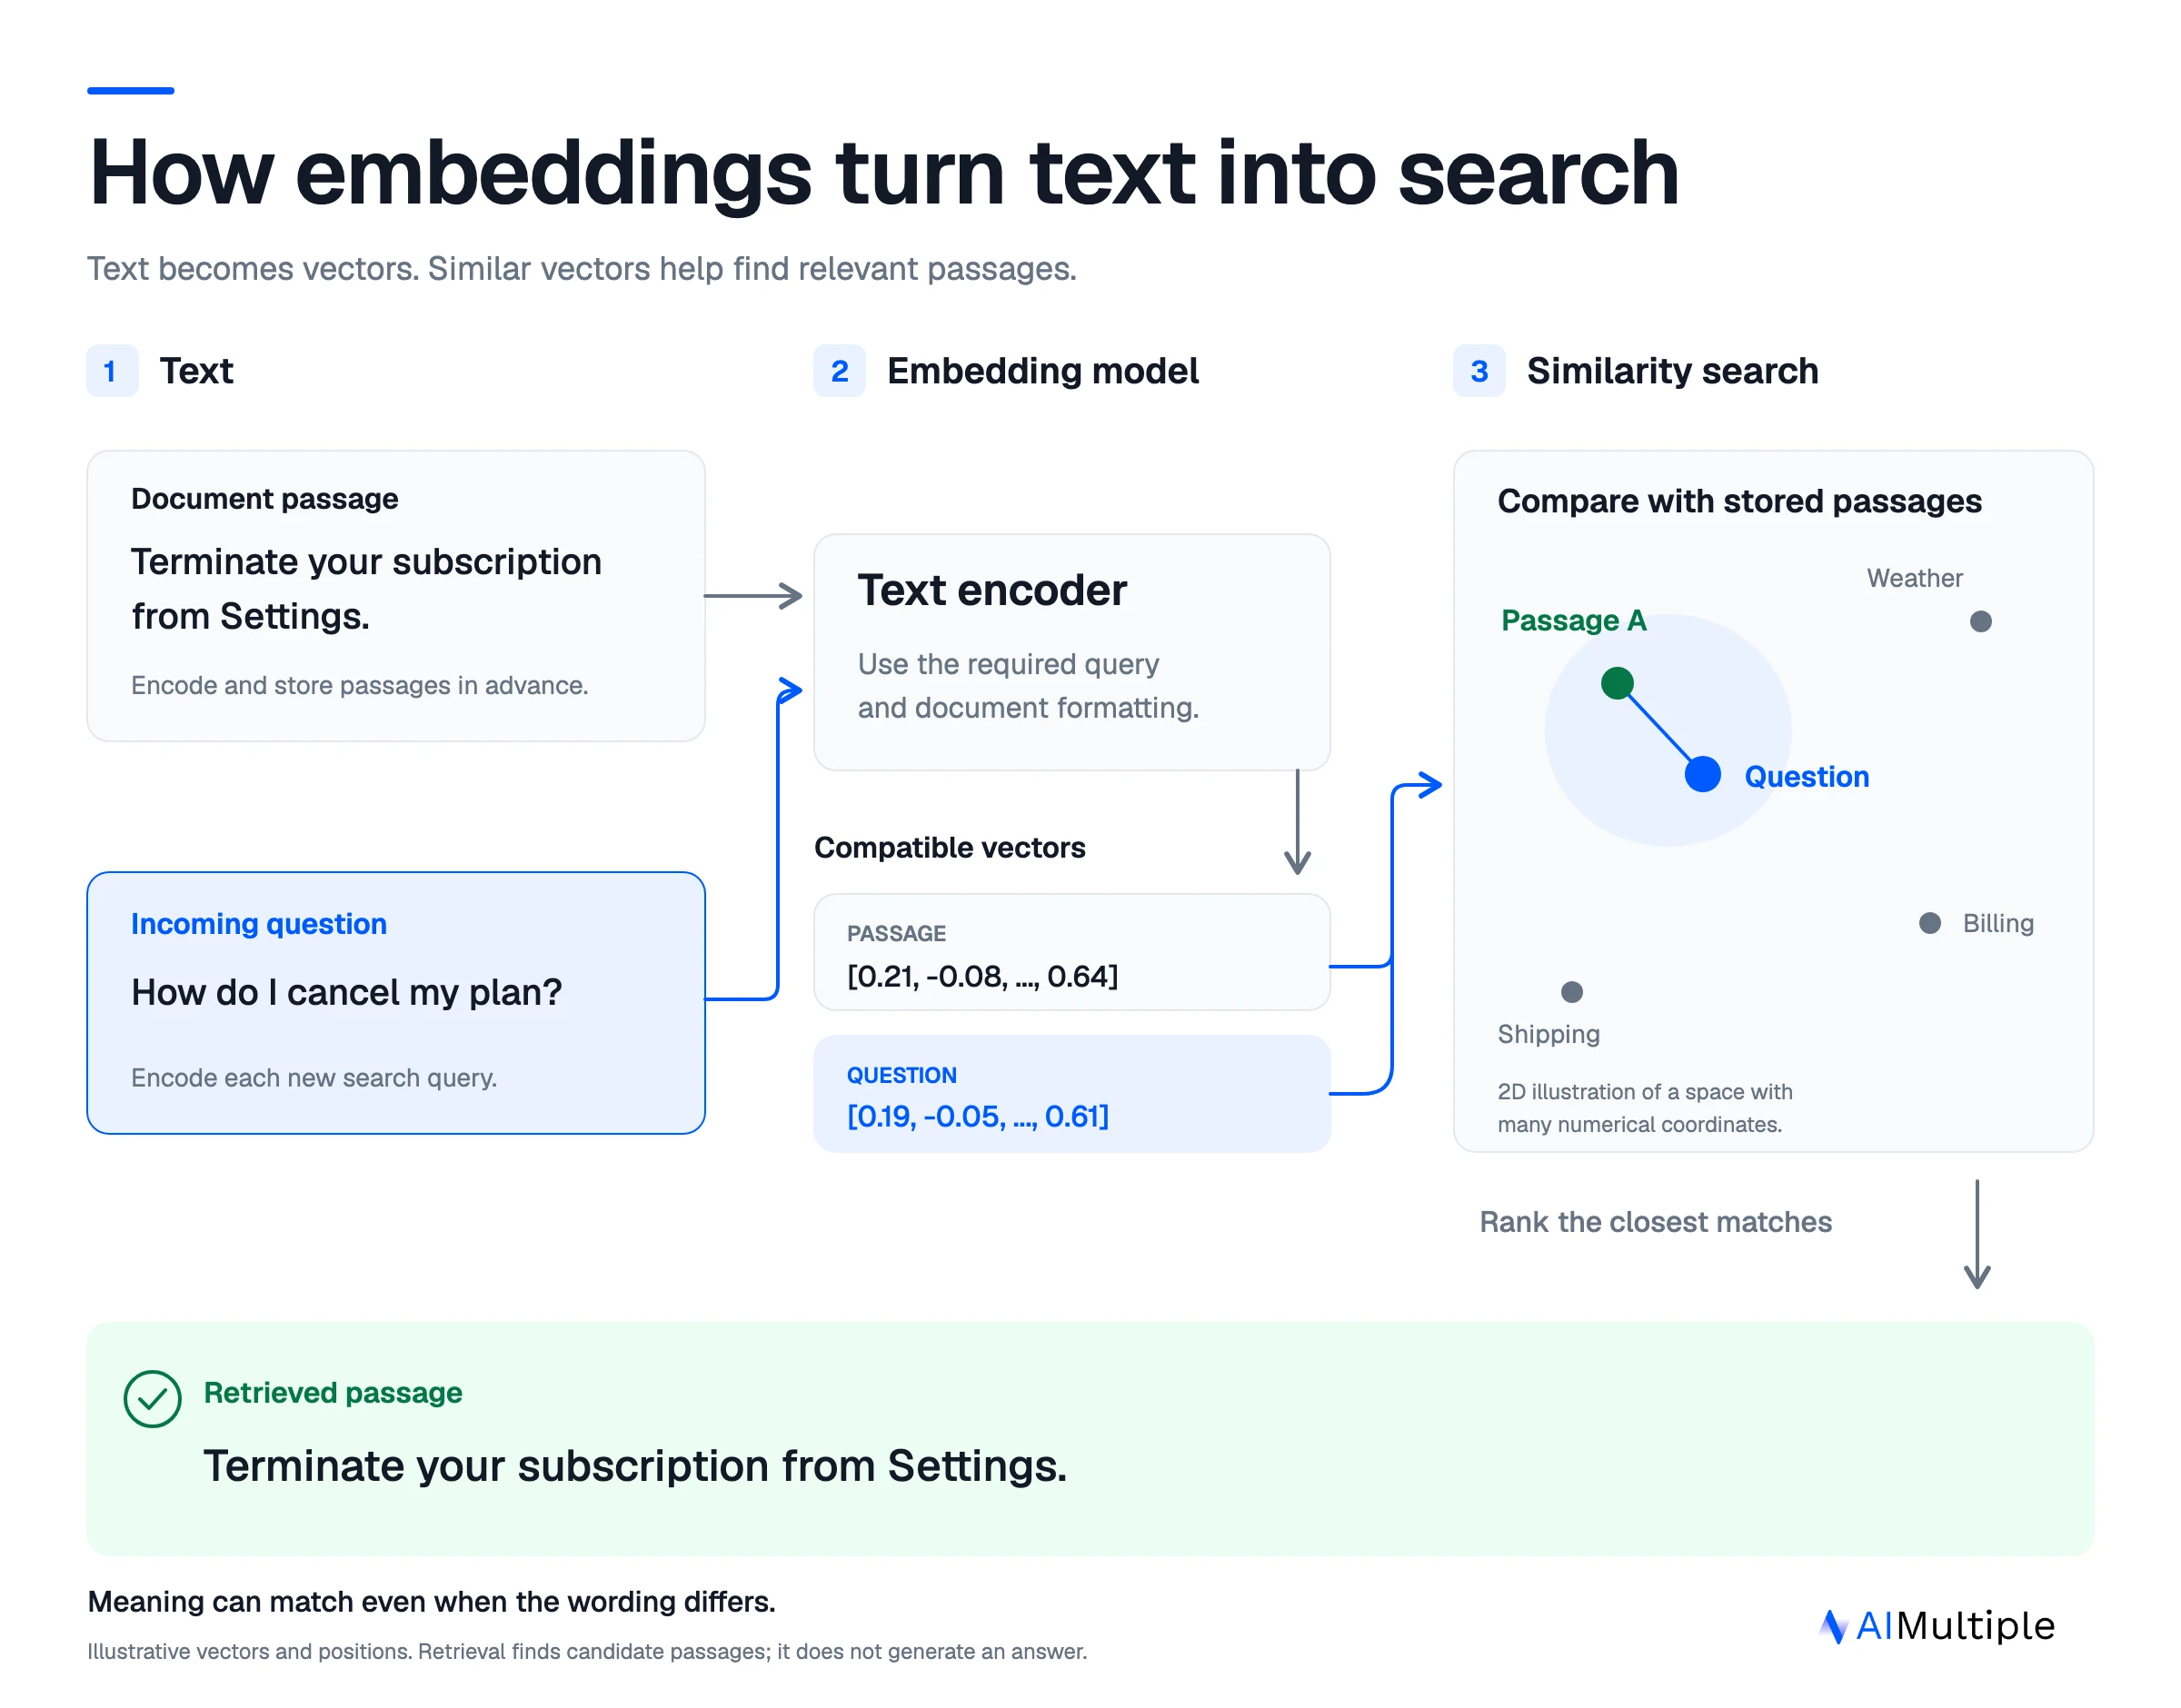
La recuperación por embedding codifica pasajes y consultas en vectores compatibles y luego compara esos vectores para seleccionar pasajes candidatos. Los documentos pueden codificarse antes de la búsqueda. Cada consulta entrante necesita su propia representación. Los prompts o roles específicos del model para consultas y documentos deben seguir la configuración de recuperación del model.2
El comportamiento de almacenamiento y búsqueda también depende de la base de datos vectorial y de su configuración de índices. La elección del model, la precisión de los vectores, los ajustes de los índices y la profundidad de recuperación deben seguir siendo decisiones separadas al planificar un despliegue. El benchmark de models de embedding más amplio sitúa estas once entradas junto a los models comerciales API en las mismas preguntas.
Metodología del benchmark de models de embedding de código abierto
Cada model buscó en los mismos pasajes con 200 preguntas fijas y 225 pares relevantes pregunta-pasaje registrados. Las preguntas y las etiquetas de relevancia se fijaron antes de comparar las puntuaciones de embedding. Las entradas de consulta contenían únicamente la pregunta original.
Los pasajes de finanzas procedían de los informes anuales de FinQA y los pasajes legales de los contratos de CUAD v1.34 El soporte técnico utilizó las notas técnicas de TechQA y la literatura médica utilizó una muestra de resúmenes de PubMed de MedRAG.56
Los pasajes eran párrafos completos, tablas con contexto, cláusulas de contrato o resúmenes con títulos. Excluimos las unidades de más de 256 tokens con el tokenizer all-MiniLM-L6-v2 y mantuvimos intactos los pasajes aceptados. Los 512-token models recibieron como máximo 459 tokens por pasaje, por lo que esta evaluación cubre pasajes cortos.
Los LLMs de frontera redactaron las preguntas a partir de los pasajes de origen. Un miembro del equipo verificó el 20 % de las preguntas (40 de 200). Los LLMs también evaluaron los 20 pasajes principales de BM25 por pregunta, añadiendo 25 pasajes relevantes a los 200 pasajes de origen originales.
Recuperación y análisis estadístico
Cada consulta se comparó con todos los pasajes de su dominio. MultiQA utilizó el producto escalar, de acuerdo con su model card.7 Los otros diez models utilizaron la similitud coseno. BGE-M3 utilizó sus vectores densos.1 Las entradas utilizaron los roles o prefijos de recuperación configurados de cada model.
Ambas métricas son promedios entre preguntas. Calculamos los IC del 95 % con 10.000 muestras bootstrap, remuestreando 50 preguntas dentro de cada dominio. La significación utiliza las pruebas pareadas de inversión de signos del benchmark completo, con corrección de Holm en todos los 231 pares entre sus 22 models para cada métrica y alcance. Las diferencias son significativas con un valor p corregido inferior a 0.05.
IDs de model probados, dimensiones y límites de entrada
Las ejecuciones se realizaron a través de OpenRouter, con un proveedor de backend fijo por model y sin fallbacks. Estos son los API identificadores, las dimensiones de salida y los límites de entrada utilizados en esas ejecuciones.
API identificadores no garantizan una instantánea inmutable del model. Las revisiones del tokenizer se fijaron y los pesos alojados del model no se verificaron de forma independiente. Los límites de entrada describen la configuración del benchmark. Los pasajes cortos no probaron la recuperación de contexto largo.
Límites de la comparación
Las preguntas forman un conjunto de desarrollo seleccionado por BM25. Los resultados en consultas de producción ordinarias pueden diferir. Los juicios de relevancia se limitaron a los pasajes de origen y a los 20 principales de BM25. En estos once models, aproximadamente el 85 % de los pares distintos pregunta-pasaje recuperados en los diez primeros no fueron evaluados y no recibieron crédito de relevancia.
Cada model se ejecutó una vez. Los IC reflejan el muestreo de preguntas y excluyen la variación entre API ejecuciones o la incertidumbre derivada de etiquetas incompletas. La contaminación de datos de entrenamiento no se probó.
La evaluación cubre la recuperación de texto en inglés. Las cargas de trabajo de embedding multilingüe y los models de embedding multimodal requieren evidencia separada. La precisión de las respuestas generadas, la recuperación híbrida, el reranking, GPU memoria, el rendimiento local y el coste de servicio quedaron fuera de esta comparación.
Conclusión
PPLX Embed v1 4B y 0.6B tuvieron las puntuaciones globales más altas entre los once models de pesos abiertos. Su diferencia no fue estadísticamente significativa. BGE Large registró la puntuación más alta en finanzas y GTE Large recuperó todos los positivos registrados de MedRAG dentro de los diez primeros resultados.
Antes del despliegue, pruebe el conjunto de consultas previsto y mida la velocidad local de servicio, el uso de memoria y el coste.
 Añadir como fuente preferida
Lecturas adicionales
- Benchmark de models de embedding
- Models de embedding multilingüe para RAG
- Benchmark de bases de datos vectoriales de código abierto
- Dimensionamiento y selección de bases de datos vectoriales
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Models de embedding de código abierto: 11 models evaluados para recuperación}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/open-source-embedding-models}},
  note   = {AIMultiple. Recuperado el 26 de septiembre de 2026}
}Resultados y marcas de tiempo de 66 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 5 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
4 actualizacionesSe reemplazó el benchmark Top-K de 16 modelos sobre reseñas de Amazon por uno de 14 modelos con nDCG@3 y costes en CUAD, TechQA y MedRAG.
Se añadió Licencia y uso comercial a la descripción general de los modelos de incrustación de código abierto.
Se amplió el benchmark para incluir cinco modelos de código abierto adicionales.
Actualizados el hardware, el tamaño del lote y la precisión en la configuración de evaluación.
Enlaces de referencia






Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.