


AIM-Text-to-SQL Benchmark: SQL Precisión en 70+ LLMs
We evaluated SQL answers from 70+ LLMs on a 759-question BIRD-SQL subset. Each model selected a database from 11 candidates, then produced a query.
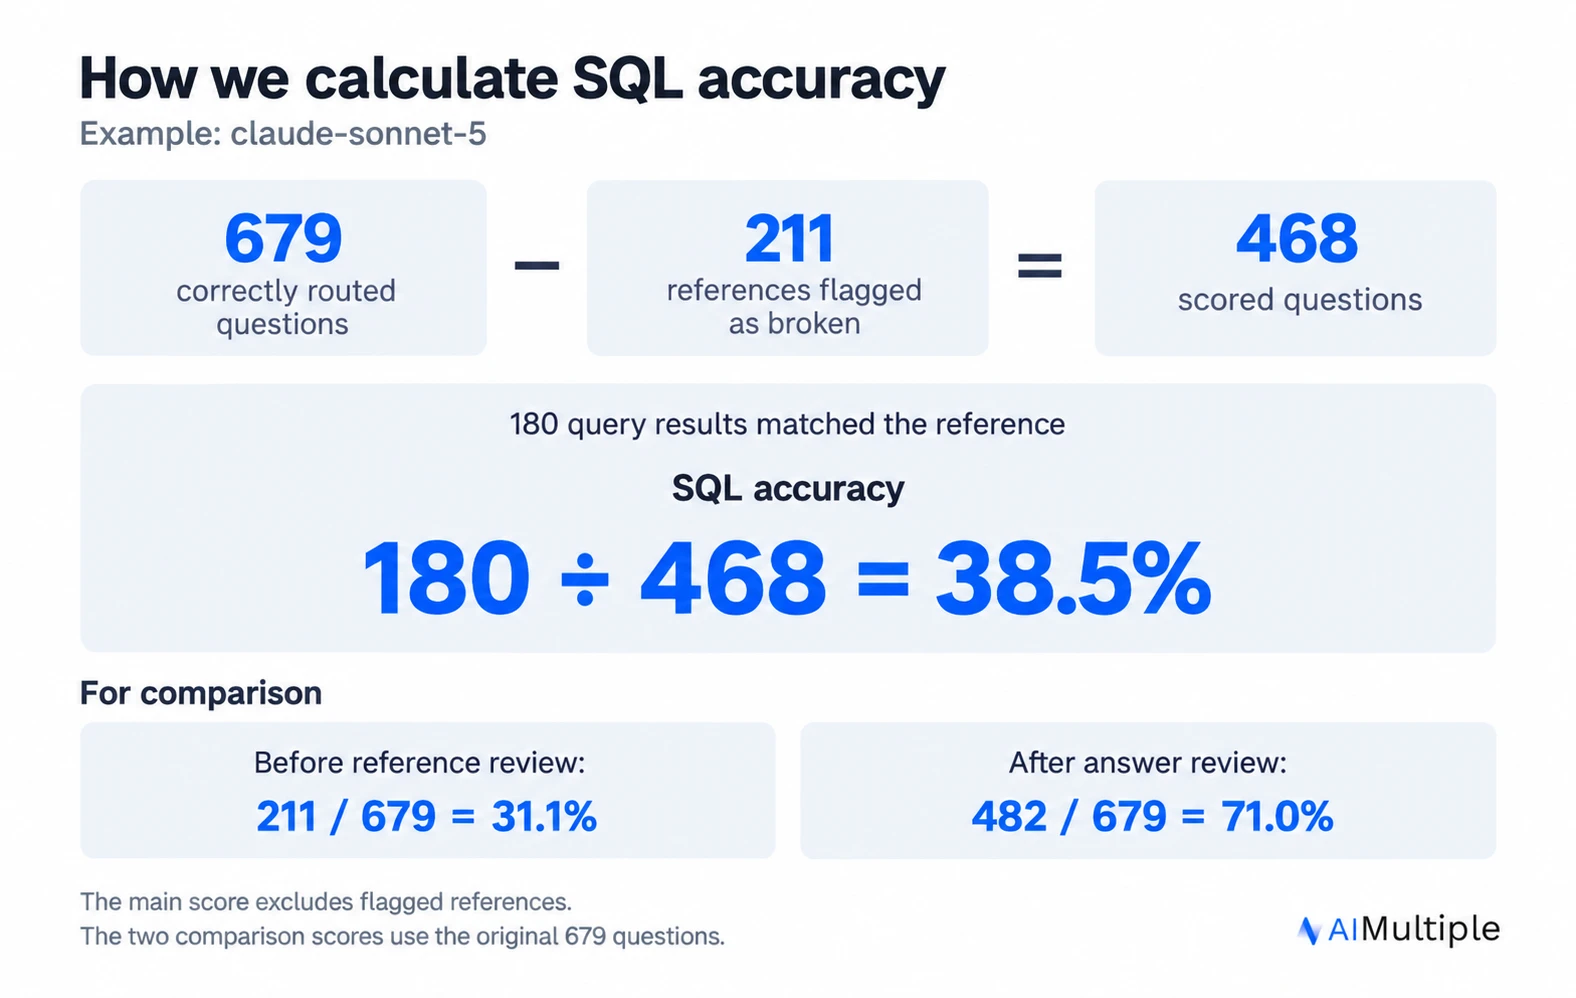
La SQL precisión es el porcentaje de consultas puntuadas que devuelven el resultado de referencia. Las rutas incorrectas y las referencias marcadas como rotas se excluyen. Una consulta de referencia es el SQL proporcionado como respuesta esperada.
Cada model llega a un conjunto diferente de preguntas de SQL porque la puntuación depende de sus elecciones de base de datos. Las diferencias en estos subconjuntos y en la configuración de ejecución limitan las comparaciones.
Hallazgos de Text-to-SQL
Opus 5.5 registró 87,8 % de precisión SQL
claude-opus-5.5 coincidió con el resultado de referencia en 444 de 506 preguntas puntuadas. gemini-4-argon le siguió con 78,6 % (407 de 518), luego gemini-3.8-flash con 77,2 % (342 de 443). Estas fueron las tres puntuaciones de precisión SQL más altas del panel de 81 model. Muse Wonder registró 56,4 % (285 de 505). GPT-6.1 Terra registró 56,6 % (280 de 495). MiniMax M3.1 Flash registró 36,5 % (177 de 485). Kimi K3.1 Pro registró 52,3 % (257 de 491). Muse Spark Open registró 44,9 % (219 de 488), y DeepSeek V4.1 Flash 1017 registró 22,8 % (108 de 474).
La puntuación excluye las elecciones de base de datos incorrectas y las referencias marcadas como rotas. Opus 5.5 utilizó Claude Code. Gemini 4 Argon y Gemini 3.8 Flash utilizaron OpenRouter. La clasificación refleja tanto las condiciones de ejecución como las diferencias en las preguntas que cada model enrutó correctamente.
Tres variantes Pro puntuaron por debajo de sus model base
gpt-6.1-sol-pro registró una precisión SQL del 63,6 %, en comparación con el 65,1 % de gpt-6.1-sol. gpt-6-sol-pro obtuvo un 53,6 % frente al 53,8 % de gpt-6-sol. gpt-6-luna-pro obtuvo un 44,2 % frente al 45,4 % de gpt-6-luna.
Los seis model utilizaron OpenRouter. Estas puntuaciones provienen de una ejecución por model y de subconjuntos diferentes de preguntas enrutadas correctamente. Serían necesarias ejecuciones repetidas sobre las mismas preguntas de SQL para evaluar si persisten las pequeñas diferencias.
Coste frente a SQL precisión
El coste de ejecución cubre las respuestas de enrutamiento y SQL retenidas de cada ejecución del benchmark de cada model. El objetivo era 759 preguntas. Siete ejecuciones tienen menos respuestas retenidas. Se excluyen las pruebas exploratorias separadas, los reintentos descartados y las decisiones del jurado. La precisión SQL utiliza las preguntas enrutadas correctamente de cada model después de excluir las referencias marcadas como rotas.
gemini-3-flash-preview registró una precisión SQL del 67,7 % a 7.67 $ por ejecución. gemini-3.8-flash alcanzó el 77,2 % a 26.48 $. La puntuación del 87,8 % de Opus 5.5 está asociada a un coste estimado equivalente a API de 188.71 $. Gemini 4 Argon alcanzó el 78,6 % a 41.41 $ en costes de ejecución retenidos. Muse Wonder alcanzó el 56,4 % a 77.44 $ en costes de ejecución retenidos. GPT-6.1 Terra alcanzó el 56,6 % a 7.19 $ en costes de ejecución retenidos. MiniMax M3.1 Flash alcanzó el 36,5 % a 2.30 $ en costes de ejecución retenidos. Kimi K3.1 Pro alcanzó el 52,3 % a 27.14 $ en costes de ejecución retenidos. Muse Spark Open costó 22.03 $ y DeepSeek V4.1 Flash 1017 costó 1.75 $ por las ejecuciones retenidas de enrutamiento más SQL.
Los 78 model de API utilizan costes medidos. Opus 5.5, Fable 5.1 y GPT-6 Astra tienen estimaciones etiquetadas por separado basadas en sus tokens de CLI registrados y en los precios de OpenRouter consultados el 1 de octubre de 2026, conservando el uso de caché registrado.
Los costes incluyen la exploración de bases de datos y las puntuaciones de SQL cubren subconjuntos de preguntas diferentes. Por lo tanto, esta comparación describe el coste y la precisión del flujo de trabajo combinado del benchmark. No se midieron los costes aislados de generación de SQL. El benchmark de RAG agéntico informa de la selección de bases de datos por separado.
Resultados de precisión de SQL
La medición antes de la revisión de referencias evalúa la coincidencia exacta de resultados en todas las preguntas enrutadas correctamente. La puntuación después de la revisión de respuestas añade crédito por las respuestas aceptadas por el jurado. Ambas columnas de comparación utilizan el denominador original, mientras que la precisión SQL excluye las referencias marcadas.
Cómo respondieron los model la misma pregunta de SQL
La misma pregunta produjo coincidencias exactas, respuestas correctas con columnas adicionales y una institución no relacionada. Los ocho model eligieron la base de datos correcta, college_completion. La tabla institution_details almacena los nombres de las instituciones en chronname, las ciudades en city y los estados en state. Estas respuestas proceden de ejecuciones guardadas del benchmark. Siete model utilizaron OpenRouter, mientras que Opus 5.5 utilizó Claude Code.
GPT-6.1 Terra, Kimi K3.1 Pro, Gemini 4 Argon y Opus 5.5 devolvieron Georgia y superaron la coincidencia de ejecución. Muse Spark Open y DeepSeek V4.1 Flash 1017 también identificaron Georgia, pero incluyeron columnas de nombre y ciudad. Fallaron la comparación estricta de resultados. Los tres jurados de la revisión de respuestas aceptaron cada respuesta.
MiniMax M3.1 Flash y GLM 5.3 utilizaron LIKE '%Mercer%', que también devolvió Mercer County Community College en Nueva Jersey. Los tres jurados clasificaron cada respuesta como un error de model. La referencia superó la auditoría de validez separada.
Seleccionamos este caso para mostrar cómo el filtrado y las columnas de salida afectan a la evaluación. Ilustra respuestas individuales. Los resultados completos del benchmark anteriores proporcionan la comparación general de los model.
Condiciones que afectan a la precisión de SQL
Las pistas de BIRD aumentaron la precisión SQL de Gemini Flash en 8.7 puntos
Repetimos gemini-3-flash-preview con la evidencia complementaria de BIRD. En las preguntas enrutadas correctamente en ambas condiciones, la precisión SQL aumentó del 67,5 % al 76,2 %. La precisión estricta, antes de la revisión de referencias, aumentó del 55,0 % al 61,6 %.
Este fue un experimento con un solo model. No establece una mejora común para el panel de 81 model. El panel principal omite las pistas porque también pueden revelar qué base de datos seleccionar.
Los model llegaron a conjuntos diferentes de preguntas de SQL
Las elecciones de base de datos de cada model determinan qué preguntas llegan a la puntuación SQL. Para claude-opus-5, el denominador estricto contiene 717 preguntas, incluidas 156 del grupo de enrutamiento más difícil. Para nova-lite-v1, contiene 285 preguntas, incluidas 22 de ese grupo. Las proporciones son del 21,8 % y del 7,7 %.
Por lo tanto, sus porcentajes de SQL combinan el rendimiento en la escritura de consultas con la dificultad de los casos que llegaron a la puntuación. Una comparación controlada de SQL suministraría a cada model la base de datos correcta para las mismas preguntas. Ese experimento no se ha realizado.
La selección de preguntas también importa al comparar benchmarks de IA que proporcionan esquemas, pistas o presupuestos de herramientas diferentes.
Hallazgos de la revisión de referencias y respuestas
La auditoría de referencias marcó 236 de 759 consultas
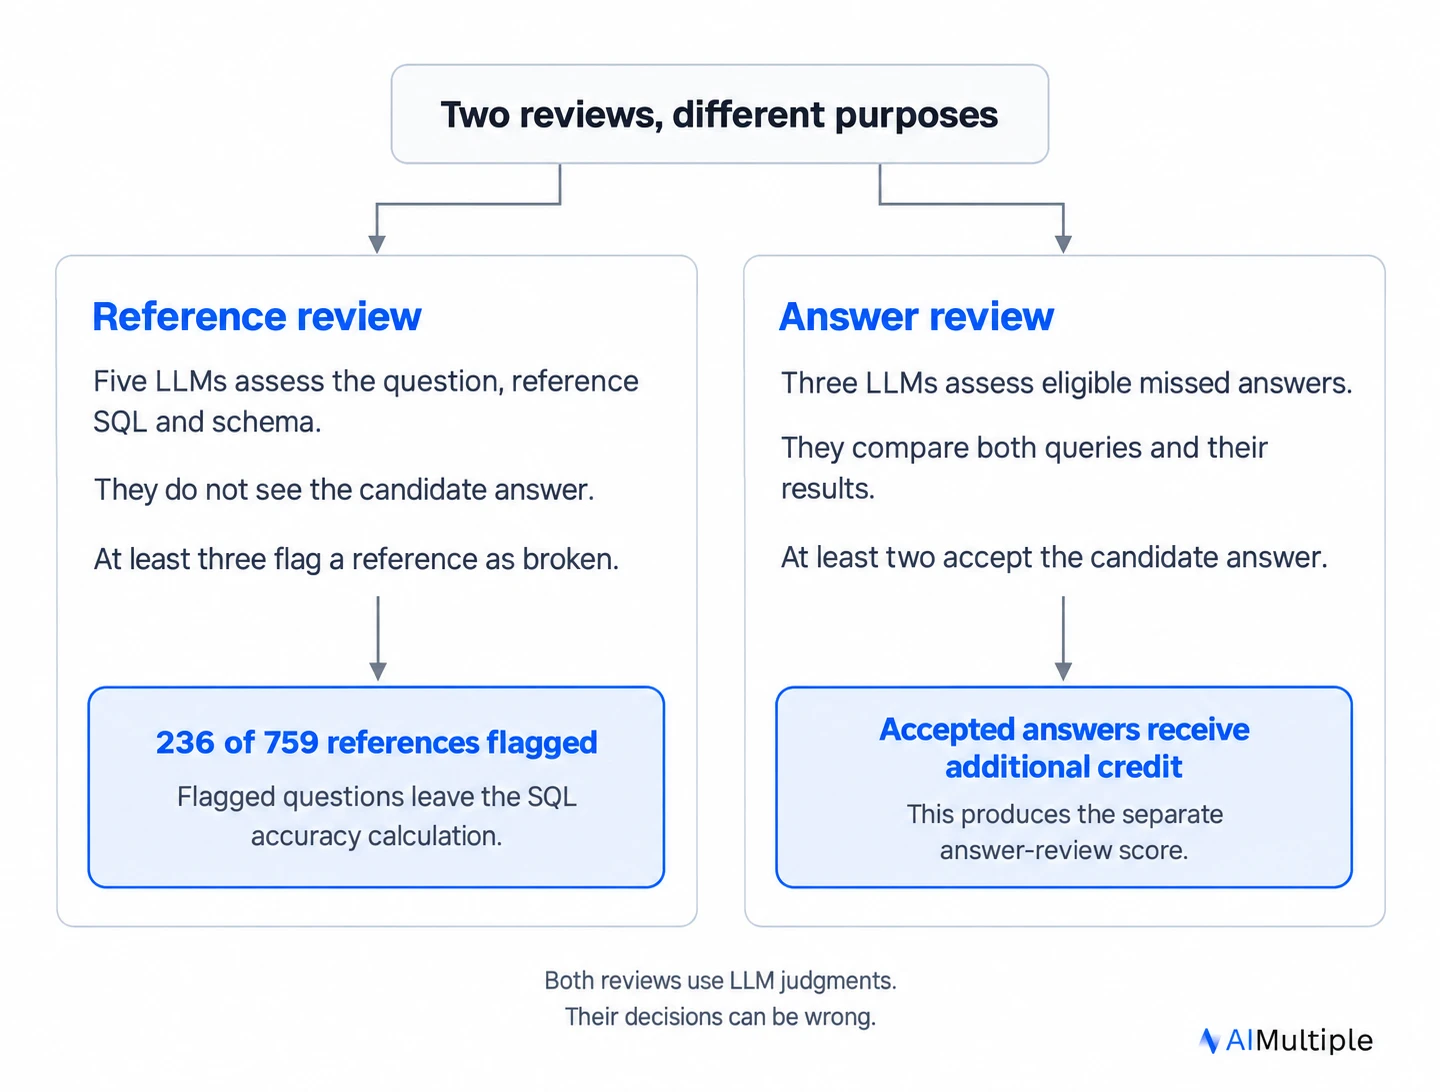
Cinco model evaluaron cada consulta de referencia en relación con su pregunta y la información de esquema disponible. No vieron ninguna respuesta de model candidata. Una mayoría de al menos tres marcaron 236 referencias como rotas, es decir, el 31,1 % del conjunto.
Después de la auditoría, el propietario del benchmark revisó las marcas. Anotadores humanos independientes no han repetido esa revisión. Estos porcentajes describen el subconjunto auditado. No deben generalizarse a todo BIRD.
Las respuestas equivalentes sumaron 22.7 puntos a la puntuación de claude-sonnet-5
claude-sonnet-5 superó 211 de 679 preguntas puntuadas de forma estricta, es decir, el 31,1 %. Un jurado aceptó otras 154 respuestas como equivalentes a la referencia. Estas aportaron 22.7 puntos porcentuales.
Otras 117 respuestas recibieron crédito porque el jurado aceptó la consulta del model y rechazó la referencia. Esas aportaron 17.2 puntos. En conjunto, las dos categorías elevaron la puntuación al 71,0 %, un aumento de 39.9 puntos.
Las respuestas equivalentes pueden devolver la información solicitada con una columna adicional o una proyección diferente. La comparación estricta puede rechazar ese resultado incluso cuando un revisor lo acepta como respuesta a la pregunta. Del aumento, 22.7 puntos proceden de las decisiones del jurado sobre estos casos. Los defectos de las referencias representan los 17.2 puntos restantes.
 Añadir como fuente preferida
Metodología del benchmark de Text-to-SQL
Questions and execution
BIRD-SQL proporciona preguntas en lenguaje natural, referencias SQL y contenidos de bases de datos.1 Utilizamos una selección congelada de 759 preguntas de 11 bases de datos, que cubre 560 ejemplos de train y 199 de dev.
Los model recibieron descripciones breves de bases de datos y herramientas para listar tablas, leer definiciones de columnas y ejecutar SQL. Cada pregunta permitía hasta nueve llamadas con herramientas y una respuesta final que contenía la base de datos elegida y el SQL. El límite de vista previa del esquema era de 4.000 caracteres, y las vistas previas de consultas estaban limitadas a 50 filas.
La consulta candidata final y la referencia se ejecutaron contra el mismo archivo de base de datos. La puntuación estricta comparó sus resultados, incluido un modo sensible al orden para las preguntas que solicitan una respuesta ordenada. Las consultas candidatas ausentes, mal formadas o con errores de ejecución no recibieron crédito estricto en preguntas por lo demás elegibles y enrutadas correctamente.
Para las 78 ejecuciones de OpenRouter, solicitamos temperatura 0. De estas, 61 utilizaron la capa de recuperación de llamadas a herramientas v3, 15 son anteriores y dos combinaron registros de ambas versiones. GPT-6 Astra se ejecutó a través de Codex CLI. Opus 5.5 y Fable 5.1 utilizaron Claude Code. Las tres ejecuciones de CLI utilizaron un esfuerzo de razonamiento medio. Las ejecuciones de GPT-6 Luna, Luna Pro, Sol y Sol Pro y GPT-5.2 utilizaron OpenRouter. Estas diferencias de ejecución impiden atribuir una brecha de puntuación únicamente al model.
Siete ejecuciones completaron menos de 759 preguntas. Los registros ausentes no figuran en los denominadores de puntuación. La tabla informa de los tamaños de muestra reales para las puntuaciones principales y complementarias. GPT-6.1 Terra, MiniMax M3.1 Flash y Kimi K3.1 Pro completaron cada uno las 759 preguntas a través de OpenRouter el 27 de octubre. Las respuestas correctas anteriores se conservaron en todas las etapas de medición. DeepSeek V4.1 Flash 1017 y Muse Spark Open completaron cada uno las 759 preguntas a través de OpenRouter el 30 de octubre.
Puntuación de SQL
La puntuación principal excluye las preguntas marcadas tanto del numerador como del denominador. Tres referencias marcadas como inciertas permanecen en el cálculo. Los archivos de resultados denominan a esta métrica ex_gold_clean.
Dos puntuaciones complementarias muestran cómo cambia la revisión el resultado:
Antes de la revisión de referencias, la puntuación estricta mide la coincidencia exacta de ejecución en todas las preguntas enrutadas correctamente. Incluye preguntas con referencias marcadas.
Después de la revisión de respuestas, la puntuación añade crédito cuando un jurado separado acepta una respuesta omitida elegible. Utiliza el mismo denominador que la puntuación estricta. Los archivos de resultados denominan a esto precisión adjudicada.
El tamaño de la muestra (n) es el número de preguntas puntuadas. La puntuación principal utiliza un subconjunto más pequeño que las dos puntuaciones complementarias.
Para claude-sonnet-5, excluir las referencias marcadas redujo las respuestas aceptadas de 211 a 180 y las preguntas puntuadas de 679 a 468. Su precisión SQL fue del 38,5 %.
La exclusión cambia ambos recuentos. La revisión de respuestas, en cambio, conserva el denominador original y añade crédito por las respuestas omitidas aceptadas.
Revisión de referencias y respuestas
Auditar referencias y revisar respuestas candidatas requieren entradas diferentes.
Los auditores de referencias fueron claude-opus-4.8, gpt-5.6-sol, gemini-3.1-pro-preview, grok-4.5 y deepseek-v4-pro. Las respuestas candidatas se ocultaron para mantener las marcas independientes del model que se estaba puntuando.
La adjudicación de respuestas utilizó tres jurados de familias de model diferentes a la del candidato. Las consultas de referencia y candidatas aparecieron en posiciones A/B aleatorias sin etiquetas que revelaran sus funciones. Los casos ambiguos y los casos con votos válidos insuficientes no recibieron crédito añadido. GPT-6.1 Terra, MiniMax M3.1 Flash y Kimi K3.1 Pro tuvieron al menos dos votos válidos de jurado para cada caso elegible. Los votos fallidos individuales permanecen en los registros de auditoría. Una respuesta truncada del jurado de GPT-6.1 Terra se completó con un límite de salida de 4.000 tokens, aumentado desde 1.200. El model del jurado, el prompt y las reglas de puntuación no se modificaron. DeepSeek V4.1 Flash 1017 y Muse Spark Open tuvieron al menos dos votos válidos de jurado para cada caso elegible.
La cobertura de la revisión es asimétrica. Las superaciones estrictas siguen aceptadas, mientras que las omisiones elegibles reciben otra evaluación. En consecuencia, la adjudicación puede conservar falsos positivos de la puntuación estricta y añadir sus propios falsos positivos. Es una estimación complementaria, sin corrección garantizada ni un límite superior garantizado para la precisión real.
Una omisión era apta para la adjudicación cuando la consulta candidata se ejecutaba y la superposición F1 entre sus filas de resultados y la referencia era inferior a 0.5. La F1 combina la proporción de filas candidatas encontradas en la referencia con la proporción de filas de referencia recuperadas por la candidata.
Por ejemplo, gemini-3.5-flash-lite tuvo 346 omisiones estrictas. De estas, 314 fueron aptas para la revisión. El jurado aceptó la candidata en 144 casos: 92 con una referencia rechazada y 52 con ambas respuestas aceptadas. Clasificó 105 como errores de model y dejó 65 ambiguos. Las otras 32 omisiones comprendieron 27 con mayor superposición de resultados y cinco errores de ejecución.
El jurado aceptó el 45,9 % de las 314 omisiones revisadas.
Limitaciones
Los errores de las referencias siguen siendo inciertos. La auditoría de cinco model inspeccionó columnas de tablas utilizadas por cada consulta de referencia, por lo que puede pasar por alto una respuesta ubicada en una tabla diferente. La auditoría también puede rechazar una referencia válida. Se necesita una revisión repetida por anotadores humanos independientes para estimar ambos tipos de error.
Los juicios del jurado dependen de la interpretación del LLM. Ninguna revisión humana independiente verificó todos los veredictos de adjudicación. En el control de nova-lite-v1, la precisión aumentó del 18,9 % con la puntuación estricta al 31,6 % después de la adjudicación, lo que muestra que la revisión no produjo automáticamente una puntuación alta. Ese control por sí solo no puede establecer la precisión del jurado.
La comparación estricta puede fallar en ambos sentidos. Las columnas adicionales o un orden de columnas diferente pueden rechazar una respuesta útil. La normalización de mayúsculas y el redondeo de valores de coma flotante a seis cifras significativas pueden aceptar diferencias importantes.
Los intervalos de muestreo de preguntas están disponibles para las puntuaciones estrictas y la precisión SQL en la exportación de resultados. Omiten la incertidumbre de las etiquetas de referencia, el error del jurado y la variación entre ejecuciones repetidas de SQL. Aquí no se informa de ningún análisis repetido de SQL.
Estos son resultados para una carga de trabajo seleccionada, sin gratis y con un requisito de enrutamiento de bases de datos. No son directamente comparables con la tabla de clasificación de BIRD. Los datos públicos de train también dejan un riesgo de solapamiento de datos de entrenamiento, como se analiza en el artículo de enrutamiento.
Conclusión
claude-opus-5.5 lideró la precisión SQL con un 87,8 %, seguido de gemini-4-argon con un 78,6 % y de gemini-3.8-flash con un 77,2 %.
Cada puntuación de SQL refleja las preguntas que ese model enrutó correctamente y las referencias retenidas después de la revisión. Una comparación controlada de SQL daría a cada model las mismas preguntas e información de base de datos, con comprobaciones independientes de las etiquetas de referencia y de las decisiones del jurado.
Lecturas adicionales
- Benchmark de RAG agéntico: enrutamiento multibase de datos
- 800+ principales benchmarks de IA
- HALC-Bench: Alucinación de LLM en el benchmark de recuperación de contexto largo
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Text-to-SQL Benchmark: SQL Precisión en 70+ LLMs}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/text-to-sql}},
  note   = {AIMultiple. Recuperado el 30 de octubre de 2026}
}Resultados y marcas de tiempo de 1.5 mil puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 5 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
9 actualizacionesSustituidos los resultados del benchmark de texto a SQL por un panel de 36 modelos puntuado con coincidencia de ejecución strict, gold-clean y adjudicated.
Se añadió un registro de cambios a la sección de benchmark de RAG agéntico: enrutamiento multidatabase y generación de consultas.
Se reemplazó la sección de metodología con un resumen y una referencia a otro artículo.
Enlaces de referencia





Comentarios 1
Comparte tus ideas
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.
Curious, how much of the context engineering and specific prompting did you apply in your benchmarks. Or, was it to review the models only? I have found much higher return of correct and consistent responses. A higher fidelity. To do that, I needed to provide a most sophisticated prompt that fed the context window as the question was being asked. Not perfect, but better than those scores represented in this article when using the Grok 4.x .
Great point. This benchmark intentionally uses zero-shot, minimal prompting with temperature=0. No few-shot examples, no domain-specific instructions, no iterative refinement. The goal was to measure each model's baseline text-to-SQL capability. So your experience with Grok 4 getting higher fidelity through sophisticated context engineering is completely expected. A well-crafted prompt with detailed schema descriptions, few-shot examples, and domain-specific rules will improve any model's performance significantly. What this benchmark isolates is how well the model performs out-of-the-box when given only the raw question and retrieved schema, which helps compare the models' inherent SQL reasoning abilities on a level playing field. We'll make this clearer in the methodology section. Thanks for raising it.