


Precios de LLM: comparativa de los 15+ principales proveedores

Realizamos un seguimiento de los precios de lanzamiento de más de 160 LLM, desde GPT-3.5 Turbo en marzo de 2023 hasta los últimos lanzamientos, agrupados por clase de tamaño. También comparamos los precios de la API de los modelos actuales con sus resultados de benchmark y revisamos los planes de suscripción de los principales proveedores.
Tendencias de precios de lanzamiento de LLM
- Los precios de lanzamiento de Claude Opus cayeron de $30,00 (Opus 4.1, agosto de 2025) a $8,00 (Opus 5.5, septiembre de 2026).
- Claude Fable 5 se lanzó a $20,00 en junio de 2026, el doble del precio de Claude Opus 4.8 dos semanas antes. OpenAI GPT-6 Astra siguió a $20,00 en septiembre.
- GPT-6 Sol se lanzó a $4,00 en septiembre de 2026, un 64 % por debajo de GPT-5.6 Sol y de sus $11,25 en julio. GPT-6 Luna se lanzó a $0,20, frente a los $2,25 de GPT-5.6 Luna.
- El precio medio de lanzamiento de los modelos cerrados pequeños subió de $0,53 en 2024 a $0,85 en 2025. En 2026, Gemini 3.5 a 3.8 Flash se lanzó a entre $3,00 y $3.38.
- En 2025, la mediana del precio de lanzamiento de los modelos grandes de pesos abiertos fue inferior a una cuarta parte de la mediana de los modelos cerrados de gama media. El Kimi K3 de Moonshot se lanzó a $6,00 en julio de 2026, por encima de Claude Sonnet 5 y de sus $4.00.
Los precios son por millón de tokens, combinando tres partes de entrada por una de salida, y excluyen las promociones de tiempo limitado. Los modelos de pesos abiertos tienen pesos publicados públicamente; para los que no cuentan con una API de primera parte, el precio es la tarifa de un proveedor de alojamiento de alrededor del lanzamiento. Los nuevos lanzamientos aún pueden cambiar las medias del trimestre actual.
Evaluación de precios de LLM API
Hay dos formas de pagar por un LLM: planes de suscripción con precios de LLM de tarifa plana de los principales proveedores, o un modelo de API de pago por uso facturado por consumo de tokens.
Haga clic en los nombres de los modelos para ver sus resultados de benchmark, latencia en condiciones reales y precios, y así evaluar la eficiencia y la relación coste-eficacia de cada modelo.
Clasificación: Los modelos se clasifican por su posición media en todos los benchmarks.
Puede consultar las tasas de alucinación y el rendimiento de razonamiento de los principales LLM en nuestros benchmarks.
Comparativa de planes de suscripción de LLM
Los usuarios no técnicos pueden preferir usar la interfaz de usuario en lugar de la API. En 2026, la mayoría de las suscripciones de los proveedores incluyen mucho más que una interfaz de chat. Agentes de programación como Claude Code, Codex, Kimi Code y Mistral Vibe vienen en los planes de nivel Pro. Para desarrolladores y usuarios intensivos, la suscripción adecuada de entre $10 y $200 a menudo sustituye lo que de otro modo sería una suscripción independiente a un IDE de programación, un presupuesto de API por token y una herramienta de vídeo o de investigación, todo combinado.
OpenAI
El plan gratuito incluye chats de texto diarios ilimitados con GPT-5.6 Luna, modo de voz estándar, cargas limitadas y generación básica de imágenes. Los anuncios contextuales llegan a unos 40 mercados a fecha de agosto de 2026, incluidos EE. UU. y la mayor parte de Europa, y solo aparecen en los planes Free y Go.
- ChatGPT Go ($8/mes) es un plan de bajo coste que puede incluir anuncios. Los chats de texto son ilimitados, como en Free; la mejora ofrece límites más altos en cargas de archivos, creación de imágenes, voz y memoria, todo con GPT-5.6 Luna.
- ChatGPT Plus ($20/mes) incluye límites de uso ampliados, acceso a GPT-5.6 Sol, Terra y Luna, modo de voz avanzado, el agente Codex, generación de imágenes y funciones de acceso anticipado.
El plan Pro tiene dos niveles a fecha de abril de 2026:
- ChatGPT Pro ($100/mes) ofrece la misma gama de modelos que el nivel de $200 (incluido GPT-5.6 Sol) con aproximadamente 5x los límites de uso de Plus.
- ChatGPT Pro ($200/mes) ofrece los límites de uso individuales más altos (aproximadamente 20x Plus), la mayor asignación de Deep Research, voz avanzada con vídeo y uso compartido de pantalla, Codex con el máximo aumento de uso y Sora.
Ambos niveles Pro incluyen acceso prioritario durante las horas punta. La tarificación de Codex en Plus, Pro y Business pasó de ser por mensaje a un uso alineado con tokens de la API en abril de 2026.
ChatGPT Work, el agente de OpenAI para proyectos de larga duración y varios pasos (lanzado el 9 de julio de 2026), está incluido en los planes de pago, y la aplicación de escritorio que agrupa Chat, Work y Codex está disponible en todos los planes, incluido Free.
- Plan Business ($20/usuario/mes anual o $25/usuario/mes mensual) es el plan de OpenAI para equipos pequeños y medianos (anteriormente ChatGPT Team, renombrado en agosto de 2025). Añade límites de mensajes más altos, consola de administración, SSO, datos de equipo excluidos del entrenamiento y grupos de créditos compartidos para funciones avanzadas. Aplicaciones incluidas: Codex con créditos de espacio de trabajo compartidos. Los asientos exclusivos de Codex se cerraron a nuevos espacios de trabajo el 24 de junio de 2026; OpenAI ha anunciado asientos Premium a $100/usuario/mes anual ($125 mensual) con 5x el uso de Standard. El plan requiere al menos 2 asientos.
- El plan Enterprise (precio personalizado) ofrece acceso a modelos de alta velocidad, ventanas de contexto ampliadas, controles de datos de nivel empresarial, verificación de dominios, analítica y registros de auditoría. Aplicaciones incluidas: Codex con un grupo de créditos compartido y asientos opcionales exclusivos de Codex.
Anthropic (Claude)
El plan gratuito incluye acceso web y móvil, análisis básico, acceso a Claude Sonnet 5 y Haiku, y carga de documentos. El uso diario está limitado y los modelos Opus y Fable no están disponibles.
- Plan Pro ($20/mes, o $17/mes facturado anualmente) ofrece acceso a Opus 5, Sonnet 5 y Haiku, aproximadamente 5x más uso que Free, organización de proyectos y acceso prioritario durante las horas punta. Fable 5 no forma parte de los límites de uso de Pro; se factura a tarifas de API mediante créditos de consumo de pago por uso. Aplicaciones incluidas: Claude Code (el agente de programación de Anthropic en la terminal y el IDE), Cowork, Claude Design y Claude para Microsoft 365, todos compartiendo el mismo grupo de uso que el chat.
- Plan Max 5x ($100/mes) ofrece aproximadamente 5x más uso que Pro, acceso prioritario a las funciones y modelos más recientes y acceso completo a Claude Code en el nivel de uso superior de Max.
- Plan Max 20x ($200/mes) ofrece aproximadamente 20x más uso que Pro, máxima prioridad de acceso y acceso completo a Claude Code. Está diseñado para usuarios intensivos diarios que ejecutan cargas de trabajo de Claude Code. Ambos niveles Max incluyen Fable 5, el modelo de mayor precio de Anthropic; su uso puede consumir hasta la mitad del límite de uso semanal del plan.
El plan Team ofrece dos tipos de asiento y admite de 2 a 150 miembros:
- Asiento Standard: $20/usuario/mes anual ($25/usuario/mes mensual). Incluye funciones básicas, límites de uso estándar y acceso a Claude Code.
- Asiento Premium: $100/usuario/mes anual ($125/usuario/mes mensual). Todo lo de Standard, además de límites de uso más altos para usuarios intensivos que ejecutan cargas de trabajo más pesadas de Claude Code.
Aplicaciones incluidas: Claude Code y Cowork están incluidos con cada asiento de Team (Standard y Premium); la diferencia está en la asignación de uso, no en el acceso. Ambos tipos de asiento incluyen facturación central, herramientas de colaboración y controles administrativos.
- Plan Enterprise ($20/asiento/mes más uso a tarifas de API en el nivel de autoservicio; precio personalizado con ventas) ofrece ventanas de contexto ampliadas, SSO, captura de dominios, acceso basado en roles, SCIM, registros de auditoría e integraciones de datos. Aplicaciones incluidas: en los planes Enterprise nuevos y de autoservicio, Claude Code y Cowork están incluidos con cada asiento; los contratos Enterprise más antiguos pueden distinguir entre asientos solo de chat y asientos de chat + Claude Code con facturación según el uso.
Google (Gemini)
El plan gratis ofrece acceso a Gemini 3.6 Flash y acceso variable a Gemini 3.1 Pro, generación básica de imágenes, Deep Research, Gemini Live, Canvas y Gems. Aplicaciones incluidas: Gemini Notebook (antes NotebookLM) y Flow con acceso limitado a Nano Banana Pro.
Google utiliza precios regionales, por lo que los precios pueden variar según la región.
- Google IA Plus ($4,99/mes, EE. UU.) es el nivel de pago inicial con 2x los límites de uso de Free. Aplicaciones incluidas: más acceso a Gemini 3.1 Pro en el chat, generación de imágenes con Nano Banana Pro, generación de vídeo con Gemini Omni Flash, 200 créditos Flow, Gemini Notebook con más resúmenes de audio, Gemini en Gmail, Docs y Vids, y acceso anticipado a Gemini en Chrome. Incluye 400 GB de almacenamiento.
- Google IA Pro ($19,99/mes, EE. UU.) ofrece 4x los límites de uso de Free y 5 TB de almacenamiento. Aplicaciones incluidas: Jules (agente de programación asíncrono), Google Antigravity (plataforma de desarrollo agéntico), límites ampliados de IA Studio, $40/mes en créditos de Google Cloud, Gemini Notebook con 5x Audio Overviews, Deep Research, 1.000 créditos Flow, YouTube Premium Lite y Google Home Premium (plan Standard).
- Google IA Ultra (EE. UU.) cuesta $99,99/mes para 5x los límites de uso de IA Pro o $199,99/mes para 20x. Aplicaciones incluidas: razonamiento Deep Think, Gemini Agent (solo EE. UU.), Gemini Spark, Project Genie (modelo de mundo interactivo), Jules en los límites más altos, Antigravity de primer nivel, 10.000 o 25.000 créditos Flow, Google Home Premium (plan Advanced) y una suscripción individual de YouTube Premium. El almacenamiento comienza en 20 TB.
Microsoft Copilot
El plan gratis (Copilot Chat) está disponible sin coste adicional para todos los usuarios de Microsoft Entra con una suscripción elegible a Microsoft 365. Incluye chat básico de Copilot en todas las aplicaciones de Microsoft sin las funciones más avanzadas dentro de los documentos.
- Microsoft 365 Premium ($19,99/mes o $199,99/año) es ahora el plan Copilot para consumidores. Incluye las aplicaciones de Office, hasta 6 TB de almacenamiento (1 TB por cada una de hasta seis personas) y los límites más altos de Copilot para consumidores; las funciones de IA se aplican solo al titular de la suscripción. El anterior Copilot Pro ($20/mes) está cerrado a nuevas compras, y los suscriptores actuales pueden mantenerlo o cambiarse a Premium.
- Microsoft 365 Copilot Business ($21/usuario/mes anual; $18/usuario/mes el primer año en compras hasta el 30 de septiembre de 2026; $25,20/usuario/mes mensual) añade Copilot en todas las aplicaciones de Microsoft 365, integración con Teams y controles de administración. Aplicaciones incluidas: Copilot Studio Lite para crear agentes ligeros, Copilot en SharePoint y Copilot Pages para borradores colaborativos. Limitado a organizaciones de hasta 300 usuarios.
- Microsoft 365 Copilot Enterprise ($30/usuario/mes anual, o $31,50/usuario/mes facturado mensualmente; requiere una licencia elegible de Microsoft 365) ofrece seguridad avanzada, cumplimiento y analítica además de las funciones de Business. Aplicaciones incluidas: creación de agentes con Copilot Studio (los agentes predefinidos y los datos de trabajo pueden medirse; Copilot Studio independiente se vende por separado), Copilot en Microsoft Purview e Intune para flujos de trabajo de TI y seguridad, y gobernanza de los agentes desplegados.
xAI (Grok)
El plan gratis ofrece acceso limitado a Grok.
- SuperGrok Lite ($10/mes) es el nivel de pago inicial. Incluye conversaciones 2x más largas, límites de velocidad aumentados y creación de imágenes y vídeo con IA. Aplicaciones incluidas: Grok Build (el agente de creación de aplicaciones de xAI, también gratis en la web desde agosto de 2026) y Grok Imagine para la generación de imágenes y vídeo.
- SuperGrok ($30/mes, o $300/año) incluye razonamiento mejorado con Grok 4.6, conversaciones 5x más largas, cargas de archivos más largas, modo de voz para chat hablado y 20x más generaciones de imágenes y vídeo de Grok Imagine, incluido vídeo HD de 720p de 30 segundos.
- SuperGrok Plus ($100/mes) añade acceso a Grok Bot, generación de vídeo en 1080p, límites de uso más altos, respuestas más rápidas y acceso prioritario.
- SuperGrok Heavy ($300/mes) ofrece todo lo de Plus, un equipo de agentes para trabajo en paralelo, límites de velocidad máximos, vistas previas anticipadas de las próximas funciones de xAI y una suscripción a X Premium+. En julio de 2026, xAI también lanzó complementos para Excel, Outlook y Google Workspace, además de Automations programadas; la mayoría son gratis, mientras que el complemento de Outlook y las Automations activadas por correo electrónico están reservadas para usuarios de pago.
Grok también está incluido en las suscripciones de X: X Premium ($8/mes) es la vía de pago más barata para usar Grok dentro de la aplicación X e incluye estado verificado y menos anuncios. X Premium+ ($40/mes) elimina los anuncios en toda X y ofrece los límites de uso más altos de Grok, junto con la monetización completa para creadores.
Moonshot IA (Kimi)
Los planes de consumo de Kimi reciben nombres de indicaciones de tempo musical, del más lento al más rápido. Los precios internacionales están en USD; los usuarios chinos pagan en CNY a tarifas más bajas. A fecha de agosto de 2026, las nuevas compras están en lista de espera. La página de precios anuncia próximos planes que separan los beneficios de Kimi y Kimi Code, y el aviso de Moonshot del 20 de julio cita limitaciones de capacidad informática para su lanzamiento retrasado, cuatro días después del lanzamiento de K3. Los suscriptores actuales mantienen sus planes y pueden renovarlos.
- Adagio (Free) ofrece conversaciones básicas ilimitadas con 6 usos del agente, consultas limitadas de Deep Research y tareas básicas del agente OK Computer.
- Moderato ($19/mes) añade Kimi K3 en el chat y en tareas de agentes, además de sesiones ampliadas de Deep Research. Aplicaciones incluidas: Kimi Code (agente de programación de IA centrado en la terminal; entre 300 y 1.200 solicitudes estimadas por ventana de 5 horas, facturadas del grupo de créditos compartido), además de herramientas de creación de Slides y Websites.
- Allegretto ($39/mes) ofrece un mayor uso en todo lo de Moderato. Aplicaciones incluidas: Agent Swarm (orquestación de subagentes en paralelo, hasta 4 subtareas paralelas en este nivel), implementación en la nube de Kimi Claw para grupos heterogéneos de agentes con memoria persistente y 2x los créditos de agente de Moderato.
- Allegro ($99/mes) ofrece 5x créditos de agente, Agent Swarm con hasta 8 subtareas paralelas y chat con K3 con hasta 1M tokens de contexto.
- Vivace ($199/mes) ofrece 10x créditos de agente, 4 tareas simultáneas, Agent Swarm con hasta 8 subtareas paralelas y chat con K3 con hasta 1M tokens de contexto, orientado a cargas de trabajo pesadas de investigación y agénticas.
La membresía incluye claves de API de Kimi Code para usar en herramientas de programación de terceros; la API independiente de Kimi Open Platform se factura por token.
MiniMax
MiniMax vende un único Token Plan unificado sobre sus modelos M3 y M2.7. Sustituyó a los anteriores planes de crédito de agente y al plan de programación a mediados de 2026.
MiniMax Token Plan (una cuota para agentes, programación y trabajo multimodal):
- Plus ($20/mes): ventanas de cuota renovables de 5 horas y semanales, suficientes para 3 o 4 agentes de programación en paralelo; para proyectos personales y creación de prototipos.
- Max ($50/mes): las mismas ventanas para 4 o 5 agentes en paralelo; para programación diaria con agentes y trabajo multimodal.
- Ultra ($120/mes): de 6 a 7 agentes en paralelo; para flujos de trabajo de agentes pesados y sesiones prolongadas.
- Paquetes de crédito: $5 por 5.000 créditos, $25 por 25.000, $100 por 100.000 (1.000 créditos = $1, válidos 365 días), utilizables además de cualquier plan.
El Token Plan cubre toda la gama de modelos (M3, M2.7, imagen y voz) en una única cuota, lo que lo convierte en una de las vías más baratas para acceder a un modelo de programación fronterizo cuando se combina con una CLI como Cline o Kilo Code.
Mistral AI
El plan gratuito de Mistral Vibe (antes Le Chat) incluye navegación web, análisis básico de archivos, generación de imágenes, sesiones de programación limitadas, más de 100 conectores y $10/mes en créditos de API.
- Plan Pro ($14,99/usuario/mes) incluye más mensajes y búsquedas web, más informes de pensamiento extendido y Deep Research, 15 GB de almacenamiento de documentos, hasta 1.000 proyectos, generación de imágenes y $30/mes en créditos de API. Aplicaciones incluidas: el modo Code de Mistral Vibe en la CLI, el IDE o la web, con pago por uso más allá de la cuota incluida. Los estudiantes verificados obtienen Pro por $5,99/mes.
- Plan Team ($24,99/usuario/mes) incluye todo lo de Pro con hasta 30 GB de almacenamiento por usuario, facturación central, control de acceso basado en roles, verificación de nombre de dominio y exportación de datos. Aplicaciones incluidas: Mistral Vibe en el nivel de uso de equipo con controles de administración compartidos.
- Plan Enterprise (precio personalizado) ofrece opciones de implementación seguras, incluidas nube privada y autoalojada, SAML SSO, registros de auditoría, soporte premium y analítica detallada. Aplicaciones incluidas: Mistral Vibe con opciones de implementación local para cargas de trabajo reguladas.
DeepSeek
DeepSeek no ofrece planes de suscripción tradicionales. El acceso por chat web y móvil a los últimos modelos (actualmente DeepSeek V4-Flash y V4-Pro) es gratis para todos los usuarios, con una limitación por uso justo.
La API se factura por token con tarifas punta y valle desde el 16 de agosto de 2026. Fuera de punta, V4-Flash cuesta $0,22 por millón de tokens de entrada (fallo de caché) y $0,66 por millón de tokens de salida; las tarifas en horas punta son el doble ($0,44 y $1,32). V4-Pro cuesta $0,66 y $1,98 fuera de punta. Los aciertos de caché cuestan aproximadamente el 3 % de la tarifa de fallo, y las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC entre semana.
DeepSeek también ha entrado en el ámbito de las herramientas para agentes. DeepSeek Harness, un kit de herramientas de código abierto basado en complementos para crear y ejecutar agentes de IA, está en vista previa para desarrolladores con código fuente público. No tiene precio propio y es independiente del modelo; el uso se factura según la API del modelo al que llame el agente.
Meta (Muse Spark)
Meta IA sigue siendo gratis en WhatsApp, Instagram, Facebook, Messenger, la aplicación Meta IA y las gafas Ray-Ban Meta, impulsada por Muse Spark (lanzado el 8 de abril de 2026, ahora en la versión 1.2). Meta ha comenzado a probar de forma limitada las suscripciones de pago Meta One. Los planes Plus y Premium aumentan la asignación mensual de uso de IA y el acceso al modo Thinking, con precios comunicados de $7,99 y $19,99 al mes.1
El modelo Meta API está en vista previa pública, es de autoservicio y compatible con el SDK de OpenAI. El precio de pago por uso de Muse Spark 1.2 comienza en $1,25 por millón de tokens de entrada y $4,25 por millón de tokens de salida, con una ventana de contexto de 1M tokens. Muse Code, un agente de programación para terminal, se lanzó en beta el 5 de agosto de 2026.
Comprender los precios de LLM
Tokens: la unidad fundamental de precios
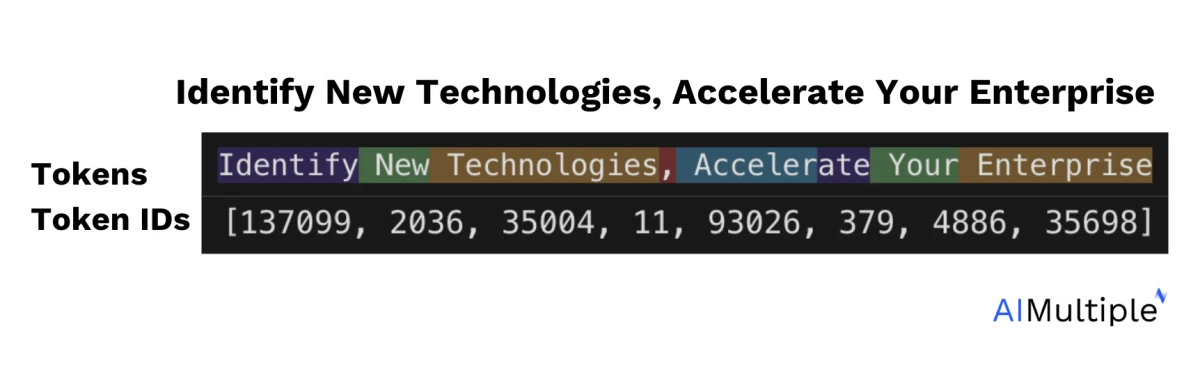
Figura 1: Ejemplo de tokenización con el tokenizador de GPT-4o y GPT-4o mini para la frase “Identifique nuevas tecnologías, acelere su empresa.”2
Aunque los proveedores ofrecen una variedad de estructuras de precios, la tarificación por token es la más habitual. Los métodos de tokenización varían según el modelo; algunos ejemplos son:
- Byte-Pair Encoding (BPE): Divide las palabras en unidades de subpalabras frecuentes, equilibrando el tamaño del vocabulario y la eficiencia.3
- Ejemplo: “unbelievable” → [“un”, “believ”, “able”]
- WordPiece: Similar a BPE, pero optimiza la probabilidad del modelo de lenguaje; se utiliza en BERT.4
- Ejemplo: “tokenization” → [“token”, “##ization”]. “token” es una palabra independiente; “##ization” es un sufijo.
- SentencePiece: Tokeniza el texto sin depender de espacios, eficaz para modelos multilingües como T5.5
- Ejemplo: “natural language” → [” natural”, ” lan”, “guage”] o [” natu”, “ral”, ” language”].
Tenga en cuenta que las subpalabras exactas dependen de los datos de entrenamiento y del proceso BPE/WordPiece. Para comprender mejor estos métodos de tokenización, vea el siguiente vídeo:
Una vez entendida la tokenización, se puede estimar un precio medio en función de la longitud de tokens del proyecto. La tabla 2 describe los rangos de tokens por tipo de contenido, incluidos los prompts de interfaz de usuario, fragmentos de correo electrónico, blogs de marketing, informes detallados y artículos de investigación, y señala que el número de tokens varía según el modelo. Una vez elegido un modelo, se puede utilizar su tokenizador para estimar el número medio de tokens del contenido.
Tabla 2: Tipos de contenido habituales, sus rangos de tamaño y consideraciones empresariales (los rangos son estimaciones y pueden variar).
Implicaciones de la ventana de contexto
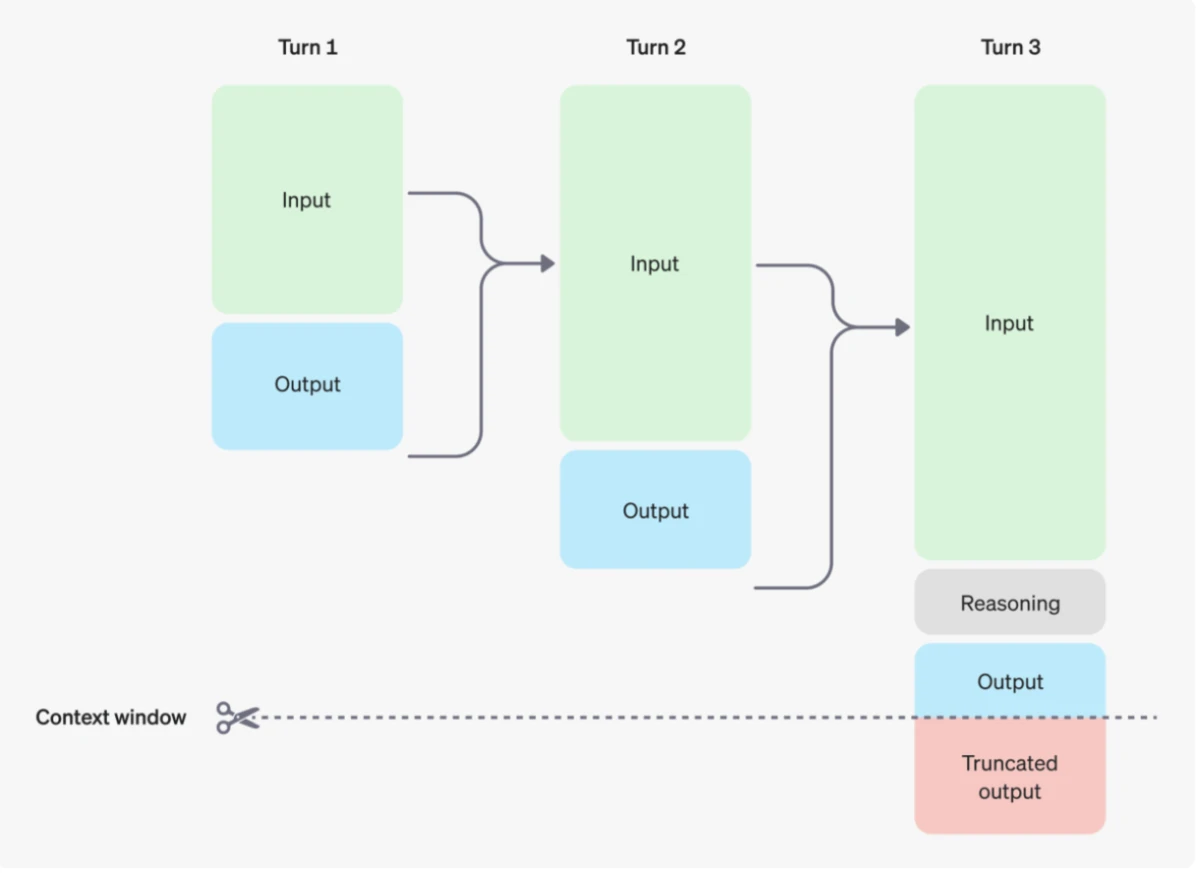
La ventana de contexto establece un límite estricto en el número de tokens de entrada y salida por llamada, incluidos los tokens que utilizan los modelos de razonamiento para el razonamiento de cadena de pensamiento. Si el total supera este límite, la respuesta se trunca o la solicitud falla por completo.
Figura 2: Ilustración de las limitaciones de la ventana de contexto que provocan el truncamiento de la salida en una conversación de varios turnos.6
En las aplicaciones que mantienen conversaciones largas, cada turno adicional introduce más historial en la entrada. Sin intervención, los tokens de entrada crecen de forma lineal con la duración de la conversación, y la factura también. Los usuarios de la API suelen abordar esto de una de estas tres maneras:
- Almacenamiento en caché de prompts. OpenAI, Anthropic, Google y DeepSeek almacenan en caché los prefijos de prompt repetidos en el servidor y facturan los aciertos de caché a una fracción de la tarifa de entrada estándar, normalmente entre el 3 y el 10 por ciento del precio de fallo de caché. Para las aplicaciones que reutilizan un prompt de sistema largo o un prefijo de conversación, el almacenamiento en caché puede reducir el coste de entrada en un orden de magnitud.
- Ventana deslizante o generación aumentada por recuperación (RAG). Elimine los turnos más antiguos una vez que se alcance un umbral, o recupere solo los mensajes pasados relevantes de un almacén vectorial en cada llamada.
- Resumen. Condense periódicamente los turnos más antiguos en un resumen en lugar de reenviarlos literalmente.
Para cargas de trabajo agénticas, como sesiones de programación o investigación profunda, los agentes de programación modernos gestionan esto automáticamente en la sesión. Claude Code, por ejemplo, incluye compactación de contexto: cuando la conversación se acerca al límite, resume los mensajes más antiguos en una versión condensada y mantiene intactos los turnos recientes. Los turnos posteriores solo envían al modelo el resumen más el contexto reciente.
El impacto en el precio es directo. En las API de pago por token, la compactación limita el crecimiento de la entrada de cada llamada y el almacenamiento en caché reduce el precio del prefijo repetido, de modo que el coste por turno sigue siendo predecible en sesiones largas. En suscripciones de tarifa plana como Claude Pro, ChatGPT Plus o Kimi Moderato, la compactación amplía los límites de uso diarios y semanales porque cada llamada lleva menos contexto. Una sesión de programación que de otro modo agotaría un límite de velocidad de 5 horas puede durar más cuando los turnos antiguos se comprimen.
La contrapartida es que cualquier forma de resumen implica pérdida de información. El resumen puede omitir detalles que más tarde resultan importantes, lo que obliga al usuario a volver a proporcionarlos
Tokens máximos de salida
El límite de tokens máximos de salida limita la longitud de la respuesta de un modelo. Aunque mucha documentación menciona que se puede ajustar mediante el parámetro max_tokens, es fundamental revisar la documentación de la API específica que se esté utilizando para identificar el parámetro correcto. Debe ajustarse según las necesidades concretas:
Si se ajusta demasiado bajo, puede dar lugar a salidas incompletas, haciendo que el modelo corte las respuestas antes de ofrecer la respuesta completa.
Si se ajusta demasiado alto, en función de la temperatura (un parámetro que controla la creatividad de la respuesta), puede dar lugar a salidas innecesariamente extensas, tiempos de respuesta más largos y un mayor coste.
Por lo tanto, es un parámetro que requiere una consideración cuidadosa para optimizar el uso de los recursos y, al mismo tiempo, equilibrar la calidad de la salida, el coste y el rendimiento.
Tabla 3: Ejemplos de prompts de entrada y recuentos de tokens estimados por tipo de contenido.
*Esto supone que cada modelo produce respuestas con el mismo número de tokens de salida, aunque el recuento de tokens tanto de entrada como de salida puede variar según la tokenización de cada modelo; aquí el número se ha mantenido constante para cada modelo.
Combinar los rangos de tokens de la tabla 2 con las tarifas por token de un modelo da el coste esperado por tipo de contenido; los prompts de ejemplo de la tabla 3 muestran los tamaños de entrada y salida que hay detrás de esas estimaciones.
Uso de varios modelos de lenguaje
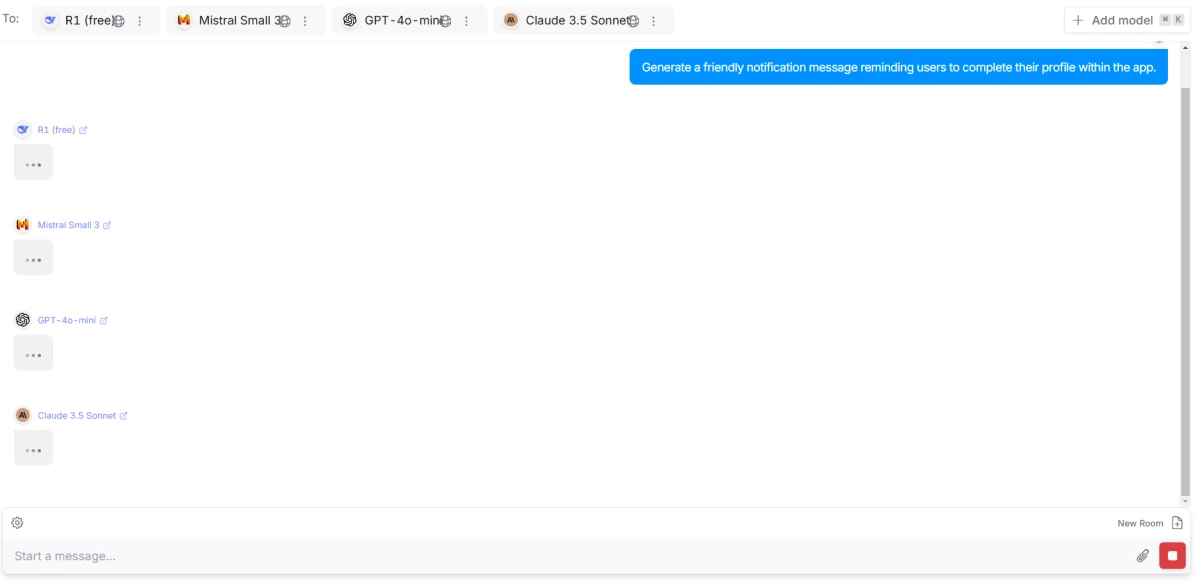
Una puerta de enlace de IA como OpenRouter permite enviar el mismo prompt a varios modelos simultáneamente. A continuación, se pueden comparar las respuestas, el consumo de tokens, el tiempo de respuesta y el precio para determinar qué modelo es el más adecuado para la tarea.
Figura 3: Interfaz que muestra un prompt enviado a varios modelos de lenguaje de gran tamaño a través de OpenRouter.7
Beneficios y retos
- Mayor adaptabilidad y eficiencia: La orquestación mejora la capacidad de respuesta, permite evaluar en tiempo real la eficiencia de los modelos e identificar un modelo rentable y posibles ahorros.
- Sensibilidad y optimización de los prompts: Los mismos prompts pueden producir resultados muy diferentes entre modelos, lo que hace necesaria una ingeniería de prompts adaptada a cada modelo para lograr los resultados deseados, lo que añade complejidad de desarrollo y mantenimiento.
Mecánica de precios & costes ocultos
Tokens de razonamiento frente a tokens de salida
Un número cada vez mayor de proveedores ha introducido modelos de razonamiento que consumen cómputo adicional para realizar internamente un razonamiento de cadena de pensamiento. OpenAI, Anthropic y Google facturan esos tokens de razonamiento como tokens de salida a la tarifa de salida estándar del modelo, por lo que el aumento del coste proviene del volumen, no de un precio por token más alto.
Modelos como GPT-5.5 Pro, Claude Opus 5 con pensamiento extendido o Gemini 3.1 Pro Deep Think generan trazas de razonamiento internas
incluso cuando no las solicitas explícitamente. Estos tokens internos cuentan para la factura y pueden aumentar sustancialmente el coste, especialmente en tareas analíticas largas como la revisión legal, el análisis de datos o el razonamiento de varios pasos.
Por lo tanto, es esencial:
- Elegir un modelo de razonamiento solo cuando la precisión supere con creces el coste.
- Desactivar la cadena de pensamiento o establecer un recuento máximo de tokens de salida más corto cuando sea posible.
- Probar la misma tarea en modelos sin razonamiento para ver si el rendimiento es comparable a una fracción del precio.
Dado que un modelo de razonamiento puede emitir entre 10 y 30 veces más tokens de salida que los que produciría el mismo prompt sin razonamiento, es fundamental comprender esta diferencia para planificar los costes.
Diferencias de precios derivadas de la arquitectura
Las arquitecturas de LLM influyen directamente en la eficiencia del modelo y, por lo tanto, en el precio de la API. Por ejemplo:
- Mezcla de expertos (MoE): los modelos activan solo un subconjunto de parámetros por solicitud, lo que reduce el coste de cómputo y permite a los proveedores ofrecer tarifas por token más bajas.
- Decodificación especulativa: combina un modelo de borrador más pequeño con uno más grande, lo que mejora el rendimiento y reduce el coste en tareas deterministas.
- Variantes cuantizadas (por ejemplo, de 4 u 8 bits) pueden realizar inferencia con menor precisión, lo que permite precios más bajos en versiones desplegadas localmente o alojadas en la nube.
Comprender estas opciones de arquitectura ayuda a los usuarios a predecir no solo las diferencias de precio, sino también la latencia, la calidad y cómo escala un modelo con cargas de trabajo en producción.
Costes operativos más allá de las tarifas de la API
Aunque la tarificación por token es el principal factor de coste, muchas implementaciones en producción incurren en costes adicionales más allá del uso de la API:
- Embeddings y bases de datos vectoriales: almacenar y recuperar vectores (por ejemplo, Pinecone, Weaviate, ChromaDB) añade coste por consulta y por GB de almacenamiento.
- Modelos de reordenación y posprocesamiento: muchas aplicaciones utilizan modelos más pequeños para resumir, filtrar o clasificar antes de enviar una solicitud final a un modelo más grande.
- Capas de almacenamiento en caché: proveedores como OpenAI ya ofrecen almacenamiento en caché a nivel de prompt, pero la infraestructura de caché local puede requerir cómputo adicional.
- Registro, supervisión y auditoría: las empresas suelen incurrir en costes de supervisión a nivel de token, seguimiento de latencia y auditorías de seguridad.
Estos costes ocultos suelen representar entre el 20 y el 40 % de los gastos operativos totales de LLM y deben tenerse en cuenta al evaluar las estructuras de precios.
 Añadir como fuente preferida
Consideraciones de precios específicas para empresas
Muchos proveedores de LLM cobran tarifas adicionales por funciones de seguridad y cumplimiento de nivel empresarial, como:
- Implementaciones de inquilino único
- Clústeres de GPU dedicados
- SLA mejorados (por ejemplo, garantías de tiempo de actividad y latencia)
- Residencia de datos y controles regionales
- Modos de cumplimiento SOC2, HIPAA o RGPD
Estas ofertas pueden aumentar considerablemente los costes, pero son esenciales para sectores regulados como la sanidad, las finanzas, los servicios jurídicos y las instituciones públicas.
Tendencias futuras en los precios de LLM
Tres factores definieron los precios de los LLM en 2025: los modelos básicos se abarataron, casi todos los grandes proveedores lanzaron una suscripción de chat y los modelos de razonamiento siguieron siendo caros. La brecha es estructural y probablemente se amplíe: un millón de tokens de salida cuesta $0,66 en DeepSeek V4-Flash (fuera de punta) y $180 en GPT-5.5 Pro. Las preguntas interesantes a partir de 2026 se refieren a lo que cambie sobre esa base.
La facturación por token da paso a la tarificación por tarea
Los agentes impulsan ahora la mayor parte del uso intensivo de LLM. Una sola tarea de programación con Claude Code, una ejecución de investigación con Cowork o una sesión de navegación autónoma con Operator pueden realizar cientos de llamadas a modelos secuenciales. La facturación por token se vuelve impredecible tanto para el comprador como para el vendedor.
En respuesta, los proveedores están pasando de los contadores de tokens a las cuotas por tarea y por sesión. Moonshot estima entre 300 y 1.200 solicitudes de Kimi Code por ventana de 5 horas desde un grupo de créditos compartido. Claude Code limita el uso por sesión de 5 horas, en lugar de por mensaje. MiniMax establece las cuotas de Token Plan como ventanas renovables de 5 horas y semanales dimensionadas por el número de agentes de programación en paralelo. Kimi establece límites específicos por nivel en los subagentes paralelos de Agent Swarm.
Los arneses de agentes multiproveedor, como OpenClaw y MaxHermes, llevan esto más lejos. Se sitúan entre los usuarios y las API de varios modelos, y sus precios siguen cada vez más el rendimiento por tarea en lugar de por millón de tokens. Es de esperar que más proveedores publiquen SKU por tarea o por sesión durante el próximo año.
Los modelos de razonamiento pequeños se trasladan al dispositivo
Apple Intelligence ejecuta la inferencia en el dispositivo para consultas rutinarias y solo recurre a Private Cloud Compute en solicitudes complejas. Los PC Copilot+ de Microsoft incluyen un modelo local. Los dispositivos Pixel ejecutan Gemini Nano. Los modelos pequeños recientes, como Microsoft con Phi-4 y Google con Gemma 3, son capaces de razonar en tamaños que caben en la unidad de procesamiento neuronal de un teléfono o portátil.
La implicación para los precios es un mercado de consumo de dos niveles. El trabajo rutinario se ejecuta gratis al coste marginal del token en el dispositivo. Las suscripciones en la nube compiten en lo que el ámbito local no puede hacer: razonamiento de frontera, contexto amplio, generación multimodal y orquestación de agentes. El suelo gratis local empuja las suscripciones solo de chat hacia cero, dejando las aplicaciones incluidas como la verdadera razón para pagar.
El contexto largo y la memoria deciden quién gana el trabajo agéntico
Las tareas agénticas de horizonte largo fallan cuando los modelos pierden el hilo de las instrucciones anteriores o alucinan hechos que deberían recordar. El trabajo agéntico sostenido depende de tres factores: una ventana de contexto amplia, memoria persistente y una baja tasa de alucinación.
En un año, tres capacidades de vanguardia han convergido hacia la línea de base. Claude Opus 5, Gemini 3.1 Pro, GPT-5.6 y Kimi K3 ofrecen ventanas de contexto de 1M tokens. En OpenAI, Anthropic, Google y DeepSeek, los aciertos de caché cuestan entre el 3 y el 10 por ciento de los fallos de caché. ChatGPT y Claude ahora incluyen memoria persistente en sus niveles gratis.
Están surgiendo modelos agénticos especializados en la parte alta de este mercado. En junio de 2026, Anthropic lanzó Claude Fable 5, un modelo de clase Mythos disponible de forma general8, con un precio de $10 por entrada y $50 por salida por millón de tokens, el doble de la tarifa de Opus 5. Fable 5 está orientado a la programación agéntica, el uso del ordenador y la investigación de largo horizonte; Claude Mythos 5, el mismo modelo con salvaguardas relajadas en algunos ámbitos, sigue limitado a socios aprobados al mismo precio.
La cuestión competitiva pasa de «¿cómo de grande es la ventana de contexto?» a «¿con qué economía y fiabilidad puede el modelo sostener una tarea agéntica larga?» Los proveedores que lo resuelvan bien impondrán precios superiores. Los que no lo hagan perderán cargas de trabajo agénticas independientemente del precio por token anunciado.
Preguntas frecuentes
Acceder a modelos de lenguaje de gran tamaño (LLM) a través de una interfaz de programación de aplicaciones (API) le otorga acceso remoto a los modelos de IA. Este acceso está sujeto a una tarifa, a menudo denominada «tarifa de API», que cobra el proveedor del servicio. Esta tarifa es una consideración fundamental al integrar LLM en sus aplicaciones.
Representa el coste asociado a cada consulta, solicitud o tarea realizada a través de la API del proveedor. Dado que las estructuras de precios pueden variar ampliamente (en función de factores como el uso de tokens, el volumen de llamadas a la API, la utilización de funciones o los modelos de suscripción), es esencial comprender cómo calculan los proveedores estos costes.
La tarificación de la LLM API puede ser compleja debido a factores como el consumo de tokens, la longitud del contexto y la elección del modelo. Los procedimientos de tokenización varían entre modelos; algunos utilizan Byte-Pair Encoding (BPE), WordPiece o SentencePiece, y cada uno influye en cómo se divide el texto en tokens y afecta a la eficiencia de costes. Comprender estas diferencias ayuda a optimizar el uso y el precio de la API.
Los costes de los LLM están determinados principalmente por el uso de tokens (tanto de entrada como de salida), el volumen de llamadas a la API y el modelo de precios (por ejemplo, por token o por suscripción).
Compare los precios de los tokens de entrada y salida, los límites de la ventana de contexto y cualquier tarifa adicional. Herramientas como OpenRouter le permiten enviar el mismo prompt a varios modelos y comparar directamente sus resultados, uso de tokens, velocidad y precio. Tenga en cuenta la longitud habitual de su contenido y sus patrones de uso para estimar los costes totales.
Los tokens de entrada son los tokens del prompt que envía al LLM, mientras que los tokens de salida son los tokens de la respuesta generada. En los modelos de razonamiento, los tokens generados durante el propio proceso de razonamiento también se cuentan como tokens de salida, lo que afecta al coste final. Tanto la entrada como la salida contribuyen al coste total.
Las solicitudes de texto más grandes requieren más procesamiento, lo que aumenta el tiempo de respuesta y los costes. Optimice el tamaño de las entradas y utilice una calculadora de precios de LLM API para estimar el recuento de tokens y gestionar su presupuesto de forma eficaz.
La comunidad de LLM ha desarrollado diversas herramientas y benchmarks para ayudar a los usuarios a comprender y optimizar los precios de los LLM. Estos recursos suelen incluir calculadoras y tablas comparativas que ofrecen información sobre la potencia y la eficiencia de los diferentes modelos.
Plataformas como Hugging Face y GitHub alojan herramientas y código desarrollados por la comunidad para analizar el rendimiento y los costes de los modelos. Muchos servicios ofrecen soporte comunitario a través de foros o funciones de chat.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem},
  title  = {{Precios de LLM: comparativa de los 15+ principales proveedores}},
  year   = {2026},
  month  = aug,
  howpublished    = {\url{https://aimultiple.com/llm-pricing}},
  note   = {AIMultiple. Recuperado el 26 de agosto de 2026}
}Resultados y marcas de tiempo de 285 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 6 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
8 actualizacionesActualizada la descripción del gráfico en la introducción.
Se añadió un gráfico a la sección de tipos de precios de LLM.
Se eliminó la sección 'Comprender los precios de LLM'.
Se amplió la sección "Implicaciones de la ventana de contexto" con estrategias para gestionar el uso de tokens en conversaciones largas.
Se añadió ChatGPT Go a la sección de OpenAI.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.




Comentarios 1
Comparte tus ideas
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.
"Really well-written and timely article! Your analysis of how different large language model (LLM) providers compare - based on token pricing, context window, and performance - really helps demystify an often opaque cost structure. I found the detailed breakdown of token-based billing (input vs output tokens), context-window implications, and the built-in “price calculator” particularly useful for anyone trying to realistically estimate LLM usage