


15 Herramientas de observabilidad de agentes de IA: AgentOps y Langfuse

Probamos 15 plataformas de observabilidad para aplicaciones LLM y agentes de IA. Cada plataforma se implementó de forma práctica mediante la configuración de flujos de trabajo, la configuración de integraciones y la ejecución de escenarios de prueba. Evaluamos comparativamente 4 herramientas de observabilidad para medir si introducen sobrecarga en los pipelines de producción. También demostramos un LangChain tutorial de observabilidad con Langfuse.
Benchmark de sobrecarga de herramientas de monitoreo agéntico
Integramos cada plataforma de observabilidad en nuestro sistema multiagente de planificación de viajes y ejecutamos 100 consultas idénticas para medir su sobrecarga de rendimiento en comparación con una línea base sin instrumentación. Lea nuestra metodología de benchmark.
- LangSmith demostró una eficiencia excepcional sin prácticamente ninguna sobrecarga medible, lo que lo hace ideal para entornos de producción críticos en rendimiento.
- Laminar introdujo una sobrecarga mínima del 5 %, lo que lo hace muy adecuado para entornos de producción donde el rendimiento es crítico.
- AgentOps y Langfuse mostraron una sobrecarga moderada del 12 % y 15 % respectivamente, lo que representa un equilibrio razonable entre las funciones de observabilidad y el impacto en el rendimiento. Estas plataformas siguen manteniendo una latencia aceptable para la mayoría de los casos de uso en producción.
Posibles razones detrás de las diferencias de rendimiento
Nuestro benchmark indica que las diferencias de latencia están impulsadas por la profundidad de la instrumentación y la participación en la ruta de ejecución, particularmente en flujos de trabajo multiagente. Las herramientas que ofrecen una observabilidad más profunda a nivel de paso mostraron una mayor sobrecarga, mientras que los enfoques de trazado más ligeros permanecieron más cerca de la línea base.
1. Profundidad de instrumentación en la ruta de ejecución
Las herramientas de observabilidad añaden lógica al flujo de ejecución del agente para capturar trazas y metadatos. Cuando esta lógica se ejecuta de forma síncrona durante el manejo de solicitudes, aumenta directamente la latencia de extremo a extremo porque el agente debe completar este trabajo adicional antes de devolver una respuesta.
Por ejemplo:
- LangSmith añadió prácticamente ninguna sobrecarga medible (~0 %), lo que indica poco trabajo síncrono,
- La instrumentación más profunda a nivel de paso de Langfuse contribuyó a una mayor sobrecarga (~15 %).
2. Amplificación de eventos en pipelines de múltiples pasos
En los sistemas multiagente, una sola solicitud de usuario desencadena múltiples acciones del agente. Cuando una herramienta registra datos detallados en cada paso, el número total de eventos crece rápidamente, lo que aumenta la sobrecarga de procesamiento y gestión de trazas a medida que el flujo de trabajo se vuelve más profundo.
En los resultados del benchmark:
- Langfuse y AgentOps generaron una sobrecarga notablemente mayor (15 % y 12 %) en nuestro flujo de trabajo de planificación de viajes de múltiples pasos
- LangSmith y Laminar emitieron menos eventos por paso del agente.
3. Sobrecarga de evaluación y validación en línea
Algunas plataformas realizan comprobaciones o monitoreo adicionales mientras el agente se está ejecutando. Aunque cada comprobación es ligera, aplicarlas repetidamente en todos los pasos del agente añade una latencia medible.
Por ejemplo:
- El monitoreo a nivel de ciclo de vida de AgentOps coincidió con una sobrecarga del 12 %
- Laminar no mostró evidencia de que la evaluación en línea afectara la ejecución, y se mantuvo en ~5 %.
4. Frecuencia de serialización y persistencia
Capturar datos detallados de observabilidad requiere serializar trazas y escribirlas en almacenamiento o backends externos. Un mayor detalle de trazas aumenta la frecuencia con la que esto ocurre, añadiendo sobrecarga de E/S a cada solicitud.
En nuestro benchmark:
- El trazado detallado de prompts, salidas y tokens de Langfuse resultó en la mayor sobrecarga (~15 %)
- Los artefactos de traza más ligeros de LangSmith permanecieron cerca de la línea base.
5. Grado de integración con el framework del agente
El grado de integración de una herramienta con el framework del agente afecta al rendimiento. Las integraciones más estrechas reducen los pasos de traducción y orquestación, mientras que los SDK más genéricos añaden capas de procesamiento adicionales.
Por ejemplo:
- La estrecha alineación de LangSmith con la ejecución del agente se correlacionó con ~0 % de sobrecarga
- AgentOps y Langfuse mostraron un mayor impacto en la latencia, consistente con rutas de integración más desacopladas.
Plataformas de observabilidad de agentes de IA
Nivel 1: Observabilidad detallada de LLM y prompt / salida
* Las capacidades enumeradas en estas columnas son ejemplos ilustrativos de lo que cada herramienta puede monitorear cuando se amplía mediante integraciones o personalización. No son exclusivas de una única plataforma.
Nivel 2: Observabilidad de flujo de trabajo, model y evaluación
Nivel 3: Observabilidad de ciclo de vida y operaciones del agente
Nivel 4: Monitoreo de sistemas e infraestructura (no nativo para agentes)
Datadog (con su módulo de observabilidad de LLM) y Prometheus (mediante exportadores) se utilizan cada vez más junto con Langfuse/LangSmith.
Plataformas de desarrollo y orquestación de agentes:
- Herramientas como Flowise, Langflow, SuperAGI y CrewAI permiten crear, orquestar y optimizar flujos de trabajo de agentes con interfaces sin código o de bajo código.
Ediciones gratis de implementación y precios
Las ediciones gratis varían según los límites de uso (p. ej., observaciones, trazas, tokens o unidades de trabajo). Los precios iniciales suelen corresponder a un plan básico, que puede tener restricciones de funciones, usuarios o límites de uso.
CoreWeave Forge (W&B Weave)
Caso de uso: Depuración de fallos en sistemas multiagente mediante el seguimiento de cómo se propagan los errores entre las llamadas de los agentes.
W&B Weave, parte de CoreWeave Forge (anteriormente Weights & Biases), registra trazas de ejecución estructuradas para sistemas multiagente, preservando las relaciones padre-hijo entre las llamadas de los agentes.
Funciones de monitoreo de Weave
- Trazado jerárquico de agentes en lugar de registros planos de solicitudes
- Atribución de costes y latencia a nivel de agente
- Soporte nativo para evaluadores que se aplican directamente a las trazas.
Capacidades de evaluación
Weave también proporciona evaluadores integrados para la evaluación, entre ellos:
- HallucinationFreeScorer para detectar alucinaciones,
- SummarizationScorer para evaluar la calidad del resumen,
- EmbeddingSimilarityScorer para la similitud semántica,
- ValidJSONScorer y ValidXMLScorer para la validación de formato,
- PydanticScorer para el cumplimiento del esquema,
- OpenAIModerationScorer para la seguridad del contenido,
- evaluadores RAGAS como ContextEntityRecallScorer,
- ContextRelevancyScorer para la evaluación de sistemas RAG.
Ideal para: Equipos que ejecutan flujos de trabajo de varios pasos o multiagente y necesitan análisis de causa raíz a nivel de traza en lugar de métricas superficiales.
Langfuse
Casos de uso: Seguimiento de las interacciones de LLM, gestión de versiones de prompts y monitoreo del rendimiento del model con sesiones de usuario.
Langfuse ofrece una visibilidad profunda de la capa de prompt, capturando prompts, respuestas, costes y trazas de ejecución para ayudar a depurar, monitorear y optimizar aplicaciones LLM.
Sin embargo, Langfuse puede no ser adecuado para equipos que prefieren flujos de trabajo basados en Git para la gestión de código y prompts, ya que su sistema externo de gestión de prompts puede no ofrecer el mismo nivel de control de versiones y colaboración.
Funciones de monitoreo de Langfuse
- Visibilidad de la evolución de los prompts y los patrones de uso
- Análisis basado en sesiones adecuado para aplicaciones orientadas al usuario
- Modelo práctico de metadatos y etiquetado para filtrado y revisión
Funciones de nivel empresarial:
Algunas de estas funciones incluyen:
- Niveles de registro: Ajusta la verbosidad de los registros para obtener información más detallada.
- Multimodalidad: Admite texto, imágenes, audio y otros formatos para aplicaciones LLM multimodales.
- Versiones y control de versiones: Sigue el historial de versiones y observa cómo afectan las nuevas versiones al rendimiento del model.
- URLs de trazas: Accede a trazas detalladas mediante URLs únicas para una inspección y depuración adicionales.
- Grafos de agentes: Visualiza las interacciones y dependencias de los agentes para comprender mejor su comportamiento.
- Muestreo: Recopila datos representativos de las interacciones para analizarlos sin saturar el sistema.
- Seguimiento de tokens y costes: Haz un seguimiento del uso de tokens y de los costes de cada llamada al model, garantizando una gestión eficiente de los recursos.
- Enmascaramiento: Protege los datos confidenciales enmascarándolos en las trazas, garantizando la privacidad y el cumplimiento.
Ideal para: Equipos que iteran sobre prompts y monitorean el uso en producción, especialmente donde las sesiones de usuario importan.
Galileo
Casos de uso: Monitorear el costo y la latencia, evaluar la calidad de las salidas, bloquear respuestas inseguras y proporcionar correcciones prácticas.
Galileo realiza un seguimiento de métricas de costo, latencia y calidad de salida, aplicando a la vez comprobaciones de seguridad y cumplimiento en tiempo real.
La plataforma combina observabilidad tradicional (latencia, costo, rendimiento) con depuración y evaluación impulsadas por IA (detección de alucinaciones, corrección fáctica, coherencia y adherencia al contexto).
Funciones de monitoreo de Galileo
- Identificación de modos de fallo más allá de los errores superficiales (p. ej., alucinaciones que conducen a entradas de herramientas no válidas)
- Retroalimentación prescriptiva, como cambios de prompt sugeridos o adiciones de few-shot
- Acoplamiento estrecho entre los resultados de la evaluación y las correcciones recomendadas.
Ideal para: Organizaciones que priorizan la calidad de las salidas, la seguridad y los ciclos de iteración rápidos con corrección guiada.
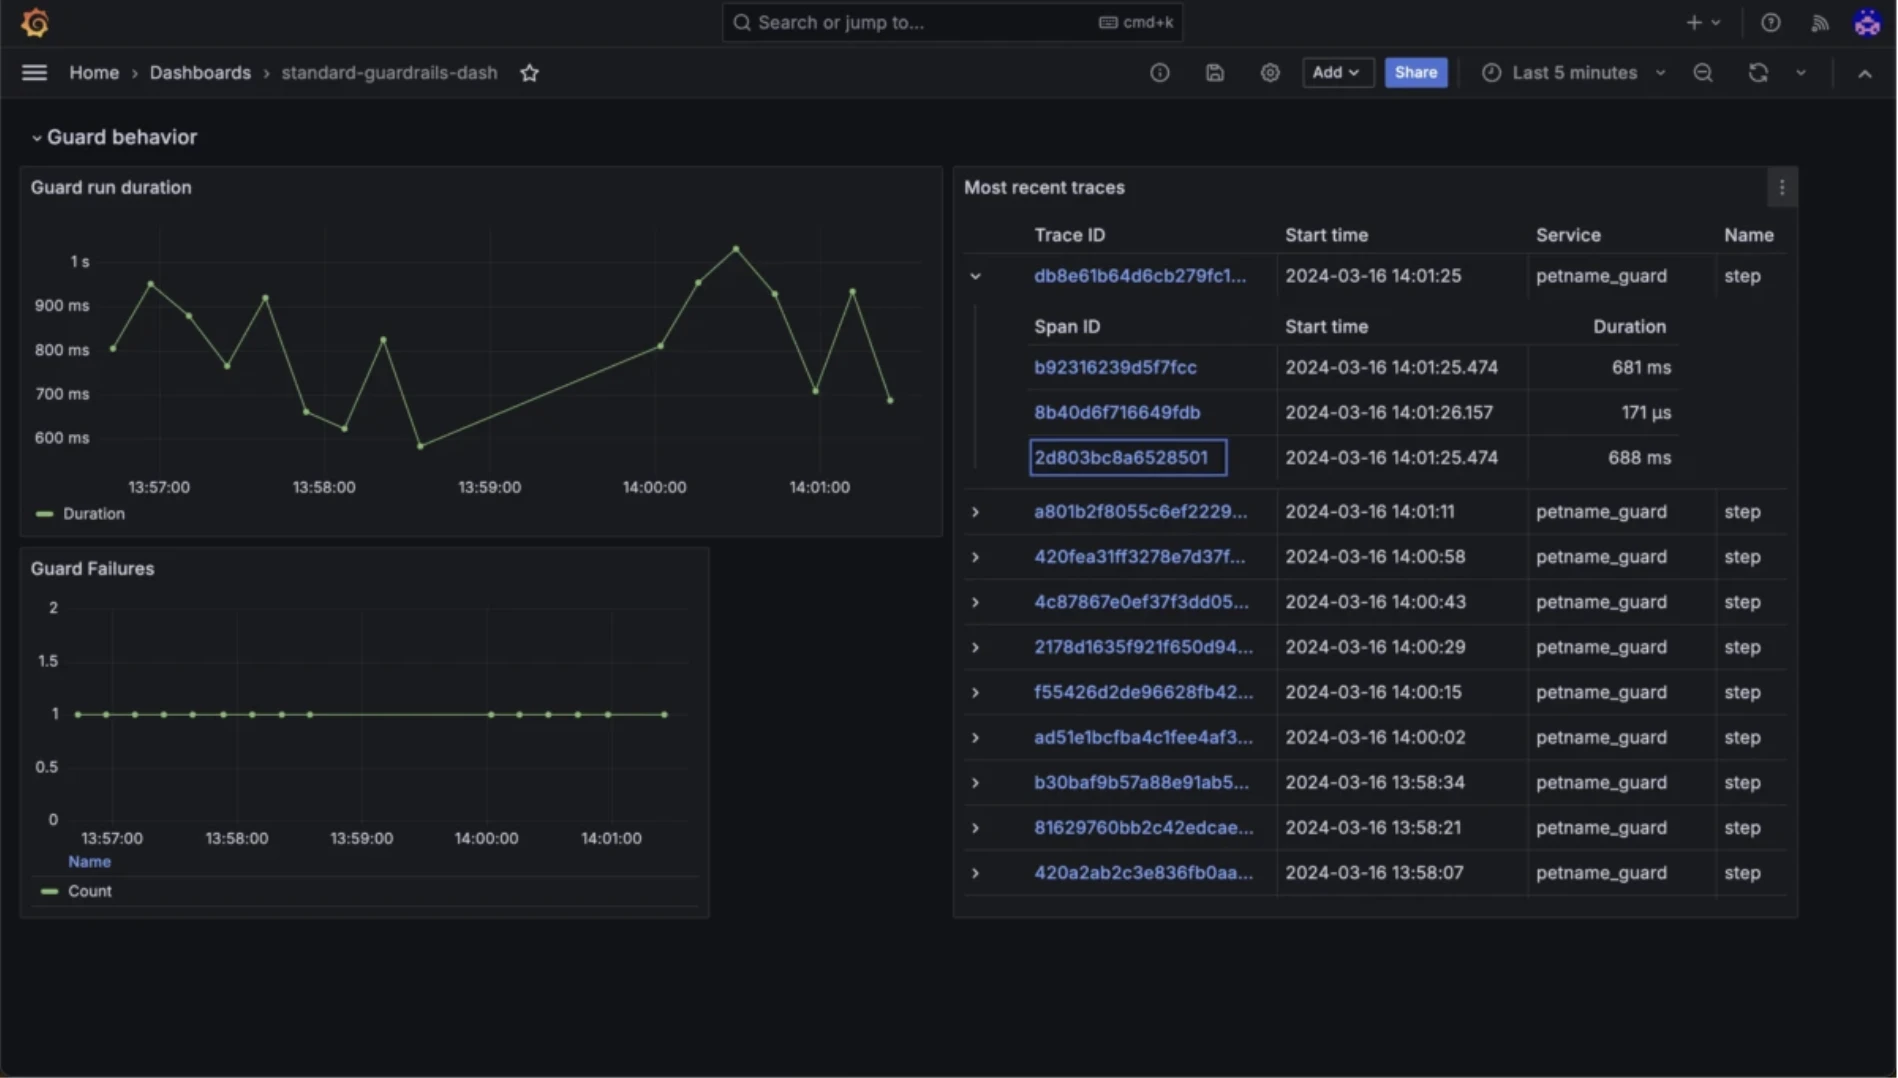
Guardrails AI
Casos de uso: Prevenir salidas dañinas, validar respuestas de LLM y garantizar el cumplimiento de las políticas de seguridad.
Guardrails valida las entradas y salidas de LLM frente a reglas configurables, incluidas la toxicidad, el sesgo, la exposición de PII, las alucinaciones marcadas y el cumplimiento del formato.
Guardrails AI funciones de monitoreo
- Validación determinista mediante especificaciones RAIL
- Guards de entrada para la inyección de prompt y la detección de jailbreak
- Reintentos automáticos cuando falla la validación.
Ideal para
Equipos que deben aplicar garantías estrictas de seguridad, cumplimiento o formato antes de devolver las respuestas.
LangSmith
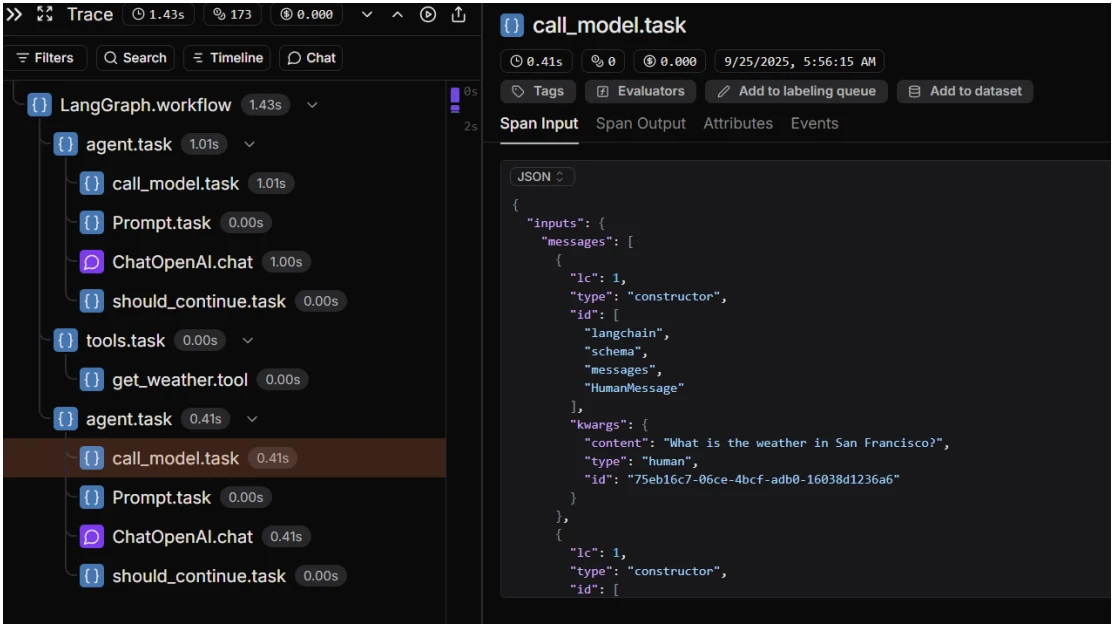
Casos de uso: Depuración del razonamiento del agente y de las llamadas a herramientas (centrado en LangChain)
LangSmith captura trazas de razonamiento completas para agentes basados en LangChain, incluidos prompts, contexto recuperado, lógica de selección de herramientas, entradas/salidas de herramientas, errores y excepciones.
Funciones de monitoreo de LangSmith
- Inspección paso a paso de las rutas de decisión del agente
- Reproducción de ejecuciones y comparación lado a lado entre prompts, models o herramientas
- Integración estrecha con LangChain mediante callbacks.
Ideal para
Equipos que crean con LangChain y necesitan depurar en detalle razonamientos incorrectos o invocaciones de herramientas.
Langtrace IA
Casos de uso: Identificar cuellos de botella de costo y latencia en aplicaciones de LLM
Langtrace realiza un seguimiento de los recuentos de tokens, la duración de ejecución, los costes de API y los parámetros de solicitud en pipelines de LLM mediante trazas compatibles con OpenTelemetry.
Langtrace IA funciones de monitoreo
- Alineación con OpenTelemetry para la integración con backends existentes
- Visibilidad de los factores de costo y latencia por paso
- Control de versiones de prompts ligero y entorno de pruebas.
Ideal para: Equipos que optimizan el rendimiento y el gasto en flujos de trabajo de LLM en lugar de evaluar la calidad de las salidas.
Arize (Phoenix)
Casos de uso: Monitorear la deriva del model, detectar sesgos y evaluar las salidas de LLM con sistemas de puntuación integrales
Phoenix se centra en la deriva del comportamiento, la detección de sesgos y la puntuación de LLM como juez para la relevancia, toxicidad y precisión.
Sin embargo, tiene una mayor sobrecarga de integración en comparación con proxies ligeros y no gestiona el control de versiones de prompts tan bien como las herramientas dedicadas.
Funciones de monitoreo de Phoenix
- Núcleo de código abierto con extensiones empresariales opcionales
- Entorno interactivo de prompts para desarrollo
- Detección de deriva para rastrear cambios de comportamiento a lo largo del tiempo
- Comprobaciones de sesgo para identificar sesgos en las respuestas,
- puntuación de LLM como juez para precisión, toxicidad y relevancia.
Ideal para: Equipos que monitorean el comportamiento del model a largo plazo y el riesgo de regresión en lugar de la iteración de prompts.
Agenta
Casos de uso: Encontrar qué prompt funciona mejor en cada model
Agenta compara las respuestas de los models en términos de costo, latencia y calidad de salida utilizando entradas compartidas y contexto controlado.
Funciones de monitoreo de Agenta
- Evaluación de models lado a lado
- Soporte para la toma de decisiones en preproducción.
Ideal para: Evaluación en etapas tempranas y selección de models.
AgentOps.ai
Casos de uso: Monitorear el razonamiento del agente, rastrear costes y depurar sesiones en producción
AgentOps captura trazas de razonamiento, llamadas a herramientas/API, estado de sesión, comportamiento de caché y métricas de costes para agentes implementados.
Funciones de monitoreo de AgentOps
- Reproducción de sesiones para depuración en producción
- Enfoque en el comportamiento de agentes en vivo en lugar de la evaluación fuera de línea.
Ideal para: Equipos que ejecutan agentes en producción y necesitan visibilidad operativa.
Braintrust
Casos de uso: Encontrar qué prompt, dataset o model funciona mejor con evaluación detallada y análisis de errores
Braintrust evalúa prompts, datasets y models frente a salidas esperadas, realizando un seguimiento de latencia, costo, errores de herramientas y métricas de ejecución.
Funciones de monitoreo de Braintrust
- Evalúa datasets de prueba con entradas y salidas esperadas, y luego compara prompts o models lado a lado usando variables como
{{input}},{{expected}}y{{metadata}}. - Desgloses de métricas, incluida la calidad de ejecución de herramientas
Ideal para: Equipos que comparan models y prompts antes del lanzamiento.
AgentNeo
Casos de uso: Depuración de interacciones multiagente, trazado del uso de herramientas y evaluación de flujos de trabajo de coordinación
AgentNeo realiza un seguimiento de la comunicación del agente, el uso de herramientas, los grafos de ejecución y el costo y la latencia por agente mediante un SDK de Python.
Funciones de monitoreo de AgentNeo
- Código abierto y ejecutable localmente
- Panel local interactivo (
localhost:3000) para el monitoreo en tiempo real de flujos de trabajo multiagente. - Integración mediante decoradores (p. ej.,
@tracer.trace_agent,@tracer.trace_tool)
Ideal para: Equipos de ingeniería que experimentan con sistemas multiagente.
 Añadir como fuente preferida
Laminar
Caso de uso: Realizar un seguimiento del rendimiento en diferentes frameworks y models de LLM.
Laminar realiza un seguimiento de los spans de ejecución, costes, uso de tokens y percentiles de latencia en frameworks y models de LLM.
Funciones de monitoreo de Laminar
- Análisis de rendimiento independiente del framework
- Inspección detallada de spans.
Ideal para: Análisis comparativo del rendimiento en stacks heterogéneos.
Helicone
Casos de uso: Realizar un seguimiento de los flujos de trabajo de agentes de varios pasos y analizar los patrones de sesión de los usuarios.
Helicone captura volúmenes de solicitudes, costes, errores, tendencias de latencia y flujos de trabajo de agentes a nivel de sesión.
Funciones de monitoreo de Helicone
- Visibilidad del recorrido del usuario
- Análisis de tendencias históricas.
Ideal para: Equipos de producto que monitorean patrones de uso y comportamiento a nivel de usuario.
Coval
Casos de uso: Simular miles de conversaciones de agentes, probar interacciones de voz/chat y validar el comportamiento antes de la implementación.
Coval simula miles de conversaciones para medir la finalización de tareas, la corrección y la eficacia de las llamadas a herramientas.
Funciones de monitoreo de Coval
- Pruebas de agentes basadas en simulación
- Detección automática de regresiones
- Soporte para agentes de voz y texto.
Ideal para: Validación previa a la implementación y detección de regresiones.
Datadog
Casos de uso: Observabilidad de infraestructura y aplicaciones con correlación de señales de LLM.
Datadog recopila métricas de infraestructura (CPU, memoria, red), datos de rendimiento de aplicaciones (latencia, tasas de error, rendimiento) y registros. Para aplicaciones de LLM, puede ingerir uso de tokens, costo por solicitud, latencia del model y señales relacionadas con la seguridad, como intentos de inyección de prompts.
Datadog funciones de monitoreo
- Observabilidad amplia y de todo el sistema en infraestructura, aplicaciones y cargas de trabajo de IA
- Amplio ecosistema de integraciones (más de 900 integraciones) que permite correlacionar el comportamiento de la IA con la salud de la infraestructura
Ideal para: Organizaciones que desean correlacionar el comportamiento de LLM con la infraestructura subyacente y el rendimiento de las aplicaciones, en lugar de inspeccionar el razonamiento del agente o los prompts
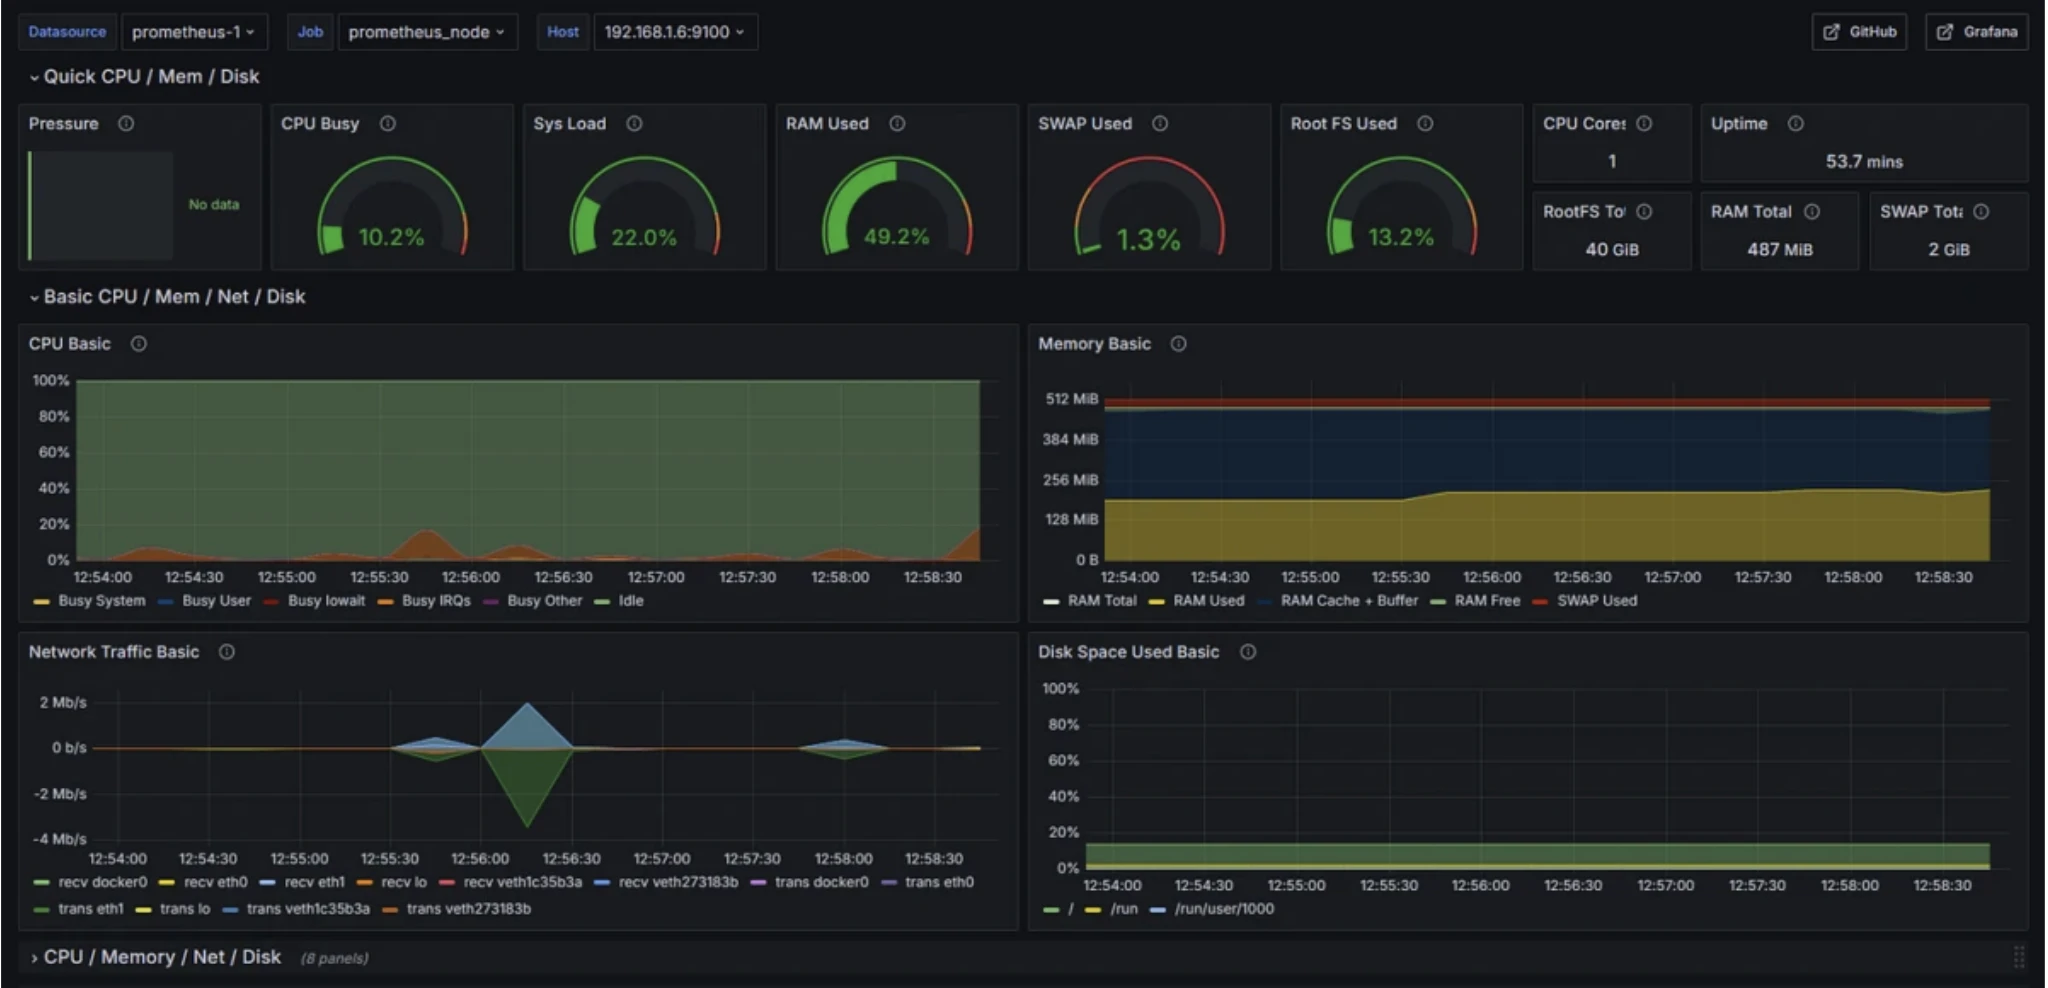
Prometheus
Casos de uso: Monitorear el rendimiento del sistema, rastrear métricas de aplicaciones y configurar alertas para problemas de infraestructura.
Prometheus es un sistema de monitoreo de código abierto que extrae métricas de series temporales de endpoints HTTP a intervalos regulares para rastrear métricas de infraestructura, aplicaciones, bases de datos, contenedores y métricas de negocio personalizadas.
Funciones de monitoreo de Prometheus
- Recopilación de métricas de series temporales mediante extracción pull
- PromQL para consultas, agregación y condiciones de alerta
- Ecosistema de exportadores (p. ej., Node Exporter) para una amplia cobertura del sistema
Ideal para: Monitoreo de infraestructura y aplicaciones con alertas basadas en reglas.
Grafana
Casos de uso: Visualizar métricas, crear paneles y enrutar alertas entre datos de LLM, agentes e infraestructura.
Grafana es una plataforma de visualización y análisis de código abierto que se integra con fuentes de datos como Prometheus, OpenTelemetry y Datadog para proporcionar paneles de observabilidad unificados.
Funciones de monitoreo de Grafana
- Paneles de métricas, registros y trazas
- Correlación entre sistemas para señales de LLM, agentes e infraestructura
- Enrutamiento de alertas y gestión de notificaciones.
Ideal para: Visualización centralizada de observabilidad y respuesta a incidentes.
Tutorial: LangChain observabilidad con Langfuse
Creamos un pipeline de LangChain de varios pasos con tres etapas:
- análisis de preguntas
- generación de respuestas
- verificación de respuestas
Después de configurar el pipeline, lo conectamos a Langfuse para monitorear y rastrear la ejecución en tiempo real. Al hacerlo, pudimos explorar cómo Langfuse nos ayuda a recopilar información detallada sobre el rendimiento, los costes y el comportamiento de las aplicaciones de IA.
Esto es lo que observamos a través de Langfuse:
Vista general del panel
Langfuse nos proporcionó varios paneles que nos dan visibilidad sobre diferentes aspectos del rendimiento del pipeline:
- Panel de costes: Realiza un seguimiento del gasto en todas las llamadas a la API, con desgloses detallados por model y período de tiempo.
- Gestión de uso: Monitorea métricas de ejecución, como el número de observaciones y la asignación de recursos, lo que nos ayuda a rastrear cómo se utilizan los recursos durante la ejecución.
- Panel de latencia: Este panel nos ayudó a analizar los tiempos de respuesta, detectar cuellos de botella y visualizar tendencias de rendimiento.
Métricas de uso
El panel de métricas de uso nos proporcionó la siguiente información sobre el rendimiento del sistema:
- Recuento total de trazas: Registramos ocho trazas, cada una de las cuales representa un ciclo completo de pregunta-respuesta en el pipeline.
- Recuento total de observaciones: En promedio, cada traza tenía 16 observaciones, lo que refleja la naturaleza de varios pasos del proceso.
Además, Langfuse nos permite rastrear patrones de uso, asignación de recursos y horas punta durante los últimos 7 días, lo que nos ayuda a comprender cuándo está más activo el sistema y cómo se distribuyen los recursos a lo largo del tiempo.
Inspección de trazas
Al profundizar en una traza individual, pudimos ver información detallada de la ejecución:
- Filas de trazas: Cada fila representa una ejecución completa del pipeline con un ID de traza único.
- Métricas de latencia: El tiempo de ejecución varió, desde 0.00s hasta 34.08s.
- Recuentos de tokens: El panel registró el uso de tokens de entrada/salida, lo que ayuda a gestionar costes y eficiencia.
- Filtrado por entorno: Podíamos filtrar las trazas según los entornos de implementación (p. ej., desarrollo, producción).
Detalles de trazas individuales
Exploramos la traza con más detalle para comprender el desglose de la ejecución:
- Arquitectura de cadena secuencial: La traza mostró un flujo visual de cada paso, desde SequentialChain → LLMChain → ChatOpenAI, con estructura jerárquica.
- Seguimiento de entrada/salida: La pregunta original, “¿Cuáles son los beneficios de usar Langfuse para la observabilidad de agentes de IA?”, fue rastreada en cada etapa, junto con las salidas respectivas producidas por la IA en cada paso.
- Análisis de tokens: Observamos que se utilizaron 1.203 tokens para la entrada y 1.516 tokens para la salida, lo que tiene implicaciones de costes relacionadas con el uso de tokens y ayuda a optimizar la gestión de recursos.
- Datos de tiempo: La latencia total de la traza completa fue de 34.08s, desglosada en cada componente:
- SequentialChain → 14.02s
- LLMChain → 10.25s
- ChatOpenAI → 9.81s
- Información del model: Langfuse confirmó el uso del model Anthropic Claude-Sonnet-4, con detalles sobre la configuración específica, incluida la configuración de temperatura.
- Salida formateada: Se proporcionaron vistas tanto de Vista previa como de JSON para la depuración, lo que ofrece información sobre la respuesta del model en formato legible por humanos y en formato legible por máquinas.
Análisis automatizado
Langfuse también proporcionó evaluaciones automatizadas de nuestras respuestas:
- Evaluación de calidad: El sistema evaluó la estructura, coherencia y exhaustividad de las respuestas, destacando las secciones bien organizadas pero sugiriendo que las respuestas podrían ser más concisas.
- Sugerencias de mejora: Identificó secciones con redundancias, sugirió dónde se podía mejorar la redacción y combinó puntos relacionados para que la respuesta fuera más transparente y más eficiente.
- Información sobre el rendimiento: El sistema proporcionó retroalimentación sobre el uso de tokens y la relevancia de las respuestas, lo que nos ayudó a optimizar la eficiencia y a garantizar que la salida siguiera siendo útil y pertinente.
- Retroalimentación estructurada: La retroalimentación se organizó en categorías, lo que nos permitió abordar áreas específicas de mejora de manera específica.
Analítica de usuarios
Langfuse realiza un seguimiento detallado de las interacciones entre los usuarios y el agente de IA:
- Cronología de actividad del usuario: Muestra la primera y la última interacción de cada usuario, lo que ayuda a identificar usuarios activos frente a inactivos. Podemos ver cuándo los usuarios interactuaron con el sistema por primera y última vez.
- Seguimiento del volumen de eventos: Registra el número de eventos que activó cada usuario. Por ejemplo, algunos usuarios generaron más de 2.000 eventos, lo que muestra su nivel de interacción con el sistema.
- Análisis del consumo de tokens: Monitorea el número total de tokens consumidos por cada usuario. El uso de tokens osciló entre 6.59K y 357K tokens, lo que proporciona información sobre el uso de recursos.
- Atribución de costes: Desglosa los costes asociados a cada usuario, lo que facilita el seguimiento del gasto y la optimización de la asignación del presupuesto para el uso de recursos.
- Identificación del usuario: Utiliza IDs de usuario anonimizados para mantener la privacidad mientras se rastrean las interacciones individuales, lo que ayuda con el análisis de uso sin comprometer la confidencialidad del usuario.
La vista de sesión nos permite rastrear detalles granulares de las interacciones de los usuarios:
- Flujo completo de la conversación: Muestra la interacción completa de pregunta-respuesta, lo que facilita seguir toda la conversación de principio a fin.
- Visibilidad de la implementación: Muestra el código Python real utilizado durante la sesión, lo que proporciona información sobre la implementación técnica.
- Correlación de entrada/salida: Vincula las preguntas de los usuarios con las respuestas correspondientes del sistema, lo que nos ayuda a solucionar problemas e identificar dónde pueden haberse producido incidencias en la conversación.
- Metadatos de la sesión: Incluye detalles técnicos como tiempos, contexto del usuario y datos de implementación específicos, lo que ofrece una visión integral de la ejecución de la sesión.
Cuándo no usar herramientas de observabilidad
- Desarrollo en etapas tempranas: Si todavía estás validando el ajuste producto-mercado o creando tus primeros flujos de trabajo de agentes, el enfoque debe estar en la funcionalidad principal y no en una observabilidad exhaustiva.
- Cuellos de botella de API: Si tus principales problemas son los costes de API, la latencia o el almacenamiento en caché, la prioridad inmediata debería ser optimizar estas áreas, no rastrear métricas a nivel del sistema.
- Optimización de models: Si las mejoras están impulsadas principalmente por la selección de models, el fine-tuning o la ingeniería de prompts, es posible que las herramientas de observabilidad para la deriva y el sesgo aún no sean necesarias.
Cuándo usar herramientas de observabilidad
- Producción a escala: Cuando operas con múltiples models, agentes o cadenas, las herramientas de observabilidad son esenciales para monitorear el rendimiento y garantizar la salud del sistema.
- Aplicaciones empresariales u orientadas al cliente: Para aplicaciones donde la fiabilidad, la seguridad y el cumplimiento son innegociables, las herramientas de observabilidad proporcionan la visibilidad y el control necesarios.
- Monitoreo continuo: Cuando necesitas monitorear la deriva, el sesgo, el rendimiento y los problemas de seguridad a lo largo del tiempo, que no se pueden captar fácilmente con scripts básicos o comprobaciones manuales, las herramientas de observabilidad son cruciales.
- Escenarios de alto riesgo: En entornos donde el costo de los fallos (p. ej., alucinaciones, salidas inseguras) es significativo, la observabilidad garantiza que los riesgos se minimicen y que los problemas se detecten de forma temprana.
Metodología del benchmark
Para evaluar la sobrecarga de rendimiento de las plataformas de observabilidad en aplicaciones de LLM en producción, desarrollamos un enfoque de benchmarking sistemático utilizando un flujo de trabajo agéntico del mundo real.
Aplicación de prueba
Creamos un sistema secuencial multiagente de planificación de viajes utilizando LangChain que procesa solicitudes de viaje en lenguaje natural a través de cinco etapas:
- Agente analizador: Extrae datos estructurados (origen, destino, fechas, duración) de la entrada del usuario
- Agente buscador de vuelos: Recupera vuelos disponibles a través de la API de Amadeus
- Agente de informes meteorológicos: Obtiene previsiones meteorológicas del destino mediante WeatherAPI
- Agente recomendador de actividades: Sugiere actividades en función de las condiciones meteorológicas
- Agente planificador de viajes: Sintetiza todas las salidas en un itinerario completo
El sistema utiliza Claude 4 Haiku a través de OpenRouter para todas las llamadas de LLM e integra APIs externas para datos en tiempo real.
Diseño del benchmark
Establecimiento de la línea base: Primero medimos el rendimiento de la aplicación sin ninguna instrumentación de observabilidad, ejecutando 100 consultas idénticas para establecer una línea base de comparación.
Integración de plataformas: A continuación, integramos cinco plataformas de observabilidad líderes (LangSmith, Laminar, AgentOps, Langfuse) una a una, instrumentando los mismos puntos de trazado en todas las plataformas para mantener la coherencia.
Ejecución secuencial: Cada plataforma se probó de forma independiente ejecutando todas las 100 consultas de forma consecutiva antes de pasar a la siguiente plataforma. Este enfoque minimiza la variabilidad derivada de factores externos como las condiciones de la red o los límites de velocidad de la API.
Entorno controlado: Todas las pruebas se ejecutaron en la misma infraestructura de servidor con conjuntos de consultas idénticos para garantizar una comparación justa. Para aislar la sobrecarga de las variaciones de latencia inducidas por LLM, configuramos el model con temperatura=0 y prompts estructurados para minimizar la variabilidad de las respuestas entre ejecuciones.
Métricas recopiladas
Para cada plataforma, medimos la latencia promedio y calculamos la sobrecarga como la latencia adicional introducida en comparación con la línea base: ((Platform Latency - Base Latency) / Base Latency) × 100
Preguntas frecuentes
La observabilidad es la capacidad de comprender el funcionamiento interno de un agente de IA examinando señales externas como registros, métricas y trazas.
Para los agentes de IA, esto implica monitorear acciones, uso de herramientas, interacciones con models y respuestas para solucionar problemas y mejorar el rendimiento.
La observabilidad de agentes es crucial para rastrear y mejorar el rendimiento de la IA, ya que permite:
Comprender las compensaciones: Ayuda a medir métricas clave como la precisión y el costo, lo que facilita encontrar un equilibrio entre rendimiento y uso de recursos.
Medición de la latencia: El seguimiento de la latencia en tiempo real ofrece información sobre los tiempos de respuesta, lo que ayuda a optimizar el rendimiento del agente.
Detección de entradas maliciosas: La observabilidad ayuda a identificar lenguaje dañino e inyecciones de prompt, lo que permite una intervención rápida para prevenir problemas.
Monitoreo de la retroalimentación de los usuarios: Al observar las interacciones y la retroalimentación de los usuarios, la observabilidad proporciona datos valiosos para la mejora continua y el fine-tuning de los agentes.
Los componentes clave incluyen:
– Seguimiento de acciones: Monitorear cada paso que da el agente.
– Uso de herramientas: Observar las herramientas y recursos que utiliza el agente.
– Medición de latencia: Monitorear los tiempos de respuesta para optimizar el rendimiento.
– Evaluaciones: Evaluar el comportamiento del agente y el rendimiento del model.
– Detección de entradas maliciosas: Identificar prompts o ataques dañinos.
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Şipi, Nazlı},
  title  = {{15 Herramientas de observabilidad de agentes de IA: AgentOps y Langfuse}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/agentic-monitoring}},
  note   = {AIMultiple. Recuperado el 3 de junio de 2026}
}Resultados y marcas de tiempo de 35 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 5 archivos CSV.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
8 actualizacionesSe actualizó la sección "Posibles razones detrás de las diferencias de rendimiento" con nuevas explicaciones y ejemplos.
Se amplió la sección 'Plataformas de observabilidad de agentes de IA' con posibles razones detrás de las diferencias de rendimiento.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.

Siguiente para leer
Comparativa de plataformas de agentes de IA: Claude Managed Agents frente a Google Vertex Agent Engine

Agentes de uso de computadora: Benchmark y arquitectura


Búsqueda agéntica: Benchmark de 8 APIs de búsqueda para agentes


Creación de agentes personales de IA + 18 plataformas y herramientas de agentes

Construcción de agentes de IA con patrones componibles
Las 9 mejores plataformas de CRM agénticas















Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.