


Investigación profunda con IA: Codex vs Claude vs Grok vs Exa

Una herramienta de investigación profunda responde una pregunta con un informe escrito en lugar de una página de enlaces. Ejecutamos cinco formas de producir uno sobre los mismos 20 informes breves de investigación empresarial y puntuamos cada informe según reglas escritas antes de las ejecuciones para encontrar la mejor herramienta para investigación profunda. Cuatro de las cinco son agentes de programación, herramientas de línea de comandos creadas para trabajo de software que también pueden buscar y leer la web; el quinto, Exa Agent, está creado para la investigación.
Resultados del benchmark DR-20
Cada una de las cinco herramientas produjo un informe para cada una de las 20 tareas, 100 informes en total, calificados a ciegas según reglas escritas antes de las ejecuciones. Consulte más detalles sobre la metodología.
El único producto de investigación profunda creado específicamente para ello terminó por debajo de tres de los cuatro agentes de programación. Exa Agent obtuvo 0.584, y cada una de esas tres diferencias sobrevive la corrección de Holm en las diez comparaciones por pares. En estos informes, Codex CLI, Claude Code y Grok CLI obtuvieron puntuaciones superiores al producto creado para este trabajo.
Exa Agent y Gemini CLI no mostraron una diferencia estadísticamente significativa en las puntuaciones de requisitos.
No encontramos una diferencia estadísticamente significativa entre Codex CLI y Claude Code en estas 20 tareas. La diferencia es de 0.015 en una escala de 0 a 1, con una p sin ajustar de 0.67 y 0.96 después de la corrección de Holm. En 10.000 muestras bootstrap, ambos tuvieron un intervalo de clasificación del 95 % de 1 a 2. Lideran en medidas diferentes: Codex CLI en los requisitos escritos por 0.015, Claude Code en la reproducción de hechos por 1.2 puntos porcentuales.
Hechos exactos reproducidos
Claude Code reprodujo completamente 202 de los 434 elementos factuales requeridos, Codex CLI 198 y Exa Agent 89. Ninguna herramienta alcanzó la mitad. Un elemento recibía crédito solo cuando el informe incluía correctamente todos sus detalles requeridos. Esta comprobación cubría una lista de hechos predefinida; no auditamos cada afirmación de los informes.
Coste y calidad de la investigación
Grok CLI obtuvo 0.699 por $1,91 por tarea; los dos líderes cuestan entre $13,38 y $18,35, de siete a diez veces más. Grok quedó por detrás de Claude Code por 0.076, con una p ajustada por Holm de 0.006. Su diferencia de 0.091 respecto a Codex CLI no fue significativa después de la corrección, con 0.072.
Las dos herramientas más baratas también obtuvieron las puntuaciones más bajas. Gemini CLI costó $0,58 por tarea y obtuvo 0.565; Exa Agent costó $1,00 y obtuvo 0.584, una diferencia con una p ajustada por Holm de 0.958.
Codex CLI, Claude Code y Grok CLI se ejecutaron aquí con suscripciones; sus cifras son equivalentes de tarifa de API. Consulte LLM pricing para saber cuánto cuestan esas suscripciones y sus tarifas de API. Exa se facturó como uso de API y $20,00 es su gasto real. Los $0,58 por tarea de Gemini cubren solo tokens y excluyen el grounding de búsqueda, cuyo recuento de consultas facturables no se capturó.
Tiempo por tarea y calidad de la investigación
Los dos líderes también son los dos más lentos. La tarea mediana de Codex CLI tardó 42 minutos para una puntuación de 0.790 y la de Claude Code 36 minutos para 0.775, frente a 13 minutos de Grok CLI con 0.699. El tiempo de ejecución no ordena al resto. Gemini CLI tardó 1.5 minutos más que Exa Agent y obtuvo 0.019 menos.
Longitud del informe y trabajo realizado
El contraejemplo más claro de que más largo no es mejor está en la parte superior de la tabla. En el informe mediano, Claude Code emplea 271 palabras por requisito cumplido y Codex CLI 137, y ambos puntúan con una diferencia de 0.015 entre sí. Exa Agent es el más económico con 91 palabras por requisito, para una puntuación de 0.584.
La amplitud y la calidad de las fuentes se separan. El informe mediano de Claude Code cita 28 sitios web distintos frente a los 16 de Codex CLI, mientras que una mayor proporción de las citas de Codex CLI apunta a páginas oficiales y primarias, 34,8 % frente a 25,8 %. Gemini CLI cita con menor densidad, con 4.2 enlaces por 1.000 palabras.
Algunos enlaces citados estaban rotos. Contamos las URL que devolvieron un error 404 o 410 o tenían un formato no válido. Los totales en 20 informes por herramienta fueron:
- Gemini CLI: 63
- Claude Code: 26
- Grok CLI: 16
- Codex CLI: 14
- Exa Agent: 14
Novedades en las herramientas de investigación profunda con IA
La investigación profunda llegó a la Gemini API
Google añadió Deep Research a la Gemini API como un agente que los desarrolladores llaman directamente, junto con la función que ya viene en la aplicación Gemini.1 Se ofrece en dos versiones: deep-research-preview-04-2026 para velocidad, y deep-research-max-preview-04-2026 para exhaustividad.
Google lo cobra por uso según los modelos y herramientas subyacentes, y estima una tarea típica entre $1 y $3 para la versión estándar y entre $3 y $7 para Max. Una tarea se ejecuta en segundo plano y tiene un límite de 60 minutos; la mayoría termina en 20.
Exa indexó publicaciones académicas
Exa lanzó una búsqueda semántica sobre artículos académicos el 23 de julio de 2026, que cubre alrededor de 350 millones de publicaciones y 30 millones de autores.2 La propuesta es encontrar un artículo a partir de un recuerdo vago en lugar de un título exacto.
Exa informa de un recall del 86,4 % en su benchmark de recuperación frente al 66,8 % de Perplexity y el 28,0 % de Google Scholar. Son cifras del propio proveedor en su propio benchmark, así que trátelas como una indicación y no como una clasificación consolidada; la misma publicación cita dos latencias medias diferentes, motivo para esperar una verificación independiente.
Bright Data Deep Lookup responde a una pregunta diferente
Deep Lookup de Bright Data devuelve filas de entidades, no un informe de investigación escrito. Cada fila representa una empresa, persona o producto. Los usuarios pueden crear listas para prospección de ventas, investigación de inversiones o reclutamiento.3
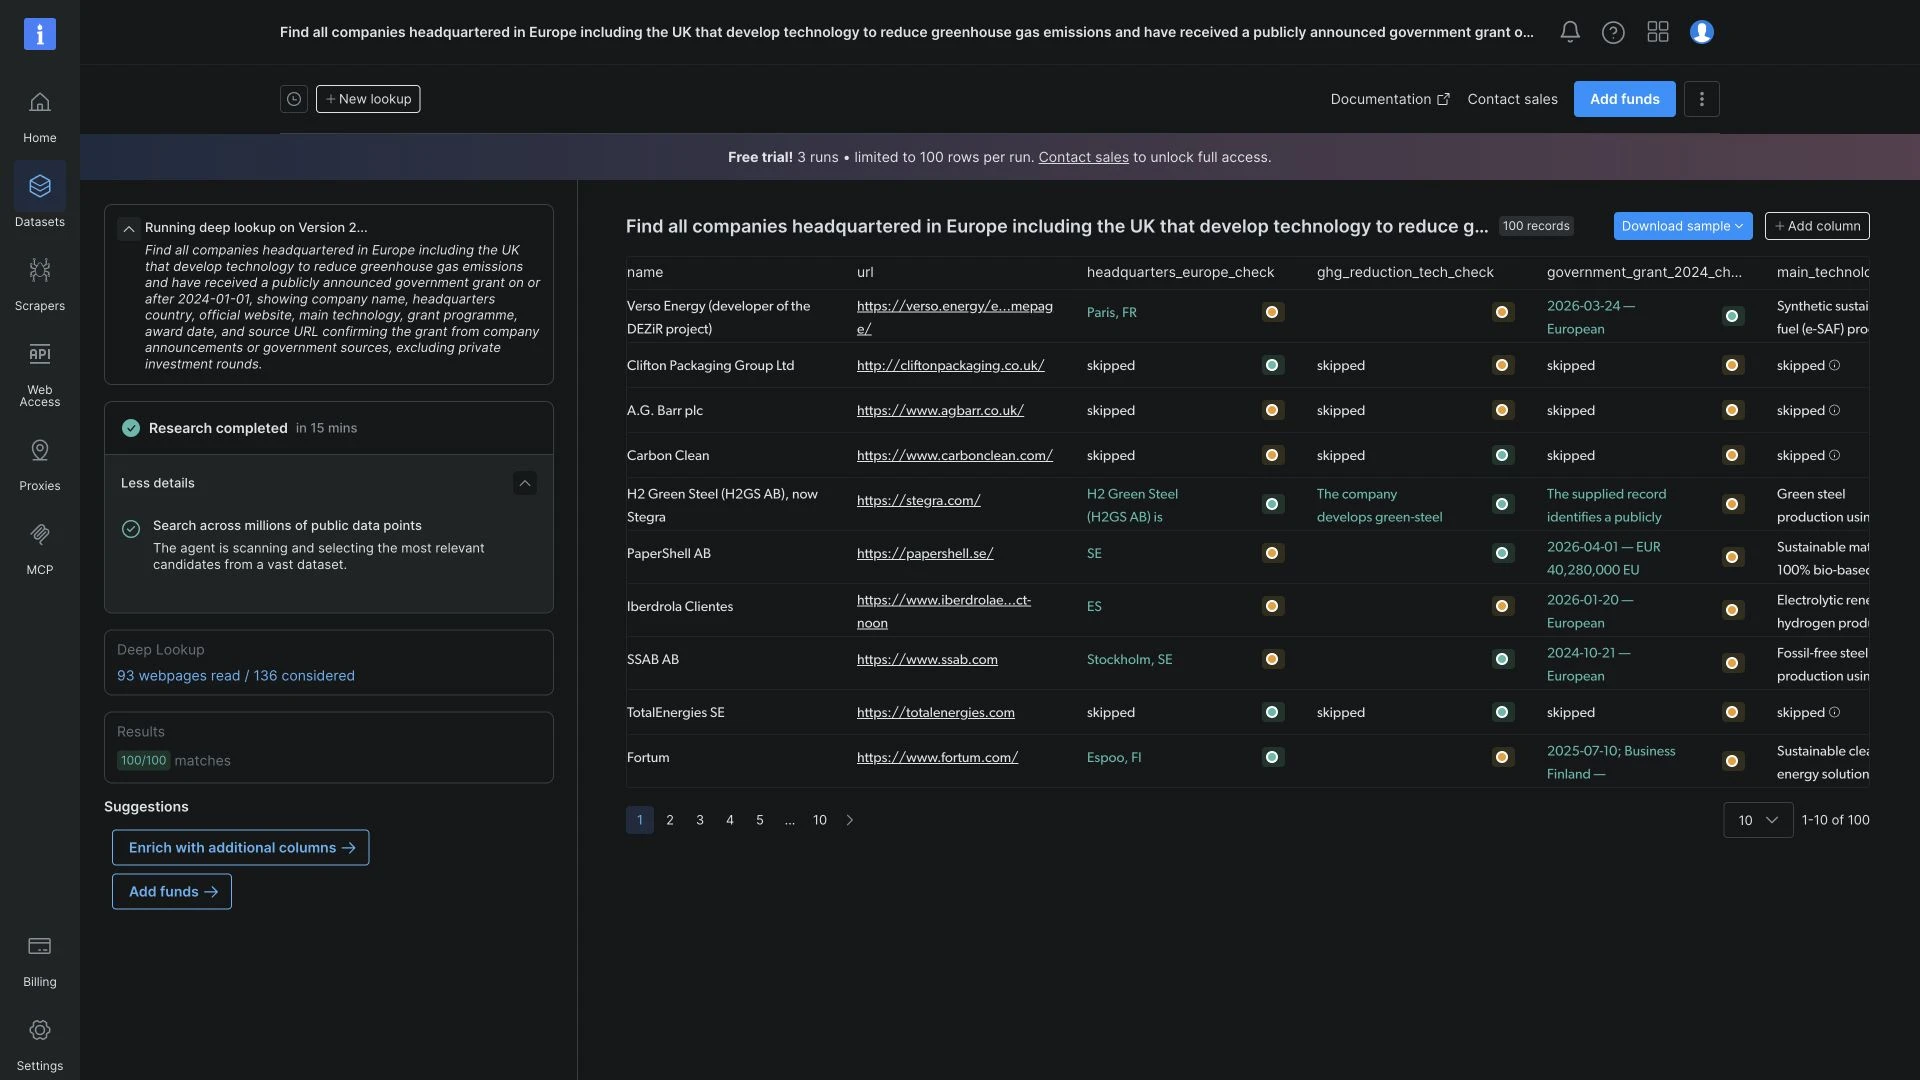
Buscamos empresas europeas que desarrollan tecnología para reducir las emisiones de gases de efecto invernadero. La consulta incluía el Reino Unido y exigía una subvención gubernamental anunciada públicamente desde el 1 de enero de 2024.
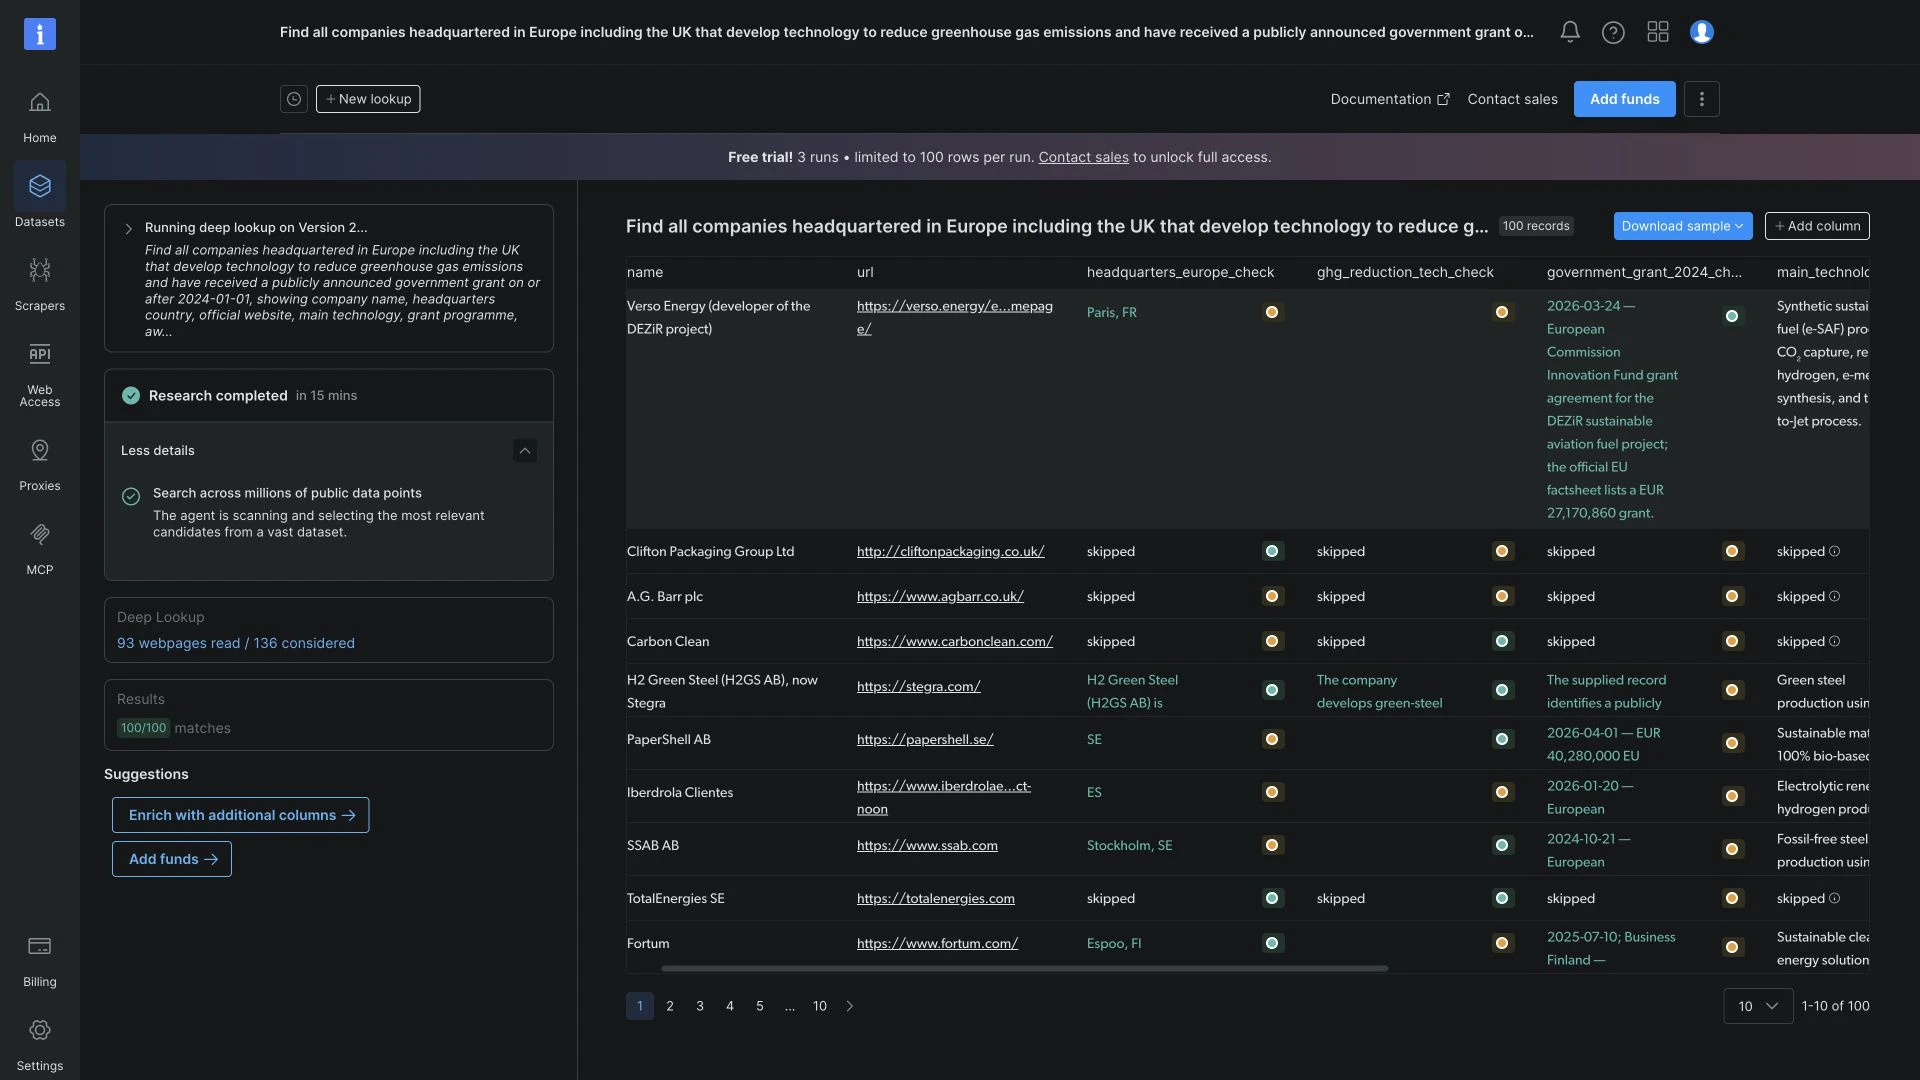
Deep Lookup creó una columna separada para cada condición. Al expandir una fila se mostraban explicaciones más largas, con indicadores de confianza de colores junto a los detalles individuales. La interfaz informó de una ejecución de 15 minutos que alcanzó el límite de 100 registros de la prueba.
Otras columnas contenían descripciones de tecnología, programas de subvenciones, fechas de adjudicación y enlaces a fuentes. Los enlaces nos permitieron comprobar las afirmaciones sobre subvenciones con los anuncios. El menú de descarga ofrecía formatos CSV y JSON.3
Los equipos de ventas pueden usar Deep Lookup para encontrar empresas de un sector y una región objetivo. Los inversores pueden identificar negocios que desarrollan una tecnología particular o reciben financiación pública. Los reclutadores pueden buscar profesionales con funciones y experiencia relevantes.3
Combinar varias condiciones de búsqueda con columnas de resultados personalizadas permite a los equipos crear listas según sus propios criterios y comparar los detalles en un solo lugar.
La herramienta Deep Research de Azure lleva una advertencia de límite de datos
Microsoft ofrece Deep Research en Azure AI Foundry Agent Service, accesible desde los SDK de Python, C# y JavaScript, y ahora documentado en su herramienta de agentes clásica.4
La razón para leer esa página antes de adoptarlo está en la propia página: Microsoft indica que la consulta de búsqueda de Bing, los parámetros de la herramienta y la clave del recurso se transfieren fuera del límite de cumplimiento de Azure a Grounding con Bing Search. Los equipos que eligieron Azure para que nada salga del límite deberían comprobar qué partes de una ejecución de investigación lo cruzan.
Beneficios de las herramientas de investigación profunda con IA
Un informe de investigación con fuentes en minutos
En nuestro benchmark, los tiempos medianos por tarea oscilaron entre 5.5 y 42 minutos, según la herramienta. Cada ejecución produjo un informe de investigación con enlaces a fuentes. No medimos cuánto tardaría una persona en completar las mismas tareas.
Las puntuaciones de requisitos alcanzaron 0.790 en la parte superior entre las cinco herramientas y los 20 informes. Los requisitos cubren todo el informe, desde las secciones solicitadas hasta la aritmética de la tabla de costes, de modo que una puntuación de ese nivel significa que la mayor parte del encargo se respondió en la forma solicitada.
Amplitud en una sola pasada
Un agente de investigación puede reunir material de múltiples sitios web para una comparación de proveedores, una revisión de cambios en una norma del sector o una introducción a un tema de investigación desconocido. El informe resultante ofrece al lector una visión inicial y fuentes para investigar más.
Un borrador de investigación editable
El resultado es un documento, por lo que puede editarse, cuestionarse y volver a ejecutarse. Es un modo de trabajo diferente al de una página de resultados de búsqueda. Un documento con aspecto acabado también es el riesgo: invita a comprobar menos que una lista de enlaces.
 Añadir como fuente preferida
Retos y limitaciones de las herramientas de investigación profunda con IA
Los hechos son el punto débil, no la estructura
La mayoría de la gente sabe que un LLM puede inventar una respuesta y comprueba lo que produce. Un informe de investigación profunda invita a comprobar menos, porque es largo, tiene fuentes y está bien organizado, de modo que se lee como si ya estuviera verificado.
Un informe puede cumplir los requisitos de sus secciones, tablas y cálculos y, aun así, omitir o declarar mal los hechos requeridos.
Antes de usar un informe para tomar una decisión, verifique las fechas, cifras y conclusiones regulatorias pertinentes con las fuentes originales.
Las citas no significan que la fuente lo diga
Nuestra auditoría de citas comprobó si los enlaces funcionaban y clasificó sus fuentes. No comprobó si cada página respaldaba la afirmación asociada a ella. Incluso un enlace que funciona a una fuente oficial necesita esa comprobación: la página puede tratar el tema sin respaldar la cifra o la conclusión específica del informe.
La longitud no es profundidad
El informe mediano de Claude Code contenía 11.449 palabras frente a las 5.734 de Codex CLI, sin una diferencia estadísticamente significativa en las puntuaciones de requisitos.
Los lectores deberían considerar cuánto material tendrán que revisar junto con el tiempo de ejecución y el precio de la herramienta.
Sesgo, privacidad y dependencia excesiva
Los datos de entrenamiento arrastran los sesgos de lo que se escribió, y un paso de síntesis puede endurecerlos hasta convertirlos en algo que se lee como una conclusión. Con una herramienta alojada, cualquier documento interno que se suba como contexto sale de sus sistemas, lo que conviene comprobar con los términos del proveedor antes de que se convierta en rutina. El riesgo más difícil de medir es el último: un informe pulido que nadie comprueba erosiona el hábito de comprobar.
Metodología
Entorno de prueba
Ejecutamos las cuatro herramientas CLI desde un servidor en la nube con Linux y accedimos a Exa Agent a través de su API. Cada una usó sus propias herramientas de investigación.
Tareas y procedimiento de prueba
- Escribimos 20 informes que cubrían selección de proveedores, planificación de migraciones, modelos de costes e investigación regulatoria. Cada uno especificaba una fecha límite de informe y tenía respuestas de referencia elaboradas a partir de fuentes primarias.
- Cada herramienta recibió los mismos prompts de tarea. Evaluamos un informe por herramienta y por tarea, lo que dio 100 informes entre las cinco herramientas.
- Fijamos los prompts, las configuraciones de los modelos y las reglas de puntuación antes de la producción. Ninguna tarea se repitió para mejorar una puntuación baja.
Criterios de puntuación
- Requisitos: Cada tarea tenía de 42 a 74 comprobaciones de aprobado/fallido. Por ejemplo, una tabla de costes podía necesitar un precio unitario y su fuente.
- Penalizaciones: Los defectos predefinidos reducían la puntuación, como tratar un asunto como resuelto después de haberlo llamado no resuelto en otra parte del informe. Puntuación = max(0, (requisitos aprobados − penalizaciones activadas) / requisitos totales). La puntuación global de cada herramienta es la media de sus 20 puntuaciones por tarea. También comprobamos una fórmula alternativa que deduce 0.1 por penalización de la fracción de requisitos aprobados, con una puntuación mínima de cero. Esta es la opción de penalización alternativa del gráfico. El orden de las cinco herramientas no cambió.
- Detalles factuales: Una lista de verificación separada contenía 434 hechos requeridos. Un elemento solo obtenía crédito cuando el informe incluía correctamente cada detalle requerido dentro de la tolerancia indicada. Las respuestas parciales no obtenían crédito. Estas comprobaciones no contribuían a la puntuación de requisitos. Los porcentajes de hechos dan el mismo peso a cada tarea. Los recuentos combinan los aciertos entre los 434 elementos.
Jueces de modelo
- Eliminamos los metadatos identificativos y las rutas de archivos locales antes de la calificación. Ambos jueces recibieron el mismo informe, las reglas de la tarea, los hechos de referencia y la auditoría de citas.
- GPT-5.6 Sol y Grok 4.6 calificaron cada informe de forma independiente. Para cada requisito y penalización, cada juez registró un motivo vinculado al informe antes de emitir un veredicto de aprobado/fallido. También comprobaron cada elemento factual.
- Claude Opus 5 resolvió los desacuerdos con la misma evidencia. Las decisiones en las que los dos primeros jueces coincidieron permanecieron sin cambios. Los dos jueces iniciales coincidieron en el 93,3 % de los veredictos de reglas y en el 89,1 % de las decisiones sobre elementos factuales.
Análisis estadístico
Utilizamos pruebas pareadas en las 20 tareas y aplicamos la corrección de Holm en las diez comparaciones de herramientas por pares. Estimamos intervalos de clasificación del 95 % remuestreando las tareas 10.000 veces.
Limitaciones
- Un informe por herramienta y por tarea no mide cuánto varían las respuestas de la misma herramienta entre ejecuciones.
- Comprobamos la disponibilidad de los enlaces y el tipo de fuente, pero no verificamos si cada página citada respaldaba la afirmación asociada. Las comprobaciones que requerían esa verificación recibieron un veredicto de fallido en todas las herramientas: las comprobaciones positivas no obtuvieron crédito y las negativas no activaron penalización.
- Perfeccionamos ocho tareas después de una prueba piloto anterior. Mantenemos los informes sin publicar para evaluaciones futuras.
Preguntas frecuentes
La investigación impulsada por IA utiliza herramientas de IA para encontrar, analizar y resumir información. Una herramienta de investigación profunda va más allá de una respuesta de chat: se ejecuta durante minutos, abre muchas fuentes y produce un informe con citas.
En lo que destaca, según nuestras propias mediciones, es en la forma de la respuesta. En lo que falla es en los detalles concretos. La más fuerte de las cinco herramientas que probamos reprodujo 202 de los 434 valores, fechas y nombres requeridos, y la más débil reprodujo 89.
Por eso un informe de investigación profunda debe comprobarse antes de publicar nada. El informe puede parecer acabado aunque las cifras sean incorrectas. Benchmarks relacionados: programación con IA.
Las herramientas de IA pueden ayudar en varios aspectos de las revisiones bibliográficas, como identificar artículos relevantes, resumir hallazgos clave y organizar temas de investigación. Estas herramientas pueden procesar rápidamente grandes volúmenes de literatura académica y ayudar a los investigadores a identificar lagunas o patrones entre estudios. Sin embargo, la IA no puede sustituir por completo el juicio humano a la hora de evaluar la calidad de las fuentes, sintetizar argumentos complejos o proporcionar un análisis crítico. Los investigadores deben revisar, verificar e interpretar el contenido generado por IA para garantizar la precisión y mantener el rigor académico en sus revisiones bibliográficas.
Las herramientas de IA pueden ayudar con el análisis de datos y el trabajo estadístico limpiando datasets, realizando pruebas estadísticas, creando visualizaciones e identificando patrones en grandes datasets. Estas herramientas pueden sugerir métodos estadísticos apropiados según el tipo de datos y las preguntas de investigación. Sin embargo, los investigadores deben comprender el contexto de sus datos y validar los resultados, ya que la IA puede pasar por alto matices específicos del dominio o hacer suposiciones inapropiadas.
La mayoría de las herramientas modernas de investigación con IA utilizan interfaces de lenguaje natural que no requieren conocimientos de programación. Sin embargo, una alfabetización básica en datos y la comprensión de conceptos fundamentales de investigación ayudan a los usuarios a formular mejores consultas e interpretar los resultados de forma más eficaz. Las aplicaciones avanzadas pueden beneficiarse de conocimientos técnicos para análisis personalizados o flujos de trabajo especializados.
Abra cada fuente utilizada para una afirmación importante y compruebe que respalda las cifras, fechas y conclusiones del informe. Confirme que la fuente corresponde al período de tiempo y al contexto pertinentes. La lista de verificación de hechos de nuestro benchmark cubría detalles predefinidos, por lo que sus puntuaciones no establecen la precisión de cada afirmación de un informe.
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{kalelioglu2026,
  author = {Kalelioğlu, Berk},
  title  = {{Investigación profunda con IA: Codex vs Claude vs Grok vs Exa}},
  year   = {2026},
  month  = sep,
  howpublished    = {\url{https://aimultiple.com/ai-deep-research}},
  note   = {AIMultiple. Recuperado el 11 de septiembre de 2026}
}Resultados y marcas de tiempo de 10 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 2 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
8 actualizacionesReemplazado el resumen de Agentes frente a Modelos de Investigación Profunda por el hallazgo de que los agentes igualan su precisión a menor costo.
Añadida una sección de benchmark Agentes frente a Modelos de Investigación Profunda que compara seis herramientas en cinco tareas.
Añadida una sección de metodología del benchmark que detalla las cinco tareas de investigación, las fuentes de referencia, la puntuación y las interfaces de las herramientas.
Se añadió el DR-2T (Deep Research 2 Task) Bench a la sección de evaluación comparativa de investigación profunda de IA.
Enlaces de referencia





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.