


AIM-Agentic RAG Benchmark: Enrutamiento entre 11 SQL bases de datos
We benchmarked 70+ LLMs on 759 questions that require choosing among 11 SQL databases. The benchmark measures whether each model identifies the right database, explores alternatives and states a final choice.
La precisión de enrutamiento es el porcentaje de preguntas puntuadas en las que el modelo nombra explícitamente la base de datos correcta en su respuesta final. El titular utiliza las 184 preguntas marcadas como difíciles tanto por nuestra prueba de similitud como por un jurado de tres LLMs. Las declaraciones explícitas omitidas no reciben crédito.
Hallazgos de enrutamiento de bases de datos
Gemini 4 Argon registró la mayor precisión de enrutamiento con un 94,0 %
gemini-4-argon seleccionó la base de datos correcta en 173 de 184 preguntas difíciles. claude-opus-5.5 lo siguió con un 90,2 % (166 de 184). Muse Wonder registró 86,4 % (159 de 184). GPT-6.1 Terra registró 83,7 % (154 de 184). MiniMax M3.1 Flash registró 81,5 % (150 de 184). Kimi K3.1 Pro registró 84,8 % (156 de 184). Muse Spark Open registró 81,0 % (149 de 184), y DeepSeek V4.1 Flash 1017 registró 77,2 % (142 de 184).
Gemini 4 Argon lideró en todas las preguntas con un 98,4 % (747 de 759). Se ejecutó a través de OpenRouter. Las puntuaciones observadas reflejan tanto el modelo como las condiciones de ejecución.
DeepSeek V4 Flash 0731 registró una precisión de enrutamiento del 82,1 % a $1,37
DeepSeek V4 Flash 0731 respondió correctamente 151 de 184 preguntas difíciles. Sus respuestas retenidas en las 759 preguntas costaron $1.37. Qwen3.8 Flash obtuvo 79,3 % a $2,08, mientras que MiMo-V2.6-Pro alcanzó 82,6 % a $4.17.
Estos costes suman las respuestas correctas retenidas en cada archivo de resultados. Se excluyen los intentos fallidos y los reintentos sustituidos. Estos totales dependen de los proveedores y las condiciones de caché utilizadas durante la medición. El gráfico de costes incluye 78 totales medidos de la API y tres estimaciones equivalentes a OpenRouter, etiquetadas por separado, para Opus 5.5, Fable 5.1 y GPT-6 Astra. Estas estimaciones aplican los precios de la API del 1 de octubre de 2026 a los tokens de CLI registrados y al uso de caché. No miden el gasto en suscripciones.
Grok 4.6 ganó 41.8 puntos tras su primera elección de base de datos
La precisión de enrutamiento de Grok 4.6 en preguntas difíciles aumentó del 38,0 % en su primera comprobación al 79,9 % en su declaración final. GPT-6 Sol Pro ganó 34.2 puntos durante su ejecución. Nova Lite perdió 14.0 puntos.
Estos cambios utilizan preguntas con una única base de datos en el primer turno. Describen trayectorias registradas. Ninguna intervención separada aisló el beneficio de las llamadas adicionales.
En los 81 modelos, 8.203 registros de preguntas difíciles incluyeron un cambio de base de datos:
Esta tabla toma la primera base de datos en el orden de llamadas registrado, incluidos los primeros turnos con múltiples bases de datos. El crédito final requiere una declaración correcta explícita. Los cambios en puntos porcentuales anteriores utilizan el subconjunto más reducido de una única primera elección.
Resultados de enrutamiento de bases de datos
Los modelos se ordenan por precisión de enrutamiento, de mayor a menor. La metodología identifica diferencias en el software utilizado para ejecutarlos. Estas condiciones son importantes al interpretar pequeñas diferencias de puntuación.
Los intervalos estiman la incertidumbre del muestreo de preguntas. Los costes registrados cubren los registros correctos de cada ejecución. Reflejan los proveedores y las condiciones de caché utilizadas en el momento de la medición.
Condiciones que afectan la selección de bases de datos
Las bases de datos similares redujeron la precisión de enrutamiento en unos 20 puntos
Probamos el método de selección de bases de datos en un experimento separado con 128 preguntas. Cada pregunta mantuvo su base de datos correcta, mientras que las otras 10 candidatas procedían de nuestro grupo seleccionado o de un sorteo aleatorio.
En el subconjunto difícil, claude-opus-4.8 obtuvo un 71,3 % con candidatas similares y un 92,0 % con candidatas aleatorias. gemini-3.5-flash obtuvo un 77,0 % y un 96,6 %. Ambas diferencias tuvieron valores p inferiores a 0.001 en pruebas pareadas.
Este experimento utilizó descripciones y una respuesta del modelo por pregunta, sin el bucle agéntico de herramientas. Respalda la conclusión más limitada de que seleccionar candidatas similares dificulta la elección de la base de datos. La brecha medida no debe presentarse como el efecto de la exploración agéntica.
Solo los nombres produjeron una precisión del 68,8 % y 71,1 % en una prueba piloto
En otra prueba piloto de 128 preguntas, claude-opus-4.8 seleccionó la base de datos correcta el 68,8 % de las veces únicamente con los nombres. Su puntuación con nombres y descripciones fue del 67,2 %. gemini-3.5-flash obtuvo un 71,1 % con los nombres y un 75,0 % con el catálogo completo.
Nombres como california_schools y toxicology revelan el tema directamente. Para el benchmark principal, sustituimos los nombres de las bases de datos por alias de db_01 a db_11. Las descripciones siguen explicando el dominio de cada base de datos, y las respuestas de las herramientas exponen los nombres de sus tablas y columnas.
Fiabilidad de las comparaciones de enrutamiento y costes
Las ejecuciones repetidas cambiaron la precisión de enrutamiento entre 1.6 y 2.7 puntos
claude-opus-5 seleccionó la base de datos correcta en 156 de 184 preguntas difíciles en su primera ejecución y en 151 en la repetición. Su precisión cayó del 84,8 % al 82,1 %. qwen3.8-max pasó de 153 respuestas correctas a 150, un descenso del 83,2 % al 81,5 %.
Ambas repeticiones utilizaron las mismas preguntas, anonimización, temperatura y configuración del proveedor que sus ejecuciones originales. qwen3.8-max cambió su respuesta en 13 preguntas difíciles aunque su total se movió en tres. Las mejoras en algunas preguntas cancelaron errores en otras.
Estas repeticiones muestran que las pequeñas diferencias de puntuación pueden desaparecer en otra ejecución. Una repetición por modelo no puede establecer una distribución de resultados, y los otros 79 modelos no tienen medición repetida.
Los costes registrados dependen de la configuración del proveedor y de la caché
La caché de prompts reutiliza entradas previamente procesadas para reducir los costes facturados de entrada. La ejecución de claude-opus-5 costó $62,78, frente a un estimado de $105,54 con tarifas de lista sin caché para el mismo uso registrado. Esa estimación implica un ahorro del 40,5 %. Se trata de una comparación contable, sin una ejecución de precisión separada sin caché.
RAG agéntico y selección de bases de datos
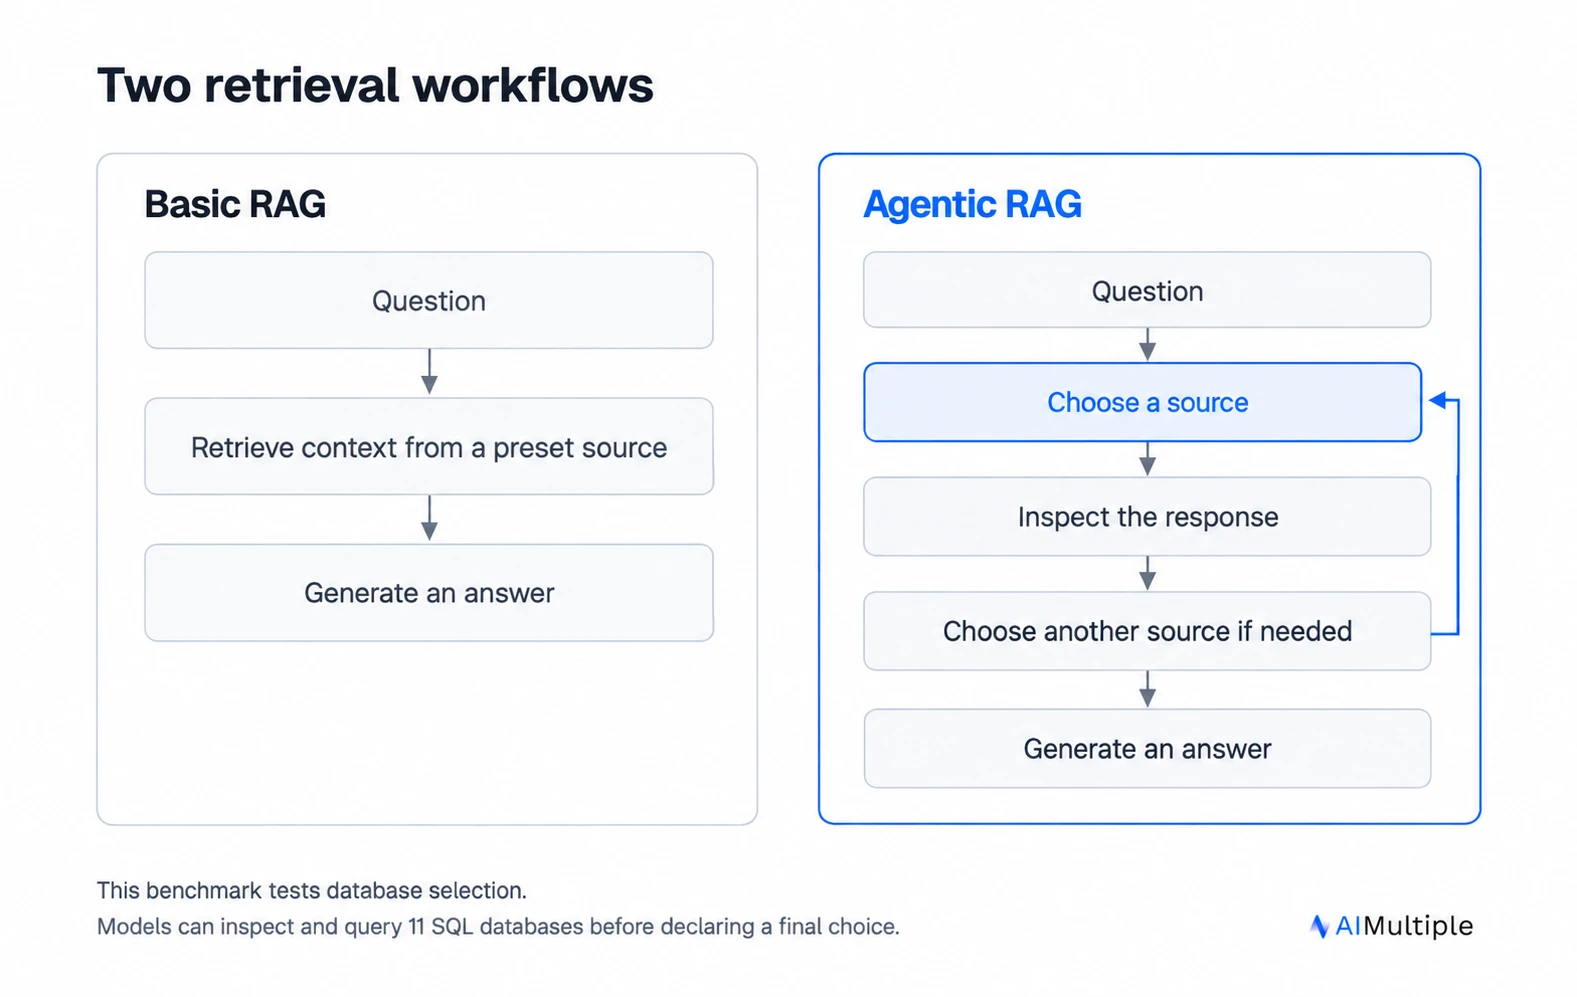
El RAG agéntico da al modelo control sobre las decisiones de recuperación. Puede elegir una fuente, inspeccionar la respuesta y hacer otra solicitud. Un RAG pipeline simple recupera contexto mediante una secuencia predeterminada antes de generar una respuesta.
Este benchmark evalúa la selección de fuentes mediante herramientas de bases de datos SQL. No contiene índice de documentos, pasajes recuperados ni puntuación de fundamentación de respuestas. Por lo tanto, los resultados describen una parte de un sistema de recuperación agéntico. La búsqueda documental se trata por separado en nuestro benchmark de búsqueda agéntica.
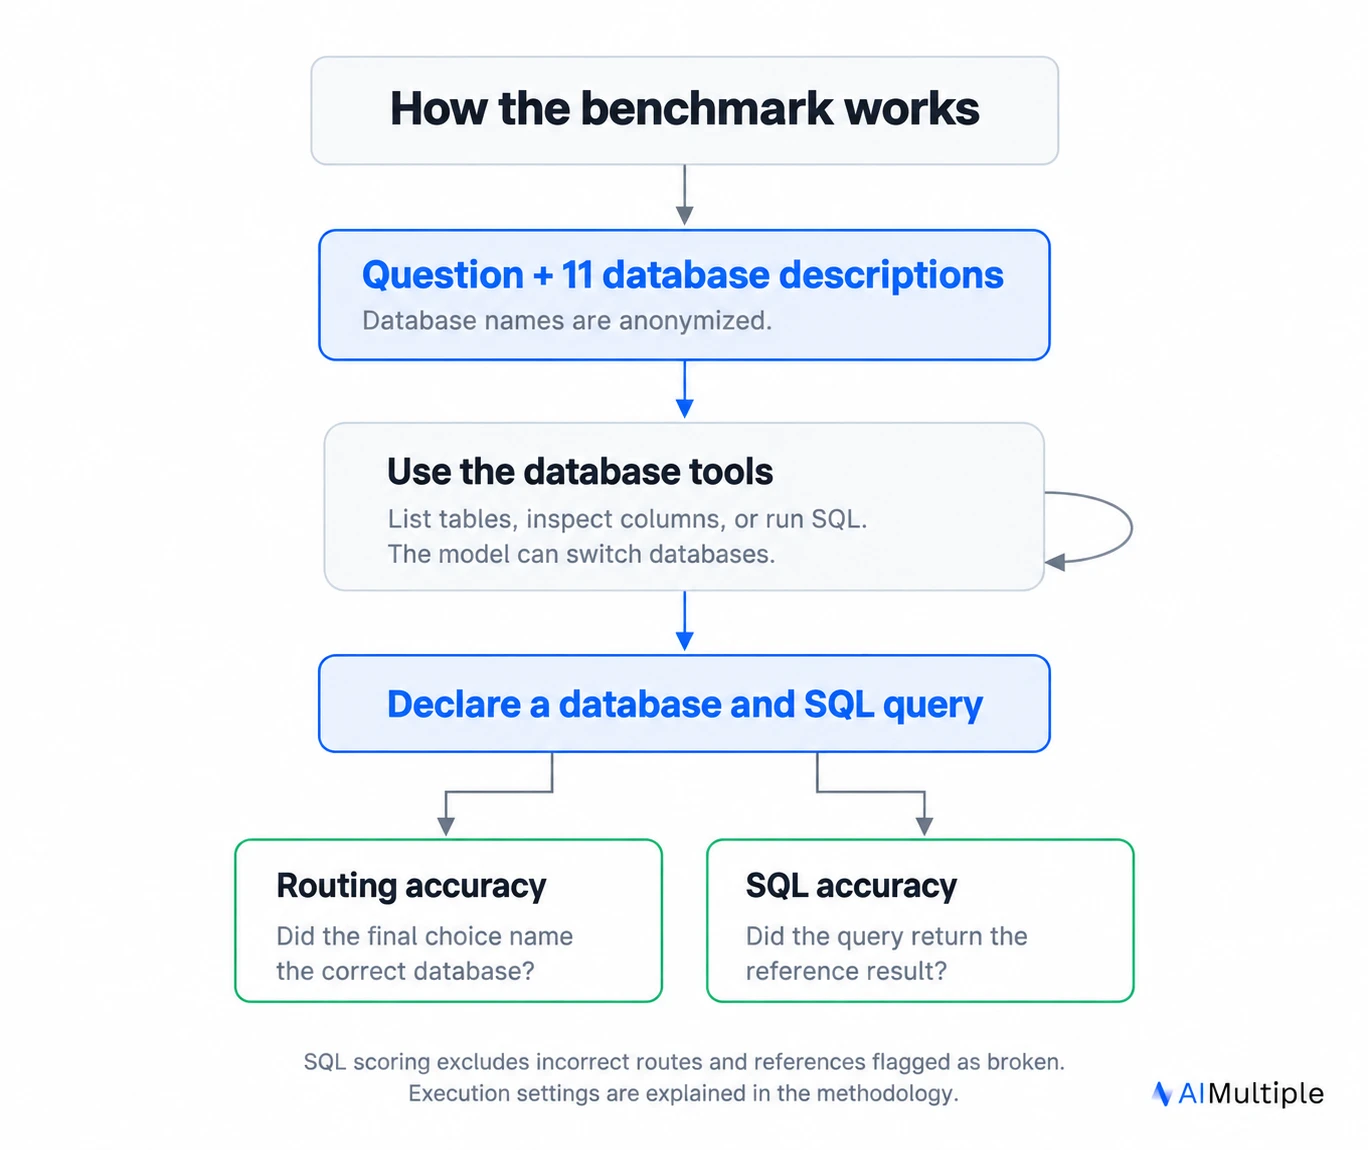
Un modelo comienza con descripciones breves de las bases de datos. Puede solicitar listas de tablas, inspeccionar columnas, ejecutar SQL y cambiar de base de datos. Su respuesta final contiene una elección de base de datos y una consulta. Nuestro benchmark de texto a SQL informa de la precisión en SQL y de dos puntuaciones de revisión complementarias.
Metodología del benchmark de RAG agéntico
El conjunto de preguntas es un subconjunto congelado de BIRD-SQL, que empareja preguntas en lenguaje natural con consultas de referencia SQL.1
Dos señales definen la dificultad. La prueba de similitud cuenta cuántos de los 20 vecinos más cercanos de una pregunta pertenecen a otras bases de datos. Tres LLMs evalúan si la pregunta resulta confusa entre bases de datos. La pertenencia al grupo más difícil requiere al menos cinco vecinos de otras bases de datos y una etiqueta del jurado de confusión.
El enrutamiento utiliza la base de datos nombrada en el campo explícito selected_database. Una ruta inferida a partir de la prosa queda excluida del titular. La corrección de SQL se puntúa por separado y no determina el crédito de enrutamiento.
El harness es el software que presenta las herramientas y registra las respuestas del modelo. El panel contiene 78 ejecuciones de OpenRouter, dos ejecuciones de Claude Code y una ejecución de Codex CLI. Entre las ejecuciones de API, 61 usaron la v3, 15 usaron una versión anterior y dos combinaron registros de ambas versiones. En la v3, una capa de recuperación analiza los formatos alternativos compatibles de llamadas a herramientas. Para llama-4-maverick, la proporción registrada del formato no nativo fue del 97,9 %, por lo que ese resultado depende en gran medida del adaptador. minimax-m2.7 fue excluido porque no realizó las llamadas a herramientas de base de datos requeridas por la tarea.
GPT-6 Astra se ejecutó dentro de Codex CLI. Opus 5.5 y Fable 5.1 se ejecutaron a través de Claude Code. Los tres utilizaron un esfuerzo de razonamiento medio y completaron 759 preguntas. Las ejecuciones de Claude Code usaron suscripciones, y Astra no informó de coste en dólares. El gráfico de costes incluye estimaciones equivalentes a OpenRouter etiquetadas por separado para estas tres ejecuciones de CLI. Las ejecuciones de GPT-6 Luna, Luna Pro, Sol y Sol Pro y GPT-5.2 usaron OpenRouter.
 Añadir como fuente preferida
Limitaciones
El subconjunto difícil se concentra en el comercio. Cuatro bases de datos aportan 171 de sus 184 preguntas, o el 92,9 %. Cinco de las 11 bases de datos no aportan ninguna. Esto respalda conclusiones sobre la elección entre bases de datos similares dentro de un dominio, con evidencia limitada para otras combinaciones de dominios. GPT-6.1 Terra, MiniMax M3.1 Flash y Kimi K3.1 Pro completaron cada uno las 759 preguntas a través de OpenRouter el 27 de octubre. Las respuestas correctas anteriores se retuvieron. Los resultados de los reintentos pueden depender de cambios en la disponibilidad del servicio. DeepSeek V4.1 Flash 1017 y Muse Spark Open completaron cada uno las 759 preguntas a través de OpenRouter el 30 de octubre.
Los datos públicos del benchmark pueden haber aparecido en el entrenamiento de los modelos. Los controles que utilizaron 138 paráfrasis validadas y 65 preguntas de nueva creación no encontraron una disminución de la precisión en los modelos de menor coste evaluados. Su cobertura se limitó a seis y tres bases de datos, respectivamente. No resuelven la contaminación para el panel completo, y ningún control utilizó bases de datos publicadas después de los cortes de entrenamiento de los modelos.
El truncado del esquema puede ocultar tablas útiles. En works_cycles, el límite de 4.000 caracteres deja visibles 26 de 66 tablas en el listado inicial del esquema. El modelo puede solicitar más detalles, pero la vista inicial está incompleta.
Conclusión
gemini-4-argon registró la mayor puntuación de enrutamiento en preguntas difíciles con un 94,0 %. DeepSeek V4 Flash 0731 alcanzó un 82,1 % con $1,37 en costes de respuestas retenidas a lo largo de toda la ejecución.
La configuración de ejecución, los reintentos y los precios de los proveedores limitan las comparaciones. Estos resultados miden la selección de bases de datos entre fuentes SQL similares. La recuperación de documentos y la generación de respuestas fundamentadas requieren evaluaciones separadas.
Lecturas adicionales
- De texto a SQL: Comparación de la precisión de LLM
- Frameworks de RAG: LangChain vs LangGraph vs LlamaIndex
- Mejores herramientas, frameworks y librerías de RAG
- Búsqueda agéntica en 2026: Benchmark de 8 APIs de búsqueda para agentes
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{AIM-Agentic RAG Benchmark: Enrutamiento entre 11 SQL bases de datos}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/agentic-rag}},
  note   = {AIMultiple. Recuperado el 27 de octubre de 2026}
}Resultados y marcas de tiempo de 1.1 mil puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 7 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
16 actualizacionesSe actualizó la sección '¿Qué hace que una pregunta sea difícil en este benchmark?' con nuevo contenido.
Se actualizó la metodología para aclarar cómo se distribuyen las preguntas más difíciles entre las bases de datos.
Se reemplazó la sección de metodología de evaluación comparativa de RAG Agentic con una nueva que cubre 36 LLM y 11 bases de datos.
Se agregaron nuevos modelos al benchmark: Claude Fable 5, Claude Opus 4.8, Gemini 3.5 Flash, Grok 4.3, Claude Opus 4.7.
Se actualizó la sección de metodología con nuevos detalles sobre el entorno de la base de datos, la arquitectura del agente y el proceso de evaluación.
Se añadió una sección sobre modelos de contexto largo frente a RAG agéntico.
Se eliminaron métricas agénticas adicionales de la metodología.
Enlaces de referencia








Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.