


Embedding Models: 25 Models evaluados para recuperación

Evaluamos 25 embedding models en 200 preguntas de recuperación sobre finanzas, contratos legales, soporte técnico y literatura médica. Los cuatro corpus contenían 341.040 pasajes de texto en total. Cada consulta buscó en su propio dominio.
Resultados del benchmark de embedding models
nDCG@10 mide cuán arriba aparecen los pasajes relevantes registrados en los primeros diez resultados. Las puntuaciones van de 0 a 1, y los valores más altos recompensan una mejor ubicación.
Recall@10 mide la proporción de pasajes relevantes registrados de cada pregunta recuperados dentro de los primeros diez resultados, promediada entre preguntas. La precisión de las respuestas generadas quedó fuera de esta evaluación.
Los intervalos de confianza (IC) del 95 % estiman la incertidumbre en el nDCG@10 promedio a partir del muestreo de preguntas. Intervalos más amplios indican estimaciones menos precisas.
Las preguntas se seleccionaron porque BM25 no incluyó sus pasajes de respuesta en sus primeros diez resultados. Su puntuación cero refleja esa selección y limita las comparaciones con la recuperación por palabras clave en tráfico ordinario.
Hallazgos de recuperación en 25 models
Voyage 4 Large registró el nDCG@10 más alto con 0.851
Su IC del 95 % fue 0.817–0.884. Las pruebas pareadas no encontraron diferencias significativas respecto a Cohere Embed 5 Pro, Cohere Embed 5 Fast, Gemini Embedding 2, Voyage 4 ni Gemini Embedding 001 tras corregir por comparaciones múltiples. El ranking sigue siendo incierto. Un resultado no significativo no establece un rendimiento equivalente.
Cohere Embed 5 Pro y Fast obtuvieron puntuaciones significativamente superiores a Embed v4.0
Pro obtuvo 0.850 y Fast obtuvo 0.839, en comparación con 0.772 de Cohere Embed v4.0. Sus mejoras de 0.078 y 0.067 en nDCG@10 fueron significativas tras la corrección en los 300 pares de models. La diferencia de 0.010 entre Pro y Fast no fue significativa.
Gemini Embedding 2 registró el Recall@10 más alto con 96,50 %
Le siguieron Cohere Embed 5 Pro con 95,88 % y Voyage 4 con 95,83 %. Ninguna de las diferencias respecto a Gemini Embedding 2 fue significativa tras la corrección. Mover un pasaje relevante del quinto al primer lugar mejora el nDCG sin cambiar el recall.
PPLX Embed v1 4B lideró los models de pesos abiertos con 0.741 nDCG@10
PPLX Embed v1 0.6B le siguió con 0.698. El model 4B obtuvo una puntuación significativamente superior a nueve de los otros diez models de pesos abiertos. Su diferencia con 0.6B no fue significativa. La comparación de embedding models de código abierto cubre este subconjunto.
Resultados por dominio para finanzas, contratos, soporte y medicina
Las seis puntuaciones nDCG@10 más altas dentro de cada dominio. Cada filtro vuelve a clasificar los models completados en las 50 preguntas de ese dominio.
Cada dominio contribuye por igual al promedio general. Cohere Embed 5 Fast registró la puntuación CUAD más alta con 0.762, y Pro registró la puntuación TechQA más alta con 0.894. MedRAG produjo el nDCG@10 más alto de cada model. Con 50 preguntas por dominio, las pequeñas diferencias en estas puntuaciones siguen siendo inciertas.
Coste de embedding y calidad de recuperación
Calculamos el coste de API de hacer embedding de los mismos 341.040 pasajes y 200 consultas para cada model.
PPLX Embed v1 0.6B tuvo el coste de embedding más bajo, $0,13, y obtuvo 0.698 nDCG@10. Voyage 4 Lite costó $0,62 y obtuvo 0.793. Con $1,87, Voyage 4 alcanzó 0.829.
Cohere Embed 5 Fast costó $2,52 y obtuvo 0.839, mientras que Pro costó $3,40 y obtuvo 0.850. El coste de embedding de Fast fue un 26 % menor en esta carga de trabajo. La diferencia en sus puntuaciones de recuperación no fue estadísticamente significativa tras la corrección por comparaciones múltiples.
Voyage 4 Large costó $3,74 y registró la puntuación más alta, 0.851. Gemini Embedding 2 tuvo el coste más alto, $6,68, y obtuvo 0.830. Gastar más en embeddings no produjo de forma consistente una puntuación de recuperación más alta en esta prueba.
Los costes cubren las llamadas de embedding exitosas utilizadas en la evaluación. Los totales de Cohere usan los tokens de entrada reportados multiplicados por la tarifa registrada. El coste de $3,72 de Embed v4.0 es una estimación porque su tarifa directa de API no se verificó. Quedan excluidos los reintentos, diagnósticos, comisiones de cuenta, almacenamiento y cómputo de búsqueda. Estos importes describen la carga de trabajo probada y las rutas de API. Los costes de producción dependerán del volumen de texto, la tokenización y los precios del proveedor.
Cómo los text embeddings apoyan la recuperación
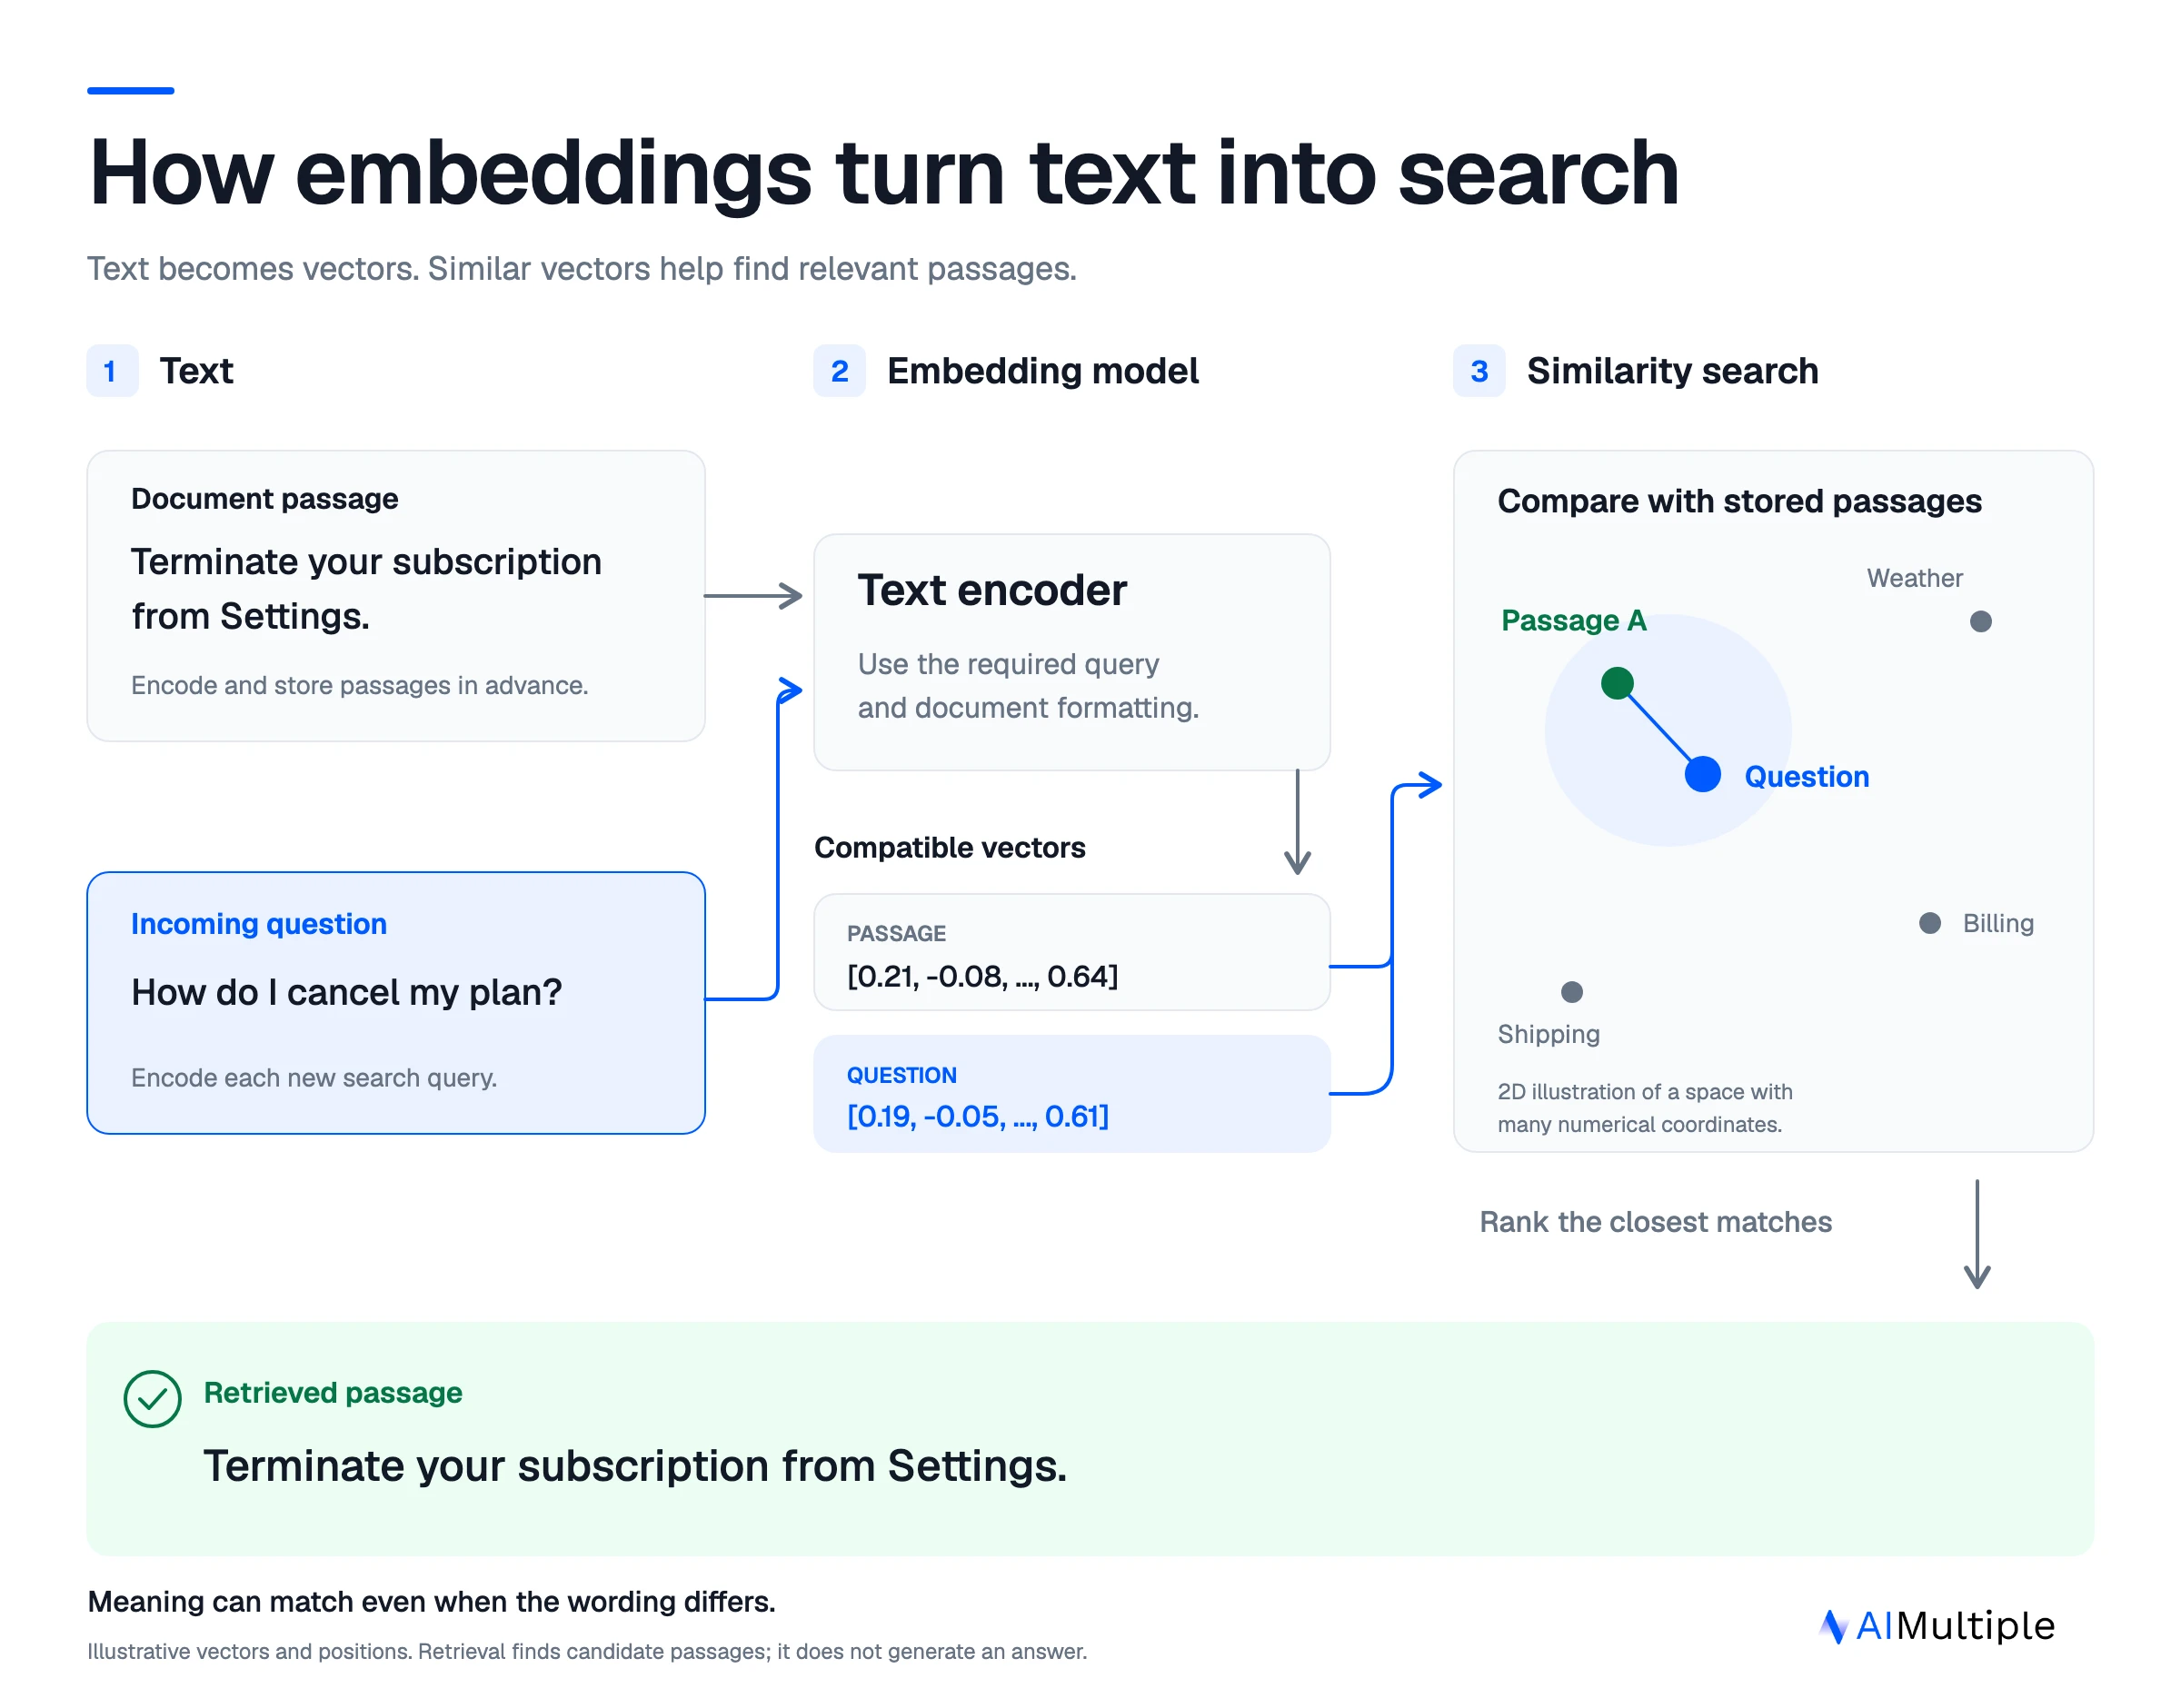
Un embedding model convierte texto en un vector, una lista de valores numéricos que se puede comparar con otros vectores de un model compatible. En la recuperación semántica, los pasajes de documentos se codifican de antemano. En el momento de la búsqueda, el sistema codifica la consulta y clasifica los pasajes almacenados por similitud vectorial.1
Por ejemplo, una pregunta sobre cancelar un plan puede estar cerca de un pasaje sobre rescindir una suscripción a pesar de una redacción diferente. El entrenamiento del model determina qué relaciones conservan los vectores.2 El diagrama comprime esta idea en dos dimensiones. Los embeddings desplegados generalmente contienen muchas más coordenadas.
El formato de consulta y documento también importa. Un model puede esperar roles o prefijos de recuperación separados incluso cuando ambas salidas ocupan un espacio vectorial compatible. Aplicamos el formato de consulta y documento requerido por cada model.
Una base de datos vectorial almacena y busca vectores, mientras que el embedding model determina las representaciones que se buscan. Los pasajes recuperados pueden convertirse luego en contexto para un generador de respuestas. Este benchmark se detiene en la recuperación de pasajes y no puntúa las respuestas generadas.
Metodología del benchmark de embedding models
Todos los models buscaron los mismos pasajes usando las mismas 200 preguntas y 225 pares pregunta-pasaje relevantes registrados. Las preguntas y etiquetas se congelaron antes de comparar las puntuaciones de embedding. Las entradas de consulta contenían solo la pregunta original.
Los pasajes de finanzas procedían de los informes anuales de FinQA y los pasajes legales de los contratos de CUAD v1.34 El soporte técnico utilizó notas técnicas de TechQA, y la literatura médica utilizó una muestra de resúmenes de PubMed de MedRAG.56
Los pasajes eran párrafos completos, tablas con contexto, cláusulas de contrato o resúmenes con títulos. Excluimos unidades de más de 256 tokens según el tokenizador all-MiniLM-L6-v2. Los pasajes aceptados se mantuvieron intactos, y los models de 512 tokens recibieron como máximo 459 tokens por pasaje. Por lo tanto, este benchmark evalúa pasajes cortos.
Unos LLMs de vanguardia redactaron las preguntas a partir de los pasajes fuente. Un miembro del equipo verificó el 20 % de las preguntas (40 de 200). Los LLMs también juzgaron los 20 pasajes principales de BM25 por pregunta, añadiendo 25 pasajes relevantes a los 200 pasajes fuente originales.
Análisis de recuperación y estadístico
La recuperación comparó cada consulta con cada pasaje de su dominio. Usamos similitud de coseno para 21 models y producto punto para MultiQA MPNet Base Dot v1. BGE-M3 usó sus vectores densos.7 Las entradas de consulta y documento usaron los roles o prefijos de recuperación configurados de cada model.
Ambas métricas son promedios entre preguntas. Calculamos los IC del 95 % con 10.000 muestras bootstrap, remuestreando 50 preguntas dentro de cada dominio. Las comparaciones por pares usaron pruebas pareadas de signo invertido con corrección de Holm en los 231 pares de models para cada métrica y alcance. Consideramos significativas las diferencias con un valor p corregido inferior a 0.05.
IDs de model probados, dimensiones y límites de entrada
Los 22 models originales se ejecutaron a través de OpenRouter, con un proveedor de backend fijo por model y fallbacks desactivados. Los tres models de Cohere se ejecutaron a través de la API de Cohere usando roles nativos de documento y consulta (search_document y search_query). La tabla registra los identificadores de API, las dimensiones de salida y los límites de entrada utilizados, incluidos los límites conservadores.
Los identificadores de API no garantizan una instantánea inmutable del model. Las revisiones del tokenizador se fijaron donde estaban disponibles. Los pesos de los models alojados no se verificaron de forma independiente. Las longitudes de entrada de Gemini y Cohere se comprobaron mediante estimaciones conservadoras. Los pasajes cortos no probaron la recuperación de contexto largo.
 Añadir como fuente preferida
Alcance y limitaciones
Las preguntas forman un conjunto de desarrollo seleccionado por BM25. Los resultados en consultas de producción ordinarias pueden diferir. Los juicios de relevancia se limitaron a los pasajes fuente y a los 20 principales de BM25. En los 25 models, el 87 % de los pares pregunta-pasaje distintos recuperados en los diez primeros no fueron juzgados y no recibieron crédito de relevancia.
Cada model se ejecutó una vez. Los IC reflejan el muestreo de preguntas y excluyen la variación entre ejecuciones de API o la incertidumbre por etiquetas incompletas. No se probó la contaminación de datos de entrenamiento.
Esta evaluación cubre la recuperación de texto. La precisión de las respuestas generadas, la recuperación híbrida, el reranking, la latencia y el coste de servicio quedaron fuera de su alcance. El benchmark de rerankers, la comparación de embedding multilingüe y la comparación de embedding multimodal cubren cargas de trabajo independientes.
Conclusión
Voyage 4 Large registró el nDCG@10 más alto, sin una brecha significativa respecto a Cohere Embed 5 Pro o Fast. Ambos models de Cohere obtuvieron puntuaciones significativamente superiores a Embed v4.0. Gemini Embedding 2 lideró en recall, y PPLX Embed v1 4B lideró el grupo de pesos abiertos.
Usa los resultados por dominio para elegir candidatos y compáralos en consultas representativas con etiquetas de relevancia revisadas. Mide la latencia y el coste de servicio de extremo a extremo por separado.
Lecturas adicionales
- Benchmark de embedding models de código abierto
- Embedding models multilingües para RAG
- Embedding models multimodales
- Benchmark de bases de datos vectoriales de código abierto
Cita este benchmark
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{sari2026,
  author = {Sarı, Ekrem},
  title  = {{Embedding Models: 25 Models evaluados para recuperación}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/embedding-models}},
  note   = {AIMultiple. Recuperado el 1 de octubre de 2026}
}Resultados y marcas de tiempo de 180 puntos de datos. Descargue los datos resumidos que se muestran en los gráficos y las tablas de este artículo como un archivo ZIP que contiene 8 archivos CSV y un README.
¿Quieres los datos granulares que hay detrás? Únete a Premium
Registro de cambios
5 actualizacionesSe añadió la definición de la métrica Top-1 hit a la metodología del benchmark de embeddings.
Reemplazó el benchmark por 15 modelos y una línea base BM25 probados en corpus legales, de soporte al cliente y de salud.
Enlaces de referencia





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.