


Calidad de los datos en IA: desafíos y mejores prácticas

La mala calidad de los datos retrasa la implementación exitosa de proyectos de IA y ML. 1 Incluso los algoritmos de IA más avanzados pueden producir resultados defectuosos si los datos subyacentes son de baja calidad.
Explore la importancia de la calidad de los datos en la IA, los desafíos que encuentran las organizaciones y las mejores prácticas para garantizar datos de alta calidad:
¿Cuál es la importancia de la calidad de los datos en la IA?
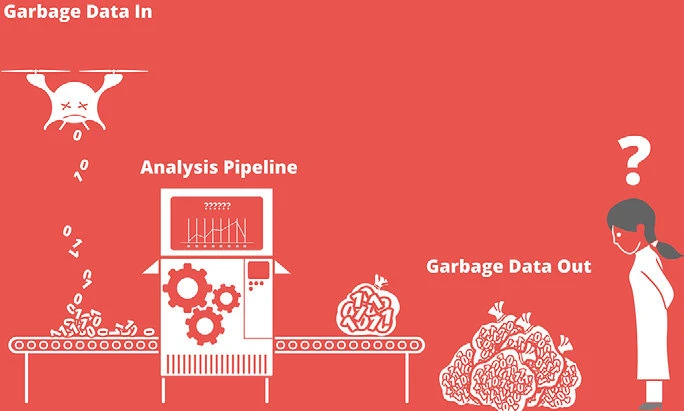
La calidad de los datos es esencial para la inteligencia artificial, ya que influye directamente en el rendimiento, la precisión y la fiabilidad de los IA models. Los datos de alta calidad permiten que los models hagan mejores predicciones y produzcan resultados más fiables. El impacto de la mala calidad de los datos en la IA se ilustra en la Figura 1.
Figura 1: Impacto de la mala calidad de los datos y de la analítica
Fuente: SnapLogic2
Abordar los sesgos de los datos es crucial para garantizar la calidad de los datos. Esto evita la perpetuación y amplificación de sesgos en los resultados generados por la IA, ayudando a minimizar el trato injusto a grupos o individuos específicos.
Además, un dataset diverso y representativo mejora la capacidad de un IA model para generalizar bien en diferentes situaciones y entradas, garantizando su rendimiento y relevancia en diversos contextos y grupos de usuarios.
Como afirma Andrew Ng, profesor de IA de la Universidad de Stanford y fundador de DeepLearning.IA: «Si el 80 por ciento de nuestro trabajo es la preparación de datos, garantizar la calidad de los datos es la tarea más crítica para un equipo de aprendizaje automático».
¿Por qué es crucial evitar el problema de «basura entra, basura sale» para la calidad de los datos?
«Basura entra, basura sale» (GIGO) es un principio simple pero eficaz que subraya la importancia de la calidad de los datos de entrada. Significa que si los datos de entrada de un sistema, como un IA model o algoritmo, son de mala calidad, inexactos o irrelevantes, la salida del sistema también será de mala calidad, inexacta o irrelevante.
Figura 2: Calidad y estándares de los datos: datos «basura entra», resultados «basura sale».
Fuente: Shakoor et al. 3
Este concepto es particularmente significativo en el contexto de la IA, ya que los IA models, incluidos los modelos de aprendizaje automático y aprendizaje profundo, dependen en gran medida de los datos utilizados para el entrenamiento y la validación. Es probable que el IA model produzca resultados poco fiables o sesgados si los datos de entrenamiento están sesgados, incompletos o contienen errores.
Para evitar el problema GIGO, es crucial garantizar que los datos utilizados en los sistemas de IA sean precisos, representativos y de alta calidad. Esto suele implicar limpieza de datos, preprocesamiento y aumento de datos, junto con el uso de métricas de evaluación sólidas para evaluar el rendimiento de los IA models.
¿Cuáles son los componentes clave de los datos de calidad en la IA?
Precisión: Los datos precisos son cruciales para los algoritmos de IA, ya que les permiten producir resultados correctos y fiables. Los errores en la entrada de datos pueden llevar a decisiones incorrectas o a perspectivas equivocadas, lo que podría perjudicar a organizaciones e individuos.
Consistencia: Garantiza que los datos sigan un formato y una estructura estándar, lo que facilita su procesamiento y análisis eficientes. Los datos inconsistentes pueden generar confusión y malas interpretaciones, perjudicando el rendimiento de los sistemas de IA.
Completitud: Los datasets incompletos pueden hacer que los algoritmos de IA pasen por alto patrones y correlaciones esenciales, lo que genera resultados incompletos o sesgados. Garantizar la completitud de los datos es vital para entrenar IA models de manera precisa y completa.
Puntualidad: La frescura de los datos desempeña un papel importante en el rendimiento de la IA. Los datos obsoletos pueden no reflejar el entorno o las tendencias actuales, lo que genera resultados irrelevantes o engañosos.
Relevancia: Los datos relevantes contribuyen directamente al problema en cuestión, ayudando a los sistemas de IA a centrarse en las variables y relaciones más importantes. Los datos irrelevantes pueden saturar los models y generar ineficiencias.
¿Cuáles son los desafíos para garantizar la calidad de los datos en la IA?
1-Recopilación de datos
A medida que los avances en IA benefician a industrias como las finanzas, la atención médica, la fabricación y el entretenimiento, las organizaciones enfrentan el desafío de recopilar datos de diversas fuentes manteniendo la calidad. Muchas recurren a web scrapers para automatizar y garantizar que todos los puntos de datos sigan los mismos estándares.
2-Etiquetado de datos
Los algoritmos de IA dependen de datos etiquetados para el entrenamiento, pero el etiquetado manual consume mucho tiempo y es propenso a errores. Obtener etiquetas precisas que reflejen las condiciones del mundo real suele ser difícil.
3-Almacenamiento y seguridad de los datos
Garantizar la calidad de los datos implica protegerlos del acceso no autorizado y de la posible corrupción. Es esencial que las organizaciones cuenten con un almacenamiento de datos seguro y fiable, pero esto puede resultar difícil.
4-Gobernanza de datos
Las organizaciones a menudo tienen dificultades para implementar frameworks de gobernanza de datos que aborden eficazmente los problemas de calidad de los datos. La falta de una gobernanza de datos adecuada puede dar lugar a datos aislados, inconsistencias y errores.
5-Envenenamiento de datos
El envenenamiento de datos es un ataque dirigido a los sistemas de IA en el que los atacantes introducen información maliciosa o engañosa en el dataset. Estos datos envenenados pueden distorsionar el entrenamiento del model, lo que genera resultados poco fiables o incluso perjudiciales. Para mitigar este riesgo, es crucial mantener la integridad de los datos mediante auditorías periódicas y detección de anomalías.
6-Bucles de retroalimentación de datos sintéticos
Alimentar IA models con datos generados por IA puede crear bucles de retroalimentación que degradan la calidad del model. Por ejemplo, cuando se utilizan datos sintéticos repetidamente, el model puede aprender patrones demasiado artificiales y alejados de las condiciones del mundo real. Esto puede hacer que los models tengan un mal rendimiento con datos reales, amplificando potencialmente sesgos o errores. Equilibrar los datos sintéticos y reales es esencial para mantener la robustez del model.
Casos de estudio del mundo real
Caso de estudio 1: Mayo Clinic – Administración de datos antes de la IA
Mayo Clinic, con aproximadamente 76.000 empleados en tres campus, trata la preparación de los datos como el primer paso de cualquier proyecto de IA.4
El desafío: La responsabilidad de los datos está repartida entre muchas unidades clínicas y de negocio. El director de datos y analítica, Ajai Sehgal, afirma que cuando nadie es responsable de administrar los datos, aparecen problemas de datos, y la IA en el cuidado de la salud no puede permitirse resultados de baja calidad.
La solución: Mayo convirtió a los equipos clínicos y de negocio que mejor conocen los datos en sus administradores, responsables de preparar sus datos para el análisis. Un equipo central mantiene una biblioteca de datos que vincula cada elemento de datos con sus metadatos y reglas clínicas relacionadas. La práctica de cirugía de Mayo, por ejemplo, está iniciando su trabajo de IA preparando sus datos y ha propuesto un equipo de datos y analítica autofinanciado.
Caso de estudio 2: JPMorgan Chase – Detección de fraude con datos internos verificados
JPMorgan Chase utiliza large language models para detectar fraudes como el compromiso del correo electrónico empresarial.5
El desafío: Ryan Schmiedl, que dirige la detección de fraudes, el cribado de sanciones y las comprobaciones de conocimiento del cliente del banco, advirtió en 2023 que los models entrenados con datos de todo internet, como ChatGPT, pueden presentar afirmaciones no verificadas como hechos.
La solución: El banco entrena sus LLMs solo con datos de su propio ecosistema y primero se asegura de que esos datos hayan sido auditados y validados. También utiliza IA para extract nombres de empresas y personas a partir de datos no estructurados y los analiza para detectar riesgo de fraude.
Caso de estudio 3: Walmart – Limpieza de datos del catálogo de productos con LLMs
Walmart utilizó IA generativa para mejorar los datos del catálogo de productos que respaldan su búsqueda y sus páginas de productos.6
El desafío: Mantener los datos del catálogo completos y precisos a la escala de Walmart requiere mucha mano de obra. El CEO Doug McMillon afirmó que, sin IA generativa, el trabajo habría requerido “casi 100 veces la plantilla actual”.
La solución: Walmart utilizó múltiples large language models para crear o mejorar más de 850 millones de piezas de datos del catálogo, dijo McMillon en la llamada de resultados del 15 de agosto de 2024. El CEO de Walmart U.S., John Furner, afirmó que los datos mejorados ayudan a la empresa a hacer coincidir el catálogo con lo que buscan los clientes.
Mejores prácticas para garantizar la calidad de los datos en la IA
1-Implementar políticas de gobernanza de datos
Un framework de gobernanza de datos debe definir estándares, procesos y roles de calidad de datos. Esto ayudará a crear una cultura de calidad de datos y a garantizar que las prácticas de gestión de datos se alineen con los objetivos organizacionales.
Ejemplo de la vida real: Airbnb
Airbnb lanzó «Data University» para mejorar la alfabetización de datos en toda su plantilla ofreciendo cursos personalizados que integran los datos y las herramientas específicas de Airbnb. Desde su creación en el tercer trimestre de 2016, Data University ha aumentado el compromiso con las herramientas internas de ciencia de datos de Airbnb, elevando los usuarios activos semanales del 30 % al 45 %.
Con más de 500 empleados participando, la iniciativa subraya la importancia de alinear los esfuerzos de gobernanza de datos con los objetivos organizacionales, promoviendo una cultura empresarial de calidad de datos y toma de decisiones informada. El programa ejemplifica cómo los frameworks de gobernanza de datos personalizados pueden impulsar la competencia en datos y fomentar la alineación con los objetivos de negocio.
2-Utilizar herramientas de calidad de datos
Las herramientas de calidad de datos pueden automatizar los procesos de limpieza, validación y monitoreo de datos, garantizando que los IA models tengan acceso constante a datos de alta calidad.
Ejemplo de la vida real: General Electric
Un ejemplo relevante de la vida real sobre el uso de herramientas de calidad de datos es la implementación por parte de General Electric (GE) de su estrategia de gobernanza y gestión de la calidad de datos, particularmente dentro de su plataforma Predix para analítica de datos industriales. Para respaldar su transformación digital y sus iniciativas de IA, GE invirtió en un sólido conjunto de herramientas de calidad de datos para mantener altos estándares de datos en todo su ecosistema de IoT industrial.
GE implementó herramientas automatizadas de limpieza, validación y monitoreo continuo de datos para gestionar los enormes volúmenes de datos generados por sus equipos industriales, como turbinas y motores a reacción. Estas herramientas ayudaron a GE a garantizar que los datos que alimentaban sus IA models fueran precisos, consistentes y fiables, reduciendo la necesidad de intervención manual y permitiendo información en tiempo real basada en datos.
Ejemplos de soluciones de calidad de datos
Pandada IA, que se lanzó a principios de 2026, es una plataforma impulsada por IA para la limpieza y el análisis automatizado de datos. Puede ingerir archivos de datos (CSV, hojas de cálculo de Excel, PDF e incluso imágenes) y generar informes y presentaciones de analítica estructurados y compartibles.7 La plataforma incluye funciones inteligentes de limpieza de datos (eliminación de duplicados, normalización de formatos, detección de valores faltantes) que corrigen automáticamente los problemas de datos, reduciendo el trabajo manual de preparación de datos.8
Sieve es una plataforma de limpieza de datos de una startup de Y Combinator de la primavera de 2025 que combina el procesamiento impulsado por IA con una revisión humana opcional.9 Proporciona una API y un complemento de Excel para la limpieza automatizada de datos, dirigiendo automáticamente cualquier problema marcado a operadores humanos para su validación.9
3-Desarrollar un equipo de calidad de datos
Desarrollar un equipo dedicado responsable de la calidad de los datos garantizará el monitoreo y la mejora continua de los procesos relacionados con los datos. El equipo también puede educar y capacitar a otros empleados sobre la importancia de la calidad de los datos.
4-Colaborar con los proveedores de datos
Establecer relaciones sólidas con los proveedores de datos y garantizar su compromiso con la calidad de los datos puede minimizar el riesgo de recibir datos de baja calidad.
5-Monitorear continuamente las métricas de calidad de datos
Medir y monitorear periódicamente las métricas de calidad de los datos puede ayudar a las organizaciones a identificar y abordar posibles problemas antes de que afecten al rendimiento de la IA.
 Añadir como fuente preferida
¿Qué son los datos de IA?
Los datos de IA se refieren, en términos generales, a cualquier dato utilizado en el desarrollo o el funcionamiento de sistemas de inteligencia artificial. En consecuencia, esto incluye, entre otros, datasets utilizados para entrenar models, datos de entrada en tiempo real utilizados para predicciones y datos sintéticos generados para aumentar ejemplos del mundo real. Si bien no es un término técnico formal, «datos de IA» se utiliza comúnmente para describir la información que impulsa los sistemas de aprendizaje automático y aprendizaje profundo.
Preguntas frecuentes
Según la investigación de Gartner, la mala calidad de los datos cuesta a las organizaciones un promedio de 12.9 millones de dólares al año. Sin embargo, el coste real va más allá del impacto financiero directo. La mala calidad de los datos provoca proyectos de IA fallidos; los informes del sector sugieren que hasta el 85 % de los proyectos de IA y ML no cumplen su promesa inicial, a menudo debido a problemas de calidad de los datos. Los costes adicionales incluyen el tiempo perdido, ya que los científicos de datos pasan entre el 60 y el 80 % de su tiempo en la limpieza de datos en lugar del desarrollo de models, la pérdida de oportunidades de ingresos por predicciones inexactas y malas experiencias de los clientes, y riesgos de cumplimiento, especialmente en industrias reguladas donde los fallos de calidad de los datos pueden dar lugar a multas significativas.
Investigaciones de fuentes del sector indican que entre el 70 y el 85 % de los fracasos de los proyectos de IA se deben a problemas relacionados con los datos, siendo la calidad de los datos la principal culpable. El análisis de VentureBeat sobre implementaciones de IA encontró que el 87 % de los proyectos de ciencia de datos nunca llegan a producción, y la causa principal son datos inadecuados o de mala calidad. Una encuesta de Dimensional Research reveló que el 96 % de las organizaciones encuentra problemas de calidad de datos al entrenar IA models. Estos fracasos se manifiestan de varias maneras, incluyendo models que funcionan bien en las pruebas pero fallan en producción debido a la deriva de datos, resultados sesgados derivados de datos de entrenamiento no representativos y la incapacidad de escalar porque las pipelines de datos no pueden mantener la calidad en los volúmenes de producción.
Si bien están estrechamente relacionadas, la calidad de los datos y la gobernanza de datos tienen propósitos diferentes. La calidad de los datos se refiere a las características de los propios datos, centrándose en si son precisos, completos, consistentes, puntuales y relevantes. Se trata de la condición y la usabilidad de los datos para su propósito previsto. La calidad de los datos se mide normalmente mediante métricas como tasas de error, porcentajes de completitud y recuentos de duplicados.
La gobernanza de datos, por otro lado, es el framework de políticas, procedimientos, roles y responsabilidades que garantizan una gestión adecuada de los datos en toda la organización. La gobernanza define quién es el propietario de los datos, quién puede acceder a ellos, cómo deben utilizarse, qué estándares deben cumplir y cómo debe mantenerse la calidad.
Piense en la gobernanza de datos como la estructura organizativa y el libro de reglas, mientras que la calidad de los datos es el resultado que se intenta lograr. Una buena gobernanza permite una buena calidad, pero se necesitan ambas para tener éxito en las iniciativas de IA. La gobernanza proporciona la estructura sostenible que garantiza que la calidad de los datos no sea una limpieza puntual, sino una práctica continua.
Cita esta investigación
Elige el formato que se ajuste al lugar donde vas a publicar. Pegar la versión con enlace en tu CMS conserva el enlace de retroceso.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Arslan, Ezgi},
  title  = {{Calidad de los datos en IA: desafíos y mejores prácticas}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/data-quality-ai}},
  note   = {AIMultiple. Recuperado el 23 de octubre de 2026}
}
Registro de cambios
6 actualizacionesSe añadieron Pandada AI y Sieve a la sección "Ejemplos de soluciones de calidad de datos".
Se añadió la sección de preguntas frecuentes.
Enlaces de referencia
El trabajo de Cem en AIMultiple ha sido citado por publicaciones líderes mundiales como Business Insider, Forbes, Morning Brew y Washington Post, empresas globales como Deloitte y HPE, ONG como World Economic Forum y organizaciones supranacionales como European Commission. [1], [2], [3], [4], [5]
A lo largo de su carrera, Cem trabajó como consultor tecnológico, comprador de tecnología y emprendedor tecnológico. Asesoró a empresas en sus decisiones tecnológicas en McKinsey & Company y Altman Solon durante más de una década. También publicó un informe de McKinsey sobre digitalización.
Dirigió la estrategia tecnológica y las adquisiciones de una empresa de telecomunicaciones reportando al CEO. También lideró el crecimiento comercial de la empresa de deep tech Hypatos, que alcanzó unos ingresos recurrentes anuales de 7 dígitos y una valoración de 9 dígitos desde 0 en 2 años. El trabajo de Cem en Hypatos fue cubierto por publicaciones tecnológicas líderes como TechCrunch y Business Insider.
Cem participa habitualmente en conferencias internacionales de tecnología. Se graduó en Bogazici University como ingeniero informático y tiene un MBA de Columbia Business School.





Sé el primero en comentar
Tu dirección de correo electrónico no será publicada. Todos los campos son obligatorios. Los comentarios se dejan en su idioma original.