


Melhores ferramentas de web scraping com IA em benchmark

Avaliamos as principais ferramentas de web scraping com IA com 25.000 solicitações, 5.000 por ferramenta, em 500 URLs em cada um dos 10 domínios mais visitados para ver o desempenho delas e também comparamos como cada uma aproveita a IA.
Benchmark de web scraping com IA
Veja a metodologia do benchmark seção para mais detalhes sobre o processo de teste.
Comparação de completude e precisão
Para cada domínio, solicitamos os campos que importam naquele tipo de página: preço e moeda em páginas de e-commerce, texto da publicação, curtidas e autor nas redes sociais. Para medir o desempenho dessas ferramentas, usamos três métricas: sucesso, completude e precisão. São necessárias três porque uma ferramenta pode retornar algo sem retornar tudo, e tudo sem que nada esteja correto.
Sucesso: a parcela de solicitações que retornaram com pelo menos um dos campos solicitados.
Completude: a parcela dos campos solicitados que realmente retornaram, calculada em média entre as solicitações.
Precisão: a parcela dos campos verificáveis que retornaram com um valor correto, verificada em relação a uma referência ou ao consenso das outras ferramentas. Um campo que nunca retornou conta como errado.
Metodologia estatística
Os intervalos de confiança foram calculados usando reamostragem bootstrap por percentil:
Reamostragens: 10.000
Nível de confiança: 95%
Unidade de reamostragem: URL, com todos os cinco fornecedores reamostrados no mesmo sorteio
Métricas: taxa de sucesso, completude, precisão e tempo de conclusão
Tamanho da amostra: N = 5.000 URLs por fornecedor (500 em cada um dos 10 domínios)
As pontuações por domínio são calculadas primeiro e, em seguida, é calculada a média entre os dez domínios
Resultados do benchmark de web scraping com IA
Em 5.000 URLs nos 10 domínios, chamamos cada ferramenta da forma como sua própria API foi construída. Bright Data, Apify e Firecrawl aceitam uma lista de URLs em uma única solicitação, por isso enviamos 100 URLs por solicitação. Oxylabs e ScrapingBee aceitam uma URL por solicitação, por isso as enviamos uma por vez. A concorrência foi a mesma em todas as ferramentas, cinco solicitações paralelas, então a única diferença é o que cada API suporta.
- Bright Data obteve a maior pontuação em todas as três medidas de qualidade: 85% de sucesso, 76% de completude, 60% de precisão.
- A maior precisão no campo foi de 60%. Dois em cada cinco campos verificáveis voltaram ausentes ou errados.
- A completude variou de Bright Data’s 76% até Apify’s 32%, com Oxylabs em 59%, Firecrawl em 53% e Scraping Bee em 41%.
- Firecrawl foi a mais rápida, com menos de meio segundo por URL, contra Bright Data’s 4,6 segundos, e 22 pontos a menos em precisão. Oxylabs foi a mais lenta, com 35 segundos.
Cada fornecedor adota uma abordagem diferente de IA, e nosso objetivo foi comparar essas abordagens e as compensações que elas trazem.
Principais conclusões sobre as ferramentas de web scraping com IA a partir do benchmark
- Falhas podem parecer dados. Quando uma ferramenta não consegue ler um preço, muitas vezes porque a página atingiu uma barreira anti-bot, ela pode retornar 0 em vez de falha. Um nulo pode ser repetido ou ignorado, mas um 0 passa pela validação sem ser notado. Apify e Oxylabs retornaram nulo nesses casos. A documentação do Firecrawl recomenda adicionar “Retorne null se não for encontrado na página” a cada campo do esquema para que o modelo não adivinhe um valor.
- Campos extras: um prompt que solicita preço e moeda também pode retornar marca, descrição ou URLs de imagem. Um esquema limita a resposta aos campos que você nomeia. Bright Data bloqueia o esquema de saída no momento da criação, então cada chamada retorna os mesmos campos.
- Elemento errado: em páginas que mostram um preço com desconto e um preço original, preços com e sem impostos, ou opções regionais de preço, uma ferramenta pode extract o número errado.
- Números alterados: ferramentas de prompt para JSON podem adicionar decimais, cortar valores ou retornar aproximações convertidas de moeda que não aparecem na página.
- A localização altera o preço: alguns sites definem preços pela localização do IP do visitante, então uma ferramenta em proxies dos EUA vê um preço diferente de um usuário europeu.
O esquema e a região do proxy são os parâmetros que permitem detectar a maior parte disso antes que chegue aos seus dados.
Preços das ferramentas de web scraping com IA
A Kadoa não está no gráfico de preços porque não publica tarifas. A Kadoa oferece um plano Flex baseado em consumo e um plano Enterprise com preços definidos por meio da equipe de vendas.
Comparação das ferramentas de web scraping com IA
Tempo até o primeiro scraper: para ferramentas que criam um scraper que você chama por ID, quanto tempo a configuração leva. “Chamada HTTP única” significa que não há nenhuma etapa de criação.
Esquema de saída definido pelo usuário: se você pode definir os campos de saída e seus tipos antes da raspagem ser executada, em vez de descrevê-los em um prompt e deixar o LLM decidir a estrutura em tempo de execução.
Endpoint de criar uma vez, chamar muitas vezes: se o scraper é criado uma vez, armazenado no lado do fornecedor e depois chamado apenas com uma URL. Aqui, o LLM (ou, para ferramentas baseadas em gravação, o seu fluxo de cliques) é executado no momento da criação e sua saída é congelada em um scraper que você possui e pode alterar no lugar, que é o que as programações, webhooks e integrações usam como referência. Quando isso não existe, a extração é recalculada a cada chamada, e a definição completa viaja com cada solicitação.
Scraper salvo com autorreparação: se um scraper salvo é reparado quando o site de destino muda, sem reconstruí-lo do zero. A correção se aplica ao mesmo scraper armazenado sob seu identificador existente, para que gatilhos, programações e integrações continuem funcionando.
* A Kadoa armazena o scraper e o chama por ID, mas as URLs de destino são vinculadas quando o workflow é criado. Apontá-lo para uma nova URL exige uma atualização separada de metadados antes da execução.
Ferramentas que executam um LLM sobre a página a cada chamada não são contadas aqui: não há lógica de extração persistida para reparar, o que as torna tolerantes a mudanças de layout, mas também significa que não há artefato para inspecionar, versionar ou aprovar. Nem caches internos sem um identificador para o qual você possa apontar, já que, novamente, não há nada para inspecionar, versionar ou aprovar.
Além de questões como páginas em constante mudança, em pipelines agênticos muitas vezes você precisa de uma API simples para chamar: forneça uma URL e receba dados estruturados de volta. Mas nem sempre você encontra uma API pronta de scraper para cada domínio que precisa raspar regularmente; e, quando encontra, os campos que você deseja podem não estar lá, ou você precisa personalizar o esquema de acordo com suas próprias necessidades. Existem diferentes abordagens para resolver esses problemas.
Plataformas de web scraping com IA de criar uma vez e chamar muitas vezes
Se você criar seu próprio scraper, terá que escrever o crawler, configurar proxies, executar navegadores headless e lidar com filas, repetições e anti-bot por conta própria.
As ferramentas de web scraping com IA reduzem esse trabalho. Plataformas de criar uma vez e chamar muitas vezes, como Bright Data Scraper Studio, Browse IA e Kadoa, criam um scraper uma vez, a partir de um prompt ou da gravação de cliques, e o armazenam para que você possa chamá-lo com uma URL.
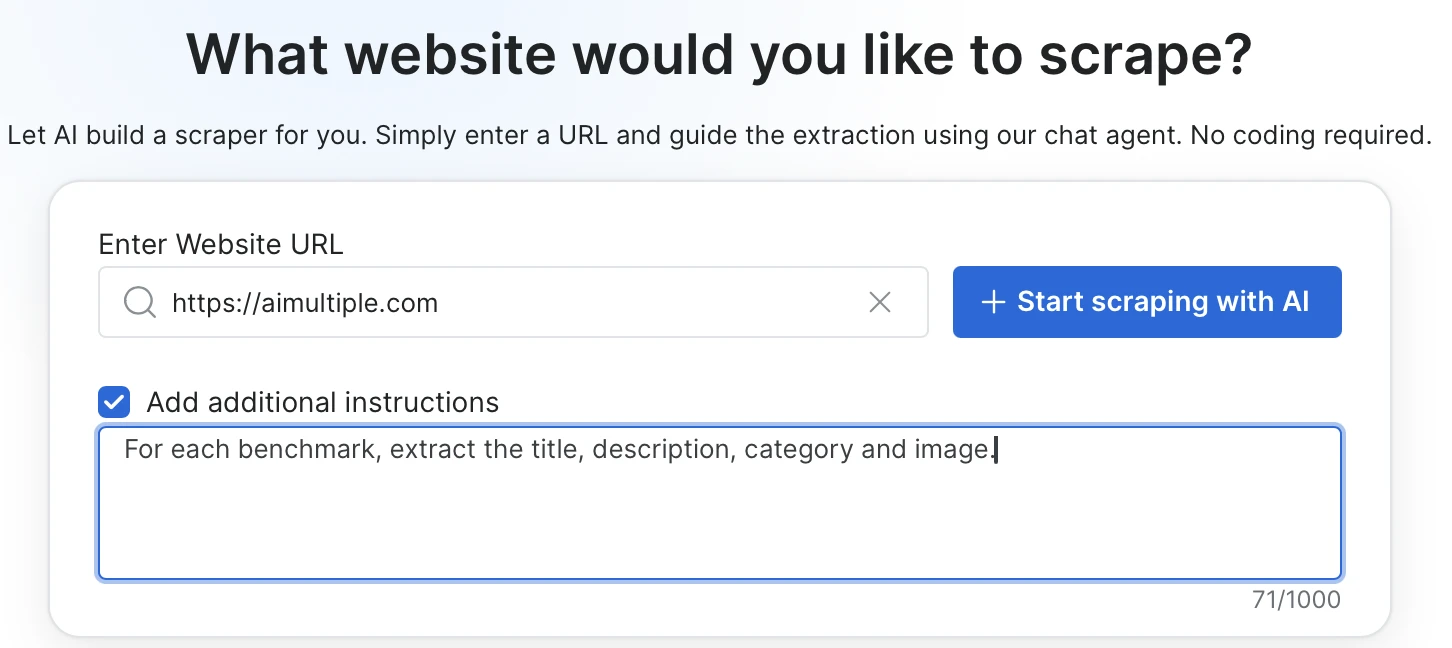
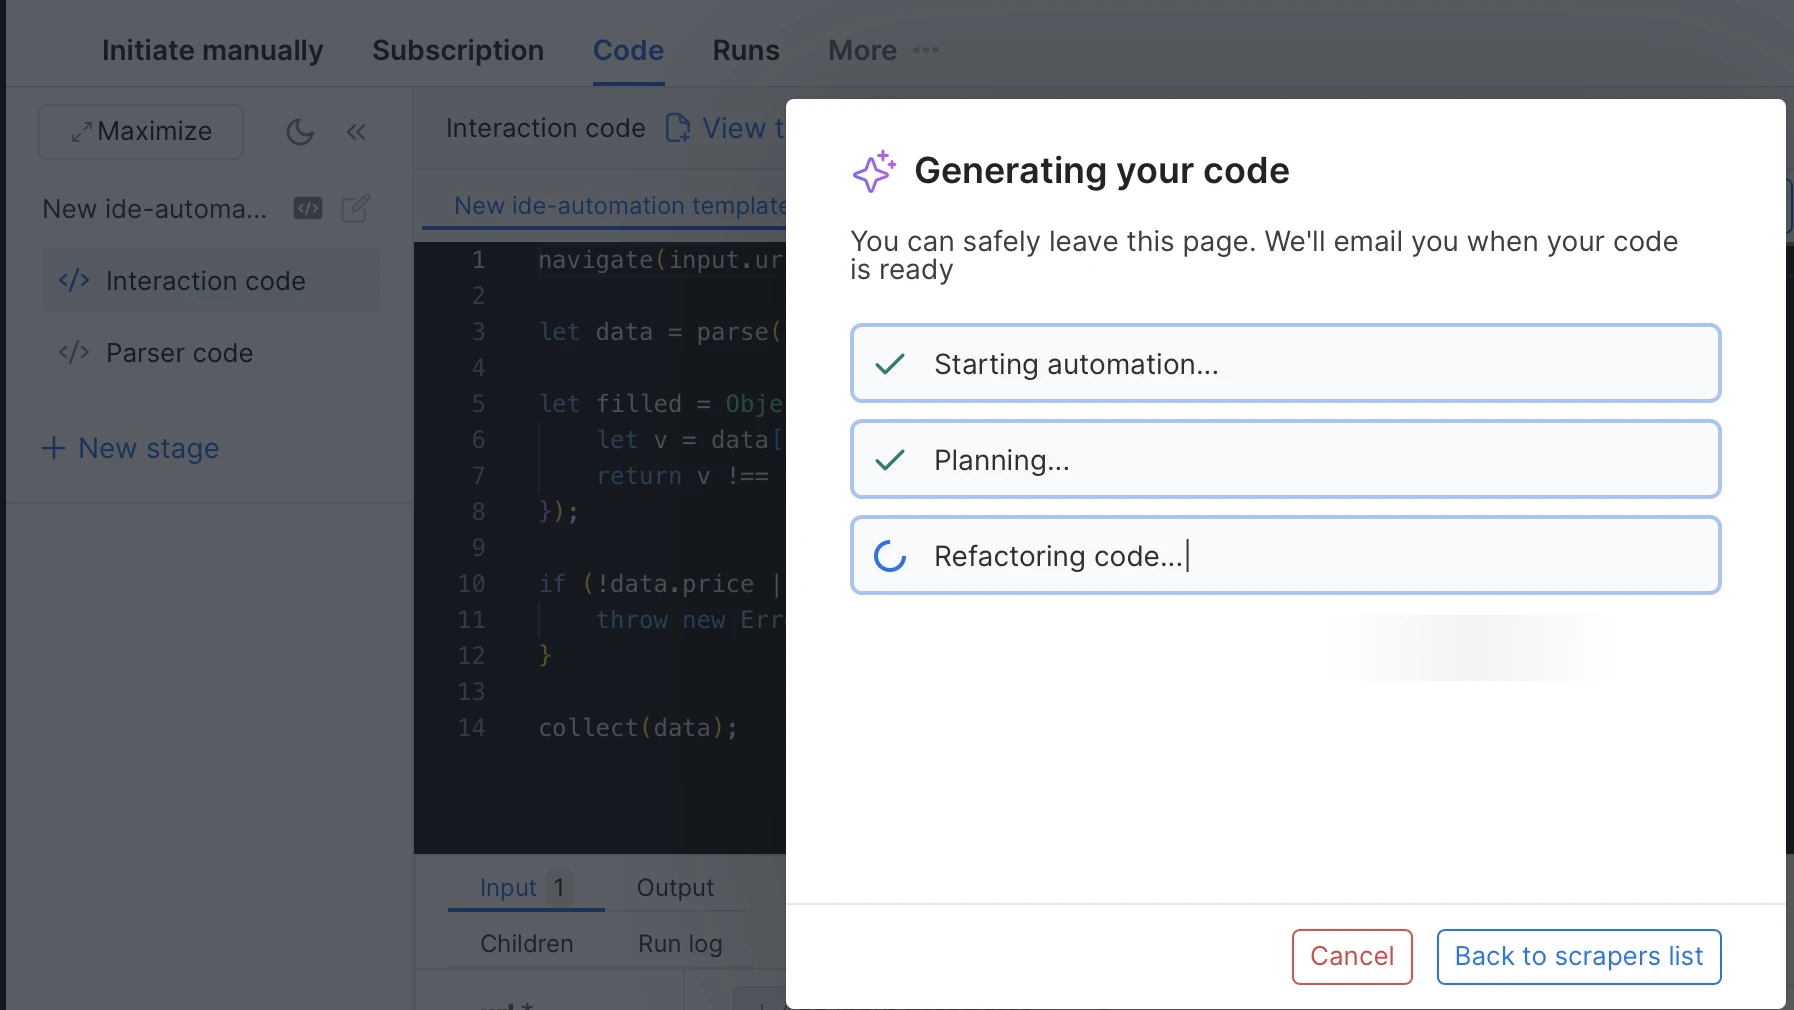
Bright Data Scraper Studio cria um scraper a partir de um prompt e depois o disponibiliza como uma API estável. Após a configuração única, cada chamada recebe apenas uma URL.
Você descreve os campos que deseja extract em linguagem simples, e pode, opcionalmente, adicionar seletores CSS, ações obrigatórias na página ou comportamento de carregamento da página.
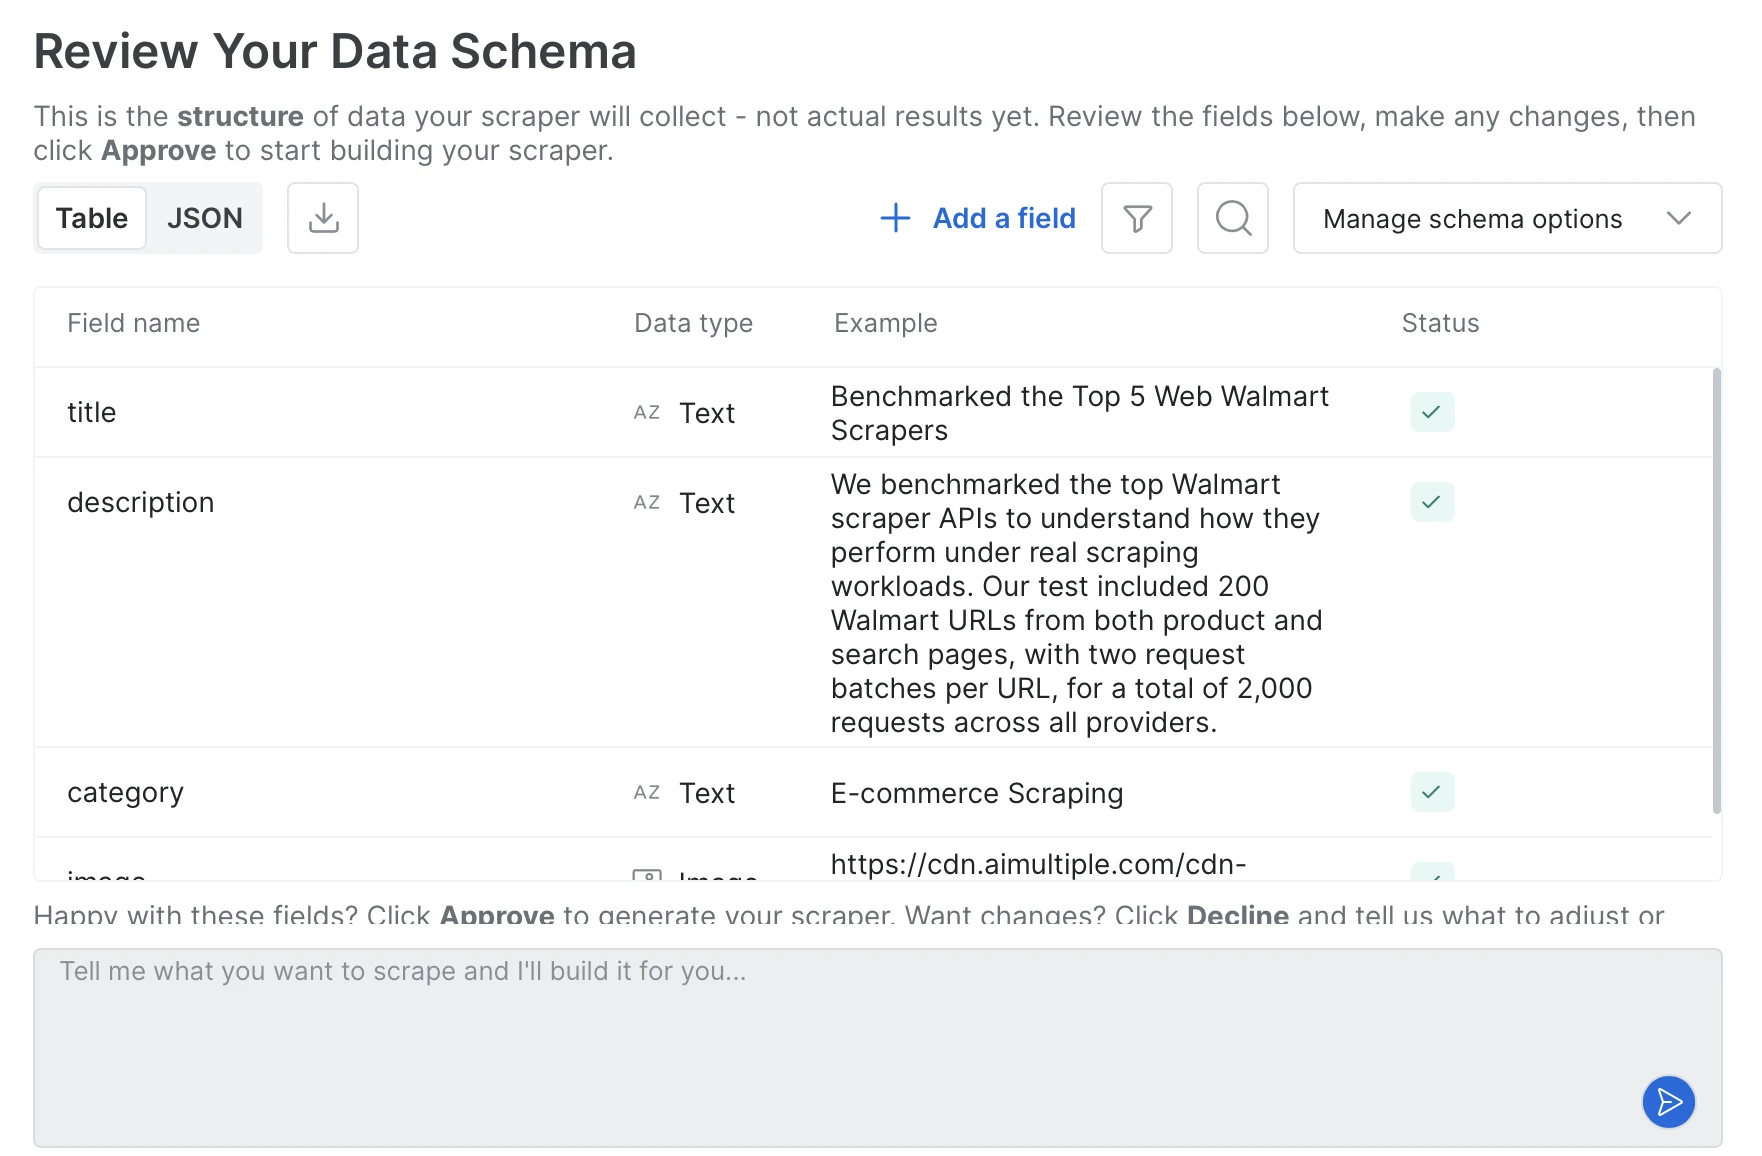
O agente do Scraper Studio gera o esquema de saída a partir do prompt. Você revisa o esquema, adiciona ou remove campos ou altera tipos, e o agente então escreve o código do scraper.
- Endpoint de criar uma vez, chamar muitas vezes: depois que você aprova o esquema, o scraper é registrado como um endpoint de longa duração com um identificador fixo. Cada chamada atinge o mesmo endpoint apenas com uma URL, e o esquema de saída permanece o mesmo entre as chamadas. Em nossos testes, criar um scraper dedicado levou cerca de 10 minutos em média.
- Dois métodos de criação: você pode conversar com o Agent no navegador ou usar a CLI do Bright Data para criar o scraper a partir do seu terminal com um único comando que recebe uma URL e um prompt. Ambos produzem o mesmo scraper.
- Fluxo de trabalho de agente de codificação: os comandos do terminal são executados sem alterações dentro de Claude Code, Cursor e Codex, para que o agente possa criar, executar ou autorreparar um scraper sem sair do editor. Você também pode fixar o identificador do scraper no arquivo de regras do agente para que sessões futuras o reutilizem.
- Entrega: API, SDK, CLI, webhooks ou entrega direta ao armazenamento em nuvem no S3, GCS, Azure ou OSS.
- Combinado com scrapers pré-criados: Bright Data mantém uma biblioteca de scrapers prontos para sites populares como Amazon, LinkedIn e Zillow.
Autorreparação automatizada
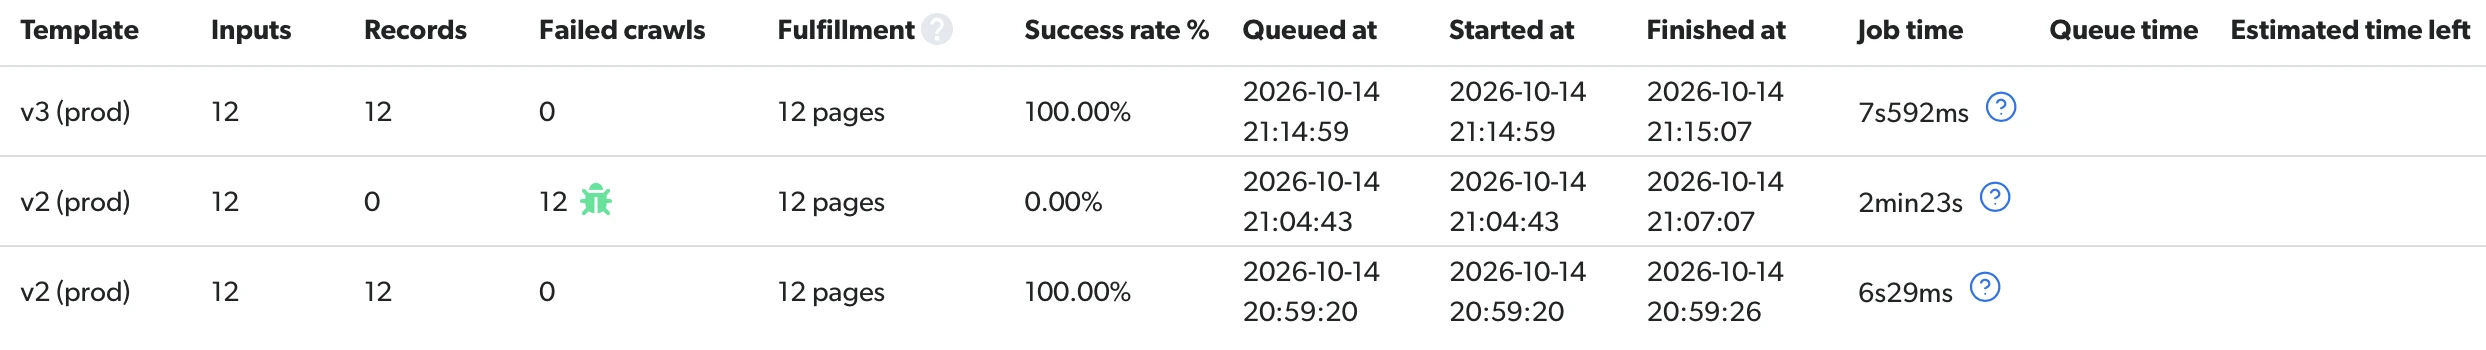
O Scraper Studio da Bright Data consegue reparar sozinho um scraper salvo. Nós o testamos em páginas de produto que hospedamos, solicitando título, preço, moeda, vendedor e disponibilidade. A primeira execução retornou registros com 100% de sucesso.
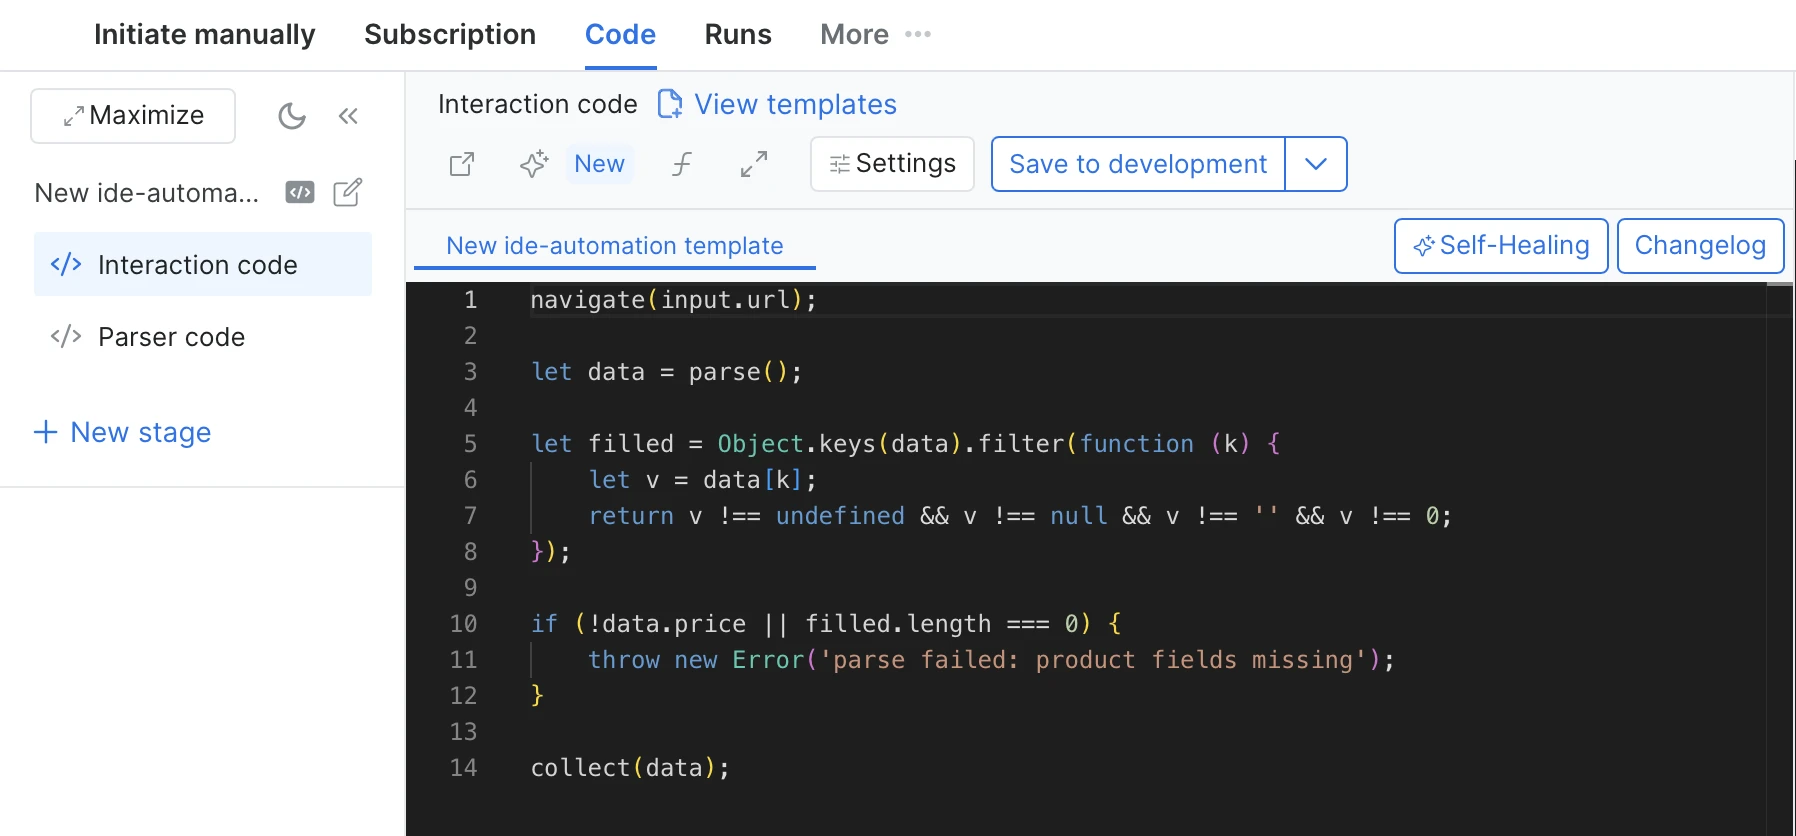
Adicionamos uma verificação ao código gerado. Se o preço estiver ausente, ou se nenhum campo retornar, a execução gera um erro em vez de coletar um registro vazio.
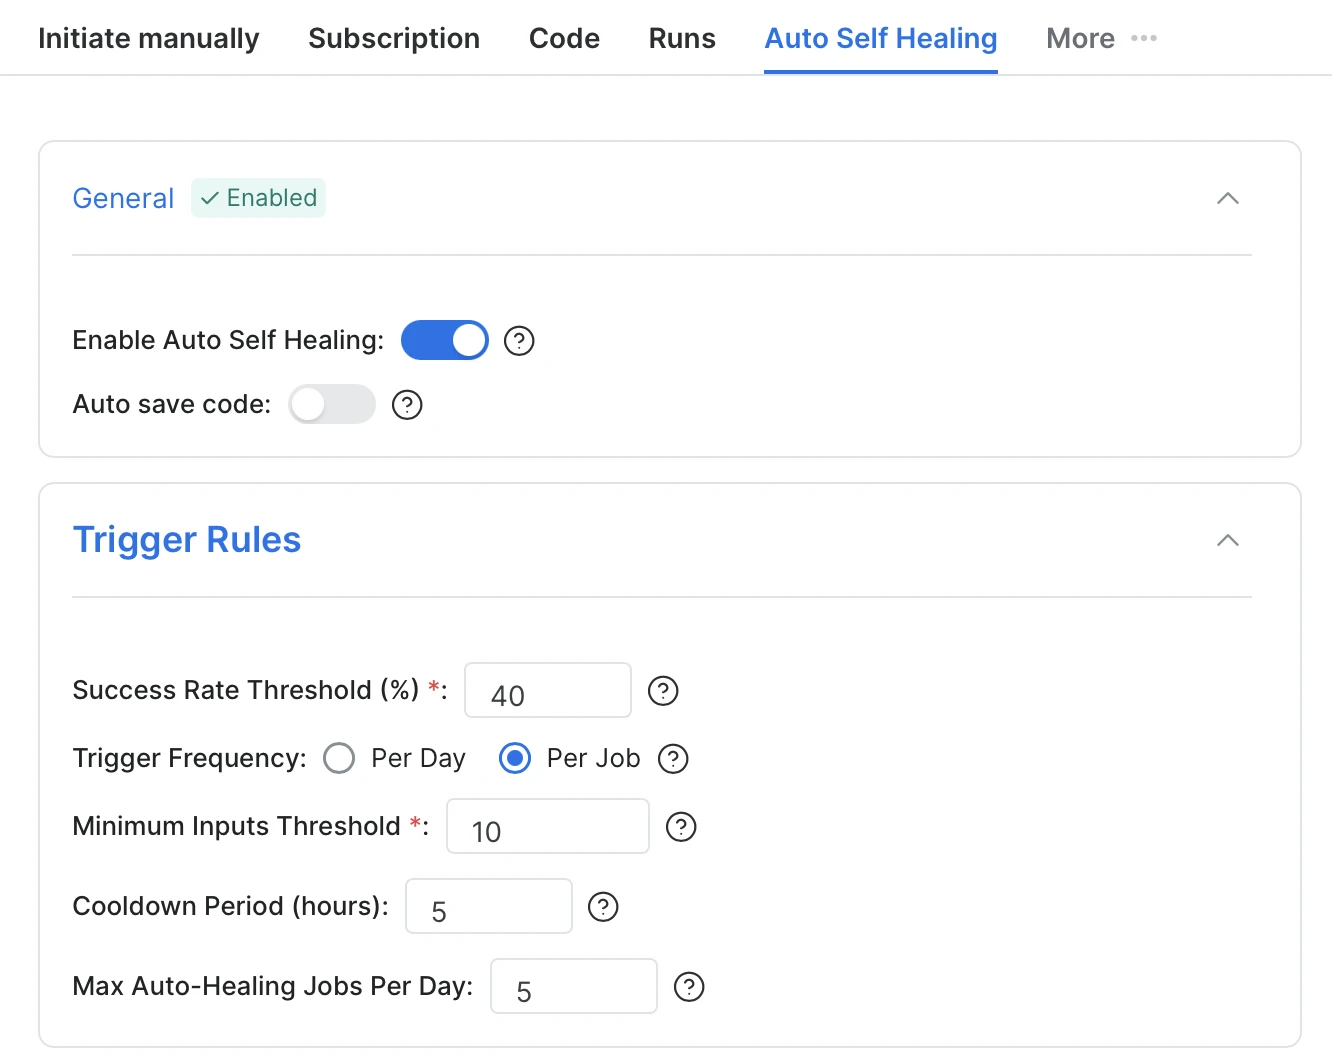
Ativamos a Auto Self-Healing com as regras de gatilho padrão: a recuperação começa quando a taxa de sucesso cai abaixo de 40%, verificada após cada tarefa, em execuções com pelo menos 10 entradas. Deixamos o salvamento automático de código desativado, para que qualquer reescrita aguardasse aprovação.
Redesenhamos então as páginas por trás das mesmas URLs, alterando tags e nomes de classes, mas deixando todos os valores no HTML como texto simples. A execução seguinte relatou 12 rastreamentos falhados e 0% de sucesso, e a recuperação começou sem que pedíssemos.
A versão recuperada retornou todos os registros com 100% nas mesmas URLs.
As mesmas URLs obtiveram 100% no layout original, 0% após o redesenho e 100% novamente depois que a Auto Self-Healing reescreveu o coletor.
Isso é importante para scrapers que você mantém em um pipeline: quando o site muda de layout, o scraper que você criou se repara e retoma, desde que a queda na taxa de sucesso fique abaixo do limite que você definiu.
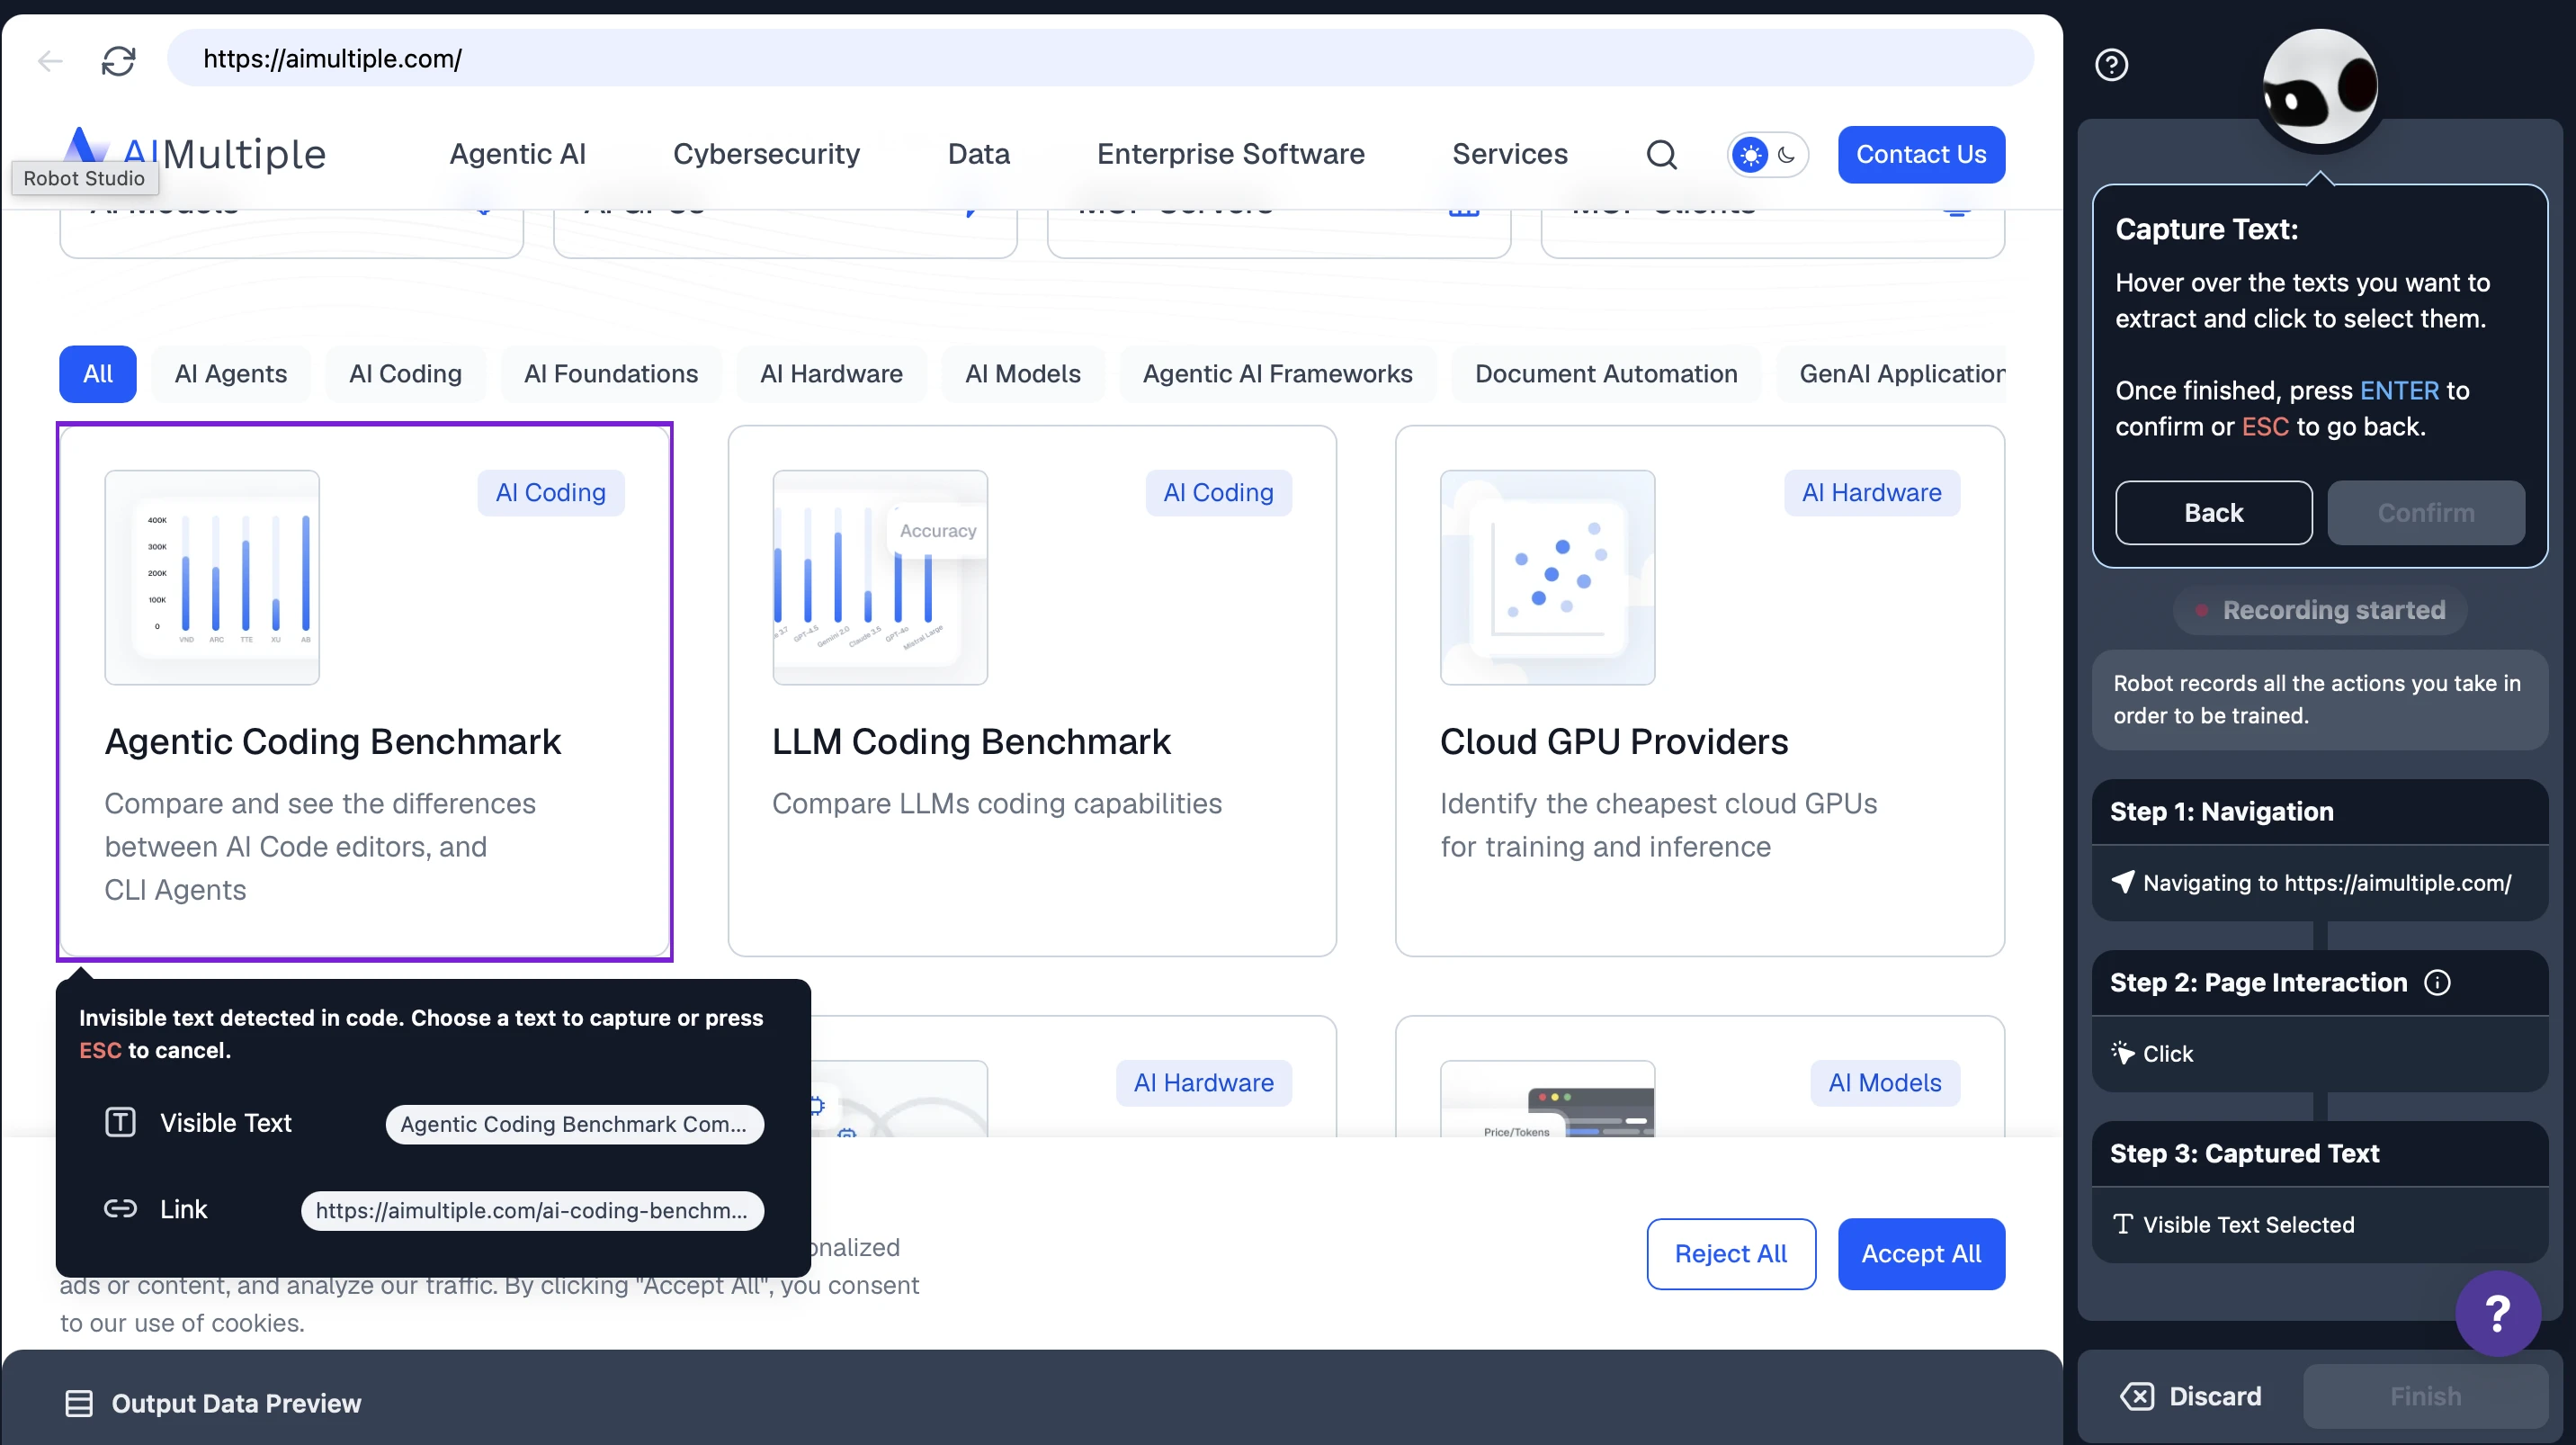
Browse IA cria scrapers, chamados robôs, a partir de uma gravação visual. Você abre a página de destino e clica nos campos a capturar. O robô salva as etapas de navegação e os campos selecionados como uma gravação e a reproduz em cada execução.
- Configuração visual com Robot Studio: os scrapers são criados com um fluxo de clicar → capturar campo → salvar.
- Monitoramento e alertas integrados: programações por hora, dia ou semana, detecção de mudanças e alertas por e-mail ou webhook no mesmo produto.
- O esquema é formado a partir dos campos capturados: uma etapa de captura separada é adicionada para cada campo; sem prompt para esquema.
- Adaptação automática: o mecanismo do Browse IA adapta o código de raspagem quando um site muda, e a maioria dos robôs continua funcionando sem intervenção. Quando a adaptação não é suficiente, você retreina o robô, o que preserva seu histórico, execuções e fluxos de trabalho.
A Kadoa cria um scraper, chamado workflow, a partir de um prompt e o armazena como código gerado, de modo que há um artefato concreto para monitorar e reparar.
- Endpoint de criar uma vez, chamar muitas vezes: um workflow salvo recebe um ID persistente e é chamado com
PUT /v4/workflows/{id}/run. A solicitação carrega apenas variáveis e um limite de linhas; o esquema e o código de extração permanecem no lado da Kadoa. Apontar o mesmo workflow para uma URL diferente significa atualizar seus metadados primeiro, portanto não é uma única chamada com uma URL dentro dela. - Prompt para esquema tipado: você descreve os dados no prompt de configuração e a Kadoa propõe um esquema que você edita em uma visualização visual ou JSON. Os campos têm tipos como STRING, NUMBER, MONEY, DATE e LINK e podem ser marcados como chaves.
- Scraper salvo com autorreparação: o reparo é acionado por uma execução falha em vez de uma programação. A Kadoa regenera o código de extração e o valida em relação aos dados extraídos anteriormente, sob o mesmo ID de workflow, para que programações e integrações continuem funcionando. Não há etapa de aprovação antes de a correção entrar em vigor. Quando a recuperação automática falha, um chamado é enviado à equipe de operações da Kadoa.
- Fluxo de trabalho de agente de codificação: um servidor MCP hospedado com mais de 40 ferramentas, além de SDKs oficiais para Node e Python e uma CLI (
kadoa create,kadoa run,kadoa export). - Entrega: API, SDK, CLI, MCP e Google Sheets para pull; S3, GCS, Azure Blob, webhooks, WebSockets, e-mail e Slack para push; Snowflake e Databricks para compartilhamento. Os conectores de armazenamento em nuvem são configurados por meio do suporte, e não por autoatendimento.
APIs de extração de IA de uma única chamada
As APIs de extração de IA de uma única chamada não armazenam nenhum scraper. Cada chamada envia uma URL com um prompt ou um esquema, e a ferramenta busca a página e executa a extração com LLM no momento da solicitação. Oxylabs IA Studio, o ator IA Web Scraper da Apify, Firecrawl e ScrapingBee funcionam dessa forma.
O Oxylabs IA Studio é um conjunto de cinco aplicações de IA separadas sob um único SDK (pip install oxylabs-ai-studio): AiScraper, AiCrawler, BrowserAgent, AiSearch e AiMap. Nada é persistido no lado do servidor; cada chamada de raspagem executa uma nova busca e extração com LLM.
- Fluxo do AiScraper: generate_schema(prompt=…) chama opcionalmente o LLM para produzir um esquema JSON e, em seguida, scrape(url, schema) busca a página e executa a extração com LLM. Você pode manter e reutilizar o esquema do seu lado, mas o servidor não registra um scraper de longa duração.
- Cinco aplicações, um SDK: AiScraper para extração estruturada de URL única, AiCrawler para navegação de sites orientada por prompt, BrowserAgent para ações na página, AiSearch para busca em linguagem natural com extração e AiMap para mapas filtrados de URLs de um site.
- Formatos de saída: markdown (padrão), json, csv, toon (um formato otimizado para tokens), screenshot e html (somente no agente de navegador).
- Esquemas escritos à mão:
generate_schemaé opcional. O parâmetroschemaaceita qualquer JSON Schema que você escrever, e os próprios exemplos da Oxylabs passam um modelo Pydantic escrito à mão. Um esquema é obrigatório para saída em JSON, CSV e TOON. - Parâmetros notáveis: render_javascript="auto" permite que o serviço decida se a renderização de JS é necessária, geo_location aceita um código de país ISO ou nome para a localização do proxy e max_credits define um teto de gastos por solicitação.
A Apify oferece um ecossistema aberto de desenvolvedores onde “Actors”, programas executáveis de raspagem e automação, são criados e executados em sua plataforma. Você pode escrever seu próprio Actor do zero, começar a partir de um modelo pronto ou usar Actors que outras pessoas publicaram na Apify Store.
- Actor de extração com IA: a Apify também tem um Actor pronto apify/ai-web-scraper que recebe um prompt em linguagem natural e retorna JSON estruturado de qualquer URL. Você insere o prompt novamente a cada execução, e a saída JSON não tem garantia de permanecer consistente entre as chamadas, o que é comportamento comum em ferramentas orientadas por prompt.
- Somente prompt: a entrada do Actor tem cinco campos:
startUrls,extractionMode,prompt,maxPagesToVisitemaxCrawlDepth. Não há parâmetro para um esquema de saída definido pelo usuário. - Crie seu próprio Actor: se não existir um scraper pronto para o seu site de destino ou se nenhum deles extrair os campos de dados que você deseja, você escreve seu próprio Actor e decide quais campos extract, onde eles estão na página e como lidar com o restante. Quanto tempo isso leva depende das suas habilidades de codificação e da complexidade do site. Se preferir não fazer por conta própria, você também pode obter ajuda dos serviços profissionais da Apify.
- Combinado com scrapers pré-criados: a Apify Store lista Actors que os desenvolvedores publicam. A maioria dos scrapers para sites populares é publicada e mantida por desenvolvedores terceirizados.
- Serviços da plataforma: os Actors vêm com agendamento, monitoramento, armazenamento de dataset, pool de proxies e acesso à API prontos para uso.
- Acesso para agentes: o servidor MCP da Apify permite que um agente de codificação pesquise e execute Actors, mas não possui um fluxo integrado para criar ou manter um Actor a partir do agente.
- Responsabilidade de manutenção: se você mesmo criou o Actor, você o corrige quando o site mudar. Se estiver usando um da Store, você aguarda o proprietário do Actor disponibilizar a correção no cronograma dele.
O Firecrawl transforma uma URL mais um prompt ou um esquema JSON em JSON em uma única chamada síncrona. Cada solicitação executa o pipeline de extração no momento em que a chamada é feita.
- Prompt ou esquema: um esquema fixa os nomes e tipos dos campos antes da chamada, para que a resposta contenha apenas os campos que você nomeou. Um prompt deixa a estrutura a cargo do modelo, o que é mais rápido de escrever, mas pode variar entre as chamadas.
- Formatos por tipo de página:
product,menu,branding,audioevideoretornam uma estrutura fixa definida pelo Firecrawl.productcobre título, preço, disponibilidade, variações e preço promocional. Eles não recebem parâmetros e são executados sem um LLM. deterministicJson: recebe um esquema e armazena em cache um extrator gerado por site, para que raspagens repetidas ignorem o LLM. Não pode ser combinado com o formatojson.- Execução por solicitação: cada chamada carrega seu próprio prompt ou esquema e é executada no momento da solicitação, para que a saída reflita a página como ela se apresenta naquele momento e não haja nada para registrar antecipadamente.
- Suporte a agentes de codificação: servidor MCP e CLI oficiais, com guias rápidos para Claude Code, Cursor, Codex CLI e Gemini CLI, além de um plugin oficial para o Claude.
- Agente: o Firecrawl também oferece um produto Agent em que a URL é opcional. Você descreve o que deseja e o agente navega na web para encontrar.
O ScrapingBee é uma API de extração de uma única chamada, como o Firecrawl: cada chamada é independente e não armazena nada. O ScrapingBee difere na forma como você descreve os dados que deseja.
- Três modos de extração: ai_query para um único campo em linguagem natural (retorna uma string), ai_extract_rules para um esquema JSON em que cada campo tem sua própria descrição e uma forma avançada do mesmo com tipos, enums e saída aninhada.
- ai_selector: passe um seletor CSS para concentrar o LLM em uma parte específica da página. Mais rápido e mais preciso do que deixá-lo ler o DOM inteiro.
- Raspagem clássica na mesma chamada: render_js para sites com muito JavaScript, screenshot, extract_rules para extração por CSS/XPath sem IA e json_response para obter HTML, cookies, XHRs e iframes em um único envelope.
Como escolher a ferramenta certa para o seu pipeline?
A ferramenta certa depende da frequência com que seu pipeline raspa os mesmos sites e de quem mantém o scraper:
Raspagem pontual ou ocasional
Para raspagem pontual ou ocasional, as APIs de extração de IA de uma única chamada, como Firecrawl, ScrapingBee e Oxylabs IA Studio, são a opção mais rápida. Você envia um prompt ou um esquema a cada chamada, e não há nenhum scraper para criar.
Raspagem repetida em um pipeline
Para raspagem repetida, ou quando você precisa de campos de dados personalizados, uma plataforma de criar uma vez e chamar muitas vezes, como Bright Data Scraper Studio, Browse IA ou Kadoa, se encaixa melhor. O scraper armazenado retorna o mesmo esquema a cada chamada, e seu pipeline passa apenas URLs.
Quanto tempo leva a configuração
O tempo de criação varia conforme a abordagem. Escrever um scraper ou Actor do zero normalmente leva dias ou semanas, já que o crawler, a configuração de proxies e as repetições são de sua responsabilidade. As plataformas baseadas em prompt geram o esquema e o código em minutos. As ferramentas baseadas em gravação também ficam prontas em minutos, com configuração por apontar e clicar em vez de um prompt. As APIs de extração de IA de uma única chamada pulam a etapa de criação; a primeira resposta chega em uma única chamada HTTP.
Site já coberto por um scraper pronto
Um scraper pronto para um site popular geralmente é mais rápido do que criar o seu próprio, mas quem o mantém funcionando depende de onde ele vem. Uma biblioteca mantida pelo fornecedor, como a da Bright Data, é atualizada pelo fornecedor quando o site muda. Um scraper de terceiros, como a maioria dos Actors de sites populares na Apify Store, é corrigido no cronograma do proprietário.
Site não coberto por nada pronto
Para sites sem um scraper pronto, a questão é quem corrige o scraper quando o layout muda. Se você criar o seu próprio, você o mantém. Com uma ferramenta baseada em gravação, como o Browse IA, o robô se adapta à maioria das mudanças sozinho, e você o retreina quando ele não consegue. Com a autorreparação por IA, a ferramenta repara seu scraper armazenado sob o mesmo ID: a Bright Data mostra a correção para sua aprovação antes de entrar em vigor, enquanto a Kadoa a aplica automaticamente.
Criação com agentes de codificação
Se o seu fluxo de trabalho passa pelo Claude Code, Cursor ou Codex, é importante saber se a ferramenta expõe uma CLI ou uma integração MCP que o agente possa conduzir de ponta a ponta, ou se o agente só pode chamar uma HTTP API simples.
 Adicionar como fonte preferencial
Metodologia do benchmark de web scraping com IA
Domínios do benchmark:
Os dez domínios do benchmark de web scraping com IA vêm do ranking da Semrush dos sites mais visitados. Cinco são de e-commerce (amazon, ebay, etsy, aliexpress, walmart) e cinco são de redes sociais (facebook, instagram, reddit, tiktok, x). Coletamos 500 URLs de cada um, 5.000 no total, e enviamos cada uma a todas as cinco ferramentas, o que soma 25.000 solicitações.
Prompts:
Cada ferramenta recebeu exatamente o mesmo prompt para um determinado tipo de página, sem ajustes específicos de ferramenta:
- E-commerce: Extract o preço e a moeda do produto e retorne json
- Social: Extract o texto da publicação, o número de curtidas e o nome de usuário do autor da publicação e retorne json
O Bright Data usa o prompt uma etapa antes dos demais. Em vez de raspar a partir de um prompt a cada chamada, você fornece o prompt uma única vez e ele cria um scraper, retornando um ID de coletor que você passa a chamar repetidamente. Essa etapa de criação não é raspagem; é a ferramenta gerando uma API, e acontece uma vez por domínio antes do início de qualquer benchmark, portanto não entra nas medições de tempo. Medimos a partir do ID do coletor em diante, ponto em que o processo se iguala aos outros quatro. Para mantê-lo zero-shot, o esquema gerado pela Bright Data foi aceito automaticamente conforme veio da API, sem revisão e sem correção.
Cada ferramenta foi chamada da forma como sua própria API foi construída. Bright Data, Apify e Firecrawl foram projetadas para receber uma lista de URLs em uma única solicitação, por isso enviamos 100 URLs por solicitação. Oxylabs e ScrapingBee não são construídos dessa forma; suas APIs recebem uma URL por vez, então foi assim que as chamamos. A concorrência foi a mesma para todas as ferramentas, cinco solicitações paralelas.
Métricas:
Sucesso é a parcela de solicitações que retornaram com pelo menos um dos campos solicitados. Strings vazias, zeros no lugar de um número e respostas que repetem o prompt de volta não contam como campo.
Completude é quantos dos campos solicitados retornaram, calculada em média entre as solicitações. Uma página social em que apenas o autor chega pontua um de três.
Precisão é a parcela de valores verificáveis que estavam corretos. Um campo que a ferramenta nunca retornou conta como errado, porque, no restante do fluxo, um valor ausente e um valor errado custam o mesmo.
Cada medida é calculada por domínio e, em seguida, é calculada a média entre os dez.
Como estabelecer a resposta correta
Usamos dois métodos. Quando havia valor de referência, pontuamos em relação a ele: algumas respostas estão na própria URL, como o identificador do autor em um link de x.com ou tiktok.com, e, para outras, coletamos uma referência independente fora das cinco ferramentas, como preços de produtos e contagens de votos do Reddit.
Quando não havia valor de referência, pontuamos por consenso. Um campo só é definido dessa forma quando pelo menos quatro das cinco ferramentas o responderam. Em seguida, separamos a ferramenta que está sendo avaliada e olhamos o restante: se o mesmo valor aparecer em mais da metade delas, e em pelo menos duas, esse valor se torna a referência. Uma ferramenta nunca vota na própria resposta, e um campo sobre o qual as outras não chegaram a acordo fica fora da pontuação de precisão.
Os números não precisam corresponder exatamente. Um valor conta como correto dentro de 10% da referência, com um piso absoluto pequeno além disso, para que uma publicação com 5 curtidas não falhe por uma diferença de um, enquanto uma publicação com 90.000 ainda seja julgada pela porcentagem.
Intervalos de confiança
Todas as figuras apresentam intervalos de confiança de 95% obtidos com 10.000 reamostragens bootstrap no nível da URL. Os dados por solicitação por trás de cada número são publicados junto com os resultados.
Perguntas frequentes
Sim. Bibliotecas de código aberto como Crawl4AI, Skyvern e Browser Use são gratuito para auto-hospedagem, e a maioria das ferramentas comerciais, incluindo Browse IA, Firecrawl e Thunderbit, oferece um plano gratuito com limites de uso.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{sipi2026,
  author = {Şipi, Nazlı},
  title  = {{Melhores ferramentas de web scraping com IA em benchmark}},
  year   = {2026},
  month  = oct,
  howpublished    = {\url{https://aimultiple.com/ai-web-scraping}},
  note   = {AIMultiple. Acessado em 14 outubro 2026}
}Resultados e carimbos de data/hora de 25.1 mil pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo 7 arquivos CSV e um README.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
5 atualizaçõesAdicionada uma seção de benchmark comparando ferramentas de web scraping com IA nos principais sites de e-commerce.
Substituiu a lista de ferramentas por entradas nomeadas para Browse AI, Firecrawl, ScrapeGraphAI, Diffbot, Kadoa, Skyvern e outras, e adicionou uma seção de FAQ.
Substituída a introdução às ferramentas de web scraping de IA por uma descrição de Agentes de IA Autônomos, Scraping Baseado em Visão (VLM) e scrapers de autocorreção.








Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.