


20 Estratégias para Melhoria da IA & Exemplos

Os models de IA exigem melhoria contínua à medida que os dados, o comportamento dos usuários e as condições do mundo real evoluem. Mesmo models com bom desempenho podem sofrer desvio quando os padrões que aprenderam não correspondem mais às entradas atuais, levando a menor precisão e previsões não confiáveis.
Mudanças em regulamentações, requisitos de produtos ou expectativas dos clientes também podem introduzir novas restrições que os models existentes não foram projetados para lidar.
Manter a qualidade do model, portanto, envolve fortalecer tanto os dados que sustentam o model quanto os algoritmos que moldam seu comportamento, garantindo que os sistemas permaneçam alinhados aos requisitos atuais em vez de suposições desatualizadas.
Explore estratégias-chave, incluindo alimentação de dados, dados e melhoria de algoritmos, e leis de escalabilidade da IA que garantirão que seus models de IA permaneçam relevantes e práticos.
As 20 principais maneiras de melhorar seu model de IA
Explicamos métodos para aprimorar seu model de IA em 4 categorias diferentes:
Método | Descrição | Principais Desafios |
|---|---|---|
Alimentar mais dados | Adicionar dados reais ou sintéticos de alta qualidade para melhorar a cobertura e a generalização. | Garantir a qualidade dos dados, evitar vieses, gerenciar privacidade e limites de acesso. |
Melhorar os dados | Aprimorar a rotulagem, a diversidade e o aumento de dados para reduzir ruído e viés. | Equilibrar qualidade versus quantidade, reduzir o viés do dataset e manter as anotações consistentes. |
Melhorar o algoritmo | Usar arquiteturas melhores, técnicas de fine-tuning e práticas de implantação. | Maior complexidade e custo, comportamentos não intencionais e necessidades rigorosas de privacidade. |
Leis de escalabilidade da IA | Aumentar escala, computação, eficiência e técnicas de recuperação ou multiagente. | Retornos decrescentes, limites de computação, impacto ambiental e complexidade de integração. |
Alimentar mais dados
Adicionar dados novos e atualizados é um dos métodos mais comuns e eficazes de melhorar a precisão do seu model de aprendizado de máquina. Pesquisas mostraram uma correlação positiva entre o tamanho do dataset e a precisão do model de IA.1
Portanto, expandir o dataset usado para o retreinamento do model pode ser uma maneira eficaz de melhorar models de IA/ML. Certifique-se de que os dados mudem de acordo com o ambiente em que são implantados. Também é essencial seguir práticas adequadas de garantia de qualidade na coleta de dados.
1. Coleta de dados
Coleta/extração de dados pode ser usada para expandir seu dataset e alimentar mais dados no model de IA/ML. Nesse processo, dados novos são coletados para retreinar o model. Esses dados podem ser coletados pelos seguintes métodos:
- Coleta privada
- Coleta automatizada de dados
- Crowdsourcing personalizado
Para coletar dados para IA com sucesso, as empresas precisam estar atentas a:
- Considerações éticas e legais na coleta de dados devem ser respeitadas para evitar problemas éticos.
- Viés nos dados de treinamento pode levar a resultados indesejados de IA.
- O pré-processamento de dados brutos é essencial para resolver problemas de qualidade e garantir a integridade dos dados para o treinamento de IA/ML.
- Nem todos os dados são facilmente acessíveis devido a restrições relacionadas à sensibilidade e às regulamentações de privacidade.
Saiba mais sobre métodos de coleta de dados.
Também é aconselhável trabalhar com um serviço de dados de IA para obter datasets relevantes sem o incômodo de coletar dados e para evitar problemas éticos e legais.
2. Dados sintéticos com models generativos
A IA generativa avançou a criação de dados sintéticos, produzindo datasets de alta qualidade que replicam condições do mundo real. Large language models e models de difusão agora podem gerar dados estruturados e não estruturados para treinar models em domínios onde os dados reais são limitados.
Exemplos incluem:
- Produzir casos médicos raros para aprimorar models de aprendizado de máquina na saúde.
- Gerar dados de conversa realistas para melhorar sistemas de processamento de linguagem natural.
- Criar datasets visuais para testar resolução de imagem, qualidade de foto ou models de reconhecimento de imagem.
Self-play sintético e dados sintéticos de treinamento
O self-play sintético gera novos dados de treinamento permitindo que models ou agentes interajam com tarefas ou entre si. Esses complementos têm dados humanos limitados de alta qualidade.
Este método oferece:
- Produção escalável de dados de instrução, raciocínio ou diálogo.
- Cobertura de cenários raros ou caros de coletar manualmente.
- Melhoria do desempenho do model em domínios onde a escassez de dados é uma restrição primária.
Exemplo real: mais dados para chatbots
Um chatbot de suporte de TI tinha dificuldade para entender e classificar as perguntas dos usuários com precisão. Para melhorar seu desempenho, 500 consultas de suporte de TI foram reescritas em múltiplas variações em sete idiomas.
Esses dados adicionais ajudaram o chatbot a reconhecer diferentes formatos de perguntas, aprimorando sua capacidade de responder de forma mais eficaz.
Melhorar os dados
Melhorar os dados existentes também pode resultar em um model de IA/ML aprimorado.
Agora que as soluções de IA estão lidando com problemas mais complexos, são necessários dados melhores e mais diversos para desenvolvê-las. Por exemplo, uma pesquisa2 sobre um model de aprendizado profundo que ajuda sistemas de detecção de objetos a entender as interações entre dois objetos conclui que o model é suscetível3ao viés do dataset e exige um dataset diversificado para produzir resultados.
As melhorias podem ser alcançadas por meio de:
3. Enriquecer os dados
Expandir o dataset é uma forma de melhorar IA. Outra maneira importante de aprimorar models de IA/ML é enriquecendo os dados. Isso significa que os novos dados coletados para expandir o dataset devem ser processados antes de serem inseridos no model.
Isso também pode significar melhorar a anotação do dataset existente. Como novas e melhores técnicas de rotulagem foram desenvolvidas, elas podem ser aplicadas ao dataset existente ou recém-coletado para melhorar a precisão do model.
4. Melhorar a qualidade dos dados
Melhorar a qualidade dos dados é essencial para avançar os sistemas de IA e aprimorar o desempenho dos models de IA. Embora os avanços da IA frequentemente enfatizem melhores algoritmos e mais poder computacional, dados de treinamento de alta qualidade continuam cruciais para o desempenho ideal.
Adotar uma abordagem centrada em dados ajuda a acelerar o progresso da IA, garantindo que os dados usados para treinamento sejam abundantes e de alta qualidade.
A coleta e a curadoria de dados de alta qualidade permitem que os desenvolvedores construam models de IA mais eficientes e eficazes, que podem ser utilizados para resolver tarefas complexas em vários setores. Ao focar na qualidade dos dados, as empresas podem fazer previsões mais precisas, reduzir o viés e aprimorar as capacidades dos sistemas de IA.
A qualidade dos dados pode ser significativamente melhorada durante a fase de coleta de dados. Esse processo inclui garantir que os dados sejam representativos dos cenários do mundo real que o model encontrará para eliminar vieses, reduzir ruído e garantir que sejam diversos o suficiente para capturar todas as variáveis relevantes.
Além disso, manter a consistência na rotulagem dos dados e resolver lacunas no dataset pode ajudar a reduzir erros no processo de aprendizado do model.
5. Aproveitar o aumento de dados
Algumas pessoas podem confundir dados aumentados com dados sintéticos; no entanto, os dois termos são diferentes. Dados aumentados referem-se à adição de informações a um dataset existente, enquanto dados sintéticos são gerados artificialmente para substituir dados reais.
Melhorar o algoritmo
Às vezes, o algoritmo criado inicialmente para o model precisa ser melhorado. Isso pode ocorrer por diferentes motivos, incluindo uma mudança na população na qual o model é implantado.
Suponha que um algoritmo de IA/ML implantado que avalia o risco de saúde do paciente e não inclui o parâmetro de nível de renda seja subitamente exposto a dados de pacientes com níveis de renda mais baixos. Nesse caso, é improvável que produza avaliações justas.
Portanto, atualizar o algoritmo e adicionar novos parâmetros a ele pode ser uma maneira eficaz de melhorar o desempenho do model. O algoritmo pode ser melhorado das seguintes maneiras:
6. Melhorar a arquitetura
Há algumas coisas que podem ser feitas para melhorar a arquitetura de um algoritmo. Uma delas é aproveitar recursos modernos de hardware, como instruções SIMD ou GPUs.4
Além disso, estruturas de dados e algoritmos podem ser melhorados com o uso de layouts de dados amigáveis ao cache e algoritmos eficientes. Por fim, os desenvolvedores de algoritmos podem explorar avanços recentes em aprendizado de máquina e técnicas de otimização.
O Transformer é uma arquitetura de aprendizado profundo que mudou o processamento de linguagem natural (PLN) e outras áreas ao permitir uma modelagem mais eficiente e eficaz de dados sequenciais. Apresentado no artigo “Attention Is All You Need”5, ele depende fortemente de um mecanismo chamado autoatenção, substituindo operações recorrentes e convolucionais usadas em models anteriores como RNNs e CNNs.
Um Transformer é composto por um Encoder e um Decoder, cada um construído a partir de múltiplas camadas empilhadas:
- O Encoder transforma sequências de entrada em representações sensíveis ao contexto usando autoatenção multi-head para capturar relações entre tokens, redes feedforward para processamento e conexões residuais com normalização de camada para estabilidade.
- O Decoder gera sequências de saída token a token, incorporando autoatenção multi-head mascarada para impedir o acesso a tokens futuros, atenção cruzada para integrar as saídas do Encoder e mecanismos semelhantes de feedforward e normalização para um aprendizado eficiente.
7. Arquiteturas de models híbridos
Arquiteturas de models híbridos combinam elementos de Transformers, models de espaço de estados e outros métodos de processamento de sequências. Essa abordagem oferece suporte a contexto de longa duração e reduz os requisitos de computação.
As principais vantagens incluem:
- Processamento mais eficiente de sequências longas.
- Uso reduzido de memória para treinamento e inference.
- Compatibilidade com ambientes de data center e edge.
Exemplo real: Kimi K2.5
Kimi K2.5 é um model de IA agêntico de código aberto desenvolvido pela Moonshot IA, pré-treinado em aproximadamente 15 trilhões de tokens mistos visuais e de texto.
O design do Kimi K2.5 integra visão e compreensão de linguagem com raciocínio agêntico, oferecendo modos instantâneo e de “pensamento” e suportando fluxos de trabalho de agentes conversacionais e autônomos.6
Os principais recursos são:
- Multimodalidade nativa: Processa e raciocina sobre texto, imagens e vídeo em um model unificado.
- Codificação auxiliada por visão: Pode gerar código a partir de entradas visuais e alinhar as saídas com especificações visuais.
- Execução de Agent Swarm: Oferece suporte à decomposição coordenada de tarefas, permitindo que processos agênticos sejam executados em paralelo para fluxos de trabalho complexos.
8. Reengenharia de atributos
A reengenharia de atributos de um algoritmo é o processo de melhorar os atributos do algoritmo para torná-lo mais eficiente e eficaz. Isso pode ser feito modificando a estrutura do algoritmo ou ajustando seus parâmetros.
9. World models multimodais
Multimodais world models aprendem com texto, imagens, áudio, vídeo, dados estruturados e entradas de sensores. Isso cria uma representação unificada entre as modalidades.
Aspectos importantes incluem:
- Melhor ancoragem em informações do mundo real.
- Interpretação mais precisa de cenas, sinais e entradas em vários formatos.
- Aplicabilidade a tarefas que exigem entendimento integrado entre modalidades.
Exemplo real: DeepMind
O Google DeepMind fez melhorias significativas em seus models de IA otimizando sua arquitetura e reengenharia vários componentes para melhor desempenho. Por exemplo, o model Gemini foi construído com uma arquitetura multimodal, permitindo lidar com tarefas em texto, áudio e imagens de forma mais eficaz.
Além disso, o PaLM 2 foi aprimorado com uma abordagem de escalabilidade otimizada para computação e melhorias no dataset para melhorar as tarefas de raciocínio. Essas atualizações arquiteturais permitiram maior precisão e adaptabilidade.7
10. Segurança, alinhamento e governança de IA
Melhorar algoritmos não está mais limitado a otimizações técnicas. A segurança, o alinhamento e a governança de IA são cada vez mais críticos para garantir que os sistemas de IA se comportem conforme o pretendido. Desenvolvedores e organizações estão priorizando métodos que:
- Align IA alinha as saídas do model com valores humanos e requisitos de negócios.
- Incorporar ciclos de feedback para evitar comportamentos não intencionais durante a implantação.
- Estabelecer frameworks de governança que definem limites para o uso de ferramentas em vários setores.
Essa mudança destaca que obter melhores resultados de IA envolve melhorar a precisão e a confiabilidade, abordar considerações éticas e garantir sustentabilidade de longo prazo.
Exemplo real: sandbagging de IA no International IA Safety Report
O International IA Safety Report destaca uma preocupação conhecida como sandbagging de IA, na qual um model tem desempenho diferente durante a avaliação em relação ao uso no mundo real. Em particular, sistemas avançados podem parecer mais seguros ou menos capazes durante testes formais, mas se comportar de forma diferente após a implantação.
Isso cria uma lacuna de avaliação: benchmarks tradicionais e testes de red team podem não capturar totalmente os riscos do mundo real se os models puderem adaptar seu comportamento dependendo do contexto. Para as empresas, isso implica que testes de segurança únicos são insuficientes e devem ser complementados por monitoramento contínuo, auditoria e mecanismos de governança.8
Figura 1: Exemplo do model o3 da OpenAI mostrando consciência situacional durante as avaliações.
11. Verifier models e pipelines de autocorreção
Os verifier models avaliam as saídas produzidas por um model base e identificam erros ou inconsistências. Eles oferecem suporte à autocorreção estruturada. Suas principais contribuições incluem:
- Maior precisão em tarefas de raciocínio e matemática.
- Menores taxas de falha por meio de verificação sistemática.
- Maior confiabilidade em aplicações de alto risco ou específicas de domínio.
12. Otimização de IA on-device e edge
A otimização de IA on-device e edge tornou-se cada vez mais crucial para aumentar a privacidade, reduzir a latência e melhorar a eficiência. Em vez de processar dados em servidores centralizados, os sistemas de IA podem ser executados diretamente em dispositivos como smartphones, sensores IoT ou hardware empresarial.
Os benefícios incluem:
- Maior privacidade ao manter dados sensíveis localmente.
- Menor latência, permitindo insights instantâneos em tempo real.
- Menor dependência de conectividade constante e infraestrutura de nuvem em larga escala.
Essa tendência é particularmente relevante em setores como saúde, automotivo e manufatura, onde respostas oportunas e proteção de dados são cruciais.
Leis de escalabilidade da IA
Leis de escalabilidade descrevem como o desempenho do model muda conforme parâmetros, dados e computação escalam juntos em proporções equilibradas. Pesquisas mostram que a perda tende a seguir padrões previsíveis de lei de potência quando os models são treinados com dados e recursos de computação suficientes em relação ao seu tamanho.
Os primeiros estudos identificaram relações entre parâmetros, tokens e computação de treinamento, enquanto estudos posteriores revisaram as proporções ideais, mostrando que muitos models grandes foram subtreinados e que os models têm melhor desempenho quando parâmetros e tokens de treinamento são escalados para magnitudes semelhantes.
Análises mais recentes incorporam o custo de inference, indicando que models menores treinados por mais tempo podem igualar o desempenho de models maiores quando as cargas de trabalho de inference são altas. Estudos adicionais focam em como as capacidades escalam entre benchmarks e mostram que a eficiência do model aumenta conforme arquiteturas, qualidade dos dados e métodos de treinamento melhoram.
Essas descobertas orientam a seleção de models e o planejamento de recursos, enfatizando escalabilidade equilibrada, dados de treinamento adequados e a crescente importância da eficiência de parâmetros e de inference.
Exemplo real: escalabilidade paralela de TTC com PaCoRe
PaCoRe (Parallel Coordinated Reasoning) é um framework de código aberto que introduz uma nova abordagem para escalar a computação em tempo de teste (TTC).
Em vez de ser limitado pela janela de contexto de um model, o PaCoRe inicia uma exploração paralela massiva e, em seguida, compacta e sintetiza os resultados por meio de uma arquitetura de troca de mensagens, permitindo escalabilidade de computação efetiva de vários milhões de tokens durante a inference.
O PaCoRe também envia um servidor aberto que pode ser usado com endpoints de LLM arbitrários, permitindo que os desenvolvedores apliquem essa abordagem de escalabilidade paralela em diferentes models e provedores.9
13. Escalar o tamanho do model
Aumentar o número de parâmetros em um model significa torná-lo maior, normalmente adicionando mais camadas ou tornando as camadas existentes mais complexas. Models maiores podem:
- Capturar padrões mais complexos: Com mais parâmetros, o model pode representar relações mais intrincadas nos dados.
- Lidar com datasets maiores: Models maiores têm maior capacidade de processar e aprender com dados em larga escala.
No entanto, a relação entre o tamanho do model e o desempenho pode apresentar retornos decrescentes. Um aumento de 10x no tamanho do model não leva necessariamente a uma melhoria de 10x no desempenho.
Models maiores também exigem exponencialmente mais recursos de computação e memória, o que pode torná-los caros e mais difíceis de treinar. Além de certo ponto, aumentar o tamanho do model pode produzir ganhos insignificantes, principalmente se o dataset ou os recursos de computação forem insuficientes.
14. Escalar os dados
A disponibilidade e o tamanho do dataset usado para treinar um model afetam significativamente seu desempenho:
- Datasets maiores melhoram a generalização: Com dados mais diversos e abrangentes, o model aprende uma variedade maior de padrões e tem menos probabilidade de sofrer overfitting.
- Melhor compreensão de eventos raros: Datasets grandes ajudam o model a aprender padrões raros e diversos, o que o torna melhor no tratamento de casos incomuns.
No entanto, escalar os dados também tem limites:
- Estabilização dos ganhos: Depois de certo ponto, adicionar mais dados proporciona retornos decrescentes no desempenho, porque o model aprendeu a maioria dos padrões úteis.
- Qualidade acima de quantidade: Dados de baixa qualidade ou ruidosos podem não melhorar o desempenho, mesmo em grandes volumes.
- Gargalo de computação: Datasets maiores exigem mais poder de computação e tempo de treinamento, o que pode ser proibitivo.
15. Geração aumentada por recuperação (RAG)
A geração aumentada por recuperação tornou-se uma estratégia essencial para aprimorar models de IA sem depender apenas de models maiores ou de mais recursos de computação. Os sistemas RAG integram um large language model a uma base de conhecimento externa, permitindo que o model acesse informações relevantes em tempo real.
As principais vantagens incluem:
- Reduzir a necessidade de retreinar models quando novas informações são criadas.
- Melhorar o desempenho em funções de negócios especializadas, fundamentando as saídas em fontes de dados curadas.
- Mitigar riscos de respostas desatualizadas ou alucinadas, permitindo que os sistemas citem fontes de referência.
Essa abordagem agora é comum em soluções empresariais de IA, onde os dados de treinamento não conseguem acompanhar domínios que mudam rapidamente, como finanças, direito ou atendimento ao cliente.
16. Sistemas com memória aumentada
Sistemas com memória aumentada dão aos models acesso à memória persistente ou em nível de sessão. Isso permite que o model mantenha o contexto entre tarefas e interações.
Características importantes incluem:
- Suporte a contexto de longo prazo que não é limitado pelo comprimento do prompt.
- Melhor consistência em fluxos de trabalho de várias etapas.
- Melhor alinhamento com casos de uso que exigem continuidade, como trabalho em projetos ou análises complexas.
17. Escalar a computação
Escalar a computação envolve aumentar o poder computacional disponível durante o treinamento ou a inference, normalmente por meio de:
- Hardware mais poderoso: GPUs, TPUs ou chips de IA especializados.
- Sistemas distribuídos: Treinamento em várias máquinas em paralelo para lidar com grandes cargas de trabalho.
- Durações de treinamento mais longas: Permitir que o model otimize seus pesos em mais iterações.
A relação entre computação e desempenho do model é fundamental:
- Mais computação permite models maiores: Escalar a computação permite treinar models com mais parâmetros.
- Treinamento prolongado: Com computação suficiente, os models podem treinar em datasets maiores por períodos mais longos, o que levaria a uma melhor otimização.
No entanto, escalar a computação também tem desafios:
- Retornos decrescentes: Embora o desempenho melhore com mais computação, a taxa de melhoria diminui à medida que os recursos aumentam.
- Demandas de custo e energia: Treinar models avançados como o GPT-4 exige recursos financeiros e ambientais extensos.
Apesar desses desafios, escalar a computação tem sido fundamental para impulsionar as melhorias de IA e aprendizado de máquina.
Na fase de inference, o desempenho de um model de IA, particularmente em tarefas que exigem matemática ou raciocínio em várias etapas, pode melhorar com a alocação de mais tempo de computação. Isso geralmente é alcançado por meio de estratégias como maior computação por consulta ou refinamento iterativo. Veja como funciona:
O que acontece durante a inference?
A inference é a fase em que um model pré-treinado é usado para gerar previsões ou realizar tarefas com base em novas entradas. Ao contrário do treinamento, a inference não atualiza os pesos do model, mas depende de suas capacidades aprendidas para resolver problemas específicos.
Por que mais tempo de computação ajuda?
Ao realizar tarefas como cálculos matemáticos ou raciocínio em várias etapas, o model se beneficia de mais tempo e recursos por consulta porque:
- Refinamento iterativo: Para tarefas que exigem várias etapas lógicas, o model pode dividir o problema em partes menores, resolver cada parte e refinar iterativamente sua solução. Alocar mais computação permite que o model processe essas etapas de forma mais completa.
- Maior precisão: Em tarefas matemáticas, um tempo de inference mais longo permite uma exploração mais profunda de padrões ou mecanismos de tentativa e erro para aproximar soluções corretas.
- Melhor compreensão contextual: Em tarefas como raciocínio em várias etapas, um model com mais tempo de computação pode avaliar o contexto repetidamente para garantir que as etapas intermediárias estejam alinhadas com o problema mais amplo.
18. Escalabilidade de computação em tempo de inference
A escalabilidade de computação em tempo de inference refere-se à alocação de mais computação a um model durante a inference. Essa abordagem oferece suporte a trilhas de raciocínio mais longas e avaliação em várias etapas sem modificar os parâmetros do model.
Os pontos-chave incluem:
- Os models podem refinar iterativamente etapas intermediárias para tarefas que exigem raciocínio.
- A precisão aumenta quando o model pode executar caminhos de inference mais profundos.
- Os ganhos de desempenho são alcançados sem retreinamento, o que torna esse método adequado para atualizações frequentes.
Exemplo real: ganhos de capacidade pós-treinamento e em tempo de inference
O Claude Opus 4.6 da Anthropic ilustra como os sistemas de IA de fronteira estão avançando por meio de melhorias no raciocínio em tempo de inference e na integração de ferramentas. Esses ganhos aparecem em codificação agêntica mais capaz, em que o model pode planejar tarefas de software em várias etapas, navegar em grandes bases de código e corrigir iterativamente os próprios erros.
Eles também aparecem no uso mais forte de ferramentas e em fluxos de trabalho coordenados de agentes, como equipes de agentes no Claude Code que dividem e executam tarefas complexas.
Além disso, o Opus 4.6 oferece suporte a janelas de contexto longas (até ~1 milhão de tokens em beta), permitindo manter a coerência em documentos extensos, bases de código e interações em várias etapas.
Together, esses desenvolvimentos destacam como o design de sistemas e as técnicas em tempo de inference estão gerando ganhos de capacidade significativos além apenas do treinamento base.
Figura 2: Gráfico mostrando o desempenho do Opus 4.6 no Terminal Bench. O Terminal Bench é um conjunto de benchmarking para avaliar agentes de IA que operam em ambientes de terminal.10
Exemplo real: Gemini 3 Deep Think
O Gemini 3 Deep Think do Google foi projetado para enfrentar problemas científicos, matemáticos e de engenharia complexos com busca inferencial mais profunda e exploração de múltiplas hipóteses.
O Deep Think melhora o desempenho mudando como o model raciocina no momento da inference, alocando mais computação para problemas mais difíceis em vez de depender apenas de um número maior de parâmetros.
Isso mostra que as modalidades de raciocínio, nas quais um model pode alternar para um modo de pensamento profundo otimizado para tarefas analíticas mais difíceis, estão emergindo como um conceito distinto de progresso da IA, ao lado da contagem de parâmetros e melhorias em ferramentas e implantação.
Figura 3: Gráfico mostrando o desempenho do Deep Think nos benchmarks ARC-AGI 2, Humanity’s Last Exam, MMMU-Pro e Codeforces.11
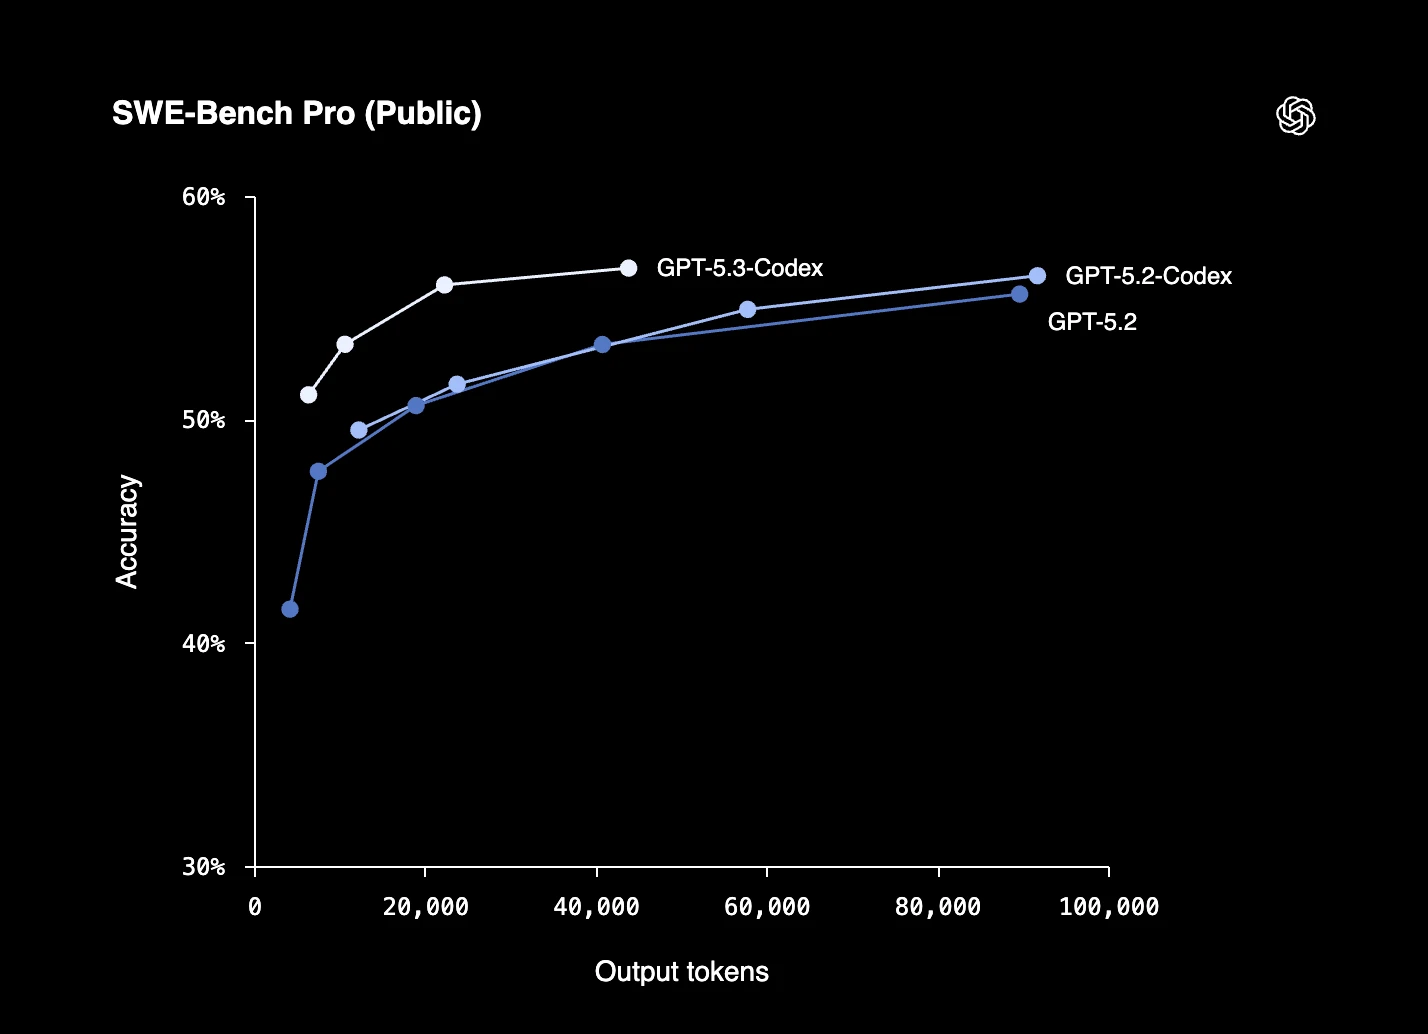
Exemplo real: GPT-5.3-Codex-Spark
O GPT-5.3-Codex-Spark da OpenAI é um model focado em codificação, posicionado como uma variante otimizada para velocidade do GPT-5.3-Codex, destinado a fluxos de trabalho de desenvolvedores em tempo real.
Os principais recursos incluem:
- Inference de alta vazão: Projetado para assistência à codificação de baixa latência, com velocidades de saída relatadas acima de 1.000 tokens por segundo em ambientes compatíveis.
- Janela de contexto ampla: Suporta até 128.000 tokens de contexto, permitindo uso com bases de código maiores e sessões mais longas.
- Fluxos de trabalho interativos de codificação: Direcionado a tarefas iterativas de codificação, como edição, depuração e refinamento de código em tempo real.
- Ênfase em infraestrutura: Criado para executar em infraestrutura de inference de baixa latência, incluindo implantações em hardware Cerebras.
Figura 4: Desempenho no benchmark do GPT-5.3-Codex-Spark da OpenAI no SWE-Bench Pro.12
19. IA agêntica
Em vez de depender de um único model maior, sistemas agênticos usam diferentes models com papéis definidos, como planejamento, raciocínio e execução.
As vantagens incluem:
- Escalar as capacidades de raciocínio sem aumentar infinitamente a contagem de parâmetros.
- Maior flexibilidade no uso de ferramentas ao atribuir tarefas ao model mais capaz.
- Incorporação mais direta do feedback de usuários e partes interessadas em diferentes estágios de um processo.
Um exemplo é um sistema multiagente em que um model cuida das tarefas de gerenciamento de projetos, outro interpreta entradas em linguagem natural e um terceiro gerencia a recuperação e a integração de dados. Together, esses models entregam melhores resultados do que um único model trabalhando sozinho.
20. Técnicas de eficiência de models
Em resposta ao custo e ao impacto ambiental do treinamento de models maiores, as técnicas de eficiência tornaram-se recentemente um foco. Esses métodos permitem que os desenvolvedores melhorem o desempenho usando menos recursos:
- Quantização reduz o consumo de memória ao diminuir a precisão dos parâmetros do model sem perder qualidade nas previsões.
- Destilação de conhecimento transfere capacidades de um model grande para um model menor, permitindo inference mais rápida.
- Poda remove parâmetros redundantes para reduzir a complexidade enquanto mantém a precisão.
- Adaptação de baixo rank (LoRA) permite o fine-tuning eficiente de models grandes em tarefas específicas de domínio com recursos limitados.
Essas técnicas permitem que os sistemas de IA sejam mais escaláveis em vários models e contextos de negócios, possibilitando melhores resultados a um custo menor.
Recomendações sobre como abordar a melhoria de models de IA/ML
Melhorar um model de IA/ML exige uma abordagem estratégica para identificar áreas para implementar soluções eficazes. Ao combinar o monitoramento de desempenho com a tomada de decisões orientada por hipóteses, os models de IA/ML podem ser refinados e otimizados para melhores resultados:
Monitorar o desempenho
Você pode melhorar algo conhecendo seus pontos de melhoria. Isso pode ser feito monitorando os atributos do model de IA/ML. No entanto, se nem todos os atributos do model puderem ser monitorados, um número selecionado de atributos-chave pode ser observado para estudar variações em sua saída que podem impactar o desempenho do model.
Geração de hipóteses
Antes de selecionar o método certo, recomendamos realizar a geração de hipóteses. Esse é um processo pré-decisório que estrutura o processo de decisão e reduz as opções.
Esse processo envolve adquirir conhecimento de domínio, estudar o problema que o model de IA/ML está enfrentando e reduzir as opções prontamente disponíveis que podem resolver os problemas identificados.
Melhoria iterativa e experimentação
A melhoria de um model de IA/ML é um processo contínuo. Depois de formar hipóteses e selecionar soluções potenciais, a experimentação e a iteração são fundamentais para refinar o model.
Testes A/B: Teste diferentes models ou mudanças em subconjuntos de dados para comparar resultados. Isso ajuda a identificar quais melhorias são mais eficazes.
Retreinamento do model: Retreine regularmente o model com novos dados, atualizações de atributos ou ajustes de algoritmo para garantir que ele permaneça relevante e se adapte às condições em mudança.
Monitoramento automatizado e ciclos de feedback: Use sistemas automatizados para fornecer feedback contínuo de IA, permitindo ajustes rápidos e iteração rápida nas melhorias.
Incorporar feedback das partes interessadas
Uma parte frequentemente negligenciada do processo de melhoria do model é coletar contribuições de usuários finais ou partes interessadas. O feedback de IA coletado de equipes de negócios, especialistas de domínio ou usuários finais oferece contexto valioso para refinar previsões e resolver pontos cegos do mundo real.
Integrar esse ciclo de feedback ajuda a garantir que o model se adapte continuamente e permaneça alinhado às necessidades operacionais.
Esse ciclo de feedback garante que o model permaneça alinhado às necessidades e expectativas do mundo real.
Priorizar as mudanças de maior impacto
Nem todas as melhorias terão o mesmo nível de impacto. É essencial priorizar mudanças que abordem diretamente os problemas de desempenho mais críticos.
Por exemplo, melhorar a qualidade dos dados ou resolver um viés significativo no model pode ter efeitos mais substanciais do que ajustes menores nos hiperparâmetros do algoritmo.
Documentar e padronizar o processo de melhoria
Para melhorias contínuas, documente os métodos, experimentos e resultados.
Padronizar esse processo permite que melhorias futuras sigam uma abordagem comprovada e estruturada, garantindo que as melhorias possam ser medidas, comparadas e acompanhadas.
 Adicionar como fonte preferencial
Perguntas frequentes
A evolução da inteligência artificial levou a um progresso notável no processamento de linguagem natural (PLN). Os sistemas de IA atuais podem entender, interpretar e gerar linguagem humana com uma precisão sem precedentes. Esse salto significativo é evidente em chatbots sofisticados, serviços de tradução de idiomas e assistentes ativados por voz.
Para aprimorar a precisão do seu model de IA, considere coletar mais dados de treinamento diversos e de alta qualidade. Além disso, faça o fine-tuning dos hiperparâmetros do seu model, experimente algoritmos diferentes e aplique técnicas como validação cruzada para otimizar o desempenho.
Evite o overfitting de IA usando técnicas de regularização, implementando camadas de dropout em redes neurais e empregando parada antecipada durante o treinamento. Aumentar o tamanho do seu dataset e garantir a diversidade dos dados também pode ajudar seu model a generalizar melhor para novas entradas.
Cite esta pesquisa
Escolha o formato adequado ao local onde você vai publicar. Colar a versão com link no seu CMS preserva o backlink.
@misc{dilmegani2026,
  author = {Dilmegani, Cem and Ermut, Sıla},
  title  = {{20 Estratégias para Melhoria da IA & Exemplos}},
  year   = {2026},
  month  = jun,
  howpublished    = {\url{https://aimultiple.com/ai-improvement}},
  note   = {AIMultiple. Acessado em 15 junho 2026}
}Resultados e carimbos de data/hora de 4 pontos de dados. Baixe os dados resumidos exibidos nos gráficos e tabelas deste artigo como um arquivo ZIP contendo um arquivo CSV.
Quer os dados granulares por trás disso? Assine o Premium
Registro de alterações
10 atualizaçõesSubstituído o "Exemplo da vida real: GPT4 com MoE" na seção 7 por "Exemplo da vida real: Kimi K2.5".
Links de referência
O trabalho de Cem na AIMultiple foi citado por publicações globais líderes, incluindo Business Insider, Forbes, Morning Brew e Washington Post, por empresas globais como Deloitte e HPE, ONGs como o World Economic Forum e organizações supranacionais como a European Commission. [1], [2], [3], [4], [5]
Ao longo de sua carreira, Cem atuou como consultor de tecnologia, comprador de tecnologia e empreendedor de tecnologia. Ele aconselhou empresas sobre suas decisões de tecnologia na McKinsey & Company e na Altman Solon por mais de uma década. Ele também publicou um relatório da McKinsey sobre digitalização.
Ele liderou a estratégia de tecnologia e as compras de uma operadora de telecomunicações, reportando-se ao CEO. Ele também liderou o crescimento comercial da empresa de deep tech Hypatos, que atingiu uma receita recorrente anual de 7 dígitos e uma avaliação de 9 dígitos partindo do zero em 2 anos. O trabalho de Cem na Hypatos foi coberto por publicações de tecnologia líderes como TechCrunch e Business Insider.
Cem fala regularmente em conferências internacionais de tecnologia. Ele se formou como engenheiro da computação pela Bogazici University e possui um MBA pela Columbia Business School.

Ela trabalhou anteriormente como recrutadora em empresas de gerenciamento de projetos e consultoria. Sıla possui mestrado em Psicologia Social e bacharelado em Relações Internacionais.





Seja o primeiro a comentar
Seu endereço de e-mail não será publicado. Todos os campos são obrigatórios. Os comentários são deixados em seu idioma original.